Co to jest homogeniczność wariancji?
Homogeniczność wariancji (jednorodność wariancji, ang. homogeneity of variance) to założenie, że wariancja zmiennej zależnej jest taka sama we wszystkich porównywanych populacjach: σ1² = σ2² = … = σk². Założenie dotyczy populacji, a nie prób – wariancje z próby zawsze trochę się różnią, a pytanie brzmi, czy różnice są na tyle duże, by zniekształcić wynik testu. Przeciwieństwem jest heterogeniczność wariancji; w regresji to samo założenie nazywa się homoskedastycznością.
Skąd to założenie? Klasyczny test t Studenta i ANOVA łączą wariancje wszystkich grup w jedno oszacowanie – średni kwadrat błędu, czyli wariancję wewnątrzgrupową. Takie uśrednienie ma sens tylko wtedy, gdy grupy mają wspólną wariancję. Jeśli jej nie mają, wspólne oszacowanie jest zdominowane przez największe grupy, a błąd standardowy różnic między średnimi – źle oszacowany.
W psychologii różne wariancje w grupach to raczej reguła niż wyjątek. Grissom (2000) pokazuje, że w danych klinicznych niejednorodności wariancji należy się spodziewać zarówno z powodów teoretycznych, jak i w świetle wyników empirycznych. Typowe sytuacje to interwencja, która u jednych osób działa silnie, a u innych wcale (rozrzut rośnie), efekt podłogi w grupie bez objawów albo grupy kliniczne bardziej zróżnicowane niż kontrolne.
Które analizy zakładają równe wariancje?
| Analiza | Czy zakłada równe wariancje? | Wersja bez tego założenia |
|---|---|---|
| Test t dla prób niezależnych (Student) | tak | test t Welcha |
| Jednoczynnikowa ANOVA | tak | ANOVA Welcha (test F Welcha) |
| Porównania par Tukeya i Bonferroniego | tak | test Gamesa–Howella (testy post hoc) |
| ANOVA wieloczynnikowa, ANCOVA | tak | test F z odpornymi błędami standardowymi (HC3) |
| Regresja liniowa | tak – stała wariancja reszt | odporne błędy standardowe, ważona MNK |
| Test t dla prób zależnych, ANOVA z powtarzanymi pomiarami | nie w tej postaci – zakłada się sferyczność | poprawki Greenhouse’a–Geissera i Huynha–Feldta |
| Testy Manna-Whitneya i Kruskala-Wallisa | formalnie nie, ale są wrażliwe na różne rozproszenia | ostrożna interpretacja, opis rozproszeń |
Co się dzieje, gdy wariancje są różne?
Odpowiedź zależy przede wszystkim od tego, czy grupy są równoliczne. Box (1954) pokazał, że w jednoczynnikowej ANOVA przy równych liczebnościach umiarkowana nierówność wariancji nie wpływa poważnie na test F, ale przy nierównych liczebnościach zniekształcenia są znacznie większe. Glass i in. (1972), podsumowując kilkadziesiąt lat badań nad skutkami naruszeń założeń ANOVA, przypominają, że założenia modeli nigdy nie są spełnione idealnie – właściwe pytanie brzmi, czy prawdopodobne naruszenia mają poważne konsekwencje.
Sprawdziliśmy to w symulacji: trzy grupy o równych średnich w populacji, wariancje w proporcji 1 : √VR : VR (VR to iloraz największej i najmniejszej wariancji), po 10 000 powtórzeń dla każdego punktu. Każdy istotny wynik jest więc fałszywym alarmem, a przy α = .05 powinno ich być 5%.
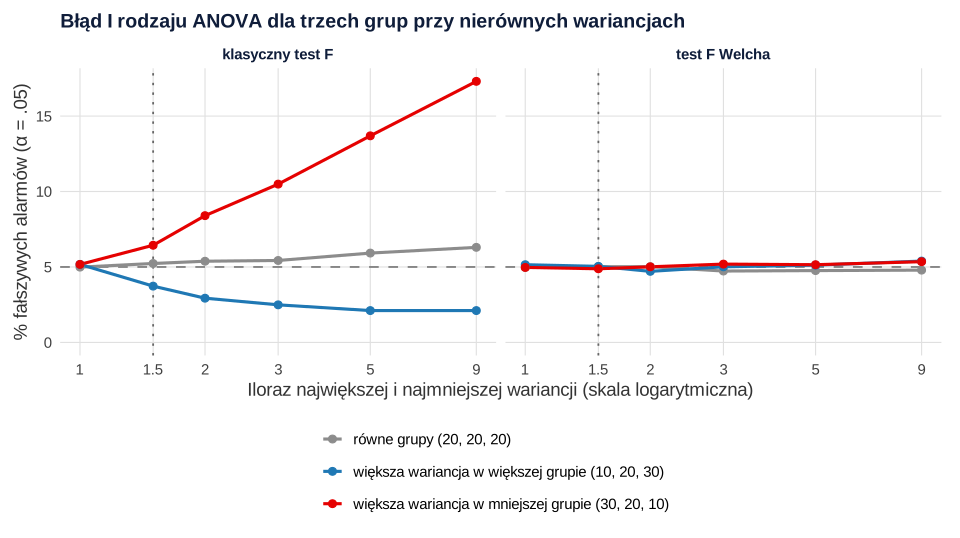
- Równe grupy (po 20 osób): klasyczny test F jest odporny – nawet przy dziewięciokrotnej różnicy wariancji dawał 6.3% fałszywych alarmów.
- Większa wariancja w większej grupie (10, 20 i 30 osób): test staje się zbyt zachowawczy – 2.1% fałszywych alarmów przy ilorazie 5 i 9. Brzmi to bezpiecznie, ale oznacza utratę mocy: test rzadziej wykryje różnicę, która naprawdę istnieje.
- Większa wariancja w mniejszej grupie (30, 20 i 10 osób): test staje się zbyt liberalny – 6.4% fałszywych alarmów już przy ilorazie 1.5, 10.5% przy ilorazie 3 i 17.3% przy ilorazie 9, czyli ponad trzy razy więcej, niż obiecuje α.
- Test F Welcha we wszystkich układach dawał od 4.7% do 5.4% fałszywych alarmów.
Mechanizm jest prosty: wspólna wariancja to średnia ważona liczebnościami. Gdy duża grupa ma małą wariancję, zaniża ona wspólne oszacowanie rozrzutu, przez co różnice średnich wyglądają na pewniejsze, niż są. Blanca i in. (2018), na podstawie obszernej symulacji jednoczynnikowej ANOVA, proponują regułę kciuka: przy nierównych liczebnościach iloraz największej i najmniejszej wariancji powyżej 1.5 należy traktować jako potencjalne zagrożenie dla odporności testu F (kropkowana linia na rysunku 1). Ten sam problem dla dwóch grup i testu t pokazuje symulacja w haśle o teście Welcha.
Jak sprawdzić homogeniczność wariancji?
- Policz odchylenia standardowe grup i iloraz wariancji (największa wariancja podzielona przez najmniejszą). Ta liczba mówi o wielkości problemu, a nie tylko o istotności. Zestaw ją z liczebnościami: szczególnie niepokojący jest układ, w którym największa wariancja przypada na najmniejszą grupę. Pamiętaj, że iloraz odchyleń standardowych równy 2 to iloraz wariancji równy 4.
- Obejrzyj wykres – surowe wyniki w grupach (jak na rysunku 2), wykres pudełkowy albo wykres reszt modelu względem wartości dopasowanych. Różna „szerokość” chmur punktów jest widoczna od razu.
- Test Levene’a, najlepiej w wersji z medianą (Browna–Forsythe’a) – jako uzupełnienie opisu. W małych próbach przeoczy duże różnice, a w dużych wykryje błahe; symulacje pokazujemy w haśle test Levene’a.
Nie uzależniaj jednak wyboru testu od testu wstępnego. Procedura „najpierw test Levene’a, potem test Studenta albo Welcha” nie chroni poziomu istotności (Zimmerman, 2004). Bezpieczniej od razu wybrać metodę, która nie wymaga równych wariancji: Delacre i in. (2019) zalecają w jednoczynnikowej ANOVA domyślne stosowanie testu F Welcha zamiast klasycznego testu F.
Przykład: trzy formy nauki i nierówne grupy
Porównujemy wyniki testu wiedzy (0–60 punktów) po trzech formach nauki: wykładzie (n = 60), kursie e-learningowym (n = 30) i nauce samodzielnej (n = 15). Dane wygenerowaliśmy tak, by średnie w populacjach były równe (32 punkty), a różniły się tylko rozproszenia – każda „istotna różnica” jest więc fałszywym alarmem.
| Forma nauki | n | M | SD | Wariancja |
|---|---|---|---|---|
| Wykład | 60 | 31.90 | 5.83 | 33.96 |
| E-learning | 30 | 31.70 | 8.96 | 80.22 |
| Nauka samodzielna | 15 | 37.73 | 11.29 | 127.35 |
Iloraz największej i najmniejszej wariancji wynosi 3.75, a największa wariancja przypada na najmniejszą grupę – to układ, w którym klasyczny test F jest zbyt liberalny. Test Levene’a w wersji z medianą potwierdza różnicę rozproszeń: F(2, 102) = 5.97, p = .004.
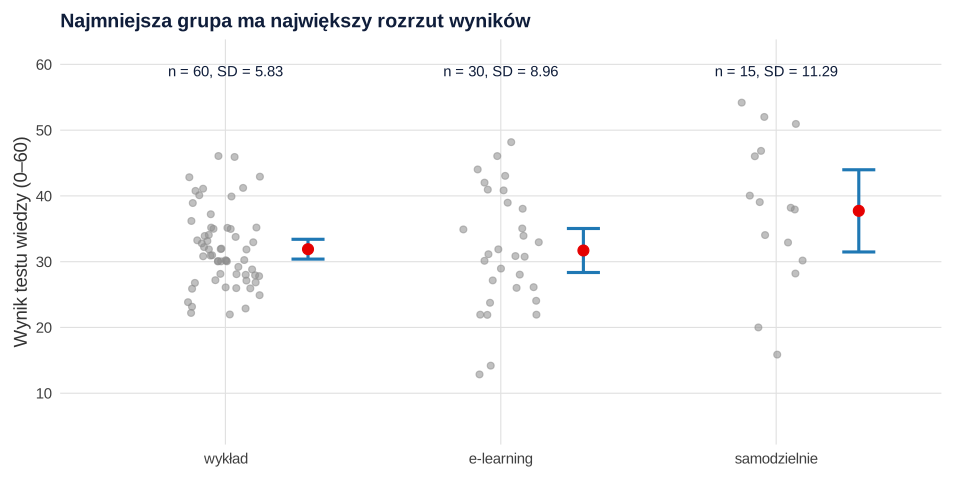
Trzy analizy tych samych danych prowadzą do różnych wniosków:
| Metoda | Wynik | Wniosek |
|---|---|---|
| Klasyczna ANOVA | F(2, 102) = 3.74, p = .027 | „istotna różnica” – fałszywy alarm |
| ANOVA Welcha | F(2, 29.97) = 1.89, p = .169 | brak podstaw do wniosku o różnicy |
| ANOVA z błędami HC3 | F(2, 102) = 1.80, p = .170 | brak podstaw do wniosku o różnicy |
Średnia w grupie uczącej się samodzielnie jest wprawdzie o około 6 punktów wyższa, ale ta grupa jest mała i bardzo zróżnicowana, więc jej średnia jest mało precyzyjna – widać to po szerokim przedziale ufności na rysunku 2. Test Welcha uwzględnia osobną wariancję każdej grupy, a mianownikowe stopnie swobody spadają ze 102 do 29.97. Porównania par testem Gamesa–Howella także nie wykazały istotnych różnic, np. nauka samodzielna a wykład: 5.83 punktu, 95% CI [−1.94, 13.60], p = .160. Jak często zdarza się taki fałszywy alarm? W 10 000 próbach o tym samym układzie liczebności i odchyleń standardowych klasyczna ANOVA dała istotny wynik w 18.2% przypadków, a ANOVA Welcha – w 5.0%.
Co zrobić, gdy wariancje nie są równe?
- Test Welcha – dla dwóch grup test t Welcha, dla trzech i więcej ANOVA Welcha z porównaniami Gamesa–Howella. To rozwiązanie domyślne (Delacre i in., 2019); pełny przykład znajdziesz w poradniku ANOVA krok po kroku.
- Odporne błędy standardowe (HC3) – w modelach z kilkoma czynnikami lub kowariantami test F z błędami HC3 nie wymaga równych wariancji. To samo narzędzie stosuje się w regresji z predyktorami ciągłymi – zob. hasło o heterogeniczności wariancji.
- Transformacja zmiennej – gdy rozrzut rośnie wraz ze średnią (np. czasy reakcji), logarytm często wyrównuje wariancje. Grissom (2000) ostrzega jednak, że transformacje mające zmniejszyć niejednorodność wariancji są problematyczne, a sama transformacja zmienia sens porównania.
- Opis zamiast ukrywania – różnica rozproszeń bywa ciekawym wynikiem sama w sobie. Podaj SD grup i iloraz wariancji, a jeśli hipoteza dotyczy zróżnicowania, przetestuj ją wprost.
Uważaj natomiast na odruchowe przejście na testy nieparametryczne. Grissom (2000) zwraca uwagę, że test Manna-Whitneya i test Kruskala-Wallisa są – podobnie jak testy t i F – wrażliwe na niejednorodność wariancji.
Jak opisać homogeniczność wariancji w pracy (APA)
Podaj odchylenia standardowe i liczebności grup, iloraz wariancji lub wynik testu Levene’a oraz nazwę testu, którym porównano średnie. Opis dla przykładu:
Przykład w R
Kod liczy statystyki opisowe i iloraz wariancji, test Levene’a, klasyczną ANOVA, ANOVA Welcha, test F z błędami HC3 i porównania Gamesa–Howella. Symulację z rysunku 1 przygotowano w osobnym skrypcie. W SPSS test Welcha i test jednorodności wariancji zaznaczysz w oknie Analiza → Porównywanie średnich → Jednoczynnikowa ANOVA → Opcje, a test Gamesa–Howella – w oknie Post hoc.
Trzy grupy, nierówne wariancje i liczebności
R
library(car)   # leveneTest(), Anova() z błędami HC3
# Dane symulowane: test wiedzy (0–60) po trzech formach nauki; średnie w populacjach są równe
set.seed(66)
forma <- factor(rep(c("wyklad", "e-learning", "samodzielnie"), c(60, 30, 15)),
                levels = c("wyklad", "e-learning", "samodzielnie"))
wynik <- round(c(rnorm(60, 32, 6), rnorm(30, 32, 9), rnorm(15, 32, 15)))
wynik <- pmin(pmax(wynik, 0), 60)

# 1. Opis: liczebności, średnie, SD i iloraz największej do najmniejszej wariancji
round(sapply(split(wynik, forma), function(x) c(n = length(x), M = mean(x), SD = sd(x), war = var(x))), 2)
round(max(tapply(wynik, forma, var)) / min(tapply(wynik, forma, var)), 2)
leveneTest(wynik ~ forma)                          # wersja z medianą (Brown–Forsythe)

# 2. Klasyczna ANOVA i dwie metody odporne na nierówne wariancje
model <- lm(wynik ~ forma)
anova(model)                                       # zakłada równe wariancje
oneway.test(wynik ~ forma)                         # ANOVA Welcha
Anova(model, white.adjust = "hc3")                 # test F z błędami odpornymi HC3
rstatix::games_howell_test(data.frame(wynik, forma), wynik ~ forma)   # pary: Games–Howell
Wynik w R
Loading required package: carData
    wyklad e-learning samodzielnie
n    60.00      30.00        15.00
M    31.90      31.70        37.73
SD    5.83       8.96        11.29
war  33.96      80.22       127.35
[1] 3.75
Levene's Test for Homogeneity of Variance (center = median)
       Df F value   Pr(>F)
group   2  5.9716 0.003528 **
      102
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Analysis of Variance Table

Response: wynik
           Df Sum Sq Mean Sq F value  Pr(>F)
forma       2  448.4 224.179  3.7408 0.02705 *
Residuals 102 6112.6  59.928
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	One-way analysis of means (not assuming equal variances)

data:  wynik and forma
F = 1.8865, num df = 2.000, denom df = 29.967, p-value = 0.1692

Coefficient covariances computed by hccm()
Analysis of Deviance Table (Type II tests)

Response: wynik
           Df      F Pr(>F)
forma       2 1.8043 0.1698
Residuals 102
# A tibble: 3 × 8
  .y.   group1     group2       estimate conf.low conf.high p.adj p.adj.signif
* <chr> <chr>      <chr>           <dbl>    <dbl>     <dbl> <dbl> <chr>
1 wynik wyklad     e-learning     -0.200    -4.57      4.17 0.993 ns
2 wynik wyklad     samodzielnie    5.83     -1.94     13.6  0.16  ns
3 wynik e-learning samodzielnie    6.03     -2.33     14.4  0.19  ns
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Wariancje są równe, bo test Levene’a jest nieistotny” – w małych grupach test przeoczy nawet kilkukrotne różnice; patrz na SD grup i iloraz wariancji.
- Pomijanie liczebności grup – ten sam iloraz wariancji jest niegroźny przy równych grupach, a groźny, gdy największa wariancja przypada na najmniejszą grupę.
- Klasyczna ANOVA mimo niekorzystnego układu – w przykładzie dała p = .027 zamiast .169 w teście Welcha, choć średnie w populacjach były równe.
- Mylenie ilorazu odchyleń standardowych z ilorazem wariancji – proponowany próg 1.5 (Blanca i in., 2018) dotyczy wariancji, a nie odchyleń standardowych.
- Test Kruskala-Wallisa jako „lekarstwo” na nierówne wariancje – testy rangowe także są wrażliwe na różne rozproszenia (Grissom, 2000).
- Brak opisu decyzji – w pracy napisz, jak oceniono założenie i dlaczego wybrano test Welcha albo błędy HC3.
Najczęstsze pytania
Co to jest homogeniczność wariancji?
To założenie, że rozproszenie wyników (wariancja) jest takie samo we wszystkich porównywanych populacjach. Wymaga go klasyczny test t Studenta i ANOVA, bo łączą wariancje grup w jedno wspólne oszacowanie. Gdy wariancje się różnią, mówimy o heterogeniczności wariancji.
Jak sprawdzić homogeniczność wariancji?
Policz odchylenia standardowe grup i iloraz największej do najmniejszej wariancji, obejrzyj wykres wyników w grupach i – jako uzupełnienie – wykonaj test Levene’a w wersji z medianą. Zwróć uwagę na liczebności: najgroźniejsza jest sytuacja, w której największa wariancja przypada na najmniejszą grupę.
Co zrobić, gdy nie ma homogeniczności wariancji?
Porównaj średnie testem, który jej nie wymaga: testem t Welcha (dwie grupy) albo ANOVA Welcha z porównaniami Gamesa–Howella (trzy grupy i więcej). W modelach z kilkoma czynnikami lub kowariantami użyj odpornych błędów standardowych HC3. Najlepiej stosuj te metody od początku, a nie dopiero po istotnym teście Levene’a.
Czy przy równych grupach nierówne wariancje są problemem?
Zwykle niewielkim. W symulacji na tej stronie, przy trzech grupach po 20 osób, klasyczny test F dawał 6.3% fałszywych alarmów nawet przy dziewięciokrotnej różnicy wariancji. Przy nierównych grupach ten sam iloraz prowadził do 17.3% fałszywych alarmów albo do utraty mocy – zależnie od tego, która grupa ma większą wariancję.
Jaki iloraz wariancji jest dopuszczalny?
Nie ma jednej granicy. Blanca i in. (2018) proponują, by przy nierównych liczebnościach traktować iloraz największej i najmniejszej wariancji powyżej 1.5 jako potencjalne zagrożenie dla testu F. Przy równych grupach test jest znacznie bardziej odporny, ale bezpieczniej i tak użyć testu Welcha.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Blanca, M. J., Alarcón, R., Arnau, J., Bono, R., & Bendayan, R. (2018). Effect of variance ratio on ANOVA robustness: Might 1.5 be the limit? Behavior Research Methods, 50(3), 937–962. https://doi.org/10.3758/s13428-017-0918-2 ● Otwarty dostęp
- Box, G. E. P. (1954). Some theorems on quadratic forms applied in the study of analysis of variance problems, I. Effect of inequality of variance in the one-way classification. The Annals of Mathematical Statistics, 25(2), 290–302. https://doi.org/10.1214/aoms/1177728786 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Glass, G. V., Peckham, P. D., & Sanders, J. R. (1972). Consequences of failure to meet assumptions underlying the fixed effects analyses of variance and covariance. Review of Educational Research, 42(3), 237–288. https://doi.org/10.3102/00346543042003237
- Grissom, R. J. (2000). Heterogeneity of variance in clinical data. Journal of Consulting and Clinical Psychology, 68(1), 155–165. https://doi.org/10.1037/0022-006x.68.1.155
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{blanca2018effect, author={Blanca, María J. and Alarcón, Rafael and Arnau, Jaume and Bono, Roser and Bendayan, Rebecca}, title={{Effect of variance ratio on ANOVA robustness: Might 1.5 be the limit?}}, journal={Behavior Research Methods}, year={2018}, volume={50}, number={3}, pages={937--962}, doi={10.3758/s13428-017-0918-2}}@article{box1954some, author={Box, G. E. P.}, title={{Some theorems on quadratic forms applied in the study of analysis of variance problems, I. Effect of inequality of variance in the one-way classification}}, journal={The Annals of Mathematical Statistics}, year={1954}, volume={25}, number={2}, pages={290--302}, doi={10.1214/aoms/1177728786}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{glass1972consequences, author={Glass, Gene V and Peckham, Percy D. and Sanders, James R.}, title={{Consequences of failure to meet assumptions underlying the fixed effects analyses of variance and covariance}}, journal={Review of Educational Research}, year={1972}, volume={42}, number={3}, pages={237--288}, doi={10.3102/00346543042003237}}@article{grissom2000heterogeneity, author={Grissom, Robert J.}, title={{Heterogeneity of variance in clinical data}}, journal={Journal of Consulting and Clinical Psychology}, year={2000}, volume={68}, number={1}, pages={155--165}, doi={10.1037/0022-006x.68.1.155}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}