Co to jest ekonometria?
Ekonometria (ang. econometrics) to dziedzina łącząca teorię ekonomii, statystykę i dane empiryczne. Służy do szacowania zależności gospodarczych, testowania hipotez ekonomicznych i prognozowania. Jej podstawowym narzędziem jest regresja, ale ekonometria wnosi do niej własny sposób myślenia. Najważniejsze pytanie brzmi zwykle: czy oszacowany współczynnik ma interpretację przyczynową, choć dane pochodzą z obserwacji, a nie z eksperymentu?
Dla studentki psychologii ekonometria jest ważna z dwóch powodów. Po pierwsze, w pracach z zarządzania, ekonomii i finansów (zob. poradnik statystyka w pracy z zarządzania i ekonomii) to ona wyznacza standard analizy. Po drugie, jej narzędzia do wnioskowania przyczynowego z danych nieeksperymentalnych coraz częściej trafiają do psychologii organizacji, zdrowia i edukacji.
Główne obszary i narzędzia ekonometrii
| Obszar | Typowe narzędzia | Odpowiednik w psychologii |
|---|---|---|
| Dane przekrojowe | MNK, odporne błędy standardowe, testy specyfikacji | Regresja wieloraka na danych z ankiety |
| Szeregi czasowe | Modele ARIMA, testy autokorelacji, kointegracja | Dzienniczki, ESM, monitorowanie objawów (szereg czasowy) |
| Dane panelowe | Efekty stałe i losowe, różnica w różnicach | Pomiary powtarzane, modele wielopoziomowe |
| Endogeniczność | Zmienne instrumentalne (2SLS), regresja nieciągła | Plany quasi-eksperymentalne |
| Zmienne jakościowe i ograniczone | Logit, probit, modele Tobit, modele zliczeń | Regresja logistyczna, regresja Poissona |
Wiele pojęć ma w obu dziedzinach różne nazwy. „Zmienna objaśniana” to zmienna zależna, „regresory” to predyktory, a „efekty stałe” w ekonometrii panelowej oznaczają osobną stałą dla każdej jednostki. To coś innego niż efekty stałe i losowe w metaanalizie czy modelach mieszanych w psychologii.
Ekonometria różni się też celem od eksploracji danych. W data mining liczy się trafność prognozy, a model może być „czarną skrzynką”. W ekonometrii współczynnik ma zwykle znaczenie merytoryczne – elastyczność, zwrot z edukacji, efekt polityki – więc ważniejsze jest to, czy jest nieobciążony, niż to, jak dobrze model dopasowuje się do danych. Wysokie R² nie chroni przed obciążeniem współczynnika.
Endogeniczność – centralny problem
Zmienna objaśniająca jest endogeniczna, gdy koreluje ze składnikiem losowym modelu. Wtedy metoda najmniejszych kwadratów daje oszacowania obciążone, a zwiększanie próby tego nie naprawia. Antonakis i in. (2010) wymieniają główne źródła endogeniczności:
- pominięte zmienne (zob. zmienna zakłócająca),
- pominiętą selekcję,
- równoczesność, czyli wpływ w obie strony,
- błąd wspólnej metody,
- błąd pomiaru.
W przeglądzie 110 artykułów o przywództwie z czołowych czasopism stwierdzili, że badacze nie uwzględniali od 66% do 90% warunków, od których zależy trafność wniosków przyczynowych. Omówili też metody, które pozwalają testować hipotezy przyczynowe bez randomizacji: panele z efektami stałymi, zmienne instrumentalne, regresję nieciągłą i różnicę w różnicach.
Zmienne instrumentalne (IV) to klasyczne narzędzie ekonometrii. Angrist i Krueger (2001) wyjaśniają ich intuicję. Metoda wykorzystuje tylko tę część zmienności zmiennej objaśniającej, która – jeśli instrument jest trafny – nie jest związana z pominiętymi zmiennymi. Bollen (2012) podkreśla dwa warunki dobrego instrumentu. Musi być nieskorelowany ze składnikiem losowym równania i dostatecznie silnie związany ze zmienną endogeniczną. Pierwszego warunku nie da się w pełni sprawdzić danymi – trzeba go uzasadnić merytorycznie. Drugi sprawdza się statystyką F pierwszego etapu.
Przykład: ile daje rok nauki? MNK a zmienne instrumentalne
Klasyczne pytanie ekonometrii pracy brzmi: o ile procent rosną zarobki z każdym dodatkowym rokiem nauki? W danych symulowanych dla 1000 pracowników prawdziwy efekt wynosi 0.040 w logarytmie zarobków (około 4% na rok). Działa jednak zmienna pominięta – nieobserwowane zdolności. Osoby zdolniejsze uczą się dłużej i więcej zarabiają niezależnie od nauki. Instrumentem jest odległość od najbliższej uczelni: wpływa na to, jak długo ktoś się uczy, ale (z założenia) nie wpływa wprost na zarobki.
- MNK pomija zdolności i przypisuje ich wpływ nauce: b = 0.062, 95% CI [0.054, 0.069], czyli około 6.4% na rok. Przedział nie obejmuje prawdziwej wartości.
- Pierwszy etap 2SLS: każdy kilometr odległości zmniejsza liczbę lat nauki o 0.029 roku (SE = 0.002). Instrument jest silny: F(1, 998) = 338.0, znacznie powyżej zwyczajowego progu 10.
- Drugi etap: zarobki regresuje się na liczbę lat nauki przewidzianą z pierwszego etapu. Oszacowanie IV wynosi b = 0.040, SE = 0.008, 95% CI [0.025, 0.055], czyli około 4.1% na rok. Trafia w prawdziwą wartość, ale przedział jest dwa razy szerszy niż w MNK – taka jest cena wykorzystania tylko części zmienności.
- Test endogeniczności (Durbina–Wu–Hausmana, z resztami pierwszego etapu dodanymi do równania zarobków) potwierdza, że MNK i IV istotnie się różnią: b = 0.029, p < .001.
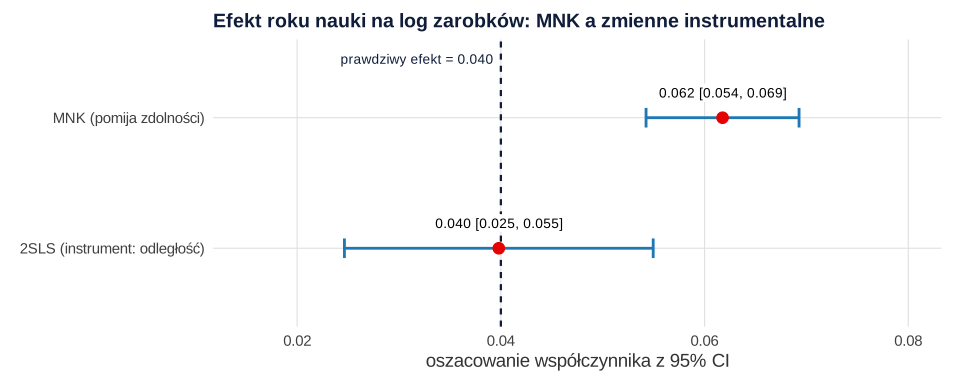
W prawdziwych danych nie znasz prawdziwego efektu i nie możesz sprawdzić, czy instrument wpływa na wynik tylko przez zmienną endogeniczną. Odległość od uczelni może się wiązać z miejscem zamieszkania, a ono – z zarobkami. Dlatego wiarygodność analizy IV zależy przede wszystkim od argumentu za instrumentem, a nie od samego obliczenia.
Diagnostyka modelu w ujęciu ekonometrycznym
Ekonometria przywiązuje dużą wagę do testów specyfikacji, czyli sprawdzania, czy model ma właściwą postać. Ramsey (1969) pokazał, że przy wielu błędach specyfikacji reszty MNK mają niezerową średnią. Na tej podstawie zaproponował procedury wykrywania pominiętych zmiennych, złej postaci funkcyjnej i heteroskedastyczności (dziś znane jako test RESET). Do standardowej diagnostyki należą też:
- test homoskedastyczności i błędy standardowe odporne na jej brak,
- w szeregach czasowych – test Durbina-Watsona i modele z autokorelacją (GLS),
- ocena współliniowości,
- logarytmowanie zmiennych pieniężnych (transformacja logarytmiczna), dzięki któremu współczynnik czyta się jako zmianę procentową.
Jak opisać analizę IV w pracy
Jeśli potrzebujesz pomocy w doborze modelu do pracy z ekonomii lub zarządzania, zobacz analizy statystyczne dla studentów.
MNK i zmienne instrumentalne w R
Kod tworzy dane, szacuje MNK, oba etapy 2SLS z poprawnym błędem standardowym i test endogeniczności. Używa tylko funkcji bazowych; ten sam model daje funkcja ivreg() z pakietu AER lub ivreg, jeśli masz go zainstalowanego.
Dwustopniowe najmniejsze kwadraty krok po kroku
R
# Dane symulowane: 1000 pracowników. Pytanie: o ile rosną zarobki z każdym rokiem nauki?
# Problem endogeniczności: nieobserwowane zdolności podnoszą i liczbę lat nauki, i zarobki.
# Instrument: odległość od najbliższej uczelni (km) – wpływa na liczbę lat nauki, ale nie wprost na zarobki.
set.seed(201)
n <- 1000
zdolnosci  <- rnorm(n)                                   # zmienna pominięta (nieobserwowana)
odleglosc  <- round(rexp(n, 1 / 40))                      # instrument
lata_nauki <- round(pmin(pmax(14 + 1.2 * zdolnosci - 0.03 * odleglosc + rnorm(n, sd = 1.6), 8), 22))
# prawdziwy efekt: 4% wyższe zarobki za każdy rok nauki (zarobki w logarytmie)
log_zarobki <- 7.6 + 0.04 * lata_nauki + 0.10 * zdolnosci + rnorm(n, sd = 0.25)
dane <- data.frame(log_zarobki, lata_nauki, odleglosc)
round(cor(dane), 2)

# 1. MNK – pomija zdolności, więc przypisuje ich wpływ nauce
m_mnk <- lm(log_zarobki ~ lata_nauki, data = dane)
round(coef(summary(m_mnk))["lata_nauki", ], 4)

# 2. Pierwszy etap 2SLS: czy instrument jest silny?
etap1 <- lm(lata_nauki ~ odleglosc, data = dane)
round(coef(summary(etap1))["odleglosc", ], 4)
round(summary(etap1)$fstatistic, 1)                     # F pierwszego etapu (reguła: > 10)

# 3. Drugi etap: zarobki na przewidywaną liczbę lat nauki; poprawne SE liczone z reszt na prawdziwym X
dane$lata_hat <- fitted(etap1)
etap2 <- lm(log_zarobki ~ lata_hat, data = dane)
b_iv <- coef(etap2)
reszty <- dane$log_zarobki - (b_iv[1] + b_iv[2] * dane$lata_nauki)
sigma2 <- sum(reszty^2) / (n - 2)
X_hat <- cbind(1, dane$lata_hat)
se_iv <- sqrt(diag(sigma2 * solve(t(X_hat) %*% X_hat)))
wynik_iv <- c(b = unname(b_iv[2]), SE = se_iv[2], dolna = unname(b_iv[2]) - 1.96 * se_iv[2],
              gorna = unname(b_iv[2]) + 1.96 * se_iv[2])
round(wynik_iv, 4)
round(c(MNK = unname(coef(m_mnk)[2]), MNK_dolna = confint(m_mnk)[2, 1], MNK_gorna = confint(m_mnk)[2, 2]), 4)
round(100 * (exp(c(MNK = unname(coef(m_mnk)[2]), IV = unname(b_iv[2]))) - 1), 1)   # w procentach

# 4. Test endogeniczności (Durbin–Wu–Hausman, wersja z resztami pierwszego etapu)
dane$v_hat <- resid(etap1)
round(coef(summary(lm(log_zarobki ~ lata_nauki + v_hat, data = dane)))["v_hat", ], 4)
Wynik w R
            log_zarobki lata_nauki odleglosc
log_zarobki        1.00       0.45     -0.15
lata_nauki         0.45       1.00     -0.50
odleglosc         -0.15      -0.50      1.00
  Estimate Std. Error    t value   Pr(>|t|)
    0.0618     0.0038    16.1388     0.0000
  Estimate Std. Error    t value   Pr(>|t|)
   -0.0289     0.0016   -18.3842     0.0000
value numdf dendf
  338     1   998
     b     SE  dolna  gorna
0.0398 0.0077 0.0246 0.0550
      MNK MNK_dolna MNK_gorna
   0.0618    0.0543    0.0693
MNK  IV
6.4 4.1
  Estimate Std. Error    t value   Pr(>|t|)
    0.0294     0.0088     3.3573     0.0008
Bibliografia oprogramowania
Wyniki pochodzą z R 4.5.3 (funkcje bazowe); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Interpretacja przyczynowa współczynnika MNK z danych obserwacyjnych. W przykładzie MNK zawyżyło efekt nauki o ponad połowę, bo pominęło zdolności.
- Słaby instrument. Gdy F pierwszego etapu jest małe, oszacowanie IV bywa bardziej obciążone niż MNK i ma ogromny błąd standardowy.
- Instrument bez uzasadnienia. Warunku, że instrument działa na wynik tylko przez zmienną endogeniczną, nie potwierdzi żaden test na jednym instrumencie; trzeba go uargumentować.
- Ręczny drugi etap z błędami standardowymi z
lm(). Są błędne, bo liczone z reszt na przewidywanych, a nie prawdziwych wartościach; użyj gotowej funkcji albo poprawki jak w kodzie. - Korelowanie szeregów z trendem – np. PKB i liczby studentów w kolejnych latach – i wnioskowanie o związku (korelacja pozorna).
- Mylenie terminologii. „Efekty stałe” w panelu i w metaanalizie to różne rzeczy; w pracy zdefiniuj, w jakim znaczeniu używasz terminu.
Najczęstsze pytania
Czym ekonometria różni się od statystyki stosowanej w psychologii?
Narzędzia są w dużej mierze wspólne (regresja, modele dla szeregów i paneli), ale ekonometria kładzie większy nacisk na endogeniczność i identyfikację efektów przyczynowych w danych obserwacyjnych, a psychologia – na eksperyment i pomiar zmiennych latentnych. Różni się też terminologia, np. „regresor” zamiast „predyktor”.
Co to jest endogeniczność w modelu regresji?
To sytuacja, w której zmienna objaśniająca jest skorelowana ze składnikiem losowym modelu – z powodu pominiętych zmiennych, wpływu zwrotnego, selekcji albo błędu pomiaru. Oszacowania MNK są wtedy obciążone i nie poprawiają się wraz ze wzrostem próby (Antonakis i in., 2010).
Na czym polega metoda zmiennych instrumentalnych?
Używa się zmiennej (instrumentu), która wpływa na predyktor, ale na wynik działa wyłącznie przez ten predyktor. W pierwszym etapie przewiduje się predyktor z instrumentu, a w drugim – wynik z przewidywanego predyktora (2SLS). Instrument musi być silny (F pierwszego etapu wyraźnie powyżej 10) i merytorycznie uzasadniony.
Jaki program do ekonometrii wybrać do pracy dyplomowej?
Wystarczy R (pakiety do regresji, szeregów czasowych, danych panelowych i zmiennych instrumentalnych), Stata albo Gretl; prostsze modele policzysz też w SPSS. Ważniejszy od programu jest opis modelu: zmienne, postać funkcyjna, sposób liczenia błędów standardowych i diagnostyka.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja w Gretlu krok po kroku
Import CSV, model KMNK, odczyt okna modelu i gwiazdek, testy White’a, Breuscha–Pagana i RESET, VIF, błędy HC3 oraz tabela APA – z danymi do pobrania.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Angrist, J. D., & Krueger, A. B. (2001). Instrumental variables and the search for identification: From supply and demand to natural experiments. Journal of Economic Perspectives, 15(4), 69–85. https://doi.org/10.1257/jep.15.4.69 ● Otwarty dostęp
- Antonakis, J., Bendahan, S., Jacquart, P., & Lalive, R. (2010). On making causal claims: A review and recommendations. The Leadership Quarterly, 21(6), 1086–1120. https://doi.org/10.1016/j.leaqua.2010.10.010 ● Otwarty dostęp: pełny tekst
- Bollen, K. A. (2012). Instrumental variables in sociology and the social sciences. Annual Review of Sociology, 38(1), 37–72. https://doi.org/10.1146/annurev-soc-081309-150141
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
Cytowania BibTeX
@article{angrist2001instrumental, author={Angrist, Joshua D and Krueger, Alan B}, title={{Instrumental variables and the search for identification: From supply and demand to natural experiments}}, journal={Journal of Economic Perspectives}, year={2001}, volume={15}, number={4}, pages={69--85}, doi={10.1257/jep.15.4.69}}@article{antonakis2010making, author={Antonakis, John and Bendahan, Samuel and Jacquart, Philippe and Lalive, Rafael}, title={{On making causal claims: A review and recommendations}}, journal={The Leadership Quarterly}, year={2010}, volume={21}, number={6}, pages={1086--1120}, doi={10.1016/j.leaqua.2010.10.010}}@article{bollen2012instrumental, author={Bollen, Kenneth A.}, title={{Instrumental variables in sociology and the social sciences}}, journal={Annual Review of Sociology}, year={2012}, volume={38}, number={1}, pages={37--72}, doi={10.1146/annurev-soc-081309-150141}}@article{ramsey1969tests, author={Ramsey, J. B.}, title={{Tests for specification errors in classical linear least-squares regression analysis}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1969}, volume={31}, number={2}, pages={350--371}, doi={10.1111/j.2517-6161.1969.tb00796.x}}