Co to jest homoskedastyczność?
Homoskedastyczność to jedno z założeń regresji liniowej metodą najmniejszych kwadratów. Zakłada, że składnik losowy (w praktyce: reszty) ma taką samą wariancję niezależnie od wartości predyktorów:
Jeśli wariancja zależy od wartości predyktora, Var(εi | xi) = σi², występuje heteroskedastyczność. W psychologii to częsta sytuacja. Rozrzut czasów reakcji rośnie z wiekiem, rozrzut wydatków — z dochodem, a zmienność objawów bywa większa w grupach o wyższym nasileniu zaburzeń. W teście t i ANOVA ta sama idea występuje jako homogeniczność wariancji w porównywanych grupach.
Przykład w regresji: wiek a czas reakcji
Wygenerowałem w R dwa zbiory danych po 200 osób o tym samym modelu średniej: czas reakcji = 250 + 4 · wiek (w milisekundach). W pierwszym zbiorze rozrzut wyników jest stały. W drugim rośnie z wiekiem — młodsze osoby reagują podobnie, a u starszych różnice indywidualne są znacznie większe. Wiek ma rozkład prawoskośny: więcej jest osób młodszych niż starszych.
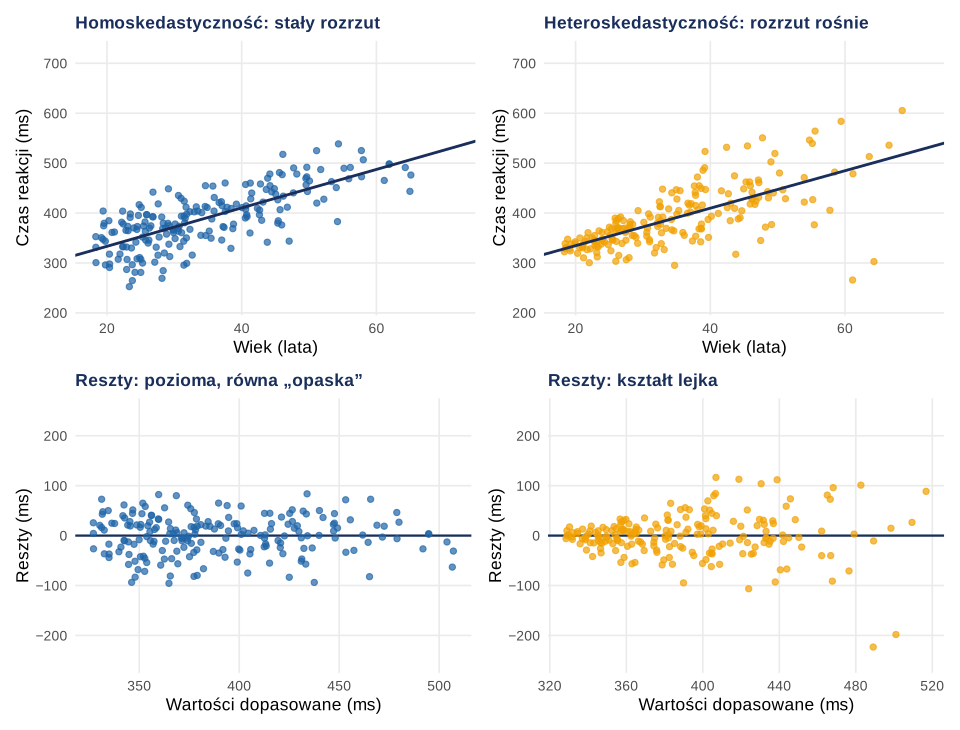
Na wykresie reszt homoskedastyczność wygląda jak pozioma opaska punktów o stałej szerokości wokół zera. Heteroskedastyczność najczęściej przybiera kształt lejka, rzadziej „klepsydry” lub łuku. Łuk sugeruje też, że model pomija nieliniowość, a nie tylko problem z wariancją.
Co się dzieje, gdy założenie nie jest spełnione?
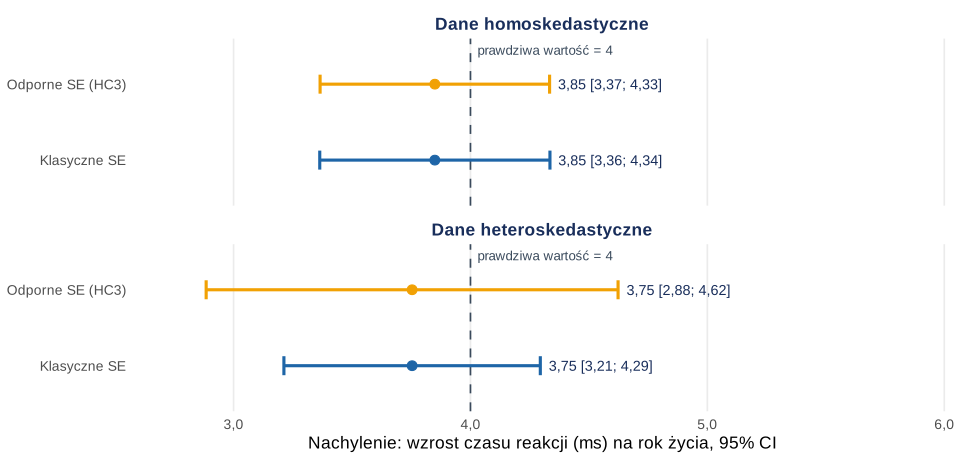
Przy heteroskedastyczności oszacowania współczynników metodą najmniejszych kwadratów pozostają nieobciążone, ale klasyczne błędy standardowe są niepoprawne. W naszym przykładzie nachylenie wynosi b = 3,75. Klasyczny błąd standardowy (0,274) jest jednak wyraźnie mniejszy niż odporny błąd HC3 (0,441), więc klasyczny przedział ufności jest zbyt wąski.
| Wynik | Dane homoskedastyczne | Dane heteroskedastyczne |
|---|---|---|
| Nachylenie b (ms na rok) | 3,85 | 3,75 |
| Klasyczny błąd standardowy | 0,246 | 0,274 |
| Odporny błąd standardowy HC3 | 0,246 | 0,441 |
| 95% CI — klasyczny | [3,36; 4,34] | [3,21; 4,29] |
| 95% CI — HC3 | [3,37; 4,33] | [2,88; 4,62] |
| Test Breuscha-Pagana | BP(1) = 0,37, p = 0,540 | BP(1) = 34,40, p < 0,001 |
| Pokrycie 95% CI w symulacji — klasyczne | 95,8% | 83,2% |
| Pokrycie 95% CI w symulacji — HC3 | 95,7% | 95,0% |
Najważniejsze są ostatnie dwa wiersze tabeli. Powtórzyłem badanie 2000 razy i sprawdziłem, jak często 95% przedział ufności obejmował prawdziwe nachylenie równe 4. Przy danych heteroskedastycznych klasyczny przedział trafił tylko w 83,2% prób zamiast deklarowanych 95%, a przedział z błędami HC3 — w 95,0%. Przy danych homoskedastycznych obie metody działają poprawnie (95,8% i 95,7%). Klasyczne błędy standardowe dają więc fałszywe poczucie precyzji i zawyżają ryzyko błędu pierwszego rodzaju.
Jak sprawdzić homoskedastyczność?
- Wykres reszt względem wartości dopasowanych to podstawowe narzędzie. Szukaj zmiany szerokości „chmury” punktów: lejka, klepsydry, łuku.
- Wykres reszt względem każdego predyktora pokazuje, która zmienna wiąże się ze zmianą wariancji.
- Test Breuscha-Pagana (Breusch i Pagan, 1979) sprawdza, czy kwadraty reszt zależą od predyktorów. W R funkcja
bptest()z pakietu lmtest domyślnie stosuje odporną na nienormalność wersję Koenkera (1981). W przykładzie: dane homoskedastyczne — BP = 0,37, p = 0,540; dane heteroskedastyczne — BP = 34,40, p < 0,001. - Test White’a (White, 1980) uwzględnia również kwadraty predyktorów i ich interakcje, więc wykrywa bardziej złożone wzorce.
- Przy porównaniu grup zamiast wykresu reszt stosuje się często test Levene’a.
Podobnie jak test Shapiro-Wilka, testy heteroskedastyczności zależą od liczebności. Przy dużej próbie wykrywają nawet niewielkie, praktycznie nieistotne zmiany wariancji, a przy małej mogą przeoczyć poważny problem. Decyzję warto więc opierać na wykresie i porównaniu klasycznych błędów standardowych z odpornymi.
Co zrobić przy heteroskedastyczności?
- Odporne błędy standardowe (HC3). Najprostsze i zwykle wystarczające rozwiązanie. Long i Ervin (2000) zalecają wariant HC3, zwłaszcza przy próbach poniżej 250 obserwacji. Hayes i Cai (2007) pokazują, jak go stosować w typowych programach statystycznych, a w R oblicza go pakiet sandwich (Zeileis, 2004).
- Ważona metoda najmniejszych kwadratów (WLS), gdy wiadomo, jak wariancja zależy od predyktora.
- Transformacja zmiennej zależnej, np. logarytm czasu reakcji. Zmienia ona jednak interpretację współczynników.
- Model dopasowany do rodzaju danych, np. uogólniony model liniowy z rozkładem gamma dla czasów reakcji lub model z jawnie modelowaną wariancją.
- Sprawdzenie specyfikacji modelu. Pozorna heteroskedastyczność bywa skutkiem pominiętej nieliniowości, interakcji lub ważnej zmiennej.
Field i Wilcox (2017) zalecają, by zamiast zakładać spełnienie założeń, porównywać analizę klasyczną z odporną i raportować wersję odporną, gdy wyniki się różnią.
Przykład w R
Kod odtwarza przykład z danymi heteroskedastycznymi oraz symulację pokrycia przedziałów ufności. Wyniki poniżej to dokładny wydruk z R.
1. Wykres reszt, test Breuscha-Pagana i błędy HC3
R
library(lmtest)     # test Breuscha-Pagana, coeftest()
library(sandwich)   # odporne błędy standardowe HC3

# Dane symulowane: wiek a czas reakcji; rozrzut wyników rośnie z wiekiem
generuj <- function(n, hetero) {
  wiek <- 18 + 62 * rbeta(n, 1.3, 3.5)                    # więcej osób młodszych
  sd_e <- if (hetero) 8 + 1.8 * (wiek - 18) else 40
  data.frame(wiek = wiek, czas = 250 + 4 * wiek + rnorm(n, 0, sd_e))
}
set.seed(2027)
hetero <- generuj(200, TRUE)
m_het  <- lm(czas ~ wiek, data = hetero)

plot(fitted(m_het), resid(m_het), xlab = "Wartości dopasowane", ylab = "Reszty")
abline(h = 0)

bptest(m_het)                                         # test Breuscha-Pagana (wersja Koenkera)
coeftest(m_het)                                       # klasyczne błędy standardowe
coeftest(m_het, vcov. = vcovHC(m_het, type = "HC3"))  # odporne błędy standardowe HC3
Wynik w R
	studentized Breusch-Pagan test
data:  m_het
BP = 34.398, df = 1, p-value = 4.492e-09
t test of coefficients:
             Estimate Std. Error t value  Pr(>|t|)
(Intercept) 259.65940   10.05142  25.833 < 2.2e-16 ***
wiek          3.75366    0.27443  13.678 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
t test of coefficients:
             Estimate Std. Error t value  Pr(>|t|)
(Intercept) 259.65940   13.31224 19.5053 < 2.2e-16 ***
wiek          3.75366    0.44087  8.5143 4.165e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
2. Symulacja: pokrycie 95% przedziałów ufności
R
# Jak często 95% CI obejmuje prawdziwe nachylenie (b = 4)? 2000 symulacji
set.seed(99)
pokrycie <- function(hetero, R = 2000) rowMeans(replicate(R, {
  d  <- generuj(200, hetero); m <- lm(czas ~ wiek, data = d)
  ck <- confint(m)["wiek", ]
  ch <- coefci(m, vcov. = vcovHC(m, type = "HC3"))["wiek", ]
  c(klasyczne = unname(ck[1] <= 4 & 4 <= ck[2]), hc3 = unname(ch[1] <= 4 & 4 <= ch[2]))
}))
rbind(homo = pokrycie(FALSE), hetero = pokrycie(TRUE))
Wynik w R
       klasyczne    hc3
homo      0.9580 0.9570
hetero    0.8325 0.9495
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lmtest (wersja 0.9-40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1-1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Jak opisać homoskedastyczność w pracy (APA 7)?
Najczęstsze błędy
- Utożsamianie heteroskedastyczności z obciążeniem współczynników. Współczynniki są nieobciążone; problemem jest niepewność ich oszacowania.
- Sprawdzanie wariancji surowej zmiennej zależnej zamiast reszt modelu.
- Poleganie wyłącznie na teście bez wykresu reszt i bez porównania z błędami odpornymi.
- Usuwanie obserwacji o dużych resztach, aby „naprawić” wykres — bez uzasadnienia merytorycznego to manipulacja danymi.
- Transformacja zmiennej bez zmiany interpretacji — po logarytmowaniu współczynniki opisują zmiany względne, a nie bezwzględne.
Najczęstsze pytania
Co to jest homoskedastyczność?
To założenie regresji liniowej, zgodnie z którym wariancja reszt jest taka sama przy wszystkich wartościach predyktorów. Na wykresie reszt względem wartości dopasowanych widać wtedy poziomą „opaskę” punktów o stałej szerokości.
Homoskedastyczność czy homoscedastyczność — jak się pisze?
Obie formy są używane w polskiej literaturze i oznaczają to samo. Częściej spotyka się zapis „homoskedastyczność” (od greckiego skedasis — rozproszenie), a „homoscedastyczność” to spolszczenie angielskiego homoscedasticity.
Czy heteroskedastyczność obciąża współczynniki regresji?
Nie — przy poprawnie określonym modelu współczynniki metody najmniejszych kwadratów pozostają nieobciążone. Problemem są błędy standardowe, a więc przedziały ufności i wartości p, oraz mniejsza efektywność oszacowań.
Co oznacza istotny test Breuscha-Pagana?
Że wariancja reszt zmienia się wraz z predyktorami, czyli występuje heteroskedastyczność. O tym, czy to problem, decyduje jej wielkość i wzorzec — dlatego zawsze obejrzyj wykres reszt i porównaj klasyczne błędy standardowe z odpornymi (HC3).
Czym różni się homoskedastyczność od homogeniczności wariancji?
To ta sama idea w dwóch kontekstach. W regresji mówimy o stałej wariancji reszt w całym zakresie predyktorów, a w teście t i ANOVA — o równych wariancjach w porównywanych grupach, sprawdzanych np. testem Levene’a.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikStatystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Field, A. P., & Wilcox, R. R. (2017). Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers. Behaviour Research and Therapy, 98, 19–38. https://doi.org/10.1016/j.brat.2017.05.013
- Hayes, A. F., & Cai, L. (2007). Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation. Behavior Research Methods, 39(4), 709–722. https://doi.org/10.3758/BF03192961
- Koenker, R. (1981). A note on studentizing a test for heteroscedasticity. Journal of Econometrics, 17(1), 107–112. https://doi.org/10.1016/0304-4076(81)90062-2
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Zeileis, A. (2004). Econometric computing with HC and HAC covariance matrix estimators. Journal of Statistical Software, 11(10), 1–17. https://doi.org/10.18637/jss.v011.i10
Cytowania BibTeX
@article{breusch1979simple, author={Breusch, Trevor S. and Pagan, Adrian R.}, title={A simple test for heteroscedasticity and random coefficient variation}, journal={Econometrica}, year={1979}, volume={47}, number={5}, pages={1287--1294}, doi={10.2307/1911963}}@article{field2017robust, author={Field, Andy P. and Wilcox, Rand R.}, title={Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers}, journal={Behaviour Research and Therapy}, year={2017}, volume={98}, pages={19--38}, doi={10.1016/j.brat.2017.05.013}}@article{hayes2007using, author={Hayes, Andrew F. and Cai, Li}, title={Using heteroskedasticity-consistent standard error estimators in {OLS} regression: An introduction and software implementation}, journal={Behavior Research Methods}, year={2007}, volume={39}, number={4}, pages={709--722}, doi={10.3758/BF03192961}}@article{koenker1981note, author={Koenker, Roger}, title={A note on studentizing a test for heteroscedasticity}, journal={Journal of Econometrics}, year={1981}, volume={17}, number={1}, pages={107--112}, doi={10.1016/0304-4076(81)90062-2}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={Using heteroscedasticity consistent standard errors in the linear regression model}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{white1980heteroskedasticity, author={White, Halbert}, title={A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity}, journal={Econometrica}, year={1980}, volume={48}, number={4}, pages={817--838}, doi={10.2307/1912934}}@article{zeileis2004econometric, author={Zeileis, Achim}, title={Econometric computing with {HC} and {HAC} covariance matrix estimators}, journal={Journal of Statistical Software}, year={2004}, volume={11}, number={10}, pages={1--17}, doi={10.18637/jss.v011.i10}}