Co to są reszty regresji?
Reszta (ang. residual) to różnica między wynikiem obserwowanym a wynikiem przewidywanym przez model regresji: ei = yi − ŷi. Dodatnia reszta oznacza, że osoba uzyskała wynik wyższy, niż przewiduje model, a ujemna – niższy. Reszty są obserwowalnymi odpowiednikami błędów losowych ε z modelu regresji liniowej: błędów w populacji nie znamy, a reszty liczymy z próby.
W metodzie najmniejszych kwadratów reszty mają dwie własności wynikające z samej konstrukcji modelu: w modelu ze stałą sumują się do zera i nie korelują ani z predyktorami, ani z wartościami dopasowanymi. Dlatego na wykresie reszt nie szukamy trendu liniowego, tylko tego, czego prosta nie potrafi uchwycić: zakrzywienia, zmieniającego się rozrzutu, pojedynczych punktów daleko od zera i zależności od kolejności pomiarów.
Założenia regresji dotyczą błędów, czyli w praktyce reszt, a nie surowych zmiennych. Williams i in. (2013) podkreślają, że regresja wieloraka wymaga – zwłaszcza w małych próbach – normalności błędów, a nie normalności zmiennej zależnej czy predyktorów. Analiza reszt jest więc podstawą diagnostyki każdego modelu: od regresji prostej, przez regresję wieloraką, po modele z predyktorami jakościowymi zakodowanymi zero-jedynkowo (dummy coding).
Reszty surowe, standaryzowane i studentyzowane
Reszta surowa jest wyrażona w jednostkach zmiennej zależnej, np. w milisekundach albo punktach skali, więc trudno ocenić, czy jest „duża”. Dlatego reszty się skaluje – dzieli przez oszacowanie ich odchylenia standardowego:
- s – błąd standardowy reszt (ang. residual standard error), czyli typowa wielkość reszty w modelu;
- hii – dźwignia (ang. leverage) obserwacji i: im bardziej nietypowe wartości predyktorów, tym wyższa dźwignia i tym mniejsza wariancja reszty, bo linia regresji „przyciąga się” do takiego punktu;
- s(i) – błąd standardowy reszt z modelu oszacowanego bez obserwacji i; dzięki temu nietypowy punkt nie zawyża mianownika własnej reszty.
| Rodzaj reszty | Wzór | R | SPSS (okno Zapisz) | Do czego |
|---|---|---|---|---|
| Surowa (niestandaryzowana) | e = y − ŷ | resid() | RES_1 | Interpretacja w jednostkach Y |
| Standaryzowana | e / s | resid() / sigma() | ZRE_1 | Szybki przegląd; pomija dźwignię |
| Studentyzowana wewnętrznie | e / (s√(1 − h)) | rstandard() | SRE_1 | Wykresy diagnostyczne, odległość Cooka |
| Studentyzowana zewnętrznie (usunięta) | e / (s(i)√(1 − h)) | rstudent() | SDR_1 | Wykrywanie obserwacji odstających w Y |
Uwaga na nazwy: funkcja rstandard() w R nazywa „standaryzowanymi” reszty, które SPSS nazywa studentyzowanymi. Reszta studentyzowana zewnętrznie ma rozkład t z n − p − 1 stopniami swobody (p – liczba parametrów modelu ze stałą). Przy normalnych błędach około 5% reszt studentyzowanych przekracza ±2, a około 0.3% – ±3. W próbie stu kilkudziesięciu osób kilka reszt poza ±2 to norma, a nie sygnał problemu. Największą resztę można sprawdzić testem z poprawką Bonferroniego, bo przeglądając wszystkie reszty, wykonujemy tyle porównań, ile jest obserwacji.
Co pokazują wykresy reszt?
Podstawowy wykres diagnostyczny przedstawia reszty – najlepiej studentyzowane – względem wartości dopasowanych ŷ. Rysunek 1 pokazuje trzy wzorce, które warto rozpoznawać od pierwszego spojrzenia.
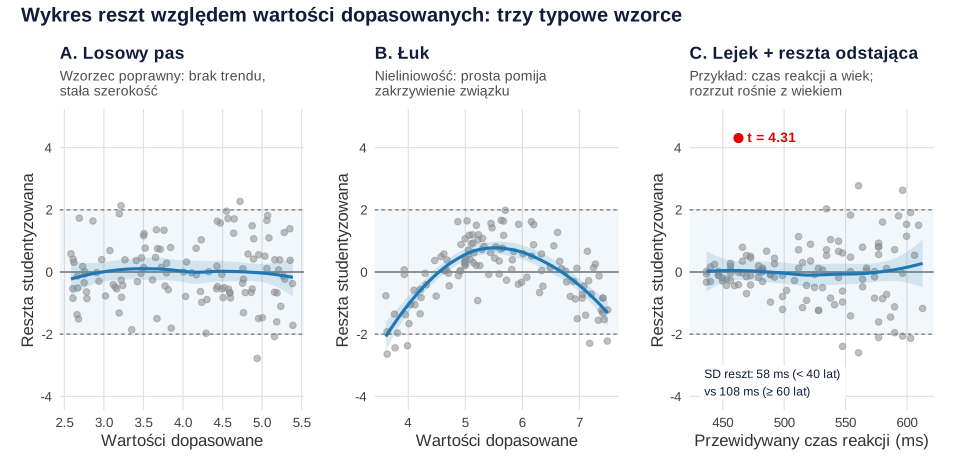
- Losowy pas (A) – chmura bez trendu i o stałej szerokości, wygładzona linia blisko zera. Pojedyncze punkty poza ±2 są oczekiwane: w panelu A są cztery na 120.
- Łuk (B) – reszty dodatnie w środku zakresu i ujemne na krańcach (albo odwrotnie). Związek jest krzywoliniowy, a prosta go nie oddaje. W tym modelu dodanie kwadratu predyktora podnosi R² z .70 do .88 – zob. regresja krzywoliniowa.
- Lejek (C) – rozrzut reszt rośnie (lub maleje) wraz z ŷ, czyli naruszona jest homoskedastyczność. Współczynniki pozostają nieobciążone, ale klasyczne testy istotności przestają być właściwe (Long i Ervin, 2000). Heteroskedastyczność nie jest w naukach behawioralnych rzadkością, a jej pominięcie może zawyżać odsetek błędów I rodzaju albo obniżać moc (Rosopa i in., 2013).
- Pojedynczy punkt daleko od pozostałych (czerwony w panelu C) – obserwacja odstająca w zmiennej zależnej. To, czy taki punkt zmienia wyniki, ocenia dopiero miara wpływu łącząca resztę z dźwignią, np. odległość Cooka.
Oprócz tego obejrzyj wykres Q-Q reszt (normalność), reszty względem każdego predyktora, a gdy dane mają kolejność w czasie – reszty względem numeru pomiaru (autokorelację ocenia test Durbina-Watsona). Cztery standardowe panele diagnostyczne dla modelu z dwoma predyktorami pokazujemy w haśle o regresji liniowej. Wykresy reszt nie ujawnią natomiast współliniowości predyktorów – tę ocenia się osobno, np. współczynnikiem VIF. Normalność reszt jest zwykle najmniej krytyczna: w symulacjach Kniefa i Forstmeiera (2021) modele zakładające normalne błędy dawały dość wiarygodne wartości p także dla danych nienormalnych – wyjątkiem były dane z wpływowymi obserwacjami odstającymi oceniane przy surowym poziomie alfa. Autorzy podkreślają, że wzrokowa ocena wykresów pod kątem obserwacji odstających i heteroskedastyczności jest ważna.
Przykład: czas reakcji a wiek
Sto dwadzieścia osób w wieku 20–75 lat (dane symulowane) wykonało komputerowe zadanie z wyborem reakcji. Postępujemy w trzech krokach, które proponują Rosopa i in. (2013): dopasuj model wynikający z teorii i zapisz reszty, przeanalizuj reszty, a dopiero potem wnioskuj o współczynnikach. Model ma postać: czas reakcji = 368.27 + 3.26 × wiek. Każdy rok życia wiąże się z odpowiedzią dłuższą średnio o 3.26 ms, b = 3.26, SE = 0.50, t(118) = 6.53, p < .001, R² = .27; błąd standardowy reszt wynosi s = 85.96 ms.
Krok 1: największe reszty
| Osoba | Wiek | RT (ms) | ŷ (ms) | e | Standaryzowana | Studentyzowana wewn. | Studentyzowana zewn. | h |
|---|---|---|---|---|---|---|---|---|
| 120 | 29 | 805 | 462.81 | 342.19 | 3.98 | 4.02 | 4.31 | .019 |
| 47 | 59 | 791 | 560.61 | 230.39 | 2.68 | 2.70 | 2.77 | .014 |
| 50 | 70 | 814 | 596.47 | 217.53 | 2.53 | 2.57 | 2.63 | .027 |
| 63 | 59 | 344 | 560.61 | −216.61 | −2.52 | −2.54 | −2.60 | .014 |
| 40 | 55 | 347 | 547.57 | −200.57 | −2.33 | −2.35 | −2.39 | .011 |
Osoba 120 (29 lat) odpowiadała średnio w 805 ms, czyli o 342 ms wolniej, niż model przewiduje dla 29-latka. Jej reszta standaryzowana wynosi 3.98, studentyzowana wewnętrznie 4.02, a zewnętrznie 4.31 – wyłączenie tej osoby z oszacowania s sprawia, że jej reszta okazuje się jeszcze bardziej nietypowa. Test największej reszty z poprawką Bonferroniego daje p = .004. Reszt poza ±2 jest 9 (7.5%), ale poza osobą 120 żadna nie przekracza co do wartości bezwzględnej 2.78.
Krok 2: kształt chmury reszt
Wykres reszt (rysunek 1C) ma kształt lejka: odchylenie standardowe reszt wynosi 58 ms u osób poniżej 40 lat i 108 ms u osób w wieku 60 lat i więcej. Test Breuscha–Pagana potwierdza heteroskedastyczność, BP(1) = 9.91, p = .002. Long i Ervin (2000) zalecają w takiej sytuacji – zwłaszcza przy N ≤ 250 – odporne błędy standardowe typu HC3, i to niezależnie od wyniku testu przesiewowego. Odporne błędy standardowe (HC3, HC4) i bootstrap są dostępne także w SPSS, choć – jak piszą Rajh-Weber i in. (2026) w poradniku dla użytkowników tego programu – dotarcie do nich nie zawsze jest proste. Z HC3 błąd standardowy nachylenia rośnie z 0.50 do 0.55, a 95% CI poszerza się z [2.27, 4.25] do [2.16, 4.36]. Wniosek o związku wieku z czasem reakcji się nie zmienia, ale oszacowanie jest mniej precyzyjne, niż sugerował klasyczny wydruk.
Krok 3: co zrobić z osobą 120?
Najpierw sprawdź, czy to nie błąd – pomylone jednostki, przerwa w zadaniu, źle zrozumiana instrukcja. Jeśli wynik jest prawdziwy, nie usuwaj go automatycznie, tylko pokaż analizę wrażliwości: bez osoby 120 nachylenie wynosi 3.47, 95% CI [2.54, 4.39]. Osoba ta ma niską dźwignię (h = .019), bo jej wiek jest typowy dla próby, więc mimo bardzo dużej reszty zmienia nachylenie tylko o 0.21 ms na rok. Duża reszta nie oznacza więc dużego wpływu na wynik.
Jak opisać analizę reszt w pracy (APA)
W rozdziale z wynikami wystarczą dwa–trzy zdania: jakie reszty obejrzano, co wykazały i jaką decyzję podjęto. Wzór dla przykładu:
W rozdziale metod podaj z góry przyjęte kryteria (np. reszta studentyzowana |t| > 3) i sposób postępowania z obserwacjami odstającymi. Pełny przebieg diagnostyki modelu z kilkoma predyktorami pokazujemy w poradniku regresja wieloraka krok po kroku, a gotowe zdania do innych analiz – w tekście jak opisać wyniki w stylu APA.
Przykład w R i SPSS
Kod tworzy dane z przykładu, szacuje model, liczy wartości przewidywane, trzy rodzaje reszt i dźwignię, testuje największą resztę, sprawdza heteroskedastyczność i porównuje klasyczne błędy standardowe z HC3. Liczby w tekście i panel C rysunku 1 pochodzą z tego kodu.
Reszty, test Breuscha–Pagana i błędy standardowe HC3
R
suppressPackageStartupMessages({
  library(car)        # outlierTest()
  library(lmtest)     # bptest(), coeftest()
  library(sandwich)   # vcovHC() – odporne błędy standardowe HC3
})

# Dane symulowane: wiek (20–75 lat) i średni czas reakcji w zadaniu wyboru (ms), N = 120
set.seed(348)
n <- 120
wiek <- round(runif(n, 20, 75))
rt <- round(430 + 3.0 * (wiek - 20) + rnorm(n, sd = 18 + 1.9 * (wiek - 20)))
rt[n] <- 805; wiek[n] <- 29          # osoba 120: bardzo wolne odpowiedzi
dane <- data.frame(wiek, rt)

model <- lm(rt ~ wiek, data = dane)
summary(model)
round(confint(model), 2)                  # klasyczne 95% CI

# Wartość przewidywana, trzy rodzaje reszt i dźwignia dla każdej osoby
dane$fit <- fitted(model)               # ŷ (ms)
dane$e   <- resid(model)                 # surowa: y − ŷ (ms)
dane$z   <- resid(model) / sigma(model)  # standaryzowana (jak ZRE w SPSS)
dane$r   <- rstandard(model)             # studentyzowana wewnętrznie (SRE)
dane$t   <- rstudent(model)              # studentyzowana zewnętrznie (SDR)
dane$h   <- hatvalues(model)             # dźwignia
round(head(dane[order(-abs(dane$t)), ], 5), 3)   # 5 osób o największej |t|
c(t_powyzej_2 = sum(abs(dane$t) > 2), t_powyzej_3 = sum(abs(dane$t) > 3))
outlierTest(model)                        # największa reszta studentyzowana z poprawką Bonferroniego

# Heteroskedastyczność: test Breuscha–Pagana i odporne błędy standardowe HC3
bptest(model)
coeftest(model, vcov. = vcovHC(model, type = "HC3"))
round(coefci(model, vcov. = vcovHC(model, type = "HC3")), 2)

# Analiza wrażliwości: model bez osoby 120
round(cbind(b = coef(update(model, data = dane[-120, ])), confint(update(model, data = dane[-120, ]))), 2)
Wynik w R
Call:
lm(formula = rt ~ wiek, data = dane)

Residuals:
    Min      1Q  Median      3Q     Max
-216.61  -38.38   -1.94   43.93  342.19

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 368.2660    24.5352  15.010  < 2e-16 ***
wiek          3.2601     0.4989   6.534  1.7e-09 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 85.96 on 118 degrees of freedom
Multiple R-squared:  0.2657,	Adjusted R-squared:  0.2595
F-statistic: 42.69 on 1 and 118 DF,  p-value: 1.701e-09

             2.5 % 97.5 %
(Intercept) 319.68 416.85
wiek          2.27   4.25
    wiek  rt     fit        e      z      r      t     h
120   29 805 462.808  342.192  3.981  4.019  4.307 0.019
47    59 791 560.610  230.390  2.680  2.699  2.774 0.014
50    70 814 596.471  217.529  2.531  2.565  2.629 0.027
63    59 344 560.610 -216.610 -2.520 -2.537 -2.598 0.014
40    55 347 547.570 -200.570 -2.333 -2.346 -2.393 0.011
t_powyzej_2 t_powyzej_3
          9           1
    rstudent unadjusted p-value Bonferroni p
120 4.307463         3.4548e-05    0.0041458

	studentized Breusch-Pagan test

data:  model
BP = 9.9092, df = 1, p-value = 0.001645


t test of coefficients:

             Estimate Std. Error t value  Pr(>|t|)
(Intercept) 368.26597   22.56175 16.3226 < 2.2e-16 ***
wiek          3.26008    0.55314  5.8938  3.66e-08 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

             2.5 % 97.5 %
(Intercept) 323.59 412.94
wiek          2.16   4.36
                 b  2.5 % 97.5 %
(Intercept) 355.73 310.03 401.43
wiek          3.47   2.54   4.39
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Sprawdzanie normalności zmiennej zależnej zamiast reszt. Skośny rozkład wyniku nie narusza założeń, jeśli reszty są w porządku (Williams i in., 2013).
- Traktowanie każdej reszty poza ±2 jako problemu. Około 5% takich reszt to norma. Usuwanie kolejnych osób „do skutku” zmienia próbę i prowadzi do p-hackingu.
- Mylenie nazw.
rstandard()w R odpowiada SRE_1 w SPSS, a ZRE_1 to reszta podzielona tylko przez s. W pracy napisz, której reszty użyłeś. - Test zamiast wykresu. Przy dużym N testy (Breuscha–Pagana, Shapiro–Wilka) wykrywają drobne odchylenia, a przy małym przeoczą duże. Zawsze obejrzyj wykres reszt.
- Utożsamianie dużej reszty z dużym wpływem. Obserwacja z dużą resztą i niską dźwignią może prawie nie zmieniać współczynników; wpływ oceniaj miarami takimi jak odległość Cooka.
- Pomijanie kolejności pomiarów. W badaniach dzienniczkowych i szeregach czasowych reszty kolejnych dni bywają skorelowane, czego wykres względem ŷ nie pokaże.
Najczęstsze pytania
Co to są reszty w regresji?
Reszta to różnica między wynikiem obserwowanym a wynikiem przewidywanym przez model, e = y − ŷ. Dodatnia reszta oznacza wynik wyższy od przewidywanego, ujemna – niższy. Reszty są oszacowaniami błędów losowych modelu, dlatego na nich sprawdza się założenia regresji.
Czym różnią się reszty standaryzowane od studentyzowanych?
Reszta standaryzowana to reszta podzielona przez błąd standardowy reszt s. Reszta studentyzowana uwzględnia dodatkowo dźwignię obserwacji, a w wersji zewnętrznej (usuniętej) liczy s bez danej osoby, więc najlepiej wykrywa obserwacje odstające. W R to rstandard() i rstudent(), w SPSS – SRE_1 i SDR_1.
Jak interpretować wykres reszt?
Na wykresie reszt względem wartości dopasowanych szukaj losowego pasa bez trendu i o stałej szerokości. Łuk oznacza nieliniowość, lejek – heteroskedastyczność, a pojedyncze punkty daleko od zera – obserwacje odstające. Kilka reszt poza ±2 jest normalne.
Jaka reszta jest za duża?
Przy normalnych błędach około 5% reszt studentyzowanych przekracza ±2, a około 0.3% – ±3. Wartości powyżej 3 co do wartości bezwzględnej sprawdź (np. testem z poprawką Bonferroniego, car::outlierTest()), ale nie usuwaj ich automatycznie – najpierw ustal przyczynę i pokaż analizę wrażliwości.
Czy reszty muszą mieć rozkład normalny?
Normalność błędów ma znaczenie głównie w małych próbach; nie dotyczy ona rozkładu samej zmiennej zależnej ani predyktorów (Williams i in., 2013). W symulacjach wartości p z regresji okazywały się dość odporne na nienormalne dane, z wyjątkiem wpływowych obserwacji odstających (Knief i Forstmeier, 2021). Ważniejsze bywają liniowość i stała wariancja reszt.
Co zrobić, gdy wykres reszt ma kształt lejka?
To heteroskedastyczność: współczynniki są nieobciążone, ale klasyczne błędy standardowe i wartości p mogą być błędne. Użyj odpornych błędów standardowych HC3 (Long i Ervin, 2000), w R: coeftest(model, vcov. = vcovHC(model, type = "HC3")), albo zastanów się nad przekształceniem zmiennej lub innym modelem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Galeria wykresów reszt
Łuk, lejek, skos, dźwignia, dwa pasma i fale w czasie – jak wyglądają złamane założenia regresji na wykresach reszt z R, z podpisami i ćwiczeniem.
Czytaj →PoradnikDiagnostyka regresji w R
Reszty studentyzowane, dźwignia, Cook i DFBETAS, VIF, maskowanie heteroskedastyczności, HC3 i analiza wrażliwości – z danymi i kodem R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikNormalność reszt czy zmiennych?
Dlaczego w regresji i ANOVA sprawdzasz reszty, a nie surową zmienną: przykład w R z dwugarbnym rozkładem, wykres Q-Q reszt i wpływ liczebności próby.
Czytaj →PoradnikKorelacja i regresja – zadania z rozwiązaniami
Dziesięć zadań: kowariancja, Pearson i Spearman, metoda najmniejszych kwadratów, R², przedział predykcji, reszty, punkt wpływowy, regresja wieloraka i kwartet Anscombe’a.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Knief, U., & Forstmeier, W. (2021). Violating the normality assumption may be the lesser of two evils. Behavior Research Methods, 53(6), 2576–2590. https://doi.org/10.3758/s13428-021-01587-5 ● Otwarty dostęp
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Rajh-Weber, H., Huber, S. E., & Arendasy, M. (2026). Using heteroskedasticity-consistent standard errors and the bootstrap for linear regression analysis available in SPSS: A tutorial. Advances in Methods and Practices in Psychological Science, 9(1), Article 25152459251408046. https://doi.org/10.1177/25152459251408046 ● Otwarty dostęp
- Rosopa, P. J., Schaffer, M. M., & Schroeder, A. N. (2013). Managing heteroscedasticity in general linear models. Psychological Methods, 18(3), 335–351. https://doi.org/10.1037/a0032553
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{knief2021violating, author={Knief, Ulrich and Forstmeier, Wolfgang}, title={{Violating the normality assumption may be the lesser of two evils}}, journal={Behavior Research Methods}, year={2021}, volume={53}, number={6}, pages={2576--2590}, doi={10.3758/s13428-021-01587-5}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{rajhweber2026using, author={Rajh-Weber, Hanna and Huber, Stefan Ernest and Arendasy, Martin}, title={{Using heteroskedasticity-consistent standard errors and the bootstrap for linear regression analysis available in SPSS: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2026}, volume={9}, number={1}, eid={25152459251408046}, doi={10.1177/25152459251408046}}@article{rosopa2013managing, author={Rosopa, Patrick J. and Schaffer, Meline M. and Schroeder, Amber N.}, title={{Managing heteroscedasticity in general linear models}}, journal={Psychological Methods}, year={2013}, volume={18}, number={3}, pages={335--351}, doi={10.1037/a0032553}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}