Co to jest regresja liniowa?
Regresja liniowa (ang. linear regression) to model, który opisuje, jak średnia wartość ilościowej zmiennej zależnej Y zmienia się wraz z jednym lub kilkoma predyktorami X. Schober i Vetter (2021) ujmują to krótko: regresja liniowa kwantyfikuje związek jednej lub więcej zmiennych niezależnych z ciągłą zmienną zależną. Gdy predyktor jest jeden, mówimy o regresji prostej, gdy jest ich kilka – o regresji wielorakiej.
W psychologii regresja służy do opisu związków (o ile wyższy jest średni wynik przy wyższym predyktorze), do przewidywania (jaki wynik uzyska osoba o danych cechach) i do kontroli zmiennych (jaki jest związek X z Y przy stałym poziomie innych predyktorów). Podręcznik Gelmana i in. (2020) pokazuje praktyczne użycie regresji właśnie do porównań, estymacji, predykcji i wnioskowania przyczynowego. „Liniowa” oznacza liniowość względem współczynników – model może zawierać także kwadrat predyktora czy iloczyn dwóch predyktorów (regresja krzywoliniowa, moderacja).
Model regresji: wzór, współczynniki b i β, R²
- b0 – stała (wyraz wolny): przewidywany wynik, gdy wszystkie predyktory są równe zero;
- b1 … bk – współczynniki nachylenia: o ile zmienia się przewidywany Y, gdy dany predyktor rośnie o jednostkę, a pozostałe predyktory są stałe;
- e – błąd losowy; jego oszacowania z próby to reszty, czyli różnice między wynikiem obserwowanym a przewidywanym.
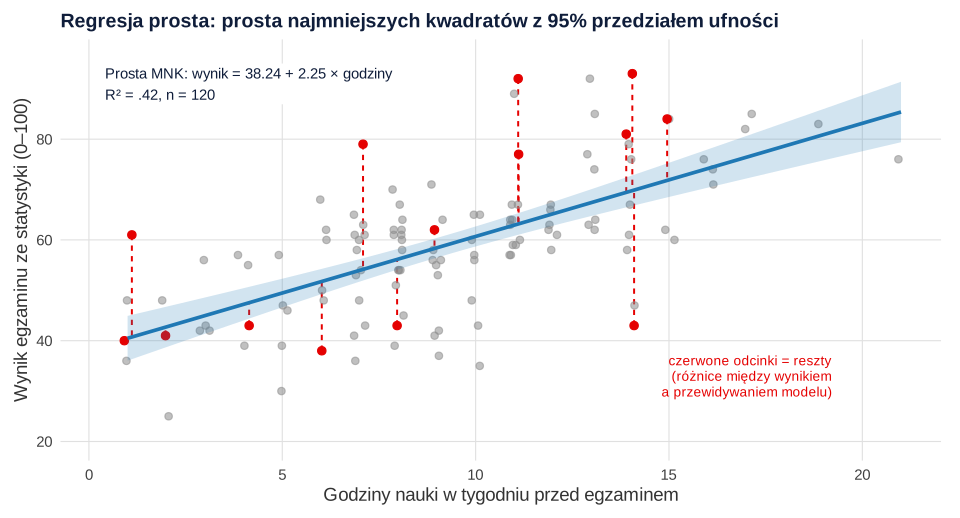
Współczynniki szacuje się zwykle metodą najmniejszych kwadratów (MNK): program wybiera takie b, przy których suma kwadratów reszt jest najmniejsza. W regresji prostej daje to linię najlepszego dopasowania, a jej nachylenie jest związane z korelacją Pearsona: b = r × SDY / SDX. Najważniejsze wielkości z wydruku zebraliśmy w tabeli.
| Wielkość | Co mówi | Na co uważać |
|---|---|---|
| b (niestandaryzowany) | Zmiana Y w jednostkach skali na jednostkę predyktora | Nie porównuj b predyktorów mierzonych na różnych skalach |
| β (standaryzowany) | Zmiana Y w odchyleniach standardowych na 1 SD predyktora (po standaryzacji) | Zależy od zróżnicowania zmiennych w próbie |
| SE i 95% CI dla b | Precyzja oszacowania (błąd standardowy, przedział ufności) | CI nieobejmujący zera odpowiada p < .05 |
| R² | Odsetek wariancji Y wyjaśniony przez model | Rośnie po dodaniu każdego predyktora; podawaj też skorygowane R² |
| Test F modelu | Czy model jako całość wyjaśnia więcej niż sama średnia | Istotny F nie znaczy, że każdy predyktor jest istotny |
Założenia regresji liniowej
Wnioskowanie z regresji MNK (p, przedziały ufności) opiera się na założeniach dotyczących błędów modelu, a nie surowych zmiennych. Williams i in. (2013) korygują popularne nieporozumienie: regresja wieloraka wymaga – zwłaszcza w małych próbach – normalności błędów, a nie normalności zmiennej zależnej czy predyktorów. Lumley i in. (2002) pokazują ponadto, że w dużych próbach regresja liniowa daje trafne wnioski także przy rozkładzie wyniku dalekim od normalnego.
| Założenie | Jak sprawdzić | Co zrobić, gdy nie jest spełnione |
|---|---|---|
| Liniowość związku | Wykres reszt względem wartości dopasowanych (linia powinna być płaska) | Dodaj składnik krzywoliniowy lub przekształć zmienną |
| Niezależność obserwacji | Plan badania (pomiary powtarzane, osoby w grupach) | Model wielopoziomowy; w szeregach czasowych test Durbina–Watsona |
| Homoskedastyczność | Wykres pierwiastka z |reszt standaryzowanych| względem wartości dopasowanych | Odporne błędy standardowe (np. HC3) |
| Normalność reszt | Wykres Q-Q reszt | W dużej próbie zwykle niegroźna; w małej – bootstrap lub inny model |
| Brak silnej współliniowości | VIF predyktorów | Połącz lub usuń nadmiarowe predyktory |
| Brak obserwacji nadmiernie wpływowych | Odległość Cooka, dźwignia | Sprawdź dane; podaj wyniki z obserwacjami i bez nich |
W praktyce te kroki często się pomija. W przeglądzie 12 czasopism psychologii klinicznej Ernst i Albers (2017) ustalili, że 92% artykułów stosujących regresję liniową nie raportowało jasno sprawdzania założeń, a w 4% artykułów za konieczne założenie uznawano normalność samych zmiennych zamiast reszt.
Przykład: czas nauki, lęk przed statystyką i wynik egzaminu
Przyjmijmy, że 120 studentów psychologii (dane symulowane) podało liczbę godzin nauki w tygodniu przed egzaminem ze statystyki (M = 9.26, SD = 4.05) i wypełniło skalę lęku przed statystyką (1–5; M = 3.03, SD = 0.89). Wynik egzaminu (0–100) wyniósł średnio 59.02 punktu (SD = 14.08) i korelował z czasem nauki, r = .65, oraz z lękiem, r = −.41.
Regresja prosta
Model z jednym predyktorem ma postać: wynik = 38.24 + 2.25 × godziny. Każda dodatkowa godzina nauki wiąże się z wynikiem wyższym średnio o 2.25 punktu, 95% CI [1.76, 2.73], t(118) = 9.20, p < .001. Czas nauki wyjaśnia 42% wariancji wyników, R² = .42, F(1, 118) = 84.58, p < .001. Stała 38.24 to przewidywany wynik osoby, która w ogóle się nie uczyła – to jednak ekstrapolacja, bo najmniejsza wartość w próbie wynosiła 1 godzinę.
Regresja wieloraka
Po dodaniu lęku przed statystyką model wyjaśniał 49% wariancji, R² = .49, skorygowane R² = .48, F(2, 117) = 56.34, p < .001. Współczynniki przedstawia tabela.
| Predyktor | b | SE | 95% CI dla b | β | t(117) | p |
|---|---|---|---|---|---|---|
| Stała | 53.46 | 4.38 | [44.79, 62.13] | — | 12.21 | < .001 |
| Godziny nauki | 2.03 | 0.23 | [1.57, 2.50] | 0.59 | 8.66 | < .001 |
| Lęk przed statystyką | −4.38 | 1.07 | [−6.49, −2.26] | −0.28 | −4.10 | < .001 |
Przy tym samym poziomie lęku każda godzina nauki wiąże się z wynikiem wyższym o 2.03 punktu, a przy tej samej liczbie godzin każdy punkt lęku – z wynikiem niższym o 4.38 punktu. Dwie osoby, które uczyły się po 10 godzin, ale różnią się lękiem (2 i 4 punkty), mają przewidywane wyniki 65.06 i 56.30. Współczynnik czasu nauki spadł z 2.25 do 2.03, bo bardziej zalęknieni studenci uczyli się nieco krócej (r = −.22) – część związku godzin z wynikiem była wspólna z lękiem. Według β silniejszym predyktorem jest czas nauki (β = 0.59) niż lęk (β = −0.28).
Diagnostyka reszt
Rysunek 2 przedstawia panel diagnostyczny z funkcji check_model() (pakiet performance).
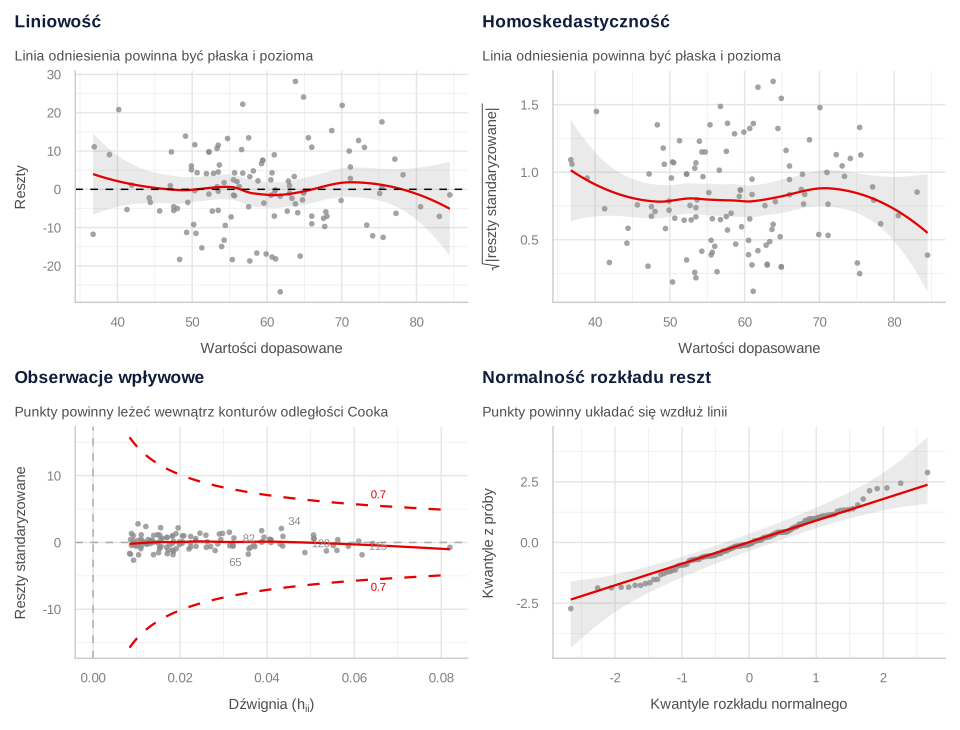
Linie odniesienia są prawie płaskie, a reszty układają się wzdłuż prostej na wykresie Q-Q; formalne testy nie wskazują na problem (normalność reszt: p = .763; heteroskedastyczność: p = .768). Współliniowość jest znikoma (VIF = 1.05), a największa odległość Cooka wynosi 0.075, więc żadna obserwacja odstająca nie dominuje wyniku. Przy wielu predyktorach lub dodawaniu ich blokami sięgnij po regresję hierarchiczną.
Jak opisać regresję w pracy (APA)
Podaj rodzaj modelu, R² z testem F, dla każdego predyktora b z 95% CI (lub SE), β, t i p oraz jedno zdanie o diagnostyce. Wzór dla przykładu:
Przy kilku predyktorach wyniki zbierz w tabeli – wzór z notą znajdziesz w haśle tabela regresji w APA, a gotowe zdania do innych analiz w poradniku jak opisać wyniki w stylu APA.
Przykład w R
Kod tworzy dane z przykładu, szacuje regresję prostą i wieloraką, liczy współczynniki standaryzowane, VIF i testy założeń. Liczby w tekście pochodzą z tego kodu; rysunki przedstawiają te same wyniki w szacie graficznej serwisu.
Regresja prosta i wieloraka z diagnostyką
R
library(effectsize)    # standardize_parameters()
library(car)           # vif()
library(performance)   # check_model(), check_normality(), check_heteroscedasticity()

# Dane symulowane: godziny nauki, lęk przed statystyką (1–5) i wynik egzaminu (0–100), N = 120
set.seed(355)
n <- 120
lek <- pmin(pmax(round(rnorm(n, 3, 0.8) * 4) / 4, 1), 5)
godziny <- pmin(pmax(round(9 - 1.2 * (lek - 3) + rnorm(n, sd = 3.8)), 0), 25)
wynik <- pmin(pmax(round(42 + 2.0 * godziny - 4.5 * (lek - 3) + rnorm(n, sd = 10)), 0), 100)
dane <- data.frame(godziny, lek, wynik)
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane), 2)

# Regresja prosta: wynik egzaminu przewidywany liczbą godzin nauki
m_prosty <- lm(wynik ~ godziny, data = dane)
summary(m_prosty)

# Regresja wieloraka: godziny nauki i lęk przed statystyką
model <- lm(wynik ~ godziny + lek, data = dane)
summary(model)
round(confint(model), 2)
standardize_parameters(model)   # współczynniki standaryzowane β
vif(model)

# Diagnostyka reszt: wykresy, wartości p testów założeń i największa odległość Cooka
check_model(model, check = c("linearity", "homogeneity", "qq", "outliers"))
round(c(normalnosc_reszt = as.numeric(check_normality(model)),
        heteroskedastycznosc = as.numeric(check_heteroscedasticity(model))), 3)
round(max(cooks.distance(model)), 3)
Wynik w R
Loading required package: carData
   godziny  lek wynik
M     9.26 3.03 59.02
SD    4.05 0.89 14.08
        godziny   lek wynik
godziny    1.00 -0.22  0.65
lek       -0.22  1.00 -0.41
wynik      0.65 -0.41  1.00

Call:
lm(formula = wynik ~ godziny, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-26.6707  -5.2563  -0.8224   6.6922  29.0647

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  38.2388     2.4657  15.509  < 2e-16 ***
godziny       2.2451     0.2441   9.197 1.59e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 10.79 on 118 degrees of freedom
Multiple R-squared:  0.4175,	Adjusted R-squared:  0.4126
F-statistic: 84.58 on 1 and 118 DF,  p-value: 1.592e-15


Call:
lm(formula = wynik ~ godziny + lek, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-26.7739  -5.9371  -0.6922   6.1710  28.1915

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   53.461      4.378  12.212  < 2e-16 ***
godziny        2.035      0.235   8.660 3.04e-14 ***
lek           -4.376      1.068  -4.097 7.74e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 10.14 on 117 degrees of freedom
Multiple R-squared:  0.4906,	Adjusted R-squared:  0.4819
F-statistic: 56.34 on 2 and 117 DF,  p-value: < 2.2e-16

            2.5 % 97.5 %
(Intercept) 44.79  62.13
godziny      1.57   2.50
lek         -6.49  -2.26
# Standardization method: refit

Parameter   | Std. Coef. |         95% CI
-----------------------------------------
(Intercept) |   1.16e-17 | [-0.13,  0.13]
godziny     |       0.59 | [ 0.45,  0.72]
lek         |      -0.28 | [-0.41, -0.14]
 godziny      lek
1.050202 1.050202
    normalnosc_reszt heteroskedastycznosc
               0.763                0.768
[1] 0.075
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2 (panel diagnostyczny – w pakietach performance, see i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- performance (wersja 0.16.0): Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- see (wersja 0.13.0): Lüdecke, D., Patil, I., Ben-Shachar, M. S., Wiernik, B. M., Waggoner, P., & Makowski, D. (2021). see: An R package for visualizing statistical models. Journal of Open Source Software, 6(64), 3393. https://doi.org/10.21105/joss.03393
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Sprawdzanie normalności zmiennych zamiast reszt. Założenie dotyczy błędów modelu (Williams i in., 2013); skośny rozkład predyktora nie jest problemem.
- Brak opisu diagnostyki. Jedno zdanie o resztach, VIF i obserwacjach wpływowych wystarczy, a w wielu artykułach go brakuje (Ernst i Albers, 2017).
- Język przyczynowy w badaniu korelacyjnym. b opisuje różnicę w średnim wyniku między osobami różniącymi się predyktorem, a nie skutek zmiany predyktora u tej samej osoby.
- Ekstrapolacja. Przewidywania poza zakresem obserwowanych danych (np. dla 0 godzin nauki, gdy najmniej było 1) są niepewne.
- Porównywanie siły predyktorów po b. Predyktory na różnych skalach porównuj za pomocą β albo w jednostkach o znaczeniu praktycznym.
- Dobór predyktorów metodą krokową na podstawie wartości p zamiast teorii – model dopasowuje się do przypadkowych cech próby.
- Regresja liniowa dla niewłaściwego typu wyniku. Dla wyniku dwuwartościowego użyj regresji logistycznej, dla porządkowego – regresji porządkowej, a dla liczebności – regresji Poissona.
Najczęstsze pytania
Co to jest regresja liniowa?
To model, który przewiduje średnią wartość ilościowej zmiennej zależnej na podstawie jednego (regresja prosta) lub kilku predyktorów (regresja wieloraka). Każdy predyktor ma współczynnik b, a cały model – miarę dopasowania R². Współczynniki szacuje się zwykle metodą najmniejszych kwadratów.
Jak interpretować współczynnik b w regresji?
b to przewidywana zmiana zmiennej zależnej, gdy predyktor rośnie o jednostkę, a pozostałe predyktory są stałe. W przykładzie z tej strony b = 2.03 oznacza, że przy tym samym poziomie lęku każda godzina nauki wiąże się z wynikiem egzaminu wyższym średnio o 2.03 punktu.
Czym różni się b od β (beta) w regresji?
b jest wyrażone w jednostkach skali (np. punkty na godzinę), a β – w odchyleniach standardowych, bo pochodzi z modelu na zmiennych standaryzowanych. β pozwala porównać siłę predyktorów mierzonych na różnych skalach, ale zależy od zróżnicowania zmiennych w próbie, więc w pracy podawaj oba współczynniki.
Jakie są założenia regresji liniowej?
Liniowość związku, niezależność obserwacji, stała wariancja reszt (homoskedastyczność), normalność reszt (ważna zwłaszcza w małych próbach), brak silnej współliniowości predyktorów i brak obserwacji nadmiernie wpływowych. Sprawdza się je głównie na wykresach reszt, VIF i odległości Cooka.
Czy zmienne w regresji muszą mieć rozkład normalny?
Nie. Założenie normalności dotyczy błędów modelu, czyli reszt, a nie zmiennej zależnej ani predyktorów (Williams i in., 2013). W dużych próbach nawet wyraźnie nienormalne reszty zwykle nie podważają wniosków o współczynnikach (Lumley i in., 2002).
Co oznacza R² w regresji?
R² to odsetek wariancji zmiennej zależnej wyjaśniony przez model, od 0 do 1. Na przykład R² = .49 oznacza, że predyktory wyjaśniają 49% zróżnicowania wyników. Ponieważ R² rośnie po dodaniu każdego predyktora, podawaj też skorygowane R².
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Metoda najmniejszych kwadratów w obrazkach
Reszty jako kwadraty, parabola sumy kwadratów, regresja y na x i x na y, oś główna, dźwignia i R² – skąd się bierze prosta regresji, na rysunkach z R.
Czytaj →PoradnikWynik regresji na wykresie
Współczynniki z CI, pasmo ufności a predykcji, ekstrapolacja, interakcja, efekty brzegowe i prawdopodobieństwa – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ernst, A. F., & Albers, C. J. (2017). Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions. PeerJ, 5, Article e3323. https://doi.org/10.7717/peerj.3323 ● Otwarty dostęp
- Gelman, A., Hill, J., & Vehtari, A. (2020). Regression and other stories. Cambridge University Press. https://doi.org/10.1017/9781139161879
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23(1), 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Schober, P., & Vetter, T. R. (2021). Linear regression in medical research. Anesthesia & Analgesia, 132(1), 108–109. https://doi.org/10.1213/ANE.0000000000005206 ● Otwarty dostęp
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{ernst2017regression, author={Ernst, Anja F. and Albers, Casper J.}, title={{Regression assumptions in clinical psychology research practice—A systematic review of common misconceptions}}, journal={PeerJ}, year={2017}, volume={5}, eid={e3323}, doi={10.7717/peerj.3323}}@book{gelman2020regression, author={Gelman, Andrew and Hill, Jennifer and Vehtari, Aki}, title={{Regression and other stories}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781139161879}}@article{lumley2002importance, author={Lumley, Thomas and Diehr, Paula and Emerson, Scott and Chen, Lu}, title={{The importance of the normality assumption in large public health data sets}}, journal={Annual Review of Public Health}, year={2002}, volume={23}, number={1}, pages={151--169}, doi={10.1146/annurev.publhealth.23.100901.140546}}@article{schober2021linear, author={Schober, Patrick and Vetter, Thomas R.}, title={{Linear regression in medical research}}, journal={Anesthesia \& Analgesia}, year={2021}, volume={132}, number={1}, pages={108--109}, doi={10.1213/ane.0000000000005206}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}