Co to jest regresja hierarchiczna?
Regresja hierarchiczna (hierarchiczna regresja wieloraka, ang. hierarchical multiple regression) to sposób budowania regresji wielorakiej, w którym predyktory wprowadza się do modelu w kolejnych blokach, w kolejności ustalonej przez badacza na podstawie teorii. Po każdym kroku sprawdza się, o ile wzrósł współczynnik determinacji R² i czy ten przyrost (ΔR²) jest istotny. Analiza odpowiada więc na pytanie: czy nowy zestaw zmiennych wyjaśnia wynik ponad to, co wyjaśniają zmienne wprowadzone wcześniej?
Nazwa bywa myląca. Regresja hierarchiczna w tym znaczeniu nie dotyczy hierarchicznej struktury danych (np. uczniów w klasach) – do takich danych służy model wielopoziomowy, nazywany też hierarchicznym modelem liniowym. Nie jest też osobnym modelem statystycznym: model z ostatniego kroku to zwykła regresja wieloraka, a „hierarchia” dotyczy kolejności testowania bloków.
Bloki, ΔR² i test F zmiany
Typowy plan ma dwa–trzy bloki: najpierw zmienne kontrolne (np. wiek, płeć), potem predyktory dobrze udokumentowane we wcześniejszych badaniach, a na końcu zmienne, których dodatkowy wkład chcesz wykazać. Ten sam schemat służy do testowania interakcji: najpierw efekty główne, potem ich iloczyn (zob. analiza moderacji krok po kroku). Po każdym kroku liczy się:
gdzie m to liczba predyktorów dodanych w kroku k, p – liczba wszystkich predyktorów w kroku k, a N – liczebność próby. Statystyka ma rozkład F z (m, N − p − 1) stopniami swobody. Wielkość przyrostu opisuje też f² = ΔR² / (1 − R²krok k). W SPSS te wartości znajdziesz w kolumnach „Zmiana R kwadrat” i „Zmiana F” (R Square Change, F Change), a w R – w porównaniu kolejnych modeli funkcją anova().
Przykład: wyczerpanie emocjonalne nauczycieli w trzech krokach
Załóżmy, że badasz 210 nauczycieli (dane symulowane; 40 mężczyzn). Zmienną zależną jest wyczerpanie emocjonalne (0–54; M = 22.40, SD = 10.43). Hipoteza zakłada, że zasoby pracy – wsparcie od współpracowników i autonomia (skale 1–5) – wiążą się z wyczerpaniem także po uwzględnieniu wymagań pracy (obciążenia i trudnych zachowań uczniów, skale 1–5) oraz wieku i płci. Kolejność bloków wynika z hipotezy: najpierw zmienne kontrolne, potem znane czynniki ryzyka, na końcu zasoby, których wkład chcemy wykazać.
| Krok | Dodane predyktory | R² | ΔR² | Test F zmiany |
|---|---|---|---|---|
| 1 | Wiek, płeć | .002 | .002 | F(2, 207) = 0.23, p = .793 |
| 2 | Obciążenie pracą, trudne zachowania uczniów | .285 | .283 | F(2, 205) = 40.59, p < .001 |
| 3 | Wsparcie współpracowników, autonomia | .349 | .064 | F(2, 203) = 9.93, p < .001 |
Zmienne demograficzne nie wyjaśniały wyczerpania. Wymagania pracy dodały 28.3% wyjaśnionej wariancji, a zasoby – kolejne 6.4% ponad wymagania i demografię (f² = 0.10). Model końcowy wyjaśniał 34.9% wariancji, R² = .349, skorygowane R² = .330, F(6, 203) = 18.13, p < .001. Przy stałych pozostałych zmiennych wyższe wsparcie (b = −2.28, 95% CI [−3.97, −0.60], β = −0.17, p = .008) i większa autonomia (b = −2.11, 95% CI [−3.72, −0.50], β = −0.16, p = .011) wiązały się z niższym wyczerpaniem.
Zwróć uwagę na współczynniki z wcześniejszych kroków: współczynnik obciążenia pracą zmalał między krokiem 2 a 3 z 5.22 do 4.16 (β z 0.39 do 0.31), bo nauczyciele bardziej obciążeni mieli zarazem mniej zasobów. Współczynniki interpretuje się w modelu, w którym zostały oszacowane – wynik z kroku 2 opisuje związek obciążenia z wyczerpaniem bez kontroli zasobów.
Dlaczego kolejność bloków wyznacza teoria
ΔR² zależy od tego, co już jest w modelu. Gdy bloki są ze sobą skorelowane, ich wspólna część wariancji „przypada” blokowi wprowadzonemu wcześniej. Rysunek 1 pokazuje te same dane z odwróconą kolejnością dwóch ostatnich bloków. Model końcowy jest identyczny (R² = .349), ale podział wyjaśnionej wariancji wygląda zupełnie inaczej.
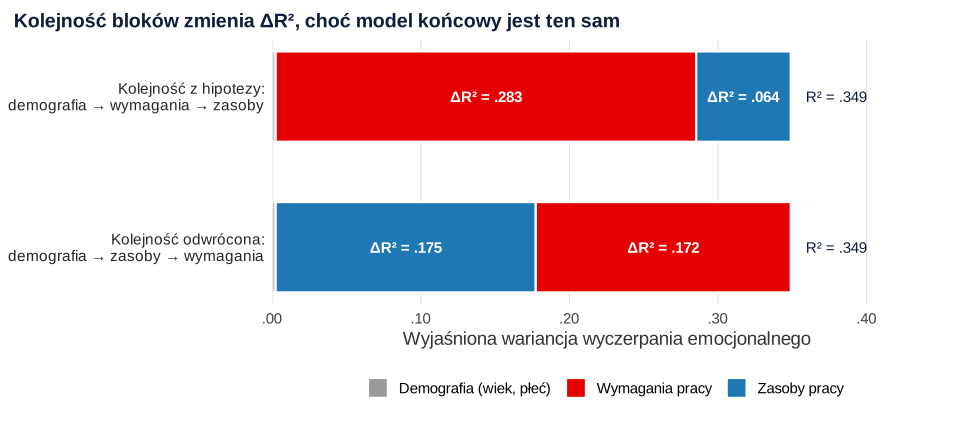
Zasoby wprowadzone jako drugi krok „wyjaśniają” .175 wariancji, a jako ostatni – tylko .064. Wymagania – odpowiednio .283 albo .172. ΔR² nie jest więc stałą „ważnością” bloku, lecz odpowiedzią na konkretne pytanie: ile blok wnosi ponad bloki wcześniejsze. ΔR² ostatniego bloku to jego łączny unikalny wkład w modelu pełnym. Kolejność musi zatem wynikać z hipotezy i być ustalona przed analizą – najlepiej w prerejestracji. Petrocelli (2003), analizując artykuły z dwóch czasopism psychologii poradnictwa z lat 1997–2001, opisał typowe problemy w stosowaniu regresji hierarchicznej i sposoby ich uniknięcia.
Regresja hierarchiczna a metoda krokowa
Regresję hierarchiczną często myli się z metodą krokową, bo w obu predyktory pojawiają się w modelu po kolei. Różnica jest jednak zasadnicza: o kolejności decyduje badacz, a nie algorytm.
| Cecha | Regresja hierarchiczna | Metoda krokowa (postępująca, wsteczna) |
|---|---|---|
| Kto ustala kolejność | Badacz, na podstawie teorii, przed analizą | Program, na podstawie wartości p lub kryterium dopasowania w tej próbie |
| Na jakie pytanie odpowiada | Czy blok wnosi coś ponad bloki wcześniejsze? | Który zestaw zmiennych najlepiej pasuje do tych danych? |
| Wartości p i przedziały ufności | Zgodne z planem analizy | Zbyt optymistyczne – ukryte wielokrotne testowanie |
| Replikowalność | Zależy od jakości teorii i danych | Niska – wybór zmiennych zmienia się między próbami |
Krytyka metod krokowych jest w literaturze zgodna. Thompson (1995) wskazał trzy problemy: programy używają błędnych stopni swobody, co zwiększa szansę fałszywej istotności; procedura nie znajduje najlepszego zestawu zmiennych danej wielkości; a wyniki wykorzystują przypadkowe cechy próby i słabo się replikują. Whittingham i in. (2006) ustalili, że mimo tych wad w trzech czołowych czasopismach ekologicznych i behawioralnych 57% z 65 artykułów z 2004 roku, w których stosowano regresję wielokrotną, korzystało z procedury krokowej. Smith (2018) pokazuje, że prawdziwe predyktory mogą przy tym wypaść z modelu, a zmienne bez znaczenia – przypadkowo okazać się istotne, więc model dobrze pasuje do próby, ale źle przewiduje nowe dane. Heinze i in. (2018) dodają, że selekcja zmiennych – zwłaszcza gdy celem jest wyjaśnianie, a nie sama predykcja – może naruszać stabilność modelu, nieobciążoność współczynników i poprawność wartości p oraz przedziałów ufności; autorzy podają praktyczne zalecenia, w tym sprawdzanie stabilności wyboru zmiennych.
Prosta symulacja pokazuje skalę problemu. W 1000 badaniach ze 100 osobami i 15 kandydatami na predyktory, z których żaden nie był związany z wynikiem, selekcja postępująca (próg wejścia p < .05) w 54% badań zostawiła w modelu co najmniej jeden „istotny” predyktor, a w 188 badaniach – dwa lub więcej. Podobnie działa metoda eliminacji wstecznej. Jeśli nie testujesz bloków, wprowadzaj wszystkie zaplanowane predyktory naraz – to metoda wprowadzania.
Jak opisać regresję hierarchiczną w pracy (APA)
Opisz kolejność bloków i jej uzasadnienie, a dla każdego kroku podaj R², ΔR² i test F zmiany. Współczynniki predyktorów przedstaw w tabeli dla wszystkich kroków. Wzór opisu:
Tabela 1
Hierarchiczna regresja liniowa: predyktory wyczerpania emocjonalnego nauczycieli
| Krok i predyktor | b | SE | β | p | R2 | ΔR2 |
|---|---|---|---|---|---|---|
| Krok 1 | .002 | .002 | ||||
| Wiek | −0.03 | 0.06 | −0.04 | .583 | ||
| Płeć (mężczyzna) | 0.87 | 1.85 | 0.08 | .640 | ||
| Krok 2 | .285 | .283 | ||||
| Wiek | −0.06 | 0.05 | −0.06 | .293 | ||
| Płeć (mężczyzna) | −0.44 | 1.58 | −0.04 | .782 | ||
| Obciążenie pracą | 5.22 | 0.83 | 0.39 | < .001 | ||
| Trudne zachowania uczniów | 3.84 | 0.86 | 0.27 | < .001 | ||
| Krok 3 | .349 | .064 | ||||
| Wiek | −0.04 | 0.05 | −0.05 | .388 | ||
| Płeć (mężczyzna) | −0.48 | 1.52 | −0.05 | .753 | ||
| Obciążenie pracą | 4.16 | 0.84 | 0.31 | < .001 | ||
| Trudne zachowania uczniów | 3.38 | 0.85 | 0.24 | < .001 | ||
| Wsparcie współpracowników | −2.28 | 0.85 | −0.17 | .008 | ||
| Autonomia | −2.11 | 0.82 | −0.16 | .011 |
Uwaga. N = 210. β obliczono po standaryzacji zmiennych ilościowych; dla płci β to różnica w odchyleniach standardowych wyczerpania między mężczyznami a kobietami. Test F zmiany: krok 1 F(2, 207) = 0.23, p = .793; krok 2 F(2, 205) = 40.59, p < .001; krok 3 F(2, 203) = 9.93, p < .001. Dane symulowane.
Inne warianty tabel regresji znajdziesz w haśle tabela regresji w APA, a pełną analizę z diagnostyką założeń – w poradniku regresja wieloraka krok po kroku.
Przykład w R
Pierwszy przepis odtwarza wszystkie liczby z przykładu i tabeli, drugi – symulację metody krokowej. Rysunek przedstawia wyniki pierwszego przepisu w szacie graficznej serwisu.
1. Trzy kroki, ΔR² i test F zmiany
R
library(effectsize)   # standardize_parameters()
library(car)          # vif()

# Dane symulowane: 210 nauczycieli – wyczerpanie emocjonalne (0–54), wiek, płeć,
# wymagania pracy (obciążenie, trudne zachowania uczniów; 1–5) i zasoby (wsparcie, autonomia; 1–5)
set.seed(210)
n <- 210
plec <- factor(rbinom(n, 1, 0.18), levels = 0:1, labels = c("kobieta", "mężczyzna"))
wiek <- round(runif(n, 25, 64))
z_obc <- rnorm(n)
z_zach <- 0.35 * z_obc + sqrt(1 - 0.35^2) * rnorm(n)
z_wsp <- -0.25 * z_obc - 0.15 * z_zach + sqrt(1 - 0.25^2 - 0.15^2 - 0.05) * rnorm(n)
z_aut <- -0.20 * z_obc + 0.30 * z_wsp + sqrt(1 - 0.2^2 - 0.3^2 - 0.05) * rnorm(n)
skala <- function(z, m, s) pmin(pmax(round((m + s * z) * 5) / 5, 1), 5)
obciazenie <- skala(z_obc, 3.4, 0.8); zachowania <- skala(z_zach, 2.9, 0.8)
wsparcie <- skala(z_wsp, 3.5, 0.8); autonomia <- skala(z_aut, 3.2, 0.8)
wycz <- 22 - 0.06 * (wiek - 45) - 1.0 * (plec == "mężczyzna") + 4.2 * (obciazenie - 3.4) +
  3.0 * (zachowania - 2.9) - 2.6 * (wsparcie - 3.5) - 2.2 * (autonomia - 3.2) + rnorm(n, sd = 8.5)
dane <- data.frame(wyczerpanie = pmin(pmax(round(wycz), 0), 54), wiek, plec,
                   obciazenie, zachowania, wsparcie, autonomia)

# Trzy kroki w kolejności wynikającej z teorii (wymagania, potem zasoby)
k1 <- lm(wyczerpanie ~ wiek + plec, data = dane)
k2 <- update(k1, . ~ . + obciazenie + zachowania)
k3 <- update(k2, . ~ . + wsparcie + autonomia)
r2 <- sapply(list(krok1 = k1, krok2 = k2, krok3 = k3), function(m) summary(m)$r.squared)
round(rbind(R2 = r2, delta_R2 = c(r2[1], diff(r2))), 3)

# Test F zmiany R² – każdy krok względem poprzedniego (tak jak „F change” w SPSS)
summary(k1)$fstatistic
anova(k1, k2)
anova(k2, k3)

# Współczynniki w każdym kroku
round(coef(summary(k1)), 3)
round(coef(summary(k2)), 3)
summary(k3)
round(confint(k3), 2)
standardize_parameters(k1)
standardize_parameters(k2)
standardize_parameters(k3)
vif(k3)

# Ten sam model końcowy, odwrotna kolejność bloków: zasoby przed wymaganiami
k2_alt <- update(k1, . ~ . + wsparcie + autonomia)
round(c(zasoby_jako_krok2 = summary(k2_alt)$r.squared - r2[["krok1"]],
        wymagania_jako_krok3 = r2[["krok3"]] - summary(k2_alt)$r.squared), 3)
Wynik w R
Loading required package: carData
         krok1 krok2 krok3
R2       0.002 0.285 0.349
delta_R2 0.002 0.283 0.064
      value       numdf       dendf
  0.2323024   2.0000000 207.0000000
Analysis of Variance Table

Model 1: wyczerpanie ~ wiek + plec
Model 2: wyczerpanie ~ wiek + plec + obciazenie + zachowania
  Res.Df   RSS Df Sum of Sq      F    Pr(>F)
1    207 22705
2    205 16265  2    6440.2 40.585 1.415e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Analysis of Variance Table

Model 1: wyczerpanie ~ wiek + plec + obciazenie + zachowania
Model 2: wyczerpanie ~ wiek + plec + obciazenie + zachowania + wsparcie +
    autonomia
  Res.Df   RSS Df Sum of Sq      F   Pr(>F)
1    205 16265
2    203 14816  2    1449.3 9.9291 7.69e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
              Estimate Std. Error t value Pr(>|t|)
(Intercept)     23.759      2.844   8.354    0.000
wiek            -0.035      0.063  -0.550    0.583
plecmężczyzna    0.868      1.855   0.468    0.640
              Estimate Std. Error t value Pr(>|t|)
(Intercept)     -3.865      3.909  -0.989    0.324
wiek            -0.057      0.054  -1.054    0.293
plecmężczyzna   -0.439      1.585  -0.277    0.782
obciazenie       5.224      0.833   6.274    0.000
zachowania       3.843      0.864   4.448    0.000

Call:
lm(formula = wyczerpanie ~ wiek + plec + obciazenie + zachowania +
    wsparcie + autonomia, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-24.8741  -5.7410   0.0023   5.4407  22.7282

Coefficients:
              Estimate Std. Error t value Pr(>|t|)
(Intercept)   15.09919    5.67783   2.659  0.00845 **
wiek          -0.04482    0.05184  -0.864  0.38835
plecmężczyzna -0.47897    1.52103  -0.315  0.75316
obciazenie     4.16075    0.84116   4.946 1.58e-06 ***
zachowania     3.38196    0.84524   4.001 8.83e-05 ***
wsparcie      -2.28376    0.85404  -2.674  0.00810 **
autonomia     -2.10545    0.81666  -2.578  0.01064 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 8.543 on 203 degrees of freedom
Multiple R-squared:  0.3489,	Adjusted R-squared:  0.3297
F-statistic: 18.13 on 6 and 203 DF,  p-value: < 2.2e-16

              2.5 % 97.5 %
(Intercept)    3.90  26.29
wiek          -0.15   0.06
plecmężczyzna -3.48   2.52
obciazenie     2.50   5.82
zachowania     1.72   5.05
wsparcie      -3.97  -0.60
autonomia     -3.72  -0.50
# Standardization method: refit

Parameter        | Std. Coef. |        95% CI
---------------------------------------------
(Intercept)      |      -0.02 | [-0.17, 0.14]
wiek             |      -0.04 | [-0.18, 0.10]
plec [mężczyzna] |       0.08 | [-0.27, 0.43]
# Standardization method: refit

Parameter        | Std. Coef. |        95% CI
---------------------------------------------
(Intercept)      |   8.01e-03 | [-0.12, 0.14]
wiek             |      -0.06 | [-0.18, 0.05]
plec [mężczyzna] |      -0.04 | [-0.34, 0.26]
obciazenie       |       0.39 | [ 0.27, 0.51]
zachowania       |       0.27 | [ 0.15, 0.40]
# Standardization method: refit

Parameter        | Std. Coef. |         95% CI
----------------------------------------------
(Intercept)      |   8.74e-03 | [-0.12,  0.13]
wiek             |      -0.05 | [-0.16,  0.06]
plec [mężczyzna] |      -0.05 | [-0.33,  0.24]
obciazenie       |       0.31 | [ 0.19,  0.43]
zachowania       |       0.24 | [ 0.12,  0.36]
wsparcie         |      -0.17 | [-0.29, -0.04]
autonomia        |      -0.16 | [-0.29, -0.04]
      wiek       plec obciazenie zachowania   wsparcie  autonomia
  1.020900   1.026439   1.213359   1.137751   1.203322   1.230512
   zasoby_jako_krok2 wymagania_jako_krok3
               0.175                0.172
2. Symulacja: metoda krokowa na danych bez żadnego związku
R
# Selekcja postępująca (jak metoda krokowa w SPSS): dodawaj predyktor o najmniejszym p, dopóki p < .05
krokowa <- function(y, X, p_wej = .05) {
  wybrane <- character(0)
  repeat {
    kandydaci <- setdiff(names(X), wybrane)
    if (length(kandydaci) == 0) break
    p <- sapply(kandydaci, function(v) {
      m <- lm(y ~ ., data = X[, c(wybrane, v), drop = FALSE])
      coef(summary(m))[v, 4]
    })
    if (min(p) >= p_wej) break
    wybrane <- c(wybrane, names(which.min(p)))
  }
  wybrane
}

# 1000 symulowanych badań: N = 100, 15 kandydatów na predyktory, żaden niezwiązany z wynikiem
set.seed(31)
wybrano <- replicate(1000, {
  X <- as.data.frame(matrix(rnorm(100 * 15), nrow = 100))
  y <- rnorm(100)
  length(krokowa(y, X))
})
table(wybrano)            # ile „istotnych” predyktorów zostawiła procedura
mean(wybrano > 0)         # odsetek badań z co najmniej jednym fałszywym predyktorem
Wynik w R
wybrano
  0   1   2   3   4   5
460 352 138  39  10   1
[1] 0.54
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Kolejność bloków ustalona po obejrzeniu wyników. Przestawianie bloków, aż „ulubiona” zmienna da istotne ΔR², to forma p-hackingu.
- Mylenie regresji hierarchicznej z metodą krokową albo z modelem wielopoziomowym. Pierwsza to plan badacza, druga – algorytm, trzecia – model dla danych zagnieżdżonych.
- Traktowanie ΔR² jak stałej „ważności” zmiennych. W przykładzie ten sam blok zasobów miał ΔR² = .064 albo .175 – zależnie od kolejności.
- Raportowanie tylko modelu końcowego. Bez R², ΔR² i testu F zmiany dla każdego kroku czytelnik nie wie, co wniosły kolejne bloki.
- Interpretowanie współczynników z wcześniejszych kroków jak ostatecznych. Współczynnik obciążenia pracą zmalał z 5.22 do 4.16 po dodaniu zasobów.
- Zbyt wiele kroków z pojedynczymi zmiennymi. Każdy krok to osobny test; gdy kroków jest dużo, rośnie ryzyko wyniku fałszywie dodatniego. Łącz zmienne w bloki odpowiadające hipotezom.
Najczęstsze pytania
Co to jest regresja hierarchiczna?
To regresja wieloraka, w której predyktory wprowadza się do modelu w kolejnych blokach, w kolejności wynikającej z teorii. Po każdym kroku sprawdza się, o ile wzrosło R² (ΔR²) i czy przyrost jest istotny w teście F zmiany. Odpowiada na pytanie, czy nowy zestaw zmiennych wyjaśnia wynik ponad zmienne wprowadzone wcześniej.
Czym różni się regresja hierarchiczna od regresji krokowej?
W regresji hierarchicznej kolejność bloków ustala badacz przed analizą, na podstawie teorii. W metodzie krokowej zmienne wybiera algorytm według wartości p w danej próbie, co zawyża istotność i daje słabo replikowalne modele (Thompson, 1995). W symulacji na tej stronie selekcja postępująca w 54% zbiorów danych bez żadnego związku „znalazła” istotny predyktor.
Jak interpretować ΔR² w regresji hierarchicznej?
ΔR² to odsetek wariancji zmiennej zależnej, który blok wyjaśnia ponad bloki wprowadzone wcześniej. W przykładzie ΔR² = .064 oznacza, że zasoby pracy wyjaśniły dodatkowe 6.4% wariancji wyczerpania przy kontroli wymagań, wieku i płci. Istotność przyrostu sprawdza test F zmiany; wartość ΔR² zależy od kolejności bloków.
W jakiej kolejności wprowadzać zmienne do regresji hierarchicznej?
Kolejność wynika z hipotezy i ustala się ją przed analizą. Najczęściej najpierw wprowadza się zmienne kontrolne (np. wiek, płeć), potem predyktory dobrze udokumentowane w literaturze, a na końcu zmienne, których dodatkowy wkład chcesz wykazać. Przy testowaniu interakcji najpierw wchodzą efekty główne, potem iloczyn.
Jak zrobić regresję hierarchiczną w SPSS?
W oknie Analiza → Regresja → Liniowa wprowadź pierwszy blok predyktorów, kliknij Następny (Next) i dodaj kolejny blok. W oknie Statystyki zaznacz Zmiana R kwadrat (R squared change). W tabeli Podsumowanie modelu odczytasz R², zmianę R² i test F zmiany dla każdego kroku.
Czy regresja hierarchiczna to to samo co model wielopoziomowy?
Nie. Regresja hierarchiczna dotyczy kolejności wprowadzania predyktorów do zwykłej regresji wielorakiej. Model wielopoziomowy (hierarchiczny model liniowy) służy do danych zagnieżdżonych, np. uczniów w klasach albo wielu pomiarów tej samej osoby, i uwzględnia zależność obserwacji w obrębie grup.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikRegresja hierarchiczna krok po kroku
Plan bloków, wspólna próba dla wszystkich kroków, ΔR² i test F zmiany, f², interakcja w ostatnim kroku i tabela APA – z pełnym przykładem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Heinze, G., Wallisch, C., & Dunkler, D. (2018). Variable selection – A review and recommendations for the practicing statistician. Biometrical Journal, 60(3), 431–449. https://doi.org/10.1002/bimj.201700067 ● Otwarty dostęp
- Petrocelli, J. V. (2003). Hierarchical multiple regression in counseling research: Common problems and possible remedies. Measurement and Evaluation in Counseling and Development, 36(1), 9–22. https://doi.org/10.1080/07481756.2003.12069076
- Smith, G. (2018). Step away from stepwise. Journal of Big Data, 5(1), Article 32. https://doi.org/10.1186/s40537-018-0143-6 ● Otwarty dostęp
- Thompson, B. (1995). Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial. Educational and Psychological Measurement, 55(4), 525–534. https://doi.org/10.1177/0013164495055004001
- Whittingham, M. J., Stephens, P. A., Bradbury, R. B., & Freckleton, R. P. (2006). Why do we still use stepwise modelling in ecology and behaviour? Journal of Animal Ecology, 75(5), 1182–1189. https://doi.org/10.1111/j.1365-2656.2006.01141.x ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{heinze2018variable, author={Heinze, Georg and Wallisch, Christine and Dunkler, Daniela}, title={{Variable selection – A review and recommendations for the practicing statistician}}, journal={Biometrical Journal}, year={2018}, volume={60}, number={3}, pages={431--449}, doi={10.1002/bimj.201700067}}@article{petrocelli2003hierarchical, author={Petrocelli, John V.}, title={{Hierarchical multiple regression in counseling research: Common problems and possible remedies}}, journal={Measurement and Evaluation in Counseling and Development}, year={2003}, volume={36}, number={1}, pages={9--22}, doi={10.1080/07481756.2003.12069076}}@article{smith2018step, author={Smith, Gary}, title={{Step away from stepwise}}, journal={Journal of Big Data}, year={2018}, volume={5}, number={1}, eid={32}, doi={10.1186/s40537-018-0143-6}}@article{thompson1995stepwise, author={Thompson, Bruce}, title={{Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial}}, journal={Educational and Psychological Measurement}, year={1995}, volume={55}, number={4}, pages={525--534}, doi={10.1177/0013164495055004001}}@article{whittingham2006why, author={Whittingham, Mark J. and Stephens, Philip A. and Bradbury, Richard B. and Freckleton, Robert P.}, title={{Why do we still use stepwise modelling in ecology and behaviour?}}, journal={Journal of Animal Ecology}, year={2006}, volume={75}, number={5}, pages={1182--1189}, doi={10.1111/j.1365-2656.2006.01141.x}}