Co to jest regresja wieloraka?
Regresja wieloraka (regresja wielokrotna, ang. multiple regression) to regresja liniowa z co najmniej dwoma predyktorami. Model opisuje średni wynik ilościowej zmiennej zależnej jako sumę wkładów kilku predyktorów, a każdy współczynnik pokazuje związek danego predyktora z wynikiem przy stałym poziomie pozostałych. Schober i Vetter (2021) opisują regresję liniową właśnie jako narzędzie do ilościowego opisu związku jednej lub wielu zmiennych niezależnych z ciągłą zmienną zależną.
W psychologii regresję wieloraką stosuje się z trzech powodów: by sprawdzić, czy predyktor wiąże się z wynikiem także po uwzględnieniu innych zmiennych (np. czy wsparcie społeczne wiąże się z mniejszym nasileniem objawów depresji niezależnie od ruminacji), by przewidywać wynik na podstawie kilku informacji naraz i by ocenić, ile wariancji wyjaśnia cały zestaw zmiennych. Model z jednym predyktorem to regresja prosta. Pełną analizę – od przygotowania danych przez diagnostykę po tabelę APA – pokazujemy w poradniku regresja wieloraka krok po kroku.
Wzór i współczynniki cząstkowe
- b0 – stała: przewidywany Y, gdy wszystkie predyktory są równe zero;
- bj – współczynnik cząstkowy: o ile zmienia się przewidywany Y, gdy Xj rośnie o jednostkę, a pozostałe predyktory mają te same wartości;
- e – błąd, czyli ta część wyniku, której predyktory nie wyjaśniają.
Współczynniki szacuje się metodą najmniejszych kwadratów. Kluczowe jest słowo „cząstkowy”: bj opiera się na tej części zmienności Xj, której nie da się przewidzieć z pozostałych predyktorów. Dlatego współczynnik zwykle się zmienia, gdy do modelu dołączy skorelowany z nim predyktor. Dla dwóch predyktorów widać to wprost we wzorze na współczynnik standaryzowany:
Gdy predyktory są nieskorelowane (r12 = 0), β1 równa się zwykłej korelacji rY1. Im silniej X1 i X2 są ze sobą powiązane, tym bardziej β1 odbiega od rY1. Bliskimi krewnymi współczynników cząstkowych są korelacja cząstkowa i korelacja semicząstkowa.
Cały model ocenia się za pomocą współczynnika determinacji R², czyli odsetka wariancji Y wyjaśnionego przez wszystkie predyktory razem, oraz testu F, który sprawdza, czy model wyjaśnia więcej niż sama średnia. Ponieważ R² rośnie po dodaniu każdego predyktora, obok niego podaje się R² skorygowane. Predyktory jakościowe (np. płeć, warunek eksperymentalny) wprowadza się jako zmienne zero-jedynkowe – zob. dummy coding.
Współczynniki b, β i sr² – co mówi każdy z nich
| Miara | Co mówi | Kiedy jej używać |
|---|---|---|
| b (niestandaryzowany) | Zmiana Y w jego jednostkach na 1 jednostkę predyktora, przy stałych pozostałych | Zawsze – to podstawowy wynik; podawaj go z 95% CI |
| β (standaryzowany) | Zmiana Y w odchyleniach standardowych na 1 SD predyktora (po standaryzacji) | Do porównania predyktorów mierzonych na różnych skalach w tym samym modelu |
| sr² (kwadrat korelacji semicząstkowej) | Jaką część wariancji Y wyjaśnia wyłącznie ten predyktor | Do oceny unikalnego wkładu; suma sr² jest mniejsza od R², gdy predyktory się pokrywają |
Nathans i in. (2012) przestrzegają przed opieraniem interpretacji wyłącznie na wagach β: przy skorelowanych predyktorach daje to ograniczony obraz ich znaczenia. Autorzy proponują zestawiać kilka uzupełniających się miar ważności – w praktyce studenckiej wystarczy pokazać obok siebie b z przedziałem ufności, β i sr².
Przykład: ruminacje, wsparcie i sen a objawy depresyjne
W badaniu 150 dorosłych (dane symulowane) zmierzono nasilenie objawów depresyjnych (0–60; M = 16.26, SD = 8.39), skłonność do ruminacji (22–88; M = 45.55, SD = 10.85), wsparcie społeczne (1–7; M = 5.11, SD = 1.11) i średni czas snu (M = 6.92 godziny, SD = 0.92). Objawy depresyjne korelowały z ruminacjami (r = .66), wsparciem (r = −.43) i snem (r = −.40). Predyktory były jednak powiązane także ze sobą: osoby o silniejszych ruminacjach miały mniejsze wsparcie (r = −.43) i krócej spały (r = −.41). Rysunek 1 porównuje współczynniki z trzech osobnych regresji prostych ze współczynnikami z jednej regresji wielorakiej.
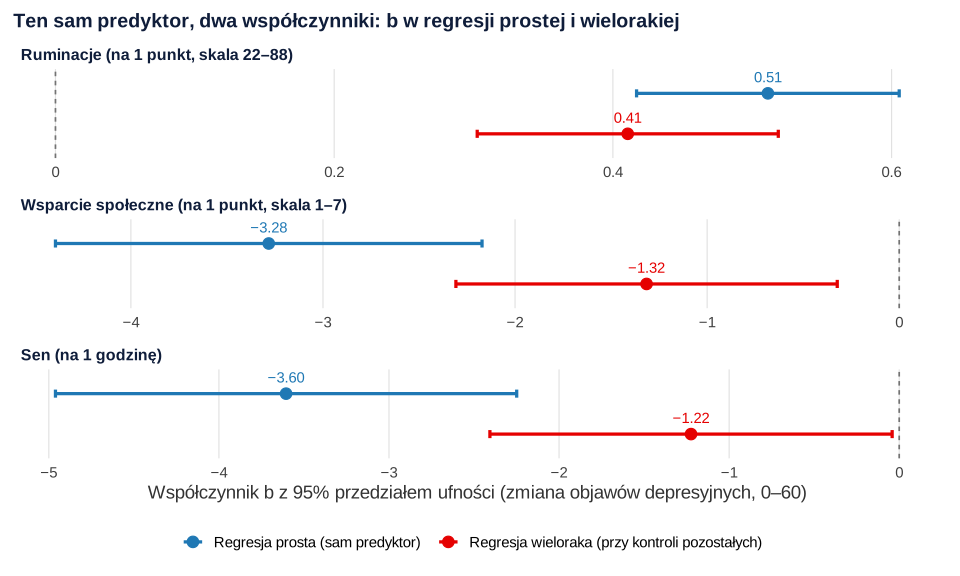
W regresjach prostych każda dodatkowa godzina snu wiązała się z wynikiem niższym o 3.60 punktu, a każdy punkt wsparcia – o 3.28 punktu. W regresji wielorakiej te współczynniki zmalały o 66% i 60%, do −1.22 i −1.32, bo część związku snu i wsparcia z objawami pokrywa się ze związkiem ruminacji z objawami. Współczynnik ruminacji zmalał mniej: z 0.51 do 0.41 (o 20%). To samo widać w R²: osobno predyktory wyjaśniały 44%, 19% i 16% wariancji, a razem nie 78%, lecz 48%. Wzór na β pokazuje ten mechanizm na liczbach: w modelu z samymi ruminacjami i wsparciem β ruminacji wynosi (.66 − (−.43) × (−.43)) / (1 − .43²) = .58, czyli mniej niż korelacja .66.
| Predyktor | b | 95% CI dla b | β | t(146) | p |
|---|---|---|---|---|---|
| Stała | 12.75 | [0.14, 25.35] | — | 2.00 | .048 |
| Ruminacje | 0.41 | [0.30, 0.52] | 0.53 | 7.51 | < .001 |
| Wsparcie społeczne | −1.32 | [−2.31, −0.32] | −0.17 | −2.62 | .010 |
| Sen (godziny) | −1.22 | [−2.41, −0.04] | −0.13 | −2.05 | .043 |
Model wyjaśniał 48% wariancji objawów, R² = .48, skorygowane R² = .47, F(3, 146) = 44.85, p < .001. Interpretacja współczynnika ruminacji brzmi: dwie osoby o takim samym wsparciu (5 punktów) i śnie (7 godzin), z których jedna ma 40, a druga 60 punktów ruminacji, mają przewidywane wyniki 14.03 i 22.24 punktu. Według β najsilniej z objawami wiążą się ruminacje (β = 0.53), a wsparcie i sen mają mniejsze, choć istotne współczynniki cząstkowe.
Założenia i liczebność próby
Regresję wieloraką obowiązują te same założenia co regresję prostą: liniowość, niezależność obserwacji, stała wariancja i – w małych próbach – normalność reszt, a nie samych zmiennych (Williams i in., 2013). Dochodzą do nich dwie kwestie typowe dla wielu predyktorów:
- Współliniowość. Silnie skorelowane predyktory zawyżają wariancje współczynników, przez co wartości p i przedziały ufności stają się niewiarygodne. Kim (2019) jako sygnał problemu podaje VIF powyżej 5–10. W przykładzie VIF nie przekraczał 1.40.
- Liczebność próby. W symulacjach Austina i Steyerberga (2015) do trafnego oszacowania współczynników, ich błędów standardowych i przedziałów ufności wystarczały około dwie obserwacje na predyktor, ale nieobciążone R² wymagało znacznie więcej osób. To dolna granica precyzji, a nie liczebność zapewniająca odpowiednią moc testu – tę zaplanuj osobno (zob. dobór liczebności próby).
Sprawdź też, czy wyniku nie wyznacza kilka nietypowych osób (odległość Cooka). Gdy predyktory dodajesz zgodnie z teorią w kolejnych blokach i chcesz wiedzieć, ile wyjaśnia każdy blok, zastosuj regresję hierarchiczną.
Jak opisać regresję wieloraką w pracy (APA)
Podaj R², skorygowane R² i test F modelu, a dla każdego predyktora b z 95% CI, β i p. Dodaj zdanie o diagnostyce. Wzór dla przykładu:
Przy trzech i więcej predyktorach zbierz wyniki w tabeli – wzór z notą znajdziesz w haśle tabela regresji w APA.
Przykład w R
Kod tworzy dane z przykładu, liczy trzy regresje proste i regresję wieloraką, współczynniki β, VIF oraz przewidywane wyniki dwóch osób różniących się ruminacjami. Liczby w tekście, tabeli i na rysunku pochodzą z tego kodu.
Regresje proste a regresja wieloraka
R
library(effectsize)   # standardize_parameters()
library(car)          # vif()

# Dane symulowane: 150 dorosłych – objawy depresyjne (0–60), ruminacje (22–88),
# wsparcie społeczne (1–7) i średni czas snu (godziny)
set.seed(315)
n <- 150
z_rum <- rnorm(n)
z_wsp <- -0.45 * z_rum + sqrt(1 - 0.45^2) * rnorm(n)
z_sen <- -0.25 * z_rum + 0.10 * z_wsp + sqrt(1 - 0.25^2 - 0.1^2) * rnorm(n)
ruminacje <- pmin(pmax(round(46 + 11 * z_rum), 22), 88)
wsparcie  <- pmin(pmax(round((5.1 + 1.1 * z_wsp) * 12) / 12, 1), 7)
sen       <- pmin(pmax(round((6.8 + 0.9 * z_sen) * 4) / 4, 4), 9.5)
depresja  <- 17 + 0.42 * (ruminacje - 46) - 1.2 * (wsparcie - 5.1) -
  1.3 * (sen - 6.8) + rnorm(n, sd = 7)
depresja  <- pmin(pmax(round(depresja), 0), 60)
dane <- data.frame(depresja, ruminacje, wsparcie, sen)
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane), 2)

# Trzy regresje proste – każdy predyktor osobno
round(sapply(c("ruminacje", "wsparcie", "sen"),
             function(v) unname(coef(lm(reformulate(v, "depresja"), data = dane))[2])), 2)

# Regresja wieloraka – wszystkie predyktory naraz
model <- lm(depresja ~ ruminacje + wsparcie + sen, data = dane)
summary(model)
round(confint(model), 2)
standardize_parameters(model)   # β
vif(model)

# Przewidywanie: dwie osoby różniące się tylko ruminacjami (40 i 60 punktów)
round(predict(model, data.frame(ruminacje = c(40, 60), wsparcie = 5, sen = 7)), 2)
Wynik w R
Loading required package: carData
   depresja ruminacje wsparcie  sen
M     16.26     45.55     5.11 6.92
SD     8.39     10.85     1.11 0.92
          depresja ruminacje wsparcie   sen
depresja      1.00      0.66    -0.43 -0.40
ruminacje     0.66      1.00    -0.43 -0.41
wsparcie     -0.43     -0.43     1.00  0.24
sen          -0.40     -0.41     0.24  1.00
ruminacje  wsparcie       sen
     0.51     -3.28     -3.60

Call:
lm(formula = depresja ~ ruminacje + wsparcie + sen, data = dane)

Residuals:
    Min      1Q  Median      3Q     Max
-16.101  -3.964  -1.123   4.452  18.224

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 12.74794    6.37829   1.999  0.04750 *
ruminacje    0.41067    0.05466   7.513 5.32e-12 ***
wsparcie    -1.31528    0.50230  -2.619  0.00976 **
sen         -1.22410    0.59833  -2.046  0.04257 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 6.115 on 146 degrees of freedom
Multiple R-squared:  0.4796,	Adjusted R-squared:  0.4689
F-statistic: 44.85 on 3 and 146 DF,  p-value: < 2.2e-16

            2.5 % 97.5 %
(Intercept)  0.14  25.35
ruminacje    0.30   0.52
wsparcie    -2.31  -0.32
sen         -2.41  -0.04
# Standardization method: refit

Parameter   | Std. Coef. |         95% CI
-----------------------------------------
(Intercept) |   1.99e-16 | [-0.12,  0.12]
ruminacje   |       0.53 | [ 0.39,  0.67]
wsparcie    |      -0.17 | [-0.30, -0.04]
sen         |      -0.13 | [-0.26,  0.00]
ruminacje  wsparcie       sen
 1.401764  1.230921  1.214797
    1     2
14.03 22.24
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Pomijanie dopisku „przy kontroli pozostałych”. Współczynnik z modelu wielorakiego to nie to samo co związek „surowy”: w przykładzie wsparcie miało b = −3.28 w regresji prostej i −1.32 w wielorakiej.
- Porównywanie b predyktorów mierzonych na różnych skalach. Punkt ruminacji i godzina snu to inne jednostki. Do porównań używaj β lub sr² – i nie traktuj kolejności β jako rozstrzygającej (Nathans i in., 2012).
- „Predyktor przestał być istotny, więc nie ma związku”. Brak istotności w modelu wielorakim oznacza tylko, że predyktor nie wnosi w tej próbie istotnego wkładu ponad pozostałe; jego zwykła korelacja z wynikiem nadal może być wyraźna.
- Dobór predyktorów metodą krokową. Automatyczne dodawanie i usuwanie zmiennych według p dopasowuje model do przypadkowych cech próby – zob. metoda krokowa. Predyktory wybieraj na podstawie teorii.
- Zbyt wiele predyktorów w małej próbie. Model z dziesięcioma predyktorami na 40 osobach daje szerokie przedziały ufności, testy o małej mocy i wyraźnie zawyżone R².
- Język przyczynowy. Statystyczna kontrola zmiennych nie zastępuje eksperymentu: niezmierzona zmienna zakłócająca może tłumaczyć zarówno predyktor, jak i wynik.
Najczęstsze pytania
Co to jest regresja wieloraka?
To regresja liniowa z co najmniej dwoma predyktorami. Model przewiduje średni wynik zmiennej zależnej na podstawie kilku zmiennych naraz, a każdy współczynnik b opisuje związek predyktora z wynikiem przy stałych wartościach pozostałych predyktorów. Dopasowanie całego modelu opisuje R².
Czym różni się regresja wieloraka od regresji prostej?
Regresja prosta ma jeden predyktor, a jej nachylenie opisuje związek „surowy”. W regresji wielorakiej współczynniki są cząstkowe – uwzględniają, że predyktory są ze sobą skorelowane. W przykładzie z tej strony współczynnik wsparcia społecznego wynosił −3.28 w regresji prostej i −1.32 w regresji wielorakiej.
Co znaczy „przy kontroli pozostałych zmiennych” w regresji?
Że współczynnik predyktora porównuje osoby, które mają takie same wartości pozostałych predyktorów w modelu. Statystycznie bj opiera się na tej części zmienności predyktora, której nie da się przewidzieć z pozostałych predyktorów. Kontrola obejmuje tylko zmienne uwzględnione w modelu – nie zastępuje eksperymentu.
Ile obserwacji na jeden predyktor potrzeba w regresji wielorakiej?
Zależy to od oczekiwanej wielkości efektu i liczby predyktorów, dlatego liczebność najlepiej wyznaczyć analizą mocy, np. w G*Power. Symulacje Austina i Steyerberga (2015) pokazują, że około dwie obserwacje na predyktor wystarczają do trafnego oszacowania samych współczynników, ale to nie gwarantuje wystarczającej mocy testów ani nieobciążonego R².
Czy w regresji wielorakiej można użyć zmiennej jakościowej?
Tak. Zmienną o dwóch kategoriach koduje się jako 0 i 1, a zmienną o k kategoriach – jako k − 1 zmiennych zero-jedynkowych z jedną kategorią odniesienia (dummy coding). Współczynnik takiej zmiennej to różnica średnich między kategorią a grupą odniesienia przy stałych pozostałych predyktorach.
Jak zrobić regresję wieloraką w SPSS?
Wybierz Analiza → Regresja → Liniowa (Analyze → Regression → Linear), wskaż zmienną zależną i wszystkie predyktory, metoda: Wprowadzania (Enter). W oknie Statystyki zaznacz przedziały ufności, dopasowanie modelu, korelacje cząstkowe i semicząstkowe oraz diagnostykę współliniowości. Współczynniki b i β odczytasz w tabeli Współczynniki.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka w obrazkach
Wykres zmiennej dodanej, zmiana znaku współczynnika, elipsa ufności przy współliniowości i ten sam predyktor w pięciu modelach – „kontrolując” na rysunkach z R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikStatystyka do pracy magisterskiej
Plan analiz, CFA i omega, regresja hierarchiczna, moderacja i mediacja z bootstrapem, wzory opisu APA i pytania na obronie – z danymi i kodem R.
Czytaj →PoradnikIle predyktorów w regresji?
Reguła 10 zdarzeń na predyktor i jej słabości, minimalna liczebność według Rileya i in., regresja liniowa i logistyczna oraz symulacja przeuczenia w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C., & Steyerberg, E. W. (2015). The number of subjects per variable required in linear regression analyses. Journal of Clinical Epidemiology, 68(6), 627–636. https://doi.org/10.1016/j.jclinepi.2014.12.014 ● Otwarty dostęp
- Kim, J. H. (2019). Multicollinearity and misleading statistical results. Korean Journal of Anesthesiology, 72(6), 558–569. https://doi.org/10.4097/kja.19087 ● Otwarty dostęp
- Nathans, L. L., Oswald, F. L., & Nimon, K. (2012). Interpreting multiple linear regression: A guidebook of variable importance. Practical Assessment, Research, and Evaluation, 17, Article 9. https://doi.org/10.7275/5fex-b874 ● Otwarty dostęp: pełny tekst
- Schober, P., & Vetter, T. R. (2021). Linear regression in medical research. Anesthesia & Analgesia, 132(1), 108–109. https://doi.org/10.1213/ANE.0000000000005206 ● Otwarty dostęp
- Williams, M. N., Grajales, C. A. G., & Kurkiewicz, D. (2013). Assumptions of multiple regression: Correcting two misconceptions. Practical Assessment, Research, and Evaluation, 18, Article 11. https://doi.org/10.7275/55hn-wk47 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{austin2015number, author={Austin, Peter C. and Steyerberg, Ewout W.}, title={{The number of subjects per variable required in linear regression analyses}}, journal={Journal of Clinical Epidemiology}, year={2015}, volume={68}, number={6}, pages={627--636}, doi={10.1016/j.jclinepi.2014.12.014}}@article{kim2019multicollinearity, author={Kim, Jong Hae}, title={{Multicollinearity and misleading statistical results}}, journal={Korean Journal of Anesthesiology}, year={2019}, volume={72}, number={6}, pages={558--569}, doi={10.4097/kja.19087}}@article{nathans2012interpreting, author={Nathans, Laura L. and Oswald, Frederick L. and Nimon, Kim}, title={{Interpreting multiple linear regression: A guidebook of variable importance}}, journal={Practical Assessment, Research, and Evaluation}, year={2012}, volume={17}, eid={9}, doi={10.7275/5fex-b874}}@article{schober2021linear, author={Schober, Patrick and Vetter, Thomas R.}, title={{Linear regression in medical research}}, journal={Anesthesia \& Analgesia}, year={2021}, volume={132}, number={1}, pages={108--109}, doi={10.1213/ane.0000000000005206}}@article{williams2013assumptions, author={Williams, Matt N. and Grajales, Carlos A. G. and Kurkiewicz, Dason}, title={{Assumptions of multiple regression: Correcting two misconceptions}}, journal={Practical Assessment, Research, and Evaluation}, year={2013}, volume={18}, eid={11}, doi={10.7275/55hn-wk47}}