Co to jest regresja logistyczna?
Regresja logistyczna (ang. logistic regression) to model, który przewiduje prawdopodobieństwo jednego z dwóch wyników – na przykład tego, czy student zgłosi się po pomoc psychologiczną, zda egzamin albo przerwie terapię. Zmienna zależna jest dychotomiczna i kodowana jako 0 i 1, a predyktory mogą być ilościowe lub jakościowe. Sperandei (2014) opisuje ją jako sposób na uzyskanie ilorazów szans przy kilku zmiennych objaśniających jednocześnie: każdy współczynnik pokazuje związek predyktora z wynikiem przy uwzględnieniu pozostałych zmiennych w modelu.
Dlaczego nie zwykła regresja liniowa? Prosta dopasowana do wyników 0/1 przewiduje dla części osób „prawdopodobieństwa” poniżej zera albo powyżej jedności. W regresji logistycznej przewidywania zawsze mieszczą się między 0 a 1, a zależność ma kształt litery S. To hasło wyjaśnia logikę modelu i interpretację wyników; założenia, diagnostykę i kalibrację omawia poradnik regresja logistyczna: założenia, interpretacja i raportowanie modelu.
Model: logit, szanse i prawdopodobieństwo
Model nie opisuje prawdopodobieństwa wprost, tylko jego logit, czyli logarytm naturalny szans. Szansa to prawdopodobieństwo zdarzenia podzielone przez prawdopodobieństwo jego niezajścia (Bland i Altman, 2000): przy prawdopodobieństwie 20% szansa wynosi 20/80 = 0.25.
- π – prawdopodobieństwo wyniku zakodowanego jako 1 (np. „zgłosił się po pomoc”),
- π / (1 − π) – szansa (ang. odds) tego wyniku,
- b1 … bk – współczynniki (w SPSS kolumna B): zmiana logitu, gdy predyktor rośnie o jednostkę, a pozostałe są stałe; eb to iloraz szans (OR).
Współczynniki szacuje się metodą największej wiarygodności: program szuka takich b, przy których zaobserwowane zera i jedynki są najbardziej prawdopodobne. Ten sam efekt można opisać na trzech skalach, które zachowują się inaczej:
| Skala | Co mówi | Jak zmienia się wraz z predyktorem |
|---|---|---|
| Logit (b) | Zmiana logarytmu szans | Liniowo – o b na każdą jednostkę predyktora |
| Szansa (OR = eb) | Ile razy rosną lub maleją szanse | Mnożnikowo – ten sam iloraz szans na każdą jednostkę |
| Prawdopodobieństwo | Jaki odsetek osób ma wynik 1 | Nieliniowo – zmiana zależy od punktu wyjścia |
Przykład: kto zgłasza się po pomoc psychologiczną?
W badaniu 320 studentów (dane symulowane) sprawdzono, czy w ciągu semestru zgłosili się do akademickiego centrum wsparcia psychologicznego (1 = tak, 0 = nie). Predyktorami były: nasilenie objawów depresyjnych (0–27 pkt; M = 9.23, SD = 4.90), samostygmatyzacja związana z szukaniem pomocy (1–5; M = 2.90, SD = 0.78) oraz wcześniejszy kontakt z psychologiem (94 osoby, 29.4%). Po pomoc zgłosiło się 115 osób (35.9%): 55.3% osób z wcześniejszym kontaktem i 27.9% osób bez niego.
Dopasowany model ma postać:
| Predyktor | b | SE | z | p | OR | 95% CI dla OR |
|---|---|---|---|---|---|---|
| Stała | −0.24 | 0.53 | −0.44 | .659 | 0.79 | [0.28, 2.25] |
| Objawy depresyjne (pkt) | 0.11 | 0.03 | 4.15 | < .001 | 1.12 | [1.06, 1.18] |
| Samostygmatyzacja (1–5) | −0.61 | 0.17 | −3.59 | < .001 | 0.54 | [0.39, 0.76] |
| Wcześniejszy kontakt (1 = tak) | 1.12 | 0.27 | 4.13 | < .001 | 3.06 | [1.80, 5.20] |
Jak czytać współczynniki? Każdy dodatkowy punkt objawów mnoży szanse zgłoszenia się po pomoc przez 1.12, czyli zwiększa je o 12% – przy tej samej stygmatyzacji i historii kontaktu. Dla różnicy 5 punktów iloraz szans wynosi e5 × 0.112 = 1.75. Wzrost samostygmatyzacji o punkt zmniejsza szanse o 46% (OR = 0.54), a osoby, które już kiedyś były u psychologa, mają szanse około trzy razy większe niż osoby bez takiego doświadczenia (OR = 3.06). Przedział ufności dla OR nieobejmujący 1 odpowiada istotnemu wynikowi testu Walda (p < .05). Predyktory na różnych skalach porównuj we wspólnych jednostkach, np. na jedno odchylenie standardowe: dla objawów OR = 1.73, dla stygmatyzacji OR = 0.62.
Iloraz szans jest stały, ale zmiana prawdopodobieństwa – nie. Dla osoby bez wcześniejszego kontaktu i z przeciętną stygmatyzacją przewidywane prawdopodobieństwo rośnie z 18.9% przy 5 punktach objawów do 28.9% przy 10 punktach (o 10.0 punktu procentowego), ale z 41.6% przy 15 punktach do 55.4% przy 20 punktach (o 13.9 punktu procentowego) – choć w obu przypadkach OR = 1.75. Dlatego obok ilorazów szans pokaż przewidywane prawdopodobieństwa, najlepiej na wykresie.
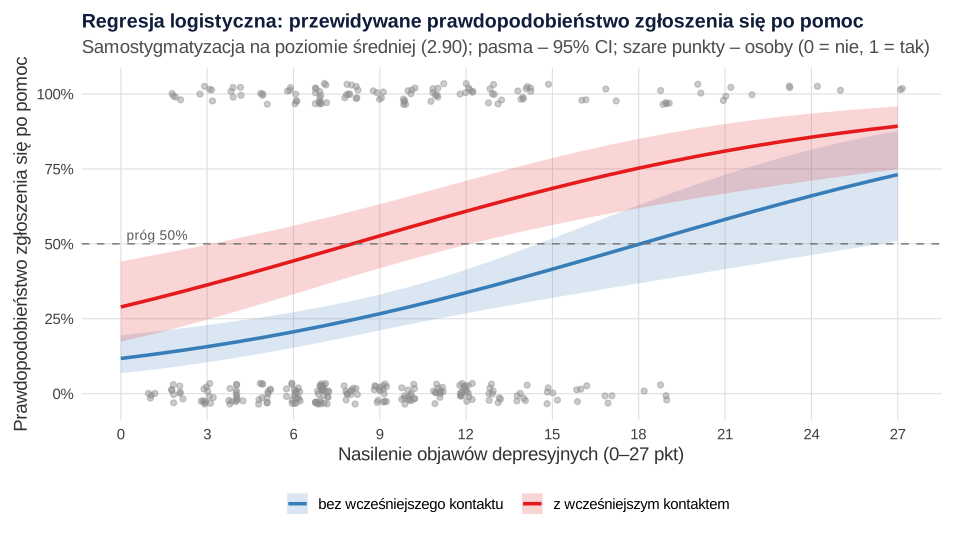
Krzywe rosną najszybciej w okolicy 50% i spłaszczają się przy krańcach skali. Przewidywane prawdopodobieństwo przekracza 50% przy około 18 punktach objawów u osób bez wcześniejszego kontaktu i już przy około 8 punktach u osób z takim kontaktem. Pasma ufności rozszerzają się po prawej stronie, bo osób z bardzo nasilonymi objawami było niewiele.
Dopasowanie modelu: test ilorazu wiarygodności i pseudo-R²
O tym, czy predyktory razem poprawiają przewidywanie, mówi test ilorazu wiarygodności (ang. likelihood ratio test). Porównuje dewiancję (−2 × logarytm wiarygodności) modelu zawierającego tylko stałą z dewiancją modelu z predyktorami; różnica ma w przybliżeniu rozkład χ² z liczbą stopni swobody równą liczbie dodanych parametrów. W przykładzie dewiancja spadła z 417.96 do 366.60, χ²(3) = 51.36, p < .001. Tak samo porównuje się modele zagnieżdżone, np. przed dodaniem bloku predyktorów i po nim (regresja hierarchiczna).
W regresji logistycznej nie ma R² rozumianego jako odsetek wyjaśnionej wariancji. Programy podają pseudo-R² – miary oparte na wiarygodności, które dla tego samego modelu dają różne liczby. W przykładzie R² McFaddena wynosi .12, Coxa i Snella – .15, a Nagelkerkego – .20. Menard (2000) pokazał, że takie współczynniki w różnym stopniu zależą od częstości wyniku, a wnioski z nich nie muszą się zgadzać z ocenami trafności przewidywań. Traktuj pseudo-R² pomocniczo, podawaj nazwę miary i nie pisz o „procencie wyjaśnionej wariancji”.
Klasyfikacja, krzywa ROC i kalibracja
Przewidywane prawdopodobieństwa można zamienić na prognozy 0/1, przyjmując próg – domyślnie 50%. W przykładzie model poprawnie zaklasyfikował 70.9% osób, ale prognoza „nikt nie zgłosi się po pomoc” dałaby 64.1% trafień. Model rozpoznał 40.9% osób, które zgłosiły się po pomoc (czułość), i 87.8% pozostałych (swoistość). Jak czytać te liczby i jak próg zmienia proporcję trafień do fałszywych alarmów, pokazuje hasło macierz pomyłek.
Ocenę niezależną od progu daje pole pod krzywą ROC: AUC = .72, 95% CI [.66, .78]. Oznacza to, że w około 72% par „osoba, która zgłosiła się po pomoc – osoba, która tego nie zrobiła” model przypisuje wyższe prawdopodobieństwo tej pierwszej. W modelach predykcyjnych sprawdza się też kalibrację, czyli zgodność przewidywanych prawdopodobieństw z obserwowanymi częstościami (zob. poradnik o regresji logistycznej).
Założenia w skrócie
- Niezależność obserwacji – przy pomiarach powtarzanych lub osobach zagnieżdżonych w grupach potrzebny jest model wielopoziomowy.
- Liniowość logitu dla predyktorów ilościowych – liniowo ma się zmieniać logit, a nie prawdopodobieństwo.
- Brak silnej współliniowości predyktorów (sprawdzisz ją m.in. współczynnikiem VIF).
- Wystarczająco dużo zdarzeń – liczy się liczebność mniej licznej kategorii wyniku. Popularna reguła „10 zdarzeń na predyktor” ma słabe uzasadnienie: van Smeden i in. (2016) pokazali, że problemy małych prób zależą też od całkowitej liczebności i od separacji. W przykładzie na każdy predyktor przypada ponad 38 zdarzeń.
- Brak separacji – gdy predyktor idealnie rozdziela zera i jedynki, oszacowania i błędy standardowe gwałtownie rosną; pomaga wtedy np. korekta Firtha (van Smeden i in., 2016).
Jak opisać regresję logistyczną w pracy (APA)
Peng i in. (2002) opracowali wytyczne raportowania regresji logistycznej: jakie tabele i wykresy pokazać, jakie założenia sprawdzić i jaka ma być minimalna liczba obserwacji na predyktor. Podaj kodowanie wyniku i liczebności obu kategorii, test χ² modelu, nazwaną miarę pseudo-R², OR z 95% CI i p dla każdego predyktora oraz AUC. Wzór dla przykładu:
Pełny zestaw współczynników (b, SE, Wald, p, OR, 95% CI) umieść w tabeli – wzór z notą znajdziesz w haśle tabela regresji logistycznej w APA, a gotowe zdania do innych analiz w poradniku jak opisać wyniki w stylu APA.
Przykład w R
Kod tworzy dane z przykładu, szacuje model funkcją glm() i liczy wszystkie wartości podane w tekście. W SPSS: Analiza → Regresja → Logistyczna (pomoc jako zmienna zależna, pozostałe jako współzmienne; w Opcjach zaznacz przedział ufności dla Exp(B)). Test χ² modelu znajdziesz w tabeli „Testy zbiorcze współczynników modelu”, pseudo-R² – w „Podsumowaniu modelu”, a współczynniki – w tabeli „Zmienne w równaniu” (statystyka Walda to z², np. 4.147² = 17.19).
Regresja logistyczna z ilorazami szans i oceną modelu
R
# Czy student zgłosi się po pomoc psychologiczną? Dane symulowane, N = 320
set.seed(7)
n <- 320
objawy  <- pmin(27, round(rgamma(n, shape = 3, scale = 3)))      # objawy depresyjne, 0–27 pkt
stygmat <- pmin(5, pmax(1, round(rnorm(n, 2.9, 0.8), 1)))         # samostygmatyzacja, 1–5
kontakt <- rbinom(n, 1, 0.3)                                      # wcześniej u psychologa: 1 = tak
pomoc   <- rbinom(n, 1, plogis(-2.4 + 0.15 * objawy - 0.8 * (stygmat - 3) + 0.9 * kontakt))
dane <- data.frame(pomoc, objawy, stygmat, kontakt)
table(dane$pomoc)                                                 # 1 = zgłosił(a) się po pomoc

model <- glm(pomoc ~ objawy + stygmat + kontakt, family = binomial, data = dane)
summary(model)                                                    # B, SE, z (Wald), p
round(exp(cbind(OR = coef(model), confint.default(model))), 2)    # ilorazy szans z 95% CI (Walda)
round(exp(5 * coef(model)["objawy"]), 2)                          # OR dla 5 punktów objawów

# Test ilorazu wiarygodności: model z predyktorami a model zerowy
model0 <- glm(pomoc ~ 1, family = binomial, data = dane)
anova(model0, model, test = "LRT")

# Pseudo-R²: McFadden, Cox i Snell, Nagelkerke
LR <- model$null.deviance - model$deviance
round(c(McFadden   = 1 - model$deviance / model$null.deviance,
        CoxSnell   = 1 - exp(-LR / n),
        Nagelkerke = (1 - exp(-LR / n)) / (1 - exp(-model$null.deviance / n))), 3)

# Przewidywane prawdopodobieństwo dla osoby bez wcześniejszego kontaktu i z przeciętną stygmatyzacją
nowe <- data.frame(objawy = c(5, 10, 15, 20), stygmat = mean(dane$stygmat), kontakt = 0)
round(predict(model, newdata = nowe, type = "response"), 3)

# Klasyfikacja przy progu 50% i dyskryminacja (pole pod krzywą ROC)
table(Prognoza = as.integer(fitted(model) >= 0.5), Rzeczywistosc = dane$pomoc)
suppressPackageStartupMessages(library(pROC))
roc_m <- roc(dane$pomoc, fitted(model), levels = c(0, 1), direction = "<", quiet = TRUE)
round(as.numeric(ci.auc(roc_m)), 3)          # dolna granica 95% CI, AUC, górna granica (metoda DeLonga)
Wynik w R
  0   1
205 115

Call:
glm(formula = pomoc ~ objawy + stygmat + kontakt, family = binomial,
    data = dane)

Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept) -0.23571    0.53339  -0.442 0.658553
objawy       0.11171    0.02694   4.147 3.38e-05 ***
stygmat     -0.61443    0.17110  -3.591 0.000329 ***
kontakt      1.11831    0.27058   4.133 3.58e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 417.96  on 319  degrees of freedom
Residual deviance: 366.60  on 316  degrees of freedom
AIC: 374.6

Number of Fisher Scoring iterations: 4

              OR 2.5 % 97.5 %
(Intercept) 0.79  0.28   2.25
objawy      1.12  1.06   1.18
stygmat     0.54  0.39   0.76
kontakt     3.06  1.80   5.20
objawy
  1.75
Analysis of Deviance Table

Model 1: pomoc ~ 1
Model 2: pomoc ~ objawy + stygmat + kontakt
  Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1       319     417.96
2       316     366.60  3    51.36  4.1e-11 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  McFadden   CoxSnell Nagelkerke
     0.123      0.148      0.203
    1     2     3     4
0.189 0.289 0.416 0.554
        Rzeczywistosc
Prognoza   0   1
       0 180  68
       1  25  47
[1] 0.662 0.722 0.782
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (model: pakiet stats); AUC policzono w pakiecie pROC, a rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Iloraz szans czytany jak ryzyko względne. Zdanie „kontakt z psychologiem zwiększa prawdopodobieństwo 3 razy” jest błędne. Surowe odsetki zgłoszeń wynosiły 55.3% i 27.9%, więc prawdopodobieństwo było 1.98 raza większe, choć iloraz szans dla tych samych odsetków to 3.20 (zob. iloraz szans).
- Porównywanie OR między modelami lub grupami. Ilorazy szans zmieniają się po dodaniu predyktora nawet wtedy, gdy nowa zmienna nie jest skorelowana z dotychczasowymi, bo odzwierciedlają też nieobserwowaną heterogeniczność (Mood, 2010). Spadek OR po dodaniu zmiennej kontrolnej nie musi więc oznaczać, że efekt został „wyjaśniony”.
- Pseudo-R² jako odsetek wyjaśnionej wariancji albo podany bez nazwy miary – McFadden, Cox i Snell oraz Nagelkerke dają różne wartości (Menard, 2000).
- Brak informacji o kodowaniu. Bez opisu, która kategoria wyniku to 1 i która kategoria predyktora jest odniesieniem (dummy coding), nie wiadomo, czy OR = 3.06 i OR = 0.33 to różne wyniki, czy ten sam.
- Dychotomizacja wyniku ilościowego tylko po to, by użyć regresji logistycznej – traci się informację. Dla wyniku porządkowego lepsza bywa regresja porządkowa, a dla liczby zdarzeń – regresja Poissona.
- Język przyczynowy w badaniu korelacyjnym – OR opisuje związek, a nie skutek zmiany predyktora.
Najczęstsze pytania
Co to jest regresja logistyczna?
To model statystyczny dla zmiennej zależnej o dwóch kategoriach (np. zgłosił się po pomoc: tak/nie). Opisuje logarytm szans wyniku jako liniową funkcję predyktorów, dzięki czemu przewidywane prawdopodobieństwa zawsze mieszczą się między 0 a 1. Wyniki podaje się zwykle jako ilorazy szans z 95% przedziałami ufności.
Jak zamienić współczynnik b z regresji logistycznej na iloraz szans?
Exp(b) to iloraz szans (OR): mówi, ile razy zmieniają się szanse wyniku, gdy predyktor rośnie o jednostkę, a pozostałe zmienne są stałe. OR = 1.12 oznacza szanse większe o 12% na każdy punkt, a OR = 0.54 – mniejsze o 46%. OR nie mówi, ile razy rośnie prawdopodobieństwo; zmianę prawdopodobieństwa pokaż osobno, np. na wykresie przewidywanych wartości.
Czym różni się regresja logistyczna od liniowej?
Regresja liniowa przewiduje średnią zmiennej ilościowej i szacuje się ją metodą najmniejszych kwadratów. Regresja logistyczna przewiduje prawdopodobieństwo wyniku 0/1 przez logit, a współczynniki szacuje metodą największej wiarygodności. Zamiast testu F i R² stosuje się test ilorazu wiarygodności (χ²) i miary pseudo-R².
Które pseudo-R² podać w regresji logistycznej?
Najczęściej podaje się R² Nagelkerkego (jest w SPSS) albo McFaddena. Różne miary dają dla tego samego modelu różne liczby – w przykładzie z tego hasła od .12 do .20 – więc zawsze podawaj nazwę miary i nie interpretuj jej jako odsetka wyjaśnionej wariancji.
Ile osób potrzeba do regresji logistycznej?
Liczy się przede wszystkim liczba osób w mniej licznej kategorii wyniku, a nie sama liczebność próby. Popularna reguła 10 zdarzeń na predyktor jest tylko orientacyjna: van Smeden i in. (2016) pokazali, że jej uzasadnienie jest słabe, a problemy małych prób zależą też od całkowitej liczebności i od separacji danych.
Jak zrobić regresję logistyczną w SPSS?
Wybierz Analiza → Regresja → Logistyczna, wpisz wynik 0/1 jako zmienną zależną, a predyktory jako współzmienne (jakościowe oznacz w oknie Kategorialne). W Opcjach zaznacz przedział ufności dla Exp(B). Odczytaj test χ² z tabeli „Testy zbiorcze współczynników modelu”, pseudo-R² z „Podsumowania modelu” i OR z tabeli „Zmienne w równaniu”.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja logistyczna w obrazkach
Prosta MNK na 0/1, krzywa S, logit a prawdopodobieństwo, interakcja w dwóch skalach i separacja – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikRegresja logistyczna – zadania z rozwiązaniami
Dziesięć zadań: szansa i logit, iloraz szans z tabeli i z modelu, prawdopodobieństwo dla osoby, wydruk glm, kontrola zmiennej, klasyfikacja, AUC, pseudo-R² i LRT – krok po kroku.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikWielomianowa regresja logistyczna
Kategoria odniesienia, RRR, test predyktorów, prawdopodobieństwa przewidywane, założenie IIA i tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikIle predyktorów w regresji?
Reguła 10 zdarzeń na predyktor i jej słabości, minimalna liczebność według Rileya i in., regresja liniowa i logistyczna oraz symulacja przeuczenia w R.
Czytaj →PoradnikPrognoza upadłości firm – regresja logistyczna
1500 firm transportowych: winsoryzacja wskaźników, ilorazy szans, walidacja w czasie, AUC i kalibracja oraz złudna trafność – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bland, J. M., & Altman, D. G. (2000). Statistics notes: The odds ratio. BMJ, 320(7247), 1468. https://doi.org/10.1136/bmj.320.7247.1468 ● Otwarty dostęp: pełny tekst
- Menard, S. (2000). Coefficients of determination for multiple logistic regression analysis. The American Statistician, 54(1), 17–24. https://doi.org/10.1080/00031305.2000.10474502
- Mood, C. (2010). Logistic regression: Why we cannot do what we think we can do, and what we can do about it. European Sociological Review, 26(1), 67–82. https://doi.org/10.1093/esr/jcp006 ● Otwarty dostęp: pełny tekst
- Peng, C.-Y. J., Lee, K. L., & Ingersoll, G. M. (2002). An introduction to logistic regression analysis and reporting. The Journal of Educational Research, 96(1), 3–14. https://doi.org/10.1080/00220670209598786
- Sperandei, S. (2014). Understanding logistic regression analysis. Biochemia Medica, 24(1), 12–18. https://doi.org/10.11613/bm.2014.003 ● Otwarty dostęp
- van Smeden, M., de Groot, J. A. H., Moons, K. G. M., Collins, G. S., Altman, D. G., Eijkemans, M. J. C., & Reitsma, J. B. (2016). No rationale for 1 variable per 10 events criterion for binary logistic regression analysis. BMC Medical Research Methodology, 16(1), Article 163. https://doi.org/10.1186/s12874-016-0267-3 ● Otwarty dostęp
Cytowania BibTeX
@article{bland2000statistics, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: The odds ratio}}, journal={BMJ}, year={2000}, volume={320}, number={7247}, pages={1468}, doi={10.1136/bmj.320.7247.1468}}@article{menard2000coefficients, author={Menard, Scott}, title={{Coefficients of determination for multiple logistic regression analysis}}, journal={The American Statistician}, year={2000}, volume={54}, number={1}, pages={17--24}, doi={10.1080/00031305.2000.10474502}}@article{mood2010logistic, author={Mood, Carina}, title={{Logistic regression: Why we cannot do what we think we can do, and what we can do about it}}, journal={European Sociological Review}, year={2010}, volume={26}, number={1}, pages={67--82}, doi={10.1093/esr/jcp006}}@article{peng2002introduction, author={Peng, Chao-Ying Joanne and Lee, Kuk Lida and Ingersoll, Gary M.}, title={{An introduction to logistic regression analysis and reporting}}, journal={The Journal of Educational Research}, year={2002}, volume={96}, number={1}, pages={3--14}, doi={10.1080/00220670209598786}}@article{sperandei2014understanding, author={Sperandei, Sandro}, title={{Understanding logistic regression analysis}}, journal={Biochemia Medica}, year={2014}, volume={24}, number={1}, pages={12--18}, doi={10.11613/bm.2014.003}}@article{vansmeden2016no, author={van Smeden, Maarten and de Groot, Joris A. H. and Moons, Karel G. M. and Collins, Gary S. and Altman, Douglas G. and Eijkemans, Marinus J. C. and Reitsma, Johannes B.}, title={{No rationale for 1 variable per 10 events criterion for binary logistic regression analysis}}, journal={BMC Medical Research Methodology}, year={2016}, volume={16}, number={1}, eid={163}, doi={10.1186/s12874-016-0267-3}}