Co to jest regresja krzywoliniowa?
Regresja krzywoliniowa (ang. curvilinear regression) to model regresji, w którym związek predyktora ze zmienną zależną nie jest linią prostą: wraz ze wzrostem X wynik może rosnąć coraz wolniej, osiągać maksimum i spadać albo najpierw spadać, a potem rosnąć. W psychologii najczęściej stosuje się regresję wielomianową, zwykle kwadratową, w której do modelu dodaje się kwadrat predyktora. Mimo zakrzywionej linii to wciąż model regresji liniowej – liniowy względem współczynników – więc szacuje się go zwykłą metodą najmniejszych kwadratów.
Grant i Schwartz (2011) zwracają uwagę, że psychologia długo koncentrowała się na korzyściach „im więcej, tym lepiej”, przez co niedoceniała efektów niemonotonicznych w kształcie odwróconego U: pozytywne cechy i stany po przekroczeniu pewnego poziomu zaczynają szkodzić. Krzywoliniowość można też wykryć przypadkiem – na wykresie reszt modelu liniowego przybiera ona postać łuku.
Model kwadratowy i centrowanie predyktora
- b2 – krzywizna: b2 < 0 oznacza odwrócone U (maksimum), b2 > 0 – kształt U (minimum); im większe |b2|, tym ostrzej wygięta krzywa;
- b1 – nachylenie krzywej w punkcie X = 0, a nie „efekt główny” predyktora; nachylenie zmienia się wzdłuż osi X;
- X* – wartość predyktora, przy której krzywa osiąga maksimum lub minimum.
Przed podniesieniem do kwadratu predyktor warto wycentrować, czyli odjąć od niego średnią. Dalal i Zickar (2012) pokazują, że centrowanie zmienia współczynniki niższego rzędu, ale nie zmienia współczynnika najwyższego rzędu, dopasowania modelu ani mocy testu; zmniejsza tylko „techniczną” współliniowość między X a X² i ułatwia interpretację, gdy zero na skali nie ma sensu. Po wycentrowaniu b1 to nachylenie krzywej przy średniej wartości predyktora. W przykładzie niżej korelacja pobudzenia z jego kwadratem wynosi .973 przed wycentrowaniem i −.052 po nim, a współczynnik b2 jest w obu wersjach identyczny (−0.418) – zmienia się tylko b1 (5.10 wobec 0.93). Dlatego wysoki VIF dla X i X² w modelu bez centrowania nie jest powodem do niepokoju.
Przykład: pobudzenie przed testem a wynik
Sto pięćdziesiąt osób (dane symulowane) oceniło tuż przed testem swoje pobudzenie na skali 0–10 (M = 4.99, SD = 1.87), a następnie rozwiązało test (0–40 punktów). Model liniowy sugeruje prosty związek „im większe pobudzenie, tym lepszy wynik”: b = 0.98, p < .001, R² = .13. Rysunek 1 pokazuje jednak, że prosta źle opisuje dane.
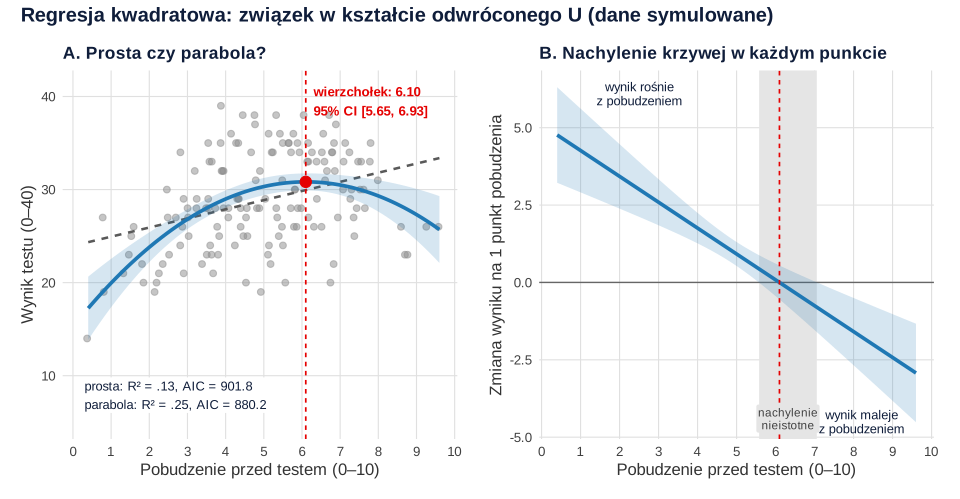
W modelu kwadratowym z wycentrowanym pobudzeniem współczynnik krzywizny jest ujemny, b2 = −0.42, SE = 0.08, t(147) = −5.00, p < .001, a nachylenie przy średnim pobudzeniu wynosi b1 = 0.93, SE = 0.20, p < .001. Wierzchołek paraboli przypada na pobudzenie 6.10, bootstrapowy 95% CI [5.65, 6.93], gdzie przewidywany wynik wynosi 30.83 punktu; na prawo od wierzchołka leży 45 osób. Panel B rysunku 1 pokazuje, jak zmienia się nachylenie: przy niskim pobudzeniu każdy punkt więcej wiąże się z wyraźnie lepszym wynikiem, przy pobudzeniu od 5.58 do 7.06 krzywa jest płaska, a powyżej – opada.
Taki kształt bywa ilustrowany „prawem Yerkesa–Dodsona”, ale ostrożnie z tym skojarzeniem. Teigen (1994) pokazuje, że pierwotnie prawo opisywało związek siły bodźca z tempem uczenia się przy zadaniach o różnej trudności rozróżniania, a późniejsze podręczniki przekształcały je w twierdzenia o pobudzeniu, lęku czy stresie – często błędnie przypisując te wersje samym autorom. Dane z przykładu są ponadto korelacyjne: pokazują, że osoby o umiarkowanym pobudzeniu uzyskiwały najwyższe wyniki, a nie że zmiana pobudzenia zmieni wynik.
Porównanie modeli: ΔR², test F i AIC
Czy kwadrat predyktora jest potrzebny, sprawdza się, porównując model liniowy z kwadratowym:
| Model | R² | AIC | Porównanie |
|---|---|---|---|
| Liniowy: wynik ~ pobudzenie | .13 | 901.8 | — |
| Kwadratowy: + pobudzenie² | .25 | 880.2 | ΔR² = .13, F(1, 147) = 25.00, p < .001; ΔAIC = −21.6 |
- Przyrost R² z testem F – jak w regresji hierarchicznej: składnik kwadratowy wprowadzasz w drugim kroku. Gdy dodajesz jeden składnik, F jest kwadratem statystyki t dla b2 (5.00² = 25.00). Przy porównaniu modeli o różnej liczbie predyktorów patrz też na skorygowane R².
- AIC (kryterium informacyjne Akaike) – Akaike (1974) zdefiniował je jako −2 × logarytm maksymalnej wiarygodności plus 2 × liczba szacowanych parametrów. Mniejsza wartość oznacza lepszy kompromis między dopasowaniem a złożonością; tu AIC spada o 21.6, więc parabola wyraźnie wygrywa mimo dodatkowego parametru. Kryteria informacyjne stosuje się także w modelach SEM (AIC i BIC).
Czy to naprawdę odwrócone U?
Istotny współczynnik b2 i wierzchołek w zakresie danych to za mało. Lind i Mehlum (2010) pokazują, że taki kształt może dać parabola dopasowana do związku, który jest zakrzywiony, ale monotoniczny – wtedy wierzchołek jest artefaktem. Właściwy test sprawdza, czy krzywa rośnie na lewym krańcu zakresu i maleje na prawym. W przykładzie nachylenie przy najniższym pobudzeniu (0.4) wynosi 4.76, t(147) = 6.10, p < .001, a przy najwyższym (9.6) −2.93, t(147) = −3.63, p < .001 – oba warunki są spełnione. Nachylenie w dowolnym punkcie uzyskasz, przesuwając zero predyktora do tego punktu i ponownie szacując model (zob. kod).
Simonsohn (2018) idzie dalej: regresja kwadratowa narzuca arbitralny kształt funkcji i w niektórych sytuacjach – np. gdy prawdziwy związek ma postać logarytmu – może dawać nawet 100% wyników fałszywie dodatnich, czyli „wykrywać” nieistniejące U. Zamiast niej proponuje test dwóch prostych: osobne nachylenia dla niskich i wysokich wartości X, z punktem podziału wyznaczanym algorytmem, który nazwał Robin Hood. Jeśli hipoteza dotyczy zmiany kierunku związku, warto pokazać oba podejścia.
Jak opisać regresję krzywoliniową w pracy (APA)
Do raportu dołącz wykres z danymi i krzywą – sama tabela współczynników nie pokazuje, gdzie leży wierzchołek ani ile osób znajduje się po każdej jego stronie. Więcej o budowaniu modeli krok po kroku piszemy w poradniku regresja wieloraka krok po kroku, a o krzywoliniowości w modelach z interakcją – we wpisie o analizie moderacji.
Przykład w R i SPSS
Kod tworzy dane z przykładu, porównuje model liniowy z kwadratowym (test F i AIC), pokazuje skutki centrowania, wyznacza wierzchołek z przedziałem bootstrapowym i liczy nachylenia krzywej na krańcach zakresu danych. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Regresja kwadratowa z wycentrowanym predyktorem
R
# Dane symulowane: N = 150 studentów; pobudzenie przed testem (0–10) i wynik testu (0–40)
set.seed(39)
n <- 150
pobudzenie <- round(pmin(pmax(rnorm(n, 5, 2), 0), 10), 1)
wynik <- round(pmin(pmax(14 + 6.0 * pobudzenie - 0.52 * pobudzenie^2 + rnorm(n, sd = 4.5), 0), 40))
dane <- data.frame(pobudzenie, wynik)
round(c(M = mean(dane$pobudzenie), SD = sd(dane$pobudzenie), min = min(dane$pobudzenie), max = max(dane$pobudzenie)), 2)

# 1. Model liniowy i kwadratowy (predyktor wycentrowany przed podniesieniem do kwadratu)
dane$pob_c <- dane$pobudzenie - mean(dane$pobudzenie)
m_lin <- lm(wynik ~ pob_c, data = dane)
m_kw  <- lm(wynik ~ pob_c + I(pob_c^2), data = dane)
round(summary(m_lin)$coefficients, 3)              # model liniowy
summary(m_kw)
round(c(R2_lin = summary(m_lin)$r.squared, R2_kw = summary(m_kw)$r.squared), 3)
anova(m_lin, m_kw)                                  # czy kwadrat poprawia dopasowanie (test F dla ΔR²)
round(c(AIC_lin = AIC(m_lin), AIC_kw = AIC(m_kw)), 1)

# 2. Centrowanie zmienia b1 (nachylenie w punkcie zero), ale nie b2
m_surowy <- lm(wynik ~ pobudzenie + I(pobudzenie^2), data = dane)
round(rbind(surowy = coef(m_surowy), wycentrowany = coef(m_kw)), 3)
round(c(r_surowe = cor(dane$pobudzenie, dane$pobudzenie^2), r_wycentrowane = cor(dane$pob_c, dane$pob_c^2)), 3)

# 3. Wierzchołek paraboli: x* = −b1 / (2 × b2), plus średnia (bo predyktor był wycentrowany)
b <- coef(m_kw)
round(unname(-b[2] / (2 * b[3]) + mean(dane$pobudzenie)), 2)
round(unname(predict(m_kw, data.frame(pob_c = -b[2] / (2 * b[3])))), 2)   # przewidywany wynik w wierzchołku
sum(dane$pobudzenie > -b[2] / (2 * b[3]) + mean(dane$pobudzenie))          # ile osób leży na prawo od wierzchołka
set.seed(1)                                         # 95% przedział bootstrapowy dla wierzchołka
w_boot <- replicate(2000, {
  i <- sample(n, replace = TRUE)
  bb <- coef(lm(wynik ~ pob_c + I(pob_c^2), data = dane[i, ]))
  -bb[2] / (2 * bb[3]) + mean(dane$pobudzenie)
})
round(quantile(w_boot, c(.025, .975)), 2)

# 4. Nachylenie krzywej na krańcach zakresu danych: przesuwamy zero predyktora do x0
nachylenie <- function(x0)
  summary(lm(wynik ~ I(pobudzenie - x0) + I((pobudzenie - x0)^2), data = dane))$coefficients[2, ]
round(rbind(przy_minimum = nachylenie(min(dane$pobudzenie)), przy_maksimum = nachylenie(max(dane$pobudzenie))), 3)
Wynik w R
   M   SD  min  max
4.99 1.87 0.40 9.60
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   28.853      0.394  73.248        0
pob_c          0.982      0.211   4.654        0

Call:
lm(formula = wynik ~ pob_c + I(pob_c^2), data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-11.2277  -3.1188  -0.0499   3.3760  10.1930

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 30.31081    0.46742  64.847  < 2e-16 ***
pob_c        0.93083    0.19594   4.751 4.78e-06 ***
I(pob_c^2)  -0.41797    0.08359  -5.000 1.61e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 4.475 on 147 degrees of freedom
Multiple R-squared:  0.2545,	Adjusted R-squared:  0.2443
F-statistic: 25.09 on 2 and 147 DF,  p-value: 4.235e-10

R2_lin  R2_kw
 0.128  0.254
Analysis of Variance Table

Model 1: wynik ~ pob_c
Model 2: wynik ~ pob_c + I(pob_c^2)
  Res.Df    RSS Df Sum of Sq  F    Pr(>F)
1    148 3444.7
2    147 2944.0  1    500.69 25 1.611e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
AIC_lin  AIC_kw
  901.8   880.2
             (Intercept) pobudzenie I(pobudzenie^2)
surowy            15.279      5.099          -0.418
wycentrowany      30.311      0.931          -0.418
      r_surowe r_wycentrowane
         0.973         -0.052
[1] 6.1
[1] 30.83
[1] 45
 2.5% 97.5%
 5.65  6.93
              Estimate Std. Error t value Pr(>|t|)
przy_minimum     4.764      0.781   6.097        0
przy_maksimum   -2.926      0.806  -3.632        0
SPSS
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Interpretowanie b1 jako „efektu” predyktora. W modelu z X² to nachylenie w punkcie X = 0 – bez centrowania często poza zakresem danych.
- Wniosek o kształcie U wyłącznie na podstawie istotnego b2. Sprawdź nachylenia na obu krańcach zakresu (Lind i Mehlum, 2010) i rozważ test dwóch prostych (Simonsohn, 2018).
- Wierzchołek poza zakresem danych. Parabola jest wtedy tylko przybliżeniem krzywizny monotonicznej; nie pisz o „optimum”.
- Usuwanie składnika liniowego, „bo jest nieistotny”. Model z X² musi zawierać także X, inaczej wymusza wierzchołek w punkcie zero.
- Kolejne potęgi bez teorii. Wielomian trzeciego czy czwartego stopnia dopasuje się do szumu; porównuj modele (AIC) i uzasadniaj kształt teoretycznie.
- Język przyczynowy i „prawo Yerkesa–Dodsona” jako gotowe wyjaśnienie danych korelacyjnych (Teigen, 1994).
- Pominięcie wpływowych obserwacji na krańcach. Kilka osób o skrajnych wartościach X może „wygiąć” parabolę – sprawdź odległość Cooka.
Krzywoliniowość można też modelować dla predyktorów kategorialnych (np. trend kwadratowy dla uporządkowanych grup koduje się kontrastami wielomianowymi zamiast zwykłych zmiennych zero-jedynkowych – zob. dummy coding), a w danych zbieranych w czasie pamiętaj o autokorelacji reszt (test Durbina-Watsona).
Najczęstsze pytania
Co to jest regresja krzywoliniowa?
To regresja, w której związek predyktora z wynikiem jest zakrzywiony – np. wynik rośnie coraz wolniej albo osiąga maksimum i spada. Najczęściej do modelu dodaje się kwadrat predyktora (regresja kwadratowa). Model wciąż szacuje się zwykłą metodą najmniejszych kwadratów.
Jak interpretować współczynniki regresji kwadratowej?
b2 opisuje krzywiznę: ujemne oznacza odwrócone U, dodatnie – kształt U. b1 to nachylenie krzywej w punkcie X = 0, a po wycentrowaniu – przy średniej X. Nachylenie w dowolnym punkcie wynosi b1 + 2b2X, a wierzchołek leży w punkcie −b1/(2b2).
Po co centrować zmienną przed podniesieniem do kwadratu?
Centrowanie (odjęcie średniej) sprawia, że b1 opisuje nachylenie przy średniej wartości predyktora, i usuwa techniczną współliniowość X z X² – w przykładzie z tej strony korelacja spadła z .973 do −.052. Nie zmienia natomiast b2, dopasowania modelu ani testu krzywizny (Dalal i Zickar, 2012).
Jak sprawdzić, czy model kwadratowy jest lepszy od liniowego?
Porównaj oba modele: przyrost R² z testem F (w R: anova(m_lin, m_kw)) i kryterium AIC – mniejsze AIC oznacza lepszy kompromis między dopasowaniem a liczbą parametrów. W przykładzie ΔR² = .13, F(1, 147) = 25.00, p < .001, a AIC spadło z 901.8 do 880.2.
Czy istotny kwadrat predyktora oznacza związek w kształcie U?
Nie. Parabola może wskazać wierzchołek także wtedy, gdy związek jest zakrzywiony, ale monotoniczny. Sprawdź, czy nachylenie jest istotnie dodatnie na jednym krańcu zakresu danych i istotnie ujemne na drugim (Lind i Mehlum, 2010), albo zastosuj test dwóch prostych (Simonsohn, 2018).
Jak zrobić regresję kwadratową w SPSS?
Utwórz wycentrowany predyktor i jego kwadrat (Przekształcenia → Oblicz wartości zmiennej), a potem w regresji liniowej wprowadź predyktor w bloku 1, a kwadrat w bloku 2 z opcją Zmiana R kwadrat. Kształt krzywej szybko obejrzysz w menu Analiza → Regresja → Estymacja krzywej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikNieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/tac.1974.1100705 ● Otwarty dostęp: pełny tekst
- Dalal, D. K., & Zickar, M. J. (2012). Some common myths about centering predictor variables in moderated multiple regression and polynomial regression. Organizational Research Methods, 15(3), 339–362. https://doi.org/10.1177/1094428111430540
- Grant, A. M., & Schwartz, B. (2011). Too much of a good thing: The challenge and opportunity of the inverted U. Perspectives on Psychological Science, 6(1), 61–76. https://doi.org/10.1177/1745691610393523
- Lind, J. T., & Mehlum, H. (2010). With or without U? The appropriate test for a U-shaped relationship. Oxford Bulletin of Economics and Statistics, 72(1), 109–118. https://doi.org/10.1111/j.1468-0084.2009.00569.x ● Otwarty dostęp
- Simonsohn, U. (2018). Two lines: A valid alternative to the invalid testing of U-shaped relationships with quadratic regressions. Advances in Methods and Practices in Psychological Science, 1(4), 538–555. https://doi.org/10.1177/2515245918805755 ● Otwarty dostęp: pełny tekst
- Teigen, K. H. (1994). Yerkes-Dodson: A law for all seasons. Theory & Psychology, 4(4), 525–547. https://doi.org/10.1177/0959354394044004
Cytowania BibTeX
@article{akaike1974new, author={Akaike, Hirotugu}, title={{A new look at the statistical model identification}}, journal={IEEE Transactions on Automatic Control}, year={1974}, volume={19}, number={6}, pages={716--723}, doi={10.1109/tac.1974.1100705}}@article{dalal2012some, author={Dalal, Dev K. and Zickar, Michael J.}, title={{Some common myths about centering predictor variables in moderated multiple regression and polynomial regression}}, journal={Organizational Research Methods}, year={2012}, volume={15}, number={3}, pages={339--362}, doi={10.1177/1094428111430540}}@article{grant2011too, author={Grant, Adam M. and Schwartz, Barry}, title={{Too much of a good thing: The challenge and opportunity of the inverted U}}, journal={Perspectives on Psychological Science}, year={2011}, volume={6}, number={1}, pages={61--76}, doi={10.1177/1745691610393523}}@article{lind2010with, author={Lind, Jo Thori and Mehlum, Halvor}, title={{With or without U? The appropriate test for a U-shaped relationship}}, journal={Oxford Bulletin of Economics and Statistics}, year={2010}, volume={72}, number={1}, pages={109--118}, doi={10.1111/j.1468-0084.2009.00569.x}}@article{simonsohn2018two, author={Simonsohn, Uri}, title={{Two lines: A valid alternative to the invalid testing of U-shaped relationships with quadratic regressions}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={4}, pages={538--555}, doi={10.1177/2515245918805755}}@article{teigen1994yerkes, author={Teigen, Karl Halvor}, title={{Yerkes-Dodson: A law for all seasons}}, journal={Theory \& Psychology}, year={1994}, volume={4}, number={4}, pages={525--547}, doi={10.1177/0959354394044004}}