Co to jest regresja prosta?
Regresja prosta (regresja liniowa prosta, ang. simple linear regression) to model, który opisuje średnią wartość ilościowej zmiennej zależnej Y za pomocą jednego predyktora X i linii prostej. Odpowiada na dwa pytania: o ile średnio różni się Y, gdy X jest wyższe o jednostkę, oraz jaki wynik Y przewidujemy dla danej wartości X. To najprostszy przypadek regresji liniowej; gdy predyktorów jest kilka, mówimy o regresji wielorakiej.
W psychologii regresję prostą stosuje się na przykład do opisu, jak czas reakcji zmienia się z wiekiem, jak wynik egzaminu wiąże się z liczbą godzin nauki albo jak nasilenie lęku wiąże się z długością snu. Schober i Vetter (2021) podkreślają, że regresja liniowa kwantyfikuje związek predyktora z ciągłą zmienną zależną, a jej interpretacja opiera się na nachyleniu, jego 95% przedziale ufności i R². Ten sam model służy też do przewidywania – Gelman i in. (2020) pokazują praktyczne użycie regresji zarówno do porównań i estymacji, jak i do predykcji.
Wzór regresji prostej i interpretacja współczynników
- Ŷ – wartość przewidywana, czyli średni wynik osób o danej wartości X;
- b1 – nachylenie: o ile zmienia się przewidywany Y, gdy X rośnie o 1 jednostkę;
- b0 – stała (wyraz wolny): przewidywany Y dla X = 0;
- e – reszta, czyli różnica między wynikiem obserwowanym a przewidywanym (zob. reszty regresji).
Współczynniki szacuje się metodą najmniejszych kwadratów: prosta jest tak dobrana, by suma kwadratów reszt była najmniejsza. Taką prostą nazywa się linią najlepszego dopasowania. Przy jednym predyktorze rozwiązanie da się zapisać przez korelację i odchylenia standardowe:
Z drugiego wzoru wynika, że prosta regresji zawsze przechodzi przez punkt średnich (X̄, Ȳ). Stała ma sens tylko wtedy, gdy X = 0 jest realną wartością. W przeciwnym razie wycentruj predyktor (odejmij od niego średnią) – stała oznacza wtedy przewidywany wynik osoby o przeciętnym X, a nachylenie się nie zmienia.
Regresja prosta a korelacja Pearsona
Regresja prosta i korelacja Pearsona opisują ten sam liniowy związek, ale odpowiadają na inne pytania. Rodgers i Nicewander (1988) wśród trzynastu interpretacji współczynnika r wymieniają nachylenie prostej: po standaryzacji obu zmiennych nachylenie regresji prostej (β) równa się dokładnie r. Najważniejsze zależności zebraliśmy w tabeli.
| Cecha | Korelacja r | Regresja prosta |
|---|---|---|
| Co opisuje | Siłę i kierunek związku, bez jednostek | Zmianę przewidywanego Y na jednostkę X, w jednostkach Y |
| Kierunek analizy | Symetryczna: r(X, Y) = r(Y, X) | Niesymetryczna: regresja Y na X to inna prosta niż regresja X na Y |
| Związek między miarami | — | b1 = r × SDY / SDX, β = r |
| Wyjaśniona wariancja | r² | R² = r² |
| Test istotności | Test t dla r | Test t dla b1 – ta sama wartość t i p |
| Przewidywanie wyników | Nie | Tak: Ŷ z przedziałem ufności lub predykcji |
Bewick i in. (2003) omawiają obie techniki razem – obliczanie i interpretację r oraz równania regresji, testy i przedziały ufności – a także ich częste nadużycia i skutki niespełnienia założeń. Gdy potrzebujesz tylko siły związku, wystarczy korelacja. Regresję wybierz wtedy, gdy interesuje Cię zmiana wyniku w jego naturalnych jednostkach (np. milisekundach, punktach testu) albo przewidywanie.
Przykład: wiek a czas reakcji
Sześćdziesiąt osób w wieku od 21 do 70 lat (dane symulowane; wiek: M = 46.73, SD = 15.02) wykonało komputerowe zadanie z wyborem reakcji. Średni czas reakcji wyniósł 489.13 ms (SD = 56.13), a jego korelacja z wiekiem r = .60. Model regresji prostej ma postać:
- Nachylenie b = 2.24 ms, 95% CI [1.46, 3.03], t(58) = 5.71, p < .001. Osoby starsze o rok mają przewidywany czas reakcji dłuższy średnio o 2.24 ms, a starsze o dekadę – o 22.4 ms.
- Stała b0 = 384.33 ms to przewidywany czas reakcji osoby w wieku 0 lat – wartość bez sensu, bo najmłodsza osoba w próbie miała 21 lat. Po wycentrowaniu wieku stała wynosi 489.13 ms, czyli tyle, ile przewidywany czas reakcji osoby w przeciętnym wieku (46.73 roku).
- R² = .36, F(1, 58) = 32.63, p < .001: wiek wyjaśnia 36% wariancji czasu reakcji. To dokładnie kwadrat korelacji (.60² = .36), a test F modelu jest tu równoważny testowi t dla nachylenia (5.71² ≈ 32.63).
Nachylenie można też odtworzyć z korelacji: .600 × 56.13 / 15.02 = 2.24. To dobry sposób, by zrozumieć, że b zależy nie tylko od siły związku, ale też od rozproszenia obu zmiennych – dlatego b i r nie są wymienne.
Przewidywanie: przedział ufności a przedział predykcji
Dla osoby w wieku 45 lat model przewiduje czas reakcji 485.2 ms. Wokół tej wartości można zbudować dwa różne przedziały, które odpowiadają na różne pytania:
- 95% przedział ufności dla średniej mówi, gdzie leży średni czas reakcji wszystkich 45-latków w populacji: [473.5, 497.0] ms;
- 95% przedział predykcji mówi, gdzie znajdzie się wynik jednej, nowej 45-letniej osoby: [393.8, 576.7] ms.
Różnicę widać we wzorach na błędy standardowe obu przewidywań:
gdzie s to błąd standardowy estymacji, czyli odchylenie standardowe reszt (tu 45.29 ms), a x0 – wiek, dla którego przewidujemy. Dodatkowa jedynka pod pierwiastkiem oznacza zmienność pojedynczych osób wokół prostej. Dlatego przedział predykcji jest tu prawie ośmiokrotnie szerszy od przedziału ufności (182.8 wobec 23.6 ms) i – w przeciwieństwie do niego – nie zwęża się do zera nawet w bardzo dużej próbie. Oba przedziały rozszerzają się wraz z oddalaniem od średniego wieku: dla 70-latków przedział ufności ma już szerokość 43.4 ms.
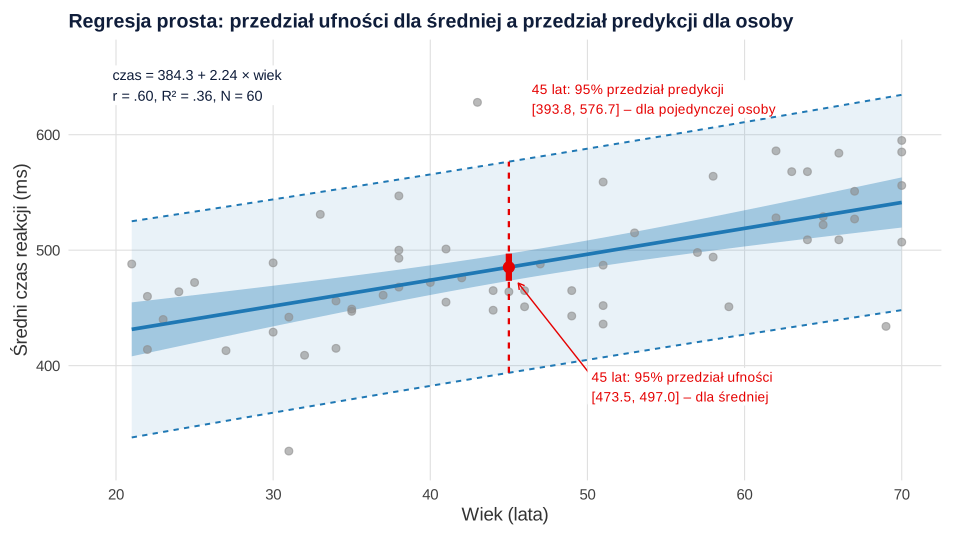
W próbie wewnątrz swoich 95% przedziałów predykcji znalazło się 57 z 60 osób, czyli 95% – tak powinno być, jeśli model dobrze opisuje dane. Przedział predykcji silniej niż przedział ufności zależy od kształtu rozkładu reszt i stałości ich wariancji, bo dotyczy pojedynczych wyników, a nie średniej.
Założenia regresji prostej
Regresja prosta ma te same założenia co każda regresja liniowa: liniowość związku (zacznij od wykresu rozrzutu), niezależność obserwacji, stałą wariancję reszt (homoskedastyczność) i – zwłaszcza w małych próbach – normalność reszt. Z jednym predyktorem nie ma problemu współliniowości, ale tym wyraźniej widać wpływ pojedynczych obserwacji odstających: jeden nietypowy punkt na skraju zakresu X potrafi wyraźnie zmienić nachylenie. Gdy związek jest zakrzywiony, sięgnij po regresję krzywoliniową. Sposoby sprawdzania założeń opisujemy w haśle regresja liniowa i w poradniku regresja wieloraka krok po kroku.
Jak opisać regresję prostą w pracy (APA)
Podaj nachylenie b z jednostkami i 95% CI, test t, R² z testem F, a gdy celem jest przewidywanie – przedział predykcji. Współczynnika β nie musisz podawać osobno: w regresji prostej równa się on r. Wzór opisu dla przykładu:
Gotowe zdania do innych analiz znajdziesz w poradniku jak opisać wyniki w stylu APA, a wzór tabeli – w haśle tabela regresji w APA.
Przykład w R
Kod tworzy dane z przykładu, szacuje regresję prostą, odtwarza nachylenie z korelacji, centruje wiek i liczy oba przedziały dla osoby w wieku 45 lat. Liczby w tekście i na rysunku pochodzą z tego kodu.
Regresja prosta, przedział ufności i przedział predykcji
R
# Dane symulowane: wiek (lata) i średni czas reakcji w zadaniu z wyborem (ms), N = 60
set.seed(909)
n <- 60
wiek <- round(runif(n, 19.5, 70.5))
czas <- round(430 + 2.4 * (wiek - 20) + rnorm(n, sd = 48))
dane <- data.frame(wiek, czas)
round(c(M_wiek = mean(wiek), SD_wiek = sd(wiek), M_czas = mean(czas),
        SD_czas = sd(czas), r = cor(wiek, czas)), 3)

# Regresja prosta: czas reakcji przewidywany wiekiem
model <- lm(czas ~ wiek, data = dane)
summary(model)
round(confint(model), 2)

# Nachylenie z korelacji i R² jako kwadrat r
r <- cor(dane$wiek, dane$czas)
round(c(b_z_korelacji = r * sd(dane$czas) / sd(dane$wiek), r_kwadrat = r^2), 3)

# Stała po wycentrowaniu wieku: przewidywany czas osoby w przeciętnym wieku
dane$wiek_c <- dane$wiek - mean(dane$wiek)
round(coef(lm(czas ~ wiek_c, data = dane)), 2)

# Przewidywanie dla osoby w wieku 45 lat: przedział ufności i przedział predykcji
nowa <- data.frame(wiek = 45)
round(predict(model, nowa, interval = "confidence"), 1)
round(predict(model, nowa, interval = "prediction"), 1)
Wynik w R
 M_wiek SD_wiek  M_czas SD_czas       r
 46.733  15.017 489.133  56.127   0.600

Call:
lm(formula = czas ~ wiek, data = dane)

Residuals:
     Min       1Q   Median       3Q      Max
-127.851  -22.519   -5.443   27.361  147.239

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 384.3337    19.2567  19.958  < 2e-16 ***
wiek          2.2425     0.3926   5.712 4.05e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 45.29 on 58 degrees of freedom
Multiple R-squared:   0.36,	Adjusted R-squared:  0.349
F-statistic: 32.63 on 1 and 58 DF,  p-value: 4.048e-07

             2.5 % 97.5 %
(Intercept) 345.79 422.88
wiek          1.46   3.03
b_z_korelacji     r_kwadrat
        2.243         0.360
(Intercept)      wiek_c
     489.13        2.24
    fit   lwr upr
1 485.2 473.5 497
    fit   lwr   upr
1 485.2 393.8 576.7
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe lm() i predict()); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Interpretowanie stałej, gdy X = 0 nie występuje. „Czas reakcji noworodka” równy 384 ms to artefakt wzoru, a nie wynik badania. Wycentruj predyktor albo pomiń interpretację stałej.
- Ekstrapolacja. Przewidywanie dla 90-latków z danych osób w wieku 21–70 lat zakłada, że związek pozostaje liniowy poza obserwowanym zakresem – a tego dane nie pokazują.
- Mylenie przedziału ufności z przedziałem predykcji. Wąski przedział ufności dla średniej nie oznacza, że trafnie przewidzisz wynik konkretnej osoby.
- „Odwracanie” równania. Z regresji czasu reakcji na wiek nie wyliczysz wieku na podstawie czasu reakcji – do tego potrzebna jest osobna regresja X na Y.
- Utożsamianie b z r. Nachylenie zależy od jednostek i rozproszenia zmiennych; o sile związku mówi r (lub β), a o jego wielkości w praktyce – b.
- Język przyczynowy w badaniu korelacyjnym. Dane przekrojowe pokazują, że starsze osoby reagowały wolniej, a nie że starzenie się konkretnej osoby wydłuża jej czas reakcji o 2.24 ms rocznie.
- Brak wykresu rozrzutu. Ten sam współczynnik r i ta sama prosta mogą opisywać zupełnie różne układy punktów – zakrzywione, z jedną obserwacją odstającą albo z dwiema grupami.
Najczęstsze pytania
Co to jest regresja prosta?
To regresja liniowa z jednym predyktorem: model opisuje średni wynik zmiennej zależnej Y jako prostą Ŷ = b0 + b1X. Służy do opisu związku w jednostkach Y (np. milisekundach na rok życia) i do przewidywania wyniku dla danej wartości X. Gdy predyktorów jest więcej, stosuje się regresję wieloraką.
Jak interpretować współczynnik b w regresji prostej?
Nachylenie b1 to przewidywana różnica w Y między osobami, które różnią się o 1 jednostkę X. W przykładzie z tej strony b = 2.24 oznacza, że osoby starsze o rok mają przewidywany czas reakcji dłuższy średnio o 2.24 ms. W badaniu korelacyjnym to opis różnic między osobami, a nie skutek zmiany X u jednej osoby.
Czym różni się regresja prosta od korelacji Pearsona?
Korelacja r opisuje siłę i kierunek związku bez jednostek i jest symetryczna. Regresja opisuje zmianę Y na jednostkę X i pozwala przewidywać wyniki. Obie miary są powiązane: b1 = r × SDY/SDX, R² = r², a test t dla nachylenia daje tę samą wartość p co test korelacji.
Co oznacza stała (wyraz wolny) w regresji prostej?
Stała b0 to przewidywany wynik Y, gdy X = 0. Ma sens tylko wtedy, gdy zero leży w zakresie danych. Jeśli nie leży (np. wiek 0 lat), wycentruj predyktor – wtedy stała oznacza przewidywany wynik osoby o przeciętnej wartości X, a nachylenie się nie zmienia.
Czym różni się przedział ufności od przedziału predykcji w regresji?
Przedział ufności mówi, gdzie leży średni wynik wszystkich osób o danym X, a przedział predykcji – gdzie znajdzie się wynik jednej nowej osoby. Przedział predykcji uwzględnia dodatkowo zmienność osób wokół prostej, więc jest znacznie szerszy: w przykładzie dla 45 lat [393.8, 576.7] ms wobec [473.5, 497.0] ms.
Jak zrobić regresję prostą w SPSS?
Wybierz Analiza → Regresja → Liniowa (Analyze → Regression → Linear), wskaż zmienną zależną i jeden predyktor. W oknie Statystyki zaznacz przedziały ufności, a w oknie Zapisz – przedziały predykcji dla średniej i dla pojedynczej obserwacji (Prediction Intervals: Mean, Individual). Nachylenie odczytasz w kolumnie B tabeli współczynników.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikStatystyka do pracy licencjackiej
Typowe plany analiz w licencjacie, co przygotować przed analizą i przykład z danymi CSV: alfa, korelacja, test t Welcha, chi-kwadrat i skrócony rozdział wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bewick, V., Cheek, L., & Ball, J. (2003). Statistics review 7: Correlation and regression. Critical Care, 7(6), 451–459. https://doi.org/10.1186/cc2401 ● Otwarty dostęp
- Gelman, A., Hill, J., & Vehtari, A. (2020). Regression and other stories. Cambridge University Press. https://doi.org/10.1017/9781139161879
- Rodgers, J. L., & Nicewander, W. A. (1988). Thirteen ways to look at the correlation coefficient. The American Statistician, 42(1), 59–66. https://doi.org/10.1080/00031305.1988.10475524
- Schober, P., & Vetter, T. R. (2021). Linear regression in medical research. Anesthesia & Analgesia, 132(1), 108–109. https://doi.org/10.1213/ANE.0000000000005206 ● Otwarty dostęp
Cytowania BibTeX
@article{bewick2003statistics, author={Bewick, Viv and Cheek, Liz and Ball, Jonathan}, title={{Statistics review 7: Correlation and regression}}, journal={Critical Care}, year={2003}, volume={7}, number={6}, pages={451--459}, doi={10.1186/cc2401}}@book{gelman2020regression, author={Gelman, Andrew and Hill, Jennifer and Vehtari, Aki}, title={{Regression and other stories}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781139161879}}@article{rodgers1988thirteen, author={Rodgers, Joseph Lee and Nicewander, W. Alan}, title={{Thirteen ways to look at the correlation coefficient}}, journal={The American Statistician}, year={1988}, volume={42}, number={1}, pages={59--66}, doi={10.1080/00031305.1988.10475524}}@article{schober2021linear, author={Schober, Patrick and Vetter, Thomas R.}, title={{Linear regression in medical research}}, journal={Anesthesia \& Analgesia}, year={2021}, volume={132}, number={1}, pages={108--109}, doi={10.1213/ane.0000000000005206}}