Co to jest heterogeniczność wariancji?
Heterogeniczność wariancji (niejednorodność wariancji; w regresji – heteroskedastyczność, ang. heteroscedasticity) oznacza, że rozrzut wyników wokół wartości przewidywanych przez model nie jest stały: przy jednych wartościach predyktora albo w jednych grupach wyniki są bardziej rozproszone niż przy innych. Formalnie wariancja błędu zależy od obserwacji, Var(εi) = σi², zamiast jednego σ² dla wszystkich.
To samo zjawisko ma dwie postaci:
- w porównaniach grup (test t, ANOVA) – grupy mają różne wariancje, czyli naruszone jest założenie homogeniczności wariancji; jego skutki dla testu F omawiamy w osobnym haśle;
- w regresji z predyktorami ciągłymi – rozrzut reszt zmienia się płynnie wraz z wartością predyktora lub wartością przewidywaną. Temu przypadkowi poświęcamy to hasło; założenie przeciwne to homoskedastyczność.
Nie myl tego pojęcia z heterogenicznością w metaanalizie (zróżnicowaniem efektów między badaniami) ani z niejawną heterogenicznością w modelowaniu, czyli istnieniem nieobserwowanych podgrup o różnych zależnościach między zmiennymi.
Jak wygląda? Lejek reszt i jego przyczyny
Heteroskedastyczność najłatwiej zobaczyć na wykresie reszt względem wartości dopasowanych. Przy stałej wariancji punkty tworzą poziomą „opaskę” o stałej szerokości. Najczęstszy wzór heteroskedastyczności to lejek rozszerzający się w prawo – rozrzut rośnie wraz z przewidywanym wynikiem. Rzadziej spotkasz lejek zwężający się (np. gdy wysokie wyniki dochodzą do maksimum skali) albo „klepsydrę”, gdy rozrzut jest największy na obu krańcach.
Typowe źródła w danych psychologicznych:
- wariancja rośnie razem ze średnią – czasy reakcji, liczby zdarzeń (np. liczba objawów czy papierosów), kwoty pieniędzy;
- granice skali – przy efekcie podłogi lub sufitu wyniki „ściskają się” przy krańcu skali, więc rozrzut jest tam mniejszy;
- różne reakcje różnych osób – predyktor działa silnie u jednych i słabo u innych, więc przy wysokich wartościach predyktora wyniki się rozchodzą;
- źle określony model – pominięta interakcja, nieliniowość albo ważna zmienna potrafią udawać heteroskedastyczność; wtedy trzeba poprawić model, a nie tylko błędy standardowe.
Przykład: czas w mediach społecznościowych a lęk
Sto dwadzieścia osób podało, ile godzin dziennie spędza w mediach społecznościowych, i wypełniło skalę lęku (0–63 punkty; dane symulowane). Rozkład czasu jest prawostronnie skośny: mediana wynosi 1.95 godziny, ale 9 osób spędza w mediach ponad 6 godzin dziennie. Regresja liniowa metodą najmniejszych kwadratów (MNK) daje nachylenie b = 2.21: każda dodatkowa godzina wiąże się z wynikiem lęku wyższym średnio o 2.21 punktu (R² = .18).
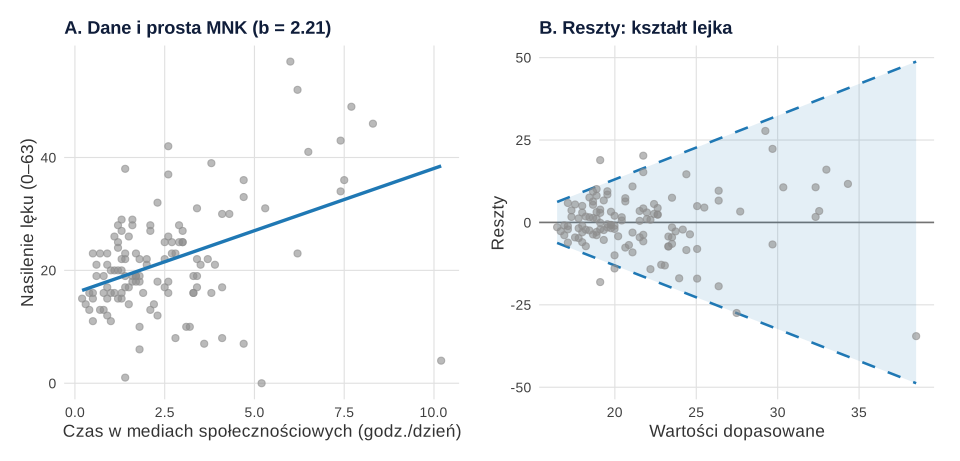
Panel B pokazuje klasyczny lejek. Odchylenie standardowe reszt wynosi 3.80 punktu u osób spędzających w mediach do godziny dziennie, 6.70 przy 1–2 godzinach, 8.24 przy 2–4 godzinach i 16.32 powyżej 4 godzin – ponad czterokrotnie więcej niż w pierwszej grupie. Formalne testy potwierdzają to, co widać: test Breuscha–Pagana, BP(1) = 32.92, p < .001, i test Cooka–Weisberga, χ²(1) = 71.55, p < .001.
Co heterogeniczność wariancji robi z wynikami regresji?
Samo oszacowanie nachylenia nie jest obciążone. Long i Ervin (2000) przypominają, że przy heteroskedastyczności oszacowania MNK pozostają nieobciążone, ale zwykłe testy istotności bywają niewłaściwe. Problem dotyczy błędów standardowych: Hayes i Cai (2007) wyjaśniają, że klasyczny estymator macierzy kowariancji współczynników może być wtedy obciążony i niezgodny, a testy i przedziały ufności – zbyt liberalne albo zbyt zachowawcze. Kierunek zależy od układu danych: klasyczny błąd standardowy jest zaniżony, gdy największy rozrzut przypada na obserwacje o skrajnych wartościach predyktora – tak jak w przykładzie, w którym nieliczne osoby z bardzo długim czasem w mediach mają też najbardziej rozproszone wyniki.
| Metoda | b | SE | 95% CI | p |
|---|---|---|---|---|
| MNK, klasyczne błędy standardowe | 2.21 | 0.43 | [1.34, 3.07] | < .001 |
| MNK, odporne błędy standardowe HC3 | 2.21 | 0.90 | [0.42, 3.99] | .016 |
| Ważona MNK (WLS) | 2.29 | 0.53 | [1.23, 3.34] | < .001 |
Klasyczny błąd standardowy (0.43) jest o połowę mniejszy od odpornego (0.90), więc klasyczny przedział ufności sugeruje dwa razy większą precyzję, niż naprawdę dają dane. Wniosek o istnieniu związku się nie zmienia (p = .016 w wersji HC3), ale oszacowanie jego siły jest znacznie mniej pewne: od 0.42 do 3.99 punktu na godzinę.
Klasyczne czy odporne błędy standardowe? Symulacja
Ile kosztuje zignorowanie heteroskedastyczności? Powtórzyliśmy po 5000 razy regresję z tym samym mechanizmem (prawoskośny predyktor i rozrzut rosnący razem z nim), ale bez związku w populacji (β = 0). Każdy istotny wynik testu nachylenia jest więc fałszywym alarmem.
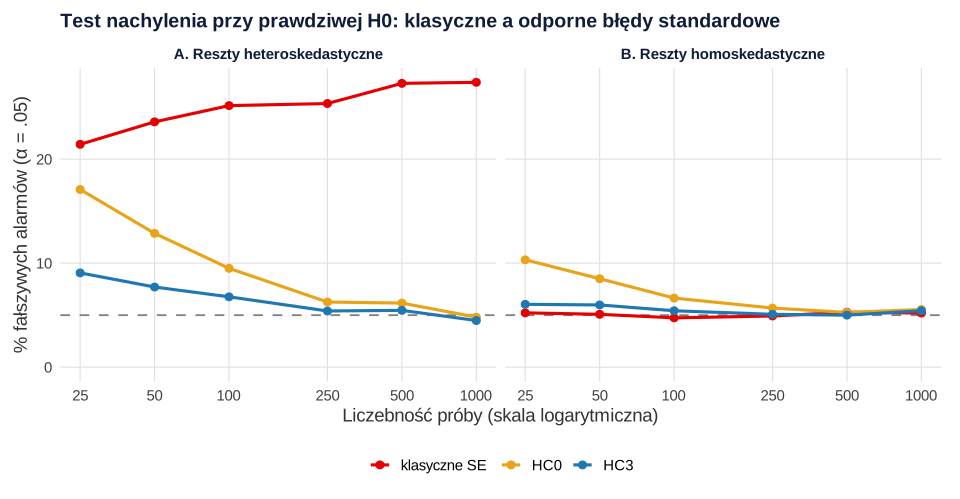
- Klasyczne błędy standardowe dawały od 21.4% do 27.4% fałszywych alarmów, a problem nie znikał w dużych próbach – przy 1000 osobach było ich 27.4%.
- HC0, czyli pierwotny estymator White’a (1980), zgodny także przy heteroskedastyczności, działał dobrze dopiero w dużych próbach: 17.1% fałszywych alarmów przy 25 osobach, 9.5% przy 100 i 6.3% przy 250.
- HC3 był najbliżej nominalnych 5% przy każdej liczebności: 9.1% przy 25 osobach, 6.8% przy 100 i 5.4% przy 250. Przy tak silnej heteroskedastyczności i bardzo małej próbie nawet on jest nieco zbyt liberalny.
- Przy stałym rozrzucie (panel B) klasyczne błędy standardowe i HC3 działały poprawnie (HC3: od 5.0% do 6.0%), a HC0 w małych próbach znów przesadzał (10.3% przy 25 osobach).
Wyniki są zgodne z symulacjami Longa i Ervin (2000), w których HC0 często prowadził do błędnych wniosków przy N ≤ 250, a HC3 działał dobrze nawet przy 25 obserwacjach. Autorzy zalecają stosowanie odpornych błędów standardowych zawsze, gdy można podejrzewać heteroskedastyczność, nieuzależnianie tej decyzji od testu wstępnego i wybór HC3 przy N ≤ 250. Hayes i Cai (2007) idą dalej i radzą stosować takie estymatory rutynowo w każdej regresji MNK.
Jak wykryć heterogeniczność wariancji?
- Wykres reszt względem wartości dopasowanych – podstawowe narzędzie; szukaj lejka, klepsydry albo łuku. W R:
plot(model, which = 1), a wykres pierwiastka z |reszt standaryzowanych| (scale-location) –which = 3. W SPSS w oknie regresji liniowej: Wykresy → oś Y: *ZRESID, oś X: *ZPRED. - Wykres reszt względem każdego predyktora – pokazuje, z którą zmienną wiąże się zmiana rozrzutu.
- Testy formalne. Test Breuscha–Pagana (Breusch i Pagan, 1979) sprawdza, czy kwadraty reszt zależą od predyktorów; funkcja
bptest()z pakietu lmtest liczy domyślnie jego wersję studentyzowaną (Koenkera). Test Cooka i Weisberga (1983), oparty na statystyce wyniku, wykonasz funkcjąncvTest()z pakietu car; autorzy zaproponowali też uzupełniającą go procedurę graficzną. White (1980) zaproponował test oparty na porównaniu klasycznej i odpornej macierzy kowariancji; jego popularną wersję uzyskasz, dodając dobptest()kwadraty predyktorów (w przykładzie BP(2) = 40.27, p < .001).
Testy traktuj jako uzupełnienie wykresu. Jak każdy test istotności, w dużych próbach wykrywają nawet nieistotny praktycznie wzór, a w małych mogą przeoczyć poważny. Long i Ervin (2000) przestrzegają przed uzależnianiem wyboru błędów standardowych od wyniku testu wstępnego.
Co zrobić przy heterogeniczności wariancji?
Rosopa i in. (2013), syntetyzując literaturę z psychologii stosowanej, ekonometrii i statystyki, proponują trzy kroki: dopasuj model wynikający z teorii i zapisz reszty, przeanalizuj reszty, a wnioskowanie oprzyj na metodach dostosowanych do wykrytego problemu. Autorzy podkreślają też, że nieuwzględniona heteroskedastyczność może zarówno zwiększać odsetek błędów I rodzaju, jak i obniżać moc. Do wyboru masz:
| Rozwiązanie | Kiedy | Na co uważać |
|---|---|---|
| Odporne błędy standardowe HC3 | niemal zawsze – zwłaszcza gdy kształt heteroskedastyczności jest nieznany | nie zmieniają oszacowania b; w bardzo małych próbach bywają lekko liberalne |
| Ważona MNK (WLS) | gdy wiadomo albo da się oszacować, jak rozrzut zależy od predyktora (np. średnie z grup o różnej liczebności) | źle dobrane wagi mogą zaszkodzić; warto łączyć z HC3 |
| Transformacja zmiennej zależnej (np. logarytm) | gdy rozrzut rośnie proporcjonalnie do średniej | zmienia interpretację i nie zawsze usuwa problem |
| Model dopasowany do danych | liczby zdarzeń – regresja Poissona; czasy reakcji – modele uogólnione | wymaga znajomości modelu i jego założeń |
| Poprawa specyfikacji | gdy lejek wynika z pominiętej interakcji lub nieliniowości (zob. regresja krzywoliniowa) | zmiana modelu powinna wynikać z teorii, a nie z szukania istotności |
W przykładzie WLS z wagami odwrotnie proporcjonalnymi do przewidywanej wariancji (oszacowanej z modelu |reszta| ~ czas) dał b = 2.29, SE = 0.53, 95% CI [1.23, 3.34]; z odpornymi błędami HC3 błąd standardowy wyniósł 0.50. Przedział jest węższy niż przy samym HC3, bo WLS daje większą wagę precyzyjniejszym obserwacjom. Logarytmowanie nie pomogło: po transformacji log(lęk + 1) test Breuscha–Pagana nadal był istotny, BP(1) = 7.73, p = .005, a nachylenie (4.9% na godzinę) przestało być istotne, p = .072 – transformacja zmieniła pytanie badawcze. Pełną diagnostykę modelu z kilkoma predyktorami pokazujemy w poradniku regresja wieloraka krok po kroku.
Jak opisać heterogeniczność wariancji w pracy (APA)
Napisz, jak oceniono założenie (wykres, test), jakich błędów standardowych użyto i podaj wyniki z odpornymi błędami. Opis dla przykładu:
W tabeli wyników zaznacz w nocie, że podano odporne błędy standardowe HC3 (wzór tabeli: tabela regresji w APA).
Przykład w R
Kod odtwarza przykład: wykres reszt, testy Breuscha–Pagana i Cooka–Weisberga, klasyczne i odporne błędy standardowe oraz ważoną MNK. Rysunki i symulację przygotowano w osobnym skrypcie. W nowszych wersjach SPSS odporne błędy standardowe (HC0–HC4) wybierzesz w oknie Analiza → Ogólny model liniowy → Jednej zmiennej zależnej → Opcje (Parameter estimates with robust standard errors); dla starszych wersji Hayes i Cai (2007) udostępnili makra.
Diagnoza i odporne błędy standardowe
R
# Pakiety: lmtest (testy i coeftest), sandwich (błędy HC3), car (ncvTest) – wywołania z prefiksem pakiet::
# Dane symulowane: czas w mediach społecznościowych (godz./dzień) a nasilenie lęku (0–63)
set.seed(22)
czas <- round(pmin(rgamma(120, shape = 2, rate = 0.8), 12), 1)
lek  <- round(18 + 1.6 * czas + rnorm(120, 0, 2 + 2.4 * czas))
lek  <- pmin(pmax(lek, 0), 63)
m <- lm(lek ~ czas)

# 1. Diagnoza: wykres reszt względem wartości dopasowanych i testy heteroskedastyczności
plot(m, which = 1)                           # „Residuals vs Fitted” – szukaj lejka
lmtest::bptest(m)                            # Breusch–Pagan (wersja Koenkera)
car::ncvTest(m)                              # test Cooka–Weisberga

# 2. Klasyczne i odporne (HC3) błędy standardowe nachylenia
lmtest::coeftest(m)
lmtest::coeftest(m, vcov. = sandwich::vcovHC(m, type = "HC3"))
lmtest::coefci(m, vcov. = sandwich::vcovHC(m, type = "HC3"))

# 3. Ważona MNK: wagi z modelu rozrzutu |reszta| ~ czas
rozrzut <- lm(abs(resid(m)) ~ czas)
wls <- lm(lek ~ czas, weights = 1 / fitted(rozrzut)^2)
round(cbind(summary(wls)$coefficients[, 1:2], confint(wls)), 3)
Wynik w R
	studentized Breusch-Pagan test

data:  m
BP = 32.915, df = 1, p-value = 9.628e-09

Non-constant Variance Score Test
Variance formula: ~ fitted.values
Chisquare = 71.54704, Df = 1, p = < 2.22e-16

t test of coefficients:

            Estimate Std. Error t value  Pr(>|t|)
(Intercept) 16.01112    1.36805 11.7036 < 2.2e-16 ***
czas         2.20531    0.43498  5.0699 1.493e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


t test of coefficients:

            Estimate Std. Error t value  Pr(>|t|)
(Intercept) 16.01112    1.87541  8.5374 5.543e-14 ***
czas         2.20531    0.90225  2.4442     0.016 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

                 2.5 %    97.5 %
(Intercept) 12.2972879 19.724951
czas         0.4186037  3.992019
            Estimate Std. Error  2.5 % 97.5 %
(Intercept)   15.854      0.949 13.974 17.734
czas           2.286      0.532  1.232  3.340
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- „Heteroskedastyczność obciąża współczynnik” – nie obciąża b, tylko jego błąd standardowy, a więc testy i przedziały ufności.
- Przekonanie, że duża próba rozwiązuje problem – klasyczne błędy standardowe nie poprawiają się wraz z liczebnością; w symulacji przy 1000 osobach dawały 27.4% fałszywych alarmów.
- HC0 w małej próbie – jest zbyt liberalny; przy N ≤ 250 wybierz HC3 (Long i Ervin, 2000).
- Odporne błędy standardowe tylko „po istotnym teście” – zaplanuj je z góry; testy wstępne mają małą moc w małych próbach.
- Leczenie objawu zamiast przyczyny – lejek bywa skutkiem pominiętej nieliniowości lub interakcji; najpierw sprawdź, czy model jest dobrze określony.
- Transformacja bez sprawdzenia skutków – logarytm zmienia interpretację współczynników i nie zawsze usuwa heteroskedastyczność (w przykładzie nie usunął).
Najczęstsze pytania
Co to jest heterogeniczność wariancji?
To sytuacja, w której rozrzut wyników nie jest jednakowy: w regresji rozrzut reszt zmienia się wraz z wartością predyktora (heteroskedastyczność), a w porównaniach grup grupy mają różne wariancje. Najczęściej rozrzut rośnie razem z przewidywanym wynikiem, co na wykresie reszt wygląda jak lejek.
Czym różni się heterogeniczność wariancji od heteroskedastyczności?
To w gruncie rzeczy to samo zjawisko. Określenia „heterogeniczność” lub „niejednorodność wariancji” używa się zwykle przy porównywaniu grup (test t, ANOVA), a „heteroskedastyczność” – przy regresji z predyktorami ciągłymi. Przeciwieństwami są odpowiednio homogeniczność wariancji i homoskedastyczność.
Jak sprawdzić heteroskedastyczność w regresji?
Obejrzyj wykres reszt względem wartości dopasowanych: lejek, klepsydra lub łuk wskazują na problem. Uzupełniająco wykonaj test Breuscha–Pagana (w R lmtest::bptest()) albo test Cooka–Weisberga (car::ncvTest()). Pamiętaj, że w dużych próbach testy wykrywają nawet drobne, bez znaczenia praktycznego wzory.
Co to są odporne błędy standardowe HC3?
To błędy standardowe współczynników regresji liczone tak, że pozostają poprawne także przy heteroskedastyczności o nieznanym kształcie. Wariant HC3 dodatkowo koryguje wpływ obserwacji o dużej dźwigni, dlatego działa dobrze także w małych próbach. W R: lmtest::coeftest(model, vcov. = sandwich::vcovHC(model, type = "HC3")).
Czy przy heteroskedastyczności wyniki regresji są nieważne?
Nie. Współczynniki pozostają nieobciążone – błędne są klasyczne błędy standardowe, a więc wartości p i przedziały ufności. Wystarczy zwykle podać wyniki z odpornymi błędami standardowymi HC3; w przykładzie na tej stronie związek pozostał istotny (p = .016), ale przedział ufności nachylenia był dwa razy szerszy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cook, R. D., & Weisberg, S. (1983). Diagnostics for heteroscedasticity in regression. Biometrika, 70(1), 1–10. https://doi.org/10.1093/biomet/70.1.1 ● Otwarty dostęp: pełny tekst
- Hayes, A. F., & Cai, L. (2007). Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation. Behavior Research Methods, 39(4), 709–722. https://doi.org/10.3758/bf03192961 ● Otwarty dostęp
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Rosopa, P. J., Schaffer, M. M., & Schroeder, A. N. (2013). Managing heteroscedasticity in general linear models. Psychological Methods, 18(3), 335–351. https://doi.org/10.1037/a0032553
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
Cytowania BibTeX
@article{breusch1979simple, author={Breusch, T. S. and Pagan, A. R.}, title={{A simple test for heteroscedasticity and random coefficient variation}}, journal={Econometrica}, year={1979}, volume={47}, number={5}, pages={1287--1294}, doi={10.2307/1911963}}@article{cook1983diagnostics, author={Cook, R. Dennis and Weisberg, Sanford}, title={{Diagnostics for heteroscedasticity in regression}}, journal={Biometrika}, year={1983}, volume={70}, number={1}, pages={1--10}, doi={10.1093/biomet/70.1.1}}@article{hayes2007using, author={Hayes, Andrew F. and Cai, Li}, title={{Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation}}, journal={Behavior Research Methods}, year={2007}, volume={39}, number={4}, pages={709--722}, doi={10.3758/bf03192961}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{rosopa2013managing, author={Rosopa, Patrick J. and Schaffer, Meline M. and Schroeder, Amber N.}, title={{Managing heteroscedasticity in general linear models}}, journal={Psychological Methods}, year={2013}, volume={18}, number={3}, pages={335--351}, doi={10.1037/a0032553}}@article{white1980heteroskedasticity, author={White, Halbert}, title={{A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity}}, journal={Econometrica}, year={1980}, volume={48}, number={4}, pages={817--838}, doi={10.2307/1912934}}