Co sprawdza test Shapiro-Wilka?
Test Shapiro-Wilka (Shapiro i Wilk, 1965) jest jednym z najczęściej stosowanych testów normalności rozkładu. Porównuje uporządkowane wyniki z próby z wartościami, jakich należałoby oczekiwać, gdyby dane pochodziły z rozkładu normalnego. Wynikiem jest statystyka W z przedziału od 0 do 1 oraz wartość p.
- Hipoteza zerowa (H0): dane pochodzą z populacji o rozkładzie normalnym.
- Hipoteza alternatywna (H1): rozkład w populacji nie jest normalny.
Funkcja shapiro.test() w R korzysta z algorytmu Roystona (1995) i przyjmuje od 3 do 5000 obserwacji. W porównaniach symulacyjnych test Shapiro-Wilka ma zwykle większą moc niż test Kołmogorowa-Smirnowa czy Lillieforsa (Razali i Wah, 2011), dlatego jest polecany jako podstawowy test normalności (Ghasemi i Zahediasl, 2012).
Jak interpretować wynik testu Shapiro-Wilka?
| Wynik | Co oznacza | Czego nie oznacza |
|---|---|---|
| p ≥ 0,05 | Brak podstaw do odrzucenia hipotezy, że dane pochodzą z rozkładu normalnego. | Nie dowodzi, że rozkład jest normalny — przy małej próbie test często nie wykrywa nawet wyraźnej skośności. |
| p < 0,05 | Rozkład w próbie istotnie odbiega od normalnego. | Nie mówi, jak duże jest odchylenie ani czy przeszkadza w planowanej analizie — przy dużej próbie istotne bywają odchylenia bez znaczenia praktycznego. |
| W bliskie 1 | Uporządkowane wyniki dobrze zgadzają się z wartościami oczekiwanymi przy normalności. | Nie ma uniwersalnego progu W — ta sama wartość W może być istotna przy dużym n i nieistotna przy małym. |
W praktyce interpretacja przebiega w czterech krokach:
- Ustal, co testujesz. W teście t i ANOVA założenie dotyczy rozkładu w każdej grupie, a w regresji — reszt modelu, nie surowych zmiennych.
- Odczytaj W i p. Przy p < 0,05 odrzucasz hipotezę o normalności, przy p ≥ 0,05 nie masz podstaw, by ją odrzucić.
- Obejrzyj wykresy. Histogram i wykres kwantyl-kwantyl pokazują, jak rozkład odbiega od normalnego: czy jest skośny, ma grube ogony (wysoką kurtozę) czy pojedyncze obserwacje odstające.
- Oceń znaczenie dla analizy. Weź pod uwagę liczebność, odporność wybranej metody i to, czy odchylenie może zmienić wnioski.
Przykład: test wiedzy i czas reakcji
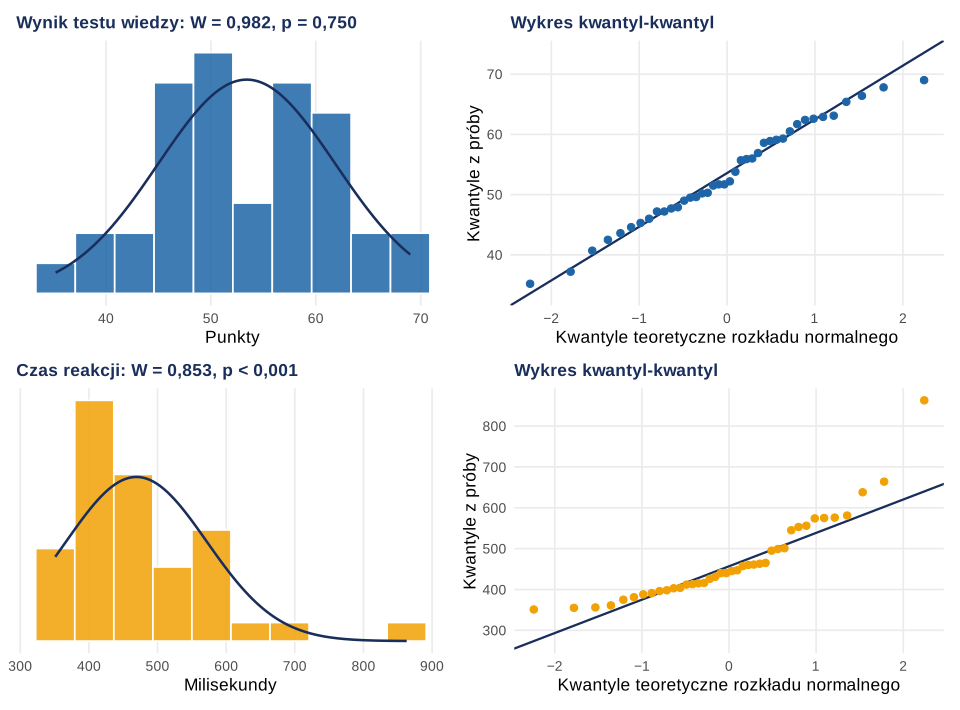
Dla dwóch zmiennych zmierzonych u 40 osób test Shapiro-Wilka w R dał następujące wyniki:
- Wynik testu wiedzy: W = 0,982, p = 0,750. Brak podstaw do odrzucenia normalności; skośność wynosi −0,08, a punkty na wykresie kwantyl-kwantyl leżą blisko prostej.
- Czas reakcji: W = 0,853, p < 0,001. Rozkład istotnie odbiega od normalnego — jest wyraźnie prawoskośny (skośność 1,68), co widać na histogramie i w odchyleniu punktów od prostej na wykresie kwantyl-kwantyl.
Dlaczego wynik testu zależy od liczebności próby?
Test Shapiro-Wilka, jak każdy test istotności, ma moc zależną od liczebności. Poniższa symulacja w R pokazuje, jak często test odrzucał normalność (p < 0,05) przy danych z trzech rozkładów: normalnego, lekko skośnego (rozkład gamma, skośność ≈ 0,63) i silnie skośnego (rozkład wykładniczy, skośność 2).
| Liczebność n | Rozkład normalny | Lekka skośność (≈ 0,63) | Silna skośność (= 2) |
|---|---|---|---|
| 10 | 4,7% | 7,8% | 45,1% |
| 20 | 5,5% | 13,5% | 82,7% |
| 50 | 5,0% | 32,6% | 100,0% |
| 100 | 5,5% | 61,1% | 100,0% |
| 300 | 4,9% | 98,9% | 100,0% |
| 1000 | 4,9% | 100,0% | 100,0% |
| 5000 | 4,2% | 100,0% | 100,0% |
Wnioski z symulacji:
- Przy danych naprawdę normalnych test odrzuca normalność w około 5% prób (4,2%–5,5%), czyli zgodnie z poziomem istotności.
- Przy małej próbie (n = 10) lekka skośność jest wykrywana tylko w 7,8% przypadków, a nawet silna — w 45,1%. Wynik p ≥ 0,05 przy małym n niewiele więc mówi.
- Przy dużej próbie ta sama lekka skośność jest wykrywana w 98,9% prób już przy n = 300 i we wszystkich próbach przy n ≥ 1000. Test „alarmuje”, choć przy takiej liczebności test t i ANOVA są zwykle odporne na tak niewielkie odchylenie (zob. centralne twierdzenie graniczne).
Dlatego raport APA zaleca opierać ocenę założeń na wykresach, a nie na samych testach (Wilkinson i Task Force on Statistical Inference, 1999), a Field i Wilcox (2017) odradzają traktowanie testów normalności jako „bramki” wyboru metody.
Co zrobić, gdy test Shapiro-Wilka da p < 0,05?
- Sprawdź, czy normalność jest w ogóle potrzebna. Przy kilkudziesięciu osobach w grupie test t i ANOVA dobrze znoszą umiarkowane odchylenia; ważniejsze są wartości odstające i nierówne wariancje.
- Testuj właściwy obiekt — reszty modelu lub rozkłady w grupach, a nie połączoną próbę.
- Rozważ metodę odporną (np. średnie przycięte, bootstrap) i porównaj jej wynik z analizą klasyczną (Field i Wilcox, 2017).
- Rozważ test nieparametryczny, np. test Manna-Whitneya, pamiętając, że odpowiada on na nieco inne pytanie niż porównanie średnich (zob. testy nieparametryczne).
- Nie wybieraj testu wyłącznie na podstawie wyniku testu normalności. Rochon i in. (2012) odradzają taką dwuetapową procedurę; metodę lepiej zaplanować z góry i opisać analizę wrażliwości.
Szerzej o doborze testu piszę w poradniku jak dobrać test statystyczny do hipotezy.
Przykład w R
Kod odtwarza przykład, rysunek i symulację z tej strony. Wyniki poniżej to dokładny wydruk z R.
1. Test Shapiro-Wilka i wykresy diagnostyczne
R
set.seed(4)
wiedza <- round(rnorm(40, mean = 50, sd = 10), 1)        # wynik testu wiedzy (punkty)
set.seed(7)
czas   <- round(350 + rexp(40, rate = 1 / 120))          # czas reakcji (ms), rozkład prawoskośny

shapiro.test(wiedza)
shapiro.test(czas)

# Diagnostyka graficzna: histogram i wykres kwantyl-kwantyl
par(mfrow = c(1, 2))
hist(czas, main = "Czas reakcji", xlab = "ms")
qqnorm(czas); qqline(czas)
Wynik w R
	Shapiro-Wilk normality test
data:  wiedza
W = 0.98165, p-value = 0.7504
	Shapiro-Wilk normality test
data:  czas
W = 0.85256, p-value = 0.0001039
2. Symulacja: moc testu a liczebność próby
R
# Jak często test odrzuca normalność (p < 0,05) przy różnych liczebnościach?
set.seed(2026)
ns   <- c(10, 20, 50, 100, 300, 1000, 5000)
reps <- 2000
rej  <- function(gen, n) mean(replicate(reps, shapiro.test(gen(n))$p.value < .05))
sim  <- data.frame(n = ns,
  normalny       = sapply(ns, function(n) rej(rnorm, n)),
  lekka_skosnosc = sapply(ns, function(n) rej(function(k) rgamma(k, shape = 10), n)),
  silna_skosnosc = sapply(ns, function(n) rej(rexp, n)))
sim
Wynik w R
     n normalny lekka_skosnosc silna_skosnosc
1   10   0.0465         0.0785         0.4505
2   20   0.0550         0.1350         0.8265
3   50   0.0495         0.3265         0.9995
4  100   0.0545         0.6110         1.0000
5  300   0.0485         0.9885         1.0000
6 1000   0.0490         1.0000         1.0000
7 5000   0.0425         1.0000         1.0000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Jak zapisać wynik testu Shapiro-Wilka (APA 7)?
Podaj statystykę W, wartość p i — jeśli to możliwe — wskaż, którego elementu analizy dotyczy test oraz jaka decyzja z niego wynikła.
Najczęstsze błędy przy interpretacji testu Shapiro-Wilka
- „p > 0,05, więc rozkład jest normalny”. Brak istotności nie dowodzi zgodności — zwłaszcza przy małym n.
- Testowanie surowej zmiennej zamiast reszt w regresji lub połączonej próby zamiast grup w teście t.
- Automatyczna zmiana metody po wyniku p < 0,05 przy dużej próbie, choć odchylenie jest praktycznie nieistotne.
- Pomijanie wykresów, które pokazują rodzaj problemu: skośność, grube ogony, obserwacje odstające.
- Raportowanie samego „założenie normalności spełniono” bez W, p i informacji, czego dotyczył test.
Najczęstsze pytania
Co oznacza p > 0,05 w teście Shapiro-Wilka?
Brak podstaw do odrzucenia hipotezy zerowej, że dane pochodzą z rozkładu normalnego. Nie jest to dowód normalności — przy małej liczebności test ma niską moc i może nie wykryć nawet wyraźnej skośności, dlatego wynik warto uzupełnić histogramem i wykresem kwantyl-kwantyl.
Co oznacza statystyka W?
W mierzy, jak dobrze uporządkowane wyniki z próby odpowiadają wartościom oczekiwanym przy rozkładzie normalnym. Przyjmuje wartości do 1; im bliżej 1, tym lepsza zgodność. O istotności decyduje wartość p, bo rozkład W zależy od liczebności próby.
Czy przy dużej próbie trzeba wykonywać test Shapiro-Wilka?
Zwykle nie warto opierać na nim decyzji. Przy setkach obserwacji test wykrywa nawet nieistotne praktycznie odchylenia, a test t czy ANOVA są przy dużych grupach dość odporne na umiarkowane odchylenia od normalności. Ważniejsze są wykresy, wartości odstające i kształt rozkładu.
Dla jakiej liczebności można użyć testu Shapiro-Wilka?
Funkcja shapiro.test() w R przyjmuje od 3 do 5000 obserwacji. Przy bardzo małych próbach test ma jednak niską moc, a przy bardzo dużych reaguje na drobne odchylenia, więc wynik zawsze trzeba interpretować w kontekście liczebności.
Czy normalność sprawdzam w całej próbie, czy w każdej grupie?
To zależy od analizy. Przy teście t lub ANOVA założenie dotyczy rozkładu w każdej grupie (lub reszt modelu), a w regresji — reszt modelu, a nie surowych zmiennych. Test na całej, połączonej próbie może wprowadzać w błąd, gdy grupy mają różne średnie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikCzym jest centralne twierdzenie graniczne?
Intuicja, warunki i interaktywna symulacja pokazująca, dlaczego rozkład średnich może zbliżać się do normalnego, choć surowe dane są skośne.
Czytaj →PoradnikStatystyka do pracy licencjackiej: analiza krok po kroku
Jak zaplanować analizę statystyczną do pracy licencjackiej, przygotować ankietę i bazę danych oraz otrzymać wyniki, które da się obronić.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Field, A. P., & Wilcox, R. R. (2017). Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers. Behaviour Research and Therapy, 98, 19–38. https://doi.org/10.1016/j.brat.2017.05.013
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21–33.
- Rochon, J., Gondan, M., & Kieser, M. (2012). To test or not to test: Preliminary assessment of normality when comparing two independent samples. BMC Medical Research Methodology, 12, Artykuł 81. https://doi.org/10.1186/1471-2288-12-81
- Royston, P. (1995). Remark AS R94: A remark on algorithm AS 181: The W-test for normality. Journal of the Royal Statistical Society: Series C (Applied Statistics), 44(4), 547–551. https://doi.org/10.2307/2986146
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594
Cytowania BibTeX
@article{field2017robust, author={Field, Andy P. and Wilcox, Rand R.}, title={Robust statistical methods: A primer for clinical psychology and experimental psychopathology researchers}, journal={Behaviour Research and Therapy}, year={2017}, volume={98}, pages={19--38}, doi={10.1016/j.brat.2017.05.013}}@article{ghasemi2012normality, author={Ghasemi, Asghar and Zahediasl, Saleh}, title={Normality tests for statistical analysis: A guide for non-statisticians}, journal={International Journal of Endocrinology and Metabolism}, year={2012}, volume={10}, number={2}, pages={486--489}, doi={10.5812/ijem.3505}}@article{razali2011power, author={Razali, Nornadiah Mohd and Wah, Yap Bee}, title={Power comparisons of {S}hapiro-{W}ilk, {K}olmogorov-{S}mirnov, {L}illiefors and {A}nderson-{D}arling tests}, journal={Journal of Statistical Modeling and Analytics}, year={2011}, volume={2}, number={1}, pages={21--33}}@article{rochon2012test, author={Rochon, Justine and Gondan, Matthias and Kieser, Meinhard}, title={To test or not to test: Preliminary assessment of normality when comparing two independent samples}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, pages={81}, doi={10.1186/1471-2288-12-81}}@article{royston1995remark, author={Royston, Patrick}, title={Remark {AS} {R94}: A remark on algorithm {AS} 181: The {W}-test for normality}, journal={Journal of the Royal Statistical Society: Series C (Applied Statistics)}, year={1995}, volume={44}, number={4}, pages={547--551}, doi={10.2307/2986146}}@article{shapiro1965analysis, author={Shapiro, Samuel S. and Wilk, Martin B.}, title={An analysis of variance test for normality (complete samples)}, journal={Biometrika}, year={1965}, volume={52}, number={3--4}, pages={591--611}, doi={10.1093/biomet/52.3-4.591}}@article{wilkinson1999statistical, author={Wilkinson, Leland and {Task Force on Statistical Inference}}, title={Statistical methods in psychology journals: Guidelines and explanations}, journal={American Psychologist}, year={1999}, volume={54}, number={8}, pages={594--604}, doi={10.1037/0003-066X.54.8.594}}