Jak czytać wydruk SPSS i po co ten poradnik
Po kliknięciu „OK” SPSS wyświetla kilka tabel naraz, a w każdej z nich kilkanaście liczb, z których większości nie potrzebujesz. Kłopot w tym, które są ważne: który wiersz testu t przepisać, czy „Sig.” to wartość p, co zrobić z „.000” i dlaczego przy tabeli krzyżowej SPSS podaje pięć testów chi-kwadrat. Ten poradnik przechodzi przez osiem najczęstszych wydruków – od statystyk opisowych po alfę Cronbacha – i przy każdej tabeli wyjaśnia, co odczytać, co pominąć, jak przepisać wynik w stylu APA i jakie błędy popełnia się najczęściej.
Wszystkie tabele pochodzą z jednego zbioru danych: badania 180 osób studiujących, losowo przydzielonych do grupy kontrolnej, treningu relaksacji albo treningu uważności. To ten sam przykład, który opisujemy we wpisach jak opisać wyniki w stylu APA i wyniki badań własnych – przykładowy rozdział, więc liczby z wydruków możesz porównać z gotowymi zdaniami (dane symulowane).
Jak powstały tabele. Nie są to zrzuty ekranu. Odtworzyliśmy układ tabel SPSS z angielskimi etykietami z dokumentacji IBM (IBM, 2026), a liczby policzyliśmy w R tak, jak liczy je SPSS (kod na końcu wpisu). Pogrubione liczby przepisujesz do pracy. W Twoim wydruku może się różnić liczba miejsc po przecinku, a zależnie od wersji programu także niektóre etykiety – np. nowsze wersje w tabelach testu t zamiast kolumny Sig. (2-tailed) pokazują dwie: One-Sided p i Two-Sided p. Polska wersja SPSS ma przetłumaczone nazwy tabel i kolumn, ale tłumaczenia nie są jednolite (nawet polska dokumentacja IBM nazywa tę samą procedurę raz „analizą rzetelności”, raz „analizą niezawodności”), dlatego trzymamy się nazw angielskich, a ich znaczenie wyjaśniamy po polsku.
Pięć zasad, które działają przy każdej tabeli
- Zacznij od liczebności. N mniejsze, niż się spodziewasz, oznacza braki danych pominięte przez SPSS.
- „Sig.” to wartość p. W zależności od tabeli kolumna nazywa się Sig., Sig. (2-tailed), Asymp. Sig. (2-sided), Exact Sig., Approx. Sig. albo Two-Sided p (IBM, 2026). Do pracy przepisuj wartość dwustronną, chyba że test jednostronny zaplanowałeś przed badaniem (zob. test jednostronny i dwustronny).
- „.000” nie oznacza zera. Dokumentacja IBM wprost opisuje sytuację, w której wartość istotności jest tak mała, że zostaje wyświetlona jako .000 (IBM, 2026). W pracy zapisz p < .001 – więcej w następnej sekcji.
- SPSS pomija zero przed kropką przy wszystkich liczbach, np. „.819” dla odchylenia standardowego. W stylu APA zero pomija się tylko przy wartościach, które nie mogą przekroczyć 1, takich jak p, r czy α, a pozostałe zapisuje z zerem: SD = 0.82 (American Psychological Association, 2024).
- Wydruk to materiał roboczy, a nie tabela do pracy. Wybrane liczby przepisz do zdań i tabel w stylu APA (zob. tabele APA – wzory i przykłady).
Rysunek 1 streszcza, co przepisać z trzech wydruków, które sprawiają najwięcej kłopotów.
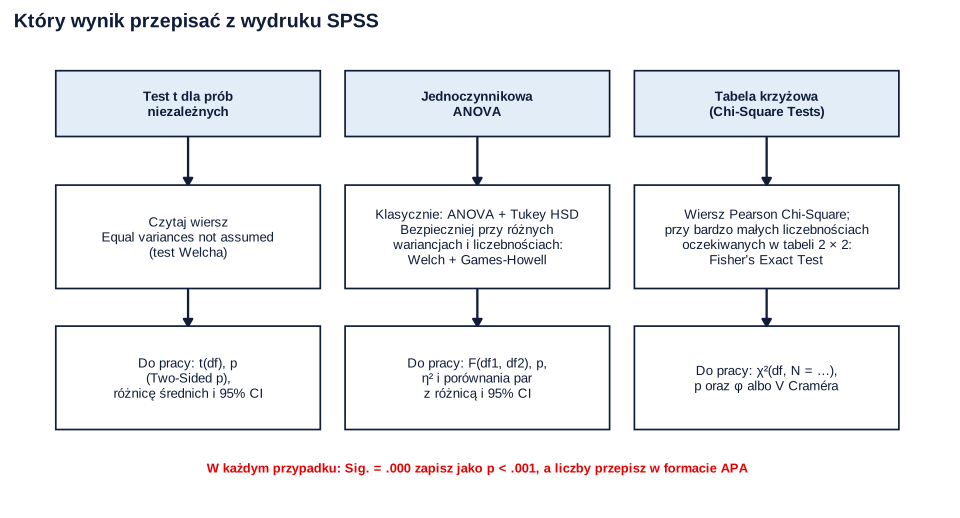
Sig. = .000 i istotność dwustronna
SPSS zaokrągla wartości p do trzech miejsc po kropce. Jeśli prawdziwa wartość wynosi na przykład 0.00007, na wydruku zobaczysz „.000”. Wartość p nigdy nie jest jednak równa zeru, dlatego zapis „p = .000” jest błędny. Przewodnik APA zaleca podawać dokładne wartości p z dwoma lub trzema miejscami po przecinku, a wartości mniejsze od .001 zapisywać jako p < .001 (American Psychological Association, 2024). Jeśli Twoja wersja programu pokazuje w tym miejscu „<.001”, zasada jest ta sama.
Gdy chcesz zobaczyć więcej cyfr, kliknij dwukrotnie tabelę w oknie wyników, zaznacz komórkę, otwórz Cell Properties i na karcie Format Value zwiększ liczbę miejsc po przecinku (Decimals) – tak zmianę formatu liczb opisuje samouczek IBM (IBM, 2026).
Istotność dwustronna (Sig. (2-tailed), Two-Sided p) to wartość p dla hipotezy bez założonego kierunku. Wartość jednostronna (One-Sided p) jest w teście t o połowę mniejsza, ale wolno ją podać tylko wtedy, gdy kierunek przewidziałeś i zapisałeś przed zebraniem danych – nie po to, by „wyciągnąć” wynik poniżej .05. Pamiętaj też, że wartość p nie mówi, jak duży jest efekt (Wasserstein i Lazar, 2016), dlatego przy każdym teście podaj również wielkość efektu.
Statystyki opisowe (Descriptive Statistics)
Tabelę Descriptive Statistics daje procedura Analyze > Descriptive Statistics > Descriptives. Domyślnie zawiera N, minimum, maksimum, średnią i odchylenie standardowe; skośność i kurtozę z błędami standardowymi dodasz w oknie Options (IBM, 2026). Szczegóły statystyk opisuje hasło statystyka opisowa.
| N | Minimum | Maximum | Mean | Std. Deviation | Skewness | Kurtosis | |||
|---|---|---|---|---|---|---|---|---|---|
| Statistic | Statistic | Statistic | Statistic | Statistic | Statistic | Std. Error | Statistic | Std. Error | |
| Stres przed treningiem | 180 | 1.33 | 5.00 | 3.136 | .819 | .003 | .181 | −.770 | .360 |
| Wsparcie społeczne | 180 | 2.42 | 7.00 | 5.125 | .982 | −.207 | .181 | −.187 | .360 |
| Samoskuteczność | 180 | 19.00 | 40.00 | 28.739 | 4.324 | −.007 | .181 | −.315 | .360 |
| Valid N (listwise) | 180 | ||||||||
- Co odczytać: N, Mean i Std. Deviation – to trafia do tekstu lub tabeli statystyk opisowych. Skośność i kurtozę podaj, gdy opisujesz kształt rozkładów.
- Co pominąć w pracy: Valid N (listwise), czyli liczbę osób bez braków we wszystkich zmiennych. Minimum i maksimum zwykle nie trafiają do tekstu, ale je przejrzyj: wynik poza zakresem skali zdradza błąd w danych.
- Skośność i kurtoza: dla rozkładu normalnego obie wynoszą 0, bo SPSS podaje tzw. kurtozę nadwyżkową. Dokumentacja IBM podaje orientacyjną regułę, że skośność większa niż dwukrotność jej błędu standardowego wskazuje na asymetrię (IBM, 2026). W dużych próbach błąd standardowy jest jednak mały, więc reguła wskazuje nawet niewielką asymetrię – oceniaj też samą wartość (zob. jak sprawdzić normalność rozkładu).
Kurtoza stresu wynosi tu −0.770, a we wpisie o wynikach w stylu APA podaliśmy −0.81 dla tych samych danych. Oba wyniki są poprawne: programy liczą skośność i kurtozę różnymi estymatorami (Joanes i Gill, 1998). SPSS stosuje wzory z poprawką na wielkość próby, a domyślne ustawienie funkcji describe() z pakietu psych w R – inne; w kodzie na końcu wpisu używamy argumentu type = 2, który daje wartości jak w SPSS. W pracy podaj, jakim programem liczyłeś statystyki.
Test t dla prób niezależnych
Procedura Analyze > Compare Means > Independent-Samples T Test (w nowszych wersjach menu nazywa się Compare Means and Proportions) daje dwie tabele: Group Statistics ze statystykami opisowymi grup i Independent Samples Test z wynikiem testu (IBM, 2026). W przykładzie porównujemy stres przed treningiem u kobiet i mężczyzn.
| Płeć | N | Mean | Std. Deviation | Std. Error Mean |
|---|---|---|---|---|
| kobieta | 111 | 3.275 | .823 | .078 |
| mężczyzna | 69 | 2.913 | .766 | .092 |
| Levene’s Test for Equality of Variances | t-test for Equality of Means | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| F | Sig. | t | df | One-Sided p | Two-Sided p | Mean Difference | Std. Error Difference | 95% Confidence Interval of the Difference | ||
| Lower | Upper | |||||||||
| Equal variances assumed | .496 | .482 | 2.943 | 178 | .002 | .004 | .362 | .123 | .119 | .604 |
| Equal variances not assumed | 2.993 | 152.273 | .002 | .003 | .362 | .121 | .123 | .601 | ||
Tabela Independent Samples Test zawiera dwa testy dla tych samych danych. Wiersz Equal variances assumed to klasyczny test t Studenta, który zakłada równe wariancje w grupach. Wiersz Equal variances not assumed to test Welcha, który tego nie zakłada – stąd ułamkowe stopnie swobody (152.273). Pierwsze dwie kolumny to test Levene’a, który sprawdza, czy wariancje się różnią. W wersji 31 można go dodatkowo zamówić opcją Homogeneity of variance test, a wtedy SPSS pokazuje osobną tabelę z kilkoma wariantami testu (IBM, 2026).
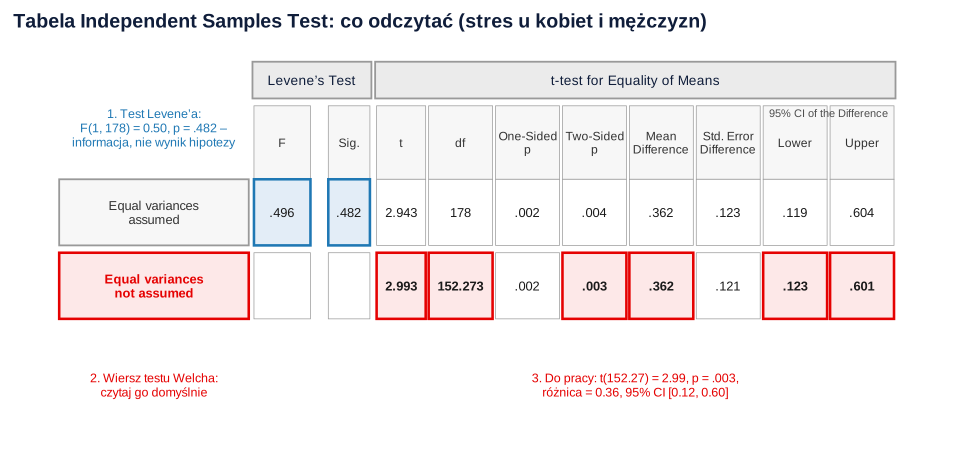
Który wiersz czytać? Tradycyjna reguła mówi: jeśli Sig. testu Levene’a jest większe od .05, czytaj pierwszy wiersz, a jeśli mniejsze – drugi. Ta dwuetapowa procedura ma jednak wadę: Zimmerman (2004) pokazał, że nie chroni ona poziomu istotności i zwykle pogarsza sytuację, a najlepszą ochronę daje bezwarunkowe stosowanie testu dla nierównych wariancji. Delacre i in. (2017) zalecają więc w psychologii test Welcha jako wybór domyślny, bo lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy wariancje są równe. Dlatego czytaj wiersz Equal variances not assumed, a test Levene’a traktuj jako informację o danych, nie jako wynik hipotezy. W przykładzie oba wiersze prowadzą do tego samego wniosku (p = .004 i .003), ale przy nierównych grupach i wariancjach mogą się różnić.
- Co odczytać: z Group Statistics – N, Mean i Std. Deviation obu grup; z wiersza Welcha – t, df, Two-Sided p, Mean Difference i 95% przedział ufności różnicy.
- Co pominąć: Std. Error Mean, Std. Error Difference oraz, zwykle, One-Sided p.
- Wielkość efektu: od wersji 27 SPSS może wyświetlić tabelę wielkości efektu dla testów t (opcja Estimate effect sizes; IBM, 2026). Jeśli Twoja wersja jej nie ma, policz d Cohena osobno – w przykładzie d = 0.45, 95% CI [0.15, 0.75] (zob. d Cohena).
Typowe błędy: przepisanie Sig. testu Levene’a jako wyniku hipotezy, czytanie pierwszego wiersza „bo jest pierwszy”, podanie t z wiersza Welcha ze stopniami swobody z wiersza Studenta (178) i zaokrąglanie ułamkowych stopni swobody do liczby całkowitej. Więcej o samym teście w haśle test t dla prób niezależnych.
Test t dla prób zależnych
Przy dwóch pomiarach tych samych osób procedura Paired-Samples T Test daje trzy tabele: statystyki pomiarów, ich korelację (Paired Samples Correlations) i test (Paired Samples Test; IBM, 2026). W przykładzie porównujemy stres przed treningiem i po nim w grupie uważności (n = 60).
| Paired Differences | t | df | One-Sided p | Two-Sided p | |||||
|---|---|---|---|---|---|---|---|---|---|
| Mean | Std. Deviation | Std. Error Mean | 95% Confidence Interval of the Difference | ||||||
| Lower | Upper | ||||||||
| Pair 1: stres przed – stres po | .753 | .494 | .064 | .625 | .880 | 11.796 | 59 | .000 | .000 |
- Co odczytać: średnią różnic (Mean), jej przedział ufności, t, df i Two-Sided p. Kolumna Mean dotyczy różnicy „pierwsza zmienna minus druga”, więc jej znak zależy od kolejności zmiennych w parze – tu 0.753 oznacza spadek stresu.
- Co pominąć: korelację z tabeli Paired Samples Correlations (r = .834). Mówi ona tylko, że osoby z wyższym stresem przed treningiem miały go wyższy także po nim; nie jest testem różnicy średnich.
- Wielkość efektu: przy pomiarach zależnych napisz, którą miarę podajesz. dz (średnia różnica podzielona przez SD różnic) wynosi tu 1.52; SPSS pozwala wybrać sposób standaryzacji w opcjach wielkości efektu (IBM, 2026).
Typowe błędy: opisywanie korelacji jako wyniku testu, podanie p = .000 i przepisanie średnich z tabeli różnic zamiast z tabeli statystyk obu pomiarów. Hasło test t dla prób zależnych wyjaśnia założenia testu.
Jednoczynnikowa ANOVA
Procedura Analyze > Compare Means > One-Way ANOVA wyświetla tabelę ANOVA, a pozostałe tabele dodajesz w oknie Options (Descriptive, Homogeneity of variance test, Brown-Forsythe, Welch) i Post Hoc. W przykładzie porównujemy stres po czterech tygodniach w trzech warunkach – to analiza dla hipotez H1 i H2 z przykładowego rozdziału wyników.
| Levene Statistic | df1 | df2 | Sig. | |
|---|---|---|---|---|
| Based on Mean | .642 | 2 | 177 | .527 |
| Based on Median | .620 | 2 | 177 | .539 |
Tabela Tests of Homogeneity of Variances zawiera warianty testu Levene’a liczone od średniej, mediany (także z poprawionymi stopniami swobody) i średniej przyciętej (IBM, 2026); w tabeli pokazaliśmy dwa pierwsze. Klasyczny test Levene’a to wiersz Based on Mean. Przy rozkładach wyraźnie odbiegających od normalnego bardziej odporny jest wariant oparty na medianie (Brown i Forsythe, 1974). W przykładzie wariancje nie różnią się istotnie, F(2, 177) = 0.64, p = .527.
| Sum of Squares | df | Mean Square | F | Sig. | |
|---|---|---|---|---|---|
| Between Groups | 15.576 | 2 | 7.788 | 10.088 | .000 |
| Within Groups | 136.648 | 177 | .772 | ||
| Total | 152.224 | 179 |
Tabela ANOVA to główny wynik: przepisz F, stopnie swobody z wierszy Between Groups i Within Groups oraz Sig. Sumy kwadratów przydadzą się do obliczenia η² = 15.576 / 152.224 = .10; od wersji 27 SPSS może też wyświetlić tabelę ANOVA Effect Sizes (IBM, 2026).
| Statistic | df1 | df2 | Sig. | |
|---|---|---|---|---|
| Welch | 9.446 | 2 | 117.528 | .000 |
| Brown-Forsythe | 10.088 | 2 | 174.077 | .000 |
Tabela Robust Tests of Equality of Means zawiera testy, które nie zakładają równych wariancji. IBM opisuje statystyki Welcha i Browna-Forsythe’a jako lepsze od klasycznego F, gdy założenie równości wariancji nie jest spełnione (IBM, 2026), a Delacre i in. (2019) zalecają w psychologii domyślne stosowanie testu Welcha. Uwaga na nazwy: Brown-Forsythe w tej tabeli to test równości średnich, a nie wariant testu Levene’a z poprzedniej tabeli. Przy równolicznych grupach jego statystyka jest równa klasycznemu F (tu 10.088) – różnią się tylko stopnie swobody.
| Test | (I) warunek | (J) warunek | Mean Difference (I-J) | Std. Error | Sig. | 95% Confidence Interval | |
|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | ||||||
| Tukey HSD | uważność | kontrola | −.719* | .160 | .000 | −1.099 | −.340 |
| Tukey HSD | uważność | relaksacja | −.394* | .160 | .039 | −.774 | −.015 |
| Tukey HSD | relaksacja | kontrola | −.325 | .160 | .109 | −.704 | .054 |
| Games-Howell | uważność | kontrola | −.719* | .166 | .000 | −1.114 | −.325 |
| Games-Howell | uważność | relaksacja | −.394* | .153 | .030 | −.759 | −.030 |
| Games-Howell | relaksacja | kontrola | −.325 | .161 | .113 | −.708 | .058 |
Tabela Multiple Comparisons pokazuje porównania par. SPSS wypisuje każdą parę dwa razy (np. kontrola–uważność i uważność–kontrola) i oznacza gwiazdką różnice istotne na poziomie .05 (IBM, 2026); w odtworzeniu zostawiliśmy po jednym wierszu dla pary. Test Tukeya (Tukey HSD) zakłada równe wariancje, a test Gamesa–Howella – nie. Sauder i DeMars (2019) sprawdzili w symulacji 18 procedur porównań parami dostępnych w SPSS: przy nierównych liczebnościach i wariancjach błąd I rodzaju właściwie kontrolowały tylko cztery testy zaprojektowane na taką sytuację, a spośród nich test Gamesa–Howella miał nieco najwyższą moc. Więcej w haśle testy post hoc i poradniku ANOVA krok po kroku.
Typowe błędy: podanie wyniku testu Levene’a zamiast wyniku ANOVA, zamiana kolejności stopni swobody, przepisanie wszystkich sześciu wierszy porównań i wybór testu LSD, który nie koryguje wielu porównań (IBM, 2026).
Macierz korelacji (Correlations)
Procedura Analyze > Correlate > Bivariate tworzy macierz, w której dla każdej pary zmiennych są trzy wiersze: współczynnik (Pearson Correlation), dwustronne p (Sig. (2-tailed)) i liczebność (N). Przy zaznaczonej opcji Flag significant correlations korelacje istotne na poziomie .05 SPSS oznacza jedną gwiazdką, a na poziomie .01 – dwiema (IBM, 2026).
| Stres przed treningiem | Wsparcie społeczne | Samoskuteczność | ||
|---|---|---|---|---|
| Stres przed treningiem | Pearson Correlation | 1 | −.376** | −.532** |
| Sig. (2-tailed) | .000 | .000 | ||
| N | 180 | 180 | 180 | |
| Wsparcie społeczne | Pearson Correlation | −.376** | 1 | .399** |
| Sig. (2-tailed) | .000 | .000 | ||
| N | 180 | 180 | 180 | |
| Samoskuteczność | Pearson Correlation | −.532** | .399** | 1 |
| Sig. (2-tailed) | .000 | .000 | ||
| N | 180 | 180 | 180 |
- Co odczytać: połowę macierzy – każda korelacja występuje dwa razy, nad i pod przekątną, a jedynki na przekątnej to korelacje zmiennych z samymi sobą.
- Jak zapisać: współczynnik ze stopniami swobody (N − 2), przedziałem ufności i dokładnym p; gwiazdek z wydruku nie przepisuj do tekstu. Przy kilku zmiennych przygotuj tabelę korelacji w APA.
Typowe błędy: wklejenie całej macierzy z wierszami Sig. i N, zapis „r = −.376**”, podanie N zamiast stopni swobody i język przyczynowy („wsparcie obniża stres”) przy danych z jednego pomiaru (zob. korelacja Pearsona).
Tabela krzyżowa i test chi-kwadrat
Procedura Analyze > Descriptive Statistics > Crosstabs daje tabelę krzyżową (Crosstabulation), a po zaznaczeniu Chi-square w oknie Statistics – tabelę Chi-Square Tests. Procenty w wierszach i liczebności oczekiwane (Expected Count) dodasz w oknie Cells. W przykładzie sprawdzamy, czy kobiety i mężczyźni równie często zdawali egzamin w pierwszym terminie.
| niezdany | zdany | Total | ||
|---|---|---|---|---|
| kobieta | Count | 31 | 80 | 111 |
| Expected Count | 27.8 | 83.3 | 111.0 | |
| % within płeć | 27.9% | 72.1% | 100.0% | |
| mężczyzna | Count | 14 | 55 | 69 |
| Expected Count | 17.3 | 51.8 | 69.0 | |
| % within płeć | 20.3% | 79.7% | 100.0% | |
| Total | Count | 45 | 135 | 180 |
Z tabeli krzyżowej odczytaj procenty we właściwym kierunku: tu „% within płeć”, czyli odsetek zdających wśród kobiet (72.1%) i mężczyzn (79.7%). Liczebności oczekiwane (Expected Count) to liczby spodziewane przy niezależności zmiennych; służą do sprawdzenia warunków testu (zob. tabela krzyżowa).
| Value | df | Asymp. Sig. (2-sided) | Exact Sig. (2-sided) | Exact Sig. (1-sided) | |
|---|---|---|---|---|---|
| Pearson Chi-Square | 1.324 | 1 | .250 | ||
| Continuity Correction | .948 | 1 | .330 | ||
| Likelihood Ratio | 1.350 | 1 | .245 | ||
| Fisher’s Exact Test | .291 | .165 | |||
| Linear-by-Linear Association | 1.317 | 1 | .251 | ||
| N of Valid Cases | 180 |
W tabeli 2 × 2 SPSS liczy test dokładny Fishera i chi-kwadrat z poprawką Yatesa (IBM, 2026), więc wierszy jest aż pięć. Każdy z nich odpowiada na to samo pytanie innym sposobem:
| Wiersz | Co to jest | Kiedy go użyć |
|---|---|---|
| Pearson Chi-Square | Klasyczny test chi-kwadrat Pearsona | Domyślnie – gdy liczebności oczekiwane są wystarczające |
| Continuity Correction | Chi-kwadrat z poprawką Yatesa, tylko dla tabel 2 × 2 | Zwykle niepotrzebny; daje większe p niż test Pearsona |
| Likelihood Ratio | Test ilorazu wiarygodności (G²) | Alternatywa dla testu Pearsona; zwykle prowadzi do tego samego wniosku |
| Fisher’s Exact Test | Test dokładny, bez przybliżenia rozkładem chi-kwadrat | Tabela 2 × 2 z bardzo małymi liczebnościami oczekiwanymi |
| Linear-by-Linear Association | Test związku liniowego dla kategorii zakodowanych liczbami | Kategorie uporządkowane (np. wiek w przedziałach); w tabeli 2 × 2 równy (N − 1)/N × χ² Pearsona |
Pod tabelą SPSS podaje, ile komórek (i jaki ich odsetek) ma liczebność oczekiwaną mniejszą niż 5 oraz jaka jest najmniejsza z nich – tu żadna komórka nie spada poniżej 5, a najmniejsza liczebność oczekiwana wynosi 17.25. Klasyczna reguła mówi, że najwyżej 20% komórek może mieć liczebność oczekiwaną poniżej 5 i żadna nie może mieć poniżej 1 (Kim, 2017). Campbell (2007), porównując siedem testów dla tabel 2 × 2, za optymalny uznał test chi-kwadrat „N − 1”, gdy najmniejsza liczebność oczekiwana wynosi co najmniej 1, a przy mniejszych – test Fishera–Irwina. W tabeli 2 × 2 wartość testu „N − 1” odpowiada wierszowi Linear-by-Linear Association (tu 179/180 × 1.324 = 1.317). Ostatnia tabela, Symmetric Measures, podaje miary siły związku: φ i V Craméra.
| Value | Approx. Sig. | ||
|---|---|---|---|
| Nominal by Nominal | Phi | .086 | .250 |
| Cramer’s V | .086 | .250 | |
| N of Valid Cases | 180 |
Typowe błędy: przepisanie wiersza Continuity Correction albo Linear-by-Linear Association zamiast testu Pearsona bez uzasadnienia, odsetki liczone w złym kierunku, procenty bez liczebności i pominięcie N w zapisie χ². Hasło test chi-kwadrat niezależności omawia założenia testu.
Regresja liniowa: Model Summary, ANOVA i Coefficients
Procedura Analyze > Regression > Linear daje trzy główne tabele. W oknie Statistics zaznacz przedziały ufności i diagnostykę współliniowości, która dodaje kolumny Tolerance i VIF (IBM, 2026). W przykładzie stres wyjaśniamy wsparciem społecznym i samoskutecznością.
| Model | R | R Square | Adjusted R Square | Std. Error of the Estimate |
|---|---|---|---|---|
| 1 | .561 | .315 | .307 | .682 |
| Model | Sum of Squares | df | Mean Square | F | Sig. | |
|---|---|---|---|---|---|---|
| 1 | Regression | 37.795 | 2 | 18.897 | 40.676 | .000 |
| Residual | 82.232 | 177 | .465 | |||
| Total | 120.026 | 179 |
| Model 1 | Unstandardized Coefficients | Standardized Coefficients | t | Sig. | 95.0% Confidence Interval for B | Collinearity Statistics | |||
|---|---|---|---|---|---|---|---|---|---|
| B | Std. Error | Beta | Lower Bound | Upper Bound | Tolerance | VIF | |||
| (Constant) | 6.441 | .371 | 17.364 | .000 | 5.709 | 7.173 | |||
| Wsparcie społeczne | −.162 | .057 | −.194 | −2.862 | .005 | −.274 | −.050 | .841 | 1.189 |
| Samoskuteczność | −.086 | .013 | −.455 | −6.701 | .000 | −.111 | −.061 | .841 | 1.189 |
- Model Summary: przepisz R Square (R² = .315, czyli 31% wyjaśnionej wariancji) i Adjusted R Square; R to korelacja wielokrotna, której zwykle się nie podaje (zob. R² skorygowany).
- ANOVA: test całego modelu – F z dwiema liczbami stopni swobody (Regression i Residual) i Sig.
- Coefficients: kolumna B to współczynniki niestandaryzowane, w jednostkach zmiennych, a Beta – standaryzowane (β = B × SDx / SDy), które pozwalają porównać siłę predyktorów mierzonych na różnych skalach. Wiersz (Constant) to przewidywany wynik przy zerowych wartościach predyktorów; jego Sig. zwykle nie ma znaczenia dla hipotez.
- Tolerance i VIF: VIF = 1 / Tolerance. Wartości bliskie 1 (tu 1.189) oznaczają brak problemu ze współliniowością (zob. VIF).
Typowe błędy: mylenie B z Beta (i podawanie β z kolumny B), interpretowanie R zamiast R², stopnie swobody testu t inne niż w wierszu Residual oraz wniosek, że predyktor o największym B jest „najważniejszy”, choć zmienne mają różne skale. Pełną procedurę opisuje poradnik regresja wieloraka krok po kroku.
Rzetelność: alfa Cronbacha i alfa po usunięciu pozycji
Procedura Analyze > Scale > Reliability Analysis z modelem Alpha daje tabelę Reliability Statistics. Opcja Scale if item deleted w oknie Statistics dodaje tabelę Item-Total Statistics, która dla każdej pozycji pokazuje średnią i wariancję skali bez tej pozycji, korelację pozycji z resztą skali i alfę Cronbacha po jej usunięciu (IBM, 2026). Pozycje 4 i 5 skali stresu są sformułowane odwrotnie i zostały przekodowane przed analizą.
| Cronbach’s Alpha | Cronbach’s Alpha Based on Standardized Items | N of Items |
|---|---|---|
| .854 | .853 | 6 |
| Pozycja | Scale Mean if Item Deleted | Scale Variance if Item Deleted | Corrected Item-Total Correlation | Squared Multiple Correlation | Cronbach’s Alpha if Item Deleted |
|---|---|---|---|---|---|
| s1 | 15.706 | 16.354 | .705 | .500 | .816 |
| s2 | 15.644 | 17.392 | .626 | .401 | .832 |
| s3 | 15.706 | 16.768 | .669 | .452 | .824 |
| s4 (przekodowana) | 15.694 | 18.146 | .581 | .342 | .840 |
| s5 (przekodowana) | 15.756 | 17.783 | .600 | .377 | .836 |
| s6 | 15.578 | 17.083 | .655 | .446 | .826 |
- Co odczytać: Cronbach’s Alpha i liczbę pozycji; alfa „Based on Standardized Items” dotyczy pozycji standaryzowanych.
- Corrected Item-Total Correlation to korelacja pozycji z sumą pozostałych pozycji. Wartość bliska zera albo ujemna to sygnał, że pozycja nie pasuje do skali lub nie została przekodowana.
- Cronbach’s Alpha if Item Deleted: tu po usunięciu dowolnej pozycji alfa spada (od .816 do .840 wobec .854), więc każda pozycja wnosi coś do skali. Nie usuwaj pozycji tylko po to, by podnieść alfę o kilka setnych – zmieniasz wtedy narzędzie.
Typowy błąd: nieprzekodowane pozycje odwrócone. Gdy policzyliśmy alfę dla surowych odpowiedzi, bez przekodowania pozycji 4 i 5, spadła z .854 do .009, a korelacje tych pozycji z resztą skali były ujemne (−.536 i −.557). Taki obraz w tabeli Item-Total Statistics prawie zawsze oznacza zapomniane pozycje odwrócone. Pamiętaj też, że alfa ma ograniczenia: McNeish (2018) pokazuje, że jej nierealistyczne założenia zwykle prowadzą do zaniżenia rzetelności, i omawia alternatywy, takie jak omega. Od wersji 27.0.1 SPSS oferuje model Omega (McDonald’s) (IBM, 2026) – zob. omega McDonalda i poradnik alfa Cronbacha – rzetelność skali.
Najczęstsze błędy przy przepisywaniu wyników z SPSS
| Źle | Dlaczego | Dobrze |
|---|---|---|
| „p = .000” | SPSS zaokrąglił bardzo małą wartość | „p < .001” |
| „Sig. = .482, więc grupy się nie różnią” (test Levene’a) | To test wariancji, a nie średnich | Wynik hipotezy z wiersza testu Welcha |
| „SD = .82”, „b = −.16” | SPSS pomija zero przed kropką przy wszystkich liczbach | „SD = 0.82”, „b = −0.16”; bez zera tylko p, r, α, R² |
| Etykiety z wydruku w tekście: Sig., Std. Error, Mean Difference | To nazwy kolumn programu, nie symbole APA | p, SE, różnica średnich |
| Jednostronne p dobrane po fakcie | Wybór testu po zobaczeniu wyniku zawyża błąd I rodzaju | Dwustronne p, chyba że kierunek zapisano przed badaniem |
| Wklejona tabela z SPSS | Za dużo liczb, nie spełnia wymogów APA | Wybrane liczby w zdaniu lub tabeli APA (zob. poprawki promotora w rozdziale wyników) |
Kod R: te same liczby co w SPSS
Poniższy kod liczy w R wszystkie liczby z odtworzonych tabel – tak, jak liczy je SPSS (test Levene’a od średniej, testy Welcha i Browna–Forsythe’a, test Tukeya z błędem standardowym różnicy, chi-kwadrat z poprawką Yatesa i bez niej, współczynniki Beta, alfa po usunięciu pozycji). Dane wczytuje pierwszy fragment: plik wyniki-apa.R to kod kroków 1–10 z wpisu jak opisać wyniki w stylu APA (dane symulowane, set.seed(443)). Fragmenty uruchamiaj po kolei. Kod pomaga też sprawdzić wydruk z SPSS: jeśli liczby się zgadzają, dobrze odczytałeś tabelę.
1. Statystyki opisowe
R
# Dane z wpisu „Jak opisać wyniki w stylu APA” (kod kroków 1–10 zapisany jako wyniki-apa.R)
invisible(capture.output(suppressMessages(source("wyniki-apa.R", encoding = "UTF-8"))))
options(contrasts = c("contr.treatment", "contr.poly"))
# Descriptive Statistics: skośność i kurtoza tak jak w SPSS (type = 2) z błędami standardowymi
zmienne <- c("stres_pre", "wsparcie", "samoskutecznosc")
op <- psych::describe(dane[, zmienne], type = 2)
n <- nrow(dane)
se_skos <- sqrt(6 * n * (n - 1) / ((n - 2) * (n + 1) * (n + 3)))
se_kurt <- 2 * se_skos * sqrt((n^2 - 1) / ((n - 3) * (n + 5)))
opisowe <- data.frame(N = op$n, Minimum = op$min, Maximum = op$max, Mean = op$mean, SD = op$sd,
                      Skewness = op$skew, SE_skew = se_skos, Kurtosis = op$kurtosis, SE_kurt = se_kurt,
                      row.names = zmienne)
round(opisowe, 3)
sum(complete.cases(dane[, zmienne]))   # Valid N (listwise)
Wynik w R
                  N Minimum Maximum   Mean    SD Skewness SE_skew Kurtosis
stres_pre       180   1.333       5  3.136 0.819    0.003   0.181   -0.770
wsparcie        180   2.417       7  5.125 0.982   -0.207   0.181   -0.187
samoskutecznosc 180  19.000      40 28.739 4.324   -0.007   0.181   -0.315
                SE_kurt
stres_pre          0.36
wsparcie           0.36
samoskutecznosc    0.36
[1] 180
2. Testy t dla prób niezależnych i zależnych
R
library(car)
# (a) test t dla prób niezależnych: stres przed treningiem u kobiet i mężczyzn
grupy <- split(dane$stres_pre, dane$plec)
sapply(grupy, function(x) round(c(N = length(x), Mean = mean(x), SD = sd(x), SE_Mean = sd(x) / sqrt(length(x))), 3))
lev_t <- leveneTest(stres_pre ~ plec, data = dane, center = mean)   # test Levene’a tak jak w SPSS
lev_t
student <- t.test(stres_pre ~ plec, data = dane, var.equal = TRUE)    # wiersz Equal variances assumed
welch   <- t.test(stres_pre ~ plec, data = dane, var.equal = FALSE)   # wiersz Equal variances not assumed
wiersz_t <- function(tt) c(t = unname(tt$statistic), df = unname(tt$parameter),
                           p_jednostronne = tt$p.value / 2, p_dwustronne = tt$p.value,
                           roznica = unname(tt$estimate[1] - tt$estimate[2]), SE = unname(tt$stderr),
                           CI_dol = tt$conf.int[1], CI_gora = tt$conf.int[2])
round(rbind(rowne_wariancje = wiersz_t(student), Welch = wiersz_t(welch)), 3)
effectsize::cohens_d(stres_pre ~ plec, data = dane)                     # d z połączonym SD
# (b) test t dla prób zależnych: stres przed i po treningu w grupie uważności
u <- subset(dane, warunek == "uważność")
round(sapply(u[, c("stres_pre", "stres_post")], function(x) c(Mean = mean(x), N = length(x), SD = sd(x), SE_Mean = sd(x) / sqrt(length(x)))), 3)
round(cor(u$stres_pre, u$stres_post), 3)                # Paired Samples Correlations: r
signif(cor.test(u$stres_pre, u$stres_post)$p.value, 3)  # i jego p
roznice <- u$stres_pre - u$stres_post
zal <- t.test(u$stres_pre, u$stres_post, paired = TRUE)
round(c(Mean = mean(roznice), SD = sd(roznice), SE = sd(roznice) / sqrt(nrow(u)), CI_dol = zal$conf.int[1],
        CI_gora = zal$conf.int[2], t = unname(zal$statistic), df = unname(zal$parameter)), 3)
zal$p.value
effectsize::repeated_measures_d(u$stres_pre, u$stres_post, method = "z", adjust = FALSE)   # d_z
Wynik w R
        kobieta mężczyzna
N       111.000    69.000
Mean      3.275     2.913
SD        0.823     0.766
SE_Mean   0.078     0.092
Levene's Test for Homogeneity of Variance (center = mean)
       Df F value Pr(>F)
group   1  0.4964  0.482
      178
                    t      df p_jednostronne p_dwustronne roznica    SE CI_dol
rowne_wariancje 2.943 178.000          0.002        0.004   0.362 0.123  0.119
Welch           2.993 152.273          0.002        0.003   0.362 0.121  0.123
                CI_gora
rowne_wariancje   0.604
Welch             0.601
Cohen's d |       95% CI
------------------------
0.45      | [0.15, 0.75]

- Estimated using pooled SD.        stres_pre stres_post
Mean        3.119      2.367
N          60.000     60.000
SD          0.847      0.868
SE_Mean     0.109      0.112
[1] 0.834
[1] 1.28e-16
   Mean      SD      SE  CI_dol CI_gora       t      df
  0.753   0.494   0.064   0.625   0.880  11.796  59.000
[1] 3.691576e-17
d (z) |       95% CI
--------------------
1.52  | [1.15, 1.89]
3. Jednoczynnikowa ANOVA
R
# jednoczynnikowa ANOVA: stres po czterech tygodniach w trzech warunkach
lev_mean   <- leveneTest(stres_post ~ warunek, data = dane, center = mean)     # Based on Mean
lev_median <- leveneTest(stres_post ~ warunek, data = dane, center = median)   # Based on Median
levene <- rbind(Based_on_Mean = c(lev_mean$`F value`[1], lev_mean$Df, lev_mean$`Pr(>F)`[1]),
                Based_on_Median = c(lev_median$`F value`[1], lev_median$Df, lev_median$`Pr(>F)`[1]))
colnames(levene) <- c("Levene", "df1", "df2", "p")
round(levene, 3)
anova_tab <- anova(lm(stres_post ~ warunek, data = dane))
anova_tab
welch_F <- oneway.test(stres_post ~ warunek, data = dane, var.equal = FALSE)   # Welch
welch_F
# Brown–Forsythe (test średnich, nie wariancji): F* = SS_B / sum((1 - n_i/N) s_i^2)
n_i <- tapply(dane$stres_post, dane$warunek, length); s2_i <- tapply(dane$stres_post, dane$warunek, var)
m_i <- tapply(dane$stres_post, dane$warunek, mean); N <- sum(n_i)
ss_b <- sum(n_i * (m_i - mean(dane$stres_post))^2)
c_i <- (1 - n_i / N) * s2_i
bf <- c(F = ss_b / sum(c_i), df1 = length(n_i) - 1, df2 = sum(c_i)^2 / sum(c_i^2 / (n_i - 1)))
round(c(bf, p = pf(bf[["F"]], bf[["df1"]], bf[["df2"]], lower.tail = FALSE)), 3)
# Multiple Comparisons: Tukey HSD (z błędem standardowym jak w SPSS) i Games–Howell
mse <- anova_tab$`Mean Sq`[2]
tukey <- TukeyHSD(aov(stres_post ~ warunek, data = dane))$warunek
se_tukey <- sqrt(mse * (1 / 60 + 1 / 60))
round(cbind(tukey, SE = se_tukey), 3)
gh <- rstatix::games_howell_test(dane, stres_post ~ warunek)
gh$SE <- with(gh, sqrt(s2_i[group1] / n_i[group1] + s2_i[group2] / n_i[group2]))
gh[, c("group1", "group2", "estimate", "SE", "conf.low", "conf.high", "p.adj")]
Wynik w R
                Levene df1 df2     p
Based_on_Mean    0.642   2 177 0.527
Based_on_Median  0.620   2 177 0.539
Analysis of Variance Table

Response: stres_post
           Df  Sum Sq Mean Sq F value    Pr(>F)
warunek     2  15.576  7.7881  10.088 7.097e-05 ***
Residuals 177 136.648  0.7720
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	One-way analysis of means (not assuming equal variances)

data:  stres_post and warunek
F = 9.4456, num df = 2.00, denom df = 117.53, p-value = 0.000157

      F     df1     df2       p
 10.088   2.000 174.077   0.000
                      diff    lwr    upr p adj   SE
relaksacja-kontrola -0.325 -0.704  0.054 0.109 0.16
uważność-kontrola   -0.719 -1.099 -0.340 0.000 0.16
uważność-relaksacja -0.394 -0.774 -0.015 0.039 0.16
# A tibble: 3 × 7
  group1     group2     estimate        SE conf.low conf.high     p.adj
  <chr>      <chr>         <dbl> <dbl[1d]>    <dbl>     <dbl>     <dbl>
1 kontrola   relaksacja   -0.325     0.161   -0.708    0.0581 0.113
2 kontrola   uważność     -0.719     0.166   -1.11    -0.325  0.0000934
3 relaksacja uważność     -0.394     0.153   -0.759   -0.0301 0.03
4. Macierz korelacji
R
# macierz korelacji Pearsona: współczynnik, p dwustronne, N
kor <- psych::corr.test(dane[, c("stres_pre", "wsparcie", "samoskutecznosc")])
round(kor$r, 3)
signif(kor$p, 3) # pod przekątną p bez korekty (nad przekątną psych stosuje korektę Holma)
kor$n
cor.test(dane$wsparcie, dane$stres_pre)   # r z 95% CI do opisu w APA
Wynik w R
                stres_pre wsparcie samoskutecznosc
stres_pre           1.000   -0.376          -0.532
wsparcie           -0.376    1.000           0.399
samoskutecznosc    -0.532    0.399           1.000
                stres_pre wsparcie samoskutecznosc
stres_pre        0.00e+00 2.04e-07        4.50e-14
wsparcie         2.04e-07 0.00e+00        5.79e-08
samoskutecznosc  1.50e-14 2.89e-08        0.00e+00
[1] 180

	Pearson's product-moment correlation

data:  dane$wsparcie and dane$stres_pre
t = -5.4071, df = 178, p-value = 2.04e-07
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.4946897 -0.2426714
sample estimates:
       cor
-0.3756031
5. Tabela krzyżowa i chi-kwadrat
R
# tabela krzyżowa 2 × 2: płeć i zdanie egzaminu w pierwszym terminie
tab <- table(dane$plec, dane$egzamin)
tab
pearson <- chisq.test(tab, correct = FALSE)
yates   <- chisq.test(tab, correct = TRUE)              # Continuity Correction
round(pearson$expected, 2)                            # Expected Count
round(prop.table(tab, 1) * 100, 1)                    # % within płeć
G2 <- 2 * sum(tab * log(tab / pearson$expected))      # Likelihood Ratio
fisher2 <- fisher.test(tab)$p.value                   # Fisher's Exact Test, dwustronnie
fisher1 <- min(fisher.test(tab, alternative = "less")$p.value, fisher.test(tab, alternative = "greater")$p.value)
kody <- cbind(as.numeric(dane$plec), as.numeric(dane$egzamin))
lbl <- (nrow(dane) - 1) * cor(kody[, 1], kody[, 2])^2   # Linear-by-Linear Association
round(rbind(Pearson = c(pearson$statistic, pearson$parameter, pearson$p.value),
            Continuity = c(yates$statistic, yates$parameter, yates$p.value),
            Likelihood = c(G2, 1, pchisq(G2, 1, lower.tail = FALSE)),
            Linear_by_linear = c(lbl, 1, pchisq(lbl, 1, lower.tail = FALSE))), 3)
round(c(Fisher_dwustronne = fisher2, Fisher_jednostronne = fisher1), 3)
c(liczebnosc_oczekiwana_min = min(pearson$expected), komorki_ponizej_5 = sum(pearson$expected < 5))
phi <- (tab[1, 1] * tab[2, 2] - tab[1, 2] * tab[2, 1]) / sqrt(prod(rowSums(tab)) * prod(colSums(tab)))
round(c(Phi = phi, V_Cramera = abs(phi), p = pearson$p.value), 3)
Wynik w R
            niezdany zdany
  kobieta         31    80
  mężczyzna       14    55

            niezdany zdany
  kobieta      27.75 83.25
  mężczyzna    17.25 51.75

            niezdany zdany
  kobieta       27.9  72.1
  mężczyzna     20.3  79.7
                 X-squared df
Pearson              1.324  1 0.250
Continuity           0.948  1 0.330
Likelihood           1.350  1 0.245
Linear_by_linear     1.317  1 0.251
  Fisher_dwustronne Fisher_jednostronne
              0.291               0.165
liczebnosc_oczekiwana_min         komorki_ponizej_5
                    17.25                      0.00
      Phi V_Cramera         p
    0.086     0.086     0.250
6. Regresja liniowa
R
# regresja liniowa: stres przed treningiem a wsparcie społeczne i samoskuteczność
model <- lm(stres_pre ~ wsparcie + samoskutecznosc, data = dane)
s <- summary(model)
round(c(R = sqrt(s$r.squared), R2 = s$r.squared, R2_skorygowane = s$adj.r.squared, SE_oszacowania = s$sigma), 3)   # Model Summary
anova_reg <- anova(model)
round(c(SS_regresja = sum(anova_reg$`Sum Sq`[1:2]), SS_reszty = anova_reg$`Sum Sq`[3], df1 = 2, df2 = s$df[2],
        F = unname(s$fstatistic[1])), 3)
pf(s$fstatistic[1], s$fstatistic[2], s$fstatistic[3], lower.tail = FALSE)
# Coefficients: B, SE, Beta (jak w SPSS: b × SD_x / SD_y), t, p, 95% CI, tolerancja i VIF
beta <- coef(model)[-1] * sapply(dane[, c("wsparcie", "samoskutecznosc")], sd) / sd(dane$stres_pre)
vif_ <- vif(model)
round(cbind(coef(s), Beta = c(NA, beta), confint(model), Tolerance = c(NA, 1 / vif_), VIF = c(NA, vif_)), 3)
Wynik w R
             R             R2 R2_skorygowane SE_oszacowania
         0.561          0.315          0.307          0.682
SS_regresja   SS_reszty         df1         df2           F
     37.795      82.232       2.000     177.000      40.676
       value
2.917152e-15
                Estimate Std. Error t value Pr(>|t|)   Beta  2.5 % 97.5 %
(Intercept)        6.441      0.371  17.364    0.000     NA  5.709  7.173
wsparcie          -0.162      0.057  -2.862    0.005 -0.194 -0.274 -0.050
samoskutecznosc   -0.086      0.013  -6.701    0.000 -0.455 -0.111 -0.061
                Tolerance   VIF
(Intercept)            NA    NA
wsparcie            0.841 1.189
samoskutecznosc     0.841 1.189
7. Rzetelność skali
R
# alfa Cronbacha dla 6 pozycji skali stresu (pozycje 4 i 5 przekodowane w obiekcie „pozycje”)
a <- psych::alpha(pozycje)
round(c(alfa = a$total$raw_alpha, alfa_standaryzowana = a$total$std.alpha, liczba_pozycji = ncol(pozycje)), 3)
# Item-Total Statistics liczone jak w SPSS (suma pozostałych pozycji)
suma <- rowSums(pozycje)
it <- t(sapply(names(pozycje), function(p) {
  reszta <- suma - pozycje[[p]]
  c(sr_skali_bez = mean(reszta), war_skali_bez = var(reszta), r_skorygowana = cor(pozycje[[p]], reszta),
    smc = summary(lm(pozycje[[p]] ~ ., data = pozycje[setdiff(names(pozycje), p)]))$r.squared,
    alfa_bez = psych::alpha(pozycje[setdiff(names(pozycje), p)])$total$raw_alpha)
}))
round(it, 3)
# typowy błąd: pozycje 4 i 5 bez przekodowania
surowe <- dane[, paste0("s", 1:6)]
a_bl <- psych::alpha(surowe, check.keys = FALSE, warnings = FALSE)
round(c(alfa = a_bl$total$raw_alpha), 3)
round(a_bl$item.stats[, "r.drop"], 3)   # skorygowana korelacja pozycja–reszta skali
Wynik w R
               alfa alfa_standaryzowana      liczba_pozycji
              0.854               0.853               6.000
   sr_skali_bez war_skali_bez r_skorygowana   smc alfa_bez
s1       15.706        16.354         0.705 0.500    0.816
s2       15.644        17.392         0.626 0.401    0.832
s3       15.706        16.768         0.669 0.452    0.824
s4       15.694        18.146         0.581 0.342    0.840
s5       15.756        17.783         0.600 0.377    0.836
s6       15.578        17.083         0.655 0.446    0.826
 alfa
0.009
[1]  0.384  0.395  0.339 -0.536 -0.557  0.453
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3; odtworzenia tabel wydruku przygotowaliśmy osobnym skryptem z tych samych obiektów, a rysunki – w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests (R package version 0.7.3) [Computer software]. https://doi.org/10.32614/CRAN.package.rstatix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Ściąga: gdzie szukać liczb do pracy
| Analiza | Tabela SPSS | Co przepisać | Zapis APA |
|---|---|---|---|
| Statystyki opisowe | Descriptive Statistics | N, Mean, Std. Deviation | M = 3.14, SD = 0.82 |
| Test t dla prób niezależnych | Independent Samples Test, wiersz Equal variances not assumed | t, df, Two-Sided p, Mean Difference, 95% CI | t(152.27) = 2.99, p = .003 |
| Test t dla prób zależnych | Paired Samples Test | Mean, 95% CI, t, df, Two-Sided p | t(59) = 11.80, p < .001 |
| ANOVA | ANOVA (lub Robust Tests), Multiple Comparisons | F, oba df, Sig.; różnice par z CI | F(2, 177) = 10.09, p < .001 |
| Korelacja | Correlations | Pearson Correlation, Sig. (2-tailed), N | r(178) = −.38, p < .001 |
| Chi-kwadrat | Crosstabulation, Chi-Square Tests, Symmetric Measures | % w wierszach, Pearson Chi-Square, df, N, φ lub V | χ²(1, N = 180) = 1.32, p = .250 |
| Regresja liniowa | Model Summary, ANOVA, Coefficients | R², F, B, SE, Beta, t, Sig., 95% CI, VIF | R² = .31; b = −0.086, β = −0.45 |
| Rzetelność | Reliability Statistics, Item-Total Statistics | Cronbach’s Alpha, liczba pozycji | α = .85 |
Procedury SPSS szerzej omawia podręcznik Fielda (2018) z przykładami w tym programie. Gdy wydruk nadal budzi wątpliwości – nie wiesz, czy wybrałeś właściwy test albo jak opisać wynik nieistotny – możesz skonsultować analizy ze statystykiem: w ofercie analizy statystyczne dla studentów ekspert omawia wyniki prostym językiem i odpowiada na pytania, tak byś rozumiał każdą liczbę, którą wpisujesz do pracy.
Najczęstsze pytania
Co oznacza Sig. w wynikach SPSS?
Sig. to wartość p danego testu. W zależności od tabeli kolumna nazywa się Sig., Sig. (2-tailed), Asymp. Sig. (2-sided), Exact Sig. albo Two-Sided p. W pracy zapisuj ją jako p z trzema miejscami po kropce, np. p = .003, a wartości mniejsze od .001 jako p < .001.
Co zrobić, gdy SPSS pokazuje Sig. = .000?
To nie jest zero – SPSS zaokrąglił bardzo małą wartość p do trzech miejsc po kropce. W pracy napisz p < .001. Dokładniejszą wartość zobaczysz po dwukrotnym kliknięciu tabeli i zwiększeniu liczby miejsc po przecinku w oknie Cell Properties.
Co to jest istotność dwustronna w SPSS?
To wartość p dla hipotezy bez założonego kierunku – sprawdza, czy różnica lub związek odbiega od zera w którąkolwiek stronę. Tę wartość podaje się domyślnie. Wartość jednostronną (One-Sided p) można podać tylko wtedy, gdy kierunek hipotezy zapisano przed zebraniem danych.
Co oznacza Equal variances not assumed w teście t w SPSS?
To wiersz testu Welcha, który nie zakłada równych wariancji w grupach, dlatego ma ułamkowe stopnie swobody. Zaleca się go jako wybór domyślny, bo lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci przy równych. Przepisz z niego t, df, dwustronne p, różnicę średnich i 95% CI.
Który wynik przepisać z tabeli Chi-Square Tests w SPSS?
Zwykle wiersz Pearson Chi-Square: wartość, df i p, a do tego liczebność próby i miarę siły związku (φ albo V Craméra). W tabeli 2 × 2 z bardzo małymi liczebnościami oczekiwanymi skorzystaj z testu dokładnego Fishera (Fisher’s Exact Test). Wiersze Continuity Correction i Linear-by-Linear Association wybieraj tylko z uzasadnieniem.
Czym różni się kolumna B od kolumny Beta w tabeli Coefficients?
B to współczynnik niestandaryzowany: o ile jednostek zmienia się zmienna zależna, gdy predyktor rośnie o jednostkę. Beta to współczynnik standaryzowany, wyrażony w odchyleniach standardowych, który pozwala porównać siłę predyktorów mierzonych na różnych skalach. W pracy podaj b z błędem standardowym i 95% CI oraz β.
Powiązane hasła
Przeczytaj też
Jak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikWyniki badań własnych – przykładowy rozdział
Cały rozdział wyników jednego badania – od przygotowania danych po tabelę hipotez – z komentarzem, tabelami APA, rysunkami i wzorem w Wordzie.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Wydruk z SPSS nadal wygląda jak szyfr?
Omówimy z Tobą wyniki prostym językiem, sprawdzimy, czy odczytałeś właściwe liczby i czy test pasuje do hipotezy – tak, byś umiał je wyjaśnić promotorowi.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2024). APA Style numbers and statistics guide. APA Style. https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf ● Otwarty dostęp
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- IBM. (2026). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/spss-statistics/31.0.0 ● Otwarty dostęp
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. Journal of the Royal Statistical Society: Series D (The Statistician), 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Sauder, D. C., & DeMars, C. E. (2019). An updated recommendation for multiple comparisons. Advances in Methods and Practices in Psychological Science, 2(1), 26–44. https://doi.org/10.1177/2515245918808784 ● Otwarty dostęp
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108 ● Otwarty dostęp
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@misc{apa2024numbers, author={{American Psychological Association}}, title={{APA Style numbers and statistics guide}}, howpublished={APA Style}, year={2024}, publisher={American Psychological Association}, url={https://apastyle.apa.org/instructional-aids/numbers-statistics-guide.pdf}}@article{brown1974robust, author={Brown, Morton B. and Forsythe, Alan B.}, title={{Robust tests for the equality of variances}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={346}, pages={364--367}, doi={10.1080/01621459.1974.10482955}}@article{campbell2007chisquared, author={Campbell, Ian}, title={{Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={19}, pages={3661--3675}, doi={10.1002/sim.2832}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@book{field2018discovering, author={Field, Andy}, title={{Discovering statistics using IBM SPSS Statistics}}, year={2018}, edition={5th}, publisher={SAGE}}@misc{ibm2026spssdocs, author={{IBM}}, title={{IBM SPSS Statistics 31.0.0 documentation}}, year={2026}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0}}@article{joanes1998comparing, author={Joanes, D. N. and Gill, C. A.}, title={{Comparing measures of sample skewness and kurtosis}}, journal={Journal of the Royal Statistical Society: Series D (The Statistician)}, year={1998}, volume={47}, number={1}, pages={183--189}, doi={10.1111/1467-9884.00122}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{sauder2019updated, author={Sauder, Derek C. and DeMars, Christine E.}, title={{An updated recommendation for multiple comparisons}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={1}, pages={26--44}, doi={10.1177/2515245918808784}}@article{wasserstein2016asa, author={Wasserstein, Ronald L. and Lazar, Nicole A.}, title={{The ASA statement on p-values: Context, process, and purpose}}, journal={The American Statistician}, year={2016}, volume={70}, number={2}, pages={129--133}, doi={10.1080/00031305.2016.1154108}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}