Co to jest omega McDonalda?
Omega McDonalda (ω, ang. McDonald’s omega, omega total) to współczynnik rzetelności wyniku skali – sumy albo średniej odpowiedzi na pozycje – obliczany z modelu czynnikowego. Mówi, jaka część wariancji wyniku skali pochodzi od wspólnego czynnika, czyli mierzonej cechy, a jaka od błędu pomiaru. W literaturze przywołuje się ją za podręcznikiem teorii testów McDonalda (1999). Podobnie jak alfa Cronbacha, omega jest miarą spójności wewnętrznej: opisuje precyzję wyniku z jednego pomiaru, a nie jego stabilność w czasie – tę mierzy rzetelność test–retest.
W psychologii omega jest dziś zalecana jako zamiennik albo uzupełnienie alfy. Dunn i in. (2014) przeglądają krytykę alfy i proponują omegę – razem z przedziałem ufności – jako praktyczne rozwiązanie. McNeish (2018) zauważa, że badacze mimo tej krytyki nadal rutynowo raportują alfę, choć jej nierealistyczne założenia zwykle prowadzą do zaniżania rzetelności. Hayes i Coutts (2020) przypominają, że metodolodzy uważają alfę za gorszą miarę niż jej ogólniejszą formę, czyli omegę, i pokazują, jak policzyć omegę w kilku programach. Podstawy alfy omawiamy w poradniku Alfa Cronbacha: jak oceniać rzetelność skali; tutaj skupiamy się na tym, czym różni się omega i jak ją policzyć.
Wzór na omegę McDonalda
Punktem wyjścia jest jednoczynnikowy model konfirmacyjnej analizy czynnikowej (CFA) z wariancją czynnika ustaloną na 1. Każda pozycja ma w nim własny ładunek czynnikowy i własną wariancję błędu:
- λi – ładunek pozycji i: o ile zmienia się odpowiedź, gdy mierzona cecha rośnie o jedno odchylenie standardowe,
- θi – wariancja błędu (reszty) pozycji i,
- (Σλi)² – wariancja wyniku sumarycznego wyjaśniona przez czynnik; cały mianownik to wariancja wyniku według modelu.
Gdy pozycje są wystandaryzowane, θi = 1 − λi², więc do obliczeń wystarczą standaryzowane ładunki. W modelach równań strukturalnych ten sam wzór nosi nazwę rzetelności kompozytowej (CR, ρC). Dla porównania – alfa Cronbacha korzysta tylko z wariancji pozycji i wariancji sumy:
gdzie k to liczba pozycji, σi² – wariancje pozycji, a σX² – wariancja wyniku sumarycznego. Alfa nie korzysta z ładunków: jako miara rzetelności zakłada, że wszystkie pozycje są z mierzoną cechą związane tak samo silnie.
Alfa a omega: kiedy alfa zaniża rzetelność?
Dunn i in. (2014) opisują trzy modele pomiaru z klasycznej teorii testów. W modelu równoległym pozycje mają równe ładunki i równe wariancje błędów. W modelu tau-równoważnym (dokładniej: zasadniczo tau-równoważnym) ładunki są równe, ale wariancje błędów mogą się różnić – na tym modelu opiera się alfa. W modelu kongenerycznym różnić się mogą także ładunki. Ten ostatni najlepiej opisuje typowe skale kwestionariuszowe i to dla niego liczy się omegę.
Gdy ładunki są nierówne, a błędy pozycji nie są ze sobą skorelowane, alfa jest niższa od rzeczywistej rzetelności – i tym niższa, im bardziej różnią się ładunki (Dunn i in., 2014). Rysunek 1 pokazuje to na wartościach populacyjnych, czyli bez błędu losowania, dla skali z sześcioma pozycjami o średnim ładunku .60.
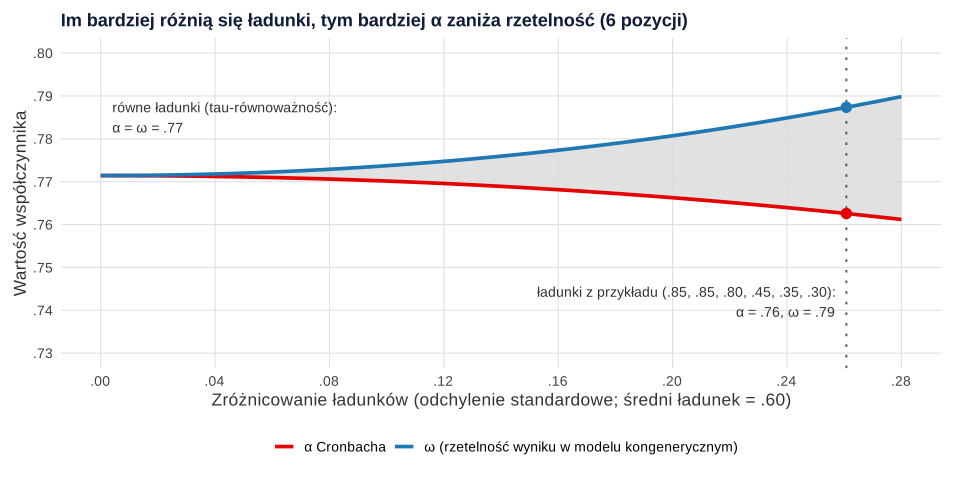
Przy równych ładunkach oba współczynniki wynoszą .77. Gdy przy tym samym średnim ładunku pozycje coraz bardziej się różnią, alfa spada, a omega rośnie. Dla ładunków .85, .85, .80, .45, .35 i .30 (odchylenie standardowe .26) alfa wynosi .76, a omega .79. Różnica jest rzędu setnych, ale ma zawsze ten sam kierunek. Inaczej bywa, gdy błędy pozycji są skorelowane, na przykład przy kilku pozycjach o niemal identycznym brzmieniu: alfa może wtedy rzetelność zawyżać (Dunn i in., 2014), a omega z modelu, który pomija te korelacje, też nie jest wiarygodna.
| Cecha | α Cronbacha | ω McDonalda |
|---|---|---|
| Model pomiaru | tau-równoważny (równe ładunki) | kongeneryczny (ładunki mogą się różnić) |
| Z czego się ją liczy | wariancje i kowariancje pozycji | ładunki i wariancje błędów z modelu CFA |
| Równe ładunki | taka sama wartość jak ω | taka sama wartość jak α |
| Nierówne ładunki, błędy nieskorelowane | zaniża rzetelność | szacuje ją trafnie, jeśli model jest dobrze dopasowany |
| Skorelowane błędy pozycji | może zawyżać rzetelność | wymaga uwzględnienia korelacji błędów w modelu |
| Jednowymiarowość | trzeba ją sprawdzić osobno | dopasowanie modelu CFA jest częścią obliczeń |
Przykład: skala prokrastynacji akademickiej
Trzystu studentów odpowiedziało na sześć pozycji skali prokrastynacji akademickiej na skali Likerta od 1 (zdecydowanie nie) do 5 (zdecydowanie tak) – dane symulowane. Trzy pozycje opisujące odkładanie nauki i prac (P1–P3) miały w populacji wysokie ładunki, a trzy ogólniejsze (P4–P6) – niskie. Średnie odpowiedzi wynosiły od 3.07 do 3.12, a średnia korelacja między pozycjami – .29.
Krok 1. Sprawdź model. Jednoczynnikowy model CFA (estymacja metodą największej wiarygodności, ML) był dobrze dopasowany: χ²(9) = 13.42, p = .145, CFI = .990, RMSEA = .040, SRMR = .035. Standaryzowane ładunki wyniosły .80, .81 i .78 dla P1–P3 oraz .39, .26 i .29 dla P4–P6 (rysunek 2A).
Krok 2. Podstaw do wzoru. Suma niestandaryzowanych ładunków z modelu wynosi 3.407, a suma wariancji błędów – 3.890:
Krok 3. Dodaj przedział ufności i porównaj z alfą. Bootstrapowy 95% przedział ufności dla omegi (2000 prób) to [.707, .786]. Alfa Cronbacha dla tych samych danych wynosi .714, 95% CI [.661, .761]. Alfa zaniżyła więc rzetelność o .035, bo słabe pozycje P4–P6 łamią założenie równych ładunków (rysunek 2B).
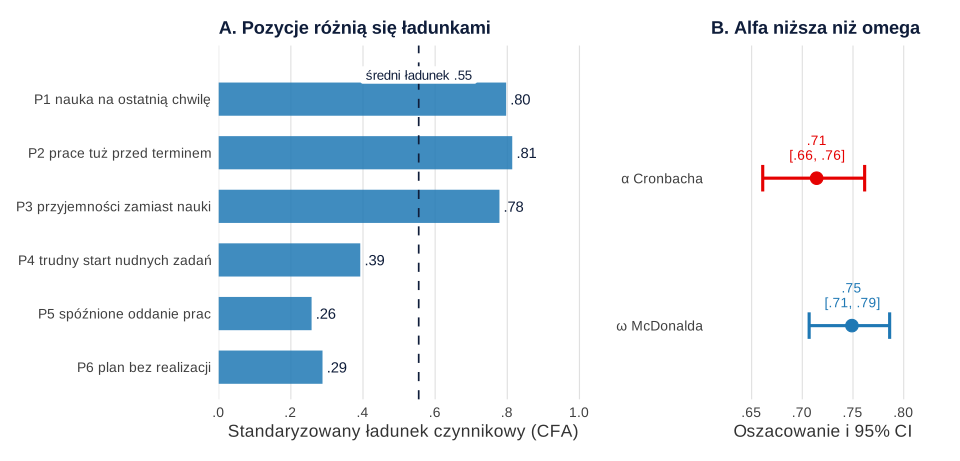
Funkcja psych::omega() dała dla tych danych ω = .742. Niewielka różnica (.007) wynika z innego sposobu estymacji – funkcja analizuje macierz korelacji metodą minres, a nie surowe odpowiedzi metodą ML – dlatego w pracy podaj, jak policzono omegę. Niskie ładunki P4–P6 to z kolei sygnał, by przyjrzeć się treści tych pozycji, a nie automatyczny powód do ich usunięcia.
Odmiany omegi: całkowita, hierarchiczna, porządkowa
Nazwa „omega” obejmuje kilka współczynników. Flora (2020) wyjaśnia, że właściwą odmianę wybiera się na podstawie modelu CFA mierzonego konstruktu, i pokazuje, jak policzyć każdą z nich w R. Najczęściej spotkasz trzy:
- ω całkowita (ωt) – dla skali jednowymiarowej; jej dotyczy to hasło;
- ω hierarchiczna (ωh) – dla skal z czynnikiem ogólnym i podskalami: mówi, jaka część wariancji wyniku ogólnego pochodzi wyłącznie od czynnika ogólnego;
- ω dla odpowiedzi porządkowych – liczona z modelu dla danych kategorialnych (korelacje polichoryczne, estymator WLSMV), przydatna przy pozycjach z małą liczbą kategorii odpowiedzi.
McNeish (2018) omawia jeszcze inne alternatywy dla alfy: omegę Revelle’a, największe dolne ograniczenie (GLB) i współczynnik H. Niezależnie od wyboru najpierw sprawdź strukturę skali – na przykład analizą równoległą, a potem modelem CFA.
Jak opisać omegę w pracy (APA)
Omegę podaje się zwykle w opisie narzędzi w rozdziale metodologicznym albo na początku wyników. Napisz, którą omegę policzono i na podstawie jakiego modelu, i dodaj 95% przedział ufności:
Gdy masz kilka skal, zbierz współczynniki w tabeli – wzór znajdziesz w haśle tabela rzetelności skal w APA, a warianty zdań we wzorze raportowania alfy i omegi.
Przykład w R
Kod odtwarza dane z przykładu, liczy alfę z przedziałem ufności, dopasowuje jednoczynnikowy model CFA w pakiecie lavaan i definiuje omegę jako parametr modelu (:=). Dzięki temu omega dostaje bootstrapowy przedział ufności. Liczby w tekście i na rysunku 2 pochodzą z tego kodu.
Alfa i omega z 95% CI (psych i lavaan)
R
library(psych); library(lavaan)
set.seed(2033)                                  # dane symulowane: 300 studentów, 6 pozycji (1–5)
lam <- c(.85, .85, .80, .45, .35, .30)          # nierówne ładunki w populacji (model kongeneryczny)
eta <- rnorm(300)                               # poziom prokrastynacji (zmienna ukryta)
X <- sapply(lam, function(l) l * eta + sqrt(1 - l^2) * rnorm(300))
dane <- as.data.frame(apply(X, 2, function(x) as.integer(cut(x, c(-Inf, -1.6, -0.6, 0.4, 1.3, Inf)))))
names(dane) <- paste0("p", 1:6)

a <- psych::alpha(dane)                         # alfa Cronbacha i 95% CI (metoda Feldta)
round(c(alfa = a$total$raw_alpha, dolna = a$feldt$lower.ci$raw_alpha, gorna = a$feldt$upper.ci$raw_alpha), 3)

model <- '
  F =~ l1*p1 + l2*p2 + l3*p3 + l4*p4 + l5*p5 + l6*p6
  p1 ~~ e1*p1
  p2 ~~ e2*p2
  p3 ~~ e3*p3
  p4 ~~ e4*p4
  p5 ~~ e5*p5
  p6 ~~ e6*p6
  omega := (l1+l2+l3+l4+l5+l6)^2 / ((l1+l2+l3+l4+l5+l6)^2 + e1+e2+e3+e4+e5+e6)
'
fit <- cfa(model, data = dane, std.lv = TRUE, se = "bootstrap", bootstrap = 2000)
round(fitMeasures(fit, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
std <- standardizedSolution(fit)
round(setNames(std$est.std[std$op == "=~"], paste0("p", 1:6)), 2)     # standaryzowane ładunki
pe <- parameterEstimates(fit, boot.ci.type = "perc")
round(pe[pe$label == "omega", c("est", "ci.lower", "ci.upper")], 3)   # omega i 95% CI (bootstrap)
round(suppressWarnings(omega(dane, nfactors = 1, plot = FALSE))$omega.tot, 3)   # psych::omega
Wynik w R
 alfa dolna gorna
0.714 0.661 0.761
 chisq     df pvalue    cfi  rmsea   srmr
13.418  9.000  0.145  0.990  0.040  0.035
  p1   p2   p3   p4   p5   p6
0.80 0.81 0.78 0.39 0.26 0.29
     est ci.lower ci.upper
14 0.749    0.707    0.786
[1] 0.742
SPSS i JASP. W SPSS od wersji 27 wybierz Analiza → Skala → Analiza rzetelności i w polu Model ustaw Omega; dla starszych wersji Hayes i Coutts (2020) opisują makro OMEGA. W JASP użyj modułu Reliability (analiza Reliability, w starszych wersjach Unidimensional Reliability) z opcją McDonald’s ω i przedziałem ufności.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://doi.org/10.32614/CRAN.package.psych
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Omega bez sprawdzenia modelu – ω całkowita zakłada jeden czynnik. Jeśli skala ma podskale, policz omegę dla każdej z nich albo omegę hierarchiczną (Flora, 2020).
- Brak informacji, którą omegę policzono – odmiany omegi i programy dają różne wartości. Podaj odmianę, estymator i metodę przedziału ufności.
- Omega jako dowód trafności – wysoka rzetelność nie mówi, czy skala mierzy to, co powinna. O tym świadczą dowody trafności, np. trafności kryterialnej.
- Nieprzekodowane pozycje odwrócone – ujemne ładunki zmniejszają sumę ładunków i zaniżają omegę. Pozycje odwrócone przekoduj przed analizą.
- Sztywny próg .70 – Dunn i in. (2014) przypominają, że próg .70 nie był pomyślany jako złoty standard. Oceniaj omegę z przedziałem ufności i z myślą o zastosowaniu: do decyzji o pojedynczej osobie, np. przy porównaniu z normami testowymi, potrzeba wyższej rzetelności niż do porównań grupowych.
- Usuwanie pozycji tylko po to, by podnieść ω – zawęża treść konstruktu. Wcześniej sprawdź jakość danych, np. nieuważne odpowiedzi, które zaburzają korelacje między pozycjami.
Najczęstsze pytania
Co to jest omega McDonalda?
Omega McDonalda (ω) to współczynnik rzetelności wyniku skali obliczany z jednoczynnikowego modelu konfirmacyjnej analizy czynnikowej. Mówi, jaka część wariancji wyniku sumarycznego pochodzi od wspólnego czynnika, a jaka od błędu pomiaru. Przyjmuje wartości od 0 do 1; im wyższa, tym mniejszy udział błędu.
Czym różni się omega McDonalda od alfy Cronbacha?
Alfa jako miara rzetelności zakłada, że wszystkie pozycje mają równe ładunki (model tau-równoważny). Omega korzysta z ładunków oszacowanych w modelu CFA, więc dopuszcza ich zróżnicowanie (model kongeneryczny). Przy równych ładunkach oba współczynniki są równe, a przy nierównych ładunkach i nieskorelowanych błędach alfa zaniża rzetelność.
Jaka wartość omegi McDonalda jest dobra?
Nie ma jednego progu. W pracach studenckich często stosuje się te same umowne granice co dla alfy (.70 jako minimum, .80 i więcej jako dobra rzetelność), ale ważniejsze są przedział ufności i cel pomiaru. Do porównań grupowych wystarcza niższa rzetelność niż do diagnozy pojedynczej osoby.
Jak policzyć omegę McDonalda w SPSS i JASP?
W SPSS od wersji 27: Analiza → Skala → Analiza rzetelności, w polu Model wybierz Omega. W JASP: moduł Reliability (analiza Reliability, dawniej Unidimensional Reliability) i opcja McDonald’s ω z przedziałem ufności. W R użyj psych::omega() albo modelu CFA w pakiecie lavaan, jak w przykładzie na tej stronie.
Czy omega może być niższa od alfy?
W populacji, gdy model jednoczynnikowy jest poprawny, a błędy pozycji nie są skorelowane, alfa nie przekracza omegi. W próbie albo przy źle dopasowanym modelu – np. przy skorelowanych błędach pozycji lub kilku wymiarach – relacja może się odwrócić. To sygnał, by sprawdzić strukturę skali, a nie by wybrać korzystniejszy współczynnik.
Czy omegę liczy się dla całego kwestionariusza, czy dla podskal?
Dla każdej podskali, która tworzy osobny wynik. Omega całkowita zakłada jeden czynnik, więc policzona dla całego wielowymiarowego kwestionariusza daje mylący obraz. Jeśli używasz wyniku ogólnego skali z podskalami, rozważ omegę hierarchiczną z modelu bifaktorowego.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Alfa Cronbacha: jak oceniać rzetelność skali bez uproszczeń
Alfa Cronbacha krok po kroku: wzór, założenia, interpretacja, ograniczenia i sytuacje, w których lepiej raportować współczynnik omega.
Czytaj →PoradnikWzór raportowania alfy Cronbacha i innych miar spójności wewnętrznej
Przykłady zapisu dla alfy, omegi i skal porządkowych wraz z informacją, czego nie wolno wnioskować z pojedynczego współczynnika.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Flora, D. B. (2020). Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates. Advances in Methods and Practices in Psychological Science, 3(4), 484–501. https://doi.org/10.1177/2515245920951747 ● Otwarty dostęp
- Hayes, A. F., & Coutts, J. J. (2020). Use omega rather than Cronbach’s alpha for estimating reliability. But…. Communication Methods and Measures, 14(1), 1–24. https://doi.org/10.1080/19312458.2020.1718629
- McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates.
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
Cytowania BibTeX
@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@article{flora2020your, author={Flora, David B.}, title={{Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={484--501}, doi={10.1177/2515245920951747}}@article{hayes2020use, author={Hayes, Andrew F. and Coutts, Jacob J.}, title={{Use omega rather than Cronbach’s alpha for estimating reliability. But…}}, journal={Communication Methods and Measures}, year={2020}, volume={14}, number={1}, pages={1--24}, doi={10.1080/19312458.2020.1718629}}@book{mcdonald1999test, author={McDonald, Roderick P.}, title={{Test theory: A unified treatment}}, year={1999}, publisher={Lawrence Erlbaum Associates}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}