Kim był Roderick P. McDonald?
Roderick Peter McDonald urodził się 16 kwietnia 1928 r. w Sydney. W 1950 r. zrobił magisterium z fizyki na University of Sydney i pracował w fizyce doświadczalnej w Londynie i Sydney. Od 1958 r. uczył psychologii w University of New England w Nowej Południowej Walii, w 1964 r. obronił doktorat (promotor: John Keats z University of Queensland), a w 1965 r. jako stypendysta Fulbrighta pracował w Educational Testing Service w grupie Freda Lorda, razem m.in. z Karlem Jöreskogiem (Maydeu-Olivares i McArdle, 2005).
W latach 1969–1981 pracował w Ontario Institute for Studies in Education Uniwersytetu w Toronto, potem w Macquarie University w Sydney, a od 1991 r. w University of Illinois. W 1984 r. został prezesem Psychometric Society, w 2001 r. dostał Nagrodę Sellsa i został prezesem Society of Multivariate Experimental Psychology. W 2004 r., w wieku 76 lat, przeszedł na emeryturę i wrócił do Sydney (Maydeu-Olivares i McArdle, 2005). Zginął w wypadku podczas nurkowania z rurką na Jamajce; nekrolog w „Campus Review” ukazał się w styczniu 2012 r. i nazywał go najbardziej wpływowym australijskim psychologiem ilościowym swojej epoki (McDonald, 2012).
Najważniejsze pomysły
Wspólną nicią jego prac było szukanie jednej, ogólnej teorii pomiaru psychologicznego (Maydeu-Olivares i McArdle, 2005):
- Nieliniowa analiza czynnikowa (1964–1967). Doktorat, wydany w 1967 r. jako monografia „Psychometric Monographs”, pokazywał, jak modele nieliniowe (np. ogiwę normalną) sprowadzić do postaci liniowej. Dał jedno ujęcie analizy czynnikowej, teorii reagowania na pozycje i modeli struktur latentnych Lazarsfelda.
- Modele struktur kowariancji (lata 70.). W Toronto z H. Swaminathanem opracował rachunek macierzowy, na którym oparto program COSAN – pierwszy, który dopasowywał niestandardowe struktury kowariancji; z niego wyprowadzono program NOHARM. Brał też udział w sporze o nieoznaczoność czynników i przyznawał rację Guttmanowi, że czynnik wspólny wymaga nieskończonej dziedziny zachowań.
- Podręczniki. Factor Analysis and Related Methods (1985) zaskoczył czytelników prostotą matematyki. Test Theory: A Unified Treatment (McDonald, 1999) łączy klasyczną teorię testów z nieliniowymi modelami IRT i jest przywoływany jako źródło omegi McDonalda.
- Podstawy modeli strukturalnych. W latach 90. podał ścisły opis metody PLS Hermana Wolda (1996), a po konsultacjach z Judeą Pearlem algebraicznie powiązał grafy przyczynowe z równaniami analizy ścieżek (2002).
Ciekawostka
McDonald miał zostać filologiem. Po magisterium z fizyki wrócił na uniwersytet jako student zaoczny, żeby studiować literaturę angielską. Jak sam mówił, zboczył do psychologii, bo z niej dostawał lepsze oceny, nagrody i w końcu University Medal. Po latach przyznawał, że nie żałuje porzucenia ukochanych poetów XVI wieku – poezja i powieści zostały tematem rozmów w domu (Maydeu-Olivares i McArdle, 2005).
Humor nie opuszczał go także w pracy. Wykład prezesowski w Psychometric Society, wygłoszony w 1986 r. w Toronto, zawierał zamiast matematyki rysunki satyryczne. Artykuł „Haldane’s lungs” (1997) o założeniach analizy ścieżek napisał z przymrużeniem oka, gdy recenzenci odrzucili jego poważniejszą, techniczną wersję, twierdząc, że te podstawy są dobrze znane.
Przykład na prawdziwych danych
Zbiór Reise z pakietu psych to – według pliku pomocy – macierz korelacji 16 pytań ankiety CAHPS o opiece zdrowotnej, oparta na ponad 35 000 obserwacji. Pytania tworzą pięć grup: szybka pomoc (3 pytania), rozmowa z lekarzem (4), uprzejmy personel (2), potrzebna opieka (4) i obsługa ubezpieczyciela (3). To typowa sytuacja dla modelu bifactor: jeden czynnik ogólny (zadowolenie z opieki) i kilka czynników grupowych.
Średnia korelacja między pytaniami wynosi .383, a alfa Cronbacha dla sumy 16 pytań .909. Rozwiązanie Schmida–Leimana z funkcji omega() rozkłada wariancję inaczej: ω całkowita = .930 (tyle wariancji sumy to wariancja wspólna), ale ω hierarchiczna = .825 – tyle pochodzi wyłącznie od czynnika ogólnego. Czynnik ogólny wyjaśnia 69.6% wariancji wspólnej (ECV = .696). Obie omegi policzone ręcznie ze wzorów zgadzają się z wynikiem pakietu co do trzeciego miejsca.
Wersja konfirmacyjna – model bifactor w lavaan z pięcioma ortogonalnymi czynnikami grupowymi (dla dwóch pytań o personel ładunki grupowe zrównano, żeby model był identyfikowalny) – pasuje dobrze (CFI = .974, RMSEA = .046, SRMR = .034) i daje ω_h = .860 oraz ω_t = .928. Podskale wyglądają gorzej: w grupie pytań o rozmowę z lekarzem ω całkowita wynosi .896, ale tylko .224 wariancji tej podskali pochodzi od jej własnego czynnika – reszta to czynnik ogólny.
Na rysunku
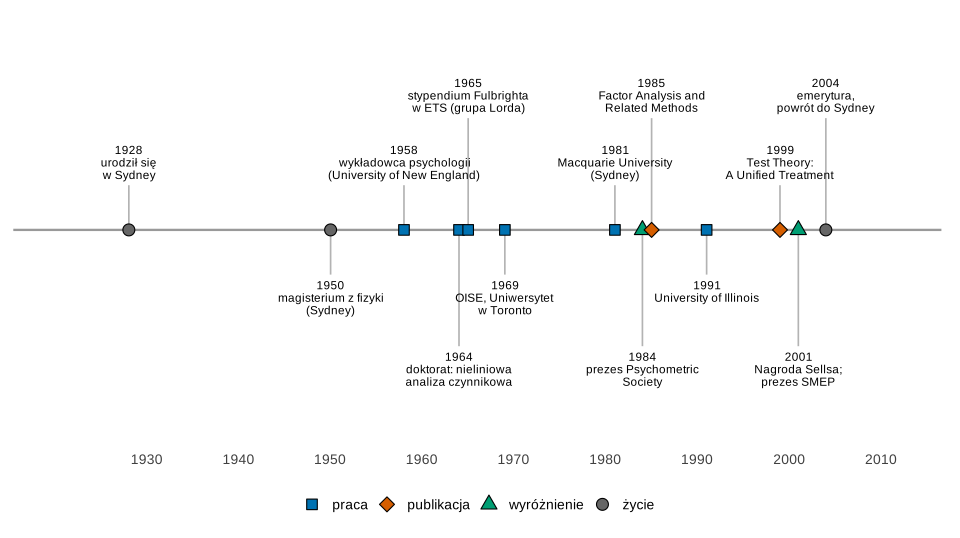
Co widać. Kariera na trzech kontynentach: Australia, Kanada, Stany Zjednoczone i znowu Australia. Najważniejsze książki powstały po pięćdziesiątce.
Na co uważać. Na osi nie ma daty śmierci: dostępna część nekrologu (McDonald, 2012) jej nie podaje, a innego potwierdzenia nie znaleźliśmy.
Podpis do pracy:
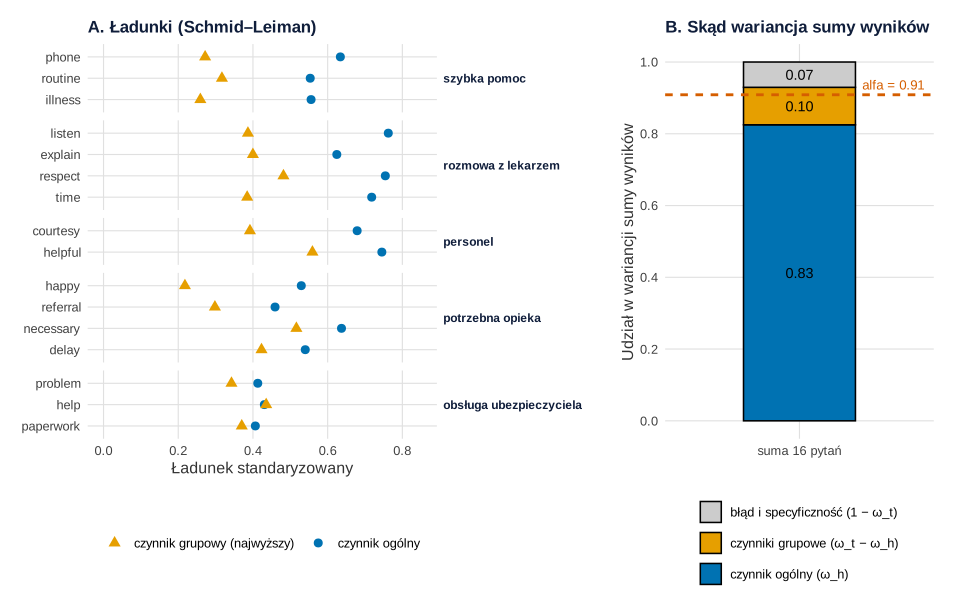
psych::Reise. Obliczenia i rysunek: R, pakiety psych, ggplot2 i patchwork (bez losowania).Co widać. W panelu A prawie wszystkie niebieskie kółka leżą na prawo od trójkątów – pytania mierzą głównie wspólne zadowolenie, a podskale dokładają niewiele. Panel B pokazuje to samo w liczbach: alfa (.91) wypada pomiędzy ω_h (.83) a ω_t (.93), więc nie mówi ani o samym czynniku ogólnym, ani o całej wariancji wspólnej.
Na co uważać. Rozwiązanie Schmida–Leimana zależy od liczby czynników i metody ekstrakcji; z modelu konfirmacyjnego ω_h wyszło .860. Dane są macierzą korelacji, więc liczymy omegi dla sumy wyników standaryzowanych.
Podpis do pracy:
Gdzie spotkasz McDonalda w swojej pracy
Za każdym razem, gdy raportujesz rzetelność skali. Na co zwracać uwagę:
- dla skali jednowymiarowej podawaj ω całkowitą obok alfy albo zamiast niej; w modelu kongenerycznym alfa zaniża rzetelność; omegę z ładunków policzysz w kalkulatorze alfy i omegi;
- gdy skala ma podskale i liczysz wynik ogólny, podaj ω hierarchiczną – mówi, na ile ten wynik odzwierciedla jedną cechę; Revelle i Condon (2019) zalecają raportowanie właśnie ω_h i ω_t;
- wynik podskali interpretuj ostrożnie, gdy jej własny czynnik wyjaśnia mało wariancji (jak w przykładzie); więcej o modelach z czynnikiem ogólnym we wpisie Model bifactor i ESEM.
Spory, mity i trudne strony
- „Omega to po prostu lepsza alfa”. Nie ma jednej omegi. ω_t i ω_h odpowiadają na różne pytania, a Zinbarg i in. (2005) wykazali formalnie, że α, β Revellego i ω_h są różnymi współczynnikami i równają się tylko w wąskich warunkach.
- Kto wymyślił omegę? W literaturze przywołuje się ją za podręcznikiem McDonalda (1999), a Zinbarg i in. (2005) już w tytule nazywają ω_h współczynnikiem McDonalda. Sposób szacowania ma znaczenie: w przykładzie ω_h z rozwiązania Schmida–Leimana i z modelu konfirmacyjnego różnią się o .035.
- Nieoznaczoność czynników. McDonald przyznawał, że wplątał się w ten długi spór z żalem; wyszedł z niego z przekonaniem, że cechę latentną definiuje nieskończona dziedzina zachowań (Maydeu-Olivares i McArdle, 2005).
Omega całkowita i hierarchiczna w R
Kod wczytuje macierz korelacji Reise, liczy alfę ręcznie i funkcją psych::alpha(), omegi z rozwiązania Schmida–Leimana ręcznie i funkcją psych::omega(), a potem omegi z konfirmacyjnego modelu bifactor w lavaan i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Kod nie losuje.
1. Alfa, omega i model bifactor: rysunek 2
Kod R rysunku 2
# McDonald: omega całkowita i hierarchiczna vs alfa na 16 pytaniach o opiekę zdrowotną (psych::Reise)
suppressPackageStartupMessages({library(psych); library(GPArotation); library(lavaan); library(ggplot2); library(patchwork)})
kol <- c(ogolny = "#0072B2", grupowy = "#E69F00", blad = "grey80", alfa = "#D55E00")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
options(width = 100)
data(Reise, package = "psych")
# macierz korelacji 16 pytań ankiety CAHPS o opiece zdrowotnej; pięć grup pytań według pliku pomocy
grupy <- c(rep("szybka pomoc", 3), rep("rozmowa z lekarzem", 4), rep("personel", 2),
           rep("potrzebna opieka", 4), rep("obsługa ubezpieczyciela", 3))
data.frame(pytanie = colnames(Reise), grupa = grupy)

# 1. Alfa Cronbacha (z macierzy korelacji – wersja standaryzowana)
k <- ncol(Reise); suma_R <- sum(Reise)              # suma_R = wariancja sumy wyników standaryzowanych
alfa <- k / (k - 1) * (1 - k / suma_R)
round(c(alfa_recznie = alfa, alfa_psych = psych::alpha(Reise)$total$std.alpha, srednia_r = mean(Reise[lower.tri(Reise)])), 3)

# 2. Omega z rozwiązania Schmida–Leimana (psych::omega, 5 czynników grupowych)
om <- omega(Reise, nfactors = 5, plot = FALSE)
sl <- om$schmid$sl
g <- sl[, "g"]; u2 <- sl[, "u2"]
omega_h <- sum(g)^2 / suma_R                         # wariancja od czynnika ogólnego / wariancja sumy
omega_t <- 1 - sum(u2) / suma_R                      # wariancja wspólna (ogólny + grupowe) / wariancja sumy
round(c(omega_h_recznie = omega_h, omega_h_psych = om$omega_h,
        omega_t_recznie = omega_t, omega_t_psych = om$omega.tot, ECV = unname(om$ECV)), 3)
round(om$omega.group, 3)

# 3. To samo konfirmacyjnie: model bifactor w lavaan (czynnik ogólny + 5 grupowych, ortogonalne)
model <- "
  ogolny =~ phone + routine + illness + listen + explain + respect + time + courtesy +
            helpful + happy + referral + necessary + delay + problem + help + paperwork
  szybka    =~ phone + routine + illness
  lekarz    =~ listen + explain + respect + time
  personel  =~ a*courtesy + a*helpful
  potrzebna =~ happy + referral + necessary + delay
  obsluga   =~ problem + help + paperwork"
fit <- cfa(model, sample.cov = Reise, sample.nobs = 35000, std.lv = TRUE, orthogonal = TRUE)
round(fitMeasures(fit, c("cfi", "rmsea", "srmr")), 3)
lam <- lavInspect(fit, "std")$lambda
theta <- diag(lavInspect(fit, "std")$theta)
wspolna_grupy <- sum(colSums(lam[, -1])^2)
mianownik <- sum(lam[, "ogolny"])^2 + wspolna_grupy + sum(theta)
round(c(omega_h_cfa = sum(lam[, "ogolny"])^2 / mianownik,
        omega_t_cfa = (sum(lam[, "ogolny"])^2 + wspolna_grupy) / mianownik), 3)

# Rysunek: A – ładunki ogólne i grupowe (Schmid–Leiman); B – rozkład wariancji sumy wyników
lad <- data.frame(pytanie = rep(rownames(sl), 2), grupa = rep(grupy, 2),
                  rodzaj = rep(c("czynnik ogólny", "czynnik grupowy (najwyższy)"), each = k),
                  ladunek = c(g, apply(abs(sl[, grep("^F", colnames(sl))]), 1, max)))
lad$pytanie <- factor(lad$pytanie, levels = rev(rownames(sl)))
lad$grupa <- factor(lad$grupa, levels = unique(grupy))
pA <- ggplot(lad, aes(ladunek, pytanie, colour = rodzaj, shape = rodzaj)) +
  geom_point(size = 2.8) +
  facet_grid(grupa ~ ., scales = "free_y", space = "free_y") +
  scale_colour_manual(values = c(`czynnik ogólny` = kol[["ogolny"]], `czynnik grupowy (najwyższy)` = kol[["grupowy"]]), name = NULL) +
  scale_shape_manual(values = c(`czynnik ogólny` = 16, `czynnik grupowy (najwyższy)` = 17), name = NULL) +
  scale_x_continuous(limits = c(0, 0.85), breaks = seq(0, 0.8, 0.2)) +
  labs(title = "A. Ładunki (Schmid–Leiman)", x = "Ładunek standaryzowany", y = NULL) +
  motyw + theme(strip.text.y = element_text(angle = 0, hjust = 0, size = 9))
czesci <- data.frame(skladnik = factor(c("czynnik ogólny (ω_h)", "czynniki grupowe (ω_t − ω_h)", "błąd i specyficzność (1 − ω_t)"),
                                       levels = c("błąd i specyficzność (1 − ω_t)", "czynniki grupowe (ω_t − ω_h)", "czynnik ogólny (ω_h)")),
                     udzial = c(omega_h, omega_t - omega_h, 1 - omega_t))
pB <- ggplot(czesci, aes(x = "suma 16 pytań", y = udzial, fill = skladnik)) +
  geom_col(width = 0.5, colour = "black") +
  geom_text(aes(label = sprintf("%.2f", udzial)), position = position_stack(vjust = 0.5), size = 3.8) +
  geom_hline(yintercept = alfa, colour = kol[["alfa"]], linetype = "22", linewidth = 1) +
  annotate("text", x = 1.28, y = alfa + 0.015, hjust = 0, vjust = 0, size = 3.5, colour = kol[["alfa"]],
           label = sprintf("alfa = %.2f", alfa)) +
  scale_fill_manual(values = c(`czynnik ogólny (ω_h)` = kol[["ogolny"]], `czynniki grupowe (ω_t − ω_h)` = kol[["grupowy"]],
                               `błąd i specyficzność (1 − ω_t)` = kol[["blad"]]), name = NULL) +
  scale_y_continuous(breaks = seq(0, 1, 0.2)) +
  labs(title = "B. Skąd wariancja sumy wyników", x = NULL, y = "Udział w wariancji sumy wyników") +
  guides(fill = guide_legend(ncol = 1)) +
  motyw
p2 <- pA + pB + plot_layout(widths = c(1.3, 1))
p2
Wynik w R
     pytanie                   grupa
1      phone            szybka pomoc
2    routine            szybka pomoc
3    illness            szybka pomoc
4     listen      rozmowa z lekarzem
5    explain      rozmowa z lekarzem
6    respect      rozmowa z lekarzem
7       time      rozmowa z lekarzem
8   courtesy                personel
9    helpful                personel
10     happy        potrzebna opieka
11  referral        potrzebna opieka
12 necessary        potrzebna opieka
13     delay        potrzebna opieka
14   problem obsługa ubezpieczyciela
15      help obsługa ubezpieczyciela
16 paperwork obsługa ubezpieczyciela
alfa_recznie   alfa_psych    srednia_r
       0.909        0.909        0.383
omega_h_recznie   omega_h_psych omega_t_recznie   omega_t_psych             ECV
          0.825           0.825           0.930           0.930           0.696
    total general group
g   0.930   0.825 0.072
F1* 0.896   0.672 0.224
F2* 0.642   0.404 0.238
F3* 0.720   0.458 0.262
F4* 0.683   0.552 0.131
F5* 0.845   0.584 0.261
  cfi rmsea  srmr
0.974 0.046 0.034
omega_h_cfa omega_t_cfa
      0.860       0.928
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Roderick P. McDonald (urodzony w 1928 r. w Sydney) – lata według cytowanych źródeł
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1928, 1950, 1958, 1964, 1965, 1969, 1981, 1984, 1985, 1991, 1999, 2001, 2004),
  opis = c("urodził się\nw Sydney", "magisterium z fizyki\n(Sydney)", "wykładowca psychologii\n(University of New England)",
           "doktorat: nieliniowa\nanaliza czynnikowa", "stypendium Fulbrighta\nw ETS (grupa Lorda)", "OISE, Uniwersytet\nw Toronto",
           "Macquarie University\n(Sydney)", "prezes Psychometric\nSociety", "Factor Analysis and\nRelated Methods",
           "University of Illinois", "Test Theory:\nA Unified Treatment", "Nagroda Sellsa;\nprezes SMEP", "emerytura,\npowrót do Sydney"),
  rodzaj = c("życie", "życie", "praca", "praca", "praca", "praca", "praca", "wyróżnienie", "publikacja",
             "praca", "publikacja", "wyróżnienie", "życie"),
  poziom = c(0.5, -0.5, 0.5, -1.3, 1.25, -0.5, 0.5, -1.3, 1.25, -0.5, 0.5, -1.3, 1.25),   # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))           # rozsunięcie bliskich etykiet
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.07 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1920, 2012), breaks = seq(1930, 2010, by = 10)) +
  scale_y_continuous(limits = c(-2.2, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (alfa, omega i dane – pakiet psych, rotacje – GPArotation; model bifactor – lavaan; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3.1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Roderick P. McDonald?
Australijskim psychometrą urodzonym w 1928 r. w Sydney. Z wykształcenia był fizykiem; psychologią zajął się podczas zaocznych studiów. Pracował w University of New England, w Ontario Institute for Studies in Education w Toronto, w Macquarie University i od 1991 r. w University of Illinois. W 1984 r. został prezesem Psychometric Society. Zginął w wypadku podczas nurkowania z rurką na Jamajce; nekrolog ukazał się w styczniu 2012 r.
Dlaczego omega nazywa się omegą McDonalda?
Bo w literaturze przywołuje się ją za jego podręcznikiem Test Theory: A Unified Treatment (1999). Omega wylicza rzetelność sumy wyników z modelu czynnikowego: ω całkowita to udział wariancji wspólnej (czynnik ogólny i grupowe), a ω hierarchiczna – udział samego czynnika ogólnego.
Czym różni się omega hierarchiczna od alfy Cronbacha?
Alfa nie rozróżnia źródeł wariancji wspólnej, a ω_h liczy tylko to, co pochodzi od czynnika ogólnego. Zinbarg i in. (2005) pokazali, że α i ω_h są równe tylko w bardzo restrykcyjnych warunkach. W przykładzie na 16 pytaniach ankiety α = .91, ω całkowita = .93, a ω hierarchiczna = .83.
Czym zajmował się McDonald poza omegą?
Nieliniową analizą czynnikową (1967), która łączyła analizę czynnikową, IRT i modele struktur latentnych; ogólnymi modelami struktur kowariancji (program COSAN), modelami wielopoziomowymi, nieoznaczonością czynników, a pod koniec kariery – podstawami analizy ścieżek i PLS Wolda.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Kalkulator alfy i omegi z ładunków
Omega McDonalda, alfa Cronbacha i współczynnik H z ładunków CFA oraz liczba pozycji potrzebna do zadanej rzetelności. Ze wzorami i kodem R.
Czytaj →PoradnikModel bifactor i ESEM
Od CFA do bifactor-ESEM na jednym kwestionariuszu: ładunki krzyżowe, czynnik ogólny, omega H, ECV, trafność podskal, tabela APA i kod lavaan.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Maydeu-Olivares, A., & McArdle, J. J. (Eds.). (2005). Contemporary psychometrics: A festschrift for Roderick P. McDonald. Lawrence Erlbaum Associates. https://doi.org/10.4324/9781410612977 ● Otwarty dostęp: pełny tekst
- McDonald, P. (2012). Leading psychologist dies in accident. Campus Review. https://www.campusreview.com.au/?p=38609
- McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates.
- Revelle, W., & Condon, D. M. (2019). Reliability from α to ω: A tutorial. Psychological Assessment, 31(12), 1395–1411. https://doi.org/10.1037/pas0000754 ● Otwarty dostęp
- Zinbarg, R. E., Revelle, W., Yovel, I., & Li, W. (2005). Cronbach’s α, Revelle’s β, and McDonald’s ωH: Their relations with each other and two alternative conceptualizations of reliability. Psychometrika, 70(1), 123–133. https://doi.org/10.1007/s11336-003-0974-7
Cytowania BibTeX
@book{maydeu2005contemporary, author={Maydeu-Olivares, Albert and McArdle, John J.}, title={{Contemporary psychometrics: A festschrift for Roderick P. McDonald}}, year={2005}, publisher={Lawrence Erlbaum Associates}, doi={10.4324/9781410612977}}@misc{mcdonald2012leading, author={McDonald, Peter}, title={{Leading psychologist dies in accident}}, howpublished={Campus Review}, year={2012}, url={https://www.campusreview.com.au/?p=38609}}@book{mcdonald1999test, author={McDonald, Roderick P.}, title={{Test theory: A unified treatment}}, year={1999}, publisher={Lawrence Erlbaum Associates}}@article{revelle2019reliability, author={Revelle, William and Condon, David M.}, title={{Reliability from α to ω: A tutorial}}, journal={Psychological Assessment}, year={2019}, volume={31}, number={12}, pages={1395--1411}, doi={10.1037/pas0000754}}@article{zinbarg2005cronbach, author={Zinbarg, Richard E. and Revelle, William and Yovel, Iftah and Li, Wen}, title={{Cronbach’s α, Revelle’s β, and McDonald’s ωH: Their relations with each other and two alternative conceptualizations of reliability}}, journal={Psychometrika}, year={2005}, volume={70}, number={1}, pages={123--133}, doi={10.1007/s11336-003-0974-7}}