Kim był Paul F. Lazarsfeld?
Paul Felix Lazarsfeld (1901–1976) urodził się 13 lutego 1901 r. w Wiedniu. Z wykształcenia był matematykiem: w 1925 r. obronił na Uniwersytecie Wiedeńskim doktorat z matematyki stosowanej, w którym zastosował teorię grawitacji Einsteina do ruchu Merkurego. W tym samym roku założył w Wiedniu instytut badań stosowanych – Wirtschaftspsychologische Forschungsstelle – który prowadził badania konsumenckie i społeczne; jego najbardziej znanym dziełem było studium bezrobotnego miasteczka Marienthal (1933) (Sills, 1987).
We wrześniu 1933 r. przyjechał do Stanów Zjednoczonych jako stypendysta Fundacji Rockefellera i po wojnie domowej w Austrii w 1934 r. już nie wrócił. Kierował ośrodkiem badawczym w Newark, od 1937 r. Princeton Radio Project, a od 1939 r. pracował na Columbii (od 1940 r. jako profesor nadzwyczajny). W 1944 r. jego biuro badań radiowych przemianowano na Bureau of Applied Social Research. W 1962 r. objął katedrę nazwaną imieniem Queteleta, a w latach 1961–1962 był prezesem American Sociological Association. Po przejściu na emeryturę w 1969 r. wykładał w University of Pittsburgh. Zmarł 30 sierpnia 1976 r. w Nowym Jorku (Sills, 1987).
Najważniejsze pomysły
- Analiza struktur latentnych. Lazarsfeld zakładał, że związki między odpowiedziami na pytania ankiety tłumaczy nieobserwowana zmienna ukryta; jeśli jest ona kategorialna, w obrębie każdej klasy odpowiedzi są niezależne. Pomysł wypracował w czasie wojny w rozmowach z Samuelem Stoufferem, opisał w rozdziale z 1959 r., a podsumował w książce Latent Structure Analysis (1968) napisanej z Neilem W. Henrym (Sills, 1987). Dziś to analiza klas latentnych; metodę największej wiarygodności i sprawdzanie identyfikowalności takich modeli dopracował Goodman (1974).
- Badania panelowe. Żeby oddzielić wpływ radia na postawy od wpływu postaw na wybór audycji, Lazarsfeld wielokrotnie przepytywał tę samą próbę. Nie wymyślił panelu, ale – jak pisze Sills (1987) – był jego najskuteczniejszym wczesnym propagatorem, m.in. w badaniu wyborów prezydenckich 1940 r. (The People’s Choice, 1944).
- Analiza danych sondażowych. Przekształcił sondaż opinii z narzędzia opisowego w wielozmiennową analizę przyczynową. Praca z Patricią Kendall z 1950 r. skodyfikowała sposoby unikania związków pozornych przez wprowadzanie trzeciej zmiennej do tabeli krzyżowej (Sills, 1987). Z tej tradycji „elaboracji” wywodzi się pojęcie zmiennej pośredniczącej (Kenny, 2024).
- Matematyka w naukach społecznych. Zredagował tom Mathematical Thinking in the Social Sciences (1954) i zachęcał uczniów do modeli matematycznych.
Ciekawostka
Lazarsfeld, matematyk z wykształcenia, poznał tablicę czteropolową dopiero w Ameryce. Według wspomnienia Sillsa (1987) pokazał mu ją Samuel Stouffer, który w 1937 r. podczas lunchu w Newarku narysował ją na obrusie. Tak zaczęła się trwająca do śmierci Stouffera w 1960 r. współpraca – Lazarsfeld nazywał ją sojuszem – z której wyrosły m.in. jego pomysły na analizę struktur latentnych i przyczynową analizę danych sondażowych.
Ta sama relacja pokazuje, jak Lazarsfeld pracował: prawie wszystko pisał ze współpracownikami, a jego teksty redagował przyjaciel z Columbii, socjolog Robert K. Merton. Na egzemplarzu długiego rozdziału o analizie struktur latentnych, który podarował Mertonowi, Lazarsfeld dopisał żartobliwie, że to pierwszy od 20 lat tekst, nad którym Merton nie musiał pracować (Sills, 1987).
Przykład na historycznych danych
Zbiór values z pakietu poLCA to – według pliku pomocy – odpowiedzi 216 osób na cztery pytania dychotomiczne (A, B, C, D) z badania Stouffera i Toby’ego (1951), później analizowane przez Goodmana (1974). Studenci rozstrzygali hipotetyczne konflikty ról; odpowiedź „uniwersalistyczna” daje pierwszeństwo zobowiązaniom bezosobowym, a „partykularystyczna” – osobistym. Odsetek odpowiedzi uniwersalistycznych wynosi .792 w pytaniu A, .500 w B, .514 w C i .310 w D. Wszystkie 16 możliwych wzorców odpowiedzi występuje w danych.
Jedna klasa, czyli założenie, że pytania są niezależne, nie pasuje: G² = 81.08, df = 11, p < .001. Dwie klasy latentne pasują bardzo dobrze: G² = 2.72, df = 6, p = .843 (statystyka G), a BIC spada z 1108.8 do 1057.3. Klasa „partykularystyczna” obejmuje 72.1% osób, a prawdopodobieństwo odpowiedzi uniwersalistycznej wynosi w niej od .132 (D) do .714 (A). W klasie „uniwersalistycznej” (27.9%) to od .769 do .993.
Ten sam model dopasowaliśmy własnym algorytmem EM – kilkanaście wierszy kodu, 120 iteracji – i uzyskaliśmy identyczną log-wiarygodność (−504.4677) i parametry. Model dwuklasowy odtwarza liczebności wzorców: 42 osoby odpowiedziały uniwersalistycznie na wszystkie pytania, model niezależności przewiduje 13.6, a model dwuklasowy 41.8. Przypisanie do klasy najbardziej prawdopodobnej daje 32.9% osób w klasie uniwersalistycznej; najmniej pewne są wzorce z trzema odpowiedziami uniwersalistycznymi (prawdopodobieństwo klasy od .285 do .517).
Na rysunku
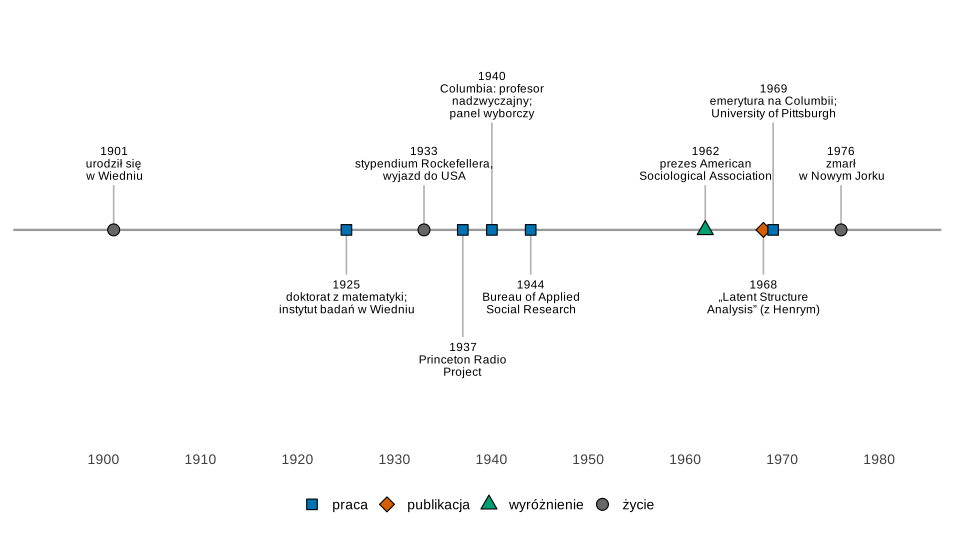
Co widać. Prawie wszystkie instytucje, z którymi związany jest Lazarsfeld, założył lub przekształcił sam – od wiedeńskiego instytutu (1925) po Bureau na Columbii (1944).
Na co uważać. Rok 1962 przy prezesurze to rok kongresu ASA; Sills podaje kadencję 1961–1962. Na osi nie ma badania Marienthalu (1933), bo to studium w dużej części jakościowe.
Podpis do pracy:
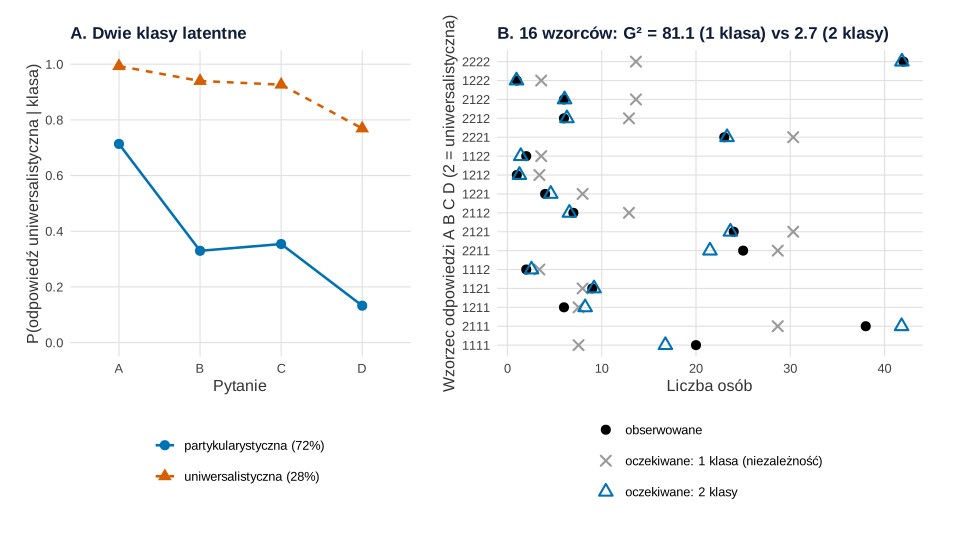
poLCA::values, N = 216): profil klas (A) i liczebności 16 wzorców odpowiedzi – obserwowane oraz oczekiwane przy jednej i dwóch klasach (B). Estymacja: pakiet poLCA (10 startów, set.seed(1950)). Rysunek: R, pakiety ggplot2 i patchwork.Co widać. Klasy różnią się najbardziej w pytaniach B i C; pytanie A „łatwo” dostaje odpowiedź uniwersalistyczną w obu klasach, a D – rzadko nawet w klasie uniwersalistycznej. W panelu B model niezależności zaniża liczbę osób spójnych (wzorce 2222 i 1111) i zawyża liczbę mieszanych; dwie klasy usuwają ten rozjazd.
Na co uważać. Klasy latentne to model, nie odkryte „typy ludzi”. Przy czterech pytaniach dychotomicznych tabela ma tylko 15 swobodnych liczebności, a model z trzema klasami ma już 14 parametrów – więcej klas szybko wyczerpuje informację w danych. Nazwy klas nadaliśmy sami na podstawie profilu.
Podpis do pracy:
Gdzie spotkasz Lazarsfelda w swojej pracy
- Typologie z ankiety. Gdy chcesz pogrupować respondentów według wzorców odpowiedzi, sięgasz po klasy latentne – krok po kroku pokazuje to wpis Analiza klas latentnych (LCA). Raportuj G² lub BIC dla kilku liczb klas, profil klas i pewność przypisania.
- Trzecia zmienna w tabeli. Sprawdzanie, czy związek dwóch zmiennych nie znika po kontroli trzeciej, to dziedzictwo analizy sondaży z Columbii; jego współczesną kontynuacją jest analiza mediacji (zob. Baron i Kenny).
- Panel. Przy powtarzanych wywiadach z tymi samymi osobami pamiętaj, że samo uczestnictwo może zmieniać odpowiedzi – zob. efekt warunkowania panelowego.
Spory, mity i trudne strony
- „Wynalazca panelu”? Sills (1987) pisze wprost, że Lazarsfeld panelu nie wymyślił – korzystał m.in. z wiedeńskich badań rozwojowych prowadzonych z Bühlerami i z wcześniejszych badań amerykańskich – ale najlepiej go wykorzystał.
- Czyj jest pomysł mediacji? Kenny (2024) przypisuje pojęcie zmiennej pośredniczącej grupie Lazarsfelda, a opis procedury w książce Hymana z 1955 r. – według przypisu – Patricii Kendall, która z powodu ówczesnych zasad zatrudniania krewnych nie mogła mieć etatu na Columbii, bo była żoną Lazarsfelda.
- Emigracja i wojna. Po klęsce socjaldemokratów w wojnie domowej w Austrii (1934) powrót na Uniwersytet Wiedeński stał się niemożliwy; książkę o Marienthalu naziści zakazali, a większość egzemplarzy spalono (Sills, 1987).
Model klas latentnych w R
Kod wczytuje dane Stouffera i Toby’ego (1951), dopasowuje modele z jedną i dwiema klasami latentnymi pakietem poLCA, powtarza model dwuklasowy własnym algorytmem EM, liczy liczebności oczekiwane 16 wzorców odpowiedzi i rysuje rysunek 2. Drugi przepis rysuje oś czasu (rysunek 1). Rysunki na stronie powstały z tych samych obiektów p1 i p2, którym podmieniono tylko motyw na motyw serwisu; dane, geometrie i skale są identyczne. Losowe są tylko punkty startowe poLCA (set.seed(1950), 10 startów); EM startuje z wartości wpisanych w kodzie.
1. Klasy latentne z poLCA i ręcznym EM: rysunek 2
Kod R rysunku 2
# Lazarsfeld: model klas latentnych dla czterech pytań 0/1 (poLCA::values – Stouffer i Toby, 1951)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(poLCA)})
kol <- c(klasa1 = "#0072B2", klasa2 = "#D55E00", jedna = "#999999", obs = "#000000")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"), legend.position = "bottom")
data(values, package = "poLCA")
# A, B, C, D – cztery pytania; 1 = odpowiedź „partykularystyczna”, 2 = „uniwersalistyczna”
c(N = nrow(values))
round(colMeans(values == 2), 3)                       # odsetek odpowiedzi uniwersalistycznych w pytaniach
wzorce <- as.data.frame(table(apply(values, 1, paste, collapse = "")), stringsAsFactors = FALSE)
names(wzorce) <- c("wzorzec", "n_obs")
wzorce <- merge(data.frame(wzorzec = apply(expand.grid(D = 1:2, C = 1:2, B = 1:2, A = 1:2)[, 4:1], 1, paste, collapse = "")),
                wzorce, all.x = TRUE)
wzorce$n_obs[is.na(wzorce$n_obs)] <- 0
c(liczba_wzorcow = nrow(wzorce), puste_wzorce = sum(wzorce$n_obs == 0))

# 1. Modele z jedną (niezależność pytań) i z dwiema klasami latentnymi
f <- cbind(A, B, C, D) ~ 1
set.seed(1950)
m1 <- poLCA(f, values, nclass = 1, verbose = FALSE)
m2 <- poLCA(f, values, nclass = 2, nrep = 10, verbose = FALSE)
round(rbind(jedna_klasa = c(logL = m1$llik, G2 = m1$Gsq, df = m1$resid.df, p = 1 - pchisq(m1$Gsq, m1$resid.df), BIC = m1$bic),
            dwie_klasy  = c(logL = m2$llik, G2 = m2$Gsq, df = m2$resid.df, p = 1 - pchisq(m2$Gsq, m2$resid.df), BIC = m2$bic)), 3)

# 2. Parametry modelu dwuklasowego: wielkości klas i P(odpowiedź uniwersalistyczna | klasa)
kolejnosc <- order(sapply(1:2, function(k) mean(sapply(m2$probs, function(p) p[k, 2]))))   # najpierw klasa „partykularystyczna”
profil <- sapply(m2$probs, function(p) p[kolejnosc, 2])
rownames(profil) <- c("klasa_partykularystyczna", "klasa_uniwersalistyczna")
round(cbind(udzial = m2$P[kolejnosc], profil), 3)

# 3. Ten sam model „ręcznie”: algorytm EM w kilkunastu wierszach
y <- as.matrix(values) - 1                              # 1 = odpowiedź uniwersalistyczna
pi_k <- c(0.5, 0.5); th <- rbind(rep(0.3, 4), rep(0.7, 4))   # wartości startowe
logL_stare <- -Inf
for (iter in 1:5000) {
  lik <- sapply(1:2, function(k) pi_k[k] * apply(y, 1, function(r) prod(th[k, ]^r * (1 - th[k, ])^(1 - r))))
  logL <- sum(log(rowSums(lik)))
  if (logL - logL_stare < 1e-10) break                  # koniec, gdy logL przestaje rosnąć
  logL_stare <- logL
  post <- lik / rowSums(lik)                            # krok E: prawdopodobieństwa przynależności
  pi_k <- colMeans(post)                                # krok M: udziały klas
  th <- t(sapply(1:2, function(k) colSums(post[, k] * y) / sum(post[, k])))
}
round(c(logL_EM = logL, logL_poLCA = m2$llik, iteracje = iter), 4)
round(cbind(udzial = pi_k, th), 3)

# 4. Liczebności oczekiwane 16 wzorców odpowiedzi i przypisanie wzorca do klasy
y16 <- t(sapply(strsplit(wzorce$wzorzec, ""), as.numeric)) - 1
prob_wzorca <- function(pk, tk) sapply(seq_along(pk), function(k) pk[k] * apply(y16, 1, function(r) prod(tk[k, ]^r * (1 - tk[k, ])^(1 - r))))
p1 <- prob_wzorca(1, matrix(colMeans(y), 1)); p2 <- prob_wzorca(m2$P[kolejnosc], profil)
wzorce$n_1klasa <- nrow(values) * p1[, 1]
wzorce$n_2klasy <- nrow(values) * rowSums(p2)
wzorce$P_klasa_uniw <- p2[, 2] / rowSums(p2)
wzorce$liczba_uniw <- rowSums(y16)
wzorce <- wzorce[order(-wzorce$liczba_uniw, wzorce$wzorzec), ]
print(transform(wzorce, n_1klasa = round(n_1klasa, 1), n_2klasy = round(n_2klasy, 1), P_klasa_uniw = round(P_klasa_uniw, 3)),
      row.names = FALSE)
c(odsetek_w_klasie_uniw = round(sum(wzorce$n_obs * (wzorce$P_klasa_uniw > 0.5)) / nrow(values), 3))

# Rysunek: A – profil dwóch klas; B – liczebności obserwowane i oczekiwane 16 wzorców
prof <- data.frame(pytanie = rep(colnames(profil), each = 2),
                   klasa = rep(sprintf("%s (%.0f%%)", c("partykularystyczna", "uniwersalistyczna"), 100 * m2$P[kolejnosc]), 4),
                   p = as.vector(profil))
pA <- ggplot(prof, aes(pytanie, p, colour = klasa, shape = klasa, linetype = klasa, group = klasa)) +
  geom_line(linewidth = 0.9) + geom_point(size = 3.2) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.2)) +
  scale_colour_manual(values = unname(kol[c("klasa1", "klasa2")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "22"), name = NULL) +
  labs(title = "A. Dwie klasy latentne", x = "Pytanie", y = "P(odpowiedź uniwersalistyczna | klasa)") +
  motyw + guides(colour = guide_legend(ncol = 1))
wz <- rbind(data.frame(wzorzec = wzorce$wzorzec, n = wzorce$n_obs, rodzaj = "obserwowane"),
            data.frame(wzorzec = wzorce$wzorzec, n = wzorce$n_1klasa, rodzaj = "oczekiwane: 1 klasa (niezależność)"),
            data.frame(wzorzec = wzorce$wzorzec, n = wzorce$n_2klasy, rodzaj = "oczekiwane: 2 klasy"))
wz$wzorzec <- factor(wz$wzorzec, levels = rev(wzorce$wzorzec))
wz$rodzaj <- factor(wz$rodzaj, levels = c("obserwowane", "oczekiwane: 1 klasa (niezależność)", "oczekiwane: 2 klasy"))
pB <- ggplot(wz, aes(n, wzorzec, colour = rodzaj, shape = rodzaj)) +
  geom_point(size = 2.8, stroke = 1.1) +
  scale_colour_manual(values = unname(kol[c("obs", "jedna", "klasa1")]), name = NULL) +
  scale_shape_manual(values = c(16, 4, 2), name = NULL) +
  labs(title = sprintf("B. 16 wzorców: G² = %.1f (1 klasa) vs %.1f (2 klasy)", m1$Gsq, m2$Gsq),
       x = "Liczba osób", y = "Wzorzec odpowiedzi A B C D (2 = uniwersalistyczna)") +
  motyw + guides(colour = guide_legend(ncol = 1))
p2 <- pA + pB + plot_layout(widths = c(1, 1.25))
p2
Wynik w R
  N
216
    A     B     C     D
0.792 0.500 0.514 0.310
liczba_wzorcow   puste_wzorce
            16              0
                logL     G2 df     p      BIC
jedna_klasa -543.650 81.084 11 0.000 1108.801
dwie_klasy  -504.468  2.720  6 0.843 1057.313
                         udzial     A    B     C     D
klasa_partykularystyczna  0.721 0.714 0.33 0.354 0.132
klasa_uniwersalistyczna   0.279 0.993 0.94 0.927 0.769
   logL_EM logL_poLCA   iteracje
 -504.4677  -504.4677   120.0000
     udzial     A    B     C     D
[1,]  0.721 0.714 0.33 0.354 0.132
[2,]  0.279 0.993 0.94 0.927 0.769
 wzorzec n_obs n_1klasa n_2klasy P_klasa_uniw liczba_uniw
    2222    42     13.6     41.8        0.959           4
    1222     1      3.6      1.0        0.285           3
    2122     6     13.6      6.1        0.424           3
    2212     6     12.9      6.3        0.504           3
    2221    23     30.3     23.3        0.517           3
    1122     2      3.6      1.4        0.012           2
    1212     1      3.4      1.3        0.017           2
    1221     4      8.0      4.6        0.018           2
    2112     7     12.9      6.6        0.031           2
    2121    24     30.3     23.6        0.033           2
    2211    25     28.7     21.5        0.044           2
    1112     2      3.4      2.6        0.001           1
    1121     9      8.0      9.2        0.001           1
    1211     6      7.5      8.2        0.001           1
    2111    38     28.7     41.8        0.001           1
    1111    20      7.5     16.8        0.000           0
odsetek_w_klasie_uniw
                0.329
2. Oś czasu: rysunek 1
Kod R rysunku 1
# Oś czasu: Paul F. Lazarsfeld (1901–1976) – lata według wspomnienia Sillsa (1987)
library(ggplot2)
zdarzenia <- data.frame(
  rok = c(1901, 1925, 1933, 1937, 1940, 1944, 1962, 1968, 1969, 1976),
  opis = c("urodził się\nw Wiedniu", "doktorat z matematyki;\ninstytut badań w Wiedniu", "stypendium Rockefellera,\nwyjazd do USA",
           "Princeton Radio\nProject", "Columbia: profesor\nnadzwyczajny;\npanel wyborczy", "Bureau of Applied\nSocial Research",
           "prezes American\nSociological Association", "„Latent Structure\nAnalysis” (z Henrym)",
           "emerytura na Columbii;\nUniversity of Pittsburgh", "zmarł\nw Nowym Jorku"),
  rodzaj = c("życie", "praca", "życie", "praca", "praca", "praca", "wyróżnienie", "publikacja", "praca", "życie"),
  poziom = c(0.5, -0.5, 0.5, -1.2, 1.2, -0.5, 0.5, -0.5, 1.2, 0.5),          # wysokość etykiety (+ nad osią, − pod)
  wyrownanie = c(0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5))
zdarzenia$etykieta <- paste0(zdarzenia$rok, "\n", zdarzenia$opis)
ksztalty <- c("życie" = 21, "praca" = 22, "publikacja" = 23, "wyróżnienie" = 24)
kolory <- c("życie" = "grey40", "praca" = "#0072B2", "publikacja" = "#D55E00", "wyróżnienie" = "#009E73")   # Okabe–Ito
p1 <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60", linewidth = 0.8) +
  geom_segment(aes(xend = rok, y = 0, yend = poziom), colour = "grey70") +
  geom_point(aes(shape = rodzaj, fill = rodzaj), size = 3.8, colour = "black") +
  geom_text(aes(y = poziom + 0.06 * sign(poziom), label = etykieta, vjust = ifelse(poziom > 0, 0, 1), hjust = wyrownanie),
            size = 3.1, lineheight = 0.88) +
  scale_shape_manual(values = ksztalty, name = NULL) +
  scale_fill_manual(values = kolory, name = NULL) +
  scale_x_continuous(limits = c(1895, 1982), breaks = seq(1900, 1980, by = 10)) +
  scale_y_continuous(limits = c(-2.2, 2.2)) +
  labs(x = NULL, y = NULL) +
  theme_minimal(base_size = 13) +
  theme(axis.text.y = element_blank(), panel.grid = element_blank(), axis.text.x = element_text(colour = "grey30"),
        legend.position = "bottom")
p1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (model klas latentnych – pakiet poLCA; algorytm EM – kod bazowego R; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- poLCA (wersja 1.6.0.2): Linzer, D. A., & Lewis, J. B. (2011). poLCA: An R package for polytomous variable latent class analysis. Journal of Statistical Software, 42(10), 1–29. https://doi.org/10.18637/jss.v042.i10
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kim był Paul Lazarsfeld?
Socjologiem i metodologiem urodzonym w 1901 r. w Wiedniu. Doktoryzował się z matematyki stosowanej (1925), założył w Wiedniu instytut badań stosowanych, w 1933 r. przyjechał do USA jako stypendysta Fundacji Rockefellera i został. Od 1940 r. profesor Columbia University, gdzie kierował Bureau of Applied Social Research; prezes American Sociological Association (1961–1962). Zmarł w 1976 r. w Nowym Jorku.
Co wymyślił Lazarsfeld?
Analizę struktur latentnych: założenie, że związki między odpowiedziami na pytania ankiety tłumaczy nieobserwowana zmienna, a w obrębie jej klas odpowiedzi są niezależne – to model klas latentnych. Rozwinął też badania panelowe (wielokrotne wywiady z tą samą próbą) i sposoby kontrolowania trzeciej zmiennej w tabelach krzyżowych.
Czy Lazarsfeld wynalazł badania panelowe?
Nie – jego biograf D. L. Sills pisze, że panelu nie wymyślił, ale był jego najskuteczniejszym wczesnym propagatorem. Wykorzystał go m.in. w badaniu wyborów prezydenckich w USA w 1940 r., opisanym w książce The People’s Choice (1944), i wprowadzał do analizy danych panelowych grupy kontrolne.
Jak dopasować model klas latentnych Lazarsfelda w R?
Najprościej pakietem poLCA: poLCA(cbind(A, B, C, D) ~ 1, dane, nclass = 2, nrep = 10). Dla danych Stouffera i Toby’ego (N = 216) model z dwiema klasami daje G² = 2.72 przy 6 stopniach swobody (p = .843), a model niezależności – G² = 81.08 przy 11. Ten sam wynik daje kilkanaście wierszy własnego algorytmu EM.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Goodman, L. A. (1974). Exploratory latent structure analysis using both identifiable and unidentifiable models. Biometrika, 61(2), 215–231. https://doi.org/10.1093/biomet/61.2.215
- Kenny, D. A. (2024). Mediation history. davidakenny.net. https://davidakenny.net/cm/MediationHistory.html ● Otwarty dostęp
- Linzer, D. A., & Lewis, J. B. (2011). poLCA: An R package for polytomous variable latent class analysis. Journal of Statistical Software, 42(10). https://doi.org/10.18637/jss.v042.i10 ● Otwarty dostęp
- Sills, D. L. (1987). Paul F. Lazarsfeld, February 13, 1901–August 30, 1976. In Biographical memoirs: Volume 56 (pp. 251–282). National Academy Press. https://www.nasonline.org/wp-content/uploads/2024/06/lazarsfeld-paul-f.pdf ● Otwarty dostęp
- Stouffer, S. A., & Toby, J. (1951). Role conflict and personality. American Journal of Sociology, 56(5), 395–406. https://doi.org/10.1086/220785
Cytowania BibTeX
@article{goodman1974exploratory, author={Goodman, Leo A.}, title={{Exploratory latent structure analysis using both identifiable and unidentifiable models}}, journal={Biometrika}, year={1974}, volume={61}, number={2}, pages={215--231}, doi={10.1093/biomet/61.2.215}}@misc{kenny2024mediationhistory, author={Kenny, David A.}, title={{Mediation history}}, howpublished={davidakenny.net}, year={2024}, url={https://davidakenny.net/cm/MediationHistory.html}}@article{linzer2011polca, author={Linzer, Drew A. and Lewis, Jeffrey B.}, title={{poLCA: An R package for polytomous variable latent class analysis}}, journal={Journal of Statistical Software}, year={2011}, volume={42}, number={10}, doi={10.18637/jss.v042.i10}}@incollection{sills1987lazarsfeld, author={Sills, David L.}, title={{Paul F. Lazarsfeld, February 13, 1901–August 30, 1976}}, booktitle={Biographical memoirs: Volume 56}, year={1987}, pages={251--282}, publisher={National Academy Press}, url={https://www.nasonline.org/wp-content/uploads/2024/06/lazarsfeld-paul-f.pdf}}@article{stouffer1951role, author={Stouffer, Samuel A. and Toby, Jackson}, title={{Role conflict and personality}}, journal={American Journal of Sociology}, year={1951}, volume={56}, number={5}, pages={395--406}, doi={10.1086/220785}}