Kiedy analiza klas latentnych, a kiedy coś innego?
Analiza klas latentnych (ang. latent class analysis, LCA) zakłada, że badana próba składa się z kilku nieobserwowanych podgrup, a wzorzec odpowiedzi danej osoby zależy od tego, do której podgrupy należy (Weller i in., 2020). Klasa jest kategorią zmiennej latentnej, a wskaźnikami są odpowiedzi kategorialne, najczęściej typu „tak/nie”: występowanie objawów, zachowań, doświadczeń. Model należy do rodziny modeli mieszanin, tak jak analiza profili latentnych. LPA robi to samo dla wskaźników ciągłych (wyników skal). Pokazaliśmy ją razem z metodą k-średnich we wpisie o segmentacji respondentów. Tutaj nie powtarzamy tamtej procedury, tylko przenosimy ją na dane dychotomiczne i dodajemy to, co dla LCA najważniejsze: lokalną niezależność i poprawną analizę zmiennych zewnętrznych.
LCA ma sens, gdy pytanie badawcze dotyczy typów osób, a nie wymiarów. „Jakie wzorce problemów ze snem występują w populacji i ile osób ma każdy z nich?” to pytanie dla LCA. „Jak silne są problemy ze snem?” to pytanie dla modelu czynnikowego albo IRT. Granica nie jest ostra. Lubke i Neale (2006) pokazali w symulacjach, że modele klas latentnych dopasowane do danych, w których współzmienność wynika z ciągłego czynnika, mogą wskazać nadmiarowe klasy. Klasy są więc modelem niejawnej heterogeniczności, a nie dowodem, że w populacji istnieją rozłączne „typy”. Lanza i Rhoades (2013) proponują LCA jako alternatywę dla klasycznej analizy podgrup. Podgrupę opisuje się wtedy kilkoma cechami naraz, zamiast dzielić próbę po kolei według każdej z nich.
| Metoda | Wskaźniki | Wynik | Typowe pytanie |
|---|---|---|---|
| LCA | kategorialne (0/1, kilka kategorii) | klasy i prawdopodobieństwa przynależności | Jakie wzorce objawów współwystępują? |
| LPA | ciągłe (wyniki skal) | profile i prawdopodobieństwa przynależności | Jakie profile motywacji mają pracownicy? |
| k-średnich | ciągłe | sztywny podział na skupienia | Jak podzielić klientów na segmenty? |
| Analiza czynnikowa, IRT | dowolne | ciągłe wymiary | Ile wymiarów ma kwestionariusz? |
Model ma dwa rodzaje parametrów. Udziały klas mówią, jaka część populacji należy do każdej klasy. Prawdopodobieństwa odpowiedzi (ang. item-response probabilities) mówią, jak często osoby z danej klasy odpowiadają „tak” na każde pytanie. Kluczowe założenie to lokalna niezależność: w obrębie klasy odpowiedzi na różne pytania nie są ze sobą związane. Cała współzmienność wskaźników ma wynikać z tego, że w próbie są różne klasy. Ten sam model opisują Linzer i Lewis (2011): skończona mieszanina tabel wielodzielczych, w których w obrębie klasy wszystkie zmienne są niezależne. Parametry szacuje się metodą największej wiarygodności, zwykle algorytmem EM.
Poradnik jest napisany dla badaczy i doktorantów, którzy chcą wyodrębnić klasy do artykułu albo rozprawy i opisać je tak, by recenzent mógł odtworzyć każdą decyzję. Sinha i in. (2021) przechodzą przez te same etapy w przeglądzie metodologicznym i przy każdym wskazują typowe pułapki. Dobrze jest go mieć pod ręką.
Przykład: wzorce problemów ze snem u 1000 dorosłych
Pracujemy na danych symulowanych od 1000 dorosłych. Każda osoba odpowiedziała „tak” albo „nie” na osiem pytań o ostatni miesiąc (co najmniej trzy noce w tygodniu): trudność z zaśnięciem, wybudzenia w nocy, zbyt wczesne budzenie, głośne chrapanie, przerwy w oddychaniu zauważone przez bliskich, senność w ciągu dnia, zasypianie po 1:00 w dni robocze i odsypianie w weekend. Do analiz zewnętrznych mamy wiek i samopoczucie (0–100). Dane wygenerowaliśmy z czterech klas, więc znamy prawdę i możemy sprawdzić, jak blisko niej dochodzi analiza. Plik: analiza-klas-latentnych-dane.csv (kolumna klasa_prawdziwa istnieje tylko w danych symulowanych).
| Wskaźnik | „Tak” (%) | Braki (n) |
|---|---|---|
| Trudność z zaśnięciem | 33.8 | 0 |
| Wybudzenia w nocy | 29.8 | 0 |
| Zbyt wczesne budzenie | 21.3 | 0 |
| Głośne chrapanie | 23.8 | 0 |
| Przerwy w oddychaniu | 9.8 | 121 |
| Senność w ciągu dnia | 38.4 | 0 |
| Zasypianie po 1:00 | 33.0 | 0 |
| Odsypianie w weekend | 29.1 | 0 |
Przy pytaniu o przerwy w oddychaniu brakuje 121 odpowiedzi (12.1%). To osoby, które śpią same i nie mają kogo zapytać. Odsetek „tak” liczymy z odpowiedzi udzielonych. 161 osób nie zgłosiło żadnego problemu, 7 zgłosiło sześć.
Krok 1. Przygotuj wskaźniki i braki danych
- Wskaźniki wybieraj z teorii. Klasy będą tylko tak sensowne, jak pytania, z których powstały. Dodanie jednego wskaźnika może zmienić liczbę i kształt klas.
- Koduj jednoznacznie. Tutaj 1 = „tak”, 0 = „nie”. Kategorie typu „nie wiem” nie są trzecim poziomem objawu. Potraktuj je jako brak danych albo modeluj osobno (zob. odpowiedź „nie wiem”).
- Nie usuwaj osób z brakami. W LCA estymacja metodą największej wiarygodności korzysta z odpowiedzi, które są, tak jak FIML w SEM. Jest to poprawne przy brakach typu MAR (zob. mechanizmy braków). Usunięcie 121 osób śpiących samotnie zmieniłoby skład próby, bo mogą się one różnić wiekiem i stylem życia. Szerzej o tym we wpisie braki danych i imputacja wielokrotna.
- Uważaj na bardzo rzadkie wskaźniki. Pytanie z odsetkiem „tak” rzędu 1–2% daje niestabilne prawdopodobieństwa bliskie 0 lub 1. Tutaj najrzadszy wskaźnik ma 9.8%.
- Liczebność. Nie ma jednej reguły. W symulacjach Nylunda i in. (2007) trafność wyboru liczby klas rosła z liczebnością (badano n = 200, 500 i 1000). Mała klasa w małej próbie to kilkanaście osób, których profil trudno oszacować. Planuj próbę z myślą o najmniejszej spodziewanej klasie, a nie o całości (zob. dobór liczebności próby).
Krok 2. Oszacuj modele z 1–6 klasami z wieloma startami
Najpopularniejszy pakiet R do LCA, poLCA (Linzer i Lewis, 2011), nie jest zainstalowany w środowisku, w którym liczyliśmy ten przykład. Zamiast niego użyliśmy krótkiej własnej funkcji lca_em() (algorytm EM, ok. 30 wierszy w sekcji z kodem). Wynik sprawdziliśmy niezależną implementacją: funkcją mdirt() z pakietu mirt (Chalmers, 2012), która szacuje modele klas latentnych. Dla czterech klas obie dały ten sam logarytm wiarygodności (−4150.19) i to samo BIC (8542.16). Jeśli masz poLCA, ten sam model oszacujesz wywołaniem poLCA(cbind(...) ~ 1, data, nclass = 4, nrep = 50). Pamiętaj, że poLCA wymaga kategorii kodowanych od 1, a nie od 0.
Funkcja wiarygodności LCA ma wiele maksimów lokalnych. Dlatego każdy model szacuje się z wielu losowych punktów startowych i sprawdza, czy najlepszy wynik się powtarza. Szacowaliśmy modele z 1–6 klasami, każdy z 50 startów. Najlepszy logL powtórzył się w 50 na 50 startów dla dwóch i czterech klas, w 39 na 50 dla trzech, w 24 na 50 dla pięciu i tylko w 5 na 50 dla sześciu. Słaba replikacja przy pięciu i sześciu klasach to typowy sygnał, że model ma więcej klas, niż dane potrafią udźwignąć. Jeśli najlepszy wynik nie powtarza się w kilku startach, nie raportuj tego modelu bez zwiększenia liczby startów.
Liczba parametrów to (K − 1) udziałów klas plus K × 8 prawdopodobieństw odpowiedzi, czyli 35 dla czterech klas. Model z sześcioma klasami ma 53 parametry, a niektóre jego prawdopodobieństwa są bliskie 0 lub 1. Taki model może być słabo identyfikowany (zob. identyfikacja modelu).
Krok 3. Ile klas? BIC, BLRT, entropia i wielkość klas
Nylund i in. (2007) porównali w symulacjach kryteria wyboru liczby klas w LCA. Spośród kryteriów informacyjnych najlepiej działało BIC, a bootstrapowy test ilorazu wiarygodności (BLRT) był bardzo spójnym wskaźnikiem liczby klas. Na tych dwóch kryteriach opieramy decyzję. AIC i SABIC (BIC z poprawką na liczebność próby) podajemy dla kompletu (zob. AIC i BIC). BLRT porównuje model z K klasami z modelem z K − 1. Rozkład statystyki pod hipotezą zerową tworzy się, losując wiele zbiorów danych z modelu K − 1 i szacując na nich oba modele. Zwykły test χ² różnicy logL nie ma tu poprawnego rozkładu, dlatego potrzebny jest bootstrap.
Tabela 1
Dopasowanie modeli klas latentnych z jedną do sześciu klas (N = 1000)
| Liczba klas | logL | Parametry | AIC | BIC | SABIC | Entropia | Najmniejsza klasa (%) | BLRT p | Replikacja logL |
|---|---|---|---|---|---|---|---|---|---|
| 1 | −4500.29 | 8 | 9016.58 | 9055.84 | 9030.43 | — | 100.0 | — | 50/50 |
| 2 | −4331.98 | 17 | 8697.97 | 8781.40 | 8727.41 | .629 | 34.0 | .010 | 50/50 |
| 3 | −4239.95 | 26 | 8531.90 | 8659.50 | 8576.93 | .646 | 20.7 | .010 | 39/50 |
| 4a | −4150.19 | 35 | 8370.39 | 8542.16 | 8431.00 | .668 | 15.0 | .010 | 50/50 |
| 5 | −4143.24 | 44 | 8374.48 | 8590.42 | 8450.67 | .699 | 5.3 | .792 | 24/50 |
| 6 | −4137.11 | 53 | 8380.21 | 8640.32 | 8471.99 | .656 | 8.2 | .812 | 5/50 |
Uwaga. logL – logarytm wiarygodności; AIC, BIC i SABIC (BIC skorygowane o liczebność próby) w konwencji „mniej = lepiej”. BLRT – bootstrapowy test ilorazu wiarygodności modelu z k klasami względem modelu z k − 1 klasami (100 prób; p = .010 to najmniejsza możliwa wartość). Replikacja – liczba spośród 50 losowych startów, które osiągnęły najlepszy logL. Braki danych uwzględnione metodą największej wiarygodności. Dane symulowane.
a Model wybrany.
Wszystkie trzy kryteria informacyjne są najmniejsze przy czterech klasach. BIC wynosi 8542.16 wobec 8659.50 dla trzech i 8590.42 dla pięciu. BLRT potwierdza ten wybór: druga, trzecia i czwarta klasa istotnie poprawiły dopasowanie (dla czterech klas LRT = 179.52, p = .010, najmniejsza możliwa wartość przy 100 próbach), a piąta – nie (LRT = 13.91, p = .792). Najmniejsza klasa w modelu czterech klas obejmuje 15.0% próby. W modelu pięciu klas najmniejsza klasa liczy 5.3%, a jej przypisanie dotyczy 36 osób.
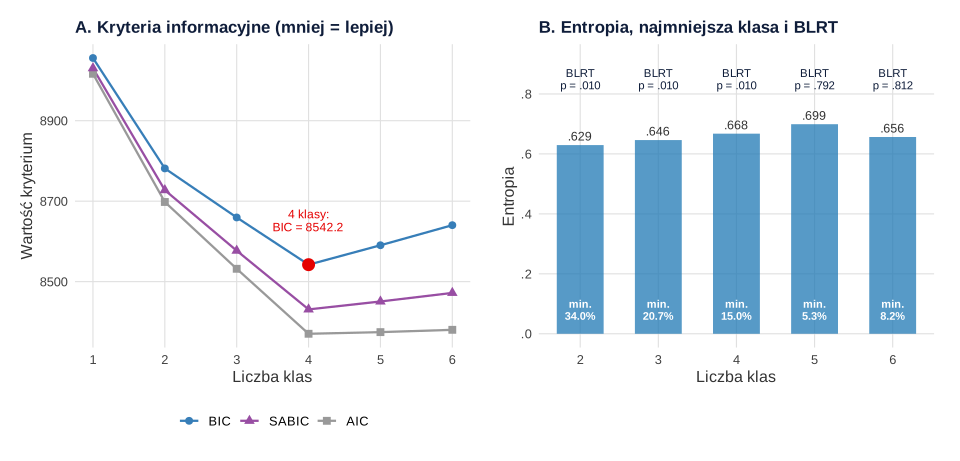
Entropia nie służy do wyboru liczby klas. To miara pewności klasyfikacji (krok 6). W przykładzie była najwyższa dla pięciu klas (.699), a nie dla czterech (.668), choć dane powstały z czterech. Tein i in. (2013) w symulacjach dla profili latentnych pokazali, że entropia słabo wskazuje właściwą liczbę klas niezależnie od warunków. Wysoka entropia nie świadczy więc o „dobrym modelu”, a niska nie dyskwalifikuje rozwiązania.
Ostatnie kryterium to sensowność. Każda klasa powinna mieć opis, który da się uzasadnić teorią, i nie powinna być „kopią” innej klasy różniącą się tylko poziomem jednego wskaźnika. Weller i in. (2020) podkreślają, że decyzja o liczbie klas łączy kryteria statystyczne z interpretacją, a uzasadnienie trzeba opisać.
Krok 4. Sprawdź lokalną niezależność
Lokalna niezależność to założenie, które najczęściej pomija się w artykułach. Najprostszy test to reszty dwuzmiennowe (ang. bivariate residuals, BVR). Dla każdej pary wskaźników porównujesz tabelę 2 × 2 obserwowaną z tabelą oczekiwaną z modelu i liczysz χ² Pearsona, jak w teście niezależności. Duża reszta oznacza, że model nie odtwarza związku tej pary. Próg 3.84 (wartość krytyczna χ² dla 1 df) traktuj orientacyjnie, bo par jest dużo, a reszty nie są niezależne.
- Trzy klasy: cztery pary powyżej 3.84. Największe reszty to chrapanie–przerwy w oddychaniu (54.50), przerwy w oddychaniu–senność w dzień (39.80) i chrapanie–senność (30.60). Model trzech klas nie ma klasy, która łączy te trzy objawy, więc ich współwystępowanie zostaje niewyjaśnione.
- Cztery klasy: żadna para powyżej 3.84, największa reszta 1.39.
- Pięć klas: największa reszta 1.42, więc piąta klasa niczego tu nie poprawia.
Reszty potwierdzają więc wybór czterech klas. Gdy w wybranym modelu jedna para nadal ma dużą resztę, masz dwie drogi: dodać klasę albo dopuścić bezpośredni związek tej pary wskaźników w obrębie klas. Drugie rozwiązanie bywa rozsądniejsze, gdy dwa pytania mierzą prawie to samo, np. chrapanie i przerwy w oddychaniu zgłaszane przez tę samą osobę. Nie dodawaj klas tylko po to, by „wchłonęły” podobieństwo dwóch pytań.
Krok 5. Zinterpretuj i nazwij klasy
Klasy opisuje się prawdopodobieństwami odpowiedzi „tak” w każdej klasie (rysunek 2). Prawdopodobieństwo powyżej ok. .50 oznacza objaw typowy dla klasy, a bliskie zera – objaw w niej rzadki. Nazwy klas są interpretacją badacza. Muszą wynikać z profilu, a nie z oczekiwań.
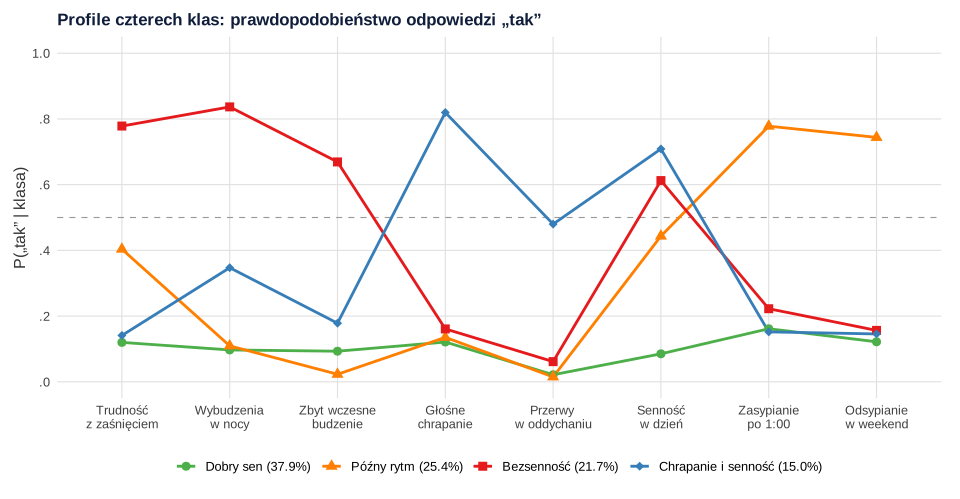
- Dobry sen (37.9%). Wszystkie prawdopodobieństwa od .02 do .16.
- Późny rytm (25.4%). Zasypianie po 1:00 (.78) i odsypianie w weekend (.74), często senność w dzień (.44) i trudność z zaśnięciem (.40), ale rzadko wybudzenia (.11) i zbyt wczesne budzenie (.02).
- Bezsenność (21.7%). Trudność z zaśnięciem (.78), wybudzenia (.84), zbyt wczesne budzenie (.67) i senność w dzień (.61).
- Chrapanie i senność (15.0%). Chrapanie (.82), senność w dzień (.71), przerwy w oddychaniu (.48) i częściej niż w klasie dobrego snu wybudzenia (.35).
Senność w ciągu dnia występuje w trzech klasach z czterech, ale z różnych powodów. To typowa sytuacja: pojedynczy wskaźnik nie odróżnia klas, odróżnia je dopiero cały wzorzec. Przy interpretacji pamiętaj też, że model nie diagnozuje. Klasa „chrapanie i senność” to wzorzec zgłaszanych objawów, a nie rozpoznanie zaburzeń oddychania w czasie snu.
Ponieważ znamy prawdę, możemy porównać oszacowania z wartościami, z których wygenerowano dane. Udziały wynosiły w populacji 45%, 18%, 22% i 15%. Model przesunął część osób z klasy dobrego snu do klasy późnego rytmu (37.9% i 25.4%). Wzorce prawdopodobieństw odtworzył dobrze. Przesunięcie udziałów przy klasach o podobnych profilach jest naturalne i dobrze pokazuje, dlaczego nie warto przywiązywać się do pierwszego miejsca po przecinku.
Krok 6. Jakość klasyfikacji: entropia i średnie prawdopodobieństwa
Każda osoba dostaje cztery prawdopodobieństwa a posteriori, które sumują się do 1. Przypisanie do najbardziej prawdopodobnej klasy (przypisanie modalne) dało 403, 238, 230 i 129 osób. O jakości klasyfikacji mówią trzy liczby.
- Entropia (0–1) wyniosła .668. To wartość umiarkowana: profile klas częściowo się nakładają, zwłaszcza dobry sen i późny rytm.
- Średnie prawdopodobieństwo przynależności do przypisanej klasy (AvePP) wyniosło .823 dla dobrego snu, .841 dla późnego rytmu, .833 dla bezsenności i .845 dla chrapania i senności.
- Odsetek osób niejednoznacznych. U 22.1% osób najwyższe prawdopodobieństwo było mniejsze niż .70.
W danych symulowanych możemy też policzyć, ile osób przypisano do właściwej klasy: 829 z 1000 (82.9%). W prawdziwym badaniu tej liczby nie znasz, dlatego entropia i AvePP są ważne. Przy entropii rzędu .67 co szósta osoba trafia do niewłaściwej klasy. Ma to bezpośrednie skutki w następnym kroku.
Krok 7. Zmienne zewnętrzne: dlaczego nie „przypisz i licz”
Po wyodrębnieniu klas zwykle chcesz wiedzieć, czym się różnią: wiekiem, samopoczuciem, wynikami leczenia. Najprostsza droga to podejście trzykrokowe: (1) model klas, (2) przypisanie osób do klas, (3) zwykła ANOVA albo regresja z przypisaną klasą. Bolck i in. (2004) pokazali, że takie użycie przypisanych klas systematycznie zaniża siłę związków. Powód jest prosty: przypisanie zawiera błąd klasyfikacji, a krok 3 go ignoruje. Vermunt (2010) rozwinął poprawkę Bolcka, Croona i Hagenaarsa (BCH) i zaproponował poprawkę opartą na największej wiarygodności. Bakk i in. (2013) rozszerzyli obie na sytuację, w której klasa jest predyktorem zmiennej zewnętrznej (tzw. zmiennej dystalnej), i pokazali, że bez poprawki oszacowania są silnie obciążone.
Poprawka BCH korzysta z macierzy błędów klasyfikacji D: wiersz t mówi, z jakim prawdopodobieństwem osoba z prawdziwej klasy t zostanie przypisana do każdej z klas. W przykładzie na przekątnej D są wartości .874, .788, .884 i .728. Osoba z klasy chrapania i senności tylko w 72.8% przypadków trafia do własnej klasy, a w 14.1% do klasy dobrego snu. Każda osoba dostaje wagi równe wierszowi odwrotności D, który odpowiada jej przypisanej klasie. Średnie ważone tymi wagami korygują błąd klasyfikacji. Wagi bywają ujemne i tak ma być.
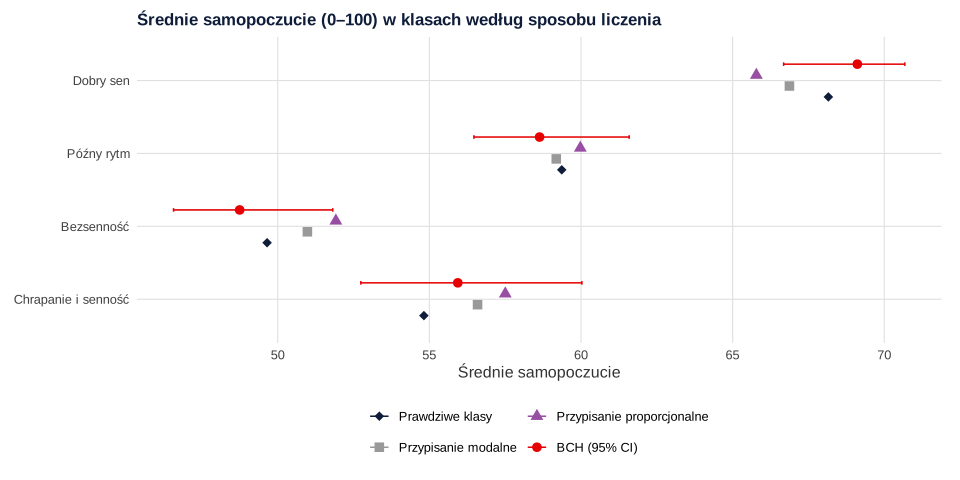
Prawdziwa różnica samopoczucia między dobrym snem a bezsennością wynosi 18.5 punktu (średnie 68.2 i 49.6). Przypisanie modalne dało 15.9 punktu (66.9 wobec 51.0), przypisanie proporcjonalne 13.9, a poprawka BCH 20.4 (69.1 wobec 48.7, 95% CI średnich [66.7, 70.7] i [46.6, 51.8]). Dwie metody bez poprawki ściągają średnie klas do siebie, czyli zaniżają różnice, tak jak opisali Bolck i in. (2004). BCH w tej jednej próbie lekko przestrzeliła w drugą stronę, ale jej przedziały obejmują prawdziwe wartości we wszystkich czterech klasach. W symulacjach Vermunta (2010) poprawki dawały wiarygodne oszacowania i błędy standardowe, z wyjątkiem bardzo słabo rozdzielonych klas. To samo widać przy wieku. W klasie późnego rytmu prawdziwa średnia to 29.9 roku, z przypisania modalnego wyszło 33.1, a z BCH 31.3.
Przy kowariantach, które mają przewidywać przynależność do klas (np. wiek jako predyktor), stosuje się analogiczne poprawki w wieloklasowej regresji logistycznej. Można też włączyć kowariant do modelu LCA w jednym kroku. Asparouhov i Muthén (2014) opisują trzykrokowe podejścia dla predyktorów i zmiennych dystalnych w Mplus. Rozważają też sytuację, w której predyktor wpływa bezpośrednio na wskaźniki klas.
LCA w SPSS, Mplus i R
Podręcznik IBM SPSS Statistics Base 31 opisuje trzy procedury analizy skupień: TwoStep, hierarchiczną i k-średnich (IBM, b.d.). Analizy klas latentnych w nim nie ma. TwoStep przyjmuje zmienne jakościowe i sam wybiera liczbę skupień według BIC albo AIC, ale jest procedurą analizy skupień, a nie modelem klas latentnych, i nie ma testu BLRT. W praktyce LCA liczy się w programach Mplus, Latent GOLD albo w R. W R oprócz poLCA i mirt są inne pakiety. Zanim wybierzesz pakiet, sprawdź, czy obsługuje braki danych, wiele startów, BLRT i poprawki trzykrokowe. Własna funkcja z tego poradnika obsługuje braki i wiele startów, a BLRT i BCH liczymy na niej w osobnych przepisach.
Jak opisać analizę klas latentnych w artykule (APA)
W „Metodzie” podaj wskaźniki i ich kodowanie, sposób traktowania braków, program i wersję, liczbę startów i to, czy najlepszy logL się powtórzył, kryteria wyboru liczby klas (z liczbą prób BLRT) oraz metodę analizy zmiennych zewnętrznych. W „Wynikach” pokaż tabelę dopasowania (Tabela 1), profile klas (Tabela 2 albo wykres) i miary klasyfikacji. Ogólny układ tabeli dopasowania modeli opisuje tabela dopasowania modelu w APA.
Tabela 2
Udziały klas i prawdopodobieństwa odpowiedzi „tak” w modelu czterech klas (N = 1000)
| Wskaźnik | Dobry sen | Późny rytm | Bezsenność | Chrapanie i senność |
|---|---|---|---|---|
| Udział klasy (%) | 37.9 | 25.4 | 21.7 | 15.0 |
| Trudność z zaśnięciem | .12 | .40 | .78 | .14 |
| Wybudzenia w nocy | .10 | .11 | .84 | .35 |
| Zbyt wczesne budzenie | .09 | .02 | .67 | .18 |
| Głośne chrapanie | .12 | .14 | .16 | .82 |
| Przerwy w oddychaniu | .02 | .01 | .06 | .48 |
| Senność w ciągu dnia | .09 | .44 | .61 | .71 |
| Zasypianie po 1:00 | .16 | .78 | .22 | .15 |
| Odsypianie w weekend | .12 | .74 | .16 | .15 |
Uwaga. Wartości to warunkowe prawdopodobieństwa odpowiedzi „tak” w danej klasie; prawdopodobieństwa powyżej .50 wyróżniono w opisie klas. Entropia = .668; średnie prawdopodobieństwo przynależności do przypisanej klasy od .823 do .845. Dane symulowane.
Wzór opisu (metoda i wyniki):
Jeśli klasy mają służyć dalej jako zmienna w kolejnych artykułach z tego samego projektu, opisz je raz, w pełni, i odsyłaj do tego opisu. Kod z wieloma startami i ziarnem generatora umieść w pakiecie replikacyjnym, bo bez niego nikt nie odtworzy rozwiązania. Gdy recenzent pyta, dlaczego cztery klasy, a nie pięć, odpowiedź masz w Tabeli 1 i w resztach dwuzmiennowych. Inne typowe pytania zebraliśmy we wpisie zarzuty recenzentów do statystyki. Jeśli chcesz, żeby ktoś przed wysłaniem artykułu sprawdził wybór liczby klas, lokalną niezależność i analizę zmiennych zewnętrznych, zajrzyj do oferty dla badaczy.
Analiza klas latentnych w R – pełny kod
Siedem przepisów odtwarza całą analizę, od danych symulowanych po poprawkę BCH. Uruchamiaj je po kolei w jednej sesji R, w folderze z plikiem CSV, bo kolejne przepisy korzystają z obiektów utworzonych wcześniej (np. Y, fits, f4). Szacowanie modeli z 50 startów trwa około trzech minut, a BLRT – kilkanaście minut na ośmiu rdzeniach (funkcja mclapply() działa równolegle w systemach macOS i Linux; w Windows ustaw mc.cores = 1). Wszystkie liczby w tekście, tabelach i na rysunkach pochodzą z tego kodu.
1. Dane symulowane (plik CSV)
R
# Dane symulowane: 1000 dorosłych, osiem dychotomicznych wskaźników problemów ze snem
# (1 = występuje co najmniej 3 noce w tygodniu w ostatnim miesiącu), wiek i samopoczucie (0–100)
set.seed(84)
n <- 1000
klasy <- c("Dobry sen", "Bezsenność", "Chrapanie i senność", "Późny rytm")
pi0 <- c(.45, .22, .15, .18)
p0 <- rbind(c(.10, .10, .08, .15, .03, .10, .12, .15),    # dobry sen
            c(.80, .75, .60, .20, .05, .55, .25, .15),    # bezsenność
            c(.15, .35, .15, .85, .55, .70, .10, .15),    # chrapanie i senność w dzień
            c(.40, .10, .05, .15, .03, .45, .85, .80))    # późny rytm dobowy
wsk <- c("zasypianie", "wybudzenia", "wczesne", "chrapanie", "bezdechy", "sennosc", "pozno", "odsypianie")
klasa_prawdziwa <- sample(1:4, n, TRUE, pi0)
Y <- matrix(rbinom(n * 8, 1, p0[klasa_prawdziwa, ]), n, 8, dimnames = list(NULL, wsk))
spi_sam <- rbinom(n, 1, .12)                          # osoby śpiące same nie wiedzą o przerwach w oddychaniu
Y[spi_sam == 1, "bezdechy"] <- NA
wiek <- round(pmin(pmax(rnorm(n, c(40, 45, 52, 29)[klasa_prawdziwa], 10), 18), 80))
samopoczucie <- round(pmin(pmax(rnorm(n, c(68, 50, 56, 60)[klasa_prawdziwa], 14), 0), 100))
dane <- data.frame(id = 1:n, Y, wiek, samopoczucie, klasa_prawdziwa = klasy[klasa_prawdziwa])
write.csv(dane, "analiza-klas-latentnych-dane.csv", row.names = FALSE, na = "")
str(read.csv("analiza-klas-latentnych-dane.csv"))
Wynik w R
'data.frame':	1000 obs. of  12 variables:
 $ id             : int  1 2 3 4 5 6 7 8 9 10 ...
 $ zasypianie     : int  1 0 1 0 0 0 0 0 1 0 ...
 $ wybudzenia     : int  1 0 0 0 0 0 0 0 1 0 ...
 $ wczesne        : int  0 0 0 1 0 0 0 0 1 0 ...
 $ chrapanie      : int  0 0 1 0 0 0 0 0 1 0 ...
 $ bezdechy       : int  NA 0 NA 0 0 0 NA 1 0 0 ...
 $ sennosc        : int  0 1 1 1 0 0 0 0 1 0 ...
 $ pozno          : int  1 1 0 1 0 0 0 0 0 0 ...
 $ odsypianie     : int  1 0 1 1 0 0 1 0 0 0 ...
 $ wiek           : int  28 23 45 30 47 38 34 51 37 44 ...
 $ samopoczucie   : int  60 78 37 31 84 58 58 62 38 68 ...
 $ klasa_prawdziwa: chr  "Późny rytm" "Dobry sen" "Chrapanie i senność" "Późny rytm" ...
2. Częstości wskaźników i braki
R
# Częstości wskaźników i braki danych
dane <- read.csv("analiza-klas-latentnych-dane.csv")
wsk <- c("zasypianie", "wybudzenia", "wczesne", "chrapanie", "bezdechy", "sennosc", "pozno", "odsypianie")
Y <- as.matrix(dane[wsk])
round(rbind(odsetek_tak = colMeans(Y, na.rm = TRUE) * 100, braki = colSums(is.na(Y))), 1)
table(liczba_objawow = rowSums(Y, na.rm = TRUE))
c(N = nrow(Y), z_brakiem = sum(!complete.cases(Y)))
Wynik w R
            zasypianie wybudzenia wczesne chrapanie bezdechy sennosc pozno
odsetek_tak       33.8       29.8    21.3      23.8      9.8    38.4    33
braki              0.0        0.0     0.0       0.0    121.0     0.0     0
            odsypianie
odsetek_tak       29.1
braki              0.0
liczba_objawow
  0   1   2   3   4   5   6
161 207 198 220 162  45   7
        N z_brakiem
     1000       121
3. Funkcja LCA (algorytm EM z brakami danych)
R
# Własna implementacja LCA dla wskaźników 0/1 (algorytm EM). Braki traktujemy jak w FIML:
# osoba wnosi do wiarygodności tylko te odpowiedzi, których udzieliła. (Pakiet poLCA nie jest zainstalowany.)
lca_em <- function(Y, K, starty = 50, maks_iter = 3000, tol = 1e-6, start = NULL, sortuj = TRUE) {
  O <- !is.na(Y); Y1 <- ifelse(O, Y, 0); Y2 <- O - Y1     # Y1: odpowiedź „tak”, Y2: odpowiedź „nie”
  jeden <- function(pk, p) {
    llo <- -Inf
    for (it in 1:maks_iter) {
      lf <- Y1 %*% t(log(p)) + Y2 %*% t(log(1 - p)) + rep(log(pk), each = nrow(Y))   # E: log P(y, klasa)
      mx <- apply(lf, 1, max); post <- exp(lf - mx); s <- rowSums(post)
      ll <- sum(mx + log(s)); post <- post / s
      pk <- colMeans(post)                                                          # M: udziały klas
      p <- pmin(pmax((t(post) %*% Y1) / (t(post) %*% O), 1e-8), 1 - 1e-8)            # M: P(„tak” | klasa)
      if (ll - llo < tol) break
      llo <- ll
    }
    list(ll = ll, pk = pk, p = p, post = post, iter = it)
  }
  wyniki <- if (!is.null(start)) list(jeden(start$pk, start$p)) else
    lapply(1:starty, function(s) jeden(rep(1 / K, K), matrix(runif(K * ncol(Y), .1, .9), K)))
  ll <- sapply(wyniki, `[[`, "ll"); best <- wyniki[[which.max(ll)]]
  o <- if (sortuj) order(-best$pk) else seq_len(K)      # klasy od największej (w bootstrapie bez zmiany kolejności)
  best$pk <- best$pk[o]; best$p <- best$p[o, , drop = FALSE]; best$post <- best$post[, o, drop = FALSE]
  colnames(best$p) <- colnames(Y)
  N <- nrow(Y); best$K <- K; best$npar <- (K - 1) + K * ncol(Y)
  best$aic   <- -2 * best$ll + 2 * best$npar
  best$bic   <- -2 * best$ll + best$npar * log(N)
  best$sabic <- -2 * best$ll + best$npar * log((N + 2) / 24)
  best$entropia <- if (K == 1) NA else 1 - sum(-best$post * log(pmax(best$post, 1e-300))) / (N * log(K))
  best$ile_najlepszy <- sum(ll > max(ll) - 0.01); best$starty <- length(ll)   # replikacja najlepszego logL
  best
}
# losowanie danych z oszacowanego modelu (parametryczny bootstrap do BLRT), z tym samym wzorcem braków
lca_losuj <- function(fit, wzorzec_brakow) {
  N <- nrow(wzorzec_brakow); k <- sample(seq_along(fit$pk), N, TRUE, fit$pk)
  Y <- matrix(rbinom(N * ncol(fit$p), 1, fit$p[k, ]), N, ncol(fit$p), dimnames = list(NULL, colnames(fit$p)))
  Y[wzorzec_brakow] <- NA; Y
}
4. Modele z 1–6 klasami i kontrola w mirt
R
# Modele z 1–6 klasami, po 50 losowych startów; porównanie kryteriów
set.seed(2026)
fits <- lapply(1:6, function(K) lca_em(Y, K, starty = 50))
porownanie <- data.frame(K = 1:6, logL = sapply(fits, `[[`, "ll"), parametry = sapply(fits, `[[`, "npar"),
  AIC = sapply(fits, `[[`, "aic"), BIC = sapply(fits, `[[`, "bic"), SABIC = sapply(fits, `[[`, "sabic"),
  entropia = sapply(fits, `[[`, "entropia"),
  najmn_proc = sapply(fits, function(f) 100 * min(f$pk)),
  najmn_n = sapply(fits, function(f) min(table(factor(apply(f$post, 1, which.max), levels = 1:f$K)))),
  replikacja = sapply(fits, function(f) paste0(f$ile_najlepszy, "/", f$starty)))
print(porownanie, digits = 6)
# kontrola niezależną implementacją: pakiet mirt (funkcja mdirt, model klas latentnych)
library(mirt)
set.seed(2026)
m4 <- mdirt(as.data.frame(Y), 4, nruns = 20, verbose = FALSE)
c(logL_mirt = extract.mirt(m4, "logLik"), logL_wlasny = fits[[4]]$ll, BIC_mirt = extract.mirt(m4, "BIC"))
Wynik w R
  K     logL parametry     AIC     BIC   SABIC entropia najmn_proc najmn_n
1 1 -4500.29         8 9016.58 9055.84 9030.43       NA  100.00000    1000
2 2 -4331.98        17 8697.97 8781.40 8727.41 0.629458   34.04751     313
3 3 -4239.95        26 8531.90 8659.50 8576.93 0.646198   20.65069     209
4 4 -4150.19        35 8370.39 8542.16 8431.00 0.667591   14.97913     129
5 5 -4143.24        44 8374.48 8590.42 8450.67 0.699119    5.26941      36
6 6 -4137.11        53 8380.21 8640.32 8471.99 0.656469    8.15776      46
  replikacja
1      50/50
2      50/50
3      39/50
4      50/50
5      24/50
6       5/50
Loading required package: stats4
Loading required package: lattice
  logL_mirt logL_wlasny    BIC_mirt
  -4150.193   -4150.193    8542.158
5. Bootstrapowy test ilorazu wiarygodności (BLRT)
R
# Bootstrapowy test ilorazu wiarygodności (BLRT): K klas vs K − 1, 100 prób parametrycznego bootstrapu.
# Dane losujemy z modelu K − 1 klas; model K − 1 szacujemy od jego parametrów i z 4 losowych startów,
# model K – z 10 losowych startów. Obliczenia równoległe (parallel::mclapply, 8 rdzeni).
library(parallel)
RNGkind("L'Ecuyer-CMRG"); set.seed(2026)
braki <- is.na(Y)
blrt <- function(K, B = 100) {
  lrt_obs <- 2 * (fits[[K]]$ll - fits[[K - 1]]$ll)
  lrt_b <- unlist(mclapply(1:B, function(b) {
    Yb <- lca_losuj(fits[[K - 1]], braki)
    ll0 <- max(lca_em(Yb, K - 1, start = fits[[K - 1]])$ll, lca_em(Yb, K - 1, starty = 4)$ll)
    2 * (lca_em(Yb, K, starty = 10)$ll - ll0)
  }, mc.cores = 8, mc.set.seed = TRUE))
  c(K = K, LRT = lrt_obs, p = (1 + sum(lrt_b >= lrt_obs)) / (B + 1))
}
wyniki_blrt <- t(sapply(2:6, blrt))
round(wyniki_blrt, 3)
Wynik w R
     K     LRT     p
[1,] 2 336.611 0.010
[2,] 3 184.066 0.010
[3,] 4 179.517 0.010
[4,] 5  13.910 0.792
[5,] 6  12.264 0.812
6. Profile klas, jakość klasyfikacji i reszty dwuzmiennowe
R
# Rozwiązanie z czterema klasami: udziały, profile odpowiedzi, jakość klasyfikacji i lokalna niezależność
f4 <- fits[[4]]
round(100 * f4$pk, 1)                                  # udziały klas (%), od największej
round(f4$p, 2)                                         # P(„tak” | klasa)
przyp <- apply(f4$post, 1, which.max)                  # klasa najbardziej prawdopodobna
table(przyp)
# średnie prawdopodobieństwo a posteriori (wiersze: przypisana klasa, kolumny: klasa)
round(t(sapply(1:4, function(s) colMeans(f4$post[przyp == s, , drop = FALSE]))), 3)
round(mean(apply(f4$post, 1, max) < .70), 3)           # odsetek osób z maks. prawdopodobieństwem < .70
# zgodność z prawdziwą klasą (znana tylko w danych symulowanych)
table(przypisana = przyp, prawdziwa = dane$klasa_prawdziwa)

# lokalna niezależność: dwuzmiennowe reszty (BVR) – χ² Pearsona dla tabeli 2 × 2 każdej pary wskaźników,
# porównanej z liczebnościami oczekiwanymi z modelu
bvr <- function(f, Y) {
  pary <- combn(ncol(Y), 2)
  apply(pary, 2, function(jl) {
    j <- jl[1]; l <- jl[2]; ok <- !is.na(Y[, j]) & !is.na(Y[, l]); n <- sum(ok)
    obs <- table(factor(Y[ok, j], 0:1), factor(Y[ok, l], 0:1))
    pj <- f$p[, j]; pl <- f$p[, l]
    ocz <- n * matrix(c(sum(f$pk * (1 - pj) * (1 - pl)), sum(f$pk * pj * (1 - pl)),
                        sum(f$pk * (1 - pj) * pl), sum(f$pk * pj * pl)), 2)
    sum((obs - ocz)^2 / ocz)
  })
}
nazwy_par <- apply(combn(colnames(Y), 2), 2, paste, collapse = "–")
bvr_tab <- sapply(2:5, function(K) bvr(fits[[K]], Y)); dimnames(bvr_tab) <- list(nazwy_par, paste0("K", 2:5))
round(apply(bvr_tab, 2, max), 2)                       # największa reszta w modelach 2–5 klas
colSums(bvr_tab > 3.84)                                # liczba par powyżej 3.84
round(head(bvr_tab[order(-bvr_tab[, "K3"]), ], 4), 2)  # pary z największymi resztami w modelu 3 klas
Wynik w R
[1] 37.9 25.4 21.7 15.0
     zasypianie wybudzenia wczesne chrapanie bezdechy sennosc pozno odsypianie
[1,]       0.12       0.10    0.09      0.12     0.02    0.09  0.16       0.12
[2,]       0.40       0.11    0.02      0.14     0.01    0.44  0.78       0.74
[3,]       0.78       0.84    0.67      0.16     0.06    0.61  0.22       0.16
[4,]       0.14       0.35    0.18      0.82     0.48    0.71  0.15       0.15
przyp
  1   2   3   4
403 238 230 129
      [,1]  [,2]  [,3]  [,4]
[1,] 0.823 0.100 0.024 0.053
[2,] 0.095 0.841 0.038 0.026
[3,] 0.071 0.038 0.833 0.058
[4,] 0.069 0.037 0.049 0.845
[1] 0.221
          prawdziwa
przypisana Bezsenność Chrapanie i senność Dobry sen Późny rytm
         1         16                  14       349         24
         2         19                   9        28        182
         3        197                   9        19          5
         4          7                 101        16          5
   K2    K3    K4    K5
77.53 54.50  1.39  1.42
K2 K3 K4 K5
15  4  0  0
                       K2    K3   K4   K5
chrapanie–bezdechy  61.45 54.50 0.10 0.01
bezdechy–sennosc    12.89 39.80 0.46 0.28
chrapanie–sennosc    8.48 30.60 0.98 0.10
wybudzenia–bezdechy  2.43  3.91 0.15 0.15
7. Zmienne zewnętrzne: przypisanie modalne, proporcjonalne i poprawka BCH
R
# Zmienne zewnętrzne (samopoczucie 0–100 i wiek): trzy sposoby liczenia średnich w klasach
z <- dane[, c("samopoczucie", "wiek")]
srednie_modalne <- function(post, z) { s <- apply(post, 1, which.max); sapply(z, function(v) tapply(v, factor(s, 1:ncol(post)), mean)) }
srednie_proporcjonalne <- function(post, z) sapply(z, function(v) colSums(post * v) / colSums(post))
srednie_bch <- function(post, z) {                     # poprawka BCH (Bolck, Croon i Hagenaars; Vermunt)
  s <- apply(post, 1, which.max); K <- ncol(post)
  D <- t(sapply(1:K, function(t) sapply(1:K, function(k) sum(post[s == k, t])) / sum(post[, t])))  # D[t, s] = P(przypisana s | klasa t)
  W <- solve(D)[s, ]                                   # wagi BCH: wiersz odwrotności D odpowiadający przypisanej klasie
  sapply(z, function(v) colSums(W * v) / colSums(W))
}
round(D_bledu <- {s <- apply(f4$post, 1, which.max); t(sapply(1:4, function(t) sapply(1:4, function(k) sum(f4$post[s == k, t])) / sum(f4$post[, t])))}, 3)
# prawdziwe średnie w klasach (dopasowanie etykiet: która klasa modelu najczęściej odpowiada prawdziwej)
mapa <- apply(table(przyp, dane$klasa_prawdziwa), 1, function(r) names(which.max(r)))
mapa
prawdziwe <- sapply(z, function(v) tapply(v, factor(dane$klasa_prawdziwa, levels = mapa), mean))
wyniki_z <- list(prawdziwe = prawdziwe, modalne = srednie_modalne(f4$post, z),
                 proporcjonalne = srednie_proporcjonalne(f4$post, z), BCH = srednie_bch(f4$post, z))
lapply(wyniki_z, round, 1)
# różnica samopoczucia: klasa 1 (dobry sen) minus klasa 3 (bezsenność)
sapply(wyniki_z, function(m) round(m[1, "samopoczucie"] - m[3, "samopoczucie"], 1))
# bootstrap przedziałów BCH (500 prób; model LCA szacowany od nowa w każdej próbie od parametrów f4)
set.seed(2026)
bch_boot <- replicate(500, {
  i <- sample(nrow(Y), replace = TRUE)
  fb <- lca_em(Y[i, ], 4, start = f4, sortuj = FALSE)
  srednie_bch(fb$post, z[i, ])[, "samopoczucie"]
})
round(t(apply(bch_boot, 1, quantile, c(.025, .975))), 1)
Wynik w R
      [,1]  [,2]  [,3]  [,4]
[1,] 0.874 0.059 0.043 0.023
[2,] 0.159 0.788 0.034 0.019
[3,] 0.045 0.041 0.884 0.029
[4,] 0.141 0.042 0.089 0.728
                    1                     2                     3
          "Dobry sen"          "Późny rytm"          "Bezsenność"
                    4
"Chrapanie i senność"
$prawdziwe
                    samopoczucie wiek
Dobry sen                   68.2 38.8
Późny rytm                  59.4 29.9
Bezsenność                  49.6 44.8
Chrapanie i senność         54.8 53.1

$modalne
  samopoczucie wiek
1         66.9 39.3
2         59.2 33.1
3         51.0 43.3
4         56.6 50.7

$proporcjonalne
     samopoczucie wiek
[1,]         65.8 39.3
[2,]         60.0 34.3
[3,]         51.9 43.3
[4,]         57.5 48.2

$BCH
     samopoczucie wiek
[1,]         69.1 39.3
[2,]         58.6 31.3
[3,]         48.7 43.5
[4,]         55.9 52.8

                  prawdziwe                     modalne
                       18.5                        15.9
proporcjonalne.samopoczucie            BCH.samopoczucie
                       13.9                        20.4
     2.5% 97.5%
[1,] 66.7  70.7
[2,] 56.5  61.6
[3,] 46.6  51.8
[4,] 52.7  60.0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja LCA napisana na potrzeby poradnika; pakiet poLCA nie był dostępny); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mirt (wersja 1.47): Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06
- parallel (pakiet bazowy R 4.5.3): R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizie klas latentnych
- Jeden start algorytmu. Wynik z jednego startu może być maksimum lokalnym. Używaj kilkudziesięciu startów i raportuj, czy najlepszy logL się powtórzył.
- Wybór liczby klas według entropii albo „ładnych” profili. Entropia opisuje klasyfikację, a nie dopasowanie (Tein i in., 2013). Decyzję opieraj na BIC i BLRT (Nylund i in., 2007), wielkości klas i interpretacji.
- Pominięcie lokalnej niezależności. Duże reszty dwuzmiennowe oznaczają, że model nie wyjaśnia związku pary pytań. Zbyt mało klas albo dwa pytania mierzące to samo dają podobny obraz.
- Przypisz i licz. ANOVA albo regresja z przypisaną klasą zaniża różnice między klasami (Bolck i in., 2004). Używaj poprawki BCH, poprawki największej wiarygodności albo modelu jednoetapowego (Bakk i in., 2013; Vermunt, 2010).
- Testowanie różnic na wskaźnikach, z których powstały klasy. Klasy z definicji różnią się profilem odpowiedzi. Test χ² dla „chrapania w klasach” niczego nie potwierdza. Trafność klas sprawdzaj na zmiennych spoza modelu (zob. trafność kryterialna).
- Reifikacja klas. Klasa to wzorzec w danych, a nie rozpoznanie ani „typ człowieka”. Lubke i Neale (2006) pokazali, że ciągły wymiar może udawać klasy. Rozważ model czynnikowy jako alternatywę.
- Usuwanie osób z brakami. Metoda największej wiarygodności korzysta z udzielonych odpowiedzi. Usunięcie osób z brakiem jednej odpowiedzi zmniejsza próbę i może zmienić skład klas.
- Zbyt mała klasa. Klasa kilkudziesięciu osób daje niestabilne profile i może się nie powtórzyć w nowej próbie. Sprawdź jej replikację, np. w drugiej połowie próby (zob. walidacja krzyżowa).
- Brak informacji o oprogramowaniu i ustawieniach. Wyniki LCA zależą od liczby startów, kryteriów zbieżności i kodowania braków. Bez tych informacji rozwiązania nie da się odtworzyć.
Najczęstsze pytania
Jak zrobić analizę klas latentnych w R?
Najczęściej używa się pakietu poLCA (poLCA(cbind(...) ~ 1, nclass = K, nrep = 50), kategorie kodowane od 1). Modele klas latentnych szacuje też funkcja mdirt() z pakietu mirt. Krótką funkcję EM można napisać samodzielnie, tak jak w tym poradniku. W każdym przypadku szacuj modele z kolejną liczbą klas z wielu startów i sprawdź, czy najlepszy logarytm wiarygodności się powtarza.
Czym różni się analiza klas latentnych od analizy profili latentnych?
To ten sam model mieszaniny dla różnych wskaźników. LCA wyodrębnia klasy na podstawie odpowiedzi kategorialnych, np. „tak/nie”, a parametrami są prawdopodobieństwa odpowiedzi w klasach. Analiza profili latentnych (LPA) robi to dla wskaźników ciągłych, np. wyników skal, i opisuje profile średnimi i wariancjami. Procedura wyboru liczby klas i analizy zmiennych zewnętrznych jest w obu przypadkach podobna.
Jak sprawdzić lokalną niezależność w LCA?
Policz reszty dwuzmiennowe (BVR): dla każdej pary wskaźników porównaj tabelę 2 × 2 obserwowaną z oczekiwaną z modelu za pomocą χ² Pearsona. Duże reszty oznaczają, że model nie wyjaśnia związku pary. W przykładzie z tego poradnika model trzech klas miał resztę 54.50 dla pary chrapanie–przerwy w oddychaniu, a model czterech klas nie miał żadnej reszty powyżej 3.84.
Jak porównać klasy latentne pod względem innych zmiennych?
Nie przypisuj osób do klas, by potem liczyć zwykłą ANOVA, bo błąd klasyfikacji zaniża różnice. Zastosuj poprawkę BCH (średnie ważone wagami z odwrotności macierzy błędów klasyfikacji), poprawkę największej wiarygodności albo model jednoetapowy. W przykładzie różnica samopoczucia między dwiema klasami wyniosła w prawdzie 18.5 punktu, z przypisania modalnego 15.9, a z poprawką BCH 20.4.
Jaka entropia jest dobra w analizie klas latentnych?
Nie ma progu, który przesądza o jakości modelu. Entropia (0–1) mówi, jak pewnie osoby są przypisane do klas, ale słabo wskazuje właściwą liczbę klas. Niska entropia oznacza, że przy porównywaniu klas trzeba poprawiać błąd klasyfikacji. W przykładzie entropia wyniosła .668, a 82.9% osób trafiło do właściwej klasy.
Powiązane hasła
Przeczytaj też
Segmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →PoradnikTeoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →Wyodrębniasz klasy latentne do artykułu lub rozprawy?
Pomożemy wybrać liczbę klas, sprawdzić lokalną niezależność, poprawnie porównać klasy na zmiennych zewnętrznych oraz przygotować tabele i opis wyników do publikacji.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Asparouhov, T., & Muthén, B. (2014). Auxiliary variables in mixture modeling: Three-step approaches using Mplus. Structural Equation Modeling: A Multidisciplinary Journal, 21(3), 329–341. https://doi.org/10.1080/10705511.2014.915181
- Bakk, Z., Tekle, F. B., & Vermunt, J. K. (2013). Estimating the association between latent class membership and external variables using bias-adjusted three-step approaches. Sociological Methodology, 43(1), 272–311. https://doi.org/10.1177/0081175012470644
- Bolck, A., Croon, M., & Hagenaars, J. (2004). Estimating latent structure models with categorical variables: One-step versus three-step estimators. Political Analysis, 12(1), 3–27. https://doi.org/10.1093/pan/mph001
- Chalmers, R. P. (2012). mirt: A multidimensional item response theory package for the R environment. Journal of Statistical Software, 48(6), 1–29. https://doi.org/10.18637/jss.v048.i06 ● Otwarty dostęp
- IBM. (b.d.). IBM SPSS Statistics Base 31. Pobrano 26 października 2026 z https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Base.pdf ● Otwarty dostęp
- Lanza, S. T., & Rhoades, B. L. (2013). Latent class analysis: An alternative perspective on subgroup analysis in prevention and treatment. Prevention Science, 14(2), 157–168. https://doi.org/10.1007/s11121-011-0201-1 ● Otwarty dostęp: pełny tekst
- Linzer, D. A., & Lewis, J. B. (2011). poLCA: An R package for polytomous variable latent class analysis. Journal of Statistical Software, 42(10). https://doi.org/10.18637/jss.v042.i10 ● Otwarty dostęp
- Lubke, G., & Neale, M. C. (2006). Distinguishing between latent classes and continuous factors: Resolution by maximum likelihood? Multivariate Behavioral Research, 41(4), 499–532. https://doi.org/10.1207/s15327906mbr4104_4
- Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling: A Multidisciplinary Journal, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
- Sinha, P., Calfee, C. S., & Delucchi, K. L. (2021). Practitioner’s guide to latent class analysis: Methodological considerations and common pitfalls. Critical Care Medicine, 49(1), e63–e79. https://doi.org/10.1097/ccm.0000000000004710 ● Otwarty dostęp: pełny tekst
- Tein, J.-Y., Coxe, S., & Cham, H. (2013). Statistical power to detect the correct number of classes in latent profile analysis. Structural Equation Modeling: A Multidisciplinary Journal, 20(4), 640–657. https://doi.org/10.1080/10705511.2013.824781 ● Otwarty dostęp: pełny tekst
- Vermunt, J. K. (2010). Latent class modeling with covariates: Two improved three-step approaches. Political Analysis, 18(4), 450–469. https://doi.org/10.1093/pan/mpq025
- Weller, B. E., Bowen, N. K., & Faubert, S. J. (2020). Latent class analysis: A guide to best practice. Journal of Black Psychology, 46(4), 287–311. https://doi.org/10.1177/0095798420930932 ● Otwarty dostęp
Cytowania BibTeX
@article{asparouhov2014auxiliary, author={Asparouhov, Tihomir and Muthén, Bengt}, title={{Auxiliary variables in mixture modeling: Three-step approaches using Mplus}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2014}, volume={21}, number={3}, pages={329--341}, doi={10.1080/10705511.2014.915181}}@article{bakk2013estimating, author={Bakk, Zsuzsa and Tekle, Fetene B. and Vermunt, Jeroen K.}, title={{Estimating the association between latent class membership and external variables using bias-adjusted three-step approaches}}, journal={Sociological Methodology}, year={2013}, volume={43}, number={1}, pages={272--311}, doi={10.1177/0081175012470644}}@article{bolck2004estimating, author={Bolck, Annabel and Croon, Marcel and Hagenaars, Jacques}, title={{Estimating latent structure models with categorical variables: One-step versus three-step estimators}}, journal={Political Analysis}, year={2004}, volume={12}, number={1}, pages={3--27}, doi={10.1093/pan/mph001}}@article{chalmers2012mirt, author={Chalmers, R. Philip}, title={{mirt: A multidimensional item response theory package for the R environment}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={6}, pages={1--29}, doi={10.18637/jss.v048.i06}}@misc{ibmspssbase31, author={{IBM}}, title={{IBM SPSS Statistics Base 31}}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Base.pdf}}@article{lanza2013latent, author={Lanza, Stephanie T. and Rhoades, Brittany L.}, title={{Latent class analysis: An alternative perspective on subgroup analysis in prevention and treatment}}, journal={Prevention Science}, year={2013}, volume={14}, number={2}, pages={157--168}, doi={10.1007/s11121-011-0201-1}}@article{linzer2011polca, author={Linzer, Drew A. and Lewis, Jeffrey B.}, title={{poLCA: An R package for polytomous variable latent class analysis}}, journal={Journal of Statistical Software}, year={2011}, volume={42}, number={10}, doi={10.18637/jss.v042.i10}}@article{lubke2006distinguishing, author={Lubke, Gitta and Neale, Michael C.}, title={{Distinguishing between latent classes and continuous factors: Resolution by maximum likelihood?}}, journal={Multivariate Behavioral Research}, year={2006}, volume={41}, number={4}, pages={499--532}, doi={10.1207/s15327906mbr4104_4}}@article{nylund2007deciding, author={Nylund, Karen L. and Asparouhov, Tihomir and Muthén, Bengt O.}, title={{Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={4}, pages={535--569}, doi={10.1080/10705510701575396}}@article{sinha2021practitioner, author={Sinha, Pratik and Calfee, Carolyn S. and Delucchi, Kevin L.}, title={{Practitioner’s guide to latent class analysis: Methodological considerations and common pitfalls}}, journal={Critical Care Medicine}, year={2021}, volume={49}, number={1}, pages={e63--e79}, doi={10.1097/ccm.0000000000004710}}@article{tein2013statistical, author={Tein, Jenn-Yun and Coxe, Stefany and Cham, Heining}, title={{Statistical power to detect the correct number of classes in latent profile analysis}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2013}, volume={20}, number={4}, pages={640--657}, doi={10.1080/10705511.2013.824781}}@article{vermunt2010latent, author={Vermunt, Jeroen K.}, title={{Latent class modeling with covariates: Two improved three-step approaches}}, journal={Political Analysis}, year={2010}, volume={18}, number={4}, pages={450--469}, doi={10.1093/pan/mpq025}}@article{weller2020latent, author={Weller, Bridget E. and Bowen, Natasha K. and Faubert, Sarah J.}, title={{Latent class analysis: A guide to best practice}}, journal={Journal of Black Psychology}, year={2020}, volume={46}, number={4}, pages={287--311}, doi={10.1177/0095798420930932}}