Co to jest niejawna heterogeniczność?
Niejawna heterogeniczność (ang. unobserved heterogeneity) to sytuacja, w której próba składa się z podgrup o różnych parametrach modelu – różnych ścieżkach, średnich albo ładunkach – a badacz nie ma zmiennej, która te podgrupy oznacza. Model oszacowany dla całej próby uśrednia wtedy różne związki. Wynik może nie opisywać dobrze żadnej z rzeczywistych podgrup.
Kontrastem jest heterogeniczność jawna. Gdy źródło różnic jest obserwowane (płeć, kraj, rodzaj studiów), można je wprowadzić jako moderator albo przeprowadzić analizę wielogrupową. Lubke i Muthén (2005) opisują ten podział wprost: obserwowane źródła różnic obsługuje się metodami wielogrupowymi, a nieobserwowane – modelami klas ukrytych. Becker i in. (2013) pokazali w symulacjach, że pominięta niejawna heterogeniczność obciąża oszacowania parametrów modeli strukturalnych i prowadzi do błędów I i II rodzaju.
Dlaczego to problem
- Uśrednione efekty. Silny związek w jednej podgrupie i brak związku w drugiej dają razem słaby związek, który nikogo nie opisuje.
- Odwrócone kierunki. Gdy podgrupy różnią się też średnimi, łączny wynik może mieć nawet przeciwny znak niż związki wewnątrz grup – to mechanizm podobny do paradoksu Simpsona.
- Zaniżone R² i źle oceniona trafność. Model dla wszystkich wyjaśnia mniej wariancji, a wnioski o tym, „jak działa” zjawisko, mogą być błędne dla większości badanych.
Jak się ją wykrywa
Narzędzia do wykrywania niejawnej heterogeniczności to modele mieszanin. Zakładają one, że każda obserwacja należy z pewnym prawdopodobieństwem do jednej z K klas ukrytych, a w każdej klasie obowiązuje inny zestaw parametrów.
| Metoda | Co różni klasy | Typowe zastosowanie |
|---|---|---|
| Mieszanina regresji | współczynniki regresji | różne związki X–Y w podgrupach |
| Analiza profili latentnych (LPA) | średnie zmiennych | typy osób o podobnym profilu wyników |
| Czynnikowy model mieszanin | parametry modelu czynnikowego | klasy różniące się strukturą pomiaru |
| FIMIX-PLS, PLS-POS | ścieżki modelu PLS | segmentacja w PLS-SEM |
W PLS-SEM najczęściej stosuje się FIMIX-PLS. Hair i in. (2016) zalecają, by liczbę segmentów ustalać na podstawie kilku kryteriów informacyjnych, teorii i logiki, a nie jednego wskaźnika. Becker i in. (2013) zaproponowali PLS-POS, który – w odróżnieniu od FIMIX-PLS – wykrywa też heterogeniczność w formatywnych modelach pomiarowych.
Niejawna heterogeniczność w SEM i PLS-SEM
W modelach równań strukturalnych podgrupy mogą różnić się na dwóch poziomach. W części strukturalnej różnią się ścieżki, np. wpływ stresu na wypalenie jest silny w jednej podgrupie i słaby w drugiej. W części pomiarowej różnią się ładunki albo wyrazy wolne – te same pozycje znaczą wtedy coś innego dla różnych osób. Druga sytuacja jest groźniejsza, bo podważa porównywalność wyników konstruktów między segmentami.
W praktyce analizy PLS-SEM postępowanie ma zwykle cztery etapy:
- ocena modelu pomiarowego i strukturalnego dla całej próby;
- segmentacja (np. FIMIX-PLS) i wybór liczby segmentów na podstawie kilku kryteriów;
- poszukiwanie zmiennych, które wyjaśniają przynależność do segmentów – płci, wieku, motywów, doświadczenia;
- jeśli takie zmienne się znajdą: analiza wielogrupowa lub moderacja z ich użyciem, poprzedzona sprawdzeniem inwariancji pomiaru.
W CB-SEM tę samą rolę pełnią czynnikowe modele mieszanin i mieszaniny modeli strukturalnych. Wymagają one większych prób i starannego sprawdzania rozwiązań lokalnych. W przykładzie niżej, dla przejrzystości, segmentujemy zwykłą regresję liniową. Logika jest ta sama.
Przykład: media społecznościowe i samopoczucie
Czterystu studentów (dane symulowane) podało, ile godzin dziennie spędza w mediach społecznościowych, i wypełniło skalę samopoczucia (0–25). W populacji istnieją dwie nieoznaczone podgrupy. U około 60% osób więcej czasu w mediach wiąże się z gorszym samopoczuciem. U pozostałych 40% związek jest lekko dodatni, np. dlatego, że używają mediów głównie do kontaktu z bliskimi. Badacz nie ma żadnej zmiennej, która by te grupy rozróżniała.
Jedna regresja dla wszystkich daje nachylenie b = −0.92 punktu na godzinę i R² = .226. Wniosek brzmiałby: „każda godzina w mediach obniża samopoczucie o niecały punkt”.
Mieszanina regresji oszacowana algorytmem EM dla K = 1, 2 i 3 klas dała BIC równe 1949.89, 1865.90 i 1882.12. Najniższe BIC wskazało rozwiązanie dwuklasowe, zgodnie z zaleceniem Nylund i in. (2007), dla których BIC był najlepszym z kryteriów informacyjnych. W rozwiązaniu dwuklasowym:
- segment 1 (60.6% próby): nachylenie −1.94, stała 20.42;
- segment 2 (39.4% próby): nachylenie +0.56, stała 11.07.
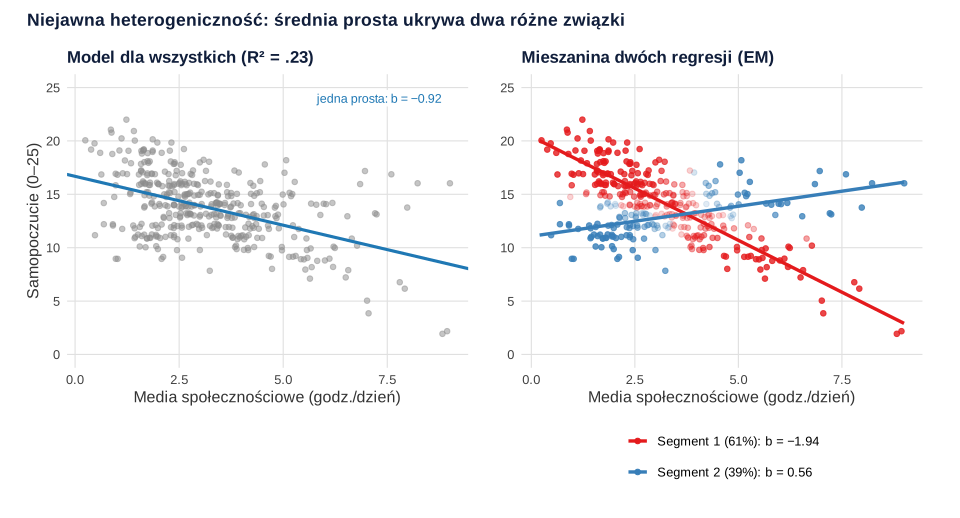
Oszacowania są bliskie wartościom populacyjnym (−1.80 i +0.60). Jedna regresja opisywała więc „przeciętną osobę”, która nie istnieje: w żadnym segmencie nachylenie nie jest bliskie −0.92. Przypisanie do segmentów było jednak niepewne. Entropia wyniosła .473, a 82% osób (329 z 400) trafiło do swojej prawdziwej grupy. Osoby o krótkim czasie w mediach i średnim samopoczuciu pasują do obu prostych.
Ostrożnie: klasy, których nie ma
Modele mieszanin potrafią „znaleźć” klasy także w jednorodnej populacji. Bauer i Curran (2003) pokazali, że przy nienormalnym rozkładzie model mieszanin może wskazać kilka klas jako optymalne, choć w populacji istnieje tylko jedna. W drugiej części kodu wygenerowaliśmy dane z jednej populacji z jednym nachyleniem, ale ze skośnymi resztami. BIC wynosił 2067.23 dla jednej klasy, 1934.84 dla dwóch i 1899.87 dla trzech. Kryterium wybrało więc trzy segmenty, których w rzeczywistości nie ma.
Dlatego rozwiązanie z klasami traktuj jako hipotezę, którą trzeba sprawdzić:
- Sprawdź rozkład reszt modelu jednoklasowego – silna skośność sama może tworzyć pozorne klasy.
- Porównaj kilka kryteriów (BIC, AIC, entropia, liczebność najmniejszej klasy) i stabilność rozwiązania przy różnych punktach startowych.
- Poszukaj zmiennych, które różnicują klasy, np. motywów korzystania z mediów. Gdy je znajdziesz, heterogeniczność staje się jawna i możesz ją modelować jako interakcję.
- Powtórz analizę na nowej próbie. Klasy, które nie replikują się w innych danych, opisz najwyżej jako wynik eksploracyjny.
Jak opisać analizę w pracy
Mieszanina regresji w R
Kod generuje dane z dwiema ukrytymi podgrupami, szacuje jedną regresję dla wszystkich, a następnie mieszaninę K = 1–3 regresji własną funkcją algorytmu EM (bez dodatkowych pakietów; 20 losowych startów). Porównuje BIC, AIC i entropię, wypisuje parametry rozwiązania dwuklasowego i zgodność przypisania z prawdziwymi segmentami, a na koniec sprawdza, ile klas BIC „znajduje” w jednorodnej populacji ze skośnymi resztami. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Mieszanina regresji algorytmem EM
R
# R126 – niejawna heterogeniczność: mieszanina regresji (algorytm EM napisany w R, bez dodatkowych pakietów)
# Dane symulowane: 400 studentów; X = godziny korzystania z mediów społecznościowych dziennie,
# Y = samopoczucie (0–25). W populacji są dwa nieoznaczone segmenty:
# 60% – im więcej mediów, tym gorsze samopoczucie; 40% – brak takiego związku (lekko dodatni).
set.seed(126)
n <- 400
segment <- rbinom(n, 1, 0.40) + 1                       # 1 albo 2 – badacz tego nie widzi
media <- round(pmin(pmax(rgamma(n, shape = 4, rate = 1.2), 0.2), 9), 1)
samop <- ifelse(segment == 1, 20 - 1.80 * media, 11 + 0.60 * media) + rnorm(n, sd = 1.8)
samop <- pmin(pmax(round(samop), 0), 25)
dane <- data.frame(media, samop, segment)

# 1. Jedna regresja dla wszystkich (homogeniczność założona)
m1 <- lm(samop ~ media, data = dane)
round(c(coef(m1), R2 = summary(m1)$r.squared), 3)

# 2. Mieszanina K regresji liniowych – algorytm EM z wieloma punktami startowymi
em_mieszanina <- function(x, y, K, starty = 20, iter = 500) {
  X <- cbind(1, x); n <- length(y); najlepszy <- NULL
  for (s in seq_len(starty)) {
    z <- matrix(runif(n * K), n); z <- z / rowSums(z)       # losowe prawdopodobieństwa przynależności
    ll_stare <- -Inf
    for (it in seq_len(iter)) {
      pi_k <- colMeans(z)
      par <- lapply(seq_len(K), function(k) {
        b <- lm.wfit(X, y, z[, k])$coefficients
        s2 <- sum(z[, k] * (y - X %*% b)^2) / sum(z[, k])
        list(b = b, s = sqrt(max(s2, 1e-4)))
      })
      gest <- sapply(seq_len(K), function(k) pi_k[k] * dnorm(y, X %*% par[[k]]$b, par[[k]]$s))
      ll <- sum(log(rowSums(gest)))
      z <- gest / rowSums(gest)
      if (abs(ll - ll_stare) < 1e-8) break
      ll_stare <- ll
    }
    if (is.null(najlepszy) || ll > najlepszy$ll) najlepszy <- list(ll = ll, pi = pi_k, par = par, z = z)
  }
  npar <- K * 3 + (K - 1)
  najlepszy$BIC <- -2 * najlepszy$ll + log(n) * npar
  najlepszy$AIC <- -2 * najlepszy$ll + 2 * npar
  ent <- if (K > 1) 1 - sum(-najlepszy$z * log(pmax(najlepszy$z, 1e-12))) / (n * log(K)) else NA
  najlepszy$entropia <- ent
  najlepszy
}
set.seed(1260)
wyniki <- lapply(1:3, function(K) em_mieszanina(dane$media, dane$samop, K))
round(t(sapply(wyniki, function(w) c(K = length(w$pi), logLik = w$ll, AIC = w$AIC, BIC = w$BIC, entropia = w$entropia))), 3)

# 3. Rozwiązanie dwusegmentowe: udziały, stałe, nachylenia, SD reszt
w2 <- wyniki[[2]]
round(t(sapply(seq_along(w2$pi), function(k) c(udzial = w2$pi[k], stala = unname(w2$par[[k]]$b[1]),
                                                 nachylenie = unname(w2$par[[k]]$b[2]), sd = w2$par[[k]]$s))), 3)
# zgodność przypisania z prawdziwym segmentem
przyp <- max.col(w2$z)
table(prawdziwy = dane$segment, przypisany = przyp)

# 4. Ostrzeżenie: jedna populacja o skośnych resztach – czy BIC „znajdzie” segmenty, których nie ma?
set.seed(1261)
y_skos <- 20 - 0.8 * media - (rgamma(n, shape = 1.2, rate = 0.35) - 1.2 / 0.35)
wyniki_skos <- lapply(1:3, function(K) em_mieszanina(media, y_skos, K))
round(t(sapply(wyniki_skos, function(w) c(K = length(w$pi), BIC = w$BIC))), 2)
saveRDS(list(dane = dane, w2 = w2, m1 = coef(m1)), "heterogenicznosc.rds")
Wynik w R
(Intercept)       media          R2
     16.682      -0.915       0.226
     K   logLik      AIC      BIC entropia
[1,] 1 -965.958 1937.915 1949.890       NA
[2,] 2 -911.980 1837.959 1865.900    0.473
[3,] 3 -908.108 1838.217 1882.123    0.500
     udzial  stala nachylenie    sd
[1,]  0.606 20.415     -1.945 1.739
[2,]  0.394 11.070      0.563 1.750
         przypisany
prawdziwy   1   2
        1 221  19
        2  52 108
     K     BIC
[1,] 1 2067.23
[2,] 2 1934.84
[3,] 3 1899.87
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe i pakiet stats); rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Interpretowanie klas jako „typów ludzi” bez dowodów zewnętrznych. Klasa może być artefaktem rozkładu.
- Wybór liczby klas po jednym kryterium albo dlatego, że rozwiązanie „dobrze się interpretuje”.
- Pomijanie niepewności przypisania. Przy entropii .47 analizowanie klas jak zwykłych grup zawyża różnice między nimi.
- Szukanie segmentów przed oceną modelu pomiarowego. W PLS-SEM najpierw oceń pomiar, a przy porównaniu segmentów sprawdź też inwariancję pomiaru kompozytów (MICOM).
Praktyczne porównanie LPA i metody k-średnich znajdziesz we wpisie segmentacja respondentów, a miejsce analizy heterogeniczności w ocenie modelu PLS – w przewodniku PLS-SEM.
Najczęstsze pytania
Czym różni się heterogeniczność jawna od niejawnej?
Jawna dotyczy podgrup oznaczonych zmienną, którą mamy w danych (np. płeć, kierunek studiów) – uwzględnia się ją przez moderację albo analizę wielogrupową. Niejawna dotyczy podgrup, których nie oznacza żadna zmienna – trzeba je wykrywać modelami mieszanin z klasami ukrytymi.
Jak wybrać liczbę segmentów w modelu mieszanin?
Porównaj kilka kryteriów: BIC (zwykle najbardziej wiarygodny wśród kryteriów informacyjnych), AIC, entropię i wielkość najmniejszej klasy, sprawdź stabilność przy różnych startach i sens merytoryczny klas. Pamiętaj, że przy skośnych danych kryteria mogą wskazywać zbyt wiele klas.
Co oznacza entropia w modelu mieszanin?
Entropia (w wersji względnej, od 0 do 1) mierzy pewność przypisania osób do klas: wartości bliskie 1 oznaczają wyraźne rozdzielenie, a niskie – że wiele osób pasuje do kilku klas. W przykładzie z tego hasła entropia wyniosła .47, a do właściwej grupy trafiło 82% osób.
Czy znaleziona klasa ukryta to rzeczywista grupa ludzi?
Niekoniecznie. Model mieszanin może podzielić na klasy także jednorodną populację o nienormalnym rozkładzie. Klasa staje się wiarygodna, gdy jest stabilna, replikuje się w nowej próbie i różni się w przewidywalny sposób zmiennymi spoza modelu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Segmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →PoradnikPLS-SEM krok po kroku: założenia, model pomiarowy i strukturalny
Praktyczny przewodnik po PLS-SEM: kiedy metoda odpowiada pytaniu, jak odróżnić kompozyt od wspólnego czynnika, ocenić model i uczciwie raportować wynik.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bauer, D. J., & Curran, P. J. (2003). Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes. Psychological Methods, 8(3), 338–363. https://doi.org/10.1037/1082-989X.8.3.338
- Becker, J.-M., Rai, A., Ringle, C. M., & Völckner, F. (2013). Discovering unobserved heterogeneity in structural equation models to avert validity threats. MIS Quarterly, 37(3), 665–694. https://doi.org/10.25300/misq/2013/37.3.01
- Hair, J. F., Jr., Sarstedt, M., Matthews, L. M., & Ringle, C. M. (2016). Identifying and treating unobserved heterogeneity with FIMIX-PLS: part I – method. European Business Review, 28(1), 63–76. https://doi.org/10.1108/ebr-09-2015-0094 ● Otwarty dostęp: pełny tekst
- Lubke, G. H., & Muthén, B. (2005). Investigating population heterogeneity with factor mixture models. Psychological Methods, 10(1), 21–39. https://doi.org/10.1037/1082-989x.10.1.21
- Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling: A Multidisciplinary Journal, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
Cytowania BibTeX
@article{bauer2003distributional, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={338--363}, doi={10.1037/1082-989x.8.3.338}}@article{becker2013discovering, author={Becker, Jan-Michael and Rai, Arun and Ringle, Christian M. and Völckner, Franziska}, title={{Discovering unobserved heterogeneity in structural equation models to avert validity threats}}, journal={MIS Quarterly}, year={2013}, volume={37}, number={3}, pages={665--694}, doi={10.25300/misq/2013/37.3.01}}@article{hair2016identifying, author={Hair, Jr., Joe F. and Sarstedt, Marko and Matthews, Lucy M. and Ringle, Christian M.}, title={{Identifying and treating unobserved heterogeneity with FIMIX-PLS: part I – method}}, journal={European Business Review}, year={2016}, volume={28}, number={1}, pages={63--76}, doi={10.1108/ebr-09-2015-0094}}@article{lubke2005investigating, author={Lubke, Gitta H. and Muthén, Bengt}, title={{Investigating population heterogeneity with factor mixture models}}, journal={Psychological Methods}, year={2005}, volume={10}, number={1}, pages={21--39}, doi={10.1037/1082-989x.10.1.21}}@article{nylund2007deciding, author={Nylund, Karen L. and Asparouhov, Tihomir and Muthén, Bengt O.}, title={{Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={4}, pages={535--569}, doi={10.1080/10705510701575396}}