Co to jest FIMIX-PLS?
FIMIX-PLS (ang. finite mixture partial least squares, PLS z mieszaniną skończoną) to metoda wykrywania nieobserwowanych segmentów osób, u których zależności w modelu strukturalnym PLS-SEM są różne. Zaproponowali ją Hahn i in. (2002). Zamiast zakładać, że jeden zestaw współczynników ścieżek opisuje wszystkich badanych, FIMIX-PLS przyjmuje, że próba jest mieszaniną kilku grup. Każda grupa ma własne ścieżki, a przynależność do grup nie jest znana – trzeba ją oszacować z danych.
Problem, który rozwiązuje FIMIX-PLS, to niejawna heterogeniczność. Jeśli u części osób wsparcie przełożonego silnie zwiększa zaangażowanie w pracę, a u innych nie ma znaczenia, model dla całej próby pokaże średni, umiarkowany efekt, który nie opisuje dobrze nikogo. Gdy podział znamy z góry (np. płeć, staż), wystarczy analiza wielogrupowa. FIMIX-PLS stosuje się wtedy, gdy zmienna różnicująca nie została zmierzona albo nie wiadomo, co nią jest.
Jak działa FIMIX-PLS
- Model dla całej próby. Oszacuj zwykły model PLS-SEM z ocenionym modelem pomiarowym (zob. AVE) i zapisz wyniki konstruktów (ang. construct scores).
- Mieszanina regresji. Dla K = 1, 2, 3… segmentów oszacuj model, w którym każdy konstrukt endogeniczny zależy od swoich predyktorów inaczej w każdym segmencie. Każda osoba ma prawdopodobieństwo przynależności do każdego segmentu. Estymacja odbywa się algorytmem EM (ang. expectation–maximization) z wielu losowych startów, bo algorytm może utknąć w maksimum lokalnym.
- Wybór liczby segmentów na podstawie kryteriów informacyjnych (AIC, AIC3, BIC, CAIC) i entropii (EN), a także wielkości segmentów i ich interpretowalności.
- Analiza ex post. Sprawdź, czy segmenty da się opisać zmiennymi obserwowalnymi (wiek, płeć, stanowisko). Jeśli tak, oszacuj modele w tych grupach i porównaj je w analizie wielogrupowej, sprawdzając wcześniej inwariancję pomiaru kompozytów (MICOM).
FIMIX-PLS obejmuje tylko model strukturalny. Model pomiarowy jest wspólny dla wszystkich, a reszty w segmentach zakłada się jako normalne. Te ograniczenia wymieniają Hair i in. (2016). Matthews i in. (2016) zalecają dlatego łączyć FIMIX-PLS z segmentacją PLS-POS, która nie ma założeń rozkładowych.
Kryteria wyboru liczby segmentów
| Kryterium | Kara za parametry | Charakter |
|---|---|---|
| AIC | 2 na parametr | najłagodniejsza; skłonność do zbyt wielu segmentów |
| AIC3 | 3 na parametr | umiarkowana |
| BIC | ln N na parametr | surowa; skłonność do mniejszej liczby segmentów |
| CAIC | ln N + 1 na parametr | najsurowsza |
| EN (entropia normowana) | – | od 0 do 1; im bliżej 1, tym wyraźniejszy podział osób |
Wzory kryteriów są takie jak w AIC i BIC w SEM, a liczba parametrów rośnie z K. Sarstedt i in. (2011) porównali w eksperymentach obliczeniowych, jak te kryteria radzą sobie ze wskazaniem właściwej liczby segmentów w FIMIX-PLS. W szerszej literaturze o modelach mieszanin Nylund i in. (2007) stwierdzili, że wśród kryteriów informacyjnych najlepiej sprawdzało się BIC. Hair i in. (2016) zalecają nie opierać decyzji na jednym kryterium, tylko uwzględnić kilka kryteriów, teorię i logikę. Segment, który obejmuje kilka procent próby, rzadko jest przydatny.
Przykład: dla kogo liczy się wsparcie, a dla kogo autonomia?
Czterystu pracowników (dane symulowane) oceniło wsparcie przełożonego, autonomię w pracy i zaangażowanie, po trzy pozycje na skali 1–7. W danych ukryto dwa segmenty. W pierwszym (60% osób) zaangażowanie zależy głównie od wsparcia, w drugim (40%) od autonomii. Informacji o segmentach nie ma w danych.
Model PLS-SEM dla całej próby daje umiarkowane ścieżki: wsparcie → zaangażowanie .316, autonomia → zaangażowanie .164, R² = .141. Wniosek „oba czynniki mają słabe znaczenie” byłby jednak mylący. Kryteria FIMIX-PLS dla 1–4 segmentów:
| K | ln L | Parametry | AIC | AIC3 | BIC | CAIC | EN |
|---|---|---|---|---|---|---|---|
| 1 | −536.74 | 3 | 1079.49 | 1082.49 | 1091.46 | 1094.46 | – |
| 2 | −517.55 | 7 | 1049.10 | 1056.10 | 1077.04 | 1084.04 | .316 |
| 3 | −516.12 | 11 | 1054.23 | 1065.23 | 1098.14 | 1109.14 | .363 |
| 4 | −510.48 | 15 | 1050.96 | 1065.96 | 1110.83 | 1125.83 | .570 |
Wszystkie cztery kryteria wskazują dwa segmenty. Segment 1 obejmuje 65.2% osób, segment 2 – 34.8%. Rysunek 1 pokazuje, co kryje się za średnim wynikiem: w segmencie 1 wsparcie ma ścieżkę .60, a autonomia −.14; w segmencie 2 odwrotnie – autonomia .69, wsparcie −.36.
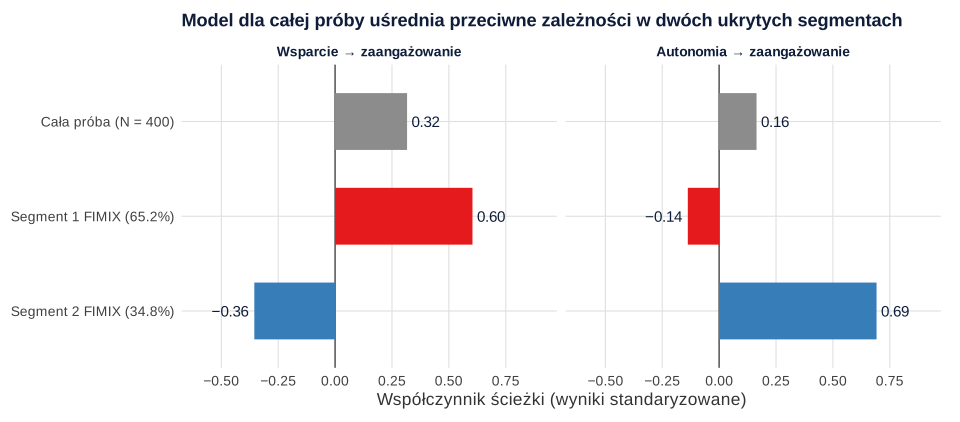
Dwie liczby studzą entuzjazm. Entropia EN = .316 oznacza, że wiele osób ma podobne prawdopodobieństwo przynależności do obu segmentów. Gdy każdą osobę przypisano do segmentu o największym prawdopodobieństwie, zgodność z prawdziwym podziałem wyniosła 71.3%. Osobne modele PLS-SEM w tak utworzonych grupach dały jeszcze silniej rozbieżne ścieżki (np. w segmencie 2: wsparcie −.47, autonomia .68, R² = .74). Twarde przypisanie wybiera bowiem osoby najlepiej pasujące do segmentu i przez to wyolbrzymia różnice. Wnioski opieraj więc na ścieżkach z FIMIX i szukaj zmiennych obserwowalnych, które wyjaśniają podział.
FIMIX-PLS a moderacja
Segmenty o różnych ścieżkach to w istocie moderacja przez nieznaną zmienną kategorialną. Gdyby segment był zmierzony, ten sam efekt opisałby efekt interakcji predyktora z tą zmienną. Dlatego analiza ex post jest tak ważna. Jeśli segment 2 to przede wszystkim osoby z dłuższym stażem, kolejne badanie powinno testować staż jako moderator, a nie powtarzać segmentację. FIMIX-PLS przydaje się więc najbardziej jako narzędzie diagnostyczne. Pokazuje, że jeden zestaw ścieżek może nie wystarczać, i podpowiada, gdzie szukać zmiennej różnicującej.
Nie myl FIMIX-PLS z segmentacją według wyników samych skal, np. analizą skupień średnich. Tamte metody grupują osoby o podobnym poziomie zmiennych. FIMIX grupuje osoby o podobnych zależnościach między zmiennymi, więc dwie osoby z identycznymi wynikami mogą trafić do różnych segmentów.
Jak opisać FIMIX-PLS w pracy (APA)
Podaj liczbę analizowanych rozwiązań i startów algorytmu, tabelę kryteriów z entropią, wielkości segmentów, ścieżki w segmentach oraz wynik analizy ex post. Zaznacz, że segmenty mają charakter eksploracyjny.
FIMIX-PLS w R (seminr i algorytm EM)
Pakiety R do PLS-SEM nie mają gotowej funkcji FIMIX-PLS, dlatego kod szacuje model w seminr, a następnie na wynikach konstruktów dopasowuje mieszaninę regresji algorytmem EM (bez wyrazu wolnego, z 10 losowymi startami dla każdego K). Liczy też kryteria AIC, AIC3, BIC, CAIC i entropię EN, porównuje przypisanie z prawdziwym podziałem i szacuje modele ex post. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Segmentacja FIMIX-PLS dla 1–4 segmentów
R
suppressPackageStartupMessages({library(lavaan); library(seminr)})

# Dane symulowane: 400 pracowników. Wsparcie przełożonego (wp1–wp3) i autonomia (au1–au3) wyjaśniają
# zaangażowanie w pracę (za1–za3). W populacji są dwa nieobserwowane segmenty (60% i 40%):
# w pierwszym silniej działa wsparcie, w drugim – autonomia. Przynależność do segmentu nie jest w danych.
set.seed(506)
gen <- function(n, b_wp, b_au) {
  lam <- c(wp1 = .88, wp2 = .85, wp3 = .82, au1 = .87, au2 = .85, au3 = .82, za1 = .88, za2 = .86, za3 = .84)
  pop <- paste(sprintf('
    wsparcie  =~ 0.88*wp1 + 0.85*wp2 + 0.82*wp3
    autonomia =~ 0.87*au1 + 0.85*au2 + 0.82*au3
    zaang     =~ 0.88*za1 + 0.86*za2 + 0.84*za3
    zaang ~ %.2f*wsparcie + %.2f*autonomia
    zaang ~~ %.4f*zaang
    wsparcie ~~ 1*wsparcie + 0.25*autonomia
    autonomia ~~ 1*autonomia', b_wp, b_au, 1 - b_wp^2 - b_au^2 - 2 * 0.25 * b_wp * b_au),
    paste(sprintf("%s ~~ %.4f*%s", names(lam), 1 - lam^2, names(lam)), collapse = "\n"), sep = "\n")
  simulateData(pop, sample.nobs = n)          # wariancje ustalone tak, by zmienne miały wariancję 1
}
z <- rbind(gen(240, 0.80, -0.30), gen(160, -0.30, 0.80))
segment_prawdziwy <- rep(1:2, c(240, 160))
dane <- as.data.frame(lapply(z, function(x) pmin(pmax(round(4 + 1.3 * x), 1), 7)))

# 1. Model PLS-SEM dla całej próby (jakby wszyscy byli jedną populacją)
mm <- constructs(composite("Wsparcie", multi_items("wp", 1:3)), composite("Autonomia", multi_items("au", 1:3)),
                 composite("Zaangazowanie", multi_items("za", 1:3)))
sm <- relationships(paths(from = c("Wsparcie", "Autonomia"), to = "Zaangazowanie"))
pls <- suppressMessages(estimate_pls(dane, mm, sm))
round(pls$path_coef[1:2, 3], 3); round(pls$rSquared[1, 1], 3)

# 2. FIMIX-PLS: mieszanina regresji na wynikach konstruktów (algorytm EM, bez wyrazu wolnego,
#    jak w FIMIX-PLS: wyniki konstruktów są standaryzowane). K segmentów, 10 losowych startów.
X <- as.matrix(pls$construct_scores[, c("Wsparcie", "Autonomia")]); y <- pls$construct_scores[, "Zaangazowanie"]
fimix <- function(K, starty = 10, iter = 500) {
  najlepszy <- NULL
  for (s in seq_len(starty)) {
    P <- matrix(runif(length(y) * K), ncol = K); P <- P / rowSums(P)      # losowe przynależności startowe
    ll_stare <- -Inf
    for (it in seq_len(iter)) {
      pi_k <- colMeans(P)
      B <- sapply(1:K, function(k) coef(lm.wfit(X, y, P[, k])))
      s2 <- sapply(1:K, function(k) sum(P[, k] * (y - X %*% B[, k])^2) / sum(P[, k]))
      g <- sapply(1:K, function(k) pi_k[k] * dnorm(y, X %*% B[, k], sqrt(s2[k])))
      ll <- sum(log(rowSums(g))); P <- g / rowSums(g)
      if (abs(ll - ll_stare) < 1e-8) break
      ll_stare <- ll
    }
    if (is.null(najlepszy) || ll > najlepszy$ll) najlepszy <- list(ll = ll, pi = pi_k, B = B, s2 = s2, P = P)
  }
  najlepszy
}
kryteria <- function(f, K, n = length(y), R = ncol(X)) {
  npar <- (K - 1) + K * (R + 1)                                   # proporcje + ścieżki + wariancje reszt
  ent <- if (K == 1) NA else 1 - sum(-f$P * log(pmax(f$P, 1e-300))) / (n * log(K))
  c(K = K, logL = f$ll, npar = npar, AIC = -2 * f$ll + 2 * npar, AIC3 = -2 * f$ll + 3 * npar,
    BIC = -2 * f$ll + log(n) * npar, CAIC = -2 * f$ll + (log(n) + 1) * npar, EN = ent)
}
set.seed(2106)
fity <- lapply(1:4, fimix)
round(do.call(rbind, Map(kryteria, fity, 1:4)), 3)

# 3. Rozwiązanie dwusegmentowe: wielkość segmentów, ścieżki w segmentach, zgodność z prawdziwym podziałem
f2 <- fity[[2]]
round(f2$pi, 3)
B <- f2$B; dimnames(B) <- list(c("Wsparcie", "Autonomia"), paste0("segment", 1:2)); round(B, 3)
przydzial <- max.col(f2$P)
table(segment_prawdziwy, przydzial)
round(mean(segment_prawdziwy == przydzial), 4)          # odsetek zgodnych przydziałów (segment 1 = 1, segment 2 = 2)

# 4. Analiza ex post: osobne modele PLS-SEM w wyodrębnionych segmentach
for (k in 1:2) {
  pk <- suppressMessages(estimate_pls(dane[przydzial == k, ], mm, sm))
  print(round(c(segment = k, n = sum(przydzial == k), pk$path_coef[1:2, 3], R2 = pk$rSquared[1, 1]), 3))
}
Wynik w R
 Wsparcie Autonomia
    0.316     0.164
[1] 0.141
     K     logL npar      AIC     AIC3      BIC     CAIC    EN
[1,] 1 -536.744    3 1079.489 1082.489 1091.463 1094.463    NA
[2,] 2 -517.551    7 1049.102 1056.102 1077.042 1084.042 0.316
[3,] 3 -516.117   11 1054.234 1065.234 1098.140 1109.140 0.363
[4,] 4 -510.479   15 1050.957 1065.957 1110.829 1125.829 0.570
[1] 0.652 0.348
          segment1 segment2
Wsparcie     0.604   -0.355
Autonomia   -0.138    0.692
                 przydzial
segment_prawdziwy   1   2
                1 220  20
                2  95  65
[1] 0.7125
  segment         n  Wsparcie Autonomia        R2
    1.000   315.000     0.702    -0.157     0.474
  segment         n  Wsparcie Autonomia        R2
    2.000    85.000    -0.466     0.682     0.743
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 i ggplot2 (rysunki). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seminr (wersja 2.5.0): Ray, S., Danks, N., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models [R package]. https://doi.org/10.32614/CRAN.package.seminr
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wybór liczby segmentów według jednego kryterium bez sprawdzenia wielkości segmentów, entropii i sensu merytorycznego.
- Traktowanie segmentów jak odkrytych typów ludzi. Segmenty to rozwiązanie statystyczne dla danej próby i wymagają replikacji oraz opisu zmiennymi obserwowalnymi.
- Za mała próba. Każdy segment musi być na tyle liczny, by oszacować w nim model; przy kilku segmentach i wielu ścieżkach szybko brakuje osób.
- Jeden start algorytmu EM. Wynik może być maksimum lokalnym; porównaj kilka startów.
- Wnioski z twardego przypisania zamiast z parametrów segmentów – różnice między grupami wychodzą wtedy przesadzone.
Pokrewne metody klasyfikacji osób opisują hasła analiza profili latentnych i analiza skupień oraz wpis segmentacja respondentów. Miejsce FIMIX w ocenie modelu pokazuje poradnik PLS-SEM krok po kroku.
Najczęstsze pytania
Kiedy stosować FIMIX-PLS?
Gdy podejrzewasz, że zależności w modelu PLS-SEM różnią się między grupami badanych, ale nie wiesz, jaka zmienna wyznacza te grupy, albo jej nie zmierzyłeś. Jeśli podział jest znany (np. płeć), wystarczy analiza wielogrupowa; FIMIX-PLS służy do wykrywania podziałów nieobserwowanych.
Jak wybrać liczbę segmentów w FIMIX-PLS?
Oszacuj rozwiązania dla kolejnych K i porównaj kilka kryteriów: AIC, AIC3, BIC i CAIC (mniej znaczy lepiej) oraz entropię EN (bliżej 1 – wyraźniejszy podział). Najmocniejsze jest rozwiązanie wskazane zgodnie przez kryteria, z segmentami na tyle dużymi, by oszacować w nich model, i dającymi się sensownie zinterpretować.
Co oznacza niska entropia w FIMIX-PLS?
Niska entropia normowana (EN) oznacza, że wiele osób ma podobne prawdopodobieństwo przynależności do kilku segmentów, więc podział jest nieostry. Parametry segmentów mogą być nadal użyteczne, ale przypisanie konkretnych osób do grup jest niepewne, a modele szacowane w twardo przypisanych grupach przesadzają z różnicami.
Czy FIMIX-PLS uwzględnia różnice w modelu pomiarowym?
Nie. FIMIX-PLS dzieli osoby tylko na podstawie modelu strukturalnego i zakłada wspólny model pomiarowy oraz normalne reszty w segmentach. Dlatego przed porównaniem segmentów warto sprawdzić inwariancję pomiaru kompozytów (MICOM), a FIMIX łączyć z innymi metodami segmentacji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PLS-SEM krok po kroku: założenia, model pomiarowy i strukturalny
Praktyczny przewodnik po PLS-SEM: kiedy metoda odpowiada pytaniu, jak odróżnić kompozyt od wspólnego czynnika, ocenić model i uczciwie raportować wynik.
Czytaj →PoradnikSegmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →PoradnikPLS-SEM w R: kompletny przykład w seminr i cSEM
Odtwarzalny przykład PLS-SEM w R: specyfikacja refleksyjna i kompozytowa, PLSc, bootstrap, HTMT, R², f² i ocena predykcyjna w seminr oraz cSEM.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hahn, C., Johnson, M. D., Herrmann, A., & Huber, F. (2002). Capturing customer heterogeneity using a finite mixture PLS approach. Schmalenbach Business Review, 54(3), 243–269. https://doi.org/10.1007/bf03396655 ● Otwarty dostęp: pełny tekst
- Hair, J. F., Jr., Sarstedt, M., Matthews, L. M., & Ringle, C. M. (2016). Identifying and treating unobserved heterogeneity with FIMIX-PLS: Part I – method. European Business Review, 28(1), 63–76. https://doi.org/10.1108/ebr-09-2015-0094 ● Otwarty dostęp: pełny tekst
- Matthews, L. M., Sarstedt, M., Hair, J. F., & Ringle, C. M. (2016). Identifying and treating unobserved heterogeneity with FIMIX-PLS: Part II – A case study. European Business Review, 28(2), 208–224. https://doi.org/10.1108/ebr-09-2015-0095
- Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling: A Multidisciplinary Journal, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
- Sarstedt, M., Becker, J.-M., Ringle, C. M., & Schwaiger, M. (2011). Uncovering and treating unobserved heterogeneity with FIMIX-PLS: Which model selection criterion provides an appropriate number of segments? Schmalenbach Business Review, 63(1), 34–62. https://doi.org/10.1007/bf03396886
Cytowania BibTeX
@article{hahn2002capturing, author={Hahn, Carsten and Johnson, Michael D. and Herrmann, Andreas and Huber, Frank}, title={{Capturing customer heterogeneity using a finite mixture PLS approach}}, journal={Schmalenbach Business Review}, year={2002}, volume={54}, number={3}, pages={243--269}, doi={10.1007/bf03396655}}@article{hair2016identifying, author={Hair, Jr., Joe F. and Sarstedt, Marko and Matthews, Lucy M. and Ringle, Christian M.}, title={{Identifying and treating unobserved heterogeneity with FIMIX-PLS: Part I – method}}, journal={European Business Review}, year={2016}, volume={28}, number={1}, pages={63--76}, doi={10.1108/ebr-09-2015-0094}}@article{matthews2016identifying, author={Matthews, Lucy M. and Sarstedt, Marko and Hair, Joseph F. and Ringle, Christian M.}, title={{Identifying and treating unobserved heterogeneity with FIMIX-PLS: Part II – A case study}}, journal={European Business Review}, year={2016}, volume={28}, number={2}, pages={208--224}, doi={10.1108/ebr-09-2015-0095}}@article{nylund2007deciding, author={Nylund, Karen L. and Asparouhov, Tihomir and Muthén, Bengt O.}, title={{Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={4}, pages={535--569}, doi={10.1080/10705510701575396}}@article{sarstedt2011uncovering, author={Sarstedt, Marko and Becker, Jan-Michael and Ringle, Christian M. and Schwaiger, Manfred}, title={{Uncovering and treating unobserved heterogeneity with FIMIX-PLS: Which model selection criterion provides an appropriate number of segments?}}, journal={Schmalenbach Business Review}, year={2011}, volume={63}, number={1}, pages={34--62}, doi={10.1007/bf03396886}}