Dlaczego statystyka zbiera najwięcej uwag recenzentów
Makin i Orban de Xivry (2019) opisali dziesięć błędów statystycznych, które są dobrze znane, a mimo to wciąż trafiają do czasopism. Ich listę przygotowano przede wszystkim dla recenzentów, bo recenzja to najlepszy moment, by takie błędy zatrzymać. Ten wpis odwraca perspektywę: dla piętnastu typowych zarzutów wobec analiz w artykułach pokazujemy, jak brzmi uwaga, skąd się bierze, jak jej zapobiec przed wysłaniem tekstu i co zrobić, gdy już padła. Gotowe odpowiedzi po polsku i angielsku są w osobnym wpisie z wzorami odpowiedzi recenzentom.
Uwagi recenzentów cytowane niżej to przykłady ułożone na potrzeby tego tekstu – nie pochodzą z konkretnych recenzji ani czasopism. Liczby pochodzą z symulacji w R, których kod znajdziesz na końcu wpisu.
| Zarzut | Co zrobić przed wysłaniem tekstu |
|---|---|
| 1. Brak uzasadnienia liczebności | Analiza mocy a priori albo analiza wrażliwości |
| 2. Wielokrotne porównania | Rodzina testów i korekta ustalone z góry |
| 3. Dobór testu i założenia | Testy odporne domyślnie, opis sprawdzania założeń |
| 4. Brak wielkości efektu i CI | Efekt z 95% CI przy każdym wyniku głównym |
| 5. Dychotomizacja | Analiza zmiennej ciągłej |
| 6. Porównywanie istotności zamiast efektów | Bezpośredni test różnicy (interakcji) |
| 7. Język przyczynowy | Czasowniki dopasowane do schematu badania |
| 8. Braki danych | Opis braków, FIML lub imputacja wielokrotna |
| 9. Wartości odstające | Reguła zapisana z góry, wyniki z nimi i bez nich |
| 10. Dobór krokowy | Model wynikający z teorii, liczba predyktorów dopasowana do N |
| 11. CMV, trafność, inwariancja | Zabezpieczenia w schemacie badania, test inwariancji |
| 12. Dane zagnieżdżone | ICC i model wielopoziomowy |
| 13. p-hacking i HARKing | Prerejestracja, oznaczenie analiz eksploracyjnych |
| 14. Niespójne liczby | Tabele generowane z kodu, przeliczenie wartości p |
| 15. Brak danych i kodu | Pakiet replikacyjny i deklaracja dostępności danych |
1. Brak uzasadnienia liczebności próby
Przykładowa uwaga recenzenta: „The sample size (n = 40 per group) is not justified. Please report a power analysis and, for the non-significant effects, the post hoc power.”
Skąd się bierze. Liczebność często wynika z możliwości rekrutacji, a rozdział o metodzie tego nie mówi. Makin i Orban de Xivry (2019) przypominają, że mała próba pozwala wykryć tylko duże efekty, a istotne wyniki z małych prób zawyżają wielkość efektu.
Jak zapobiec. Napisz, skąd wzięła się liczebność: z analizy mocy a priori (zakładany efekt i jego źródło, α, moc, test) albo z ograniczeń zasobów, uzupełnionych analizą wrażliwości. Taka analiza pokazuje, jaki efekt badanie wykrywa z mocą 80%. Przy 40 osobach w grupie test t osiąga ją dopiero dla d = 0.63, a przy 120 osobach – dla korelacji r = .25. Nie dopisuj „mocy post hoc”. Moc policzona z uzyskanego efektu jest przekształceniem wartości p (Greenland i in., 2016): przy p = .05 wynosi 50.0%, a przy p = .20 – 24.9%. Więcej o planowaniu: dobór liczebności próby. Przykładowy opis do części o metodzie:
Gdy uwaga już padła, odpowiedz analizą wrażliwości i przedziałem ufności – zob. wzór odpowiedzi na prośbę o moc post hoc.
2. Wielokrotne porównania bez korekty
Przykładowa uwaga recenzenta: „The authors tested six outcomes at three time points without correcting for multiple comparisons. Some of the reported effects may be false positives.”
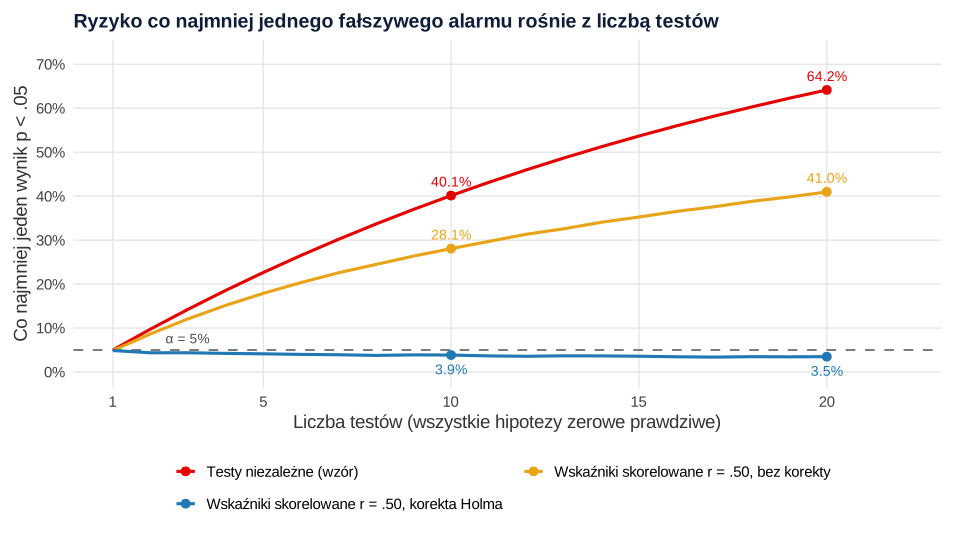
Skąd się bierze. Każdy dodatkowy test to kolejna szansa na fałszywy alarm, czyli błąd I rodzaju. Gdy wszystkie hipotezy zerowe są prawdziwe, szansa co najmniej jednego wyniku p < .05 w m niezależnych testach wynosi 1 − 0.95m: 22.6% przy 5 testach i 40.1% przy 10. Makin i Orban de Xivry (2019) podają przykład trzyczynnikowej ANOVA 2 × 3 × 3, w której szansa co najmniej jednego istotnego efektu bez żadnego prawdziwego efektu wynosi 30%. Gdy wskaźniki są skorelowane, ryzyko jest mniejsze, ale wciąż wysokie (rysunek 1).
Jak zapobiec. Rodzinę testów i sposób korekty ustal przed analizą, najlepiej w planie analizy. Oddziel analizy konfirmacyjne od eksploracyjnych. Do kontroli ryzyka całej rodziny testów użyj procedury Holma – co najmniej tak mocnej jak korekta Bonferroniego – a przy wielu testach eksploracyjnych – kontroli odsetka fałszywych odkryć (FDR). Raportuj wszystkie wykonane testy. Makin i Orban de Xivry (2019) zauważają, że metod korekty jest wiele i nie wszystkie są równie dobrze przyjęte, więc sama obecność jakiejś korekty może nie wystarczyć.
Gdy uwaga już padła, zob. wzór odpowiedzi o korekcie porównań.
3. Dobór testu i sprawdzenie założeń
Przykładowa uwaga recenzenta: „Student’s t-test was used although the group variances differ markedly (SD = 4.1 vs. 9.8) and group sizes are unequal. Please justify the test and describe how assumptions were checked.”
Skąd się bierze. Test wybiera się z przyzwyczajenia albo na podstawie wstępnych testów założeń, a metoda nie mówi, jak je sprawdzano. Delacre i in. (2017) pokazują, że założenie równych wariancji rzadko jest spełnione w psychologii, a wybór testu na podstawie wstępnego testu równości wariancji często zawodzi. Test Welcha lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy założenia są spełnione.
Jak zapobiec. W metodzie napisz, jaki test wybrano, dlaczego i jak sprawdzono założenia. Domyślnie wybieraj procedury odporne na typowe naruszenia (test Welcha, ANOVA Welcha). W regresji oceniaj rozkład reszt, a nie samych zmiennych (zob. jak sprawdzić normalność rozkładu).
Gdy uwaga już padła, pokaż analizę odporną – zob. wzór odpowiedzi o normalności rozkładu.
4. Brak wielkości efektu i przedziałów ufności
Przykładowa uwaga recenzenta: „Results are reported only as p-values. Please provide effect sizes with confidence intervals for all main analyses and discuss their practical relevance.”
Skąd się bierze. Wynik streszcza się do „istotny – nieistotny”, a to nie mówi, jak duży jest efekt ani jak precyzyjnie go oszacowano. Cumming (2014) postuluje przejście od testowania istotności do estymacji: wielkości efektów, przedziałów ufności i metaanalizy.
Jak zapobiec. Przy każdym wyniku głównym podaj wielkość efektu w jednostkach surowych (różnica średnich, b) i standaryzowanych (d, β, η²p) z 95% przedziałem ufności. Napisz, której miary użyto, i oceń jej znaczenie praktyczne (zob. wielkość efektu – interpretacja). Gotowe zdania znajdziesz w poradniku jak opisać wyniki w stylu APA.
Gdy uwaga już padła, dodaj efekty i CI i wskaż miejsce zmiany – zob. zasady dobrej odpowiedzi.
5. Dychotomizacja zmiennych ciągłych
Przykładowa uwaga recenzenta: „Why were depressive symptoms split at the median? Dichotomisation discards information and reduces power. Please analyse the variable as continuous.”
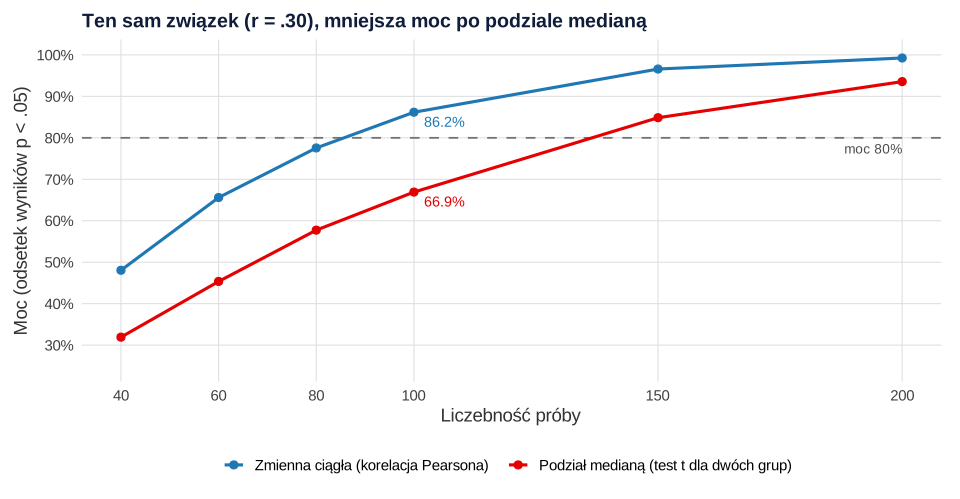
Skąd się bierze. Podział na grupę „niską” i „wysoką” upraszcza opis i pozwala użyć ANOVA. MacCallum i in. (2002) uznali jednak, że dychotomizacja zmiennych ilościowych rzadko jest uzasadniona i często prowadzi do mylących wyników. Babyak (2004) zalicza ją do praktyk, które niosą duże ryzyko wyników pozornych. Nasza symulacja pokazuje koszt w mocy. Przy prawdziwej korelacji r = .30 podział predyktora medianą obniżył średnią korelację do około .24, a moc przy 100 osobach – z 86.2% do 66.9% (rysunek 2). Do mocy 80% potrzeba wtedy 134 osób zamiast 85.
Jak zapobiec. Analizuj zmienną ciągłą, a zależność nieliniową modeluj wprost (zob. regresja krzywoliniowa). Kategorie kliniczne pokaż opisowo albo jako analizę dodatkową z uzasadnionym progiem. Kiedy zmienna naprawdę jest dwuwartościowa, wyjaśnia hasło skala dychotomiczna.
Gdy uwaga już padła, powtórz analizę na zmiennej ciągłej i pokaż oba wyniki – zob. zasady dobrej odpowiedzi.
6. „Istotny w jednej grupie, nieistotny w drugiej”
Przykładowa uwaga recenzenta: „The authors conclude that the intervention worked for women but not for men because the effect was significant only in women. This conclusion requires a test of the sex × condition interaction.”
Skąd się bierze. Dwa osobne testy kuszą prostym wnioskiem. Gelman i Stern (2006) pokazują jednak, że nawet duża różnica wartości p może odpowiadać małej, nieistotnej różnicy samych efektów. Greenland i in. (2016) dodają, że wyniki po przeciwnych stronach progu .05 nie muszą być sprzeczne, a nakładające się przedziały ufności nie dowodzą braku różnicy. Różnicę trzeba testować bezpośrednio.
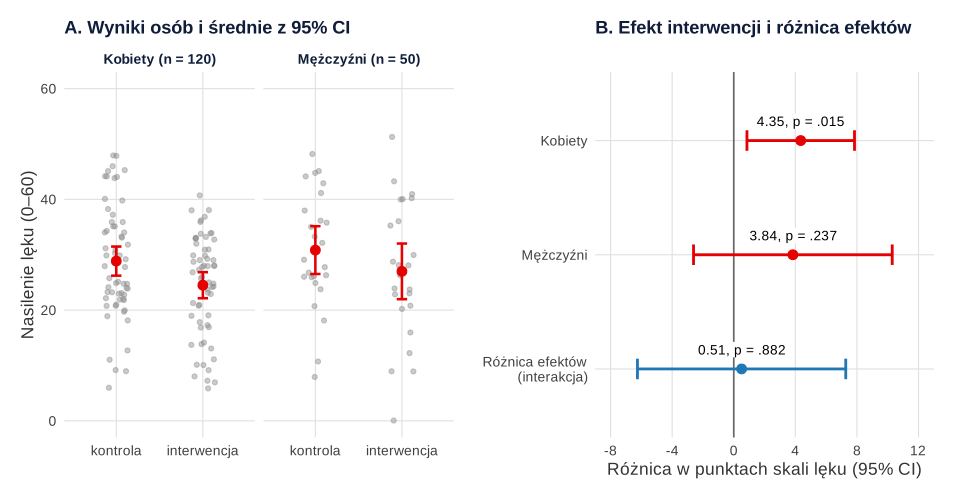
Przykład (dane symulowane): interwencja ma w populacji taki sam efekt u kobiet i mężczyzn (d = 0.45), ale kobiet jest w badaniu więcej. U kobiet spadek lęku wyniósł 4.35 punktu, 95% CI [0.86, 7.84], p = .015, a u mężczyzn 3.84 punktu, 95% CI [−2.61, 10.29], p = .237. Różnica efektów (interakcja) wynosi tylko 0.51 punktu, 95% CI [−6.25, 7.27], p = .882 (rysunek 3). Przy takich liczebnościach moc wynosi 68.6% u kobiet i 34.4% u mężczyzn. W 55.8% podobnych badań jedna grupa da więc wynik istotny, a druga nie, mimo identycznego efektu.
Jak zapobiec. Porównania grup testuj w jednym modelu z interakcją i podawaj różnicę efektów z przedziałem ufności (zob. analiza moderacji krok po kroku). Analizy podgrup zaplanuj z góry, z liczebnością wystarczającą do wykrycia interakcji. Opis wyniku z przykładu:
Gdy uwaga już padła, dodaj test interakcji i przeredaguj wniosek – zob. zasady dobrej odpowiedzi.
7. Język przyczynowy w badaniu korelacyjnym
Przykładowa uwaga recenzenta: „The study is cross-sectional, yet the Discussion states that social support ‘reduces’ burnout and that workload ‘leads to’ exhaustion. Please revise the causal language.”
Skąd się bierze. Makin i Orban de Xivry (2019) nazywają mylenie korelacji z przyczynowością być może najstarszym i najczęstszym błędem interpretacji wyników. Język przyczynowy jest według nich uprawniony tylko wtedy, gdy zmienną precyzyjnie manipulowano. Grosz i in. (2020) zwracają uwagę na drugą stronę problemu: autorzy unikają jawnych pytań przyczynowych, a mimo to interpretują wyniki przyczynowo, nie wypowiadając założeń.
Jak zapobiec. Przy schemacie korelacyjnym pisz o związkach. Jeśli celem jest pytanie przyczynowe, postaw je jawnie i wypisz założenia: zmienne zakłócające, kierunek zależności i ograniczenia. Sprawdź tytuł, abstrakt i implikacje praktyczne, a nie tylko wyniki. Tabelę czasowników dopuszczalnych przy różnych schematach znajdziesz we wpisie jak napisać dyskusję wyników.
Gdy uwaga już padła, zob. wzór odpowiedzi o języku przyczynowym.
8. Braki danych bez opisu
Przykładowa uwaga recenzenta: „The number of participants differs between tables (N = 312 in Table 1, N = 274 in Table 3), but missing data are not described. Please report the amount and pattern of missingness and justify the method.”
Skąd się bierze. Programy domyślnie usuwają osoby z brakami, więc liczebność „sama” spada z analizy na analizę. Schafer i Graham (2002) – poza nielicznymi wyjątkami – odradzają starsze, doraźne metody postępowania z brakami. Zalecają estymację metodą największej wiarygodności albo imputację wielokrotną.
Jak zapobiec. Podaj odsetek braków w każdej zmiennej i liczebność na każdym etapie. Opisz, co wiadomo o mechanizmie braków (MCAR, MAR, MNAR), i użyj FIML albo imputacji wielokrotnej z analizą wrażliwości (zob. braki danych i imputacja wielokrotna w R).
Gdy uwaga już padła, zob. wzór odpowiedzi o brakach danych.
9. Wartości odstające
Przykładowa uwaga recenzenta: „The scatterplot suggests that a few extreme observations may drive the correlation. Were outliers removed? Please report a sensitivity analysis.”
Skąd się bierze. Makin i Orban de Xivry (2019) pokazują, że jedna obserwacja odstająca potrafi wytworzyć pozorną korelację Pearsona. Zalecają metody odporne, a recenzentom radzą zwracać uwagę na korelacje podane bez wykresu rozrzutu. Problemem bywa też decyzja podjęta po obejrzeniu wyników. Simmons i in. (2011) wykazali, że nieujawniona elastyczność w analizie danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych.
Jak zapobiec. Regułę wykrywania i postępowania zapisz przed analizą, licz ją na całej próbie, pokaż wykresy i podaj wyniki z obserwacjami odstającymi i bez nich. Procedurę krok po kroku opisujemy we wpisie wartości odstające – jak je wykryć.
Gdy uwaga już padła, zob. wzór odpowiedzi o wartościach odstających.
10. Dobór krokowy i przeuczenie modelu
Przykładowa uwaga recenzenta: „Predictors were selected with a stepwise procedure, which is known to produce biased coefficients and models that do not replicate. Please justify the model.”
Skąd się bierze. Gdy kandydatów na predyktory jest wiele, kusi, by wybór zostawić programowi. Babyak (2004) wyjaśnia, że model zbyt złożony w stosunku do liczby obserwacji dopasowuje się do przypadkowych cech próby i nie replikuje się w nowych danych. Automatyczny dobór zmiennych zalicza do praktyk o dużym ryzyku wyników pozornych. W naszej symulacji 100 osób miało 20 predyktorów niezwiązanych z wynikiem. Test F pełnego modelu był istotny w 5.0% prób, zgodnie z poziomem α. Po eliminacji wstecznej końcowy model zawierał jednak co najmniej jeden „istotny” predyktor w 75.2% prób, a średnie R² wyniosło .13.
Jak zapobiec. Zbuduj model na podstawie teorii, dopasuj liczbę predyktorów do liczebności i raportuj wszystkie rozważane zmienne. Jeśli celem jest predykcja, użyj walidacji krzyżowej oraz metod ściągania i penalizacji – te ostatnie Babyak (2004) wymienia jako zabezpieczenie przed przeuczeniem. Wady metody krokowej i alternatywy omawiamy we wpisie regresja wieloraka krok po kroku.
Gdy uwaga już padła, uzasadnij model teoretycznie i pokaż wynik modelu pełnego – zob. zasady dobrej odpowiedzi.
11. Błąd wspólnej metody, trafność i inwariancja
Przykładowa uwaga recenzenta: „All measures are self-reported at one time point, so common method variance may inflate the associations. Moreover, women and men are compared on latent means without testing measurement invariance.”
Skąd się bierze. Ankieta wypełniana jednorazowo przez te same osoby to tani i popularny schemat badania, a zarazem typowe źródło tej uwagi. Autorzy często odpowiadają testem jednego czynnika Harmana. Aguirre-Urreta i Hu (2019) wykazali jednak w symulacjach, że ten test ma ograniczoną zdolność wykrywania efektów wspólnej metody i może dawać fałszywe poczucie bezpieczeństwa. Druga część uwagi dotyczy trafności: porównanie średnich między grupami ma sens tylko wtedy, gdy narzędzie mierzy w nich to samo.
Jak zapobiec. Zaplanuj zabezpieczenia w schemacie badania: pomiar w dwóch terminach, różne źródła danych, anonimowość, różne formaty odpowiedzi. Opisz dowody trafności narzędzi, a przed porównaniem grup sprawdź inwariancję pomiaru (zob. inwariancja pomiaru krok po kroku).
Gdy uwaga już padła, zob. wzory odpowiedzi o CMV i teście Harmana oraz o inwariancji pomiaru.
12. Dane zagnieżdżone traktowane jak niezależne
Przykładowa uwaga recenzenta: „Pupils are nested within classrooms, and the intervention was assigned at the classroom level. Treating pupils as independent observations underestimates standard errors. Please use a multilevel model.”
Skąd się bierze. Aarts i in. (2014) znaleźli dane zagnieżdżone w 53% z 314 przejrzanych artykułów. Pokazali, że ignorowanie zależności obserwacji może podnieść odsetek fałszywie istotnych wyników z 5% nawet do 80%. Makin i Orban de Xivry (2019) nazywają ten błąd zawyżaniem liczby jednostek analizy. W naszej symulacji interwencję przydzielano 20 klasom po 25 uczniów i w populacji nie miała ona żadnego efektu. Zwykły test t na 500 uczniach dawał wynik istotny w 18.1% prób przy ICC = .05 i w 29.0% przy ICC = .10. Test na średnich klas – w 4.8% i 5.1%.
Jak zapobiec. Ustal jednostkę przydziału i analizy, policz ICC i użyj modelu wielopoziomowego. Liczebność planuj w klasach, a nie w uczniach (przykład z ICC i efektem schematu w pracy dyplomowej znajdziesz w poradniku statystyka w pracy z pedagogiki). Przy pomiarach powtarzanych zob. ANOVA z powtarzanymi pomiarami czy model mieszany.
Gdy uwaga już padła, zob. wzór odpowiedzi o modelu mieszanym.
13. p-hacking, HARKing i odstępstwa od prerejestracji
Przykładowa uwaga recenzenta: „Hypothesis 3 does not appear in the preregistration, and the exclusion criteria differ from those registered. Please clarify which analyses were planned and which were exploratory.”
Skąd się bierze. Simmons i in. (2011) pokazali, że elastyczność w zbieraniu, analizie i raportowaniu danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Makin i Orban de Xivry (2019) wymieniają jej typowe formy: zamianę zmiennych wynikowych, dodawanie kowariantów i wykluczanie osób po fakcie. Radzą recenzentom porównywać analizy z prerejestracją. Hipoteza dopisana po poznaniu wyników to HARKing, a wybieranie analizy, która „wychodzi”, to p-hacking.
Jak zapobiec. Zapisz hipotezy i plan analizy przed zebraniem danych (zob. plan analizy statystycznej i prerejestracja). Analizy nieplanowane oznacz jako eksploracyjne, a każde odstępstwo od planu opisz w tabeli z uzasadnieniem.
Gdy uwaga już padła, wyjaśnij rozbieżności wprost i przenieś analizy nieplanowane do części eksploracyjnej – zob. zasady dobrej odpowiedzi.
14. Niespójne liczby
Przykładowa uwaga recenzenta: „Several statistics appear inconsistent: t(58) = 1.85 cannot correspond to p = .03 (two-tailed), and the degrees of freedom in Table 2 do not match the reported sample size.”
Skąd się bierze. Liczby przepisuje się ręcznie z wydruku do tekstu i tabel. Nuijten i in. (2016) sprawdzili pakietem statcheck ponad 250 tysięcy wartości p z ośmiu czasopism psychologicznych. W połowie artykułów co najmniej jedna wartość p nie zgadzała się ze statystyką testu i stopniami swobody, a w co ósmym niezgodność mogła zmienić wniosek. Takie rażące niezgodności częściej dotyczyły wyników podanych jako istotne.
Jak zapobiec. Tabele i liczby w tekście generuj z kodu i sprawdź, czy stopnie swobody pasują do liczebności. Przelicz wartości p ze statystyk testu – autorzy proponują użycie statcheck we własnym rękopisie. Nasza prosta funkcja w R wykryła, że t(58) = 1.85 odpowiada p = .069, a nie .03, a χ²(1) = 3.10 daje p = .078, a nie .042. W obu przypadkach zmienia się decyzja przy α = .05. Zasady zapisu wyników opisujemy we wpisie jak opisać wyniki w stylu APA.
Gdy uwaga już padła, przyznaj błąd i popraw wszystkie miejsca – zob. wzór odpowiedzi z przyznaniem się do błędu.
15. Brak danych i kodu
Przykładowa uwaga recenzenta: „The data and analysis code are not available. In line with the journal’s policy, please deposit them in a public repository or explain the restrictions.”
Skąd się bierze. Formuła „dane dostępne na prośbę” często nie działa. Wicherts i in. (2006) poprosili autorów 141 artykułów z czasopism APA o dane do ponownej analizy. Po pół roku i ponad 400 e-mailach 73% autorów danych nie udostępniło.
Jak zapobiec. Przygotuj dane, książkę kodową i skrypt odtwarzający wszystkie wyniki jeszcze przed wysłaniem tekstu (zob. pakiet replikacyjny – dane i kod do artykułu i hasło open science). Napisz deklarację dostępności danych, a jeśli danych nie wolno udostępnić, wyjaśnij dlaczego.
Gdy uwaga już padła, zob. wzór odpowiedzi o udostępnieniu danych i kodu.
Symulacje w R
Siedem przepisów odtwarza wszystkie liczby z tekstu i rysunków. Każdy działa samodzielnie; przepisy 2–4 zapisują też wyniki potrzebne do rysunków (pliki .rds). Symulacje z przepisów 2, 3, 5 i 6 trwają od kilku sekund do około minuty.
1. Analiza wrażliwości i „moc obserwowana”
R
# Analiza wrażliwości zamiast „mocy post hoc” (B33, zarzut 1)
# 1) jaki najmniejszy efekt badanie wykrywa z mocą 80%, 2) moc obserwowana to tylko przekształcenie p

# a) dwie grupy po 40 osób, test t dwustronny, alfa = .05
power.t.test(n = 40, power = .80, sig.level = .05)$delta          # najmniejsze d (SD = 1)

# b) korelacja, n = 120 (przybliżenie Fishera)
n <- 120
round(tanh((qnorm(.975) + qnorm(.80)) / sqrt(n - 3)), 3)          # najmniejsze r

# c) „moc obserwowana” testu z dwustronnego wyznaczona z samej wartości p
moc_obserwowana <- function(p, alfa = .05) {
  z <- qnorm(1 - p / 2); kr <- qnorm(1 - alfa / 2)
  pnorm(z - kr) + pnorm(-z - kr)
}
p <- c(.01, .05, .10, .20, .50)
round(data.frame(p, moc_obserwowana = moc_obserwowana(p)), 3)
Wynik w R
[1] 0.634299
[1] 0.253
     p moc_obserwowana
1 0.01           0.731
2 0.05           0.500
3 0.10           0.376
4 0.20           0.249
5 0.50           0.104
2. Wielokrotne porównania: ryzyko fałszywego alarmu i korekta Holma
R
# Wielokrotne porównania: prawdopodobieństwo co najmniej jednego fałszywego alarmu (FWER) (B33, zarzut 2)
alfa <- .05
m <- c(1, 3, 5, 10, 20)
round(100 * (1 - (1 - alfa)^m), 1)            # m niezależnych testów, wszystkie H0 prawdziwe
round(100 * (1 - (1 - alfa)^7), 1)            # ANOVA 2 × 3 × 3: 3 efekty główne + 4 interakcje

# Symulacja: dwie grupy po 50 osób, 20 wskaźników skorelowanych r = .50, brak prawdziwych różnic
library(MASS)
set.seed(33)
R <- 10000; k <- 20; n <- 50
S <- matrix(.5, k, k); diag(S) <- 1
p_min <- matrix(NA, R, k)                     # najmniejsze p wśród pierwszych m wskaźników
for (i in 1:R) {
  a <- mvrnorm(n, rep(0, k), S); b <- mvrnorm(n, rep(0, k), S)
  t <- (colMeans(a) - colMeans(b)) / sqrt((apply(a, 2, var) + apply(b, 2, var)) / n)
  p <- 2 * pt(-abs(t), df = 2 * n - 2)
  p_min[i, ] <- cummin(p)
}
wynik <- data.frame(m = 1:k,
                    bez_korekty = 100 * colMeans(p_min < alfa),
                    holm = 100 * colMeans(sweep(p_min, 2, alfa / (1:k), "<")))  # Holm: coś odrzuca ⇔ min p < alfa/m
round(wynik[m, ], 1)
saveRDS(wynik, "fwer-symulacja.rds")
Wynik w R
[1]  5.0 14.3 22.6 40.1 64.2
[1] 30.2
    m bez_korekty holm
1   1         4.9  4.9
3   3        12.1  4.4
5   5        17.9  4.1
10 10        28.1  3.9
20 20        41.0  3.5
3. Dychotomizacja: moc przy podziale medianą
R
# Dychotomizacja: podział predyktora medianą a moc testu (B33, zarzut 5)
# Prawdziwa korelacja w populacji r = .30; porównujemy test korelacji Pearsona
# z testem t dla grup „niskich” i „wysokich” po podziale medianą.
set.seed(330)
symuluj <- function(n, r = .30, R = 5000) {
  wyn <- replicate(R, {
    x <- rnorm(n); y <- r * x + sqrt(1 - r^2) * rnorm(n)
    grupa <- x > median(x)
    c(ciagla = cor.test(x, y)$p.value < .05,
      mediana = t.test(y ~ grupa, var.equal = TRUE)$p.value < .05,
      r_ciagla = cor(x, y), r_mediana = cor(grupa, y))
  })
  rowMeans(wyn)
}
n <- c(40, 60, 80, 100, 150, 200)
moc <- t(sapply(n, symuluj))
wynik <- data.frame(n, moc_ciagla = 100 * moc[, "ciagla"], moc_mediana = 100 * moc[, "mediana"],
                    r_ciagla = moc[, "r_ciagla"], r_mediana = moc[, "r_mediana"])
print(data.frame(n, moc_ciagla = round(wynik$moc_ciagla, 1), moc_mediana = round(wynik$moc_mediana, 1),
                 r_ciagla = round(wynik$r_ciagla, 3), r_mediana = round(wynik$r_mediana, 3)))
saveRDS(wynik, "dychotomizacja-symulacja.rds")

# Liczebność potrzebna do mocy 80% (alfa = .05): korelacja ciągła a podział medianą
ceiling(((qnorm(.975) + qnorm(.80)) / atanh(.30))^2 + 3)          # zmienna ciągła
r_pb <- mean(wynik$r_mediana)                                       # korelacja po podziale medianą
d <- 2 * r_pb / sqrt(1 - r_pb^2)
2 * ceiling(power.t.test(delta = d, power = .80)$n)                 # dwie grupy po podziale
Wynik w R
    n moc_ciagla moc_mediana r_ciagla r_mediana
1  40       48.1        31.9    0.298     0.236
2  60       65.6        45.4    0.299     0.237
3  80       77.6        57.7    0.298     0.237
4 100       86.2        66.9    0.296     0.235
5 150       96.6        84.9    0.301     0.239
6 200       99.3        93.6    0.301     0.240
[1] 85
[1] 134
4. Istotny u kobiet, nieistotny u mężczyzn – test interakcji
R
# „Istotny u kobiet, nieistotny u mężczyzn” – błąd porównywania istotności (B33, zarzut 6)
# Dane symulowane: ten sam prawdziwy efekt interwencji (d = 0.45) u kobiet i mężczyzn,
# nasilenie lęku na skali 0–60 (im mniej, tym lepiej); 60 kobiet i 25 mężczyzn w każdym warunku.
set.seed(87)
nk <- 60; nm <- 25
dane <- data.frame(
  plec    = rep(c("kobiety", "mężczyźni"), c(2 * nk, 2 * nm)),
  warunek = c(rep(c("kontrola", "interwencja"), each = nk), rep(c("kontrola", "interwencja"), each = nm)))
dane$lek <- round(pmin(60, pmax(0, rnorm(nrow(dane), ifelse(dane$warunek == "interwencja", 25.5, 30), 10))))
dane$warunek <- factor(dane$warunek, levels = c("kontrola", "interwencja"))

efekt <- function(d) {                       # różnica: kontrola minus interwencja
  tt <- t.test(lek ~ warunek, data = d, var.equal = TRUE)
  sp <- sqrt(((nrow(d) / 2 - 1) * sum(tapply(d$lek, d$warunek, var))) / (nrow(d) - 2))
  round(c(roznica = unname(-diff(tt$estimate)), CI_d = tt$conf.int[1], CI_g = tt$conf.int[2],
          t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value,
          d = unname(-diff(tt$estimate)) / sp), 3)
}
rbind(kobiety = efekt(subset(dane, plec == "kobiety")),
      mezczyzni = efekt(subset(dane, plec == "mężczyźni")))

# Właściwy test: interakcja warunek × płeć (czy efekt interwencji różni się między grupami?)
model <- lm(lek ~ warunek * plec, data = dane)
interakcja <- cbind(summary(model)$coefficients, confint(model))["warunekinterwencja:plecmężczyźni", ]
round(interakcja, 3)          # różnica efektów (mężczyźni minus kobiety) z 95% CI

# Jak często przy identycznym efekcie jedna grupa da p < .05, a druga nie?
moc_k <- power.t.test(n = nk, delta = .45)$power
moc_m <- power.t.test(n = nm, delta = .45)$power
round(c(moc_kobiety = moc_k, moc_mezczyzni = moc_m,
        rozbiezne_wyniki = moc_k * (1 - moc_m) + moc_m * (1 - moc_k)), 3)
saveRDS(dane, "roznica-istotnosci-dane.rds")
Wynik w R
          roznica   CI_d   CI_g     t  df     p     d
kobiety      4.35  0.857  7.843 2.466 118 0.015 0.450
mezczyzni    3.84 -2.613 10.293 1.197  48 0.237 0.338
  Estimate Std. Error    t value   Pr(>|t|)      2.5 %     97.5 %
     0.510      3.426      0.149      0.882     -6.254      7.274
     moc_kobiety    moc_mezczyzni rozbiezne_wyniki
           0.686            0.344            0.558
5. Dane zagnieżdżone: test na uczniach i na klasach
R
# Dane zagnieżdżone: interwencja przydzielana całym klasom, analiza na poziomie uczniów (B33, zarzut 12)
# 20 klas (10 w każdym warunku) po 25 uczniów, brak prawdziwego efektu, ICC = .05 albo .10
set.seed(1212)
symuluj <- function(icc, R = 10000, klas = 10, uczniow = 25) {
  wyn <- replicate(R, {
    klasa <- rep(1:(2 * klas), each = uczniow)
    warunek <- rep(0:1, each = klas * uczniow)
    y <- rnorm(2 * klas, 0, sqrt(icc))[klasa] + rnorm(2 * klas * uczniow, 0, sqrt(1 - icc))
    srednie <- tapply(y, klasa, mean)
    c(uczniowie = t.test(y ~ warunek, var.equal = TRUE)$p.value < .05,             # błędnie: N = 500
      klasy = t.test(srednie ~ rep(0:1, each = klas), var.equal = TRUE)$p.value < .05)  # poprawnie: N = 20
  })
  100 * rowMeans(wyn)
}
round(rbind("ICC = .05" = symuluj(.05), "ICC = .10" = symuluj(.10)), 1)   # % fałszywych alarmów
round(1 + (25 - 1) * c(.05, .10), 2)                                       # efekt schematu (design effect)
Wynik w R
          uczniowie klasy
ICC = .05      18.1   4.8
ICC = .10      29.0   5.1
[1] 2.2 3.4
6. Dobór krokowy na samym szumie
R
# Dobór krokowy na samym szumie: 20 predyktorów niezwiązanych z wynikiem, n = 100 (B33, zarzut 10)
set.seed(1010)
R <- 1000; n <- 100; k <- 20
wyn <- t(replicate(R, {
  dane <- as.data.frame(matrix(rnorm(n * (k + 1)), n, k + 1))
  names(dane) <- c("y", paste0("x", 1:k))
  pelny <- lm(y ~ ., data = dane)
  koncowy <- step(pelny, direction = "backward", trace = 0)         # eliminacja wsteczna według AIC
  wsp <- summary(koncowy)$coefficients[-1, , drop = FALSE]
  f <- summary(pelny)$fstatistic
  c(p_pelny = unname(pf(f[1], f[2], f[3], lower.tail = FALSE)),     # test F modelu z wszystkimi 20
    zostalo = nrow(wsp),
    istotnych = sum(wsp[, 4] < .05),
    R2 = summary(koncowy)$r.squared)
}))
round(c(model_pelny_istotny = 100 * mean(wyn[, "p_pelny"] < .05),
        koncowy_ma_istotny_predyktor = 100 * mean(wyn[, "istotnych"] >= 1),
        srednio_predyktorow = mean(wyn[, "zostalo"]),
        srednio_istotnych = mean(wyn[, "istotnych"]),
        sredni_R2_koncowy = mean(wyn[, "R2"])), 2)
Wynik w R
         model_pelny_istotny koncowy_ma_istotny_predyktor
                        5.00                        75.20
         srednio_predyktorow            srednio_istotnych
                        4.00                         1.47
           sredni_R2_koncowy
                        0.13
7. Czy wartość p zgadza się ze statystyką testu?
R
# Czy p zgadza się ze statystyką testu i stopniami swobody? (B33, zarzut 14)
# Prosta kontrola w duchu statcheck: przelicz p z t, F, r lub χ² (dwustronnie), z uwzględnieniem
# zaokrąglenia statystyki do dwóch miejsc, i oznacz niespójności oraz zmianę decyzji przy alfa = .05.
p_z_testu <- function(test, wartosc, df1, df2 = NA) {
  switch(test,
         t    = 2 * pt(-abs(wartosc), df1),
         F    = pf(wartosc, df1, df2, lower.tail = FALSE),
         r    = 2 * pt(-abs(wartosc * sqrt(df1 / (1 - wartosc^2))), df1),
         chi2 = pchisq(wartosc, df1, lower.tail = FALSE))
}
sprawdz <- function(test, wartosc, df1, df2 = NA, p_podane) {
  zakres <- sort(sapply(wartosc + c(-.005, .005), function(w) p_z_testu(test, w, df1, df2)))
  spojne <- p_podane >= zakres[1] - .0005 & p_podane <= zakres[2] + .0005
  p <- p_z_testu(test, wartosc, df1, df2)
  data.frame(test, wartosc, df1, df2, p_podane, p_przeliczone = round(p, 3),
             spojne, zmiana_decyzji = (p_podane < .05) != (p < .05))
}
# Wyniki „z rękopisu” (przykład ilustracyjny)
do.call(rbind, list(
  sprawdz("t",    1.85, 58,      p_podane = .030),
  sprawdz("F",    3.20, 2, 117,  p_podane = .044),
  sprawdz("r",    0.21, 98,      p_podane = .036),
  sprawdz("chi2", 3.10, 1,       p_podane = .042),
  sprawdz("t",    2.10, 45,      p_podane = .041)))

# Stopnie swobody a liczebność: test t dla dwóch grup po 31 osób powinien mieć df = 60
31 + 31 - 2
Wynik w R
  test wartosc df1 df2 p_podane p_przeliczone spojne zmiana_decyzji
1    t    1.85  58  NA    0.030         0.069  FALSE           TRUE
2    F    3.20   2 117    0.044         0.044   TRUE          FALSE
3    r    0.21  98  NA    0.036         0.036   TRUE          FALSE
4 chi2    3.10   1  NA    0.042         0.078  FALSE           TRUE
5    t    2.10  45  NA    0.041         0.041   TRUE          FALSE
[1] 60
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Lista kontrolna przed wysłaniem artykułu
- Metoda wyjaśnia, skąd wzięła się liczebność (analiza mocy a priori albo analiza wrażliwości); nie ma mocy post hoc.
- Rodzina testów i korekta są opisane; wszystkie wykonane testy są raportowane.
- Opisano wybór testów i sprawdzenie założeń; tam, gdzie to sensowne, użyto procedur odpornych.
- Każdy wynik główny ma wielkość efektu z 95% CI.
- Zmienne ciągłe nie są dzielone na grupy bez uzasadnienia.
- Różnice między grupami lub efektami są testowane bezpośrednio.
- Czasowniki w tytule, abstrakcie i dyskusji odpowiadają schematowi badania.
- Braki danych i wykluczenia opisano liczbowo; liczebność zgadza się we wszystkich tabelach.
- Reguła dla wartości odstających była ustalona z góry; jest analiza wrażliwości.
- Model regresji wynika z teorii, a nie z doboru krokowego.
- Opisano zabezpieczenia przed błędem wspólnej metody i sprawdzono inwariancję przed porównaniem grup.
- Zagnieżdżenie danych uwzględniono w modelu.
- Analizy eksploracyjne są oznaczone, a odstępstwa od prerejestracji opisane.
- Wartości p przeliczono ze statystyk testu, a tabele pochodzą z kodu.
- Dane i kod są gotowe do udostępnienia razem z deklaracją dostępności.
Jeśli chcesz, żeby ktoś niezależny sprawdził analizy i tabele przed wysłaniem albo potrzebujesz dodatkowych obliczeń po recenzji, zajrzyj do oferty analizy statystyczne dla badaczy. Za wnioski odpowiadają autorzy, więc każdą analizę trzeba rozumieć i umieć obronić. Jak zaplanować analizy w rozprawie złożonej z kilku artykułów, opisujemy we wpisie analiza statystyczna w doktoracie.
Najczęstsze pytania
Jakie błędy statystyczne najczęściej wytykają recenzenci?
Najczęściej: brak uzasadnienia liczebności, wiele testów bez korekty, wybór testu bez sprawdzenia założeń, brak wielkości efektu z przedziałami ufności, dzielenie zmiennych ciągłych na grupy, wnioskowanie o różnicy z tego, że jeden efekt jest istotny, a drugi nie, język przyczynowy w badaniu korelacyjnym, nieopisane braki danych, wartości odstające, dobór krokowy, ignorowanie zagnieżdżenia danych i niespójne liczby. Wiele z nich Makin i Orban de Xivry (2019) opisują jako błędy dobrze znane, a mimo to wciąż obecne w publikacjach.
Dlaczego recenzenci krytykują podział zmiennej na grupy medianą?
Bo podział medianą odrzuca informację, obniża moc i może dawać mylące wyniki – MacCallum i in. (2002) uznali, że taka dychotomizacja rzadko jest uzasadniona. W symulacji z tego wpisu przy korelacji r = .30 i 100 osobach moc spadła z 86.2% do 66.9%. Lepiej analizować zmienną ciągłą, a kategorie pokazać opisowo.
Czy w artykule trzeba stosować korektę na wielokrotne porównania?
Tak, gdy kilka testów sprawdza jedną hipotezę lub rodzinę hipotez – bez korekty szansa co najmniej jednego fałszywego alarmu przy 10 niezależnych testach wynosi 40.1%. Rodzinę testów i sposób korekty (np. procedurę Holma) ustal przed analizą, a analizy eksploracyjne oznacz jako takie i raportuj liczbę wszystkich testów.
Jak sprawdzić statystykę w artykule przed wysłaniem do czasopisma?
Przejdź listę kontrolną z tego wpisu: uzasadnienie liczebności, korekta porównań, założenia testów, wielkości efektu z CI, język przyczynowy, braki danych i wartości odstające. Przelicz wartości p ze statystyk testu i stopni swobody – Nuijten i in. (2016) proponują do tego pakiet statcheck – a tabele generuj z kodu, który udostępnisz razem z danymi.
Czy test Harmana wystarczy, żeby wykluczyć błąd wspólnej metody?
Nie. Aguirre-Urreta i Hu (2019) wykazali w symulacjach, że test jednego czynnika Harmana słabo wykrywa efekty wspólnej metody i może dawać fałszywe poczucie bezpieczeństwa. Lepiej zaplanować zabezpieczenia w schemacie badania (np. pomiar w dwóch terminach, różne źródła danych) i uczciwie opisać ograniczenie.
Powiązane hasła
Przeczytaj też
Odpowiedź recenzentom – wzory PL i EN
Zasady i struktura odpowiedzi oraz wzory PL/EN na 12 sytuacji: moc post hoc, korekta porównań, model mieszany, braki danych, CMV i przyznanie się do błędu.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikAnaliza statystyczna w doktoracie
Seria badań z uzasadnioną liczebnością, harmonogram zgodny z IPB i oceną śródokresową, cykl publikacji bez salami slicing, dane, etyka i autorstwo.
Czytaj →Chcesz sprawdzić analizy przed wysłaniem artykułu?
Przejrzymy plan analiz, wyniki i tabele pod kątem typowych zarzutów recenzentów, wyjaśnimy wątpliwości i wykonamy potrzebne obliczenia uzupełniające.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Aarts, E., Verhage, M., Veenvliet, J. V., Dolan, C. V., & van der Sluis, S. (2014). A solution to dependency: Using multilevel analysis to accommodate nested data. Nature Neuroscience, 17(4), 491–496. https://doi.org/10.1038/nn.3648
- Aguirre-Urreta, M. I., & Hu, J. (2019). Detecting common method bias: Performance of the Harman's single-factor test. ACM SIGMIS Database: The DATABASE for Advances in Information Systems, 50(2), 45–70. https://doi.org/10.1145/3330472.3330477
- Babyak, M. A. (2004). What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models. Psychosomatic Medicine, 66(3), 411–421. https://doi.org/10.1097/01.psy.0000127692.23278.a9 ● Otwarty dostęp
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3 ● Otwarty dostęp
- Grosz, M. P., Rohrer, J. M., & Thoemmes, F. (2020). The taboo against explicit causal inference in nonexperimental psychology. Perspectives on Psychological Science, 15(5), 1243–1255. https://doi.org/10.1177/1745691620921521 ● Otwarty dostęp
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- Makin, T. R., & Orban de Xivry, J.-J. (2019). Ten common statistical mistakes to watch out for when writing or reviewing a manuscript. eLife, 8, Article e48175. https://doi.org/10.7554/elife.48175 ● Otwarty dostęp
- Nuijten, M. B., Hartgerink, C. H. J., van Assen, M. A. L. M., Epskamp, S., & Wicherts, J. M. (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods, 48(4), 1205–1226. https://doi.org/10.3758/s13428-015-0664-2 ● Otwarty dostęp
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Wicherts, J. M., Borsboom, D., Kats, J., & Molenaar, D. (2006). The poor availability of psychological research data for reanalysis. American Psychologist, 61(7), 726–728. https://doi.org/10.1037/0003-066x.61.7.726
Cytowania BibTeX
@article{aarts2014solution, author={Aarts, Emmeke and Verhage, Matthijs and Veenvliet, Jesse V. and Dolan, Conor V. and van der Sluis, Sophie}, title={{A solution to dependency: Using multilevel analysis to accommodate nested data}}, journal={Nature Neuroscience}, year={2014}, volume={17}, number={4}, pages={491--496}, doi={10.1038/nn.3648}}@article{aguirreurreta2019detecting, author={Aguirre-Urreta, Miguel I. and Hu, Jiang}, title={{Detecting common method bias: Performance of the Harman's single-factor test}}, journal={ACM SIGMIS Database: The DATABASE for Advances in Information Systems}, year={2019}, volume={50}, number={2}, pages={45--70}, doi={10.1145/3330472.3330477}}@article{babyak2004what, author={Babyak, Michael A.}, title={{What you see may not be what you get: A brief, nontechnical introduction to overfitting in regression-type models}}, journal={Psychosomatic Medicine}, year={2004}, volume={66}, number={3}, pages={411--421}, doi={10.1097/01.psy.0000127692.23278.a9}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{greenland2016statistical, author={Greenland, Sander and Senn, Stephen J. and Rothman, Kenneth J. and Carlin, John B. and Poole, Charles and Goodman, Steven N. and Altman, Douglas G.}, title={{Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations}}, journal={European Journal of Epidemiology}, year={2016}, volume={31}, number={4}, pages={337--350}, doi={10.1007/s10654-016-0149-3}}@article{grosz2020taboo, author={Grosz, Michael P. and Rohrer, Julia M. and Thoemmes, Felix}, title={{The taboo against explicit causal inference in nonexperimental psychology}}, journal={Perspectives on Psychological Science}, year={2020}, volume={15}, number={5}, pages={1243--1255}, doi={10.1177/1745691620921521}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{makin2019ten, author={Makin, Tamar R. and Orban de Xivry, Jean-Jacques}, title={{Ten common statistical mistakes to watch out for when writing or reviewing a manuscript}}, journal={eLife}, year={2019}, volume={8}, eid={e48175}, doi={10.7554/elife.48175}}@article{nuijten2016prevalence, author={Nuijten, Michèle B. and Hartgerink, Chris H. J. and van Assen, Marcel A. L. M. and Epskamp, Sacha and Wicherts, Jelte M.}, title={{The prevalence of statistical reporting errors in psychology (1985–2013)}}, journal={Behavior Research Methods}, year={2016}, volume={48}, number={4}, pages={1205--1226}, doi={10.3758/s13428-015-0664-2}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{wicherts2006poor, author={Wicherts, Jelte M. and Borsboom, Denny and Kats, Judith and Molenaar, Dylan}, title={{The poor availability of psychological research data for reanalysis}}, journal={American Psychologist}, year={2006}, volume={61}, number={7}, pages={726--728}, doi={10.1037/0003-066x.61.7.726}}