Co to jest p-hacking?
P-hacking to dobieranie danych albo sposobu analizy tak długo, aż wynik nieistotny stanie się istotny, i raportowanie tylko tej „udanej” wersji. Head i in. (2015) definiują go jako zbieranie lub wybieranie danych albo analiz statystycznych do momentu, w którym nieistotny wynik staje się istotny. Inne nazwy to data dredging, fishing i significance chasing, a po polsku – „łowienie istotności”.
P-hacking rzadko wygląda jak oszustwo. Zwykle składa się z drobnych, z osobna rozsądnych decyzji: „usunę tę osobę, bo odpowiadała podejrzanie szybko”, „sprawdzę jeszcze na drugiej skali”, „dobiorę kilka osób, bo grupa jest mała”. Problem polega na tym, że decyzje zapadają po obejrzeniu wyniku i w kierunku, który daje p < .05. Wtedy przestaje obowiązywać obietnica, na której opiera się NHST: że przy prawdziwej hipotezie zerowej wynik istotny pojawia się tylko w 5% badań.
John i in. (2012) zapytali ponad 2000 psychologów o udział w wątpliwych praktykach badawczych, stosując anonimową ankietę z zachętami do szczerości. Odsetek osób, które przyznały się do takich praktyk, okazał się zaskakująco wysoki. Autorzy uznali, że niektóre z tych praktyk mogą być w dziedzinie normą.
Najczęstsze formy p-hackingu
Wicherts i in. (2016) wymieniają 34 „stopnie swobody badacza” – decyzje podejmowane przy formułowaniu hipotez, planowaniu, prowadzeniu, analizie i raportowaniu badania. Każda z nich może posłużyć do p-hackingu, jeśli zapada pod wpływem wyniku. W pracach dyplomowych najczęściej spotyka się:
| Forma | Jak to wygląda w praktyce |
|---|---|
| Wiele zmiennych zależnych | Nastrój mierzono dwiema skalami; w pracy opisano tę, która dała istotny wynik. |
| Dobieranie osób (optional stopping) | Analiza po każdej kolejnej porcji ankiet i koniec zbierania danych, gdy p spadnie poniżej .05. |
| Elastyczne wykluczenia | Usuwanie obserwacji odstających tylko wtedy, gdy „pomaga” – albo raz według reguły 2 SD, raz 3 SD. |
| Kowarianty i podgrupy | Dodanie płci lub wieku do modelu albo analiza „tylko dla kobiet”, gdy wynik ogólny jest nieistotny. |
| Przekształcenia i kodowanie | Logarytm, podział na grupy według mediany, inne połączenie pozycji w wynik skali. |
| Zmiana testu | Przejście z testu dwustronnego na jednostronny albo z parametrycznego na nieparametryczny po zobaczeniu wyniku. |
P-hacking blisko łączy się z HARKingiem, ale to nie to samo. P-hacking dotyczy analizy – zmienia się ją, aż wynik „wyjdzie”. HARKing dotyczy hipotezy – dopisuje się ją do wyniku, który już wyszedł. Często występują razem.
Przykład: ile kosztuje elastyczność – symulacja
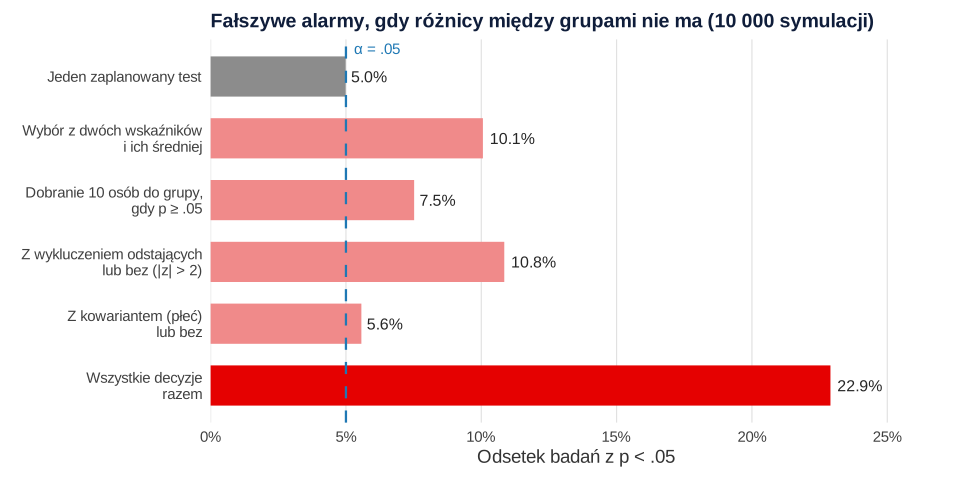
Simmons i in. (2011) pokazali w symulacjach i dwóch eksperymentach, że elastyczność w zbieraniu i analizie danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Ten mechanizm łatwo odtworzyć. W symulacji przeprowadzono 10 000 badań z dwiema grupami po 20 osób, w których różnicy między grupami nie ma. Mierzono dwa skorelowane wskaźniki nastroju (r = .50) i płeć. Dla każdej strategii za „sukces” uznawano badanie, w którym choć jedna z dopuszczonych wersji analizy dała p < .05.
Jak czytać wynik:
- Jeden zaplanowany test dał fałszywy alarm w 5.0% badań – tyle, ile obiecuje α.
- Wybór najlepszej z trzech wersji zmiennej zależnej (dwa wskaźniki i ich średnia) podwoił ten odsetek do 10.1%, a analiza z wykluczeniem wyników |z| > 2 albo bez niego – do 10.8%.
- Dobranie 10 osób do każdej grupy po nieistotnym wyniku dało 7.5%, a kowariant niezwiązany z grupą – tylko 5.6%. Nie każda decyzja szkodzi tak samo.
- Wszystkie decyzje razem – trzy wersje zmiennej zależnej, dwa momenty analizy, wykluczenia i kowariant – podniosły odsetek fałszywych alarmów do 22.9%. Prawie co czwarte badanie bez żadnego efektu kończyłoby się „potwierdzeniem hipotezy”.
Z rysunku wynika ważna lekcja. Do zawyżenia błędu nie potrzeba nieuczciwości – wystarczy kilka decyzji odłożonych do momentu, w którym widać wynik. Formalnie to ten sam mechanizm co w problemie wielokrotnych porównań. Różnica polega na tym, że porównania są ukryte i nikt ich nie koryguje.
Jak bardzo p-hacking zniekształca literaturę
Head i in. (2015) przeanalizowali metodą eksploracji tekstu wartości p z publikacji naukowych. Wnioskują, że p-hacking jest rozpowszechniony w wielu dziedzinach. Jednocześnie w analizowanych metaanalizach jego wpływ okazał się słaby w porównaniu z rzeczywistymi wielkościami efektów, więc prawdopodobnie nie zmienia drastycznie wniosków z metaanaliz. Dla pojedynczego badania – zwłaszcza małego, z wynikiem tuż poniżej .05 – ryzyko jest jednak znacznie większe niż w uśrednionej literaturze.
Jak się chronić przed p-hackingiem
- Zapisz plan przed danymi. Prerejestracja powinna określać główną zmienną zależną, liczebność i regułę zakończenia zbierania danych, reguły wykluczeń, kowarianty i test. Listę Wichertsa i in. (2016) wykorzystasz jako listę kontrolną do sprawdzenia, czy plan nie zostawia furtek.
- Ustal liczebność z góry – na podstawie analizy mocy a priori. Jeśli musisz analizować dane w trakcie, zaplanuj analizę sekwencyjną z korektą α.
- Raportuj wszystko: wszystkie mierzone zmienne, warunki, wykluczenia i ich liczbę, także analizy, które „nie wyszły”.
- Pokaż wrażliwość wyniku. Gdy istnieje kilka rozsądnych wersji analizy, pokaż wszystkie – w prostej analizie wrażliwości albo w analizie wieloświatowej (multiverse analysis). Steegen i in. (2016) proponują przeprowadzić analizę na wszystkich zbiorach danych wynikających z rozsądnych decyzji o wykluczeniach, przekształceniach i kodowaniu, by zobaczyć, jak bardzo wniosek zależy od arbitralnych wyborów.
- Oddziel konfirmację od eksploracji. Analizy wymyślone po obejrzeniu danych są dozwolone, ale opisz je w osobnej części jako eksploracyjne.
Jak recenzenci wyłapują ślady p-hackingu w rękopisach, opisuje wpis Zarzuty recenzentów do statystyki, a co zrobić z wynikiem nieistotnym bez „ratowania” go – Hipoteza się nie potwierdziła – co dalej.
Jak opisać decyzje analityczne w pracy
Najlepszą ochroną przed zarzutem p-hackingu jest akapit, który przed wynikami zdradza wszystkie decyzje. Przykład dla badania z dwiema skalami nastroju:
| Źle (elastyczność ukryta) | Dobrze (decyzje jawne) |
|---|---|
| „Grupy różniły się nastrojem, t(38) = 2.11, p = .041.” – bez informacji o drugiej skali, o trzech usuniętych osobach i o tym, że badanie dobierano do 40 osób. | Podana główna zmienna zależna wskazana w planie, liczebność z analizy mocy, reguła wykluczeń z liczbą wykluczonych osób, wynik dla drugiej skali i wynik bez wykluczeń. |
Symulacja p-hackingu w R
Kod symuluje 10 000 badań bez prawdziwego efektu i dla każdej strategii sprawdza, czy choć jedna z dopuszczonych wersji analizy dała p < .05. Odsetki w tekście i na rysunku 1 pochodzą z tego kodu (obliczenia trwają ok. 30 s).
Odsetek fałszywych alarmów przy elastycznej analizie
R
# R212 – symulacja p-hackingu: jak elastyczne decyzje podnoszą odsetek fałszywych alarmów,
# gdy hipoteza zerowa jest prawdziwa (brak różnicy między grupami)
set.seed(212)
R <- 10000                                   # liczba symulowanych badań

jedno_badanie <- function(n1 = 20, n_dod = 10) {
  # dwie zmienne zależne (np. dwie skale nastroju) skorelowane r = .50, bez różnicy między grupami
  gen <- function(n) { z1 <- rnorm(n); z2 <- 0.5 * z1 + sqrt(0.75) * rnorm(n)
                       data.frame(y1 = z1, y2 = z2, plec = rbinom(n, 1, 0.5)) }
  a <- gen(n1 + n_dod); b <- gen(n1 + n_dod)
  test <- function(a, b, y) t.test(a[[y]], b[[y]], var.equal = TRUE)$p.value
  p_zm <- function(a, b) {                   # trzy wersje wyniku: y1, y2 i ich średnia
    a$sr <- (a$y1 + a$y2) / 2; b$sr <- (b$y1 + b$y2) / 2
    c(test(a, b, "y1"), test(a, b, "y2"), test(a, b, "sr")) }
  bez_odst <- function(d) d[abs(as.numeric(scale(d$y1))) < 2, ]
  p_kow <- function(a, b) {                  # dodanie kowariantu (płeć) do modelu
    d <- rbind(cbind(a, g = 1), cbind(b, g = 0))
    summary(lm(y1 ~ g + plec, data = d))$coefficients["g", 4] }
  a20 <- a[1:n1, ]; b20 <- b[1:n1, ]
  c(plan            = test(a20, b20, "y1"),
    dwie_zmienne    = min(p_zm(a20, b20)),
    dobieranie_osob = min(test(a20, b20, "y1"), test(a, b, "y1")),
    wykluczenia     = min(test(a20, b20, "y1"), test(bez_odst(a20), bez_odst(b20), "y1")),
    kowariant       = min(test(a20, b20, "y1"), p_kow(a20, b20)),
    wszystko_razem  = min(p_zm(a20, b20), p_zm(a, b), test(bez_odst(a20), bez_odst(b20), "y1"),
                          test(bez_odst(a), bez_odst(b), "y1"), p_kow(a20, b20), p_kow(a, b)))
}
wyniki <- t(replicate(R, jedno_badanie()))
odsetek <- colMeans(wyniki < .05)
round(odsetek, 3)
Wynik w R
           plan    dwie_zmienne dobieranie_osob     wykluczenia       kowariant
          0.050           0.101           0.075           0.108           0.056
 wszystko_razem
          0.229
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy i sygnały ostrzegawcze
- Kilka wartości p tuż poniżej .05 w jednej pracy, zwłaszcza przy małych grupach.
- Liczebność „z niczego” – brak analizy mocy i reguły zakończenia zbierania danych.
- Różne liczebności w kolejnych analizach bez wyjaśnienia, kogo i dlaczego wykluczono.
- Kowarianty pojawiające się tylko w niektórych modelach albo podgrupy bez uzasadnienia teoretycznego.
- Przekonanie, że p-hacking to tylko świadome fałszerstwo. Symulacja pokazuje, że wystarczą dobre intencje i brak planu.
- „Korekta” przez pominięcie. Ukrycie nieistotnych analiz nie usuwa problemu, tylko go maskuje. Pokaż je i oznacz.
Najczęstsze pytania
Czy p-hacking to oszustwo naukowe?
Nie zawsze w sensie celowego fałszerstwa. Najczęściej wynika z serii z osobna rozsądnych decyzji podejmowanych po obejrzeniu wyniku, np. dobrania osób albo zmiany reguły wykluczeń. Skutek jest jednak ten sam: wynik istotny przestaje znaczyć to, co obiecuje poziom α.
O ile p-hacking zwiększa ryzyko fałszywego wyniku?
Zależy od liczby i rodzaju decyzji. W symulacji z dwiema grupami po 20 osób jeden zaplanowany test dawał fałszywy alarm w 5.0% badań, wybór spośród trzech wersji zmiennej zależnej – w 10.1%, a połączenie kilku elastycznych decyzji – w 22.9%.
Czym p-hacking różni się od HARKingu?
P-hacking dotyczy analizy: zmienia się dane lub metodę, aż wynik będzie istotny. HARKing dotyczy hipotezy: po poznaniu wyniku przedstawia się ją tak, jakby powstała przed badaniem. Obie praktyki często występują razem i obu zapobiega prerejestracja.
Czy dobieranie osób do badania po pierwszej analizie to p-hacking?
Tak, jeśli decyzja o dobraniu osób zależy od tego, czy wynik jest już istotny, a końcowy test nie uwzględnia tej wielokrotnej analizy. Jeśli chcesz analizować dane w trakcie, zaplanuj z góry analizę sekwencyjną z korektą poziomu α.
Jak w pracy pokazać, że nie było p-hackingu?
Napisz, które decyzje zapadły przed zebraniem danych (najlepiej z linkiem do prerejestracji), podaj liczbę i powody wykluczeń, wyniki dla wszystkich mierzonych zmiennych zależnych i wyniki alternatywnych wersji analizy. Analizy nieplanowane oznacz jako eksploracyjne.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Zarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikHipoteza się nie potwierdziła – co dalej
Jak sprawdzić, co mówi wynik nieistotny: przedział ufności, analiza wrażliwości, test równoważności TOST, czynnik Bayesa i gotowe zdania do wyników.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Head, M. L., Holman, L., Lanfear, R., Kahn, A. T., & Jennions, M. D. (2015). The extent and consequences of p-hacking in science. PLOS Biology, 13(3), Article e1002106. https://doi.org/10.1371/journal.pbio.1002106 ● Otwarty dostęp
- John, L. K., Loewenstein, G., & Prelec, D. (2012). Measuring the prevalence of questionable research practices with incentives for truth telling. Psychological Science, 23(5), 524–532. https://doi.org/10.1177/0956797611430953
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Steegen, S., Tuerlinckx, F., Gelman, A., & Vanpaemel, W. (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science, 11(5), 702–712. https://doi.org/10.1177/1745691616658637
- Wicherts, J. M., Veldkamp, C. L. S., Augusteijn, H. E. M., Bakker, M., van Aert, R. C. M., & van Assen, M. A. L. M. (2016). Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking. Frontiers in Psychology, 7, Article 1832. https://doi.org/10.3389/fpsyg.2016.01832 ● Otwarty dostęp
Cytowania BibTeX
@article{head2015extent, author={Head, Megan L. and Holman, Luke and Lanfear, Rob and Kahn, Andrew T. and Jennions, Michael D.}, title={{The extent and consequences of p-hacking in science}}, journal={PLOS Biology}, year={2015}, volume={13}, number={3}, eid={e1002106}, doi={10.1371/journal.pbio.1002106}}@article{john2012measuring, author={John, Leslie K. and Loewenstein, George and Prelec, Drazen}, title={{Measuring the prevalence of questionable research practices with incentives for truth telling}}, journal={Psychological Science}, year={2012}, volume={23}, number={5}, pages={524--532}, doi={10.1177/0956797611430953}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{steegen2016increasing, author={Steegen, Sara and Tuerlinckx, Francis and Gelman, Andrew and Vanpaemel, Wolf}, title={{Increasing transparency through a multiverse analysis}}, journal={Perspectives on Psychological Science}, year={2016}, volume={11}, number={5}, pages={702--712}, doi={10.1177/1745691616658637}}@article{wicherts2016degrees, author={Wicherts, Jelte M. and Veldkamp, Coosje L. S. and Augusteijn, Hilde E. M. and Bakker, Marjan and van Aert, Robbie C. M. and van Assen, Marcel A. L. M.}, title={{Degrees of freedom in planning, running, analyzing, and reporting psychological studies: A checklist to avoid p-hacking}}, journal={Frontiers in Psychology}, year={2016}, volume={7}, eid={1832}, doi={10.3389/fpsyg.2016.01832}}