Co to jest replikowalność?
Replikowalność (ang. replicability) to właściwość wyniku badania polegająca na tym, że nowe badanie, które stawia to samo pytanie i zbiera własne dane, uzyskuje wynik spójny z oryginałem. Raport amerykańskich Akademii Narodowych – National Academies of Sciences, Engineering, and Medicine (2019) – definiuje replikowalność jako uzyskiwanie spójnych wyników w badaniach odpowiadających na to samo pytanie naukowe. Odróżnia ją od pojęć, które w polskich tekstach często się z nią mylą:
| Pojęcie | Co się powtarza | Pytanie kontrolne |
|---|---|---|
| Odtwarzalność (ang. reproducibility) | te same dane, ten sam kod | Czy z udostępnionych danych wychodzą te same liczby co w artykule? |
| Odporność (ang. robustness) | te same dane, inna rozsądna analiza | Czy wniosek przetrwa inne wykluczenia, model lub przekształcenie? (zob. analiza wrażliwości) |
| Replikowalność (ang. replicability) | nowe dane, ta sama procedura lub pytanie | Czy w nowej próbie efekt znów się pojawi? |
| Uogólnialność (ang. generalizability) | inny kontekst lub populacja | Czy wynik dotyczy też innych grup i sytuacji? (zob. trafność zewnętrzna) |
Te same Akademie zauważają, że od odtworzenia obliczeń oczekuje się zwykle niemal identycznych wyników, a brak replikacji nie musi oznaczać, że coś zrobiono źle. Różne próby dają różne wyniki choćby z powodu błędu losowego, a czasem niepowodzenie replikacji prowadzi do odkrycia, od czego efekt zależy.
Rodzaje replikacji
- Replikacja bezpośrednia (bliska) – możliwie wierne powtórzenie procedury, materiałów i analizy na nowej próbie z tej samej populacji. Sprawdza, czy efekt w ogóle istnieje.
- Replikacja konceptualna – ta sama hipoteza, ale inna operacjonalizacja (np. inna manipulacja stresu albo inna skala). Sprawdza, czy efekt nie jest artefaktem jednej metody.
- Replikacja wewnętrzna – kolejne badanie w tym samym projekcie albo podział próby na części eksploracyjną i potwierdzającą.
Uygun Tunç i Tunç (2023) zwracają uwagę, że wyprowadzenie testowalnej predykcji zawsze wymaga hipotez pomocniczych, np. o trafności manipulacji czy pomiaru. Po nieudanej replikacji łatwo więc „ratować” teorię zarzutem, że replikacja była zrobiona inaczej. Autorzy proponują ramy systematycznych replikacji, łączących replikacje bliskie i konceptualne. Pozwalają one ocenić, czy takie poprawki teorii są postępowe, czy tylko ją chronią.
Kiedy replikacja jest „udana”? Kryteria
Nie ma jednego kryterium sukcesu. Najczęściej stosuje się:
- Istotność w tym samym kierunku – replikacja daje p < .05, a efekt ma ten sam znak. Kryterium jest proste, ale silnie zależy od mocy replikacji.
- Zgodność oszacowań – efekt z oryginału mieści się w 95% przedziale ufności replikacji (albo odwrotnie).
- Połączenie wyników – metaanaliza oryginału i replikacji, która pokazuje łączną wielkość efektu.
- „Małe teleskopy” – Simonsohn (2015) proponuje sprawdzać, czy wynik replikacji jest zgodny z efektem na tyle dużym, że oryginalne badanie mogłoby go wykryć. Jako taki „ledwie wykrywalny” efekt przyjmuje się efekt, który oryginał wykryłby z małą, ustaloną z góry mocą – w przykładzie niżej 33% (d33%). Dzięki temu da się odróżnić replikację zbyt „zaszumioną” od takiej, która aktywnie wskazuje, że efekt jest bardzo mały.
Różne kryteria dają różne odpowiedzi. W najbardziej znanym projekcie replikacyjnym w psychologii (Open Science Collaboration, 2015) powtórzono 100 badań z trzech czasopism z większą mocą i z oryginalnymi materiałami. Wynik istotny statystycznie miało 97% badań oryginalnych i 36% replikacji. Efekt z oryginału mieścił się w 95% CI replikacji w 47% par, za udane subiektywnie uznano 39% replikacji, a średnia wielkość efektu w replikacjach była o połowę mniejsza niż w oryginałach. Szerszy kontekst tych wyników opisuje hasło kryzys replikacyjny w psychologii.
Przykład: dlaczego dobre replikacje dają „gorsze” wyniki
Załóżmy, że krótki trening uważności naprawdę poprawia koncentrację o d = 0.30. W symulacji przeprowadzono 5000 badań oryginalnych po 25 osób w grupie, ale „opublikowano” tylko te z p < .05 i efektem w oczekiwanym kierunku. Następnie każde opublikowane badanie zreplikowano.
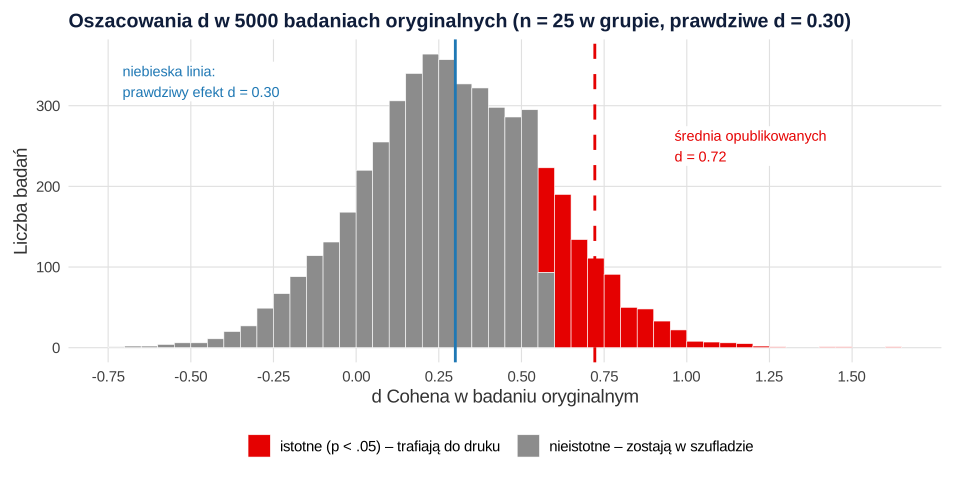
Co pokazuje symulacja:
- Moc oryginałów wynosiła tylko .17 – wynik istotny dało 16.8% badań. Średnie d ze wszystkich 5000 badań było trafne (0.30), ale średnie d z badań opublikowanych wyniosło 0.72. Przez sito istotności przechodzą tylko przeszacowania. Button i in. (2013) opisują ten mechanizm: niska moc zmniejsza szansę wykrycia efektu, a efekty z badań o niskiej mocy, które okazały się istotne, są zawyżone.
- Replikacje z tą samą liczebnością dały wynik istotny w tym samym kierunku tylko w 17.1% przypadków, choć efekt istnieje. Ich średnie d wyniosło 0.30, czyli tyle, ile wynosi prawda.
- Replikacje z 2.5 raza większą próbą (63 osoby w grupie) dały wynik istotny w 37.7% przypadków. Jednocześnie efekt z oryginału mieścił się w ich 95% CI rzadziej (37.2% wobec 66.8%). Precyzyjniejsza replikacja wyraźniej pokazuje, że oryginał przeszacował efekt.
- Dla oryginału z 25 osobami w grupie d33% = 0.44. Prawdziwy efekt jest mniejszy, więc oryginalne badanie było, mówiąc obrazowo, za małym teleskopem, by wiarygodnie go dostrzec.
Wniosek: niska replikowalność nie musi oznaczać, że efektów nie ma. Często oznacza, że oryginały miały zbyt małą moc, a literatura publikowała głównie przeszacowania (zob. efekt szuflady). Replikację planuj więc dla efektu mniejszego niż oryginalny, a nie dla tego z artykułu (zob. dobór liczebności próby).
Jak opisać replikację w pracy
Napisz, jakiego rodzaju to replikacja, co zmieniono względem oryginału, jak ustalono liczebność i jakie kryterium sukcesu przyjęto przed analizą. Podaj efekt z oryginału i z replikacji z przedziałami ufności.
Liczby w tym opisie pochodzą z jednej symulowanej replikacji w kodzie poniżej. Standardy raportowania replikacji obejmuje też moduł replikacji w standardach APA JARS (zob. styl APA). Dane i kod, które pozwolą innym odtworzyć Twoje analizy, przygotujesz według wpisu Pakiet replikacyjny: dane i kod do artykułu.
Symulacja replikacji w R
Kod symuluje badania oryginalne o niskiej mocy, selekcję wyników istotnych i ich replikacje z tą samą oraz z większą liczebnością, liczy próg d33% metody małych teleskopów, a na koniec przeprowadza jedną replikację opisaną we wzorze APA. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Klątwa zwycięzcy i odsetek udanych replikacji
R
# R214 – replikowalność: dlaczego „istotne” badania oryginalne zawyżają efekt
# i jak często replikacja kończy się sukcesem według różnych kryteriów
set.seed(214)
d_true <- 0.30                                   # prawdziwy efekt (np. trening uważności a koncentracja)
n_or <- 25                                       # osób w grupie w badaniu oryginalnym
R <- 5000

d_cohen <- function(x, y) (mean(x) - mean(y)) / sqrt((var(x) + var(y)) / 2)
badanie <- function(n) {
  x <- rnorm(n, d_true); y <- rnorm(n, 0)
  c(d = d_cohen(x, y), p = t.test(x, y, var.equal = TRUE)$p.value)
}
oryg <- t(replicate(R, badanie(n_or)))
istotne <- oryg[oryg[, "p"] < .05 & oryg[, "d"] > 0, ]          # do druku trafiają tylko wyniki istotne
round(c(moc_oryginalu = mean(oryg[, "p"] < .05 & oryg[, "d"] > 0),
        sredni_d_wszystkich = mean(oryg[, "d"]), sredni_d_opublikowanych = mean(istotne[, "d"])), 3)

# Replikacja każdego opublikowanego badania: (a) ta sama liczebność, (b) 2.5 raza większa próba
ocena <- function(n_rep) {
  wyn <- t(sapply(seq_len(nrow(istotne)), function(i) {
    x <- rnorm(n_rep, d_true); y <- rnorm(n_rep, 0)
    d_r <- d_cohen(x, y); p_r <- t.test(x, y, var.equal = TRUE)$p.value
    se_r <- sqrt(2 / n_rep + d_r^2 / (4 * n_rep))                   # przybliżony SE d
    c(d_rep = d_r,
      istotna_ten_sam_kierunek = p_r < .05 & d_r > 0,
      oryginal_w_95CI_replikacji = unname(abs(istotne[i, "d"] - d_r) < 1.96 * se_r))
  }))
  colMeans(wyn)
}
round(rbind(ta_sama_n = ocena(n_or), n_x_2.5 = ocena(round(2.5 * n_or))), 3)

# Małe teleskopy (Simonsohn, 2015): efekt, który oryginał wykryłby z mocą 33%
d33 <- power.t.test(n = n_or, power = 1/3, sig.level = .05)$delta
round(d33, 2)

# Przykład jednej replikacji do opisu w pracy: liczebność dla d = 0.50 (mniejszego niż oryginalne 0.72)
n_rep <- ceiling(power.t.test(delta = 0.5, power = 0.80, sig.level = .05)$n)
n_rep
set.seed(2140)
trening  <- rnorm(n_rep, d_true); kontrola <- rnorm(n_rep, 0)
t.test(trening, kontrola, var.equal = TRUE)
effectsize::cohens_d(trening, kontrola)
Wynik w R
          moc_oryginalu     sredni_d_wszystkich sredni_d_opublikowanych
                  0.168                   0.300                   0.722
          d_rep istotna_ten_sam_kierunek oryginal_w_95CI_replikacji
ta_sama_n 0.302                    0.171                      0.668
n_x_2.5   0.302                    0.377                      0.372
[1] 0.44
[1] 64

	Two Sample t-test

data:  trening and kontrola
t = 2.6375, df = 126, p-value = 0.009405
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 0.1131730 0.7934174
sample estimates:
 mean of x  mean of y
 0.2712699 -0.1820253

Cohen's d |       95% CI
------------------------
0.47      | [0.11, 0.82]

- Estimated using pooled SD.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietu stats i effectsize); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Mylenie replikowalności z odtwarzalnością. Ponowne przeliczenie tych samych danych nie jest replikacją.
- Liczebność replikacji z efektu oryginalnego. Jeśli oryginał przeszacował efekt, replikacja będzie miała za małą moc.
- Ocena „udała się / nie udała” na podstawie samego p. Podawaj oba efekty z przedziałami ufności.
- „Replikacja się nie udała, więc efekt nie istnieje”. Pojedyncza nieistotna replikacja zwykle tylko zawęża zakres prawdopodobnych efektów.
- Nieopisane zmiany procedury (inna populacja, przekład, forma online). Każda zmiana to hipoteza pomocnicza, którą czytelnik powinien znać.
Najczęstsze pytania
Czym różni się replikowalność od odtwarzalności?
Odtwarzalność (reproducibility) oznacza uzyskanie tych samych liczb z tych samych danych i kodu. Replikowalność (replicability) oznacza uzyskanie spójnego wyniku w nowym badaniu z nowymi danymi. Wynik może być odtwarzalny, a mimo to się nie replikować.
Co to jest replikacja konceptualna?
To badanie tej samej hipotezy innymi metodami, np. z inną manipulacją albo inną skalą. Sprawdza, czy efekt nie jest artefaktem jednej procedury. Replikacja bezpośrednia powtarza natomiast możliwie wiernie oryginalną procedurę.
Dlaczego replikacje dają zwykle mniejsze efekty niż oryginały?
Głównie dlatego, że do druku trafiały przede wszystkim wyniki istotne. W badaniach o małej mocy istotne są tylko przeszacowania, więc opublikowane efekty są zawyżone. W symulacji z prawdziwym efektem d = 0.30 średni efekt w badaniach „opublikowanych” wyniósł 0.72.
Jak dobrać liczebność do badania replikacyjnego?
Nie opieraj jej na efekcie z oryginału, bo zwykle jest zawyżony. Przyjmij efekt mniejszy, np. najmniejszy interesujący, albo zastosuj podejście małych teleskopów, i zaplanuj próbę większą niż w oryginale.
Jak ocenić, czy replikacja się udała?
Ustal kryterium przed analizą: wynik istotny w tym samym kierunku, zgodność oszacowań w przedziałach ufności, łączna metaanaliza oryginału i replikacji albo test małych teleskopów. Niezależnie od kryterium podaj oba efekty z przedziałami ufności.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Pakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikJak zaplanować badanie replikacyjne
Rodzaj replikacji, materiały od autorów, liczebność przy zawyżonym efekcie, kryteria sukcesu i protokół registered report z kodem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- National Academies of Sciences, Engineering, and Medicine. (2019). Reproducibility and replicability in science. The National Academies Press. https://doi.org/10.17226/25303 ● Otwarty dostęp: pełny tekst
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), Article aac4716. https://doi.org/10.1126/science.aac4716 ● Otwarty dostęp: pełny tekst
- Simonsohn, U. (2015). Small telescopes: Detectability and the evaluation of replication results. Psychological Science, 26(5), 559–569. https://doi.org/10.1177/0956797614567341
- Uygun Tunç, D., & Tunç, M. N. (2023). Falsificationist treatment of auxiliary hypotheses in social and behavioral sciences: Systematic replications framework. Meta-Psychology, 7. https://doi.org/10.15626/mp.2021.2756 ● Otwarty dostęp
Cytowania BibTeX
@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@book{nasem2019reproducibility, author={{National Academies of Sciences, Engineering, and Medicine}}, title={{Reproducibility and replicability in science}}, year={2019}, publisher={The National Academies Press}, url={https://doi.org/10.17226/25303}}@article{osc2015estimating, author={{Open Science Collaboration}}, title={{Estimating the reproducibility of psychological science}}, journal={Science}, year={2015}, volume={349}, number={6251}, eid={aac4716}, doi={10.1126/science.aac4716}}@article{simonsohn2015small, author={Simonsohn, Uri}, title={{Small telescopes: Detectability and the evaluation of replication results}}, journal={Psychological Science}, year={2015}, volume={26}, number={5}, pages={559--569}, doi={10.1177/0956797614567341}}@article{uygun2023falsificationist, author={Uygun Tunç, Duygu and Tunç, Mehmet Necip}, title={{Falsificationist treatment of auxiliary hypotheses in social and behavioral sciences: Systematic replications framework}}, journal={Meta-Psychology}, year={2023}, volume={7}, doi={10.15626/mp.2021.2756}}