Co to jest kryzys replikacyjny w psychologii?
Kryzys replikacyjny (kryzys replikowalności, ang. replication crisis) to określenie sytuacji, w której znaczna część opublikowanych wyników psychologii nie powtarza się w nowych badaniach przeprowadzonych tą samą procedurą. Nie chodzi o pojedyncze nieudane powtórzenia, które w nauce są normalne. Chodzi o systematyczny wzorzec: efekty w replikacjach są wyraźnie mniejsze niż w oryginałach, a wiele z nich znika. Kryzys podważył zaufanie do części literatury i zapoczątkował reformę praktyk badawczych znaną jako ruch open science.
Warto rozróżniać pojęcia. Replikowalność oznacza, że nowe badanie na nowych danych daje ten sam wniosek. Odtwarzalność (reproducibility) oznacza, że ta sama analiza na tych samych danych daje te same liczby. Kryzys dotyczy przede wszystkim pierwszego, ale problemy z drugim są również częste. Hardwicke i in. (2018) próbowali odtworzyć 1324 wartości z 35 artykułów czasopisma Cognition, które udostępniło dane po wprowadzeniu obowiązkowej polityki otwartych danych. Dla 64 wartości nie udało się uzyskać wyniku zgodnego z dokładnością do 10%. W 11 z 22 artykułów odtworzonych w pełni potrzebna była pomoc autorów, a w 13 artykułach co najmniej jednej wartości nie odtworzono mimo tej pomocy. Skoro nawet te same dane nie zawsze dają te same liczby, trudno oczekiwać zgodności nowych badań.
Najważniejsze dowody
Przełomowe było wspólne przedsięwzięcie Open Science Collaboration (2015). Badacze powtórzyli 100 badań eksperymentalnych i korelacyjnych z trzech czołowych czasopism psychologicznych. Korzystali z planów o dużej mocy i, gdy to było możliwe, z oryginalnych materiałów. Wyniki:
- istotne wyniki miało 97% badań oryginalnych i 36% replikacji;
- efekty w replikacjach były średnio o połowę mniejsze;
- 47% oryginalnych wielkości efektu mieściło się w 95% przedziale ufności replikacji;
- 39% efektów zespoły uznały subiektywnie za zreplikowane.
Już dekadę wcześniej Ioannidis (2005) pokazał w modelu teoretycznym, że wynik badania jest tym mniej prawdopodobnie prawdziwy, im mniejsze są badania i efekty, im więcej testowanych związków i im większa elastyczność planów i analiz. Jego symulacje sugerowały, że w wielu dziedzinach twierdzenie badawcze jest częściej fałszywe niż prawdziwe.
Przyczyny kryzysu
| Przyczyna | Na czym polega |
|---|---|
| Mała moc statystyczna | Małe próby rzadko wykrywają prawdziwe efekty, a wyniki istotne częściej są przypadkowe lub zawyżone (Button i in., 2013) |
| Elastyczność analizy | Wybór zmiennych, wykluczeń, kowariant i momentu zakończenia zbierania danych po obejrzeniu wyników (p-hacking) |
| Hipotezy dopisywane po fakcie | Przedstawianie wyniku eksploracji jako przewidywania (HARKing) |
| Selektywna publikacja | Wyniki nieistotne zostają w szufladzie (efekt szuflady) |
| Słaby pomiar i teoria | Niesprawdzone narzędzia i hipotezy zbyt ogólne, by dało się je jednoznacznie sfalsyfikować (zob. falsyfikowalność) |
Simmons i in. (2011) pokazali w symulacjach i dwóch eksperymentach, że niejawna elastyczność w zbieraniu, analizie i raportowaniu danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Do raportu można w ten sposób doprowadzić niemal dowolny „istotny” wynik. Button i in. (2013) wskazali, że niska moc nie tylko zmniejsza szansę wykrycia prawdziwego efektu. Obniża też prawdopodobieństwo, że wynik istotny odzwierciedla prawdziwy efekt, i prowadzi do zawyżonych oszacowań oraz niskiej replikowalności.
Przykład: dlaczego replikacja z tą samą liczebnością zwykle „nie wychodzi”
Załóżmy, że efekt istnieje i wynosi d = 0.30 – mały do umiarkowanego, typowy dla psychologii społecznej. Badania oryginalne mają po 30 osób na grupę, a publikuje się tylko wyniki istotne w oczekiwanym kierunku. Symulacja 10 000 takich badań pokazuje mechanizm krok po kroku:
- Moc oryginału to 20.9%. Tylko co piąte badanie daje istotny wynik i trafia do druku.
- Opublikowane efekty są ponad dwukrotnie zawyżone. Średnie d we wszystkich badaniach wynosi 0.307, czyli prawie dokładnie prawdę. W opublikowanych – 0.674 (rysunek 1). Przy 30 osobach na grupę istotność osiąga się tylko wtedy, gdy los zawyżył efekt.
- Replikacja z tą samą liczebnością ma moc 20.7%. W symulacji 5000 replikacji istotny wynik dało 20.9%, choć efekt istnieje.
- Replikacja zaplanowana na 80% mocy według opublikowanego d = 0.67 potrzebuje tylko 36 osób na grupę. Jej rzeczywista moc to zaledwie 24.1%.
- Do 80% mocy przy prawdziwym d = 0.30 potrzeba 176 osób na grupę. Replikacja z próbą 2.5 razy większą niż w oryginale (75 osób na grupę) ma 44.6% mocy.
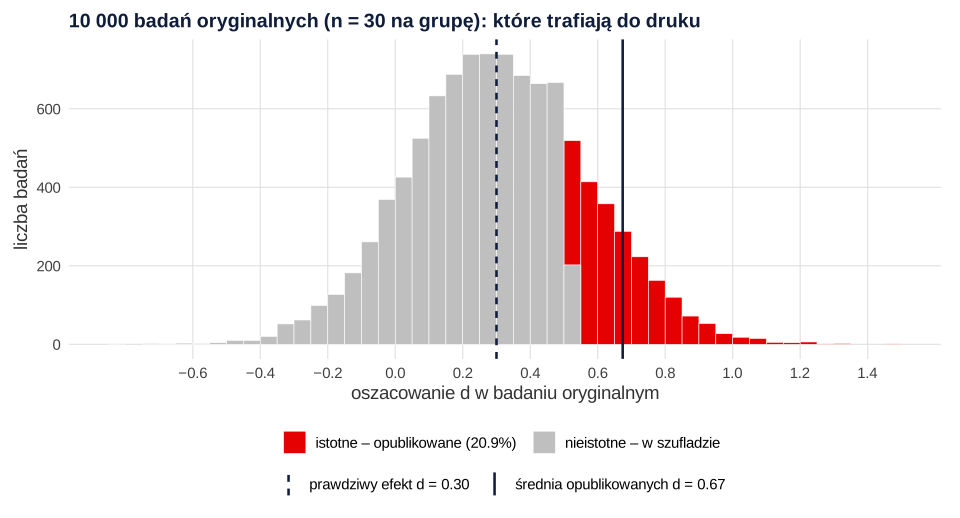
Ten prosty model nie zakłada żadnego oszustwa ani p-hackingu – wystarczą mała moc i publikowanie wyników istotnych. Wyjaśnia przy tym zarówno spadek efektów o połowę i więcej, jak i niski odsetek udanych replikacji z badania Open Science Collaboration (2015). Jednocześnie pokazuje, że nieudana replikacja z małą próbą też niewiele dowodzi. Replikacja potrzebuje mocy obliczonej dla realistycznego, a nie opublikowanego efektu (zob. dobór liczebności próby i najmniejszy interesujący efekt).
Kiedy replikacja jest „udana”?
Nie ma jednego kryterium, a wybór kryterium zmienia odpowiedź. Open Science Collaboration (2015) raportowało kilka miar równocześnie i każda dawała inny odsetek.
- Istotność w tym samym kierunku – proste, ale zależne od mocy replikacji.
- Efekt oryginalny w przedziale ufności replikacji – sprawdza zgodność wielkości.
- Metaanaliza oryginału i replikacji – łączy dowody, ale przejmuje zawyżenie oryginału (zob. metaanaliza).
- Test równoważności – pozwala stwierdzić, że efekt jest mniejszy od najmniejszego interesującego (zob. test TOST), a nie tylko „nieistotny”.
Co się zmieniło – i co możesz zrobić w swojej pracy
Odpowiedzią na kryzys były zmiany w sposobie prowadzenia i publikowania badań. Nosek i in. (2018) opisują prerejestrację – określenie pytań i planu analiz przed poznaniem wyników – jako sposób na odróżnienie testowania predykcji od wyjaśniania po fakcie. Rozpowszechniły się też registered reports, udostępnianie danych i kodu, duże replikacje wieloośrodkowe i analiza mocy jako standard. Lista kontrolna dla pracy dyplomowej:
- zaplanuj hipotezy, zmienne i analizy przed zebraniem danych i zapisz plan (plan analizy i prerejestracja);
- uzasadnij liczebność próby analizą mocy a priori, zakładając efekt mniejszy niż w pojedynczych publikacjach;
- oddziel wyraźnie analizy konfirmacyjne od eksploracyjnych;
- raportuj wielkości efektu z przedziałami ufności i wszystkie wyniki, także nieistotne;
- udostępnij dane i kod, jeśli to możliwe (pakiet replikacyjny);
- w dyskusji oceń, na ile twój wynik zgadza się z wcześniejszymi badaniami, i nie traktuj pojedynczego istotnego wyniku jako ostatecznego potwierdzenia hipotezy.
Symulacja: zawyżone efekty i moc replikacji w R
Kod symuluje 10 000 badań oryginalnych, liczy średni efekt wszystkich i opublikowanych badań oraz moc replikacji przy czterech sposobach planowania liczebności (power.t.test()), a na koniec sprawdza moc symulacją.
Badania oryginalne, publikacja selektywna i moc replikacji
R
# Dlaczego replikacje „nie wychodzą”, nawet gdy efekt istnieje?
# Dane symulowane: 10 000 badań oryginalnych, prawdziwy efekt d = 0.30, 30 osób na grupę.
# Publikowane są tylko wyniki istotne (p < .05) w oczekiwanym kierunku.
set.seed(209)
d_prawdziwe <- 0.30; n_oryg <- 30
oryg <- t(replicate(10000, {
  e <- rnorm(n_oryg, d_prawdziwe); k <- rnorm(n_oryg)
  tt <- t.test(e, k, var.equal = TRUE)
  c(d = unname(tt$statistic) * sqrt(2 / n_oryg), p = tt$p.value)
}))
oryg <- as.data.frame(oryg)
oryg$opublikowane <- oryg$p < .05 & oryg$d > 0
round(mean(oryg$opublikowane), 3)                          # moc badania oryginalnego
round(c(sr_d_wszystkie = mean(oryg$d), sr_d_opublikowane = mean(oryg$d[oryg$opublikowane])), 3)

# Moc replikacji przy trzech sposobach planowania (test t dla dwóch grup, alfa = .05)
d_publ <- mean(oryg$d[oryg$opublikowane])
moc <- function(n, d) power.t.test(n = n, delta = d, sd = 1, sig.level = .05)$power
n_wg_publ <- ceiling(power.t.test(delta = d_publ, sd = 1, power = .80)$n)    # plan na podstawie publikacji
n_wg_prawdy <- ceiling(power.t.test(delta = d_prawdziwe, sd = 1, power = .80)$n)
data.frame(plan = c("ta sama liczebność co oryginał", "80% mocy dla d z publikacji", "80% mocy dla prawdziwego d",
                    "2.5 × liczebność oryginału"),
           n_na_grupe = c(n_oryg, n_wg_publ, n_wg_prawdy, 2.5 * n_oryg),
           rzeczywista_moc = round(c(moc(n_oryg, d_prawdziwe), moc(n_wg_publ, d_prawdziwe),
                                     moc(n_wg_prawdy, d_prawdziwe), moc(2.5 * n_oryg, d_prawdziwe)), 3))

# Sprawdzenie symulacją: replikacje z tą samą liczebnością co oryginał
set.seed(2091)
rep_p <- replicate(5000, t.test(rnorm(n_oryg, d_prawdziwe), rnorm(n_oryg), var.equal = TRUE)$p.value)
round(mean(rep_p < .05), 3)                                 # odsetek „udanych” replikacji
Wynik w R
[1] 0.209
   sr_d_wszystkie sr_d_opublikowane
            0.307             0.674
                            plan n_na_grupe rzeczywista_moc
1 ta sama liczebność co oryginał         30           0.207
2    80% mocy dla d z publikacji         36           0.241
3     80% mocy dla prawdziwego d        176           0.801
4     2.5 × liczebność oryginału         75           0.446
[1] 0.209
Bibliografia oprogramowania
Wyniki pochodzą z R 4.5.3 (funkcje bazowe); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze nieporozumienia
- „Nieudana replikacja dowodzi, że efektu nie ma.” Przy małej mocy replikacja często nie wykryje istniejącego efektu – w przykładzie w ok. 79% przypadków.
- „Kryzys oznacza, że psychologia nie jest nauką.” Wykrycie problemu i reforma praktyk to przejaw samokorekty nauki; podobne problemy opisywano m.in. w badaniach medycznych (Ioannidis, 2005).
- „Winne są oszustwa.” Fałszerstwa się zdarzają, ale przykład na tej stronie pokazuje, że do zawyżonych efektów i nieudanych replikacji wystarczą mała moc i selektywna publikacja, a elastyczność analizy jeszcze to wzmacnia.
- Planowanie badania na podstawie efektu z jednej, małej publikacji. Taki efekt jest prawdopodobnie zawyżony.
- Utożsamianie wartości p z prawdopodobieństwem replikacji. Wynik p = .03 nie oznacza 97% szans na powtórzenie (zob. wartość p).
Najczęstsze pytania
Co to jest kryzys replikacyjny w psychologii?
To odkrycie, że znaczna część opublikowanych wyników psychologii nie powtarza się w nowych badaniach albo okazuje się dużo słabsza. W projekcie Open Science Collaboration (2015) istotne wyniki miało 36% ze 100 replikacji wobec 97% badań oryginalnych, a efekty były średnio o połowę mniejsze.
Jakie są przyczyny kryzysu replikacyjnego?
Najczęściej wymienia się małą moc statystyczną badań, niejawną elastyczność analizy (p-hacking), dopisywanie hipotez po poznaniu wyników (HARKing), publikowanie głównie wyników istotnych oraz słabą teorię i pomiar. Te czynniki wzajemnie się wzmacniają.
Czy nieudana replikacja oznacza, że efekt nie istnieje?
Nie zawsze. Replikacja z małą próbą ma niską moc – w przykładzie na tej stronie replikacja z 30 osobami na grupę wykrywała istniejący efekt d = 0.30 tylko w ok. 21% przypadków. O braku efektu świadczy dopiero replikacja o dużej mocy, najlepiej z testem równoważności.
Jak zaplanować liczebność próby w badaniu replikacyjnym?
Nie opieraj się na efekcie z oryginalnej publikacji, bo jest prawdopodobnie zawyżony. Zaplanuj moc dla mniejszego, realistycznego efektu albo najmniejszego efektu, który ma znaczenie. W przykładzie plan oparty na opublikowanym d = 0.67 dawał 36 osób na grupę i rzeczywistą moc 24%, a 80% mocy przy prawdziwym d = 0.30 wymagało 176 osób na grupę.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Plan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →PoradnikJak zaplanować badanie replikacyjne
Rodzaj replikacji, materiały od autorów, liczebność przy zawyżonym efekcie, kryteria sukcesu i protokół registered report z kodem w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475 ● Otwarty dostęp
- Hardwicke, T. E., Mathur, M. B., MacDonald, K., Nilsonne, G., Banks, G. C., Kidwell, M. C., Hofelich Mohr, A., Clayton, E., Yoon, E. J., Henry Tessler, M., Lenne, R. L., Altman, S., Long, B., & Frank, M. C. (2018). Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition. Royal Society Open Science, 5(8), Article 180448. https://doi.org/10.1098/rsos.180448 ● Otwarty dostęp
- Ioannidis, J. P. A. (2005). Why most published research findings are false. PLoS Medicine, 2(8), Article e124. https://doi.org/10.1371/journal.pmed.0020124 ● Otwarty dostęp
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114 ● Otwarty dostęp: pełny tekst
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), Article aac4716. https://doi.org/10.1126/science.aac4716 ● Otwarty dostęp: pełny tekst
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Cytowania BibTeX
@article{button2013power, author={Button, Katherine S. and Ioannidis, John P. A. and Mokrysz, Claire and Nosek, Brian A. and Flint, Jonathan and Robinson, Emma S. J. and Munafò, Marcus R.}, title={{Power failure: Why small sample size undermines the reliability of neuroscience}}, journal={Nature Reviews Neuroscience}, year={2013}, volume={14}, number={5}, pages={365--376}, doi={10.1038/nrn3475}}@article{hardwicke2018data, author={Hardwicke, Tom E. and Mathur, Maya B. and MacDonald, Kyle and Nilsonne, Gustav and Banks, George C. and Kidwell, Mallory C. and Hofelich Mohr, Alicia and Clayton, Elizabeth and Yoon, Erica J. and Henry Tessler, Michael and Lenne, Richie L. and Altman, Sara and Long, Bria and Frank, Michael C.}, title={{Data availability, reusability, and analytic reproducibility: Evaluating the impact of a mandatory open data policy at the journal Cognition}}, journal={Royal Society Open Science}, year={2018}, volume={5}, number={8}, eid={180448}, doi={10.1098/rsos.180448}}@article{ioannidis2005why, author={Ioannidis, John P. A.}, title={{Why most published research findings are false}}, journal={PLoS Medicine}, year={2005}, volume={2}, number={8}, eid={e124}, doi={10.1371/journal.pmed.0020124}}@article{nosek2018preregistration, author={Nosek, Brian A. and Ebersole, Charles R. and DeHaven, Alexander C. and Mellor, David T.}, title={{The preregistration revolution}}, journal={Proceedings of the National Academy of Sciences}, year={2018}, volume={115}, number={11}, pages={2600--2606}, doi={10.1073/pnas.1708274114}}@article{osc2015estimating, author={Open Science Collaboration}, title={{Estimating the reproducibility of psychological science}}, journal={Science}, year={2015}, volume={349}, number={6251}, eid={aac4716}, doi={10.1126/science.aac4716}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}