Co to jest skala dychotomiczna?
Skala dychotomiczna (ang. dichotomous lub binary variable) to pomiar z dokładnie dwiema kategoriami: tak/nie, zdał/nie zdał, grupa eksperymentalna/kontrolna. Formalnie jest to skala nominalna z dwiema kategoriami, ale ma jedną wygodną własność. Między dwiema kategoriami jest tylko jeden odstęp, więc nie ma problemu nierównych odległości, który dotyczy skal z wieloma kategoriami. Po zakodowaniu 0/1 zmienną dychotomiczną można wprowadzać do korelacji i regresji, a jej średnia ma prostą interpretację – to odsetek jedynek.
Dychotomia naturalna i sztuczna
Warto odróżnić dwie sytuacje, bo prowadzą do innych analiz:
| Rodzaj | Przykłady | Co z tego wynika |
|---|---|---|
| Naturalna – cecha naprawdę ma dwie wartości | Przydział do warunku eksperymentalnego, praca zarobkowa (tak/nie), skorzystanie z pomocy psychologicznej, wystąpienie zachowania | Analizuj jako dychotomię |
| Sztuczna – powstała z podziału zmiennej ilościowej | „Niski” i „wysoki” stres według mediany, wynik powyżej punktu odcięcia, zdał/nie zdał na podstawie punktów | W analizie związków używaj oryginalnej zmiennej; podział zostaw do decyzji praktycznych (np. kwalifikacja do programu) |
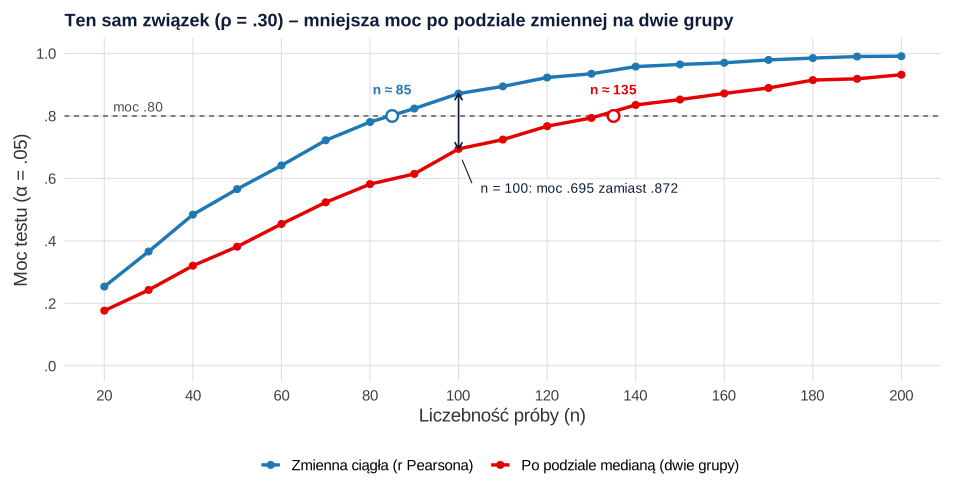
Punkt odcięcia bywa potrzebny, gdy trzeba podjąć decyzję o konkretnej osobie. Do sprawdzania hipotez o związkach lepiej jednak użyć pełnej informacji, bo – jak pokazuje symulacja niżej – podział kosztuje moc testu.
Kodowanie 0/1
Kategorię, która oznacza wystąpienie cechy lub zdarzenia („tak”, „skorzystał(a) z pomocy”), zakoduj jako 1, a kategorię odniesienia – jako 0. Wtedy:
- średnia = odsetek jedynek: M = 0.264 oznacza, że 26.4% osób odpowiedziało „tak”;
- wariancja wynosi p(1 − p), więc jest największa przy podziale 50/50;
- w regresji współczynnik predyktora 0/1 to różnica średnich między grupami (zob. dummy coding).
Formularze online i SPSS często zapisują odpowiedzi jako 1 i 2. Przed analizą przekoduj je na 0/1 i opisz kierunek w księdze kodów (zob. rekodowanie).
Jakie analizy stosować?
| Sytuacja | Analiza |
|---|---|
| Jedna zmienna | Odsetek z 95% przedziałem ufności |
| Dwie dychotomie, niezależne obserwacje | Tabela 2 × 2, test χ², φ, iloraz szans |
| Ta sama dychotomia zmierzona dwa razy | Test McNemara |
| Dychotomia i zmienna ilościowa | Korelacja punktowo-dwuseryjna = test t dla prób niezależnych |
| Dychotomiczna zmienna zależna i kilka predyktorów | Regresja logistyczna |
W tabeli 2 × 2 siłę związku opisują φ i iloraz szans; V Craméra jest potrzebne dopiero dla większych tabel (Kim, 2017). Iloraz szans opisuje związek dwóch zmiennych dychotomicznych z przedziałem ufności i pozwala uwzględniać inne zmienne w regresji logistycznej (Bland i Altman, 2000). φ to po prostu korelacja Pearsona policzona na kodach 0/1, a korelacja punktowo-dwuseryjna to korelacja Pearsona między kodami 0/1 a zmienną ilościową:
gdzie M1 i M0 to średnie zmiennej ilościowej w grupach, s – jej odchylenie standardowe w całej próbie (z mianownikiem n), a p i q = 1 − p – odsetki osób w grupach. Test istotności rpb daje dokładnie ten sam wynik co test t dla prób niezależnych.
Przykład: kto korzysta z pomocy psychologicznej?
W ankiecie 250 studentów (dane symulowane) 66 osób, czyli 26.4%, 95% CI [21.3, 32.2], skorzystało w ostatnim roku z pomocy psychologicznej. Wśród 109 osób mieszkających z rodzicami odsetek ten wyniósł 18.3%, a wśród 141 pozostałych – 32.6%: χ²(1, N = 250) = 6.45, p = .011, φ = −.16, OR = 0.46. Osoby, które skorzystały z pomocy, zgłaszały wyższy stres (skala 10–50; M = 31.73, SD = 5.89) niż pozostałe (M = 28.27, SD = 6.66): t(248) = 3.73, p < .001, co odpowiada korelacji punktowo-dwuseryjnej rpb = .23, 95% CI [.11, .34].
Regresja logistyczna z oboma predyktorami pokazała, że każde 5 punktów stresu wiązało się z 1.57 raza większymi szansami skorzystania z pomocy, 95% CI [1.24, 2.02], a mieszkanie z rodzicami – z mniejszymi szansami, OR = 0.43, 95% CI [0.23, 0.80]. Iloraz szans to nie to samo co „1.57 raza większe prawdopodobieństwo” – różnicę wyjaśnia hasło iloraz szans.
Ile kosztuje podział zmiennej ilościowej na dwie grupy?
Dzielenie wyników medianą na „niskie” i „wysokie” to częsta praktyka – pozwala zrobić test t albo ANOVA zamiast regresji. MacCallum i in. (2002) przeanalizowali uzasadnienia tej praktyki i doszli do wniosku, że dychotomizacja rzadko daje się obronić i często prowadzi do mylących wyników. Cohen (1983) obliczył, że podział jednej zmiennej w punkcie średniej zmniejsza wyjaśnianą wariancję do .647r², co pod względem mocy odpowiada odrzuceniu 38% osób badanych.
Symulacja na rysunku 1 to potwierdza. Przy prawdziwej korelacji ρ = .30 średnia korelacja w próbach spadła po podziale medianą z .30 do .24, a moc testu przy 100 osobach – z .872 do .695. Żeby uzyskać moc .80, potrzeba około 85 osób bez podziału i około 135 po podziale, czyli tak, jakby wyrzucić 37% danych.
Podział dwóch skorelowanych predyktorów może przynieść odwrotny problem: fałszywie istotne wyniki, czyli zawyżony odsetek błędów I rodzaju (Maxwell i Delaney, 1993). Argument „wynik i tak wyszedł istotny” nie uzasadnia więc podziału medianą.
Jak opisać wynik w pracy (APA)
Pełną tabelę modelu przygotujesz według wzoru tabela regresji logistycznej w APA; interpretację krok po kroku omawia poradnik regresja logistyczna: założenia i interpretacja.
Przykład w R
Kod tworzy dane z przykładu, liczy odsetek z przedziałem ufności, φ, korelację punktowo-dwuseryjną i regresję logistyczną, a na końcu powtarza symulację kosztu podziału medianą dla prób po 100 osób. Liczby w tekście pochodzą z tego kodu (porównanie odsetków w grupach i test t – w pełnym skrypcie strony).
Odsetek, φ, rpb, regresja logistyczna i symulacja
R
set.seed(94)
n <- 250
stres <- round(pmin(pmax(rnorm(n, 29, 7), 10), 50))          # poczucie stresu, skala 10–50
rodzice <- rbinom(n, 1, 0.45)                                # 1 = mieszka z rodzicami, 0 = nie
pomoc <- rbinom(n, 1, plogis(-0.75 + 0.09 * (stres - 29) - 0.80 * rodzice))   # 1 = korzystał(a) z pomocy
# 1. Średnia kodów 0/1 to odsetek; 95% CI Wilsona
prop.test(sum(pomoc), n, correct = FALSE)[c("estimate", "conf.int")]
# 2. Dwie dychotomie: tabela 2 × 2, chi-kwadrat i phi (= r Pearsona dla kodów 0/1)
table(rodzice, pomoc)
chisq.test(table(rodzice, pomoc), correct = FALSE)$statistic
round(c(phi = cor(rodzice, pomoc)), 3)
# 3. Dychotomia i zmienna ilościowa: r punktowo-dwuseryjne (= r Pearsona) i test t to ta sama informacja
cor.test(stres, pomoc)[c("estimate", "statistic", "p.value")]
# 4. Regresja logistyczna: ilorazy szans z 95% CI
m <- glm(pomoc ~ stres + rodzice, family = binomial)
round(exp(cbind(OR = coef(m), suppressMessages(confint(m))))[-1, ], 2)
# 5. Koszt podziału medianą: 5000 symulowanych prób po 100 osób, prawdziwe rho = .30
set.seed(2102)
wyn <- replicate(5000, {
  x <- rnorm(100); y <- .30 * x + sqrt(1 - .30^2) * rnorm(100)
  g <- as.numeric(x > median(x))                             # „niski” vs „wysoki” wynik
  c(ciagla = cor(x, y), podzial = cor(g, y))
})
p_r <- function(r, n = 100) 2 * pt(-abs(r * sqrt(n - 2) / sqrt(1 - r^2)), n - 2)
round(rbind(sredni_r = rowMeans(wyn), moc = rowMeans(p_r(wyn) < .05)), 3)
Wynik w R
$estimate
    p
0.264

$conf.int
[1] 0.213228 0.321915
attr(,"conf.level")
[1] 0.95

       pomoc
rodzice  0  1
      0 95 46
      1 89 20
X-squared
 6.447716
   phi
-0.161
$estimate
      cor
0.2304436

$statistic
       t
3.729404

$p.value
[1] 0.0002378898

          OR 2.5 % 97.5 %
stres   1.09  1.04   1.15
rodzice 0.43  0.23   0.80
         ciagla podzial
sredni_r  0.301   0.241
moc       0.872   0.695
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Kodowanie 1/2 zamiast 0/1 – średnia przestaje być odsetkiem, a w regresji logistycznej łatwo pomylić, która kategoria jest „zdarzeniem”.
- Podział medianą „żeby zrobić test t” – tracisz moc; związek zbadaj korelacją lub regresją na pełnej zmiennej.
- Punkt odcięcia wybrany po obejrzeniu wyników – to forma p-hackingu; próg ustal przed analizą i uzasadnij.
- Iloraz szans czytany jak „ile razy bardziej prawdopodobne” – przy częstym zdarzeniu obie miary wyraźnie się różnią.
- Sam odsetek bez liczebności i przedziału ufności – ten sam odsetek w próbie 250 osób i w próbie 40 osób oznacza zupełnie inną precyzję.
Najczęstsze pytania
Co to jest zmienna dychotomiczna?
To zmienna, która ma tylko dwie wartości, np. tak/nie, zdał/nie zdał, grupa eksperymentalna/kontrolna. Formalnie jest to zmienna nominalna z dwiema kategoriami. Zwykle koduje się ją jako 0 i 1, gdzie 1 oznacza wystąpienie cechy lub zdarzenia.
Jak kodować zmienną dychotomiczną?
Użyj kodów 0 i 1, gdzie 1 oznacza interesującą cię kategorię (np. „skorzystał z pomocy”), a 0 – kategorię odniesienia. Średnia takiej zmiennej to odsetek jedynek: M = 0.264 oznacza 26.4% odpowiedzi „tak”. Kody 1/2 z formularza przekoduj przed analizą.
Jaki test dla zmiennej dychotomicznej?
Związek dwóch zmiennych dychotomicznych sprawdzisz testem chi-kwadrat i opiszesz współczynnikiem φ albo ilorazem szans. Gdy drugą zmienną jest zmienna ilościowa, użyj testu t (lub korelacji punktowo-dwuseryjnej), a gdy dychotomia jest zmienną zależną w modelu z kilkoma predyktorami – regresji logistycznej.
Co to jest korelacja punktowo-dwuseryjna?
To korelacja Pearsona między zmienną dychotomiczną zakodowaną 0/1 a zmienną ilościową. Jej test istotności daje ten sam wynik co test t dla prób niezależnych. W przykładzie na tej stronie rpb = .23 odpowiada t(248) = 3.73.
Czy można podzielić zmienną ilościową medianą?
Zwykle nie warto. Podział na „niskich” i „wysokich” zaniża siłę związku i moc testu – w symulacji na tej stronie do uzyskania mocy .80 potrzeba było około 135 osób zamiast 85. Przy dwóch skorelowanych predyktorach podział może też prowadzić do fałszywie istotnych wyników. Lepiej analizować pełną zmienną korelacją lub regresją.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikDobór liczebności próby
Analiza mocy a priori, SESOI i test równoważności, precyzja przedziału ufności, analiza wrażliwości i pułapka pilotażu – z obliczeniami w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bland, J. M., & Altman, D. G. (2000). Statistics notes: The odds ratio. BMJ, 320(7247), 1468. https://doi.org/10.1136/bmj.320.7247.1468 ● Otwarty dostęp: pełny tekst
- Cohen, J. (1983). The cost of dichotomization. Applied Psychological Measurement, 7(3), 249–253. https://doi.org/10.1177/014662168300700301 ● Otwarty dostęp: pełny tekst
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19 ● Otwarty dostęp: pełny tekst
- Maxwell, S. E., & Delaney, H. D. (1993). Bivariate median splits and spurious statistical significance. Psychological Bulletin, 113(1), 181–190. https://doi.org/10.1037/0033-2909.113.1.181
Cytowania BibTeX
@article{bland2000statistics, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: The odds ratio}}, journal={BMJ}, year={2000}, volume={320}, number={7247}, pages={1468}, doi={10.1136/bmj.320.7247.1468}}@article{cohen1983cost, author={Cohen, Jacob}, title={{The cost of dichotomization}}, journal={Applied Psychological Measurement}, year={1983}, volume={7}, number={3}, pages={249--253}, doi={10.1177/014662168300700301}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{maxwell1993bivariate, author={Maxwell, Scott E. and Delaney, Harold D.}, title={{Bivariate median splits and spurious statistical significance}}, journal={Psychological Bulletin}, year={1993}, volume={113}, number={1}, pages={181--190}, doi={10.1037/0033-2909.113.1.181}}