Co to jest skala Likerta?
Skala Likerta (ang. Likert scale, summated rating scale) to narzędzie pomiaru postaw i innych cech złożone z kilku lub kilkunastu stwierdzeń (pozycji), do których osoba badana odnosi się na uporządkowanej skali zgody, np. od 1 = „zdecydowanie się nie zgadzam” do 5 = „zdecydowanie się zgadzam”. Wynik skali to suma lub średnia odpowiedzi na wszystkie pozycje, liczona po odwróceniu pozycji sformułowanych przeciwnie.
Technikę zaproponował Rensis Likert (1932) jako sposób pomiaru postaw. W swojej monografii opisał metodę sigma i prostszą metodę punktowania odpowiedzi, przeanalizował rzetelność i trafność skal oraz porównał je z metodą Thurstone’a. Istotą skali Likerta jest więc łączenie odpowiedzi na wiele pozycji w jeden wynik, a nie sam format „zgadzam się – nie zgadzam się”.
W praktyce ta sama nazwa oznacza trzy różne rzeczy:
- pozycję Likerta – jedno stwierdzenie z uporządkowaną kafeterią odpowiedzi;
- format odpowiedzi typu Likerta – stopniowaną skalę odpowiedzi, także gdy etykiety dotyczą częstości („nigdy” – „bardzo często”), a nie zgody;
- skalę Likerta – zestaw pozycji mierzących ten sam konstrukt, których odpowiedzi się sumuje lub uśrednia.
Ile kategorii odpowiedzi wybrać i jak je opisać, omawia osobny poradnik: ile stopni skali Likerta wybrać. Od skali Likerta odróżnij dyferencjał semantyczny, w którym osoba zaznacza położenie między dwoma przeciwstawnymi przymiotnikami.
Punkt środkowy, „nie wiem” i pozycje odwrócone
Kategoria środkowa („ani się zgadzam, ani się nie zgadzam”) to punkt na kontinuum postawy: osoba nie skłania się ani ku zgodzie, ani ku niezgodzie. Odpowiedź „nie wiem” albo „nie mam zdania” znaczy co innego – brak wiedzy lub opinii – i nie leży na tym kontinuum. Nie koduj jej więc jako 3, tylko jako brak danych, i podaj jej odsetek. Warto też pamiętać, że Krosnick (1991) zalicza odpowiedź „nie wiem” do strategii satysfakcjonowania (satisficing), czyli odpowiadania „wystarczająco dobrze”, gdy optymalna odpowiedź wymaga dużego wysiłku poznawczego. Więcej o projektowaniu odpowiedzi, w tym o kategorii środkowej i opcji „nie wiem”, znajdziesz w haśle kafeteria odpowiedzi.
Pozycje odwrócone to stwierdzenia sformułowane w kierunku przeciwnym do konstruktu, np. „Na zajęciach ze statystyki czuję się zagubiony/a” w skali pozytywnej postawy wobec statystyki. Przed obliczeniem wyniku trzeba je przekodować:
Pozycje odwrócone pomagają też zauważyć osoby, które zaznaczają tę samą odpowiedź w każdym wierszu (straightlining).
Skala porządkowa czy ilościowa?
Wokół tego pytania toczy się długi spór – zob. krótki komentarz Jamieson (2004) o właściwym i niewłaściwym używaniu skal Likerta. Rozstrzygnięcie zależy od tego, co analizujesz: pojedynczą pozycję czy wynik całej skali.
Odpowiedzi na pojedynczą pozycję są porządkowe, dlatego lepiej opisywać je medianą i rozkładem częstości; testy parametryczne można natomiast stosować do wyników skal Likerta, a połączenie pozycji w skalę trzeba uzasadnić dowodami rzetelności lub struktury (Sullivan i Artino, 2013). Norman (2010) przypomina, że badania prowadzone od lat 30. XX wieku pokazują odporność metod parametrycznych – ANOVA, regresji, korelacji – na naruszenia założeń, także przy małych próbach, rozkładach odbiegających od normalnego i danych ze skal Likerta. Z kolei Liddell i Kruschke (2018) wykazali, że analizowanie danych porządkowych modelami metrycznymi może prowadzić do fałszywych alarmów, utraty mocy, a nawet odwrócenia kierunku efektów, czego nie naprawia uśrednianie wielu pozycji; zalecają modele porządkowe, np. regresję porządkową.
| Co analizujesz | Jak opisać | Typowe analizy |
|---|---|---|
| Pojedyncza pozycja (skala porządkowa) | Rozkład procentowy, mediana, wykres słupkowy | Test Manna-Whitneya, test Kruskala-Wallisa, korelacja Spearmana, regresja porządkowa |
| Wynik skali – suma lub średnia kilku pozycji o sprawdzonej rzetelności | Średnia i odchylenie standardowe, histogram | Test t, ANOVA, korelacja Pearsona, regresja liniowa; model porządkowy jako analiza wrażliwości |
Wynik wielu pozycji ma wiele możliwych wartości i zwykle traktuje się go jak zmienną ilościową. Pojedyncza pozycja pozostaje porządkowa bez względu na to, czy ma 5, czy 7 kategorii.
Przykład: sześć pozycji o postawie wobec statystyki
Dwustu czterdziestu studentów psychologii odpowiedziało na sześć stwierdzeń o statystyce na skali 1–5 (dane symulowane). Pozycje 3 i 5 są odwrócone (oznaczone „R”). Rysunek 1 pokazuje surowe odpowiedzi na skumulowanym wykresie rozbieżnym – czytelnym sposobie prezentacji wielu pozycji Likerta naraz.
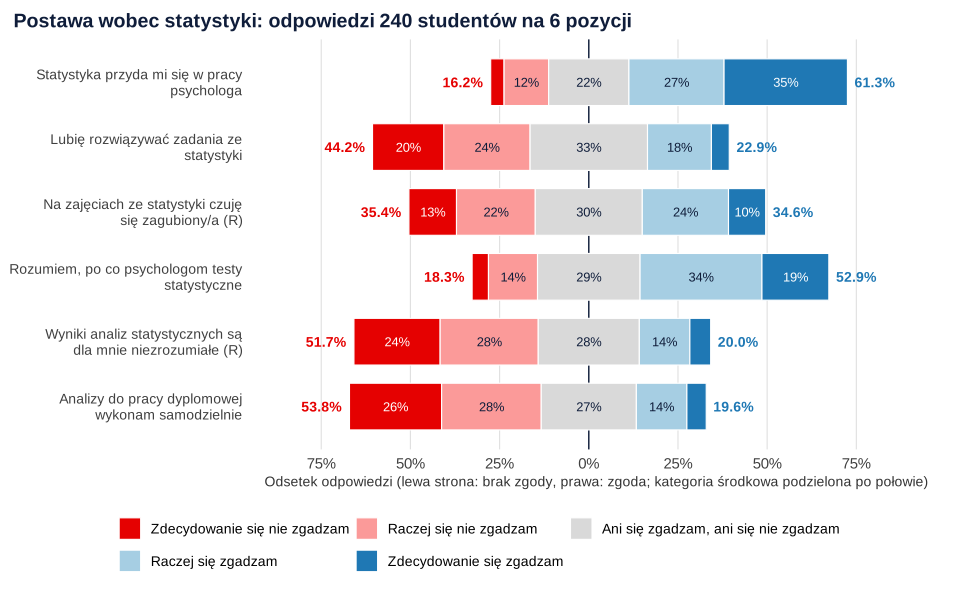
Ze stwierdzeniem „Statystyka przyda mi się w pracy psychologa” zgodziło się 61.3% osób (Mdn = 4), a ze stwierdzeniem „Analizy do pracy dyplomowej wykonam samodzielnie” – tylko 19.6% (Mdn = 2). Pozycje odwrócone mają odwrotny układ: ze stwierdzeniem „Wyniki analiz statystycznych są dla mnie niezrozumiałe” nie zgodziło się 51.7% osób, co po przekodowaniu oznacza postawę pozytywną.
Po odwróceniu pozycji 3 i 5 wynik skali policzono jako średnią sześciu odpowiedzi: M = 3.15, SD = 0.84 (zakres 1–5). Ta sama informacja w postaci sumy to M = 18.88, SD = 5.03 (zakres 6–30). Rzetelność wyniosła α = .82, a omega McDonalda ω = .82. Gdyby zapomnieć o odwróceniu pozycji, alfa spadłaby do −.11, a skorygowane korelacje pozycji 3 i 5 z resztą skali byłyby ujemne (−.52 i −.46) – to najprostszy sygnał błędu w kluczu.
Suma czy średnia?
Przy kompletnych danych suma i średnia to ta sama informacja w innej jednostce (średnia = suma / liczba pozycji), więc korelacje i wyniki testów będą identyczne. Różnią się w praktyce:
- średnia zachowuje metrykę odpowiedzi (3.15 leży blisko środka skali 1–5) i pozwala policzyć wynik przy pojedynczym braku – według reguły ustalonej przed analizą, np. „co najmniej 5 z 6 odpowiedzi”;
- suma jest wymagana, gdy korzystasz z norm testowych lub punktów odcięcia z podręcznika – wtedy licz wynik surowy dokładnie według klucza. Sumy nie licz przy brakujących odpowiedziach, bo zaniża wynik.
Zanim połączysz pozycje, sprawdź spójność wewnętrzną, a przy nowej skali także strukturę czynnikową – liczbę czynników pomoże ustalić analiza równoległa (zob. budowa i walidacja skali). Jeśli dane zbierasz w formularzu online, odpowiedzi tekstowe trzeba najpierw zamienić na liczby – opisuje to poradnik dane z Google Forms i LimeSurvey do SPSS i R.
Jak opisać skalę Likerta w pracy (APA)
W części metodologicznej podaj liczbę pozycji, etykiety skrajnych odpowiedzi, odwrócone pozycje, sposób liczenia wyniku i jego kierunek, a w wynikach – rzetelność, M i SD. Wzór dla danych z przykładu:
Rzetelność kilku skal zbierz w tabeli rzetelności w stylu APA, a sposób raportowania współczynników opisuje wzór raportowania alfy Cronbacha. Planując własną ankietę, zajrzyj do poradnika jak zrobić ankietę do pracy dyplomowej.
Przykład w R
Kod tworzy odpowiedzi z przykładu, opisuje pojedyncze pozycje, odwraca pozycje 3 i 5, liczy wynik skali (średnią i sumę) oraz rzetelność: alfę, omegę i alfę przy błędnym kluczu.
Wynik skali Likerta i rzetelność
R
set.seed(27)
n <- 240
teta <- rnorm(n)                                    # postawa wobec statystyki (cecha ukryta)
ladunki <- c(.70, .75, -.65, .70, -.60, .65)        # pozycje 3 i 5 są sformułowane odwrotnie
przesun <- c(.6, -.4, -.1, .3, -.5, -.6)
progi <- c(-1.3, -.5, .3, 1.1)
pozycje <- sapply(1:6, function(j) {
  y <- ladunki[j] * teta + sqrt(1 - ladunki[j]^2) * rnorm(n) + przesun[j]
  findInterval(y, progi) + 1                        # odpowiedzi 1–5
})
colnames(pozycje) <- paste0("p", 1:6)
dane <- as.data.frame(pozycje)
# 1. Pojedyncze pozycje: mediana i odsetek odpowiedzi 4–5 („zgadzam się”)
rbind(Mdn = sapply(dane, median), zgoda = round(100 * colMeans(dane >= 4), 1))
# 2. Odwrócenie pozycji 3 i 5 (skala 1–5: 6 − x) i wynik skali
dane$p3r <- 6 - dane$p3
dane$p5r <- 6 - dane$p5
skala <- dane[, c("p1", "p2", "p3r", "p4", "p5r", "p6")]
dane$wynik_sr <- rowMeans(skala)                    # średnia: zakres 1–5
dane$wynik_suma <- rowSums(skala)                   # suma: zakres 6–30
round(sapply(dane[, c("wynik_sr", "wynik_suma")], function(x) c(M = mean(x), SD = sd(x))), 2)
# 3. Rzetelność: alfa i omega po odwróceniu oraz alfa przy zapomnianym odwróceniu
alfa <- function(x) { k <- ncol(x); k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) }
f <- psych::fa(skala, nfactors = 1)                 # model jednoczynnikowy
omega <- sum(f$loadings)^2 / (sum(f$loadings)^2 + sum(f$uniquenesses))
round(c(alfa = alfa(skala), omega = omega, alfa_bez_odwrocenia = alfa(dane[, 1:6])), 3)
Wynik w R
        p1   p2   p3   p4 p5   p6
Mdn    4.0  3.0  3.0  4.0  2  2.0
zgoda 61.3 22.9 34.6 52.9 20 19.6
   wynik_sr wynik_suma
M      3.15      18.88
SD     0.84       5.03
               alfa               omega alfa_bez_odwrocenia
              0.821               0.824              -0.115
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; omegę policzono z modelu jednoczynnikowego (funkcja fa() z pakietu psych), a rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Nazywanie jednego pytania „skalą Likerta” – pojedyncza pozycja to pozycja Likerta; nie licz dla niej alfy Cronbacha i nie interpretuj jej jak wyniku skali.
- Kodowanie „nie wiem” jako środka skali – brak opinii to nie postawa neutralna; zakoduj go jako brak danych i podaj odsetek.
- Pominięcie odwrócenia pozycji – w przykładzie alfa spadła z .82 do −.11. Sprawdzaj znak korelacji każdej pozycji z resztą skali.
- Sumowanie pozycji bez uzasadnienia – połączenie pozycji w skalę wymaga dowodów rzetelności lub struktury (Sullivan i Artino, 2013).
- Sama średnia dla pojedynczej pozycji – średnia 3 może oznaczać, że wszyscy wybrali środek albo że połowa wybrała 1, a połowa 5; pokaż rozkład.
- Suma przy brakujących odpowiedziach – osoba z jedną pustą pozycją dostaje zaniżony wynik; użyj średniej z ustaloną regułą braków.
- Zmiana formatu gotowego kwestionariusza – inna liczba kategorii lub inne etykiety niż w oryginale utrudniają porównanie z normami i badaniami walidacyjnymi.
Najczęstsze pytania
Co to jest skala Likerta?
To narzędzie złożone z kilku lub kilkunastu stwierdzeń, do których osoba badana odnosi się na uporządkowanej skali zgody, np. od 1 = „zdecydowanie się nie zgadzam” do 5 = „zdecydowanie się zgadzam”. Wynikiem jest suma lub średnia odpowiedzi na wszystkie pozycje. Pojedyncze stwierdzenie z takim formatem odpowiedzi to pozycja Likerta, a nie skala.
Czy skala Likerta jest porządkowa czy ilościowa?
Odpowiedzi na pojedynczą pozycję są porządkowe – opisuj je rozkładem i medianą. Wynik całej skali, czyli sumę lub średnią kilku pozycji o sprawdzonej rzetelności, zwykle analizuje się jak zmienną ilościową (test t, ANOVA, korelacja Pearsona). Przy pojedynczych pozycjach i wątpliwościach co do metryki rozważ modele porządkowe, np. regresję porządkową.
Jak obliczyć wynik skali Likerta – suma czy średnia?
Najpierw odwróć pozycje sformułowane przeciwnie, potem zsumuj lub uśrednij odpowiedzi. Przy kompletnych danych obie wersje dają identyczne wyniki testów, ale średnia zachowuje metrykę odpowiedzi (np. 1–5) i lepiej znosi pojedyncze braki. Sumę stosuj wtedy, gdy wymagają tego normy lub klucz z podręcznika testu.
Jak odwrócić pozycje w skali Likerta?
Użyj wzoru x′ = (min + max) − x: dla skali 1–5 to 6 − x, a dla skali 1–7 – 8 − x. W R: dane$p3r <- 6 - dane$p3, w SPSS: Przekształcenia → Rekoduj na inne zmienne. Po przekodowaniu sprawdź, czy korelacja pozycji z resztą skali jest dodatnia.
Co zrobić z odpowiedzią „nie wiem” w skali Likerta?
Odpowiedź „nie wiem” oznacza brak wiedzy lub opinii, a nie postawę neutralną, więc nie koduj jej jako środka skali. Zakoduj ją jako brak danych, podaj, jak często ją wybierano, i ustal regułę liczenia wyniku przy brakach. W kwestionariuszu oddziel ją wizualnie od pozostałych kategorii.
Ile stopni powinna mieć skala Likerta?
Najczęściej stosuje się 5 lub 7 kategorii, ale wybór zależy od respondentów, sposobu prowadzenia badania i formatu gotowego kwestionariusza, który warto zachować. Szczegółową tabelę decyzyjną znajdziesz w poradniku ile stopni skali Likerta wybrać.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza ankiety satysfakcji pacjentów
Rozkład pozycji Likerta, top-box z 95% CI, alfa i omega, efekt sufitu, porównanie oddziałów, pytania otwarte – z danymi do pobrania, kodem R i opisem APA.
Czytaj →PoradnikIle stopni skali Likerta wybrać?
4, 5, 7 czy więcej punktów: co mówią badania, środek skali, etykiety, tabela decyzyjna, symulacja w R i wzór opisu do pracy.
Czytaj →PoradnikJak zrobić ankietę do pracy dyplomowej
12 kroków od hipotez do czystych danych: skale, pytania, zgoda, pilotaż, Google Forms czy LimeSurvey, książka kodów, harmonogram i lista kontrolna.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikSkala Likerta: średnia czy mediana?
Pozycja jest porządkowa, wynik skali – zwykle ilościowy. Kiedy mediana i odsetki, kiedy M, SD i test t, z przykładem w R i opisem APA.
Czytaj →PoradnikOdpowiedzi Likerta w raporcie
Tabela odsetków, odpowiedź „nie wiem”, wykres rozbieżny w ggplot2 i porównanie grup z poprawką Holma – z kodem R i wzorem opisu.
Czytaj →PoradnikPytania matrycowe (siatki) w ankiecie
Kiedy siatka wystarcza, a kiedy zawyża alfę i korelacje między skalami: wyniki eksperymentów, zasady projektu i symulacja w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Jamieson, S. (2004). Likert scales: How to (ab)use them. Medical Education, 38(12), 1217–1218. https://doi.org/10.1111/j.1365-2929.2004.02012.x
- Krosnick, J. A. (1991). Response strategies for coping with the cognitive demands of attitude measures in surveys. Applied Cognitive Psychology, 5(3), 213–236. https://doi.org/10.1002/acp.2350050305
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 5–55. https://archive.org/details/likert-1932
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
Cytowania BibTeX
@article{jamieson2004likert, author={Jamieson, Susan}, title={{Likert scales: How to (ab)use them}}, journal={Medical Education}, year={2004}, volume={38}, number={12}, pages={1217--1218}, doi={10.1111/j.1365-2929.2004.02012.x}}@article{krosnick1991response, author={Krosnick, Jon A.}, title={{Response strategies for coping with the cognitive demands of attitude measures in surveys}}, journal={Applied Cognitive Psychology}, year={1991}, volume={5}, number={3}, pages={213--236}, doi={10.1002/acp.2350050305}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{likert1932technique, author={Likert, Rensis}, title={{A technique for the measurement of attitudes}}, journal={Archives of Psychology}, year={1932}, volume={22}, number={140}, pages={5--55}, url={https://archive.org/details/likert-1932}}@article{norman2010likert, author={Norman, Geoff}, title={{Likert scales, levels of measurement and the “laws” of statistics}}, journal={Advances in Health Sciences Education}, year={2010}, volume={15}, number={5}, pages={625--632}, doi={10.1007/s10459-010-9222-y}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}