Co to jest skala nominalna?
Skala nominalna (ang. nominal scale, nazywana też skalą nazw) to najniższy poziom pomiaru. Przypisuje osoby lub obiekty do kategorii, które różnią się rodzajem, a nie ilością ani kolejnością. Jedyne, co można o dwóch osobach powiedzieć, to czy należą do tej samej kategorii, czy do różnych. Zmienną mierzoną w ten sposób nazywa się zmienną nominalną, jakościową albo kategorialną nieuporządkowaną.
Podział na poziomy pomiaru pochodzi od Stevensa (1946), który wyróżnił skale nominalną, porządkową, interwałową i ilorazową. Na skali nominalnej liczby służą wyłącznie jako etykiety – równie dobrze można by użyć liter albo słów. Stevens sformułował dla niej jedną regułę: nie nadawaj tej samej liczby różnym kategoriom ani różnych liczb tej samej kategorii. Wyższe poziomy dokładają kolejność (skala porządkowa) oraz równe jednostki i zero (skala ilościowa, czyli interwałowa i ilorazowa). Zmienna nominalna z dwiema kategoriami to szczególny przypadek – skala dychotomiczna.
| Zmienna | Przykładowe kategorie | Na co uważać |
|---|---|---|
| Kierunek studiów | psychologia, pedagogika, informatyka | Przy wielu kierunkach dodaj kategorię „inny” |
| Warunek eksperymentalny | trening uważności, relaksacja, lista oczekujących | Kategorie tworzy badacz – to zmienna niezależna |
| Forma terapii | poznawczo-behawioralna, psychodynamiczna, systemowa | Nie mieszaj z formą kontaktu (online czy w gabinecie) – to inny wymiar |
| Rozpoznanie | zaburzenia lękowe, depresyjne, odżywiania | Gdy rozpoznania współwystępują, każde koduj jako osobną zmienną 0/1 |
| Stan cywilny | kawaler/panna, w związku małżeńskim, rozwiedziony/a, wdowiec/wdowa | Sprawdź, czy kategorie obejmują wszystkich badanych |
Jak tworzyć kategorie?
Jakość pomiaru nominalnego zależy od listy kategorii. Zanim wpiszesz ją do kwestionariusza albo metryczki, sprawdź cztery warunki:
- rozłączność – każda osoba pasuje do dokładnie jednej kategorii;
- wyczerpywalność – kategorie obejmują wszystkich; gdy nie masz pewności, dodaj „inne (jakie?)” albo „nie dotyczy”;
- jedna zasada podziału – lista „terapia online, terapia poznawczo-behawioralna, grupa wsparcia” miesza formę kontaktu z nurtem terapii;
- jedna odpowiedź na zmienną – jeśli pytanie dopuszcza kilka odpowiedzi, każda opcja staje się osobną zmienną tak/nie (zob. kafeteria odpowiedzi).
Kategorie często powstają też z kodowania odpowiedzi na pytania otwarte. Wtedy dwie osoby powinny niezależnie zakodować przynajmniej część materiału, a ich zgodność warto ocenić współczynnikiem kappa – klasyczną miarą zgodności dla skal nominalnych (Cohen, 1960; zob. kappa Cohena).
Uwaga na kategorie, które mają kolejność. „Wieś, małe miasto, duże miasto” jest zmienną nominalną, gdy interesuje cię typ miejscowości, ale porządkową, gdy pytasz o jej wielkość. O poziomie pomiaru decyduje więc także pytanie badawcze.
Kodowanie: liczby to tylko etykiety
W pliku danych kategorie zwykle zapisuje się liczbami: 1 = terapia w gabinecie, 2 = terapia online itd. Ta numeracja jest dowolna i każda inna, która spełnia regułę Stevensa, przenosi tę samą informację. Dlatego średnia, mediana i odchylenie standardowe kodów nie mają sensu – średniej arytmetycznej nie da się obliczyć dla danych nominalnych (Manikandan, 2011). W przykładzie poniżej „średnia forma pomocy” wynosi 2.10 przy jednej numeracji i 2.31 przy innej, choć dane się nie zmieniły. Dominanta i odsetki zostają takie same.
W praktyce:
- w R zapisz zmienną jako czynnik (
factor()) z etykietami kategorii; - w SPSS ustaw w Widoku zmiennych (kolumna Measure) poziom Nominal i nadaj etykiety wartości;
- w modelach regresji zamień zmienną na k − 1 zmiennych zero-jedynkowych z kategorią odniesienia (dummy coding);
- zmiany kodów i łączenie kategorii wykonuj skryptem i opisz w księdze kodów (zob. rekodowanie i poradnik dane z Google Forms i LimeSurvey do SPSS i R).
Jakie statystyki są dozwolone?
Stevens (1946) wymienił dla skali nominalnej trzy rodzaje statystyk: liczbę przypadków, dominantę i miary związku oparte na tabeli kontyngencji. Współcześnie odpowiada im zestaw:
| Cel | Co policzyć |
|---|---|
| Opis jednej zmiennej | Liczebności, odsetki, dominanta |
| Wykres | Wykres słupkowy – kolejność słupków jest dowolna, najczytelniej malejąco |
| Porównanie rozkładu z oczekiwanym | Test chi-kwadrat zgodności |
| Związek dwóch zmiennych nominalnych | Tabela krzyżowa, test χ² niezależności, V Craméra (φ dla tabeli 2 × 2) |
| Zgodność dwóch oceniających | Kappa Cohena |
| Zmienna nominalna jako predyktor | ANOVA albo regresja ze zmiennymi zero-jedynkowymi |
| Zmienna nominalna jako zmienna zależna | Regresja logistyczna (wielomianowa przy więcej niż dwóch kategoriach) |
Test χ² mówi tylko, czy związek jest istotny statystycznie, dlatego należy go uzupełnić miarą siły związku, najczęściej V Craméra (McHugh, 2013). φ i iloraz szans stosuje się do tabel 2 × 2, a przy większych tabelach – V Craméra; test wymaga przy tym, by najwyżej 20% komórek miało liczebność oczekiwaną poniżej 5 i żadna nie spadała poniżej 1 (Kim, 2017).
Przykład: preferowana forma pomocy psychologicznej
Trzystu studentów (120 z psychologii, po 90 z pedagogiki i informatyki; dane symulowane) wskazało, z jakiej formy pomocy skorzystaliby w kryzysie: terapii w gabinecie, terapii online, grupy wsparcia albo aplikacji lub samopomocy. Rysunek 1 pokazuje rozkład odpowiedzi.
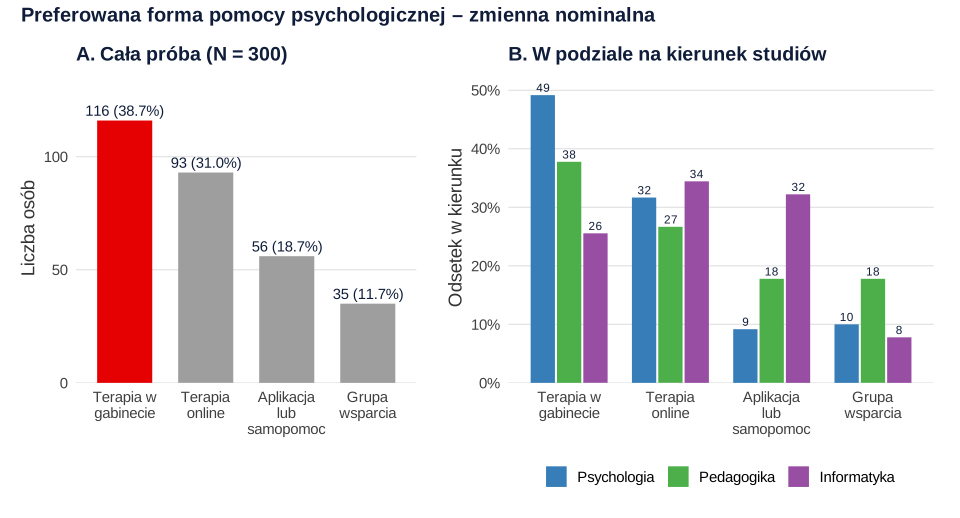
Dominantą jest terapia w gabinecie (n = 116; 38.7%), dalej terapia online (n = 93; 31.0%), aplikacja lub samopomoc (n = 56; 18.7%) i grupa wsparcia (n = 35; 11.7%).
Czy preferencje zależą od kierunku studiów? Test niezależności dał χ²(6, N = 300) = 27.38, p < .001, a najmniejsza liczebność oczekiwana wyniosła 10.5, więc warunek liczebności jest spełniony. Siła związku: V = .21, 95% CI [.11, .28]. Reszty standaryzowane pokazują, skąd bierze się wynik: studenci psychologii częściej, niż wynikałoby z niezależności, wybierali terapię w gabinecie (+3.05) i rzadziej aplikację (−3.45), a studenci informatyki odwrotnie (−3.05 i +3.94).
Jak opisać wynik w pracy (APA)
Przy zmiennej nominalnej podaj liczebności i odsetki wszystkich kategorii, a przy teście χ² – stopnie swobody, N, wartość p i miarę siły związku. Wzór dla danych z przykładu:
Rozkład zmiennych nominalnych z metryczki zwykle zbiera się w tabeli charakterystyki próby – zob. jak opisać charakterystykę próby.
Przykład w R
Kod tworzy dane z przykładu, opisuje zmienną nominalną, pokazuje, że „średnia kodów” zależy od dowolnej numeracji, i bada związek z kierunkiem studiów. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Częstości, dominanta, test χ² i V Craméra
R
set.seed(91)
formy <- c("Terapia w gabinecie", "Terapia online", "Grupa wsparcia", "Aplikacja lub samopomoc")
kierunki <- c("Psychologia", "Pedagogika", "Informatyka")
n_k <- c(120, 90, 90)                                      # liczebności kierunków
p_k <- list(c(.42, .26, .18, .14), c(.40, .24, .22, .14), c(.24, .34, .08, .34))
dane <- do.call(rbind, lapply(1:3, function(k)
  data.frame(kierunek = kierunki[k], forma = sample(formy, n_k[k], replace = TRUE, prob = p_k[[k]]))))
dane$kierunek <- factor(dane$kierunek, levels = kierunki)  # factor = zmienna nominalna
dane$forma <- factor(dane$forma, levels = formy)
# 1. Liczebności, odsetki i dominanta
tab <- table(dane$forma)
cbind(n = tab, proc = round(100 * prop.table(tab), 1))
names(tab)[which.max(tab)]
# 2. Kody to tylko etykiety: dwa równie dobre kodowania, dwie różne „średnie”
kod_a <- as.integer(dane$forma)                            # 1, 2, 3, 4 w kolejności z kwestionariusza
kod_b <- c(3, 1, 4, 2)[kod_a]                              # inna, równie dowolna numeracja
round(c(srednia_A = mean(kod_a), srednia_B = mean(kod_b)), 2)
# 3. Kierunek studiów a forma pomocy: test chi-kwadrat i V Craméra
tk <- table(dane$kierunek, dane$forma)
chi <- chisq.test(tk)
chi
round(min(chi$expected), 1)                                # najmniejsza liczebność oczekiwana
round(chi$stdres, 2)                                       # reszty standaryzowane: skąd bierze się związek
round(DescTools::CramerV(tk, conf.level = 0.95), 2)
Wynik w R
                          n proc
Terapia w gabinecie     116 38.7
Terapia online           93 31.0
Grupa wsparcia           35 11.7
Aplikacja lub samopomoc  56 18.7
[1] "Terapia w gabinecie"
srednia_A srednia_B
     2.10      2.31

	Pearson's Chi-squared test

data:  tk
X-squared = 27.381, df = 6, p-value = 0.0001229

[1] 10.5

              Terapia w gabinecie Terapia online Grupa wsparcia
  Psychologia                3.05           0.20          -0.73
  Pedagogika                -0.21          -1.06           2.16
  Informatyka               -3.05           0.84          -1.37

              Aplikacja lub samopomoc
  Psychologia                   -3.45
  Pedagogika                    -0.26
  Informatyka                    3.94
Cramer V   lwr.ci   upr.ci
    0.21     0.11     0.28
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; V Craméra z przedziałem ufności policzono w pakiecie DescTools, a rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Średnia lub mediana kodów – „średnia forma pomocy = 2.10” nic nie znaczy; po zmianie numeracji wynosi 2.31.
- Kody kategorii wpisane do regresji jak liczby – model zakłada wtedy, że „aplikacja” (4) leży trzy razy dalej od „gabinetu” (1) niż „terapia online” (2). Użyj zmiennych zero-jedynkowych.
- Korelacja Pearsona lub Spearmana z kodami – ich wartość zależy od arbitralnej numeracji. Do związku dwóch zmiennych nominalnych służą χ² i V.
- Kategorie nierozłączne lub niepełne – brak opcji „inne” albo dwie zasady podziału w jednym pytaniu.
- Test χ² przy zbyt małych liczebnościach oczekiwanych albo łączenie kategorii dopiero po obejrzeniu wyników, bez zapowiedzianej reguły.
- Same odsetki bez liczebności – „60% badanych” przy N = 15 i przy N = 1500 to zupełnie inna informacja.
Najczęstsze pytania
Co to jest skala nominalna?
To najniższy poziom pomiaru, na którym kategorie różnią się rodzajem, a nie ilością ani kolejnością – np. kierunek studiów, forma terapii czy warunek eksperymentalny. Liczby nadane kategoriom w pliku danych są tylko etykietami i można je dowolnie zamienić. Kategorie muszą być rozłączne i obejmować wszystkich badanych.
Czy na skali nominalnej można policzyć średnią?
Nie. Średnia kodów zależy od tego, jak ponumerowano kategorie: w przykładzie na tej stronie „średnia forma pomocy” wynosi 2.10 przy jednej numeracji i 2.31 przy innej, choć dane się nie zmieniły. Zmienną nominalną opisuj liczebnościami, odsetkami i dominantą.
Jaki test statystyczny dla zmiennych nominalnych?
Związek dwóch zmiennych nominalnych sprawdzisz testem chi-kwadrat niezależności i opiszesz współczynnikiem V Craméra (dla tabeli 2 × 2 – φ). Gdy zmienna nominalna jest predyktorem, a zmienna zależna jest ilościowa, użyj ANOVA; gdy zmienna nominalna jest zmienną zależną – regresji logistycznej.
Czym różni się skala nominalna od porządkowej?
Na skali nominalnej kategorie tylko się rozróżnia, a na skali porządkowej można je także uporządkować od mniejszego do większego nasilenia, np. wykształcenie albo odpowiedź „rzadko – często”. O wyborze czasem decyduje pytanie badawcze: typ miejscowości jest nominalny, ale jej wielkość – porządkowa.
Jak zakodować zmienną nominalną w SPSS i w R?
W SPSS nadaj kategoriom liczby, w Widoku zmiennych ustaw w kolumnie Measure poziom Nominal i dodaj etykiety wartości. W R zapisz zmienną jako czynnik: factor(x, levels = …, labels = …). W regresji zamień ją na k − 1 zmiennych zero-jedynkowych z kategorią odniesienia (dummy coding).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikAnaliza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- Manikandan, S. (2011). Measures of central tendency: The mean. Journal of Pharmacology and Pharmacotherapeutics, 2(2), 140–142. https://doi.org/10.4103/0976-500X.81920 ● Otwarty dostęp: pełny tekst
- McHugh, M. L. (2013). The chi-square test of independence. Biochemia Medica, 23(2), 143–149. https://doi.org/10.11613/BM.2013.018 ● Otwarty dostęp
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Cytowania BibTeX
@article{cohen1960coefficient, author={Cohen, Jacob}, title={{A coefficient of agreement for nominal scales}}, journal={Educational and Psychological Measurement}, year={1960}, volume={20}, number={1}, pages={37--46}, doi={10.1177/001316446002000104}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{manikandan2011mean, author={Manikandan, S.}, title={{Measures of central tendency: The mean}}, journal={Journal of Pharmacology and Pharmacotherapeutics}, year={2011}, volume={2}, number={2}, pages={140--142}, doi={10.4103/0976-500x.81920}}@article{mchugh2013chi, author={McHugh, Mary L.}, title={{The chi-square test of independence}}, journal={Biochemia Medica}, year={2013}, volume={23}, number={2}, pages={143--149}, doi={10.11613/bm.2013.018}}@article{stevens1946theory, author={Stevens, S. S.}, title={{On the theory of scales of measurement}}, journal={Science}, year={1946}, volume={103}, number={2684}, pages={677--680}, doi={10.1126/science.103.2684.677}}