Co to jest skala standaryzowana?
Skala standaryzowana (skala wyników standardowych, ang. standard score scale) to skala, na której wynik testu wyraża się jako odległość od średniej grupy odniesienia, mierzoną w jej odchyleniach standardowych, a następnie zapisuje w umownych jednostkach o z góry ustalonej średniej i odchyleniu standardowym. Wszystkie takie skale są przekształceniem tego samego wyniku z:
Mnorm i SDnorm pochodzą z próby normalizacyjnej (zob. normy testowe), a M′ i SD′ to stałe wybranej skali. Andrade (2021) przypomina, że wynik z mówi, o ile odchyleń standardowych wynik leży powyżej lub poniżej średniej, i że przy interpretacji względem norm używa się średniej i SD populacji odniesienia, a nie własnej próby. Skala standaryzowana nie jest więc cechą testu, lecz sposobem zapisu wyniku surowego względem konkretnej grupy porównawczej.
Najczęściej używane skale standaryzowane
| Skala | M′ | SD′ | Zapis i zakres | Gdzie spotkasz |
|---|---|---|---|---|
| Wynik z | 0 | 1 | Liczby ujemne i dziesiętne | Obliczenia, porównania między testami |
| Skala tenowa (T) | 50 | 10 | Liczby całkowite, zwykle 20–80 | Kwestionariusze osobowości i objawów |
| Skala IQ (dewiacyjna) | 100 | 15 | Liczby całkowite, zwykle 55–145 | Testy inteligencji i zdolności |
| Skala stenowa | 5.5 | 2 | 1–10, przedziały po 0.5 SD | Kwestionariusze w diagnozie i doborze |
| Skala staninowa | 5 | 2 | 1–9, przedziały po 0.5 SD (skrajne otwarte) | Testy szkolne i osiągnięć |
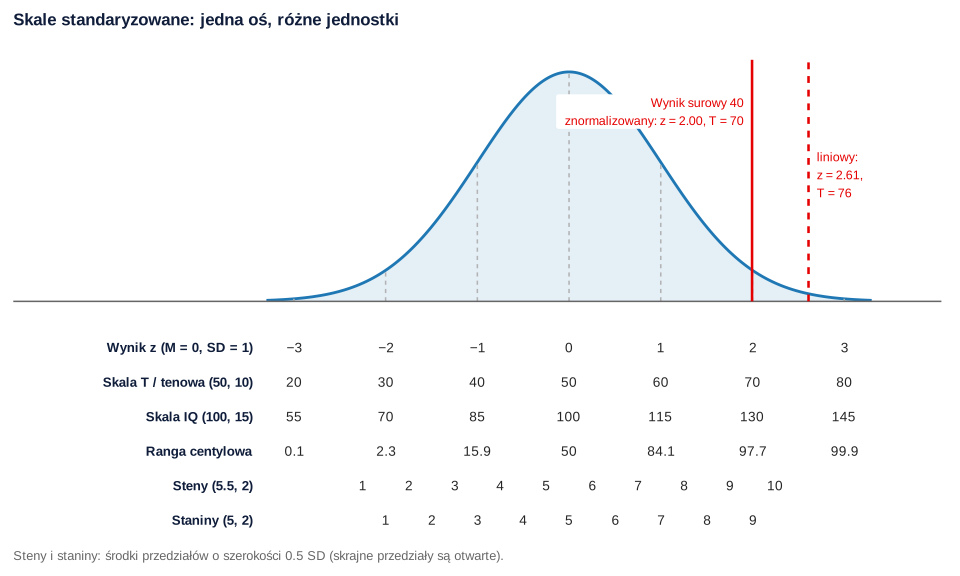
Wszystkie przedstawiają tę samą informację – położenie wyniku w rozkładzie grupy odniesienia (rysunek 1). Różnią się precyzją: z, T i IQ zachowują drobne różnice, a steny i staniny łączą wiele wyników surowych w jedną kategorię. Ranga centylowa (zob. percentyl) też opisuje położenie wyniku, ale nie jest skalą standaryzowaną w tym sensie: nie ma stałego odchylenia standardowego, a odległości centylowe w środku rozkładu są „ściśnięte”, na krańcach – „rozciągnięte”.
Skala liniowa czy znormalizowana
Wynik z można uzyskać na dwa sposoby, a różnica ma znaczenie, gdy rozkład wyników w normach jest skośny:
- przekształcenie liniowe – wzór powyżej; zachowuje kształt rozkładu surowego, więc przy skośnym rozkładzie wynik T = 70 nie musi oznaczać, że niżej leży 97.7% populacji;
- przekształcenie normalizujące – najpierw ustala się rangę centylową wyniku w próbie normalizacyjnej, a potem odczytuje odpowiadającą jej wartość z z rozkładu normalnego (zob. wynik znormalizowany i normalizacja). Wtedy relacja „wynik standaryzowany – odsetek populacji poniżej” zgadza się z krzywą normalną.
Soloman i Sawilowsky (2009) porównali kilka rangowych przekształceń normalizujących i najdokładniejsze okazało się przekształcenie rankit; zaznaczają jednak, że małe próby i skośne rozkłady pogarszają działanie każdej metody. Nowoczesne normy coraz częściej buduje się metodami ciągłymi, które modelują zależność wyników od wieku zamiast osobnych tablic dla przedziałów wiekowych – Lenhard i Lenhard (2021) pokazują, że daje to dokładniejsze normy przy mniejszych próbach.
Przykład: wynik 40 punktów w skośnym kwestionariuszu
W próbie normalizacyjnej 1000 dorosłych (dane symulowane) kwestionariusz objawów lęku (0–60 punktów) ma rozkład prawoskośny: M = 17.02, SD = 8.80, skośność 1.08. Interpretujemy wynik surowy 40.
| Skala | Przekształcenie liniowe | Przekształcenie normalizujące |
|---|---|---|
| Wynik z | 2.61 | 2.00 |
| Skala T | 76 | 70 |
| Skala IQ (100, 15) | 139 | 130 |
| Sten | 10 | 9 |
| Stanin | 9 | 9 |
| Odsetek populacji z wynikiem niższym | 99.5% (wg krzywej normalnej) | 97.7% (faktycznie w normach) |
Przekształcenie liniowe daje T = 76, co sugeruje wynik wyższy niż u 99.5% populacji. W rzeczywistości w próbie normalizacyjnej niższy wynik miało 97.7% osób – i to odpowiada T = 70 z normalizacji. Przy prawoskośnym rozkładzie skala liniowa przesadza na prawym krańcu. Sten zmienia się z 10 na 9, stanin pozostaje 9.
Precyzja. Każdy wynik testu jest obarczony błędem pomiaru. Przy rzetelności .88 błąd standardowy pomiaru w skali T wynosi 10 × √(1 − .88) = 3.5 punktu, więc 95% przedział dla T = 70 to około 63–77 (dokładnie 63.2–76.7 w kodzie). Crawford i Garthwaite (2009) zalecają, by obok wyników standaryzowanych podawać rangę centylową, a granice przedziału ufności wyrażać także w centylach. Gruboziarniste skale ukrywają tę niepewność w drugą stronę: w tych normach wyniki surowe od 20 do 25 dają ten sam sten 7, a 26 – już sten 8. Jeden punkt surowy może zmienić kategorię opisu, a sześć punktów – nie zmienić niczego.
Jak opisać wynik w pracy
W metodzie podaj, jakie normy zastosowano (populacja, rok, wiek, płeć), czy przekształcenie było liniowe czy normalizujące i na jaką skalę przeliczono wyniki. W opisie indywidualnym dodaj rangę centylową i przedział ufności. Wzór:
W badaniach grupowych, gdy porównujesz średnie, zwykle lepiej analizować wyniki surowe albo wyniki T niż steny – kategorie 1–10 tracą informację. Jeśli w pracy porównujesz zmienne o różnych jednostkach, standaryzację względem własnej próby opisuje hasło standaryzacja zmiennej; nie myl jej z przeliczaniem na normy. Proces tworzenia norm i skal dla nowego narzędzia omawia poradnik jak zbudować i zwalidować skalę psychometryczną.
Przykład w R
Kod tworzy próbę normalizacyjną, przelicza wynik surowy 40 liniowo i z normalizacją na pięć skal standaryzowanych, porównuje odsetki z krzywej normalnej i z norm, liczy przedział ufności w skali T i pokazuje, jak steny łączą sąsiednie wyniki surowe. Liczby w tekście, tabeli i na rysunku 1 pochodzą z tego kodu.
Przeliczanie wyniku surowego na skale standaryzowane
R
# Dane symulowane: próba normalizacyjna 1000 osób dorosłych, kwestionariusz objawów lęku (wynik surowy 0–60),
# rozkład prawoskośny; interpretujemy wynik surowy jednej osoby: 40 punktów
set.seed(2271)
normy <- round(pmin(60, rgamma(1000, shape = 4, scale = 4.2)))
M <- mean(normy); SD <- sd(normy)
round(c(M = M, SD = SD, skosnosc = mean((normy - M)^3) / SD^3), 2)
x <- 40

# 1. Przekształcenie liniowe: wynik z, a z niego dowolna skala standaryzowana X' = M' + SD' * z
z_lin <- (x - M) / SD
skale <- function(z) c(z = z, T = 50 + 10 * z, IQ = 100 + 15 * z,
                       sten = min(10, max(1, round(5.5 + 2 * z))), stanin = min(9, max(1, round(5 + 2 * z))))
round(skale(z_lin), 2)

# 2. Przekształcenie normalizujące: ranga centylowa w próbie normalizacyjnej -> kwantyl rozkładu normalnego
pr <- (sum(normy < x) + 0.5 * sum(normy == x)) / length(normy)   # ranga centylowa (środek przedziału)
z_norm <- qnorm(pr)
round(c(ranga_centylowa = 100 * pr, z_znormalizowany = z_norm), 2)
round(skale(z_norm), 2)

# 3. Ten sam wynik z w liniowej skali: jaki odsetek populacji leży niżej? (zakłada rozkład normalny)
round(100 * c(z_liniowe_wg_krzywej_normalnej = pnorm(z_lin), faktycznie_w_normach = pr), 1)

# 4. Precyzja: błąd standardowy pomiaru w jednostkach skali T przy rzetelności .88 i 95% przedział ufności
rel <- .88
SEM_T <- 10 * sqrt(1 - rel)
T_norm <- 50 + 10 * z_norm
round(c(SEM_T = SEM_T, dolna = T_norm - 1.96 * SEM_T, gorna = T_norm + 1.96 * SEM_T), 1)

# 5. Gruboziarnistość stenów: wyniki surowe 20–30 w stenach (normy znormalizowane)
st <- sapply(20:30, function(w) { p <- (sum(normy < w) + 0.5 * sum(normy == w)) / length(normy); min(10, max(1, round(5.5 + 2 * qnorm(p)))) })
setNames(st, 20:30)
Wynik w R
       M       SD skosnosc
   17.02     8.80     1.08
     z      T     IQ   sten stanin
  2.61  76.11 139.17  10.00   9.00
 ranga_centylowa z_znormalizowany
            97.7              2.0
     z      T     IQ   sten stanin
  2.00  69.95 129.93   9.00   9.00
z_liniowe_wg_krzywej_normalnej           faktycznie_w_normach
                          99.5                           97.7
SEM_T dolna gorna
  3.5  63.2  76.7
20 21 22 23 24 25 26 27 28 29 30
 7  7  7  7  7  7  8  8  8  8  8
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunek przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Interpretowanie wyniku standaryzowanego bez grupy odniesienia. T = 70 w normach dla studentów i w normach dla populacji ogólnej to różne informacje. Zawsze podaj, czyje to normy.
- Odczytywanie odsetków z krzywej normalnej przy liniowej skali i skośnym rozkładzie. W przykładzie dawało to 99.5% zamiast faktycznych 97.7%.
- Standaryzacja względem własnej próby nazwana „wynikiem według norm”. Wynik z policzony na 80 osobach z badania mówi o położeniu w tej próbie, nie w populacji.
- Traktowanie stenów jak precyzyjnych pomiarów. Różnica jednego stena może wynikać z jednego punktu surowego; liczenie średnich i testów na stenach traci informację.
- Brak przedziału ufności w diagnozie indywidualnej. Wynik T = 70 przy rzetelności .88 jest zgodny z wartościami od około 63 do 77.
- Stare lub niedopasowane normy. Przy małej próbie normalizacyjnej Crawford i Howell (1998) zalecają porównywać wynik osoby z normami zmodyfikowanym testem t zamiast prostego przeliczenia na z.
Najczęstsze pytania
Jak przeliczyć wynik surowy na skalę standaryzowaną?
Policz wynik z = (X − M)/SD, używając średniej i odchylenia standardowego z norm, a potem przelicz go na wybraną skalę: T = 50 + 10z, IQ = 100 + 15z, sten = 5.5 + 2z, stanin = 5 + 2z (steny i staniny zaokrąglasz i ograniczasz do zakresu skali).
Czym różni się skala liniowa od znormalizowanej?
Liniowa zachowuje kształt rozkładu wyników surowych, więc przy skośnym rozkładzie nie da się z niej odczytać odsetków z krzywej normalnej. Znormalizowana wychodzi od rangi centylowej i przypisuje jej wartość z z rozkładu normalnego. W przykładzie na tej stronie ten sam wynik surowy dał T = 76 liniowo i T = 70 po normalizacji.
Która skala standaryzowana jest najdokładniejsza?
Wynik z, skala T i skala IQ zachowują drobne różnice między wynikami. Steny i staniny łączą wiele wyników surowych w jedną kategorię – są czytelne w diagnozie, ale tracą informację w analizach statystycznych.
Czy wyniki z mojej próby można przeliczyć na skalę T bez norm?
Technicznie tak, ale taki wynik mówi tylko o położeniu osoby w Twojej próbie, a nie w populacji. Nie nazywaj go wynikiem według norm; w opisie napisz, że standaryzowano względem własnej próby.
Dlaczego przy wyniku standaryzowanym podaje się przedział ufności?
Bo każdy wynik testu zawiera błąd pomiaru. Przy rzetelności .88 błąd standardowy pomiaru w skali T wynosi 3.5 punktu, więc wynik T = 70 jest zgodny z wartościami od około 63 do 77.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Andrade, C. (2021). Z scores, standard scores, and composite test scores explained. Indian Journal of Psychological Medicine, 43(6), 555–557. https://doi.org/10.1177/02537176211046525 ● Otwarty dostęp
- Crawford, J. R., & Garthwaite, P. H. (2009). Percentiles please: The case for expressing neuropsychological test scores and accompanying confidence limits as percentile ranks. The Clinical Neuropsychologist, 23(2), 193–204. https://doi.org/10.1080/13854040801968450
- Crawford, J. R., & Howell, D. C. (1998). Comparing an individual’s test score against norms derived from small samples. The Clinical Neuropsychologist, 12(4), 482–486. https://doi.org/10.1076/clin.12.4.482.7241
- Lenhard, W., & Lenhard, A. (2021). Improvement of norm score quality via regression-based continuous norming. Educational and Psychological Measurement, 81(2), 229–261. https://doi.org/10.1177/0013164420928457 ● Otwarty dostęp
- Soloman, S. R., & Sawilowsky, S. S. (2009). Impact of rank-based normalizing transformations on the accuracy of test scores. Journal of Modern Applied Statistical Methods, 8(2), Article jmasm.eP1519. https://doi.org/10.22237/jmasm/1257034080 ● Otwarty dostęp
Cytowania BibTeX
@article{andrade2021z, author={Andrade, Chittaranjan}, title={{Z scores, standard scores, and composite test scores explained}}, journal={Indian Journal of Psychological Medicine}, year={2021}, volume={43}, number={6}, pages={555--557}, doi={10.1177/02537176211046525}}@article{crawford2009percentiles, author={Crawford, John R. and Garthwaite, Paul H.}, title={{Percentiles please: The case for expressing neuropsychological test scores and accompanying confidence limits as percentile ranks}}, journal={The Clinical Neuropsychologist}, year={2009}, volume={23}, number={2}, pages={193--204}, doi={10.1080/13854040801968450}}@article{crawford1998comparing, author={Crawford, John R. and Howell, David C.}, title={{Comparing an individual’s test score against norms derived from small samples}}, journal={The Clinical Neuropsychologist}, year={1998}, volume={12}, number={4}, pages={482--486}, doi={10.1076/clin.12.4.482.7241}}@article{lenhard2021improvement, author={Lenhard, Wolfgang and Lenhard, Alexandra}, title={{Improvement of norm score quality via regression-based continuous norming}}, journal={Educational and Psychological Measurement}, year={2021}, volume={81}, number={2}, pages={229--261}, doi={10.1177/0013164420928457}}@article{soloman2009impact, author={Soloman, Shira R. and Sawilowsky, Shlomo S.}, title={{Impact of rank-based normalizing transformations on the accuracy of test scores}}, journal={Journal of Modern Applied Statistical Methods}, year={2009}, volume={8}, number={2}, pages={448--462}, eid={jmasm.eP1519}, doi={10.22237/jmasm/1257034080}}