Co to jest skala porządkowa?
Skala porządkowa (ang. ordinal scale, nazywana też skalą rangową) pozwala uporządkować kategorie od mniejszego do większego nasilenia cechy, ale nie mówi, jak duże są odstępy między nimi. Wiadomo, że odpowiedź „bardzo” oznacza silniejszy stres niż „umiarkowanie”, ale nie wiadomo, o ile silniejszy – ani czy różnica „trochę – umiarkowanie” jest taka sama jak „bardzo – skrajnie”.
W klasyfikacji Stevensa (1946) skala porządkowa powstaje z operacji porządkowania: każde przekształcenie zachowujące kolejność (np. zamiana kodów 1, 2, 3, 4, 5 na 1, 2, 3, 4, 6) daje równie poprawny zapis tych samych danych. Stevens zauważył też, że większość skal używanych przez psychologów to skale porządkowe. Skala porządkowa ma wszystkie własności skali nominalnej i dokłada do nich kolejność; równych jednostek wymaga dopiero skala ilościowa.
| Zmienna | Kategorie | Dlaczego odstępy są nieznane |
|---|---|---|
| Wykształcenie | podstawowe, zasadnicze zawodowe, średnie, wyższe | Przejście z podstawowego do zawodowego to inna „odległość” niż ze średniego do wyższego |
| Pojedyncza pozycja skali Likerta | od „zdecydowanie się nie zgadzam” do „zdecydowanie się zgadzam” | Kategorie to etykiety słowne, nie jednostki |
| Pozycja dyferencjału semantycznego | 7 pól między przymiotnikami, np. „zimny” – „ciepły” | Opisane są tylko krańce, a równość odstępów między polami to założenie |
| Nasilenie objawów | brak, łagodne, umiarkowane, ciężkie | Granice kategorii ustala umowa kliniczna |
| Częstość zachowania | nigdy, rzadko, czasami, często | Osoby różnie rozumieją „rzadko” i „często” |
| Miejsce w rankingu | 1., 2., 3. miejsce | Pierwszego i drugiego może dzielić ułamek punktu albo przepaść (zob. rangowanie) |
| Przedziały wieku lub dochodu | 18–24, 25–34, 35–44 lata | To zgrubne kategorie liczby – lepiej pytać o dokładną wartość |
Jakie statystyki są dozwolone?
Na skali porządkowej sens mają statystyki, które nie zmieniają się, gdy kategoriom nada się inne liczby o tej samej kolejności. Stevens (1946) wymienił medianę i percentyle; medianę można wyznaczyć dla danych porządkowych, choć nie wykorzystuje ona całej informacji z danych (Manikandan, 2011). Średnie i odchylenia standardowe są według Stevensa obciążone błędem w takim stopniu, w jakim odstępy między kategoriami są nierówne.
| Cel | Co policzyć |
|---|---|
| Typowa wartość | Mediana (oraz dominanta) |
| Rozproszenie | Kwartyle, rozstęp ćwiartkowy |
| Pozycja osoby | Percentyl, ranga |
| Rozkład | Odsetki i odsetki skumulowane, wykres słupkowy |
| Dwie grupy niezależne | Test U Manna-Whitneya |
| Trzy grupy i więcej | Test Kruskala-Wallisa |
| Pomiary powtarzane | Test Wilcoxona, test Friedmana |
| Związek dwóch zmiennych | Korelacja Spearmana, tau Kendalla |
| Model z kilkoma predyktorami | Regresja porządkowa |
Korelację Spearmana stosuje się do danych porządkowych i wtedy, gdy interesuje nas związek monotoniczny, a nie liniowy (Schober i in., 2018). Przy kwartylach uważaj na interpolację: domyślna funkcja quantile() w R może zwrócić wartość „między” kategoriami, np. 3.5. Dla danych porządkowych użyj quantile(x, type = 1), która zawsze zwraca istniejącą kategorię.
Przykład: średnie zamieniają się miejscami
Po 70 studentów I i V roku (dane symulowane) odpowiedziało na pytanie „Jak bardzo stresujesz się przed sesją?” na skali: 1 = wcale, 2 = trochę, 3 = umiarkowanie, 4 = bardzo, 5 = skrajnie. Na I roku 57.1% osób wybrało „bardzo”, a tylko 2.9% – „skrajnie”. Na V roku odpowiedzi rozkładają się biegunowo: 20.0% nie stresuje się wcale, a 38.6% – skrajnie. Mediana wynosi 4 („bardzo”) na I roku i 3 („umiarkowanie”) na V roku, a kwartyle – odpowiednio 3–4 i 2–5.
Policzmy średnie. Przy kodach 1–5 wyższy stres ma I rok (M = 3.50 wobec 3.33). Wystarczy jednak przyjąć, że „skrajnie” leży dalej od „bardzo” niż pozostałe kategorie od siebie, i zakodować odpowiedzi jako 1, 2, 3, 4, 6. Kolejność kategorii się nie zmieniła, a średnie zamieniły się miejscami: 3.53 na I roku wobec 3.71 na V roku (rysunek 1). Test t Welcha zmienia znak z t = 0.81 na t = −0.71. Na skali porządkowej żadne z tych kodowań nie jest bardziej uprawnione od drugiego.
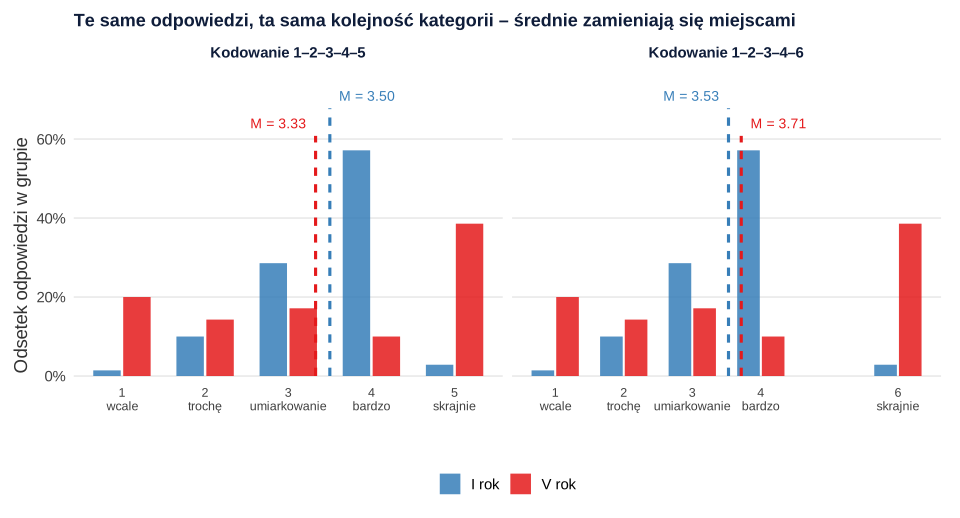
Odwrócenie jest możliwe, bo rozkłady się krzyżują: na V roku jest więcej osób zarówno spokojnych, jak i skrajnie zestresowanych. Gdyby jedna grupa odpowiadała wyżej w całym rozkładzie, każde kodowanie zachowujące kolejność dawałoby ten sam kierunek różnicy. Właśnie przed takimi wnioskami z danych porządkowych analizowanych jak metryczne – łącznie z odwróceniem kierunku efektu – ostrzegają Liddell i Kruschke (2018).
Test U Manna-Whitneya daje w obu kodowaniach identyczny wynik: U = 2433, p = .943. Test ten nie porównuje median, lecz szacuje, jak często osoba z jednej grupy odpowiada wyżej niż osoba z drugiej (Divine i in., 2018); tutaj to prawdopodobieństwo wynosi .50. Tak samo zachowuje się korelacja Spearmana z oceną jakości snu: rs = −.46 przy obu kodowaniach, podczas gdy r Pearsona zmienia się z −.46 na −.45. Najważniejszym wynikiem jest tu jednak sam rozkład: grupy różnią się nie tym, która stresuje się „bardziej”, lecz rozproszeniem odpowiedzi – i to trzeba opisać.
Pozycje Likerta: porządkowe czy ilościowe?
Odpowiedź na pojedynczą pozycję Likerta jest porządkowa. Wynik całej skali, czyli suma lub średnia wielu pozycji o sprawdzonej rzetelności, zwykle analizuje się jak zmienną ilościową, a metody parametryczne okazują się odporne na naruszenia założeń także przy danych ze skal Likerta (Norman, 2010). Z kolei Liddell i Kruschke (2018) pokazali, że modele metryczne zastosowane do danych porządkowych mogą dawać fałszywe alarmy i utratę mocy, a uśrednianie wielu pozycji nie zawsze to naprawia. Praktycznie: pojedynczą pozycję opisuj rozkładem i medianą, a gdy jest zmienną zależną – użyj regresji porządkowej. Szczegóły sporu: hasło skala Likerta.
Jak opisać wynik w pracy (APA)
Dla zmiennej porządkowej podaj medianę z kwartylami albo pełny rozkład odsetków, a przy teście rangowym – statystykę testu, p i miarę efektu. Wzór dla danych z przykładu:
Dobór testu do poziomu pomiaru i układu badania zbiera poradnik jak dobrać test statystyczny do hipotezy.
Przykład w R
Kod tworzy dane z przykładu, opisuje rozkład odpowiedzi w grupach, porównuje średnie przy dwóch kodowaniach i pokazuje, że test Manna-Whitneya i korelacja Spearmana od kodowania nie zależą. Liczby w tekście i na rysunku 1 pochodzą z tego kodu (testy t Welcha – w pełnym skrypcie strony).
Rozkład, kwartyle, dwa kodowania i testy rangowe
R
kat <- c("wcale", "trochę", "umiarkowanie", "bardzo", "skrajnie")
set.seed(3)
n <- 70
rok1 <- sample(1:5, n, replace = TRUE, prob = c(.03, .10, .28, .53, .06))   # stres przed sesją, I rok
rok5 <- sample(1:5, n, replace = TRUE, prob = c(.16, .16, .20, .13, .35))   # stres przed sesją, V rok
stres <- c(rok1, rok5)
grupa <- factor(rep(c("I rok", "V rok"), each = n))
sen <- pmin(pmax(round(5.2 - 0.55 * stres + rnorm(2 * n, 0, 1.1)), 1), 5)  # jakość snu 1–5
# 1. Rozkład w grupach (%) i kwartyle bez interpolacji (type = 1)
round(100 * prop.table(table(grupa, factor(stres, 1:5, kat)), 1), 1)
tapply(stres, grupa, quantile, probs = c(.25, .5, .75), type = 1)
# 2. Inne kodowanie o tej samej kolejności: 1, 2, 3, 4, 6
stresB <- c(1, 2, 3, 4, 6)[stres]
round(rbind(kody_1_5 = tapply(stres, grupa, mean), kody_1_2_3_4_6 = tapply(stresB, grupa, mean)), 2)
# 3. Test Manna-Whitneya: wynik identyczny w obu kodowaniach
sapply(list(kody_1_5 = stres, kody_1_2_3_4_6 = stresB), function(x)
  round(unlist(wilcox.test(x ~ grupa, exact = FALSE)[c("statistic", "p.value")]), 3))
# 4. Korelacja z jakością snu: Pearson zależy od kodów, Spearman nie
round(c(pearson_A = cor(stres, sen), pearson_B = cor(stresB, sen),
        spearman_A = cor(stres, sen, method = "spearman"), spearman_B = cor(stresB, sen, method = "spearman")), 3)
cor.test(stres, sen, method = "spearman", exact = FALSE)$p.value
Wynik w R
grupa   wcale trochę umiarkowanie bardzo skrajnie
  I rok   1.4   10.0         28.6   57.1      2.9
  V rok  20.0   14.3         17.1   10.0     38.6
$`I rok`
25% 50% 75%
  3   4   4

$`V rok`
25% 50% 75%
  2   3   5

               I rok V rok
kody_1_5        3.50  3.33
kody_1_2_3_4_6  3.53  3.71
            kody_1_5 kody_1_2_3_4_6
statistic.W 2433.000       2433.000
p.value        0.943          0.943
 pearson_A  pearson_B spearman_A spearman_B
    -0.457     -0.447     -0.457     -0.457
[1] 1.378121e-08
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Średnia jako jedyny opis pojedynczej pozycji – M = 3.33 na V roku nie pokazuje, że 58.6% odpowiedzi leży na dwóch krańcach skali.
- Wnioski z różnicy średnich, gdy rozkłady się krzyżują – kierunek różnicy może zależeć od arbitralnych kodów.
- Nazywanie testu Manna-Whitneya „testem median” – jak w przykładzie, grupy o różnych medianach mogą nie różnić się w tym teście.
- Kwartyle z interpolacją – „Q1 = 2.5” to wartość, której nie ma na skali; dla danych porządkowych używaj
type = 1. - Przedziały zamiast liczb – pytanie o wiek w przedziałach zamienia zmienną ilościową na porządkową i odbiera część możliwych analiz.
- Traktowanie zmiennej porządkowej jak nominalnej – test χ² dla wykształcenia pomija informację o kolejności; test rangowy lub regresja porządkowa ją wykorzystują.
Najczęstsze pytania
Co to jest skala porządkowa?
To poziom pomiaru, na którym kategorie można uporządkować od mniejszego do większego nasilenia cechy, ale nie wiadomo, czy odstępy między nimi są równe. Przykłady to wykształcenie, nasilenie objawów („brak – łagodne – umiarkowane – ciężkie”) i odpowiedź na pojedyncze pytanie skali Likerta.
Czy na skali porządkowej można liczyć średnią?
Ściśle biorąc – nie, bo wynik zależy od liczb nadanych kategoriom. W przykładzie na tej stronie zmiana kodów z 1–5 na 1, 2, 3, 4, 6 (ta sama kolejność) odwraca to, która grupa ma wyższą średnią. Bezpieczniej podać medianę, kwartyle i odsetki. Wyjątkiem jest wynik skali złożonej z wielu pozycji, który zwykle analizuje się jak zmienną ilościową.
Jaki test dla zmiennej porządkowej?
Dwie grupy porównasz testem U Manna-Whitneya, trzy i więcej – testem Kruskala-Wallisa, pomiary powtarzane – testem Wilcoxona lub Friedmana, a związek dwóch zmiennych – korelacją Spearmana. Gdy chcesz uwzględnić kilka predyktorów, użyj regresji porządkowej.
Czym różni się skala porządkowa od przedziałowej?
Na skali porządkowej znana jest tylko kolejność kategorii. Na skali przedziałowej (interwałowej) odstępy są równe, więc różnice wyników mają sens i można liczyć średnie – tak jest np. z temperaturą w stopniach Celsjusza. Skalę przedziałową i ilorazową łącznie nazywa się skalą ilościową.
Czy skala Likerta jest porządkowa?
Odpowiedź na pojedyncze stwierdzenie jest porządkowa. Wynik całej skali, czyli suma lub średnia kilku pozycji o sprawdzonej rzetelności, zwykle traktuje się jak zmienną ilościową. Więcej o tym sporze w haśle skala Likerta.
Jak ustawić zmienną porządkową w SPSS?
W Widoku zmiennych w kolumnie Measure wybierz Ordinal, nadaj kategoriom liczby rosnące z nasileniem cechy i dodaj etykiety wartości. Ustawienie miary nie zmienia obliczeń, ale porządkuje dane; o wyborze testu decydujesz sam.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikAnaliza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →PoradnikIle stopni skali Likerta wybrać?
4, 5, 7 czy więcej punktów: co mówią badania, środek skali, etykiety, tabela decyzyjna, symulacja w R i wzór opisu do pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- Manikandan, S. (2011). Measures of central tendency: Median and mode. Journal of Pharmacology and Pharmacotherapeutics, 2(3), 214–215. https://doi.org/10.4103/0976-500X.83300 ● Otwarty dostęp: pełny tekst
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Schober, P., Boer, C., & Schwarte, L. A. (2018). Correlation coefficients: Appropriate use and interpretation. Anesthesia & Analgesia, 126(5), 1763–1768. https://doi.org/10.1213/ANE.0000000000002864 ● Otwarty dostęp
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
Cytowania BibTeX
@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{manikandan2011median, author={Manikandan, S.}, title={{Measures of central tendency: Median and mode}}, journal={Journal of Pharmacology and Pharmacotherapeutics}, year={2011}, volume={2}, number={3}, pages={214--215}, doi={10.4103/0976-500x.83300}}@article{norman2010likert, author={Norman, Geoff}, title={{Likert scales, levels of measurement and the “laws” of statistics}}, journal={Advances in Health Sciences Education}, year={2010}, volume={15}, number={5}, pages={625--632}, doi={10.1007/s10459-010-9222-y}}@article{schober2018correlation, author={Schober, Patrick and Boer, Christa and Schwarte, Lothar A.}, title={{Correlation coefficients: Appropriate use and interpretation}}, journal={Anesthesia \& Analgesia}, year={2018}, volume={126}, number={5}, pages={1763--1768}, doi={10.1213/ane.0000000000002864}}@article{stevens1946theory, author={Stevens, S. S.}, title={{On the theory of scales of measurement}}, journal={Science}, year={1946}, volume={103}, number={2684}, pages={677--680}, doi={10.1126/science.103.2684.677}}