Czym są wartości odstające i dlaczego sprawiają kłopot?
Wartość odstająca (obserwacja odstająca, ang. outlier) to wynik, który wyraźnie odbiega od pozostałych danych. Brzmi prosto, ale w praktyce badawczej panuje tu spory chaos. Aguinis i in. (2013) przejrzeli 46 źródeł metodologicznych i 232 artykuły z nauk o organizacji i zarządzaniu. Doliczyli się 14 różnych definicji obserwacji odstających, 39 sposobów ich wykrywania i 20 sposobów postępowania z nimi. Pokazali też, że od tych decyzji zależą merytoryczne wnioski z badania.
Kilka wyników potrafi zmienić wszystko. W przykładach z tego poradnika (dane symulowane) cztery osoby z 80 zdecydowały o tym, czy różnica między grupami jest istotna (p = .021 albo p = .233). Dziesięć osób z 200 osłabiło korelację z r = −.59 do r = −.34. Jedna osoba z 30 spłaszczyła nachylenie linii regresji z 2.54 do 0.56 punktu na godzinę nauki.
Krótką definicję pojęcia znajdziesz w haśle obserwacja odstająca. Tutaj przechodzimy przez całą procedurę: plan zapisany przed analizą, szukanie błędów, wykrywanie w jednej zmiennej, w kilku zmiennych naraz i w modelu regresji, decyzję, analizę wrażliwości i opis w pracy. Wszystkie liczby pochodzą z kodu R zamieszczonego niżej.
Trzy rodzaje wartości odstających
Zanim zapytasz „jak wykryć”, zapytaj „skąd się wzięła”. Aguinis i in. (2013) proponują osobne ścieżki decyzji dla obserwacji błędnych, interesujących i wpływowych, czyli takich, które zmieniają dopasowanie modelu albo jego przewidywania. Leys i in. (2019) dzielą je na błędne, interesujące i losowe. Tabela łączy obie klasyfikacje.
| Rodzaj | Skąd się bierze | Przykład | Co zrobić |
|---|---|---|---|
| Błędna | Pomyłka przy wpisywaniu, kodowaniu lub eksporcie, usterka sprzętu | Wiek 223 lata; kod braku danych 99 potraktowany jak wynik; odpowiedź 6 na skali 1–5 | Popraw, jeśli znasz prawdziwą wartość; jeśli nie – usuń wartość i potraktuj ją jak brak danych |
| Interesująca | Prawdziwy wynik osoby z innej populacji albo skutek czynnika, którego nie mierzono | Czas reakcji osoby, która nie zrozumiała instrukcji; bardzo wysoki lęk u osoby w kryzysie | Postąp według reguły ustalonej przed analizą; opisz przypadek osobno – może stać się nowym pytaniem badawczym |
| Losowa | Rzadki, ale prawidłowy wynik z ogona rozkładu | Wynik 142 w teście inteligencji w próbie 200 osób | Zwykle zostaw – usuwanie takich wyników sztucznie zaniża zmienność |
| Wpływowa | Obserwacja, która sama zmienia wynik modelu | Jedna osoba z nietypową wartością predyktora i wynikiem niezgodnym z trendem | Sprawdź źródło, pokaż wyniki z nią i bez niej, rozważ metodę odporną |
Leys i in. (2019) zalecają poprawiać obserwacje błędne, a gdy to niemożliwe – usuwać je. Obserwacje interesujące i losowe można zostawić, przekodować albo wykluczyć. W surowych danych zwykle nie da się ich od siebie odróżnić, dlatego autorzy radzą traktować je jednakowo. Zapamiętaj najważniejsze: „odstająca” nie znaczy „błędna”. Statystyka mówi tylko, że wynik jest nietypowy. O tym, co z nim zrobić, decyduje wiedza o badaniu i reguła zapisana z góry.
Krok 1. Zapisz reguły, zanim zobaczysz wyniki
Najważniejsza decyzja zapada przed analizą. Leys i in. (2019) zalecają zapisać w prerejestracji metodę wykrywania, próg i sposób postępowania z obserwacjami odstającymi. Gdy prerejestracja nie jest możliwa, radzą podać wyniki z obserwacjami odstającymi i bez nich. Każda decyzja podjęta po obejrzeniu wyników to dodatkowa ścieżka w analizie. Simmons i in. (2011) pokazali, że nieujawniona elastyczność w analizie danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Wybieranie progu, przy którym wynik „wychodzi”, to zwykły p-hacking.
Dwie pułapki opisano szczegółowo. Bakker i Wicherts (2014) wykazali w symulacjach, że usuwanie obserwacji odstających według popularnych progów z przed testem t dla prób niezależnych silnie zawyża błąd I rodzaju. Przy progu Z = 2 w krótkim, trudnym teście przekraczał on 20%, a najgorzej było wtedy, gdy badacz zmieniał próg po obejrzeniu wyników. André (2022) pokazał z kolei, że wykluczanie obserwacji odstających osobno w każdym warunku eksperymentu może podnieść odsetek wyników fałszywie pozytywnych nawet do 43%. Sformułował też ogólną zasadę: procedura wykluczeń musi być ślepa na testowaną hipotezę.
Sprawdziliśmy to we własnej symulacji. Dziesięć tysięcy razy losowaliśmy dwie grupy po 30 osób z tej samej populacji, a potem stosowaliśmy różne reguły przed testem t. Ponieważ różnicy w populacji nie było, każdy istotny wynik jest fałszywym alarmem.
| Sposób postępowania przed testem | Rozkład normalny | Czas reakcji (prawoskośny) | Krótki, trudny test (0–10 pkt) |
|---|---|---|---|
| Bez wykluczeń | 5.0% | 4.7% | 5.2% |
| Usunięcie |z| > 3, kryterium z całej próby | 4.9% | 4.8% | 5.1% |
| Usunięcie |z| > 2, kryterium z całej próby | 5.0% | 5.0% | 5.0% |
| Usunięcie |z| > 2, kryterium osobno w każdej grupie | 10.0% | 9.3% | 9.8% |
| Usunięcie wyników spoza Mdn ± 3 MAD, kryterium z całej próby | 4.9% | 4.7% | 5.2% |
| „Elastycznie”: najmniejsze p z czterech wariantów (bez wykluczeń, |z| > 3, 2.5 lub 2 w grupach) | 11.3% | 11.7% | 11.0% |
| Test Yuena dla średnich przyciętych o 20%, bez wykluczeń | 5.2% | 4.8% | 5.2% |
| Test Manna-Whitneya, bez wykluczeń | 4.7% | 4.6% | 5.1% |
Przy poziomie istotności .05 oczekujemy około 5% fałszywych alarmów. Reguły stosowane jednakowo do całej próby trzymały ten poziom. Natomiast to samo kryterium liczone osobno w każdej grupie podwoiło odsetek fałszywych alarmów, a swobodny wybór progu po obejrzeniu wyników zwiększył go ponad dwukrotnie. W naszych warunkach skala problemu była mniejsza niż w najgorszych scenariuszach z cytowanych prac, ale kierunek jest ten sam. Wniosek praktyczny: ustal regułę z góry, licz kryterium na całej próbie, bez podziału na warunki, i stosuj ją bez względu na to, jaki daje wynik. Przykładowy zapis do prerejestracji lub planu analiz:
Krok 2. Najpierw szukaj błędów w danych
Van den Broeck i in. (2005) opisują czyszczenie danych jako powtarzany cykl trzech etapów: przesiewu, czyli wyszukania podejrzanych wartości, diagnozy, czyli ustalenia, skąd się wzięły, oraz edycji – poprawienia, usunięcia albo pozostawienia wartości. Zalecają też, by reguły postępowania z błędami, brakami danych i wartościami skrajnymi określić z góry, zamiast natrafiać na błędy przypadkiem. Zanim policzysz jakikolwiek wskaźnik odstawania, sprawdź:
- zakres możliwych wartości – odpowiedź spoza skali (6 na skali 1–5, wiek 223 lata, czas reakcji 40 ms) to błąd, a nie obserwacja odstająca;
- kody braków danych – wpisane zamiast pustej komórki „99” albo „999” zachowują się jak ekstremalne wyniki; zamień je na braki (zob. braki danych MCAR, MAR i MNAR);
- separatory i przesunięcia – przecinek zamiast kropki dziesiętnej albo przesunięta kolumna potrafią zamienić 3.5 w 35; pułapki eksportu z formularzy opisujemy w poradniku dane z Google Forms i LimeSurvey do SPSS i R;
- wzorce odpowiedzi – osoby klikające bez czytania tworzą nietypowe profile odpowiedzi (zob. straightlining i nieuważne odpowiedzi).
Błędy poprawiaj w kopii danych, a każdą zmianę zapisuj w skrypcie albo w dzienniku zmian. Dzięki temu cały proces da się odtworzyć.
Krok 3. Wartości odstające w jednej zmiennej: z, MAD i IQR
Przykład (dane symulowane): w eksperymencie sprawdzamy, czy powiadomienia wyświetlane na ekranie wydłużają czas reakcji w zadaniu Stroopa. Badanie objęło 80 osób, po 40 w grupie kontrolnej i w grupie z rozpraszaczem. Zmienną zależną jest średni czas reakcji osoby (w milisekundach). Zgodnie z planem kryteria liczymy na całej próbie.
Kryterium M ± 3 SD
Najpopularniejsza reguła zamienia wyniki na wyniki standaryzowane z = (x − M) / SD i oznacza te, dla których |z| > 3 (zob. reguła trzech sigm). Leys i in. (2013) wskazują na jej podstawową wadę: średnia i odchylenie standardowe same reagują na wartości odstające. Skrajne wyniki zawyżają SD, przez co granica oddala się od danych. To zjawisko nazywa się maskowaniem.
W naszych danych M = 650.75 ms i SD = 97.66 ms, więc kryterium obejmuje przedział 357.8–943.7 ms. Cztery najwolniejsze osoby (890, 925, 970 i 1040 ms) mają z = 2.45, 2.81, 3.27 i 3.99, więc reguła oznacza tylko dwie z nich. Bez tej czwórki SD spadłoby do 68.12 ms.
Kryterium Mdn ± 3 MAD
Leys i in. (2013) proponują zastąpić średnią medianą, a odchylenie standardowe – medianowym odchyleniem bezwzględnym (ang. median absolute deviation, MAD):
Stała 1.4826 sprawia, że przy rozkładzie normalnym MAD szacuje to samo co SD. Mediana i MAD prawie nie reagują na kilka skrajnych wyników, więc granica zostaje tam, gdzie leży większość danych. W przykładzie Mdn = 634.50 ms, a mediana odchyleń bezwzględnych wynosi 45 ms, czyli MAD = 1.4826 × 45 = 66.72 ms. Leys i in. (2019) zalecają próg 3 MAD. Granice 434.3–834.7 ms oznaczają wszystkie cztery wolne osoby – leżą one od 3.83 do 6.08 MAD od mediany.
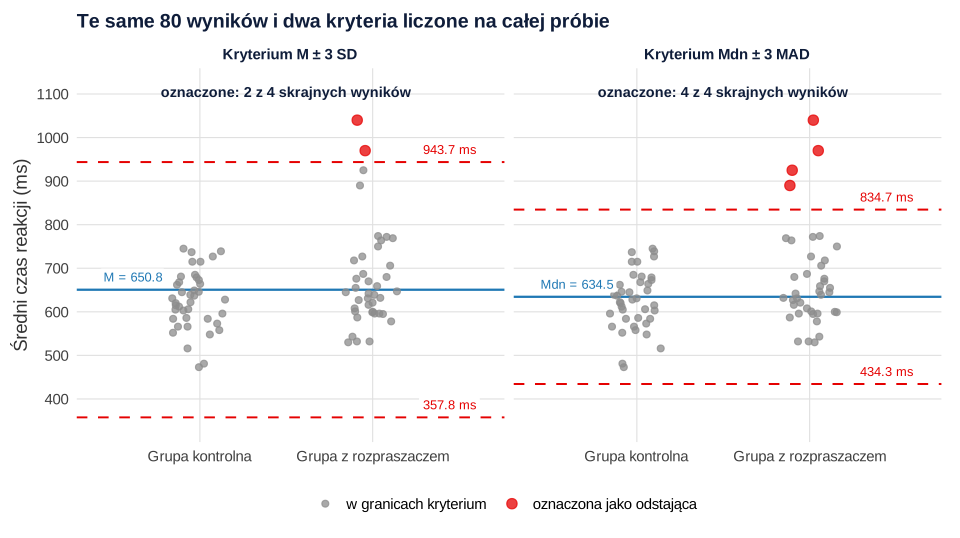
Trzecia popularna reguła – płoty Tukeya, czyli Q1 − 1.5 × IQR i Q3 + 1.5 × IQR – też jest odporna, bo opiera się na kwartylach. W przykładzie dała granice 467.0–811.0 ms i oznaczyła te same cztery osoby. Jak się ją liczy i jak wygląda na wykresie, opisujemy w hasłach rozstęp ćwiartkowy (IQR) i wykres pudełkowy.
| Kryterium | Na czym się opiera | Zalety | Ograniczenia |
|---|---|---|---|
| M ± 3 SD (|z| > 3) | Średnia i odchylenie standardowe | Proste i powszechnie znane | Maskowanie; w małej próbie |z| nie może przekroczyć (n − 1)/√n (przy n = 10 to 2.85); w dużej próbie z rozkładu normalnego oznacza ok. 0.27% prawidłowych wyników |
| Mdn ± 3 MAD | Mediana i medianowe odchylenie bezwzględne | Odporne na maskowanie; zalecane przez Leysa i in. (2013, 2019) | Przy skośnym rozkładzie oznacza wiele prawidłowych wyników w dłuższym ogonie; gdy ponad połowa wyników jest identyczna, MAD = 0 |
| Płoty Tukeya (1.5 × IQR) | Pierwszy i trzeci kwartyl | Odporne i widoczne na wykresie pudełkowym | W dużej próbie z rozkładu normalnego oznacza ok. 0.7% prawidłowych wyników; programy różnie liczą kwartyle |
Uważaj na rozkłady skośne. Czasy reakcji w pojedynczych próbach, liczba objawów czy liczba godzin w mediach społecznościowych mają długi prawy ogon, w którym leży wiele prawidłowych wyników. Symetryczne kryterium oznaczy je hurtem. Ratcliff (1993) porównał sposoby postępowania z odstającymi czasami reakcji – transformacje i punkty odcięcia – i pokazał, że miary odporne są znacznie mniej wrażliwe na obserwacje odstające niż miary oparte na momentach, takie jak średnia czy wariancja. Przy skośnych danych rozważ więc transformację przed wykrywaniem albo analizę odporną zamiast usuwania. Ocenę kształtu rozkładu opisujemy we wpisie jak sprawdzić normalność rozkładu.
Krok 4. Wartości odstające wielowymiarowe: odległość Mahalanobisa i MCD
Osoba może mieć zwyczajny wynik w każdej zmiennej osobno, a mimo to tworzyć nietypowe połączenie wyników. Przykład (dane symulowane): 200 studentów wypełniło skalę wsparcia społecznego (średnia 1–7) i skalę samotności (średnia 1–4). Zmienne są ujemnie skorelowane – kto czuje większe wsparcie, zwykle rzadziej odczuwa samotność. Dziesięć osób zgłosiło jednak jednocześnie wysokie wsparcie (5.83–6.72) i wysoką samotność (3.10–3.57). Żaden z tych wyników nie jest skrajny sam w sobie: największe |z| wynosi 2.22 dla wsparcia i 2.51 dla samotności.
Takie przypadki wykrywa odległość Mahalanobisa, która mierzy odległość profilu osoby od środka danych z uwzględnieniem wariancji i kowariancji zmiennych:
Przy wielowymiarowym rozkładzie normalnym D² ma w przybliżeniu rozkład χ² z liczbą stopni swobody równą liczbie zmiennych. Dla dwóch zmiennych i p < .001 wartość krytyczna wynosi χ²(2) = 13.82. Klasyczna odległość ma jednak tę samą wadę co wynik z: średnie i macierz kowariancji oblicza się z danych razem z obserwacjami odstającymi. Rousseeuw i van Zomeren (1990) opisali, jak kilka takich obserwacji przesuwa środek danych i rozciąga elipsę, przez co wzajemnie się maskuje. Zaproponowali odległości liczone z odpornych oszacowań położenia i kowariancji.
Najczęściej używa się do tego estymatora MCD (ang. minimum covariance determinant). Szuka on podzbioru h obserwacji, których macierz kowariancji ma najmniejszy wyznacznik, czyli najbardziej zwartego „rdzenia” danych. Szybki algorytm FAST-MCD, który opracowali Rousseeuw i Van Driessen (1999), uczynił z niego rutynowe narzędzie. Leys i in. (2019) zalecają wariant MCD75, w którym rdzeń tworzy 75% obserwacji (MCD50, gdy podejrzewasz, że odstających jest ponad 25%), oraz próg χ² dla p = .001.
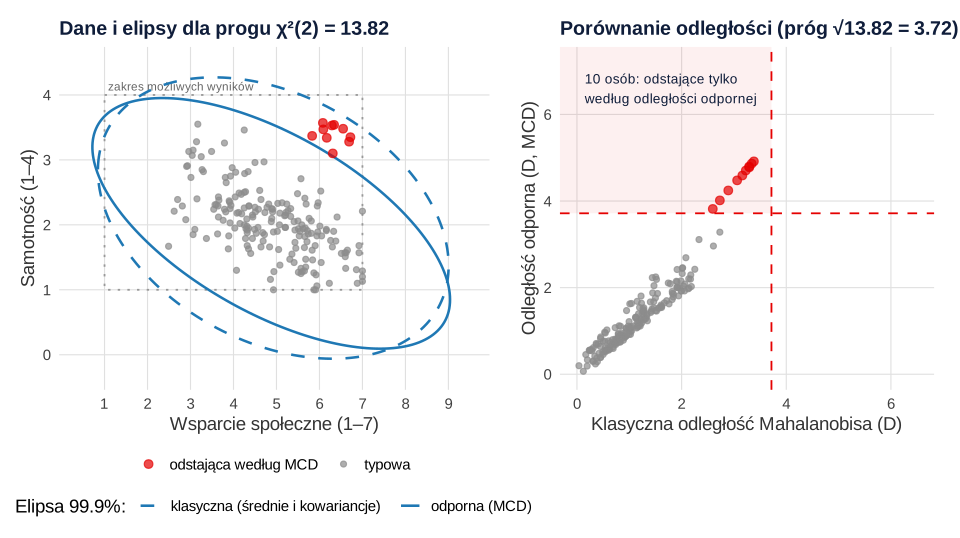
Wynik jest jednoznaczny. Klasyczne D² nie oznaczyło nikogo – największa wartość wśród dziesięciu nietypowych osób wyniosła 11.43. Odległość odporna oznaczyła wszystkie dziesięć (najmniejsza wartość: 14.58) i nikogo poza nimi. Ta dziesiątka, czyli 5% próby, osłabiła korelację Pearsona wsparcia z samotnością z r = −.59 do r = −.34. Prawy panel rysunku 2 to wykres D-D, który zaproponowali Rousseeuw i Van Driessen (1999).
Co dalej? Profil „wysokie wsparcie i wysoka samotność” może oznaczać osoby, które zgadzały się z każdym twierdzeniem, nie czytając go. Zanim kogokolwiek wykluczysz, obejrzyj jego odpowiedzi na poszczególne pozycje i inne wskaźniki staranności, które opisujemy we wpisie nieuważne odpowiedzi w ankietach online. Wielowymiarowe obserwacje odstające sprawdzaj zwłaszcza przed analizami wielu zmiennych naraz, takimi jak regresja wieloraka czy MANOVA.
Krok 5. Obserwacje wpływowe w regresji: dźwignia i odległość Cooka
W modelu regresji liczy się nie to, czy wynik jest nietypowy sam w sobie, lecz to, czy zmienia oszacowania. Rozróżnij trzy pojęcia:
- reszta – pionowa odległość obserwacji od linii regresji; duże reszty studentyzowane (|t| > 2–3) wskazują obserwacje odstające względem modelu;
- dźwignia (ang. leverage, h) – nietypowość wartości predyktorów; średnia dźwignia wynosi (k + 1)/n, gdzie k to liczba predyktorów, a za wysoką uważa się zwykle h > 2(k + 1)/n;
- wpływ – zmiana współczynników po usunięciu obserwacji; mierzy go odległość Cooka, która łączy informację o reszcie studentyzowanej oraz o wariancji reszt i wartości przewidywanych (Cook, 1977). Orientacyjne progi to D > 4/n albo D > 1.
Rousseeuw i van Zomeren (1990) dzielą obserwacje w regresji na regularne, odstające w pionie (duża reszta, mała dźwignia), dobre punkty dźwigni (nietypowy predyktor, ale wynik zgodny z trendem) i złe punkty dźwigni (nietypowy predyktor i duża reszta). Wyniki zniekształcają przede wszystkim te ostatnie.
Przykład (dane symulowane): 30 studentów podało, ile godzin uczyło się w tygodniu przed egzaminem ze statystyki. U 29 osób czas nauki wynosił od 3 do 13.5 godziny. Jedna osoba wpisała 32 godziny i uzyskała 50 punktów na 100.
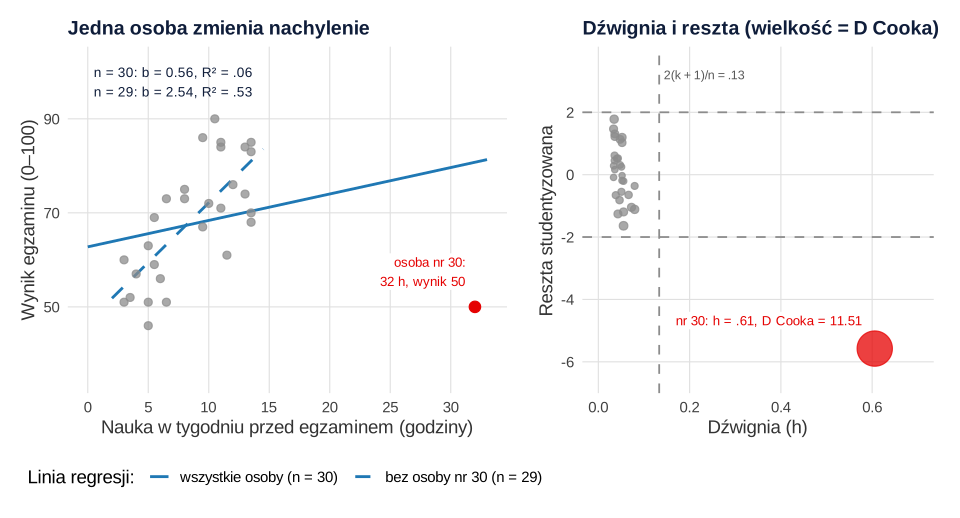
Osoba nr 30 ma dźwignię h = 0.61 przy progu 0.13, resztę studentyzowaną −5.58 i odległość Cooka D = 11.51. U pozostałych osób D nie przekracza 0.07. Z jej udziałem nachylenie wynosi b = 0.56 punktu na godzinę, 95% CI [−0.31, 1.43], p = .195, R² = .06. Bez niej b = 2.54, 95% CI [1.59, 3.49], p < .001, R² = .53. O wniosku zdecydowała jedna obserwacja.
Co zrobić? Najpierw sprawdź źródło: 32 może być pomyłką przy wpisywaniu 3.2 (po takiej korekcie b = 2.61). Jeśli wartość jest prawdziwa, model z tą osobą opisuje głównie ją, a nie zależność w grupie, więc przedstaw wyniki z nią i bez niej. Możesz też użyć regresji odpornej, która sama ogranicza wpływ takich punktów – estymator MM (funkcja lmrob() w R) dał b = 2.54. Pełną diagnostykę modelu, w tym wykresy reszt i współliniowość, omawiamy w poradniku regresja wieloraka krok po kroku.
Krok 6. Co zrobić z wartością odstającą? Sześć możliwości
| Możliwość | Kiedy | Na co uważać |
|---|---|---|
| 1. Popraw | Błąd, gdy znasz prawdziwą wartość (oryginalny arkusz, dokumentacja badania) | Zapisz zmianę w skrypcie lub dzienniku |
| 2. Usuń wartość | Błąd, którego nie da się poprawić | Powstaje brak danych – zaplanuj, jak go uwzględnisz (zob. imputacja wielokrotna w R) |
| 3. Zostaw | Prawdziwy wynik z ogona rozkładu albo analiza odporna na wartości odstające | Sprawdź, czy wniosek nie zależy od tej osoby |
| 4. Wyklucz osobę | Reguła zapisana przed analizą albo dowód, że osoba nie należy do badanej populacji (np. nie zrozumiała instrukcji) | Kryterium licz na całej próbie; podaj liczbę osób i powody |
| 5. Przekoduj (winsoryzacja) | Chcesz zachować osobę, ale ograniczyć jej wpływ – wynik zastępujesz granicą kryterium albo wartością wybranego percentyla | Zwykły test t traktuje przekodowane wartości jak prawdziwe pomiary, przez co może zaniżać błąd standardowy; winsoryzację też zapisz w planie |
| 6. Użyj metody odpornej | Zamiast usuwania: test Yuena, test Manna-Whitneya, regresja odporna, korelacja Spearmana | Metody te testują nieco inne hipotezy (np. o średnich przyciętych) – napisz to w pracy |
Bakker i Wicherts (2014) zalecają, by zamiast usuwania obserwacji odstających przed testem t użyć testu Manna-Whitneya-Wilcoxona albo odpornego testu Yuena-Welcha na pełnych danych. W ich symulacjach testy te utrzymywały nominalny poziom błędu I rodzaju, traciły niewiele mocy, gdy obserwacji odstających nie było, i zachowywały dobrą moc, gdy się pojawiały. Test Yuena porównuje średnie przycięte (obcięte), np. bez 20% najmniejszych i 20% największych wyników w każdej grupie, a błąd standardowy szacuje z wariancji winsoryzowanej. Wilcox i Keselman (2003) pokazują, że metody oparte na odpornych miarach położenia mogą znacząco zwiększyć moc i trafność porównań w stosunku do klasycznego testu t i ANOVA. Erceg-Hurn i Mirosevich (2008) zwracają uwagę, że założenia klasycznych testów rzadko są spełnione w prawdziwych danych, a nowoczesne metody odporne wciąż stosuje się rzadko, choć opisano, jak wykonać je w SPSS, SAS i R.
Więcej o teście Manna-Whitneya i innych testach nieparametrycznych przeczytasz w słowniku. Pamiętaj, że winsoryzacja i przycinanie to decyzje analityczne tak samo jak usuwanie – też powinny znaleźć się w planie analizy.
Krok 7. Analiza wrażliwości: czy wniosek zależy od kilku osób?
Analiza wrażliwości to powtórzenie kluczowej analizy przy innych rozsądnych decyzjach. Wracamy do eksperymentu z rozpraszaczem. Zgodnie z regułą z kroku 1 wykluczamy cztery osoby spoza Mdn ± 3 MAD – wszystkie z grupy z rozpraszaczem – a pozostałe warianty podajemy dla porównania.
Tabela 1
Różnica średnich czasów reakcji (grupa z rozpraszaczem minus kontrolna) przy różnych sposobach postępowania z wartościami odstającymi
| Wariant analizy | N | Różnica (ms) | 95% CI | Statystyka | p | d |
|---|---|---|---|---|---|---|
| Bez wykluczeń | 80 | 49.95 | [7.67, 92.23] | t(78) = 2.35 | .021 | 0.53 |
| Wykluczenie spoza M ± 3 SD | 78 | 32.62 | [−2.97, 68.21] | t(76) = 1.83 | .072 | 0.41 |
| Wykluczenie spoza Mdn ± 3 MADa | 76 | 18.78 | [−12.31, 49.87] | t(74) = 1.20 | .233 | 0.28 |
| Winsoryzacja do granic Mdn ± 3 MAD | 80 | 37.79 | [3.18, 72.40] | t(78) = 2.17 | .033 | 0.49 |
| Test Yuena (średnie przycięte o 20%) | 80 | 25.21 | [−14.07, 64.49] | t(40.69) = 1.30 | .202 | — |
| Test Manna-Whitneya | 80 | — | — | W = 629 | .101 | — |
Uwaga. Kryteria obliczono na całej próbie (M = 650.75, SD = 97.66, Mdn = 634.50, MAD = 66.72). Cztery pierwsze wiersze – test t dla prób niezależnych. W teście Yuena różnica dotyczy średnich przyciętych, a wyjaśniająca miara wielkości efektu wyniosła ξ = 0.23. Dane symulowane.
a Analiza główna zapisana w planie analizy.
Reguła z planu analizy daje różnicę 18.78 ms, t(74) = 1.20, p = .233, d = 0.28. W pełnej próbie różnica wynosi 49.95 ms i jest istotna, t(78) = 2.35, p = .021, d = 0.53. Testy odporne na pełnych danych – Yuena (p = .202) i Manna-Whitneya (p = .101) – zgadzają się jednak z analizą główną. Istotna różnica w pełnej próbie zależy od czterech najwolniejszych osób. Dlatego regułę trzeba ustalić wcześniej. Badacz decydujący po obejrzeniu tej tabeli mógłby wybrać wariant z p < .05 – pełną próbę albo winsoryzację – i przemilczeć pozostałe.
Taki wynik nie dowodzi, że rozpraszacz nie działa. Oznacza tylko, że te dane nie dają mocnych podstaw do wniosku o różnicy. Uczciwy opis pokazuje oba wyniki i wyjaśnia, od czego zależy rozbieżność między nimi. Różnicę warto też opisać wielkością efektu i przedziałem ufności, a nie tylko wartością p.
Jak opisać wartości odstające w pracy (APA)
Opis powinien pozwolić czytelnikowi powtórzyć Twoje decyzje. Aguinis i in. (2013) wykazali, że badacze często opisują postępowanie z obserwacjami odstającymi niejasno i niekonsekwentnie, a Leys i in. (2019) zalecają przejrzyście raportować w wynikach, co z nimi zrobiono. Przykładowy opis dla eksperymentu z tego poradnika:
Gdy obserwacje odstające zostawiasz w danych, napisz to równie jasno, np.: „[Liczba] wyników przekraczało granicę Mdn ± 3 MAD; zgodnie z planem pozostawiono je w analizie, a po ich wykluczeniu wnioski się nie zmieniły (Aneks [nr])”. Lista kontrolna:
- metoda wykrywania i próg (np. Mdn ± 3 MAD, MCD75 z progiem χ² dla p = .001, D Cooka > 4/n) oraz informacja, czy ustalono je przed analizą;
- czy kryterium liczono na całej próbie (tak powinno być), czy osobno w grupach;
- liczba obserwacji poprawionych, usuniętych i przekodowanych – łącznie i w każdej grupie – oraz powody;
- liczebność próby przed wykluczeniami i po nich, np. w opisie charakterystyki próby;
- wyniki analizy wrażliwości – z obserwacjami odstającymi i bez nich albo z metodą odporną;
- w regresji – wartości diagnostyczne obserwacji wpływowych i wyniki modelu bez nich.
Ogólne zasady zapisu statystyk znajdziesz w poradniku jak opisać wyniki w stylu APA.
Przykład w R
Pięć przepisów: wykrywanie w jednej zmiennej, analiza wrażliwości, wykrywanie wielowymiarowe, diagnostyka regresji i symulacja błędu I rodzaju. Wszystkie liczby w tekście, tabelach i na rysunkach pochodzą z tego kodu. Przepis 2 korzysta z obiektów utworzonych w przepisie 1.
1. Jedna zmienna: z, MAD i płoty Tukeya
R
set.seed(2)
kontrolna   <- round(rnorm(40, mean = 620, sd = 60))                     # średni czas reakcji (ms)
rozpraszacz <- c(round(rnorm(36, mean = 650, sd = 60)), 890, 925, 970, 1040)
dane <- data.frame(rt = c(kontrolna, rozpraszacz),
                   grupa = factor(rep(c("kontrolna", "rozpraszacz"), each = 40)))

# kryteria liczone na całej próbie – bez dzielenia na warunki
M   <- mean(dane$rt);   SD  <- sd(dane$rt)
Mdn <- median(dane$rt); MAD <- mad(dane$rt)       # mad() mnoży medianę odchyleń przez 1.4826
Q   <- quantile(dane$rt, c(.25, .75));  IQR_rt <- IQR(dane$rt)
dane$z     <- (dane$rt - M) / SD
dane$w_mad <- (dane$rt - Mdn) / MAD
granice <- rbind("M ± 3 SD"        = M + c(-3, 3) * SD,
                 "Mdn ± 3 MAD"     = Mdn + c(-3, 3) * MAD,
                 "płoty 1.5 × IQR" = c(Q[[1]] - 1.5 * IQR_rt, Q[[2]] + 1.5 * IQR_rt))
colnames(granice) <- c("dolna", "górna"); round(granice, 1)

dane$odst_sd  <- abs(dane$z) > 3
dane$odst_mad <- abs(dane$w_mad) > 3
dane$odst_iqr <- dane$rt < Q[1] - 1.5 * IQR_rt | dane$rt > Q[2] + 1.5 * IQR_rt
colSums(dane[, c("odst_sd", "odst_mad", "odst_iqr")])
with(dane[dane$odst_mad, ], data.frame(rt, grupa, z = round(z, 2), w_mad = round(w_mad, 2)))
Wynik w R
                dolna górna
M ± 3 SD        357.8 943.7
Mdn ± 3 MAD     434.3 834.7
płoty 1.5 × IQR 467.0 811.0
 odst_sd odst_mad odst_iqr
       2        4        4
    rt       grupa    z w_mad
1  890 rozpraszacz 2.45  3.83
2  925 rozpraszacz 2.81  4.35
3  970 rozpraszacz 3.27  5.03
4 1040 rozpraszacz 3.99  6.08
2. Analiza wrażliwości: test t, winsoryzacja, test Yuena i test Manna-Whitneya
R
library(WRS2)
zostaw <- !dane$odst_mad                                              # reguła z prerejestracji
dane$rt_w <- pmin(pmax(dane$rt, Mdn - 3 * MAD), Mdn + 3 * MAD)        # winsoryzacja do granic kryterium
test_t <- function(x, g) {
  tt <- t.test(x ~ g, var.equal = TRUE)
  m <- tapply(x, g, mean); s <- tapply(x, g, sd); n <- tapply(x, g, length)
  sp <- sqrt(sum((n - 1) * s^2) / (sum(n) - 2))                       # połączone SD do d Cohena
  round(c(N = length(x), roznica = unname(diff(m)), CI_d = -tt$conf.int[2], CI_g = -tt$conf.int[1],
          t = -unname(tt$statistic), p = tt$p.value, d = unname(diff(m)) / sp), 3)
}
rbind("bez wykluczeń"     = test_t(dane$rt, dane$grupa),
      "wykl. M ± 3 SD"    = test_t(dane$rt[!dane$odst_sd], dane$grupa[!dane$odst_sd]),
      "wykl. Mdn ± 3 MAD" = test_t(dane$rt[zostaw], dane$grupa[zostaw]),
      "winsoryzacja"      = test_t(dane$rt_w, dane$grupa))
yuen(rt ~ grupa, data = dane, tr = 0.2)          # średnie przycięte o 20%, bez usuwania osób
wilcox.test(rt ~ grupa, data = dane, exact = FALSE)
Wynik w R
                   N roznica    CI_d   CI_g     t     p     d
bez wykluczeń     80  49.950   7.669 92.231 2.352 0.021 0.526
wykl. M ± 3 SD    78  32.620  -2.971 68.210 1.825 0.072 0.414
wykl. Mdn ± 3 MAD 76  18.781 -12.308 49.869 1.204 0.233 0.277
winsoryzacja      80  37.790   3.182 72.398 2.174 0.033 0.486
Call:
yuen(formula = rt ~ grupa, data = dane, tr = 0.2)

Test statistic: 1.2963 (df = 40.69), p-value = 0.20216

Trimmed mean difference:  -25.20833
95 percent confidence interval:
-64.4889     14.0722

Explanatory measure of effect size: 0.23


	Wilcoxon rank sum test with continuity correction

data:  rt by grupa
W = 629, p-value = 0.1008
alternative hypothesis: true location shift is not equal to 0
3. Kilka zmiennych: klasyczna i odporna odległość Mahalanobisa
R
library(MASS); library(robustbase)
set.seed(2)
S <- matrix(c(1, -.275, -.275, .25), 2)                    # kowariancje: SD = 1 i 0.5, r = −.55
typowi    <- mvrnorm(190, mu = c(4.9, 2.1), Sigma = S)
nietypowi <- cbind(rnorm(10, 6.3, .3), rnorm(10, 3.3, .2)) # wysokie wsparcie i wysoka samotność
X <- rbind(typowi, nietypowi)
X[, 1] <- pmin(pmax(round(X[, 1], 2), 1), 7)               # wsparcie społeczne 1–7
X[, 2] <- pmin(pmax(round(X[, 2], 2), 1), 4)               # samotność 1–4
colnames(X) <- c("wsparcie", "samotnosc")

prog <- qchisq(.999, df = ncol(X))                         # p < .001, df = liczba zmiennych
D2_klas <- mahalanobis(X, center = colMeans(X), cov = cov(X))
mcd     <- covMcd(X, alpha = .75)                          # MCD75: rdzeń z 75% obserwacji
D2_odp  <- mahalanobis(X, center = mcd$center, cov = mcd$cov)
round(prog, 2)
table(klasyczna = D2_klas > prog, odporna = D2_odp > prog)
round(c(r_wszyscy = cor(X)[1, 2], r_bez_odstajacych = cor(X[D2_odp <= prog, ])[1, 2]), 2)
Wynik w R
[1] 13.82
         odporna
klasyczna FALSE TRUE
    FALSE   190   10
        r_wszyscy r_bez_odstajacych
            -0.34             -0.59
4. Regresja: dźwignia, reszty, odległość Cooka i regresja odporna
R
library(robustbase)
set.seed(6)
godziny <- round(runif(29, 2, 14) * 2) / 2                       # nauka w tygodniu przed egzaminem
wynik   <- round(pmin(100, 45 + 2.5 * godziny + rnorm(29, 0, 8))) # wynik egzaminu 0–100
godziny <- c(godziny, 32); wynik <- c(wynik, 50)                  # osoba nr 30
model <- lm(wynik ~ godziny)
diagn <- data.frame(dzwignia = hatvalues(model),                 # h: nietypowość predyktora
                    reszta_stud = rstudent(model),                # odległość od linii
                    cook = cooks.distance(model))                 # wpływ na współczynniki
n <- nrow(diagn); k <- 1
round(diagn[diagn$cook > 4 / n | diagn$dzwignia > 2 * (k + 1) / n, ], 2)
round(rbind(wszyscy = coef(model),
            bez_nr_30 = coef(lm(wynik ~ godziny, subset = -30)),
            odporna_MM = coef(lmrob(wynik ~ godziny))), 2)
Wynik w R
   dzwignia reszta_stud  cook
30     0.61       -5.58 11.51
           (Intercept) godziny
wszyscy          62.77    0.56
bez_nr_30        46.75    2.54
odporna_MM       46.73    2.54
5. Symulacja: jak reguły wykluczeń wpływają na błąd I rodzaju
R
library(WRS2)
p_t <- function(x, g) t.test(x ~ g, var.equal = TRUE)$p.value
symuluj <- function(losuj, n = 30, R = 10000) {
  wyniki <- replicate(R, {
    x <- losuj(2 * n); g <- factor(rep(1:2, each = n))
    z  <- (x - mean(x)) / sd(x)                                   # z liczone w całej próbie
    zg <- ave(x, g, FUN = function(v) (v - mean(v)) / sd(v))     # z liczone osobno w każdej grupie
    md <- if (mad(x) > 0) abs(x - median(x)) / mad(x) else 0 * x  # odległość od mediany w jednostkach MAD
    p_grupy <- function(k) p_t(x[abs(zg) <= k], g[abs(zg) <= k])
    c(bez_wykluczen   = p_t(x, g),
      z3_cala_proba   = p_t(x[abs(z) <= 3], g[abs(z) <= 3]),
      z2_cala_proba   = p_t(x[abs(z) <= 2], g[abs(z) <= 2]),
      z2_w_grupach    = p_grupy(2),
      mad3_cala_proba = p_t(x[md <= 3], g[md <= 3]),
      elastycznie     = min(p_t(x, g), p_grupy(3), p_grupy(2.5), p_grupy(2)),   # najmniejsze p z 4 wariantów
      yuen_20         = yuen(x ~ g, data = data.frame(x, g), tr = 0.2)$p.value,
      mann_whitney    = suppressWarnings(wilcox.test(x ~ g, exact = FALSE)$p.value))
  })
  round(100 * rowMeans(wyniki < .05), 1)
}
set.seed(2026)
tabela <- cbind(
  normalny    = symuluj(function(k) rnorm(k, mean = 100, sd = 15)),                # np. wynik testu IQ
  czas_reakcji = symuluj(function(k) round(exp(rnorm(k, mean = 6.4, sd = 0.35)))), # prawoskośny czas reakcji (ms)
  trudny_test = symuluj(function(k) rbinom(k, size = 10, prob = 0.2)))            # krótki, trudny test (0–10 pkt)
tabela
Wynik w R
                normalny czas_reakcji trudny_test
bez_wykluczen        5.0          4.7         5.2
z3_cala_proba        4.9          4.8         5.1
z2_cala_proba        5.0          5.0         5.0
z2_w_grupach        10.0          9.3         9.8
mad3_cala_proba      4.9          4.7         5.2
elastycznie         11.3         11.7        11.0
yuen_20              5.2          4.8         5.2
mann_whitney         4.7          4.6         5.1
Funkcje do wykrywania obserwacji odstających metodami MAD i MCD zawiera też pakiet Routliers, który towarzyszy artykułowi Leysa i in. (2019). Własny kod pozwala jednak dokładnie zobaczyć, co liczy każde kryterium.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- robustbase (wersja 0.99-7): Maechler, M., Rousseeuw, P., Croux, C., Todorov, V., Ruckstuhl, A., Salibian-Barrera, M., Verbeke, T., Koller, M., Conceicao, E. L., & Anna di Palma, M. (2026). robustbase: Basic robust statistics [R package]. http://robustbase.r-forge.r-project.org/
- WRS2 (wersja 1.1-7): Mair, P., & Wilcox, R. (2020). Robust statistical methods in R using the WRS2 package. Behavior Research Methods, 52. https://doi.org/10.3758/s13428-019-01246-w
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Wartości odstające w SPSS
- Wyniki z: Analyze → Descriptive Statistics → Descriptives, zaznacz Save standardized values as variables. SPSS doda zmienną z przedrostkiem Z.
- Wykres pudełkowy i najbardziej skrajne wyniki: Analiza → Opis statystyczny → Eksploracja (Explore); w oknie Statistics zaznacz Outliers, a tabela Extreme Values pokaże po pięć najmniejszych i największych wyników. Na wykresie pudełkowym kółko oznacza wynik odległy od pudełka o ponad 1.5 × IQR, a gwiazdka – o ponad 3 × IQR.
- MAD: nie ma go w menu. Odczytaj medianę (np. z Eksploracji), w Przekształcenia → Oblicz wartości utwórz zmienną
odch = ABS(rt - 634.5), odczytaj medianę tej zmiennej i pomnóż ją przez 1.4826. Leys i in. (2013) pokazują, jak policzyć MAD w SPSS i R. - Odległość Mahalanobisa: Analiza → Regresja → Liniowa; jako zmienną zależną wstaw dowolną zmienną (np. numer osoby), jako niezależne – zmienne do sprawdzenia. W oknie Save zaznacz Mahalanobis; powstanie zmienna MAH_1. Prawdopodobieństwo policzysz wyrażeniem
1 - CDF.CHISQ(MAH_1, 2), gdzie 2 to liczba zmiennych. Odpornej odległości MCD w menu SPSS nie ma – policzysz ją w R. - Dźwignia, reszty i odległość Cooka: w oknie Save regresji liniowej zaznacz Cook's, Leverage values i Studentized deleted. SPSS zapisuje dźwignię wycentrowaną (h − 1/n), więc odpowiadający jej próg to 2(k + 1)/n − 1/n.
- Analiza wrażliwości: oznacz wykluczane osoby zmienną 0/1 i użyj Dane → Wybierz obserwacje (Select Cases) zamiast usuwać wiersze. Test Manna-Whitneya: Analyze → Nonparametric Tests → Legacy Dialogs → 2 Independent Samples. Testu Yuena nie ma w standardowym menu.
Jeśli chcesz, żeby ktoś sprawdził Twoją procedurę czyszczenia danych i analizę wrażliwości, zajrzyj do oferty analizy statystyczne dla studentów.
Najczęstsze błędy
- Decyzja po obejrzeniu wyników. Wybieranie progu albo metody, przy której wynik jest istotny, zawyża odsetek fałszywych alarmów (Bakker i Wicherts, 2014; Simmons i in., 2011).
- Kryterium liczone osobno w każdej grupie. W naszej symulacji podwoiło odsetek wyników fałszywie pozytywnych; André (2022) opisał wzrost nawet do 43%.
- Reguła M ± 3 SD jako jedyne kryterium. Skrajne wyniki zawyżają SD i maskują się nawzajem – w przykładzie reguła wykryła 2 z 4 nietypowych osób (Leys i in., 2013).
- Usuwanie wszystkich „kropek” z wykresu pudełkowego. W dużej próbie z rozkładu normalnego płoty Tukeya oznaczają ok. 0.7% całkowicie prawidłowych wyników.
- Usuwanie „do skutku”. Po każdym usunięciu średnia i SD się zmieniają, więc kolejne osoby stają się „odstające”. Kryterium stosuj jeden raz, na danych po korekcie błędów.
- Sprawdzanie tylko pojedynczych zmiennych. Nietypowe połączenia wyników są niewidoczne w każdej zmiennej osobno – w przykładzie żadna z dziesięciu osób nie miała |z| > 3.
- Mylenie dużej reszty z wpływem. Wpływ zależy od dźwigni i reszty jednocześnie; oceniaj go odległością Cooka i porównaniem modeli z obserwacją i bez niej.
- Zwykły test t po przycięciu lub winsoryzacji. Wariancja przyciętych danych zaniża błąd standardowy; do średnich przyciętych użyj testu Yuena.
- Brak informacji w pracy. Czytelnik musi wiedzieć, ile obserwacji usunięto, według jakiej reguły i czy wnioski od tego zależą.
Najczęstsze pytania
Co to są wartości odstające?
To wyniki, które wyraźnie odbiegają od pozostałych danych. Mogą być błędami (np. wiek 223 lata), prawdziwymi, ale nietypowymi wynikami albo obserwacjami wpływowymi, które same zmieniają wynik analizy. „Odstająca” nie znaczy „błędna” – o decyzji rozstrzyga reguła ustalona przed analizą i wiedza o badaniu (zob. obserwacja odstająca).
Jak wykryć wartości odstające?
W jednej zmiennej użyj mediany i medianowego odchylenia bezwzględnego (wyniki dalej niż 3 MAD od mediany) albo płotów Tukeya 1.5 × IQR. Nietypowe połączenia kilku zmiennych wykryjesz odporną odległością Mahalanobisa (MCD) z progiem χ² dla p = .001, a obserwacje wpływowe w regresji – dźwignią i odległością Cooka. Kryterium licz na całej próbie, a nie osobno w grupach.
Czy usuwać wartości odstające?
Błędy popraw albo usuń. Prawdziwe wyniki wykluczaj tylko według reguły zapisanej przed analizą i zawsze pokaż wynik bez wykluczeń, czyli analizę wrażliwości. Często lepsza od usuwania jest metoda odporna – test Yuena, test Manna-Whitneya albo regresja odporna; takie testy zamiast usuwania obserwacji przed testem t zalecają Bakker i Wicherts (2014).
Dlaczego reguła trzech odchyleń standardowych bywa zawodna?
Bo średnia i SD same reagują na wartości odstające: kilka skrajnych wyników zawyża SD i odsuwa granicę, przez co wyniki maskują się nawzajem. W przykładzie z tego poradnika reguła M ± 3 SD oznaczyła 2 z 4 nietypowych osób, a reguła Mdn ± 3 MAD – wszystkie cztery. Leys i in. (2013) zalecają dlatego medianę i MAD.
Jak opisać usunięcie wartości odstających w pracy?
Podaj metodę i próg, informację, czy ustalono je przed analizą, liczbę wykluczonych osób w każdej grupie i powody, liczebność próby po wykluczeniach oraz wyniki bez wykluczeń. Przykład: „Z analizy wykluczono 4 z 80 osób (5.0%), których średni czas reakcji był odległy od mediany o więcej niż 3 MAD”. Pełny wzór znajdziesz w sekcji o raportowaniu.
Jak znaleźć wartości odstające w SPSS?
Wyniki z zapiszesz w oknie Descriptives (Save standardized values), a wykres pudełkowy i tabelę skrajnych wartości otrzymasz w procedurze Eksploracja. Odległość Mahalanobisa, dźwignię i odległość Cooka zapiszesz w oknie Save regresji liniowej. MAD trzeba policzyć przez Oblicz wartości, a odporną odległość MCD – w R.
Powiązane hasła
Przeczytaj też
Nieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aguinis, H., Gottfredson, R. K., & Joo, H. (2013). Best-practice recommendations for defining, identifying, and handling outliers. Organizational Research Methods, 16(2), 270–301. https://doi.org/10.1177/1094428112470848
- André, Q. (2022). Outlier exclusion procedures must be blind to the researcher’s hypothesis. Journal of Experimental Psychology: General, 151(1), 213–223. https://doi.org/10.1037/xge0001069 ● Otwarty dostęp: pełny tekst
- Bakker, M., & Wicherts, J. M. (2014). Outlier removal, sum scores, and the inflation of the Type I error rate in independent samples t tests: The power of alternatives and recommendations. Psychological Methods, 19(3), 409–427. https://doi.org/10.1037/met0000014
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Erceg-Hurn, D. M., & Mirosevich, V. M. (2008). Modern robust statistical methods: An easy way to maximize the accuracy and power of your research. American Psychologist, 63(7), 591–601. https://doi.org/10.1037/0003-066x.63.7.591 ● Otwarty dostęp: pełny tekst
- Leys, C., Delacre, M., Mora, Y. L., Lakens, D., & Ley, C. (2019). How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration. International Review of Social Psychology, 32(1), Article 5. https://doi.org/10.5334/irsp.289 ● Otwarty dostęp
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013 ● Otwarty dostęp
- Ratcliff, R. (1993). Methods for dealing with reaction time outliers. Psychological Bulletin, 114(3), 510–532. https://doi.org/10.1037/0033-2909.114.3.510
- Rousseeuw, P. J., & Van Driessen, K. (1999). A fast algorithm for the minimum covariance determinant estimator. Technometrics, 41(3), 212–223. https://doi.org/10.1080/00401706.1999.10485670
- Rousseeuw, P. J., & van Zomeren, B. C. (1990). Unmasking multivariate outliers and leverage points. Journal of the American Statistical Association, 85(411), 633–639. https://doi.org/10.1080/01621459.1990.10474920
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Van den Broeck, J., Argeseanu Cunningham, S., Eeckels, R., & Herbst, K. (2005). Data cleaning: Detecting, diagnosing, and editing data abnormalities. PLoS Medicine, 2(10), Article e267. https://doi.org/10.1371/journal.pmed.0020267 ● Otwarty dostęp
- Wilcox, R. R., & Keselman, H. J. (2003). Modern robust data analysis methods: Measures of central tendency. Psychological Methods, 8(3), 254–274. https://doi.org/10.1037/1082-989X.8.3.254
Cytowania BibTeX
@article{aguinis2013best, author={Aguinis, Herman and Gottfredson, Ryan K. and Joo, Harry}, title={{Best-practice recommendations for defining, identifying, and handling outliers}}, journal={Organizational Research Methods}, year={2013}, volume={16}, number={2}, pages={270--301}, doi={10.1177/1094428112470848}}@article{andre2022outlier, author={André, Quentin}, title={{Outlier exclusion procedures must be blind to the researcher’s hypothesis}}, journal={Journal of Experimental Psychology: General}, year={2022}, volume={151}, number={1}, pages={213--223}, doi={10.1037/xge0001069}}@article{bakker2014outlier, author={Bakker, Marjan and Wicherts, Jelte M.}, title={{Outlier removal, sum scores, and the inflation of the Type I error rate in independent samples t tests: The power of alternatives and recommendations}}, journal={Psychological Methods}, year={2014}, volume={19}, number={3}, pages={409--427}, doi={10.1037/met0000014}}@article{cook1977detection, author={Cook, R. Dennis}, title={{Detection of influential observation in linear regression}}, journal={Technometrics}, year={1977}, volume={19}, number={1}, pages={15--18}, doi={10.1080/00401706.1977.10489493}}@article{erceghurn2008modern, author={Erceg-Hurn, David M. and Mirosevich, Vikki M.}, title={{Modern robust statistical methods: An easy way to maximize the accuracy and power of your research}}, journal={American Psychologist}, year={2008}, volume={63}, number={7}, pages={591--601}, doi={10.1037/0003-066x.63.7.591}}@article{leys2019how, author={Leys, Christophe and Delacre, Marie and Mora, Youri L. and Lakens, Daniël and Ley, Christophe}, title={{How to classify, detect, and manage univariate and multivariate outliers, with emphasis on pre-registration}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={5}, doi={10.5334/irsp.289}}@article{leys2013detecting, author={Leys, Christophe and Ley, Christophe and Klein, Olivier and Bernard, Philippe and Licata, Laurent}, title={{Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median}}, journal={Journal of Experimental Social Psychology}, year={2013}, volume={49}, number={4}, pages={764--766}, doi={10.1016/j.jesp.2013.03.013}}@article{ratcliff1993methods, author={Ratcliff, Roger}, title={{Methods for dealing with reaction time outliers}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={3}, pages={510--532}, doi={10.1037/0033-2909.114.3.510}}@article{rousseeuw1999fast, author={Rousseeuw, Peter J. and Van Driessen, Katrien}, title={{A fast algorithm for the minimum covariance determinant estimator}}, journal={Technometrics}, year={1999}, volume={41}, number={3}, pages={212--223}, doi={10.1080/00401706.1999.10485670}}@article{rousseeuw1990unmasking, author={Rousseeuw, Peter J. and van Zomeren, Bert C.}, title={{Unmasking multivariate outliers and leverage points}}, journal={Journal of the American Statistical Association}, year={1990}, volume={85}, number={411}, pages={633--639}, doi={10.1080/01621459.1990.10474920}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{vandenbroeck2005data, author={Van den Broeck, Jan and Argeseanu Cunningham, Solveig and Eeckels, Roger and Herbst, Kobus}, title={{Data cleaning: Detecting, diagnosing, and editing data abnormalities}}, journal={PLoS Medicine}, year={2005}, volume={2}, number={10}, eid={e267}, doi={10.1371/journal.pmed.0020267}}@article{wilcox2003modern, author={Wilcox, Rand R. and Keselman, H. J.}, title={{Modern robust data analysis methods: Measures of central tendency}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={254--274}, doi={10.1037/1082-989x.8.3.254}}