Co to jest rozstęp ćwiartkowy (IQR)?
Rozstęp ćwiartkowy (inaczej rozstęp międzykwartylowy; ang. interquartile range, IQR) to różnica między trzecim a pierwszym kwartylem. Mówi, jak szeroko rozciąga się środkowe 50% uporządkowanych wyników (Mishra i in., 2019). Jest odporną miarą rozproszenia: w przeciwieństwie do odchylenia standardowego i zwykłego rozstępu (max − min) nie zależy od wartości najbardziej skrajnych wyników. Dlatego podaje się go razem z medianą, zwłaszcza przy skośnych rozkładach.
W polskich podręcznikach spotkasz też odchylenie ćwiartkowe Q = (Q3 − Q1) / 2, czyli połowę IQR. Rozstęp ćwiartkowy jest podstawą wykresu pudełkowego: długość pudełka to właśnie IQR. Ten typ wykresu wywodzi się z eksploracyjnej analizy danych, którą upowszechniła klasyczna monografia Tukeya (1977).
Wzór na IQR i płoty Tukeya
Na IQR opiera się popularna reguła wskazywania potencjalnych obserwacji odstających – tzw. płoty Tukeya (ang. Tukey's fences):
górny płot = Q3 + 1.5 × IQR
Wyniki poza płotami zaznacza się na wykresie pudełkowym jako osobne punkty, a wąsy kończą się na najbardziej skrajnych wynikach mieszczących się w płotach. Krzywinski i Altman (2014) opisują ten wariant jako wąsy w stylu Tukeya, sięgające najdalej 1.5 × IQR od krawędzi pudełka. SPSS dodatkowo oznacza gwiazdką wyniki odległe od pudełka o ponad 3 × IQR (tzw. wartości ekstremalne).
Przykład: IQR czasów reakcji
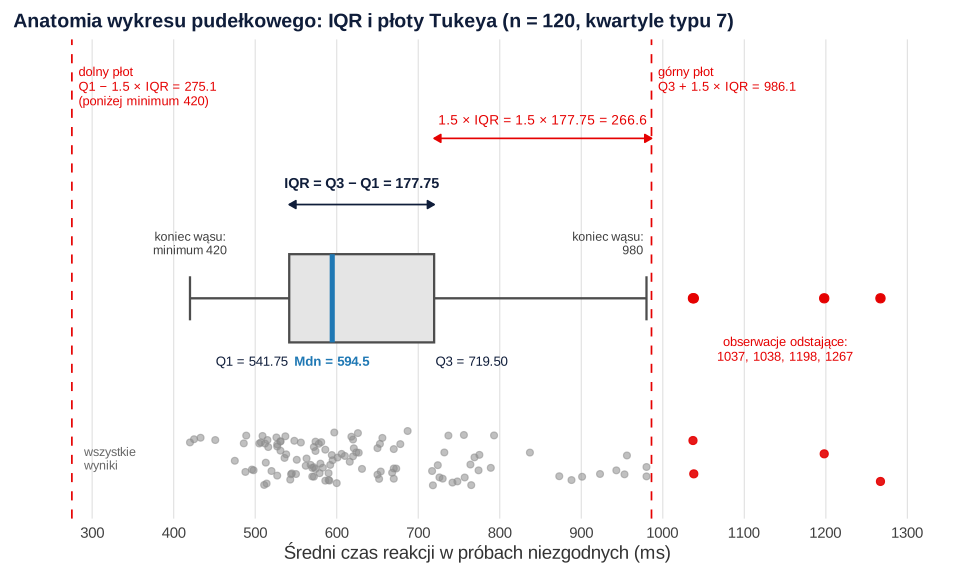
Wróćmy do 120 czasów reakcji z zadania Stroopa, które opisujemy też w hasłach o średniej i medianie (dane symulowane). Kwartyle obliczone domyślną metodą R (typ 7) wynoszą Q1 = 541.75 ms i Q3 = 719.50 ms, więc:
Środkowe 50% osób, czyli 60 ze 120, ma czasy reakcji w przedziale o szerokości 177.75 ms. Płoty Tukeya wynoszą:
- dolny: 541.75 − 1.5 × 177.75 = 275.1 ms – leży poniżej najszybszego wyniku (420 ms), więc dolny wąs kończy się na minimum;
- górny: 719.50 + 1.5 × 177.75 = 986.1 ms – górny wąs kończy się na 980 ms, ostatnim wyniku przed płotem.
Poza górnym płotem leżą cztery wyniki: 1037, 1038, 1198 i 1267 ms. Rysunek 1 pokazuje, jak te liczby przekładają się na elementy wykresu pudełkowego.
Dlaczego IQR jest odporny na wartości skrajne?
IQR zależy tylko od wyników w okolicy pierwszego i trzeciego kwartyla, więc wartości najbardziej skrajne nie mają na niego wpływu. Zamieńmy w naszych danych najwolniejszy wynik (1267 ms) na 5000 ms – jakby ktoś odszedł od komputera w trakcie zadania. Odchylenie standardowe wzrośnie wtedy ze 154.37 do 423.08 ms, rozstęp – z 847 do 4580 ms, a IQR pozostanie dokładnie taki sam: 177.75 ms.
Dla rozkładu normalnego IQR wynosi 1.349 odchylenia standardowego, dlatego iloraz IQR / 1.349 bywa używany jako odporne oszacowanie SD. W naszych skośnych danych daje 131.77 ms wobec SD = 154.37 ms – różnica pokazuje, jak bardzo długi prawy ogon zawyża odchylenie standardowe. Wan i in. (2014) proponują z kolei metody szacowania średniej i SD na podstawie liczebności próby, mediany, rozstępu i rozstępu ćwiartkowego. Przydają się w przeglądach systematycznych i metaanalizach, gdy autorzy badań podali tylko Mdn (IQR).
IQR a wykrywanie obserwacji odstających
Reguła 1.5 × IQR wskazuje kandydatów do sprawdzenia, a nie błędy do automatycznego usunięcia. Nawet w idealnie normalnym rozkładzie płoty leżą w odległości 2.698 SD od średniej, więc poza nimi znajduje się około 0.70% wyników. W symulacji 10 000 prób po 120 osób z rozkładu normalnego poza płotami wypadało średnio 1.16 wyniku, a w 60.1% prób wykres pudełkowy pokazał co najmniej jedną „obserwację odstającą”. W rozkładach skośnych, takich jak czasy reakcji, albo o grubych ogonach (z wysoką kurtozą) takich punktów jest więcej, a te za górnym płotem to często prawdziwe, choć powolne odpowiedzi.
Decyzje o obserwacjach odstających podejmuj więc według kryteriów ustalonych przed analizą (najlepiej w prerejestracji). Najpierw sprawdź, czy wynik nie jest błędem zapisu albo efektem nieuważnego wypełniania (zob. straightlining i nieuważne odpowiedzi). Jeśli potrzebujesz kryterium w stylu „średnia ± k odchyleń”, Leys i in. (2013) odradzają średnią i SD, bo same reagują na wartości odstające, i proponują w zamian medianę z medianowym odchyleniem bezwzględnym (MAD).
Jak opisać IQR w pracy (APA)
Rozstęp ćwiartkowy podawaj razem z medianą – w nawiasie albo w osobnej kolumnie tabeli. IQR to jedna liczba; jeśli chcesz pokazać granice środkowej połowy wyników, podaj Q1 i Q3. Krzywinski i Altman (2014) przypominają, że nie ma jednej metody liczenia kwartyli, dlatego w podpisie wykresu pudełkowego opisz sposób jego konstrukcji i podaj liczebność próby.
Przykładowy podpis wykresu: „Pudełko obejmuje wyniki od Q1 do Q3, linia w pudełku to mediana, wąsy sięgają do najbardziej skrajnych wyników w odległości 1.5 × IQR od krawędzi pudełka, a punkty oznaczają wyniki poza tym zakresem; n = 120, kwartyle obliczono w R (typ 7)”. Pamiętaj, że SPSS liczy kwartyle metodą typu 6 (tu IQR = 183.25 ms), a funkcja boxplot() w R rysuje pudełko z zawiasów Tukeya (540.5–721 ms) – więcej w haśle o kwartylach.
Przykład w R
Kod liczy kwartyle, IQR, płoty Tukeya i wyniki poza płotami, a na koniec sprawdza odporność IQR na jeden ekstremalny wynik. W SPSS IQR i wykres pudełkowy otrzymasz w menu Analyze → Descriptive Statistics → Explore (tabela Descriptives: Interquartile Range; zakładka Plots: Boxplots).
IQR i płoty Tukeya
R
set.seed(53)
rt <- round(rnorm(120, mean = 500, sd = 50) + rexp(120, rate = 1 / 150))  # czasy reakcji (ms)
q <- quantile(rt, c(0.25, 0.75))            # Q1 i Q3 (typ 7, domyślny w R)
iqr <- IQR(rt)                              # IQR = Q3 - Q1
c(Q1 = q[[1]], Q3 = q[[2]], IQR = iqr, IQR_typ6 = IQR(rt, type = 6))
ploty <- c(dolny = q[[1]] - 1.5 * iqr, gorny = q[[2]] + 1.5 * iqr)
ploty                                       # płoty Tukeya
sort(rt[rt < ploty["dolny"] | rt > ploty["gorny"]])   # wyniki poza płotami
boxplot.stats(rt)$stats                     # tak liczy boxplot(): wąsy i zawiasy
zam <- rt; zam[which.max(rt)] <- 5000       # najwolniejszy wynik zamieniony na 5000 ms
round(c(SD = sd(rt), SD_po = sd(zam), IQR = IQR(rt), IQR_po = IQR(zam)), 2)
Wynik w R
      Q1       Q3      IQR IQR_typ6
  541.75   719.50   177.75   183.25
  dolny   gorny
275.125 986.125
[1] 1037 1038 1198 1267
[1] 420.0 540.5 594.5 721.0 980.0
    SD  SD_po    IQR IQR_po
154.37 423.08 177.75 177.75
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Zapis „IQR = 541.75–719.50” – to są kwartyle; IQR to ich różnica: 177.75.
- Automatyczne usuwanie wszystkich punktów poza płotami – nawet w danych z rozkładu normalnego w 60.1% prób po 120 osób pojawia się co najmniej jeden taki punkt.
- IQR razem ze średnią – łącz IQR z medianą, a średnią z odchyleniem standardowym.
- Porównywanie IQR z różnych programów bez sprawdzenia metody – R (typ 7) i SPSS (typ 6) dały tu 177.75 i 183.25 ms (Hyndman i Fan, 1996).
- Wykres pudełkowy dla bardzo małej próby – przy kilku obserwacjach lepiej pokazać same punkty; Krzywinski i Altman (2014) podają minimum n = 5.
- Reguła M ± 3 SD zamiast odpornego kryterium – średnia i SD same reagują na wartości odstające (Leys i in., 2013).
Najczęstsze pytania
Jak obliczyć rozstęp ćwiartkowy?
Oblicz pierwszy (Q1) i trzeci (Q3) kwartyl, a następnie odejmij: IQR = Q3 − Q1. Dla 120 czasów reakcji z przykładu Q1 = 541.75 ms i Q3 = 719.50 ms, więc IQR = 177.75 ms. W R: IQR(x).
Co oznacza rozstęp ćwiartkowy?
To szerokość przedziału, w którym mieści się środkowe 50% uporządkowanych wyników. Im większy IQR, tym bardziej zróżnicowane są typowe wyniki. Nie zależy od wartości najbardziej skrajnych obserwacji, dlatego dobrze opisuje rozproszenie w skośnych rozkładach.
Jak wyznaczyć obserwacje odstające metodą 1.5 × IQR?
Policz płoty Tukeya: dolny Q1 − 1.5 × IQR i górny Q3 + 1.5 × IQR. Wyniki poza tym przedziałem to kandydaci na obserwacje odstające – sprawdź je, zanim cokolwiek usuniesz. W przykładzie górny płot wyniósł 986.1 ms, a poza nim znalazły się cztery wyniki.
Czym różni się rozstęp ćwiartkowy od rozstępu?
Rozstęp to różnica między największym a najmniejszym wynikiem, więc zależy od dwóch najbardziej skrajnych obserwacji. Rozstęp ćwiartkowy obejmuje tylko środkowe 50% wyników i jest odporny na wartości skrajne. Gdy w przykładzie najwolniejszy czas zamieniono na 5000 ms, rozstęp wzrósł z 847 do 4580 ms, a IQR się nie zmienił.
Podawać IQR czy odchylenie standardowe?
Przy rozkładach zbliżonych do symetrycznych podaj średnią i odchylenie standardowe. Przy wyraźnej skośności albo wartościach skrajnych – medianę i IQR. Nie łącz średniej z IQR ani mediany z SD.
Dlaczego SPSS podaje inny IQR niż R?
Bo programy liczą kwartyle różnymi metodami: SPSS typem 6, a R domyślnie typem 7. Dla 120 czasów reakcji IQR wyniósł 183.25 ms metodą SPSS i 177.75 ms w R. Szczegóły w haśle kwartyle.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Nieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Krzywinski, M., & Altman, N. (2014). Visualizing samples with box plots. Nature Methods, 11(2), 119–120. https://doi.org/10.1038/nmeth.2813
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013 ● Otwarty dostęp
- Mishra, P., Pandey, C. M., Singh, U., Gupta, A., Sahu, C., & Keshri, A. (2019). Descriptive statistics and normality tests for statistical data. Annals of Cardiac Anaesthesia, 22(1), 67–72. https://doi.org/10.4103/aca.ACA_157_18 ● Otwarty dostęp
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wan, X., Wang, W., Liu, J., & Tong, T. (2014). Estimating the sample mean and standard deviation from the sample size, median, range and/or interquartile range. BMC Medical Research Methodology, 14(1), Article 135. https://doi.org/10.1186/1471-2288-14-135 ● Otwarty dostęp
Cytowania BibTeX
@article{hyndman1996sample, author={Hyndman, Rob J. and Fan, Yanan}, title={{Sample quantiles in statistical packages}}, journal={The American Statistician}, year={1996}, volume={50}, number={4}, pages={361--365}, doi={10.1080/00031305.1996.10473566}}@article{krzywinski2014visualizing, author={Krzywinski, Martin and Altman, Naomi}, title={{Visualizing samples with box plots}}, journal={Nature Methods}, year={2014}, volume={11}, number={2}, pages={119--120}, doi={10.1038/nmeth.2813}}@article{leys2013detecting, author={Leys, Christophe and Ley, Christophe and Klein, Olivier and Bernard, Philippe and Licata, Laurent}, title={{Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median}}, journal={Journal of Experimental Social Psychology}, year={2013}, volume={49}, number={4}, pages={764--766}, doi={10.1016/j.jesp.2013.03.013}}@article{mishra2019descriptive, author={Mishra, Prabhaker and Pandey, Chandra M. and Singh, Uttam and Gupta, Anshul and Sahu, Chinmoy and Keshri, Amit}, title={{Descriptive statistics and normality tests for statistical data}}, journal={Annals of Cardiac Anaesthesia}, year={2019}, volume={22}, number={1}, pages={67--72}, doi={10.4103/aca.aca_157_18}}@book{tukey1977exploratory, author={Tukey, John W.}, title={{Exploratory data analysis}}, year={1977}, publisher={Addison-Wesley}}@article{wan2014estimating, author={Wan, Xiang and Wang, Wenqian and Liu, Jiming and Tong, Tiejun}, title={{Estimating the sample mean and standard deviation from the sample size, median, range and/or interquartile range}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={135}, doi={10.1186/1471-2288-14-135}}