Co to jest metaanaliza?
Metaanaliza (ang. meta-analysis) to statystyczna synteza wyników wielu badań, które odpowiadają na to samo pytanie. Łączy wielkości efektu – a nie wartości p – w jedno oszacowanie z przedziałem ufności i sprawdza, na ile wyniki poszczególnych badań różnią się od siebie. Najczęściej jest częścią przeglądu systematycznego: pytanie, kryteria włączenia, wyszukiwanie i ocenę badań planuje się przed połączeniem wyników, a całość raportuje według wytycznych PRISMA 2020, które obejmują 27-punktową listę kontrolną i diagramy przepływu (Page i in., 2021).
To hasło wyjaśnia podstawowe pojęcia metaanalizy na jednym małym przykładzie. Cały proces – od protokołu i wyszukiwania po ekstrakcję danych i raport – opisujemy we wpisach metaanaliza: jak rzetelnie połączyć wyniki wielu badań oraz metaanaliza wielopoziomowa, umbrella review i PRISMA 2020.
Wielkość efektu – wspólna waluta badań
Badania raportują wyniki na różnych skalach, dlatego każdy wynik najpierw przelicza się na wspólną miarę: standaryzowaną różnicę średnich (d Cohena albo jego poprawioną wersję, g Hedgesa) przy porównaniu grup, współczynnik korelacji przy związkach zmiennych albo logarytm ilorazu szans przy wynikach dychotomicznych. Każdy efekt yi ma też wariancję z próby vi, która maleje wraz z liczebnością badania. Efekt łączny to średnia ważona:
Większe, a więc precyzyjniejsze badania dostają większą wagę. Składnik τ² w drugim wzorze to wariancja prawdziwych efektów między badaniami – od niego zależy, który model wybierzesz.
Model efektu wspólnego a model efektów losowych
- Model efektu wspólnego (ang. common-effect lub fixed-effect) zakłada, że wszystkie badania szacują ten sam prawdziwy efekt, a wyniki różnią się tylko błędem losowym. Wniosek dotyczy włączonych badań.
- Model efektów losowych (ang. random-effects) zakłada, że prawdziwe efekty różnią się między badaniami – z powodu innych populacji, procedur czy narzędzi – i szacuje średnią ich rozkładu oraz wariancję τ². Wniosek dotyczy populacji podobnych badań.
Borenstein i in. (2010) podkreślają, że choć oba modele używają podobnych wzorów i często dają zbliżone liczby, opierają się na zasadniczo różnych założeniach, a wybór modelu decyduje o poprawności oszacowań i o tym, jak interpretować wynik. W psychologii badania rzadko są identyczne, dlatego zwykle wybiera się model efektów losowych. Decyzję zapisz w protokole przed analizą, a nie po obejrzeniu testu heterogeniczności.
Heterogeniczność: Q, I², τ² i przedział predykcji
| Miara | Co mówi | W przykładzie |
|---|---|---|
| Q Cochrana | Test hipotezy, że wszystkie badania szacują ten sam efekt (rozkład χ² z k − 1 stopniami swobody) | Q(9) = 15.66, p = .074 |
| I² | Odsetek zmienności wyników wynikający z różnic między badaniami, a nie z przypadku: I² = 100% × (Q − df) / Q | 43.7% |
| τ² (τ) | Wariancja (odchylenie standardowe) prawdziwych efektów w jednostkach wielkości efektu | τ² = 0.038, τ = 0.19 |
| Przedział predykcji | Zakres, w którym prawdopodobnie znajdzie się prawdziwy efekt w nowym, podobnym badaniu | [−0.03, 0.81] |
Higgins i in. (2003) zaproponowali I² właśnie dlatego, że test Q ma małą moc, gdy badań jest niewiele; wartości 25%, 50% i 75% wstępnie nazwali heterogenicznością niską, umiarkowaną i wysoką. I² mówi jednak, jaka część zmienności wyników jest „prawdziwa”, a nie jak bardzo różnią się same efekty – to pokazują τ i przedział predykcji. IntHout i in. (2016) przeanalizowali 479 istotnych metaanaliz z bazy Cochrane, w których wystąpiła heterogeniczność: w 72.4% z nich 95% przedział predykcji obejmował brak efektu albo efekt przeciwny. Dlatego zalecają, by przedział predykcji podawać rutynowo.
Przykład: trening uważności a stres w 10 badaniach
Zebraliśmy 10 badań (dane symulowane), w których porównano stres po treningu uważności i w grupie kontrolnej. Grupy liczyły od 20 do 72 osób, łącznie 868 uczestników. Efekty wyrażono jako g Hedgesa; wartości dodatnie oznaczają mniejszy stres po treningu. Obliczenia wykonano w pakiecie metafor (Viechtbauer, 2010), w modelu efektów losowych z estymatorem REML.
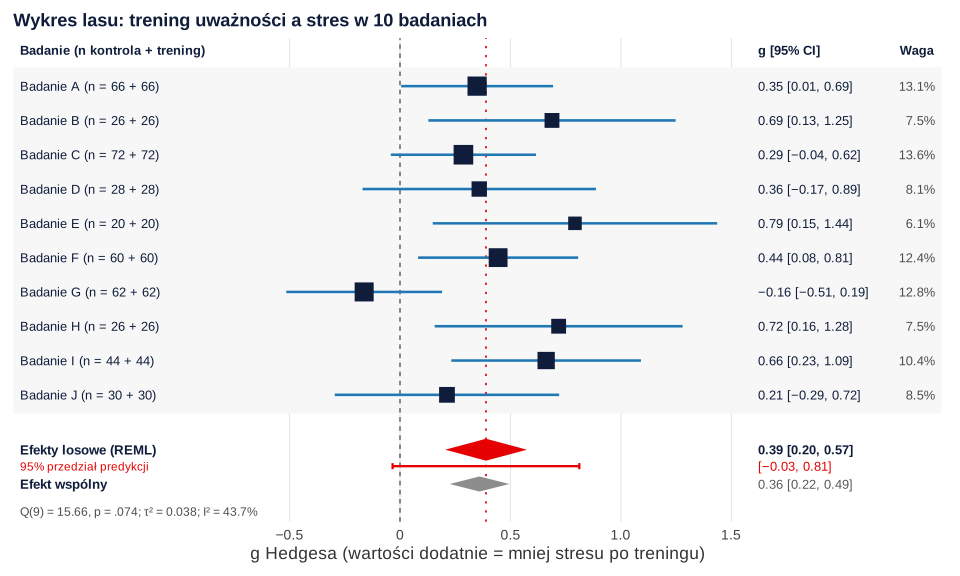
Efekt łączny wyniósł g = 0.39, 95% CI [0.20, 0.57], z = 4.12, p < .001: trening obniżał stres przeciętnie o około 0.4 odchylenia standardowego. Test heterogeniczności był nieistotny, Q(9) = 15.66, p = .074, ale I² = 43.7% i τ = 0.19 wskazują na umiarkowane różnice między badaniami. Widać to w przedziale predykcji [−0.03, 0.81]: w nowym badaniu prawdziwy efekt może być zarówno wyraźny, jak i bliski zera. Przy 10 badaniach szacunki heterogeniczności są mało precyzyjne – 95% CI dla I² sięgał od 0% do 82.5%. Model efektu wspólnego dał podobną średnią, g = 0.36, 95% CI [0.22, 0.49], ale węższy przedział, bo pomija różnice między badaniami.
Zwróć też uwagę, że cztery z dziesięciu badań osobno nie wykazały istotnego efektu (ich przedziały ufności obejmują zero), choć łącznie dowody są wyraźne. Dlatego zliczanie badań „istotnych” i „nieistotnych” nie zastąpi metaanalizy.
Błąd publikacji
Metaanaliza jest tak dobra, jak zbiór badań, który łączy. Jeśli wyniki istotne częściej trafiają do czasopism niż nieistotne (efekt szuflady), efekt łączny będzie zawyżony. Typowym narzędziem diagnostycznym jest wykres lejkowy, czyli efekty badań na tle ich błędów standardowych, i test jego asymetrii. Egger i in. (1997) pokazali, że asymetria wykresu lejkowego mierzona prostym testem regresyjnym przewidywała rozbieżność metaanaliz z późniejszymi dużymi badaniami. Zastrzegli jednak, że gdy metaanaliza obejmuje niewiele małych badań, test ma ograniczoną zdolność wykrycia błędu.
W przykładzie test Eggera dał z = 1.93, p = .054. Dane były symulowane bez żadnego błędu publikacji, więc ten graniczny wynik jest dziełem przypadku – w małych badaniach akurat wypadły nieco większe efekty. To dobra przestroga: przy kilkunastu badaniach asymetria wykresu lejkowego nie przesądza o błędzie publikacji, a jej brak nie dowodzi, że błędu nie ma. Asymetrię może też wywołać zwykła heterogeniczność.
Jak opisać wynik metaanalizy (APA)
Podaj liczbę badań i uczestników, miarę efektu, model i estymator τ², efekt łączny z 95% CI, miary heterogeniczności z przedziałem predykcji oraz wynik oceny błędu publikacji. Wzór dla przykładu:
Pełną listę elementów raportu znajdziesz w haśle przegląd systematyczny i PRISMA.
Metaanaliza w R (pakiet metafor)
Kod tworzy dane 10 badań, liczy g Hedgesa i jego wariancję, dopasowuje model efektu wspólnego i model efektów losowych, podaje przedziały ufności dla τ² i I², przedział predykcji, wagi badań i test Eggera. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Wielkości efektu, modele i heterogeniczność
R
library(metafor)   # escalc(), rma(), forest(), funnel(), regtest()

# Dane symulowane: 10 badań porównujących stres (0–40) po treningu uważności i w grupie kontrolnej
set.seed(64)
k <- 10
n <- sample(seq(20, 80, by = 2), k, replace = TRUE)   # liczebność każdej z dwóch grup w badaniu
theta <- rnorm(k, 0.40, 0.20)                         # prawdziwe efekty różnią się między badaniami
badania <- do.call(rbind, lapply(1:k, function(i) {
  kontrola <- rnorm(n[i], 20, 6); trening <- rnorm(n[i], 20 - 6 * theta[i], 6)
  data.frame(badanie = paste("Badanie", LETTERS[i]), n_k = n[i], m_k = mean(kontrola), sd_k = sd(kontrola),
             n_t = n[i], m_t = mean(trening), sd_t = sd(trening))
}))

# 1. Wielkość efektu w każdym badaniu: g Hedgesa (dodatnie = mniej stresu po treningu) i jego wariancja
es <- escalc(measure = "SMD", m1i = m_k, sd1i = sd_k, n1i = n_k, m2i = m_t, sd2i = sd_t, n2i = n_t,
             data = badania, slab = badanie)
summary(es)[, c("badanie", "n_k", "yi", "vi", "ci.lb", "ci.ub")]

# 2. Model efektu wspólnego (equal effects) i model efektów losowych (REML)
wspolny <- rma(yi, vi, data = es, method = "EE")
losowy  <- rma(yi, vi, data = es, method = "REML")
wspolny
losowy
confint(losowy)            # 95% CI dla τ² i I²
predict(losowy)            # efekt łączny z 95% CI i 95% przedziałem predykcji (pi.lb, pi.ub)
round(weights(losowy), 1)  # wagi badań (%)

# 3. Asymetria wykresu lejkowego (test regresyjny Eggera) – przy 10 badaniach test ma małą moc
egger <- regtest(losowy)
round(c(z = egger$zval, p = egger$pval), 4)

# Wykresy standardowe z pakietu: forest(losowy); funnel(losowy)
Wynik w R
Loading required package: Matrix
Loading required package: metadat
Loading required package: numDeriv

Loading the 'metafor' package (version 5.0-1). For an
introduction to the package please type: help(metafor)


     badanie n_k      yi     vi   ci.lb  ci.ub
1  Badanie A  66  0.3490 0.0308  0.0052 0.6927
2  Badanie B  26  0.6877 0.0815  0.1283 1.2471
3  Badanie C  72  0.2870 0.0281 -0.0414 0.6153
4  Badanie D  28  0.3586 0.0726 -0.1694 0.8866
5  Badanie E  20  0.7918 0.1078  0.1482 1.4354
6  Badanie F  60  0.4441 0.0342  0.0818 0.8063
7  Badanie G  62 -0.1621 0.0324 -0.5147 0.1905
8  Badanie H  26  0.7180 0.0819  0.1571 1.2788
9  Badanie I  44  0.6614 0.0479  0.2322 1.0905
10 Badanie J  30  0.2126 0.0670 -0.2949 0.7200


Equal-Effects Model (k = 10)

I^2 (total heterogeneity / total variability):   42.51%
H^2 (total variability / sampling variability):  1.74

Test for Heterogeneity:
Q(df = 9) = 15.6556, p-val = 0.0744

Model Results:

estimate      se    zval    pval   ci.lb   ci.ub
  0.3592  0.0687  5.2257  <.0001  0.2245  0.4939  ***

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


Random-Effects Model (k = 10; tau^2 estimator: REML)

tau^2 (estimated amount of total heterogeneity): 0.0375 (SE = 0.0411)
tau (square root of estimated tau^2 value):      0.1938
I^2 (total heterogeneity / total variability):   43.73%
H^2 (total variability / sampling variability):  1.78

Test for Heterogeneity:
Q(df = 9) = 15.6556, p-val = 0.0744

Model Results:

estimate      se    zval    pval   ci.lb   ci.ub
  0.3890  0.0944  4.1191  <.0001  0.2039  0.5741  ***

---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


       estimate  ci.lb   ci.ub
tau^2    0.0375 0.0000  0.2271
tau      0.1938 0.0000  0.4765
I^2(%)  43.7274 0.0000 82.4540
H^2      1.7771 1.0000  5.6993


   pred     se  ci.lb  ci.ub   pi.lb  pi.ub
 0.3890 0.0944 0.2039 0.5741 -0.0335 0.8115

Badanie A Badanie B Badanie C Badanie D Badanie E Badanie F Badanie G Badanie H
     13.1       7.5      13.6       8.1       6.1      12.4      12.8       7.5
Badanie I Badanie J
     10.4       8.5
     z      p
1.9251 0.0542
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; wykres lasu narysowano w pakiecie ggplot2 na podstawie wyników z pakietu metafor. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- metafor (wersja 5.0.1): Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Łączenie wartości p albo zliczanie badań istotnych zamiast łączenia wielkości efektu z ich wariancjami.
- Model efektu wspólnego przy wyraźnie różnych badaniach – przedział ufności jest wtedy zbyt wąski.
- I² traktowane jako miara wielkości różnic między efektami. Podawaj też τ i przedział predykcji.
- Kilka efektów z jednego badania potraktowanych jak niezależne – zaniża to niepewność; potrzebny jest model wielopoziomowy (zob. metaanaliza wielopoziomowa).
- Wnioski o braku błędu publikacji z nieistotnego testu asymetrii przy kilkunastu badaniach.
- Łączenie badań o niskiej jakości bez oceny ryzyka błędu – precyzyjna średnia z obciążonych badań pozostaje obciążona.
Najczęstsze pytania
Co to jest metaanaliza?
Metaanaliza to statystyczne połączenie wyników wielu badań dotyczących tego samego pytania. Każdy wynik przelicza się na wspólną miarę wielkości efektu (np. g Hedgesa, r, logarytm ilorazu szans), a następnie liczy średnią ważoną precyzją badań z przedziałem ufności i ocenia różnice między badaniami.
Czym się różni metaanaliza od przeglądu systematycznego?
Przegląd systematyczny to cała procedura: pytanie, protokół, wyszukiwanie, selekcja i ocena badań. Metaanaliza jest jego częścią statystyczną – łączy wyniki liczbowo. Przegląd może nie zawierać metaanalizy, gdy badania są zbyt różne, by je łączyć. Zob. przegląd systematyczny i PRISMA.
Model efektów stałych czy losowych?
Model efektu wspólnego (stałego) zakłada jeden prawdziwy efekt we wszystkich badaniach, a model efektów losowych – rozkład prawdziwych efektów o wariancji τ². W psychologii badania rzadko są identyczne, dlatego zwykle wybiera się model efektów losowych. Decyzję zapisz w protokole przed analizą.
Co oznacza I² w metaanalizie?
I² to odsetek zmienności wyników wynikający z rzeczywistych różnic między badaniami, a nie z przypadku: I² = 100% × (Q − df)/Q. Wartości 25%, 50% i 75% nazywa się zwykle heterogenicznością niską, umiarkowaną i wysoką. I² nie mówi jednak, jak duże są różnice efektów – to pokazują τ i przedział predykcji.
Jak zrobić metaanalizę w R?
Najczęściej w pakiecie metafor: funkcja escalc() liczy wielkości efektu i ich wariancje, rma() dopasowuje model (np. efektów losowych z REML), predict() podaje przedział predykcji, a forest() i funnel() rysują wykres lasu i wykres lejkowy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Metaanaliza – wizualizacja na obrazkach
Wykres lasu w dwóch modelach, I² ≈ 0/50/80%, przedział predykcji, lejek z selekcją i 1000 metaanaliz z błędem publikacji – pięć rysunków z kodem R.
Czytaj →PoradnikMetaanaliza w jamovi (MAJOR) krok po kroku
Moduł MAJOR w jamovi: okno Mean Differences, ustawienia domyślne, tabele modelu losowego i heterogeniczności, przedział predykcji, test Eggera i fail-safe N, diagnostyka wpływu – z liczbami z metafor.
Czytaj →PoradnikPrzegląd zakresu (scoping review)
Kiedy wybrać scoping review, pytanie według PCC, selekcja z pilotażem kappa, formularz ekstrakcji, mapa dowodów i raport PRISMA-ScR – z kodem R.
Czytaj →PoradnikMetaanaliza krok po kroku
Od pytania do PRISMA 2020: g Hedgesa, model efektów losowych, heterogeniczność i przedział predykcji, moderatory, wykres lejkowy – z kodem metafor.
Czytaj →PoradnikMetaanaliza wielopoziomowa, umbrella review i PRISMA 2020
Wielkość efektu i przeliczanie danych, modele efektów losowych, metaanaliza trójpoziomowa, umbrella review z klasami dowodów, PRISMA 2020 i kod R.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Borenstein, M., Hedges, L. V., Higgins, J. P. T., & Rothstein, H. R. (2010). A basic introduction to fixed-effect and random-effects models for meta-analysis. Research Synthesis Methods, 1(2), 97–111. https://doi.org/10.1002/jrsm.12
- Egger, M., Davey Smith, G., Schneider, M., & Minder, C. (1997). Bias in meta-analysis detected by a simple, graphical test. BMJ, 315(7109), 629–634. https://doi.org/10.1136/bmj.315.7109.629 ● Otwarty dostęp: pełny tekst
- Higgins, J. P. T., Thompson, S. G., Deeks, J. J., & Altman, D. G. (2003). Measuring inconsistency in meta-analyses. BMJ, 327(7414), 557–560. https://doi.org/10.1136/bmj.327.7414.557 ● Otwarty dostęp: pełny tekst
- IntHout, J., Ioannidis, J. P. A., Rovers, M. M., & Goeman, J. J. (2016). Plea for routinely presenting prediction intervals in meta-analysis. BMJ Open, 6(7), Article e010247. https://doi.org/10.1136/bmjopen-2015-010247 ● Otwarty dostęp
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L., Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A., Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., . . . Moher, D. (2021). The PRISMA 2020 statement: An updated guideline for reporting systematic reviews. BMJ, 372, Article n71. https://doi.org/10.1136/bmj.n71 ● Otwarty dostęp
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3), 1–48. https://doi.org/10.18637/jss.v036.i03 ● Otwarty dostęp
Cytowania BibTeX
@article{borenstein2010basic, author={Borenstein, Michael and Hedges, Larry V. and Higgins, Julian P. T. and Rothstein, Hannah R.}, title={{A basic introduction to fixed-effect and random-effects models for meta-analysis}}, journal={Research Synthesis Methods}, year={2010}, volume={1}, number={2}, pages={97--111}, doi={10.1002/jrsm.12}}@article{egger1997bias, author={Egger, Matthias and Davey Smith, George and Schneider, Martin and Minder, Christoph}, title={{Bias in meta-analysis detected by a simple, graphical test}}, journal={BMJ}, year={1997}, volume={315}, number={7109}, pages={629--634}, doi={10.1136/bmj.315.7109.629}}@article{higgins2003measuring, author={Higgins, Julian P. T. and Thompson, Simon G. and Deeks, Jonathan J. and Altman, Douglas G.}, title={{Measuring inconsistency in meta-analyses}}, journal={BMJ}, year={2003}, volume={327}, number={7414}, pages={557--560}, doi={10.1136/bmj.327.7414.557}}@article{inthout2016plea, author={IntHout, Joanna and Ioannidis, John P. A. and Rovers, Maroeska M. and Goeman, Jelle J.}, title={{Plea for routinely presenting prediction intervals in meta-analysis}}, journal={BMJ Open}, year={2016}, volume={6}, number={7}, eid={e010247}, doi={10.1136/bmjopen-2015-010247}}@article{page2021prisma, author={Page, Matthew J and McKenzie, Joanne E and Bossuyt, Patrick M and Boutron, Isabelle and Hoffmann, Tammy C and Mulrow, Cynthia D and Shamseer, Larissa and Tetzlaff, Jennifer M and Akl, Elie A and Brennan, Sue E and Chou, Roger and Glanville, Julie and Grimshaw, Jeremy M and Hróbjartsson, Asbjørn and Lalu, Manoj M and Li, Tianjing and Loder, Elizabeth W and Mayo-Wilson, Evan and McDonald, Steve and McGuinness, Luke A and Stewart, Lesley A and Thomas, James and Tricco, Andrea C and Welch, Vivian A and Whiting, Penny and Moher, David}, title={{The PRISMA 2020 statement: An updated guideline for reporting systematic reviews}}, journal={BMJ}, year={2021}, volume={372}, eid={n71}, doi={10.1136/bmj.n71}}@article{viechtbauer2010conducting, author={Viechtbauer, Wolfgang}, title={{Conducting meta-analyses in R with the metafor package}}, journal={Journal of Statistical Software}, year={2010}, volume={36}, number={3}, pages={1--48}, doi={10.18637/jss.v036.i03}}