Co to jest rozstęp?
Rozstęp (ang. range) to różnica między największym a najmniejszym wynikiem w danych. To najprostsza miara rozproszenia w statystyce opisowej: mówi, jak szeroki przedział zajmują wszystkie wyniki. W psychologii spotkasz go najczęściej w opisie próby (najmłodsza i najstarsza osoba badana) i przy opisie skal, gdzie porównuje się zakres teoretyczny (np. 0–40 pkt) z zakresem faktycznie uzyskanych wyników.
Warto odróżnić dwa sposoby podawania tej samej informacji. Zakres to para liczb: minimum i maksimum (w przykładzie niżej 14–27 słów). Rozstęp to jedna liczba – ich różnica (13 słów). W raportach według APA zwykle podaje się zakres, bo jest bardziej informatywny: z samego rozstępu nie da się odtworzyć, gdzie leżą wyniki.
Wzór i przykład
Przykład (dane symulowane): 12 osób uczyło się listy 30 słów, a potem odtwarzało je z pamięci. Wyniki to 14, 17, 18, 18, 19, 20, 21, 21, 22, 23, 24 i 27 słów. Najmniejszy wynik to 14, największy – 27, więc:
Wyniki mieszczą się w zakresie 14–27, choć skala pozwala na 0–30. Dla porównania odchylenie standardowe wynosi 3.47 słowa, a rozstęp ćwiartkowy (IQR) – 4.25 słowa.
Rozstęp jest wrażliwy na wartości skrajne
Rozstęp zależy tylko od dwóch wyników – najmniejszego i największego. Załóżmy, że pierwsza osoba przerwała zadanie i odtworzyła 3 słowa zamiast 14:
| Dane | Zakres | Rozstęp | M | SD | IQR |
|---|---|---|---|---|---|
| Wyniki oryginalne | 14–27 | 13 | 20.33 | 3.47 | 4.25 |
| Jeden wynik zmieniony na 3 | 3–27 | 24 | 19.42 | 5.90 | 4.25 |
Jeden wynik prawie podwoił rozstęp (z 13 do 24) i podniósł odchylenie standardowe z 3.47 do 5.90, a IQR nie zmienił się wcale. Rozstęp jest więc pierwszą miarą, która zdradza obserwację odstającą albo błąd w danych – i jednocześnie najgorszą miarą typowego rozproszenia, gdy takie wyniki występują. Dlatego przy kontroli danych zawsze sprawdzaj minimum i maksimum, a do opisu rozproszenia używaj miar, które opierają się na większej części wyników.
Rozstęp rośnie wraz z liczebnością próby
Druga, mniej znana wada: rozstęp zależy od liczby obserwacji. Im więcej osób zbadasz, tym większa szansa, że trafisz na wyniki z dalekich ogonów rozkładu. Sprawdziliśmy to symulacyjnie: z populacji wyników na skali IQ (M = 100, SD = 15) losowaliśmy po 10 000 prób różnej wielkości i w każdej liczyliśmy rozstęp, SD i IQR.
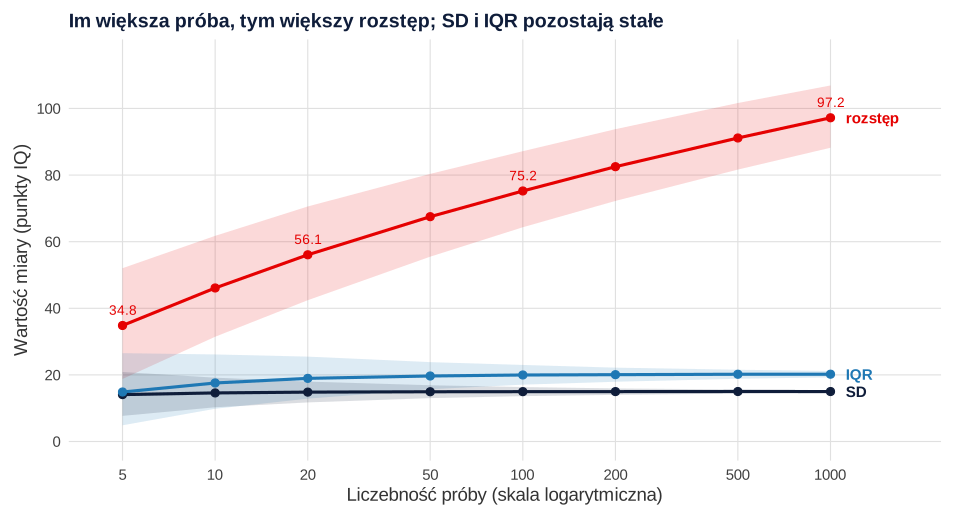
Średni rozstęp wzrósł z 34.83 punktu przy 5 osobach do 97.20 punktu przy 1000 osobach, a przy 20 osobach 80% prób dało rozstęp od 42.43 do 70.58 punktu. W tym czasie średnie SD pozostawało bliskie 15 (od 14.08 do 15.00), a średni IQR stabilizował się w okolicy 20. Nie porównuj więc rozstępów grup o różnej liczebności – większa grupa będzie miała większy rozstęp nawet wtedy, gdy obie pochodzą z tej samej populacji.
Ta zależność ma znaczenie, gdy z rozstępu szacuje się odchylenie standardowe, np. w metaanalizie badań, które podały tylko medianę i zakres. Hozo i in. (2005) zaproponowali wzory, w których najlepszym oszacowaniem SD jest rozstęp/4 przy liczebności od 16 do 70 osób i rozstęp/6 przy większych próbach. Wan i in. (2014) zauważyli, że te progi wybrano dość arbitralnie, i zaproponowali dzielnik zależny płynnie od liczebności:
Φ−1 to funkcja odwrotna do dystrybuanty rozkładu normalnego. W naszej symulacji stosunek rozstępu do SD wynosił 2.32 przy 5 osobach, 3.74 przy 20, 5.01 przy 100 i 6.48 przy 1000, a ξ(n) dawało odpowiednio 2.36, 3.74, 5.00 i 6.45. Wzór Wan i in. (2014) odtworzył więc SD = 15 z dokładnością do 0.24 punktu, a reguły rozstęp/4 i rozstęp/6 dawały od 12.54 do 16.88 punktu. Pamiętaj, że oba wzory zakładają rozkład zbliżony do normalnego.
Rozstęp, IQR i odchylenie standardowe
| Cecha | Rozstęp | Rozstęp ćwiartkowy (IQR) | Odchylenie standardowe (SD) |
|---|---|---|---|
| Wzór | max − min | Q3 − Q1 | √[Σ(x − M)² / (n − 1)] |
| Ile wyników wykorzystuje | Dwa skrajne | Środkowe 50% | Wszystkie |
| Wartości skrajne | Bardzo wrażliwy | Odporny | Wrażliwe |
| Zależność od liczebności próby | Rośnie z n | Stabilny | Stabilne |
| Z czym podawać | Jako zakres (min–max), obok M lub Mdn | Z medianą | Ze średnią |
| Najlepsze zastosowanie | Kontrola danych, opis próby (np. wiek) | Rozkłady skośne, dane z wartościami skrajnymi | Rozkłady zbliżone do normalnego |
Mishra i in. (2019) opisują IQR jako miarę rozproszenia środkowych 50% wyników, a Altman i Bland (2005) przypominają, że odchylenie standardowe jest poprawną miarą zmienności niezależnie od kształtu rozkładu. Rozstęp nie zastępuje żadnej z tych miar, ale dobrze je uzupełnia: pokazuje granice danych, których nie widać w SD ani w IQR.
Jak opisać rozstęp w pracy (APA)
W tekście i tabelach podawaj zakres jako najmniejszą i największą wartość, obok średniej i odchylenia standardowego albo mediany i IQR. Przy zmiennych takich jak wiek podaj zakres nawet wtedy, gdy opisujesz próbę średnią – czytelnik od razu zobaczy, czy w próbie są osoby nietypowe. W tabeli statystyk opisowych użyj kolumn „Min” i „Max” albo jednej kolumny „Zakres” (zob. tabela statystyk opisowych w APA).
Więcej o opisie wieku, płci i innych cech uczestników przeczytasz w poradniku jak opisać charakterystykę próby.
Przykład w R
Funkcja range() zwraca minimum i maksimum, a rozstęp to ich różnica: diff(range(x)). Druga część kodu powtarza symulację z rysunku 1 i porównuje stosunek rozstępu do SD z dzielnikiem ξ(n). W SPSS rozstęp (Range) oraz minimum i maksimum zaznaczysz w Analyze → Descriptive Statistics → Frequencies → Statistics albo w Descriptives → Options.
Rozstęp, wrażliwość na wynik skrajny i liczebność próby
R
slowa <- c(14, 17, 18, 18, 19, 20, 21, 21, 22, 23, 24, 27)   # zapamiętane słowa (0–30), 12 osób
range(slowa)                          # najmniejszy i największy wynik
diff(range(slowa))                    # rozstęp = max − min
slowa2 <- replace(slowa, 1, 3)        # jedna osoba przerwała zadanie: 3 słowa zamiast 14
opis <- function(x) round(c(rozstep = diff(range(x)), M = mean(x), Mdn = median(x), SD = sd(x), IQR = IQR(x)), 2)
rbind(oryginalne = opis(slowa), z_wynikiem_3 = opis(slowa2))

# rozstęp, SD i IQR w 10 000 prób z populacji IQ (M = 100, SD = 15)
set.seed(50)
ns <- c(5, 10, 20, 50, 100, 200, 500, 1000)
srednie <- t(sapply(ns, function(n) {
  w <- replicate(10000, { x <- rnorm(n, 100, 15); c(R = diff(range(x)), SD = sd(x), IQR = IQR(x)) })
  rowMeans(w)
}))
xi <- 2 * qnorm((ns - 0.375) / (ns + 0.25))   # Wan i in. (2014): oczekiwany rozstęp w jednostkach SD
round(data.frame(n = ns, srednie, R_do_SD = srednie[, "R"] / 15, xi, SD_z_rozstepu = srednie[, "R"] / xi), 2)
Wynik w R
[1] 14 27
[1] 13
             rozstep     M  Mdn   SD  IQR
oryginalne        13 20.33 20.5 3.47 4.25
z_wynikiem_3      24 19.42 20.5 5.90 4.25
     n     R    SD   IQR R_do_SD   xi SD_z_rozstepu
1    5 34.83 14.08 14.86    2.32 2.36         14.76
2   10 46.10 14.58 17.57    3.07 3.09         14.90
3   20 56.06 14.82 18.95    3.74 3.74         15.00
4   50 67.50 14.93 19.67    4.50 4.49         15.05
5  100 75.22 14.96 19.97    5.01 5.00         15.05
6  200 82.52 14.98 20.06    5.50 5.47         15.09
7  500 91.14 15.00 20.19    6.08 6.05         15.07
8 1000 97.20 15.00 20.20    6.48 6.45         15.06
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów bazowych); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Zapis „rozstęp = 14–27”. Para liczb to zakres; rozstęp to jedna liczba (13). W pracy podawaj zakres albo oba.
- Porównywanie rozstępów grup o różnej liczebności. W symulacji średni rozstęp przy 20 osobach wyniósł 56.06, a przy 100 osobach – 75.22 punktu, choć populacja była ta sama.
- Rozstęp jako jedyna miara rozproszenia. Jeden skrajny wynik zmienia go radykalnie; podawaj też SD albo IQR.
- Mylenie zakresu teoretycznego z uzyskanym. Skala 0–30 to zakres możliwy; w opisie wyników podaj zakres faktycznie uzyskany i zaznacz, czy ktoś osiągnął minimum lub maksimum (zob. efekt sufitu i podłogi).
- Szacowanie SD jako rozstęp/4 niezależnie od liczebności. Stosunek rozstępu do SD rośnie z n; użyj dzielnika zależnego od liczebności (Wan i in., 2014).
- Brak kontroli minimum i maksimum przed analizą. To najszybszy sposób na wykrycie błędów, np. kodu 99 wpisanego zamiast braku danych.
Najczęstsze pytania
Co to jest rozstęp w statystyce?
To różnica między największym a najmniejszym wynikiem w danych, R = max − min. Mówi, jak szeroki przedział zajmują wszystkie wyniki. Na przykład przy wynikach od 14 do 27 punktów rozstęp wynosi 13 punktów.
Jak obliczyć rozstęp?
Znajdź najmniejszy i największy wynik i odejmij jeden od drugiego. W R: diff(range(x)), a range(x) zwraca samo minimum i maksimum. W SPSS rozstęp (Range) zaznaczysz w oknie statystyk procedury Frequencies albo Descriptives.
Czym różni się rozstęp od rozstępu ćwiartkowego?
Rozstęp obejmuje wszystkie wyniki i zależy od dwóch najbardziej skrajnych, a rozstęp ćwiartkowy (IQR = Q3 − Q1) – tylko środkowe 50% wyników. W przykładzie zmiana jednego wyniku z 14 na 3 zwiększyła rozstęp z 13 do 24, a IQR pozostał równy 4.25.
Dlaczego rozstęp zależy od liczebności próby?
Bo im więcej osób zbadasz, tym większa szansa trafienia na wyniki z dalekich ogonów rozkładu. W symulacji z populacji IQ (SD = 15) średni rozstęp wynosił 34.83 punktu przy 5 osobach, 75.22 przy 100 i 97.20 przy 1000, a odchylenie standardowe pozostawało bliskie 15. Dlatego nie porównuj rozstępów grup o różnej liczebności.
Jak podać rozstęp w pracy według APA?
Najczęściej podaje się zakres, czyli minimum i maksimum, np. „wyniki mieściły się w zakresie od 14 do 27 słów (M = 20.33, SD = 3.47)”, albo kolumny „Min” i „Max” w tabeli statystyk opisowych. Rozstęp jako jedną liczbę (tu 13) możesz dopisać w nawiasie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak opisać charakterystykę próby badawczej?
Co uwzględnić w tekście i tabeli, jak dobrać miary opisowe oraz jak nie ukryć problemów z selekcją i brakami danych.
Czytaj →PoradnikWartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikMetaanaliza: jak rzetelnie połączyć wyniki wielu badań
Metaanaliza krok po kroku: pytanie badawcze, protokół, wyszukiwanie, wielkości efektu, heterogeniczność, model losowy i raport PRISMA 2020.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903 ● Otwarty dostęp
- Hozo, S. P., Djulbegovic, B., & Hozo, I. (2005). Estimating the mean and variance from the median, range, and the size of a sample. BMC Medical Research Methodology, 5(1), Article 13. https://doi.org/10.1186/1471-2288-5-13 ● Otwarty dostęp
- Mishra, P., Pandey, C. M., Singh, U., Gupta, A., Sahu, C., & Keshri, A. (2019). Descriptive statistics and normality tests for statistical data. Annals of Cardiac Anaesthesia, 22(1), 67–72. https://doi.org/10.4103/aca.ACA_157_18 ● Otwarty dostęp
- Wan, X., Wang, W., Liu, J., & Tong, T. (2014). Estimating the sample mean and standard deviation from the sample size, median, range and/or interquartile range. BMC Medical Research Methodology, 14(1), Article 135. https://doi.org/10.1186/1471-2288-14-135 ● Otwarty dostęp
Cytowania BibTeX
@article{altman2005standard, author={Altman, Douglas G. and Bland, J. Martin}, title={{Standard deviations and standard errors}}, journal={BMJ}, year={2005}, volume={331}, number={7521}, pages={903}, doi={10.1136/bmj.331.7521.903}}@article{hozo2005estimating, author={Hozo, Stela Pudar and Djulbegovic, Benjamin and Hozo, Iztok}, title={{Estimating the mean and variance from the median, range, and the size of a sample}}, journal={BMC Medical Research Methodology}, year={2005}, volume={5}, number={1}, eid={13}, doi={10.1186/1471-2288-5-13}}@article{mishra2019descriptive, author={Mishra, Prabhaker and Pandey, Chandra M. and Singh, Uttam and Gupta, Anshul and Sahu, Chinmoy and Keshri, Amit}, title={{Descriptive statistics and normality tests for statistical data}}, journal={Annals of Cardiac Anaesthesia}, year={2019}, volume={22}, number={1}, pages={67--72}, doi={10.4103/aca.aca_157_18}}@article{wan2014estimating, author={Wan, Xiang and Wang, Wenqian and Liu, Jiming and Tong, Tiejun}, title={{Estimating the sample mean and standard deviation from the sample size, median, range and/or interquartile range}}, journal={BMC Medical Research Methodology}, year={2014}, volume={14}, number={1}, eid={135}, doi={10.1186/1471-2288-14-135}}