Co to jest efekt sufitu i efekt podłogi?
Efekt sufitu (ang. ceiling effect) występuje wtedy, gdy duża część badanych uzyskuje najwyższy możliwy wynik narzędzia. Efekt podłogi (ang. floor effect) to sytuacja odwrotna – wiele osób ma wynik najniższy. W obu przypadkach narzędzie przestaje różnicować ludzi na jednym krańcu skali: wiemy, że osoba zdobyła 20 punktów na 20, ale nie wiemy, czy umiałaby odpowiedzieć na trudniejsze pytania. Prawdziwy poziom cechy jest „ucięty” na granicy skali.
W psychologii efekt sufitu pojawia się np. w zbyt łatwym teście wiedzy albo w skali satysfakcji wypełnianej przez bardzo zadowolonych klientów. Efekt podłogi typowo widać w skalach objawów klinicznych podanych osobom zdrowym – większość zaznacza „nigdy”. Terwee i in. (2007) uwzględnili efekty podłogi i sufitu wśród kryteriów jakości właściwości pomiarowych kwestionariuszy zdrowotnych, obok trafności, rzetelności i responsywności. To więc cecha nie tylko danych, ale także narzędzia użytego w konkretnej grupie.
Skąd się bierze efekt sufitu i podłogi?
| Przyczyna | Przykład |
|---|---|
| Zadania za łatwe albo za trudne dla badanej grupy | Test wiedzy przygotowany dla pierwszego roku podany studentom piątego roku |
| Wąski zakres odpowiedzi | Trzystopniowa skala odpowiedzi albo wynik z dwóch–trzech pozycji (zob. ile stopni skali Likerta wybrać) |
| Narzędzie niedopasowane do populacji | Skala objawów depresji w próbie zdrowych studentów – wiele wyników 0 |
| Pytania o cechy pożądane społecznie | Samoocena uczciwości czy życzliwości – aprobata społeczna przesuwa odpowiedzi ku maksimum |
| Interwencja „wypycha” grupę na kraniec skali | Po szkoleniu prawie wszyscy zdają test końcowy na 100% |
Konsekwencje dla analizy danych
Sufit i podłoga zmieniają niemal każdą statystykę:
- Średnia i rozproszenie. Przy suficie średnia jest zaniżona względem prawdziwego poziomu cechy, a wariancja i odchylenie standardowe – mniejsze. Rozkład staje się lewostronnie (ujemnie) skośny, a przy podłodze – prawostronnie.
- Związki między zmiennymi. Nachylenie linii regresji się spłaszcza, a korelacja zwykle słabnie, bo osoby różniące się w rzeczywistości dostają ten sam wynik.
- Porównania grup i efekty interakcji. Šimkovic i Träuble (2019) pokazali w symulacjach, że efekty sufitu i podłogi zwiększają obciążenie i niepewność wnioskowania – m.in. o różnicy między grupami i o d Cohena – oraz utrudniają wykrycie efektów głównych i interakcji. Jeśli jedna grupa jest już przy maksimum, różnica między warunkami nie ma się gdzie „zmieścić”.
- Dane podłużne. W symulacjach Wanga i in. (2008) efekt sufitu obejmujący od 10% do 40% obserwacji prowadził w zwykłych modelach krzywej wzrostu do wyboru złego modelu i obciążonych oszacowań kształtu i wielkości zmian (zob. schemat podłużny).
- Rzetelność różnic indywidualnych. Hedge i in. (2018) wyjaśniają, że mała zmienność między osobami obniża rzetelność pomiaru różnic indywidualnych – a sufit właśnie tę zmienność odbiera.
Przykład: zbyt łatwy test wiedzy
Trzysta osób (dane symulowane) napisało test wiedzy z 20 pytań. Prawdziwy wynik zależał od liczby godzin nauki (0.7 pkt na godzinę) i od udziału w kursie powtórkowym (2 pkt). Ten sam poziom wiedzy zmierzyliśmy dwa razy: hipotetycznym testem z trudnymi pytaniami, w którym da się zdobyć ponad 20 punktów, oraz testem 0–20 pkt, który okazał się za łatwy. W drugim teście 49.7% osób uzyskało maksymalne 20 punktów (rysunek 1).
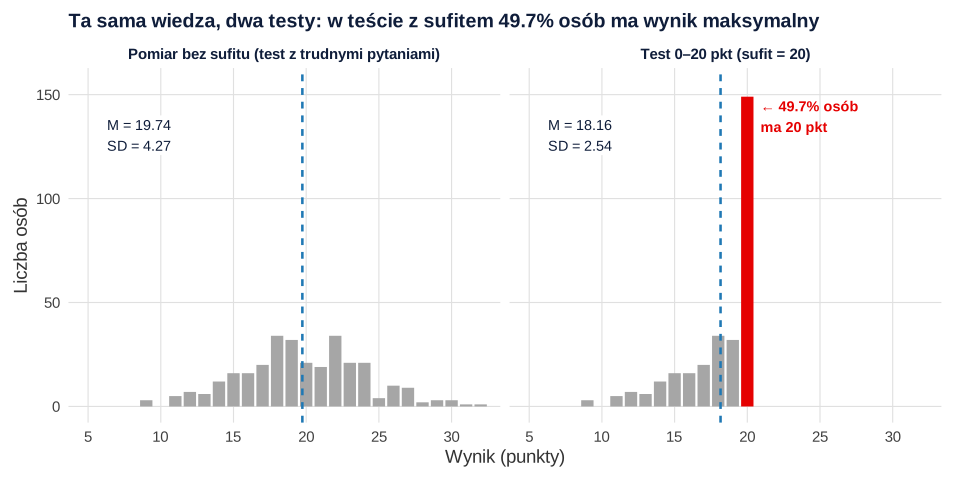
Sufit zmienił wszystkie podstawowe statystyki:
| Statystyka | Bez sufitu | Test 0–20 pkt (sufit) |
|---|---|---|
| Odsetek wyników maksymalnych | – | 49.7% |
| M (SD) | 19.74 (4.27) | 18.16 (2.54) |
| Skośność | 0.08 | −1.47 |
| Korelacja z godzinami nauki | r = .79 | r = .67 |
| Nachylenie regresji (pkt na godzinę) | 0.70 | 0.35 |
| Efekt kursu w regresji (pkt) | 1.70 | 1.02 |
| Różnica średnich: kurs – bez kursu (pkt) | 2.21 | 1.28 |
| d Cohena dla kursu | 0.54 | 0.52 |
Najmocniej ucierpiały wielkości w punktach: nachylenie regresji spadło o połowę (z 0.70 do 0.35 pkt na godzinę), a efekt kursu – z 1.70 do 1.02 pkt. Korelacja osłabła z .79 do .67 (rysunek 2). Ciekawy jest ostatni wiersz: d Cohena prawie się nie zmieniło, bo sufit zmniejszył zarówno różnicę średnich, jak i odchylenie standardowe. To nie reguła – w innych danych sufit może wielkość efektu zaniżyć albo zawyżyć, co zgadza się z obrazem obciążenia i niepewności opisanym przez Šimkovica i Träuble (2019).
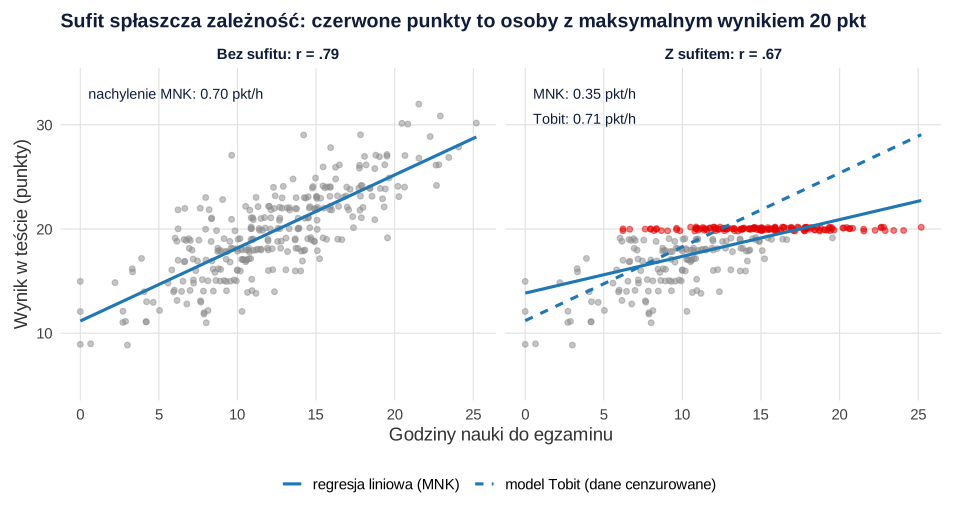
Linia przerywana na rysunku 2 to model Tobit – regresja dla danych cenzurowanych, która traktuje wynik 20 jako „co najmniej 20”. Odtworzył on nachylenie 0.71 pkt na godzinę i efekt kursu 1.92 pkt, czyli wartości bliskie prawdziwym (0.7 i 2). Podobną przewagę modelu wzrostu typu Tobit w danych podłużnych z sufitem opisali Wang i in. (2008).
Jak wykryć efekt sufitu lub podłogi?
- Policz odsetek wyników minimalnych i maksymalnych – dla wyniku całej skali i dla pojedynczych pozycji – i podaj go w pracy.
- Obejrzyj histogram: słupek „przyklejony” do granicy skali jest najlepszym sygnałem.
- Sprawdź skośność i położenie średniej – średnia blisko krańca skali i wyraźna skośność to znak ostrzegawczy.
- W testach przejrzyj łatwość pozycji: zadania, które rozwiązuje prawie każdy (albo prawie nikt), nie różnicują badanych. W modelach IRT widać to jako niską informację testu na krańcach skali (zob. teoria reagowania na pozycje testowe).
- Zrób badanie pilotażowe – to najtańszy moment, by wymienić zbyt łatwe zadania.
W praktyce często spotyka się regułę kciuka, że efekt sufitu lub podłogi jest wyraźny, gdy wynik maksymalny lub minimalny uzyskuje ponad 15% osób. To umowny próg, a nie wynik badań – zamiast samego „jest/nie ma” podaj dokładny odsetek i oceń, czy granica skali ogranicza odpowiedź na Twoje pytanie badawcze.
Co zrobić z efektem sufitu i podłogi?
| Etap | Co zrobić |
|---|---|
| Przed badaniem | Wybierz narzędzie o trudności dopasowanej do grupy (sprawdź wyniki w podobnych próbach), dodaj trudniejsze lub łatwiejsze pozycje, rozważ szerszą skalę odpowiedzi, przetestuj narzędzie w pilotażu. |
| Analiza wyników skali | Oprócz zwykłej analizy wykonaj analizę odporną na sufit: model dla danych cenzurowanych (Tobit), a przy wynikach dyskretnych – test rangowy, np. test Manna-Whitneya. W symulacjach Šimkovica i Träuble (2019) najlepiej wypadły metody na danych przekształconych (log, logit) oraz – dla danych dyskretnych – testy rangowe. |
| Pojedyncze pozycje Likerta | Rozważ regresję porządkową. Liddell i Kruschke (2018) pokazują, że analiza danych porządkowych modelami metrycznymi może dawać fałszywe alarmy, utratę mocy, a nawet odwrócenie kierunku efektu. |
| Interpretacja | Brak różnicy przy suficie nie oznacza braku efektu. Opisz efekt sufitu jako ograniczenie i podaj odsetek wyników skrajnych. |
Jak opisać efekt sufitu w pracy (APA)
Podaj odsetek wyników skrajnych, opisz kształt rozkładu i zaznacz, jak uwzględniłeś sufit w analizie. Wzór dla przykładu z tego hasła:
Przykład w R
Kod symuluje wyniki testu bez sufitu i z sufitem, porównuje statystyki opisowe, korelację i d Cohena, a następnie zestawia regresję liniową z modelem Tobit. Liczby w tekście i na rysunkach pochodzą z tego kodu.
Efekt sufitu: statystyki, korelacja i model Tobit
R
library(survival)
set.seed(2026)
n <- 300
godziny <- pmax(0, rnorm(n, mean = 12, sd = 5))   # godziny nauki do egzaminu
kurs <- rbinom(n, 1, 0.5)                          # kurs powtórkowy: 1 = tak, 0 = nie
prawdziwy <- 10 + 0.7 * godziny + 2 * kurs + rnorm(n, sd = 2.5)
bez_sufitu <- round(prawdziwy)       # wynik, gdyby test miał też trudne pytania
test <- pmin(bez_sufitu, 20)         # test 0–20 pkt: wyżej nie da się zdobyć

round(100 * mean(test == 20), 1)     # odsetek osób z wynikiem maksymalnym
d_cohena <- function(y, g) { m <- tapply(y, g, mean); s2 <- tapply(y, g, var); k <- table(g)
  unname((m[2] - m[1]) / sqrt(sum((k - 1) * s2) / (sum(k) - 2))) }
opis <- function(y) c(M = mean(y), SD = sd(y), skosnosc = psych::skew(y),
                      r_godziny = cor(godziny, y), roznica_kurs = unname(diff(tapply(y, kurs, mean))),
                      d_kurs = d_cohena(y, kurs))
round(rbind(bez_sufitu = opis(bez_sufitu), z_sufitem = opis(test)), 2)

# Regresja: prawdziwe parametry to 0.7 pkt na godzinę i 2 pkt za kurs
mnk_bez <- lm(bez_sufitu ~ godziny + kurs)
mnk_z <- lm(test ~ godziny + kurs)
tobit <- survreg(Surv(test, test < 20) ~ godziny + kurs, dist = "gaussian")  # 20 = cenzura
round(rbind(MNK_bez_sufitu = coef(mnk_bez), MNK_z_sufitem = coef(mnk_z), Tobit = coef(tobit)), 2)
round(summary(tobit)$table, 3)      # błędy standardowe i p w modelu Tobit
Wynik w R
[1] 49.7
               M   SD skosnosc r_godziny roznica_kurs d_kurs
bez_sufitu 19.74 4.27     0.08      0.79         2.21   0.54
z_sufitem  18.16 2.54    -1.47      0.67         1.28   0.52
               (Intercept) godziny kurs
MNK_bez_sufitu       10.27    0.70 1.70
MNK_z_sufitem        13.31    0.35 1.02
Tobit                10.18    0.71 1.92
             Value Std. Error      z p
(Intercept) 10.182      0.549 18.559 0
godziny      0.709      0.048 14.814 0
kurs         1.924      0.351  5.488 0
Log(scale)   0.929      0.061 15.350 0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8-6): Therneau, T. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Usuwanie osób z wynikiem maksymalnym jako „odstających”. To prawidłowe wyniki, a nie obserwacje odstające – ich usunięcie zmienia próbę i jeszcze bardziej zniekształca wyniki.
- Wniosek „brak różnicy, więc brak efektu”, gdy jedna z grup była blisko maksimum. Sufit mógł zamaskować różnicę.
- Liczenie poprawy przed i po interwencji bez sprawdzenia wyników początkowych – osoba z maksymalnym wynikiem na starcie nie może się „poprawić”.
- Raportowanie tylko M i SD bez odsetka wyników minimalnych i maksymalnych.
- Mylenie sufitu z ograniczeniem zakresu przez dobór próby – skutki są podobne (mniejsza wariancja, słabsze korelacje), ale przyczyna leży w doborze osób, a nie w narzędziu.
- Oczekiwanie, że analiza „odzyska” to, czego narzędzie nie zmierzyło. Model Tobit, transformacje i testy rangowe zmniejszają obciążenie, ale nie zastąpią narzędzia dopasowanego do badanej grupy.
Najczęstsze pytania
Co to jest efekt sufitu?
Efekt sufitu występuje wtedy, gdy duża część badanych uzyskuje maksymalny możliwy wynik narzędzia, np. 20 punktów na 20. Narzędzie nie odróżnia wtedy osób, które ledwo osiągnęły maksimum, od tych, które poradziłyby sobie z dużo trudniejszymi zadaniami – prawdziwy poziom cechy jest ucięty na granicy skali.
Czym różni się efekt sufitu od efektu podłogi?
Efekt sufitu dotyczy górnej granicy skali (wiele wyników maksymalnych, rozkład lewostronnie skośny), a efekt podłogi – dolnej (wiele wyników minimalnych, rozkład prawostronnie skośny). Podłoga pojawia się np. w skalach objawów klinicznych wypełnianych przez osoby zdrowe.
Jak sprawdzić, czy w danych jest efekt sufitu?
Policz odsetek osób z wynikiem maksymalnym i minimalnym, obejrzyj histogram i sprawdź skośność. Często stosowana reguła kciuka mówi o wyraźnym efekcie, gdy wynik skrajny ma ponad 15% osób, ale to umowny próg – w pracy podaj dokładny odsetek.
Jak efekt sufitu wpływa na korelację i porównania grup?
Zmniejsza wariancję wyników, spłaszcza nachylenie regresji i zwykle osłabia korelację. Różnice między grupami w punktach bywają zaniżone, a efekty interakcji trudniej wykryć. W przykładzie z hasła korelacja spadła z .79 do .67, a nachylenie regresji z 0.70 do 0.35 punktu na godzinę nauki.
Co zrobić, gdy w moich danych jest efekt sufitu?
Nie usuwaj osób z wynikiem maksymalnym. Podaj odsetek wyników skrajnych, wykonaj analizę odporną na sufit – np. model Tobit dla danych cenzurowanych lub test rangowy – i opisz efekt sufitu jako ograniczenie. Przy planowaniu kolejnego badania dobierz trudniejsze narzędzie i sprawdź je w pilotażu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikTeoria reagowania na pozycje testowe (IRT)
Czym jest item response theory: modele Rascha, 2PL, 3PL i GRM, informacja testu, rzetelność warunkowa oraz IRT a klasyczna teoria testów i CFA.
Czytaj →PoradnikIle stopni skali Likerta wybrać?
4, 5, 7 czy więcej punktów: co mówią badania, środek skali, etykiety, tabela decyzyjna, symulacja w R i wzór opisu do pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hedge, C., Powell, G., & Sumner, P. (2018). The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences. Behavior Research Methods, 50(3), 1166–1186. https://doi.org/10.3758/s13428-017-0935-1 ● Otwarty dostęp
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- Šimkovic, M., & Träuble, B. (2019). Robustness of statistical methods when measure is affected by ceiling and/or floor effect. PLOS ONE, 14(8), Article e0220889. https://doi.org/10.1371/journal.pone.0220889 ● Otwarty dostęp
- Terwee, C. B., Bot, S. D. M., de Boer, M. R., van der Windt, D. A. W. M., Knol, D. L., Dekker, J., Bouter, L. M., & de Vet, H. C. W. (2007). Quality criteria were proposed for measurement properties of health status questionnaires. Journal of Clinical Epidemiology, 60(1), 34–42. https://doi.org/10.1016/j.jclinepi.2006.03.012 ● Otwarty dostęp
- Wang, L., Zhang, Z., McArdle, J. J., & Salthouse, T. A. (2008). Investigating ceiling effects in longitudinal data analysis. Multivariate Behavioral Research, 43(3), 476–496. https://doi.org/10.1080/00273170802285941 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{hedge2018reliability, author={Hedge, Craig and Powell, Georgina and Sumner, Petroc}, title={{The reliability paradox: Why robust cognitive tasks do not produce reliable individual differences}}, journal={Behavior Research Methods}, year={2018}, volume={50}, number={3}, pages={1166--1186}, doi={10.3758/s13428-017-0935-1}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{simkovic2019robustness, author={Šimkovic, Matúš and Träuble, Birgit}, title={{Robustness of statistical methods when measure is affected by ceiling and/or floor effect}}, journal={PLOS ONE}, year={2019}, volume={14}, number={8}, eid={e0220889}, doi={10.1371/journal.pone.0220889}}@article{terwee2007quality, author={Terwee, Caroline B. and Bot, Sandra D. M. and de Boer, Michael R. and van der Windt, Daniëlle A. W. M. and Knol, Dirk L. and Dekker, Joost and Bouter, Lex M. and de Vet, Henrica C. W.}, title={{Quality criteria were proposed for measurement properties of health status questionnaires}}, journal={Journal of Clinical Epidemiology}, year={2007}, volume={60}, number={1}, pages={34--42}, doi={10.1016/j.jclinepi.2006.03.012}}@article{wang2008investigating, author={Wang, Lijuan and Zhang, Zhiyong and McArdle, John J. and Salthouse, Timothy A.}, title={{Investigating ceiling effects in longitudinal data analysis}}, journal={Multivariate Behavioral Research}, year={2008}, volume={43}, number={3}, pages={476--496}, doi={10.1080/00273170802285941}}