Przykład: sieć przychodni weterynaryjnych i 600 ankiet
Fikcyjna sieć sześciu przychodni weterynaryjnych (A–F) chce wiedzieć, co poprawić najpierw. Ankieta objęła 600 właścicieli zwierząt, po 100 z każdej przychodni. Każdy ocenił te same 22 stwierdzenia dwa razy na skali 1–7: przed wizytą – jak powinno być w dobrej przychodni (oczekiwanie, E), po wizycie – jak było w tej przychodni (ocena, P). Na końcu podał ogólną satysfakcję 0–10. To schemat SERVQUAL: model luk w jakości usług zaproponowali Parasuraman i in. (1985) po badaniu czterech rodzajów usług.
Pytania zarządu: gdzie usługa zawodzi, co najmocniej wiąże się z satysfakcją i która przychodnia odstaje?
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie: średnie oczekiwania 6.0–6.5 (blisko sufitu skali), średnie oceny 4.9–5.9 z najsłabszym reagowaniem, odchylenia przychodni od średniej sieci (np. B słabsza w reagowaniu, E lepsza w empatii), korelację wymiarów 0.55 i korelację oczekiwań z ocenami 0.25. Satysfakcja zależy w danych wyłącznie od ocen (najmocniej od niezawodności, potem empatii i reagowania), a oczekiwania nie wpływają na nią wcale – to ważne przy rysunku 4. Po pierwszym uruchomieniu dodaliśmy 12% klientów zaznaczających 7 przy wszystkich oczekiwaniach (wcześniej nie było żadnego, a w prawdziwych ankietach to częste). Ziarna nie zmienialiśmy. Dane pobierzesz jako servqual-przychodnie-weterynaryjne-600.csv.
Rysunek 1: pięć wymiarów i luka
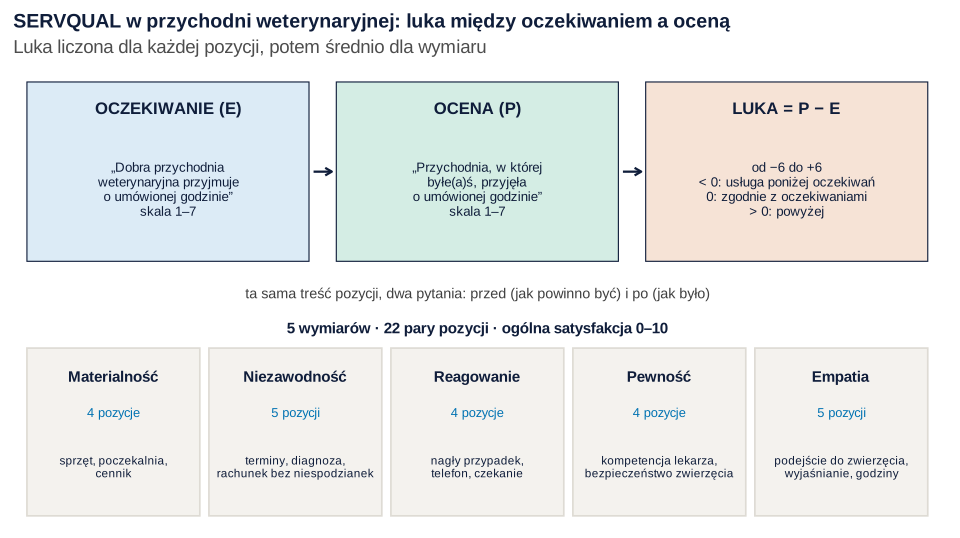
Co widać. Każda pozycja ma dwie wersje o tej samej treści. Luka = ocena − oczekiwanie: −1 znaczy, że przychodnia wypadła o punkt gorzej, niż klient oczekiwał. Wynik wymiaru to średnia luk jego pozycji. Wymiary: materialność, niezawodność (robią, co obiecali), reagowanie (szybkość, dostępność), pewność (kompetencja, zaufanie) i empatia.
Jak może zmylić. Luka to wynik różnicowy, a takie wyniki mają własne problemy: rzetelność, sufit, kolejność pytań. Pokazujemy je na rysunkach 3 i 6.
Podpis do pracy:
Rysunek 2: gdzie luka jest największa
Luka jest różnicą dwóch odpowiedzi tej samej osoby, więc jej przedział ufności liczymy jak dla testu t dla prób zależnych: z różnic, nie z dwóch osobnych średnich.
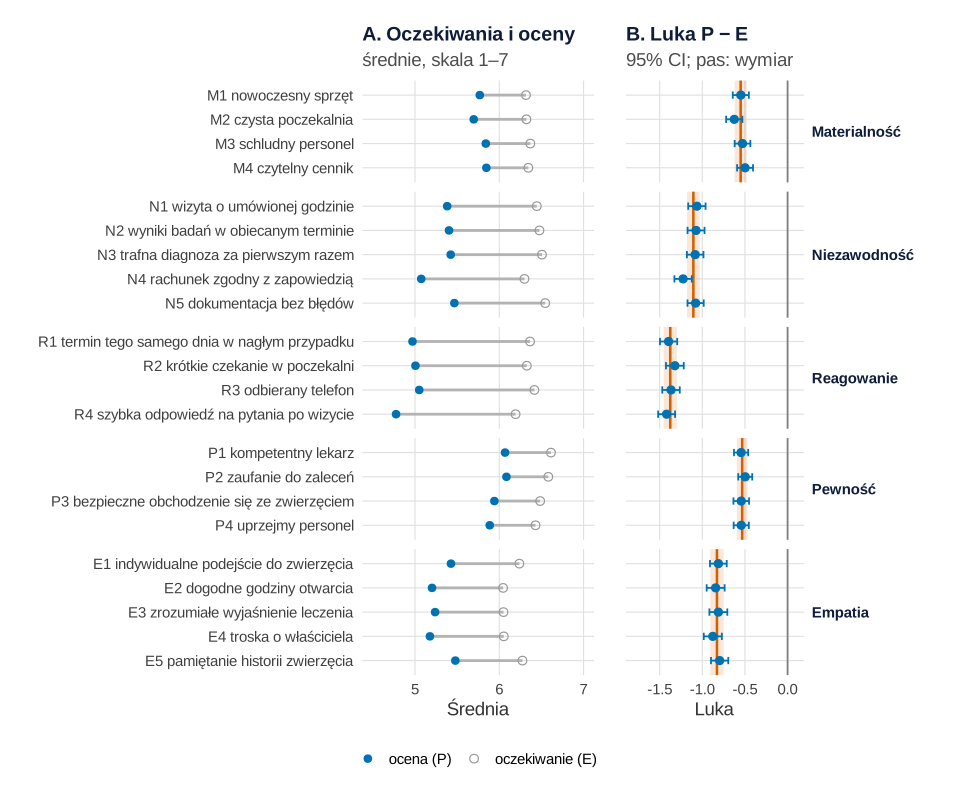
set.seed(706)).Co widać. Wszystkie luki są ujemne – przy oczekiwaniach średnio 6.35 to typowe. Najbardziej zawodzi reagowanie: −1.38 [−1.45, −1.30], dz = −1.43 (luka ujemna u 88.7% klientów). Dalej niezawodność (−1.10 [−1.18, −1.03]) i empatia (−0.83 [−0.91, −0.75]). Najmniejsze luki mają materialność (−0.55) i pewność (−0.53). Największa pojedyncza luka to „szybka odpowiedź na pytania po wizycie” (−1.42 [−1.52, −1.32]).
Jak może zmylić. Przy 600 osobach każda luka jest „istotna”; o kolejności działań decyduje wielkość luki i jej związek z satysfakcją (rysunek 4). Luka −1 może powstać z par 7 i 6 albo 4 i 3 – panel A pokazuje, skąd się wzięła.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: rzetelność ocen, oczekiwań i luk
Rzetelność wymiaru liczymy osobno dla ocen, oczekiwań i luk – alfą Cronbacha i omegą McDonalda (pakiet psych; Revelle i Condon, 2019). Dla różnicy dwóch wyników istnieje też wzór:
gdzie s to odchylenia standardowe wyników wymiaru, rel – ich rzetelności, a r – korelacja oceny z oczekiwaniem. Im wyższa korelacja, tym więcej prawdziwej wariancji odejmujemy, a błędy zostają.
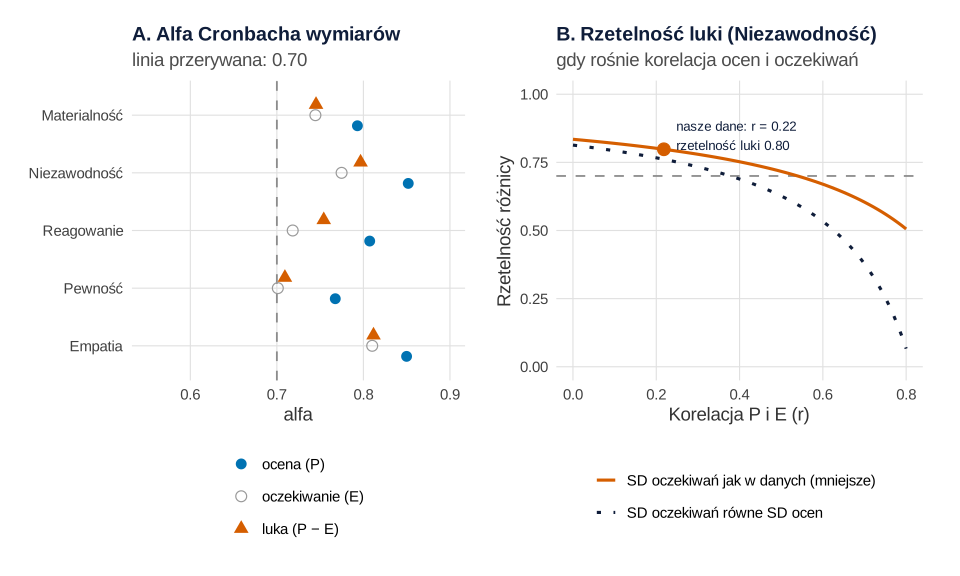
Co widać. Omega była praktycznie równa alfie (różnica najwyżej 0.01). Luki mają rzetelność niższą niż oceny: w niezawodności 0.80 wobec 0.85, w pewności 0.71 wobec 0.77. Wzór daje prawie to samo co alfa luk. Panel B: gdyby ocena i oczekiwanie korelowały na poziomie 0.5, rzetelność luki spadłaby do 0.72, a przy równych odchyleniach obu części – do 0.63.
Jak może zmylić. W naszych danych luka jest jeszcze w miarę rzetelna, bo oczekiwania mało korelują z ocenami (r = .22) i mają małe odchylenie (0.48 wobec 0.89) – dlatego luka niesie niewiele więcej niż sama ocena. Peter i in. (1993) wskazują problemy wyników różnicowych z rzetelnością, trafnością różnicową, pozornymi korelacjami i ograniczeniem wariancji; Edwards (2001) omawia mity o nich i proponuje regresję wielomianową.
Podpis do pracy:
Czy pięć wymiarów trzyma się danych? CFA krótko
Pięć wymiarów to hipoteza o strukturze, więc sprawdzamy ją konfirmacyjną analizą czynnikową w lavaan (estymator MLR) i porównujemy z modelem jednego ogólnego czynnika. Składnię krok po kroku opisuje wpis CB-SEM w R (lavaan).
| Model | χ²(df) | CFI | TLI | RMSEA [90% CI] | SRMR |
|---|---|---|---|---|---|
| Oceny, 5 czynników | 226.4 (199) | .994 | .993 | .015 [.000, .024] | .025 |
| Oceny, 1 czynnik | 1711.0 (209) | .694 | .662 | .111 [.106, .116] | .087 |
| Luki, 5 czynników | 242.2 (199) | .988 | .987 | .019 [.008, .027] | .030 |
| Luki, 1 czynnik | 1177.1 (209) | .743 | .716 | .089 [.084, .094] | .074 |
Model pięciu czynników pasuje dobrze według progów Hu i Bentlera (1999) – CFI i TLI powyżej .95, RMSEA poniżej .06, SRMR poniżej .08 – a jeden czynnik wyraźnie gorzej (skalowany test różnicy χ²: Δχ²(10) = 1657.5, p < .001). Ładunki standaryzowane wynoszą 0.65–0.75, korelacje czynników 0.44–0.60. Dane symulowaliśmy z pięcioma wymiarami; w prawdziwych ankietach struktura bywa mniej wyraźna, więc sprawdź ją przed liczeniem wyników wymiarów.
Rysunek 4: luki czy same oceny (SERVPERF)?
Który wymiar najmocniej wiąże się z satysfakcją? Dopasowujemy dwie regresje wielorakie ogólnej satysfakcji: na pięć luk (SERVQUAL) i na pięć samych ocen (SERVPERF – podejście, które zaproponowali Cronin i Taylor, 1992). Współczynniki standaryzujemy, a niepewność R² szacujemy bootstrapem (2000 prób).
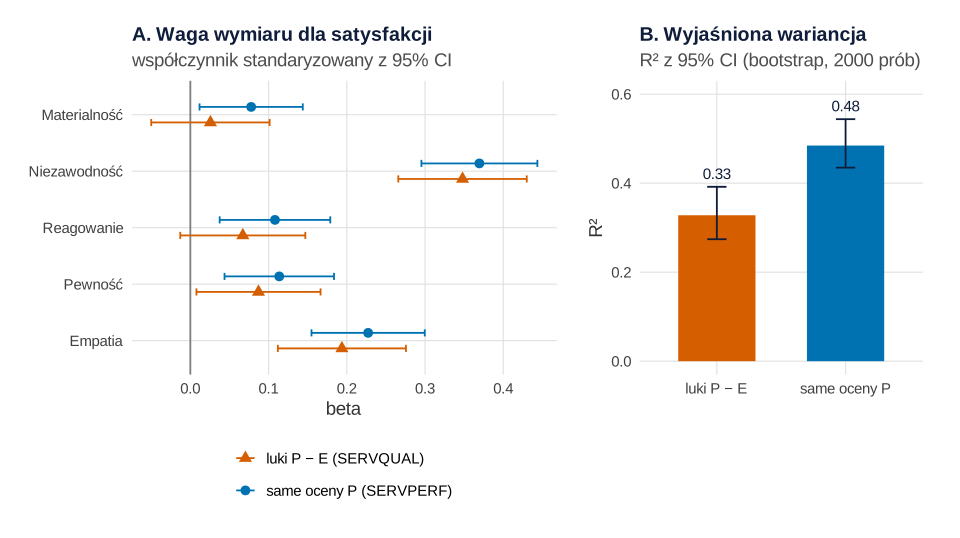
set.seed(7061)).Co widać. Kolejność wymiarów jest podobna: najważniejsza jest niezawodność (beta = 0.35 dla luki, 0.37 dla oceny), potem empatia (0.19 i 0.23). Ale same oceny wyjaśniają więcej: R² = .485 wobec .328 dla luk, różnica 0.157 [0.116, 0.200]. Dodanie oczekiwań do ocen nic nie wnosi (F(5, 589) = 0.50, p = .780), a ograniczenie „ocena i oczekiwanie mają równe i przeciwne wagi”, które wprowadza luka, wyraźnie pogarsza model (F(5, 589) = 36.44, p < .001).
Jak może zmylić. Tu przewaga SERVPERF jest wbudowana w dane – satysfakcja zależy tylko od ocen. To nie dowód, że tak jest zawsze: w metaanalizie Carrillata i in. (2007) obie skale przewidywały ogólną jakość usług równie dobrze, a SERVQUAL zalecano do diagnozy, SERVPERF – gdy liczy się krótsza ankieta. Wymiary są skorelowane, więc ranking traktuj ostrożnie (współliniowość); wagi względne opisuje wpis o analizie kluczowych czynników satysfakcji.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: która przychodnia odstaje?
Klienci są zagnieżdżeni w przychodniach: Model wielopoziomowy z losowym efektem przychodni mówi, jaka część zróżnicowania luk leży między przychodniami (ICC). Interesuje nas tych sześć przychodni, więc porównujemy je ANOVA z korektą Tukeya, a dla pięciu wymiarów – z poprawką Holma.
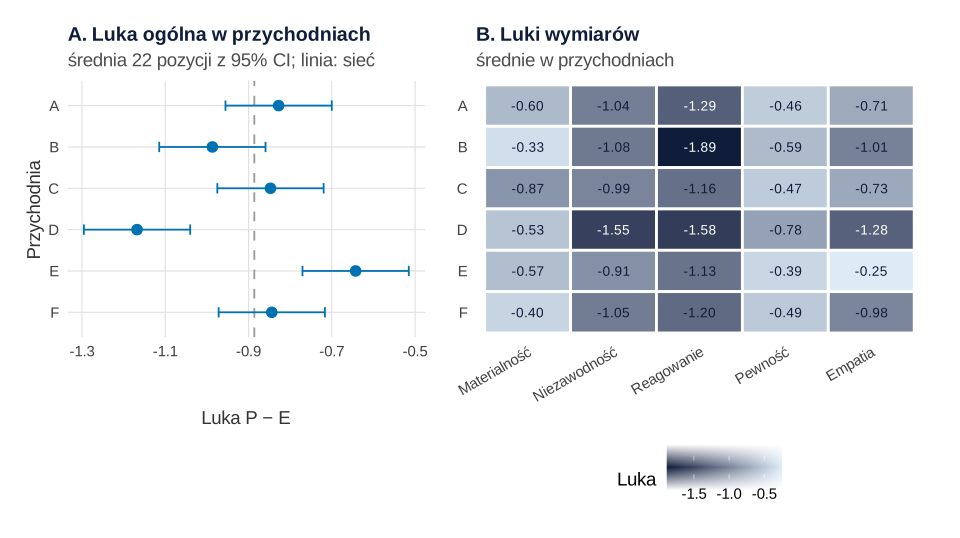
Co widać. Przychodnie różnią się luką ogólną, F(5, 594) = 7.36, p < .001, choć tylko 6% zróżnicowania leży między nimi (ICC = .06) – reszta to różnice między klientami. Przychodnia D (−1.17 [−1.30, −1.04]) jest po korekcie Tukeya gorsza od A, C, E i F, a E (−0.64 [−0.77, −0.52]) lepsza od B i D. Mapa wskazuje źródła: w D zawodzą niezawodność (−1.55) i reagowanie (−1.58), w B – samo reagowanie (−1.89). Różnice przychodni są istotne we wszystkich wymiarach także po poprawce Holma (największe pHolm = .010 dla pewności).
Jak może zmylić. Luka ogólna B (−0.99) wygląda przeciętnie, a kryje najgorsze reagowanie w sieci – średnia z 22 pozycji maskuje konkretny problem. Przychodnie mogą też mieć innych klientów (np. więcej nagłych przypadków); porównanie nie mówi, dlaczego D wypada gorzej.
Podpis do pracy:
Rysunek 6: sufit oczekiwań i oczekiwania pytane po wizycie
Panel B to symulacja: te same osoby podają oczekiwania dopiero po wizycie, a 40% różnicy między doświadczeniem a oczekiwaniem „przecieka” do pamiętanego oczekiwania (wartość ustawiona ręcznie).
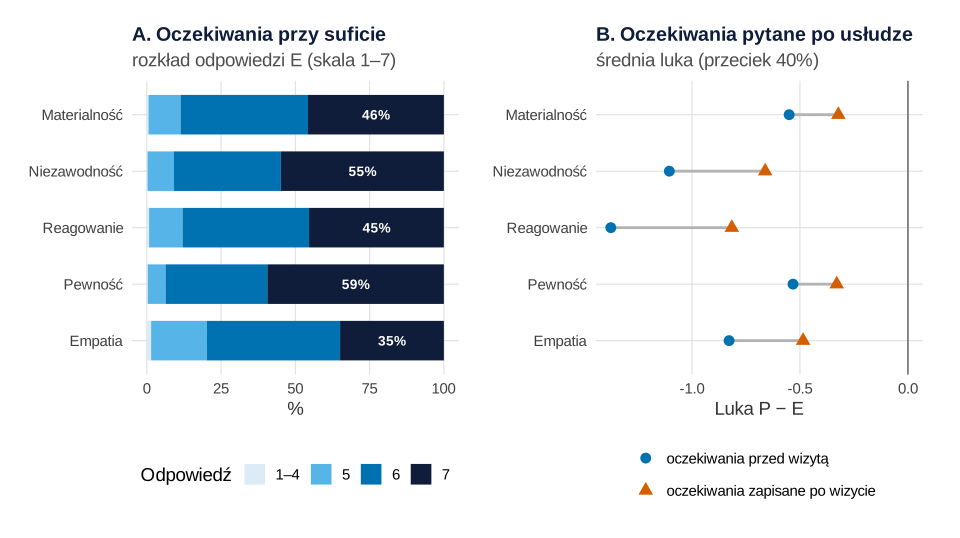
set.seed(7062)).Co widać. Prawie połowa odpowiedzi o oczekiwania to 7 (47.8%), w pewności 59.4%. To efekt sufitu: przy oczekiwaniu 7 luka nie może być dodatnia, więc „lepiej, niż oczekiwałem” jest niewidoczne – wśród par z oczekiwaniem poniżej 7 dodatnie luki stanowiły 23.8%. 72 klientów (12%) zaznaczyło 7 przy wszystkich 22 pozycjach; ich luka ogólna to −1.44 wobec −0.81 u pozostałych, choć ich oceny nie są gorsze. W panelu B pytanie po wizycie zmniejsza luki (reagowanie: −0.82 zamiast −1.38), korelacja ocen z oczekiwaniami rośnie z ok. 0.2 do 0.69–0.78, a alfa luk spada (pewność: z 0.71 do 0.63).
Jak może zmylić. Przy suficie luka zależy bardziej od stylu odpowiadania niż od jakości usługi: klient „wszystko 7” dostaje dużą lukę za te same oceny. Oczekiwania podane po wizycie są skażone doświadczeniem.
Podpis do pracy:
Co z tym zrobić w firmie
- Zacznij od niezawodności. Ma dużą lukę (−1.10) i najsilniej wiąże się z satysfakcją (rysunek 4). Rachunek zgodny z zapowiedzią i wyniki badań w obiecanym terminie warto zapisać jako standard i sprawdzać co miesiąc.
- Reagowanie popraw tanimi środkami. To największa luka w sieci (−1.38), ale w regresji jego waga jest mała (beta = 0.07 dla luki, 0.11 dla oceny), bo pokrywa się z innymi wymiarami. Dodatkowa osoba na recepcji w godzinach szczytu i oddzwanianie w ciągu godziny kosztują niewiele.
- Przychodnię D obejrzyj w całości, B – tylko w reagowaniu. D jest najgorsza w trzech wymiarach, B ma jeden konkretny problem (rysunek 5). Po zmianach powtórz ankietę i porównaj luki tej samej przychodni.
- Do bieżącego monitoringu wystarczą oceny. Krótsza ankieta (22 pytania zamiast 44) przewidywała satysfakcję lepiej. Oczekiwania mierz rzadziej, np. raz w roku, przed wizytą i na innym poziomie skali niż „wszystko 7” – np. prosząc o rangi ważności. Jak wskaźnik zadowolenia przekłada się na odejścia klientów, opisuje wpis CSAT, CES czy NPS.
- Nie ścigaj się z sufitem. Luka −0.5 przy oczekiwaniu 7 to bardzo dobra usługa – cel „luka zero” jest nierealny.
Jak opisać w pracy
Opisz kwestionariusz i jego adaptację, moment pomiaru oczekiwań, liczenie luk, rzetelność trzech części, CFA i porównanie z SERVPERF. Podobną analizę ankiety w ochronie zdrowia pokazuje wpis o analizie ankiety satysfakcji pacjentów, a szerszy kontekst – statystyka w pracy z zarządzania i ekonomii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu, tabelę CFA i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, listę pozycji i dane, przepis 2 – wyniki pozycji i wymiarów używane dalej. Przepisy z rysunkiem kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 706 w przepisie 1, 7061 w przepisie 5 (bootstrap), 7062 w przepisie 7; pozostałe przepisy nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): 6 przychodni po 100 klientów, średnie oczekiwań (6.0–6.5) i ocen (4.9–5.9) wymiarów, odchylenia przychodni od średniej sieci, korelację wymiarów 0.55, korelację oczekiwań z ocenami 0.25, wagi wymiarów dla satysfakcji (0.15, 0.90, 0.45, 0.30, 0.55 – satysfakcja zależy tylko od ocen) i 12% klientów „wszystko 7”; w przepisie 5: 2000 prób bootstrapowych; w przepisie 7: przeciek 40% doświadczenia do oczekiwań podanych po wizycie. Po pierwszym uruchomieniu zmieniono jeden parametr danych: dodano 12% klientów zaznaczających 7 przy wszystkich oczekiwaniach (w pierwszej wersji nie było żadnego, a taki styl odpowiedzi jest typowy); losowanie tych osób dopisano na końcu przepisu 1, więc pozostałe odpowiedzi się nie zmieniły. Poza tym poprawiono tylko kod rysunków (kolejność kolorów w legendzie, podziałkę osi, krótsze podtytuły). Wszystkie przepisy liczą się w kilka sekund.
1. Dane ankiety i schemat: Rysunek 1
R
# Rysunek 1. Fikcyjna sieć przychodni weterynaryjnych: ankieta SERVQUAL (600 klientów, 22 pary pozycji)
library(ggplot2)
library(MASS)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Pięć wymiarów SERVQUAL i 22 pozycje (te same treści w części „oczekiwania” i „ocena”)
wymiary <- c("Materialność", "Niezawodność", "Reagowanie", "Pewność", "Empatia")
pozycje <- data.frame(
  kod = c(paste0("M", 1:4), paste0("N", 1:5), paste0("R", 1:4), paste0("P", 1:4), paste0("E", 1:5)),
  wymiar = rep(wymiary, c(4, 5, 4, 4, 5)),
  tresc = c("nowoczesny sprzęt", "czysta poczekalnia", "schludny personel", "czytelny cennik",
            "wizyta o umówionej godzinie", "wyniki badań w obiecanym terminie", "trafna diagnoza za pierwszym razem",
            "rachunek zgodny z zapowiedzią", "dokumentacja bez błędów",
            "termin tego samego dnia w nagłym przypadku", "krótkie czekanie w poczekalni", "odbierany telefon",
            "szybka odpowiedź na pytania po wizycie",
            "kompetentny lekarz", "zaufanie do zaleceń", "bezpieczne obchodzenie się ze zwierzęciem", "uprzejmy personel",
            "indywidualne podejście do zwierzęcia", "dogodne godziny otwarcia", "zrozumiałe wyjaśnienie leczenia",
            "troska o właściciela", "pamiętanie historii zwierzęcia"))

# Parametry ustawione ręcznie (prawda ukryta w danych):
n_przych <- 6; n_na_przych <- 100                       # 6 przychodni po 100 ankiet
srednia_E <- c(6.3, 6.5, 6.2, 6.4, 6.0)                 # oczekiwania wysokie – blisko sufitu skali 1–7
srednia_P <- c(5.8, 5.4, 4.9, 5.9, 5.3)                 # oceny: najsłabiej reagowanie
# odchylenia przychodni od średniej sieci w ocenach (wiersze: przychodnie A–F, kolumny: wymiary)
efekt_przych <- rbind(c( 0.0,  0.1,  0.1,  0.0,  0.1), c( 0.2,  0.0, -0.6, -0.1, -0.2),
                      c(-0.3,  0.1,  0.3,  0.1,  0.2), c( 0.1, -0.4, -0.2, -0.2, -0.3),
                      c( 0.0,  0.2,  0.2,  0.2,  0.5), c( 0.0,  0.0,  0.2,  0.0, -0.3))
waga_satysf <- c(0.15, 0.90, 0.45, 0.30, 0.55)          # wpływ ocen (wymiarów) na ogólną satysfakcję 0–10
kor_wymiarow <- 0.55                                    # korelacja wymiarów (latentnych) między sobą
kor_E_P <- 0.25                                         # korelacja oczekiwań z ocenami tego samego wymiaru
odsetek_wszystko7 <- 0.12                               # klienci zaznaczający 7 przy wszystkich oczekiwaniach

set.seed(706)
n <- n_przych * n_na_przych
przychodnia <- rep(LETTERS[1:n_przych], each = n_na_przych)
blok <- function(przekatna, poza) { m <- matrix(poza, 5, 5); diag(m) <- przekatna; m }
S <- rbind(cbind(blok(1, kor_wymiarow), blok(kor_E_P, 0.15)),   # macierz korelacji: 5 wymiarów ocen
           cbind(blok(kor_E_P, 0.15), blok(1, kor_wymiarow)))   # i 5 wymiarów oczekiwań
lat <- mvrnorm(n, rep(0, 10), S)                         # latentne: kolumny 1–5 oceny, 6–10 oczekiwania
lat_P <- lat[, 1:5] + efekt_przych[match(przychodnia, LETTERS), ] / 0.8
skala17 <- function(x) pmin(7, pmax(1, round(x)))
dane <- data.frame(id = 1:n, przychodnia = przychodnia)
for (j in seq_len(nrow(pozycje))) {
  d <- match(pozycje$wymiar[j], wymiary)
  przes <- rnorm(1, 0, 0.15)                             # pozycje różnią się nieco średnią
  dane[[paste0("E_", pozycje$kod[j])]] <- skala17(srednia_E[d] + przes + 0.45 * lat[, 5 + d] + rnorm(n, 0, 0.55))
  dane[[paste0("P_", pozycje$kod[j])]] <- skala17(srednia_P[d] + przes + 0.80 * lat_P[, d] + rnorm(n, 0, 0.75))
}
dane$satysfakcja <- pmin(10, pmax(0, round(6.6 + as.vector(lat_P %*% waga_satysf) / 2 + rnorm(n, 0, 1.0))))
wszystko7_id <- sample(n, round(odsetek_wszystko7 * n))  # styl odpowiedzi „wszystko 7” (dodany po 1. uruchomieniu)
dane[wszystko7_id, paste0("E_", pozycje$kod)] <- 7
write.csv(dane, "servqual-przychodnie-weterynaryjne-600.csv", row.names = FALSE)

E <- dane[paste0("E_", pozycje$kod)]; P <- dane[paste0("P_", pozycje$kod)]
cat("Klientów:", nrow(dane), "| przychodni:", n_przych, "| pozycji:", ncol(E), "\n")
cat("Średnia oczekiwań:", round(mean(as.matrix(E)), 2), "| średnia ocen:", round(mean(as.matrix(P)), 2),
    "| odpowiedzi „7” w oczekiwaniach:", round(100 * mean(as.matrix(E) == 7), 1), "%",
    "| w ocenach:", round(100 * mean(as.matrix(P) == 7), 1), "%\n")
cat("Ogólna satysfakcja 0–10: średnia", round(mean(dane$satysfakcja), 2), "SD", round(sd(dane$satysfakcja), 2), "\n")
print(table(pozycje$wymiar)[wymiary])

# Schemat: luka = ocena − oczekiwanie i pięć wymiarów
pud <- data.frame(x = c(1.6, 5, 8.4), y = 3.3,
  naglowek = c("OCZEKIWANIE (E)", "OCENA (P)", "LUKA = P − E"),
  tekst = c("„Dobra przychodnia\nweterynaryjna przyjmuje\no umówionej godzinie”\nskala 1–7",
            "„Przychodnia, w której\nbyłe(a)ś, przyjęła\no umówionej godzinie”\nskala 1–7",
            "od −6 do +6\n< 0: usługa poniżej oczekiwań\n0: zgodnie z oczekiwaniami\n> 0: powyżej"),
  tlo = c("#dcebf6", "#d4ede4", "#f6e3d6"))
karty <- data.frame(x = seq(1, 9, length.out = 5), y = 1.05, wymiar = wymiary,
  liczba = paste(c(4, 5, 4, 4, 5), c("pozycje", "pozycji", "pozycje", "pozycje", "pozycji")),
  przyklad = c("sprzęt, poczekalnia,\ncennik", "terminy, diagnoza,\nrachunek bez niespodzianek",
               "nagły przypadek,\ntelefon, czekanie", "kompetencja lekarza,\nbezpieczeństwo zwierzęcia",
               "podejście do zwierzęcia,\nwyjaśnianie, godziny"))
p1 <- ggplot() +
  geom_tile(data = pud, aes(x, y), width = 3.1, height = 1.55, fill = pud$tlo, colour = "#0f1d3a", linewidth = 0.4) +
  geom_text(data = pud, aes(x, y + 0.55, label = naglowek), fontface = "bold", size = 4.4, colour = "#0f1d3a") +
  geom_text(data = pud, aes(x, y - 0.15, label = tekst), size = 3.5, lineheight = 0.92, colour = "#0f1d3a") +
  annotate("segment", x = c(3.2, 6.6), xend = c(3.4, 6.8), y = 3.3, yend = 3.3, linewidth = 0.8,
           arrow = arrow(length = unit(0.2, "cm")), colour = "#0f1d3a") +
  annotate("text", x = 5, y = 2.25, size = 3.8, colour = "grey25",
           label = "ta sama treść pozycji, dwa pytania: przed (jak powinno być) i po (jak było)") +
  geom_tile(data = karty, aes(x, y), width = 1.9, height = 1.45, fill = "#f4f2ee", colour = "#dedbd4", linewidth = 0.6) +
  geom_text(data = karty, aes(x, y + 0.48, label = wymiar), fontface = "bold", size = 4, colour = "#0f1d3a") +
  geom_text(data = karty, aes(x, y + 0.17, label = liczba), size = 3.4, colour = kol[["niebieski"]]) +
  geom_text(data = karty, aes(x, y - 0.3, label = przyklad), size = 3.1, lineheight = 0.9, colour = "#0f1d3a") +
  annotate("text", x = 5, y = 1.95, label = "5 wymiarów · 22 pary pozycji · ogólna satysfakcja 0–10",
           fontface = "bold", size = 4, colour = "#0f1d3a") +
  coord_cartesian(xlim = c(-0.1, 10.1), ylim = c(0.25, 4.2), expand = FALSE) +
  labs(title = "SERVQUAL w przychodni weterynaryjnej: luka między oczekiwaniem a oceną",
       subtitle = "Luka liczona dla każdej pozycji, potem średnio dla wymiaru", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank())
p1                       # do pliku: ggsave("servqual-schemat-luki.svg", p1, width = 10, height = 5.6)
Wynik w R
Klientów: 600 | przychodni: 6 | pozycji: 22
Średnia oczekiwań: 6.35 | średnia ocen: 5.46 | odpowiedzi „7” w oczekiwaniach: 47.8 % | w ocenach: 21 %
Ogólna satysfakcja 0–10: średnia 6.66 SD 1.45

Materialność Niezawodność   Reagowanie      Pewność      Empatia
           4            5            4            4            5
2. Luki pozycji i wymiarów: Rysunek 2
R
# Rysunek 2. Luki P − E dla 22 pozycji i 5 wymiarów z 95% przedziałami (różnice sparowane)
# (korzysta z kol, motyw, pozycje, wymiary i dane z przepisu 1)
library(ggplot2)
library(patchwork)

E <- dane[paste0("E_", pozycje$kod)]
P <- dane[paste0("P_", pozycje$kod)]
L <- P - E                                               # luka dla każdej pozycji i klienta
names(L) <- pozycje$kod
# Wynik wymiaru = średnia jego pozycji (osobno oczekiwania, oceny i luki)
wynik_wym <- function(X) sapply(wymiary, function(w) rowMeans(X[, pozycje$wymiar == w]))
E_w <- wynik_wym(E); P_w <- wynik_wym(P); L_w <- wynik_wym(L)

# Sparowany test t dla każdej pozycji: średnia luka i jej 95% CI
luka_ci <- function(x) { t <- t.test(x); c(luka = mean(x), dolna = t$conf.int[1], gorna = t$conf.int[2]) }
poz <- cbind(pozycje, E = colMeans(E), P = colMeans(P), t(sapply(L, luka_ci)))
wym <- data.frame(wymiar = wymiary, E = colMeans(E_w), P = colMeans(P_w), t(apply(L_w, 2, luka_ci)))
tw <- apply(L_w, 2, function(x) t.test(x)$statistic)
wym$t <- tw; wym$d_z <- colMeans(L_w) / apply(L_w, 2, sd)   # d dla różnic sparowanych
print(data.frame(wym[1], round(wym[-1], 2)), row.names = FALSE)
cat("Pozycje z największą luką:\n")
print(head(poz[order(poz$luka), c("kod", "tresc", "E", "P", "luka", "dolna", "gorna")], 4), digits = 3, row.names = FALSE)
cat("Pozycje z najmniejszą luką:\n")
print(tail(poz[order(poz$luka), c("kod", "tresc", "E", "P", "luka", "dolna", "gorna")], 2), digits = 3, row.names = FALSE)
cat("Odsetek klientów z luką < 0 w wymiarze Reagowanie:", round(100 * mean(L_w[, "Reagowanie"] < 0), 1), "%\n")

poz$etykieta <- paste0(poz$kod, " ", poz$tresc)
poz$etykieta <- factor(poz$etykieta, levels = rev(poz$etykieta))
poz$wymiar <- factor(poz$wymiar, levels = wymiary)
wym$wymiar <- factor(wym$wymiar, levels = wymiary)
dl <- rbind(data.frame(etykieta = poz$etykieta, wymiar = poz$wymiar, wartosc = poz$E, co = "oczekiwanie (E)"),
            data.frame(etykieta = poz$etykieta, wymiar = poz$wymiar, wartosc = poz$P, co = "ocena (P)"))
pA <- ggplot(poz, aes(y = etykieta)) +
  geom_segment(aes(x = P, xend = E, yend = etykieta), colour = "grey70", linewidth = 1) +
  geom_point(data = dl, aes(x = wartosc, colour = co, shape = co), size = 2.6) +
  scale_colour_manual(values = c("oczekiwanie (E)" = kol[["szary"]], "ocena (P)" = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c("oczekiwanie (E)" = 1, "ocena (P)" = 16), name = NULL) +
  facet_grid(wymiar ~ ., scales = "free_y", space = "free_y") +
  scale_x_continuous(limits = c(4.5, 7), breaks = 5:7) +
  labs(title = "A. Oczekiwania i oceny", subtitle = "średnie, skala 1–7", x = "Średnia", y = NULL) +
  motyw + theme(strip.text.y = element_blank())
pB <- ggplot(poz, aes(y = etykieta)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_rect(data = wym, aes(xmin = dolna, xmax = gorna, ymin = -Inf, ymax = Inf), inherit.aes = FALSE,
            fill = kol[["pomaranczowy"]], alpha = 0.15) +
  geom_vline(data = wym, aes(xintercept = luka), colour = kol[["pomaranczowy"]], linewidth = 0.9) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.3, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(aes(x = luka), size = 2.4, colour = kol[["niebieski"]]) +
  facet_grid(wymiar ~ ., scales = "free_y", space = "free_y") +
  scale_x_continuous(limits = c(-1.8, 0.1), breaks = c(-1.5, -1, -0.5, 0)) +
  labs(title = "B. Luka P − E", subtitle = "95% CI; pas: wymiar", x = "Luka", y = NULL) +
  motyw + theme(axis.text.y = element_blank(), strip.text.y = element_text(angle = 0, hjust = 0))
p2 <- pA + pB + plot_layout(widths = c(1.3, 1))
p2                       # do pliku: ggsave("servqual-luki-pozycje-wymiary.svg", p2, width = 10, height = 8.4)
Wynik w R
       wymiar    E    P  luka dolna gorna      t   d_z
 Materialność 6.34 5.79 -0.55 -0.62 -0.48 -15.31 -0.63
 Niezawodność 6.45 5.35 -1.10 -1.18 -1.03 -29.48 -1.20
   Reagowanie 6.33 4.95 -1.38 -1.45 -1.30 -34.98 -1.43
      Pewność 6.53 6.00 -0.53 -0.60 -0.47 -16.55 -0.68
      Empatia 6.13 5.30 -0.83 -0.91 -0.75 -20.87 -0.85
Pozycje z największą luką:
 kod                                      tresc    E    P  luka dolna gorna
  R4     szybka odpowiedź na pytania po wizycie 6.19 4.78 -1.42 -1.52 -1.32
  R1 termin tego samego dnia w nagłym przypadku 6.37 4.97 -1.39 -1.50 -1.29
  R3                          odbierany telefon 6.42 5.05 -1.37 -1.47 -1.26
  R2              krótkie czekanie w poczekalni 6.33 5.00 -1.32 -1.43 -1.22
Pozycje z najmniejszą luką:
 kod               tresc    E    P   luka  dolna  gorna
  M4     czytelny cennik 6.34 5.85 -0.498 -0.592 -0.405
  P2 zaufanie do zaleceń 6.58 6.08 -0.497 -0.579 -0.415
Odsetek klientów z luką < 0 w wymiarze Reagowanie: 88.7 %
3. Rzetelność: alfa, omega i wzór na różnicę – Rysunek 3
R
# Rysunek 3. Rzetelność wymiarów: alfa i omega dla ocen, oczekiwań i luk; wzór na rzetelność różnicy
# (korzysta z kol, motyw, pozycje, wymiary z przepisu 1 oraz E, P, L, E_w, P_w, L_w z przepisu 2)
library(ggplot2)
library(patchwork)
library(psych)

rzet <- function(X) c(alfa = psych::alpha(X, warnings = FALSE)$total$raw_alpha,
                      omega = suppressWarnings(psych::omega(X, nfactors = 1, plot = FALSE))$omega.tot)
tab <- do.call(rbind, lapply(wymiary, function(w) {
  k <- pozycje$wymiar == w
  data.frame(wymiar = w, czesc = c("ocena (P)", "oczekiwanie (E)", "luka (P − E)"),
             rbind(rzet(P[, k]), rzet(E[, k]), rzet(L[, k])))
}))
print(data.frame(tab[1:2], round(tab[3:4], 2)), row.names = FALSE)

# Rzetelność różnicy dwóch wyników (P i E wymiaru) z ich rzetelności, odchyleń i korelacji:
#   rel_D = (s_P² rel_P + s_E² rel_E − 2 r s_P s_E) / (s_P² + s_E² − 2 r s_P s_E)
rel_roznicy <- function(rel_P, rel_E, s_P, s_E, r) (s_P^2 * rel_P + s_E^2 * rel_E - 2 * r * s_P * s_E) /
  (s_P^2 + s_E^2 - 2 * r * s_P * s_E)
wz <- data.frame(wymiar = wymiary, s_P = apply(P_w, 2, sd), s_E = apply(E_w, 2, sd),
                 r_PE = sapply(wymiary, function(w) cor(P_w[, w], E_w[, w])),
                 alfa_P = tab$alfa[tab$czesc == "ocena (P)"], alfa_E = tab$alfa[tab$czesc == "oczekiwanie (E)"])
wz$rel_D_wzor <- with(wz, rel_roznicy(alfa_P, alfa_E, s_P, s_E, r_PE))
wz$alfa_luki <- tab$alfa[tab$czesc == "luka (P − E)"]
print(data.frame(wz[1], round(wz[-1], 2)), row.names = FALSE)
w0 <- wz[wz$wymiar == "Niezawodność", ]
cat("Niezawodność – rzetelność luki, gdyby korelacja P i E wynosiła 0.3 / 0.5 / 0.6:",
    round(rel_roznicy(w0$alfa_P, w0$alfa_E, w0$s_P, w0$s_E, c(0.3, 0.5, 0.6)), 2), "\n")
cat("… i gdyby oczekiwania miały takie samo SD jak oceny (korelacja 0.5):",
    round(rel_roznicy(w0$alfa_P, w0$alfa_E, w0$s_P, w0$s_P, 0.5), 2), "\n")

tab$wymiar <- factor(tab$wymiar, levels = rev(wymiary))
tab$czesc <- factor(tab$czesc, levels = c("ocena (P)", "oczekiwanie (E)", "luka (P − E)"))
pA <- ggplot(tab, aes(alfa, wymiar, colour = czesc, shape = czesc)) +
  geom_vline(xintercept = 0.7, linetype = "dashed", colour = "grey55") +
  geom_point(size = 3.4, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["szary"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(16, 1, 17), name = NULL) +
  scale_x_continuous(limits = c(0.55, 0.9)) +
  labs(title = "A. Alfa Cronbacha wymiarów", subtitle = "linia przerywana: 0.70", x = "alfa", y = NULL) +
  motyw + guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1))
krzywa <- data.frame(r = seq(0, 0.8, by = 0.01))
krzywa$jak_w_danych <- rel_roznicy(w0$alfa_P, w0$alfa_E, w0$s_P, w0$s_E, krzywa$r)
krzywa$rowne_SD <- rel_roznicy(w0$alfa_P, w0$alfa_E, w0$s_P, w0$s_P, krzywa$r)
dk <- rbind(data.frame(r = krzywa$r, rel = krzywa$jak_w_danych, co = "SD oczekiwań jak w danych (mniejsze)"),
            data.frame(r = krzywa$r, rel = krzywa$rowne_SD, co = "SD oczekiwań równe SD ocen"))
pB <- ggplot(dk, aes(r, rel, colour = co, linetype = co)) +
  geom_hline(yintercept = 0.7, linetype = "dashed", colour = "grey55") +
  geom_line(linewidth = 1.1) +
  annotate("point", x = w0$r_PE, y = w0$rel_D_wzor, size = 4, colour = kol[["pomaranczowy"]]) +
  annotate("text", x = w0$r_PE + 0.03, y = w0$rel_D_wzor + 0.05, hjust = 0, size = 3.5, colour = "#0f1d3a",
           label = sprintf("nasze dane: r = %.2f\nrzetelność luki %.2f", w0$r_PE, w0$rel_D_wzor)) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["granat"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dotted"), name = NULL) +
  coord_cartesian(ylim = c(0, 1)) +
  labs(title = "B. Rzetelność luki (Niezawodność)", subtitle = "gdy rośnie korelacja ocen i oczekiwań",
       x = "Korelacja P i E (r)", y = "Rzetelność różnicy") +
  motyw + guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1))
p3 <- pA + pB + plot_layout(widths = c(1, 1.1))
p3                       # do pliku: ggsave("servqual-rzetelnosc-luk.svg", p3, width = 10, height = 6)
Wynik w R
       wymiar           czesc alfa omega
 Materialność       ocena (P) 0.79  0.79
 Materialność oczekiwanie (E) 0.74  0.75
 Materialność    luka (P − E) 0.75  0.75
 Niezawodność       ocena (P) 0.85  0.85
 Niezawodność oczekiwanie (E) 0.77  0.78
 Niezawodność    luka (P − E) 0.80  0.80
   Reagowanie       ocena (P) 0.81  0.81
   Reagowanie oczekiwanie (E) 0.72  0.72
   Reagowanie    luka (P − E) 0.75  0.75
      Pewność       ocena (P) 0.77  0.77
      Pewność oczekiwanie (E) 0.70  0.70
      Pewność    luka (P − E) 0.71  0.71
      Empatia       ocena (P) 0.85  0.85
      Empatia oczekiwanie (E) 0.81  0.81
      Empatia    luka (P − E) 0.81  0.81
       wymiar  s_P  s_E r_PE alfa_P alfa_E rel_D_wzor alfa_luki
 Materialność 0.80 0.52 0.16   0.79   0.74       0.74      0.75
 Niezawodność 0.89 0.48 0.22   0.85   0.77       0.80      0.80
   Reagowanie 0.90 0.51 0.16   0.81   0.72       0.75      0.75
      Pewność 0.73 0.45 0.17   0.77   0.70       0.70      0.71
      Empatia 0.89 0.57 0.16   0.85   0.81       0.81      0.81
Niezawodność – rzetelność luki, gdyby korelacja P i E wynosiła 0.3 / 0.5 / 0.6: 0.78 0.72 0.67
… i gdyby oczekiwania miały takie samo SD jak oceny (korelacja 0.5): 0.63
4. Struktura pięciu wymiarów: CFA w lavaan (bez rysunku)
R
# Struktura pięciu wymiarów: CFA w lavaan dla ocen (P) i dla luk (P − E), porównanie z jednym czynnikiem
# (korzysta z pozycje, wymiary z przepisu 1 oraz P, L z przepisu 2; bez losowania)
library(lavaan)

skladnia <- function(prefiks) {
  w5 <- paste(sapply(wymiary, function(w) paste0(substr(w, 1, 3), " =~ ",
               paste0(prefiks, pozycje$kod[pozycje$wymiar == w], collapse = " + "))), collapse = "\n")
  w1 <- paste0("ogolny =~ ", paste0(prefiks, pozycje$kod, collapse = " + "))
  list(piec = w5, jeden = w1)
}
dP <- setNames(P, paste0("P_", pozycje$kod))
dL <- setNames(L, paste0("L_", pozycje$kod))
miary <- c("chisq.scaled", "df.scaled", "cfi.robust", "tli.robust", "rmsea.robust", "rmsea.ci.lower.robust",
           "rmsea.ci.upper.robust", "srmr")
modele <- list()
for (co in c("P", "L")) {
  s <- skladnia(paste0(co, "_"))
  d <- if (co == "P") dP else dL
  modele[[paste(co, "5 czynników")]] <- cfa(s$piec, data = d, estimator = "MLR")
  modele[[paste(co, "1 czynnik")]] <- cfa(s$jeden, data = d, estimator = "MLR")
}
print(round(t(sapply(modele, fitMeasures, fit.measures = miary)), 3))
lad <- standardizedSolution(modele[["P 5 czynników"]])
cat("Oceny, 5 czynników – ładunki standaryzowane od", round(min(lad$est.std[lad$op == "=~"]), 2), "do",
    round(max(lad$est.std[lad$op == "=~"]), 2), "| korelacje czynników od",
    round(min(lad$est.std[lad$op == "~~" & lad$lhs != lad$rhs]), 2), "do",
    round(max(lad$est.std[lad$op == "~~" & lad$lhs != lad$rhs]), 2), "\n")
print(lavTestLRT(modele[["P 1 czynnik"]], modele[["P 5 czynników"]]))
Wynik w R
              chisq.scaled df.scaled cfi.robust tli.robust rmsea.robust
P 5 czynników      226.415       199      0.994      0.993        0.015
P 1 czynnik       1711.001       209      0.694      0.662        0.111
L 5 czynników      242.152       199      0.988      0.987        0.019
L 1 czynnik       1177.133       209      0.743      0.716        0.089
              rmsea.ci.lower.robust rmsea.ci.upper.robust  srmr
P 5 czynników                 0.000                 0.024 0.025
P 1 czynnik                   0.106                 0.116 0.087
L 5 czynników                 0.008                 0.027 0.030
L 1 czynnik                   0.084                 0.094 0.074
Oceny, 5 czynników – ładunki standaryzowane od 0.65 do 0.75 | korelacje czynników od 0.44 do 0.6

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

                           Df   AIC   BIC   Chisq Chisq diff   RMSEA Df diff
modele[["P 5 czynników"]] 199 34330 34568  233.08
modele[["P 1 czynnik"]]   209 35829 36023 1752.09     1657.5 0.50164      10
                          Pr(>Chisq)
modele[["P 5 czynników"]]
modele[["P 1 czynnik"]]    < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
5. Luki czy oceny: regresja i bootstrap R² – Rysunek 4
R
# Rysunek 4. Ważność wymiarów: satysfakcja na luki (SERVQUAL) vs na same oceny (SERVPERF)
# (korzysta z kol, motyw, wymiary, dane z przepisu 1 oraz E_w, P_w, L_w z przepisu 2)
library(ggplot2)
library(patchwork)
library(boot)

skr <- substr(wymiary, 1, 3)                                         # Mat, Nie, Rea, Pew, Emp
dw <- data.frame(satysfakcja = dane$satysfakcja, setNames(as.data.frame(E_w), paste0("E_", skr)),
                 setNames(as.data.frame(P_w), paste0("P_", skr)), setNames(as.data.frame(L_w), paste0("L_", skr)))
f_L  <- reformulate(paste0("L_", skr), "satysfakcja")                     # SERVQUAL: luki
f_P  <- reformulate(paste0("P_", skr), "satysfakcja")                     # SERVPERF: same oceny
f_PE <- reformulate(c(paste0("P_", skr), paste0("E_", skr)), "satysfakcja") # oceny i oczekiwania osobno
m_L <- lm(f_L, dw); m_P <- lm(f_P, dw); m_PE <- lm(f_PE, dw)
r2 <- sapply(list(luki = m_L, oceny = m_P, oceny_i_oczekiwania = m_PE),
             function(m) c(R2 = summary(m)$r.squared, R2_skor = summary(m)$adj.r.squared))
print(round(r2, 3))
cat("Czy luka to dobre uproszczenie? (luki = ograniczenie b_P = −b_E w modelu z P i E)\n")
print(anova(m_L, m_PE))
cat("Czy oczekiwania coś dodają do ocen?\n")
print(anova(m_P, m_PE))

# Współczynniki standaryzowane (predyktory i wynik w jednostkach SD) z 95% CI
beta <- function(f) {
  m <- lm(f, data = as.data.frame(scale(dw)))
  ci <- confint(m)[-1, ]
  data.frame(wymiar = wymiary, b = coef(m)[-1], dolna = ci[, 1], gorna = ci[, 2])
}
bL <- beta(f_L); bP <- beta(f_P)
print(data.frame(wymiar = wymiary, beta_luki = round(bL$b, 2), beta_oceny = round(bP$b, 2)), row.names = FALSE)

# Bootstrap: R² obu modeli i różnica R²(oceny) − R²(luki)
set.seed(7061)
stat_r2 <- function(d, i) {
  r_L <- summary(lm(f_L, d[i, ]))$r.squared
  r_P <- summary(lm(f_P, d[i, ]))$r.squared
  c(r_L, r_P, r_P - r_L)
}
b <- boot(dw, stat_r2, R = 2000)
ci_b <- sapply(1:3, function(j) boot.ci(b, type = "perc", index = j)$percent[4:5])
print(data.frame(statystyka = c("R2 luki", "R2 oceny", "roznica"), oszacowanie = round(b$t0, 3),
                 dolna = round(ci_b[1, ], 3), gorna = round(ci_b[2, ], 3)), row.names = FALSE)

db <- rbind(data.frame(bL, model = "luki P − E (SERVQUAL)"), data.frame(bP, model = "same oceny P (SERVPERF)"))
db$wymiar <- factor(db$wymiar, levels = rev(wymiary))
pA <- ggplot(db, aes(b, wymiar, colour = model, shape = model)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, orientation = "y",
                position = position_dodge(width = 0.55)) +
  geom_point(size = 3, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(title = "A. Waga wymiaru dla satysfakcji", subtitle = "współczynnik standaryzowany z 95% CI",
       x = "beta", y = NULL) +
  motyw + guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1))
dr <- data.frame(model = factor(c("luki P − E", "same oceny P"), levels = c("luki P − E", "same oceny P")),
                 R2 = b$t0[1:2], dolna = ci_b[1, 1:2], gorna = ci_b[2, 1:2])
pB <- ggplot(dr, aes(model, R2, fill = model)) +
  geom_col(width = 0.6) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.15, colour = "#0f1d3a") +
  geom_text(aes(y = gorna + 0.03, label = sprintf("%.2f", R2)), size = 4, colour = "#0f1d3a") +
  scale_fill_manual(values = c(kol[["pomaranczowy"]], kol[["niebieski"]]), guide = "none") +
  scale_y_continuous(limits = c(0, 0.6)) +
  labs(title = "B. Wyjaśniona wariancja", subtitle = "R² z 95% CI (bootstrap, 2000 prób)",
       x = NULL, y = "R²") + motyw
p4 <- pA + pB + plot_layout(widths = c(1.5, 1))
p4                       # do pliku: ggsave("servqual-waznosc-luki-vs-oceny.svg", p4, width = 10, height = 5.6)
Wynik w R
         luki oceny oceny_i_oczekiwania
R2      0.328 0.485               0.487
R2_skor 0.322 0.480               0.478
Czy luka to dobre uproszczenie? (luki = ograniczenie b_P = −b_E w modelu z P i E)
Analysis of Variance Table

Model 1: satysfakcja ~ L_Mat + L_Nie + L_Rea + L_Pew + L_Emp
Model 2: satysfakcja ~ P_Mat + P_Nie + P_Rea + P_Pew + P_Emp + E_Mat +
    E_Nie + E_Rea + E_Pew + E_Emp
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    594 850.70
2    589 649.71  5    200.99 36.442 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Czy oczekiwania coś dodają do ocen?
Analysis of Variance Table

Model 1: satysfakcja ~ P_Mat + P_Nie + P_Rea + P_Pew + P_Emp
Model 2: satysfakcja ~ P_Mat + P_Nie + P_Rea + P_Pew + P_Emp + E_Mat +
    E_Nie + E_Rea + E_Pew + E_Emp
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1    594 652.44
2    589 649.71  5    2.7306 0.4951   0.78
       wymiar beta_luki beta_oceny
 Materialność      0.03       0.08
 Niezawodność      0.35       0.37
   Reagowanie      0.07       0.11
      Pewność      0.09       0.11
      Empatia      0.19       0.23
 statystyka oszacowanie dolna gorna
    R2 luki       0.328 0.274 0.392
   R2 oceny       0.485 0.435 0.544
    roznica       0.157 0.116 0.200
6. Porównanie przychodni: Rysunek 5
R
# Rysunek 5. Porównanie przychodni: luka ogólna (ANOVA, Tukey, model mieszany) i luki wymiarów
# (korzysta z kol, motyw, wymiary, dane z przepisu 1 oraz L, L_w z przepisu 2; bez losowania)
library(ggplot2)
library(patchwork)
library(lme4)
library(emmeans)

dp <- data.frame(przychodnia = factor(dane$przychodnia), luka = rowMeans(L), L_w)
names(dp)[-(1:2)] <- wymiary
# Model mieszany: jaka część zróżnicowania luk leży między przychodniami (ICC)?
mm <- lmer(luka ~ 1 + (1 | przychodnia), data = dp)
vc <- as.data.frame(VarCorr(mm))
cat("ICC przychodni dla luki ogólnej:", round(vc$vcov[1] / sum(vc$vcov), 3), "\n")
# ANOVA z przychodnią jako czynnikiem stałym (6 przychodni – to wszystkie, które nas interesują)
m <- lm(luka ~ przychodnia, data = dp)
print(anova(m))
em <- emmeans(m, ~ przychodnia)
print(summary(em), digits = 3)
pary <- as.data.frame(pairs(em, adjust = "tukey"))
cat("Pary przychodni różne po korekcie Tukeya (p < .05):\n")
print(pary[pary$p.value < .05, c("contrast", "estimate", "p.value")], digits = 3, row.names = FALSE)
# Osobno dla każdego wymiaru: jednoczynnikowa ANOVA i korekta Holma na 5 testów
p_wym <- sapply(wymiary, function(w) anova(lm(dp[[w]] ~ dp$przychodnia))[1, "Pr(>F)"])
print(data.frame(wymiar = wymiary, p = signif(p_wym, 3), p_Holm = signif(p.adjust(p_wym, "holm"), 3)),
      row.names = FALSE)

se <- as.data.frame(summary(em))
pA <- ggplot(se, aes(emmean, przychodnia)) +
  geom_vline(xintercept = mean(dp$luka), colour = kol[["szary"]], linetype = "dashed") +
  geom_errorbar(aes(xmin = lower.CL, xmax = upper.CL), width = 0.25, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 3.2, colour = kol[["niebieski"]]) +
  scale_y_discrete(limits = rev) +
  labs(title = "A. Luka ogólna w przychodniach", subtitle = "średnia 22 pozycji z 95% CI; linia: sieć",
       x = "Luka P − E", y = "Przychodnia") + motyw
sr <- aggregate(dp[wymiary], list(przychodnia = dp$przychodnia), mean)
dh <- data.frame(przychodnia = rep(sr$przychodnia, 5), wymiar = rep(wymiary, each = nrow(sr)),
                 luka = unlist(sr[wymiary]))
dh$wymiar <- factor(dh$wymiar, levels = wymiary)
pB <- ggplot(dh, aes(wymiar, przychodnia, fill = luka)) +
  geom_tile(colour = "white", linewidth = 1) +
  geom_text(aes(label = sprintf("%.2f", luka)), colour = ifelse(dh$luka < -1.2, "white", "#0f1d3a"), size = 3.6) +
  scale_fill_gradient(low = "#0f1d3a", high = "#dcebf6", name = "Luka") +
  scale_y_discrete(limits = rev) +
  labs(title = "B. Luki wymiarów", subtitle = "średnie w przychodniach", x = NULL, y = NULL) +
  motyw + theme(panel.grid.major = element_blank(), axis.text.x = element_text(angle = 30, hjust = 1))
p5 <- pA + pB + plot_layout(widths = c(1, 1.25))
p5                       # do pliku: ggsave("servqual-przychodnie.svg", p5, width = 10, height = 5.6)
Wynik w R
ICC przychodni dla luki ogólnej: 0.06
Analysis of Variance Table

Response: luka
             Df  Sum Sq Mean Sq F value    Pr(>F)
przychodnia   5  15.537 3.10736  7.3567 1.052e-06 ***
Residuals   594 250.897 0.42239
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 przychodnia emmean    SE  df lower.CL upper.CL
 A           -0.828 0.065 594   -0.955   -0.700
 B           -0.987 0.065 594   -1.114   -0.859
 C           -0.847 0.065 594   -0.975   -0.720
 D           -1.168 0.065 594   -1.295   -1.040
 E           -0.643 0.065 594   -0.770   -0.515
 F           -0.844 0.065 594   -0.972   -0.716

Confidence level used: 0.95
Pary przychodni różne po korekcie Tukeya (p < .05):
 contrast estimate  p.value
    A - D    0.340 3.22e-03
    B - E   -0.344 2.72e-03
    C - D    0.320 6.93e-03
    D - E   -0.525 2.64e-07
    D - F   -0.324 6.14e-03
       wymiar        p   p_Holm
 Materialność 3.29e-04 6.58e-04
 Niezawodność 8.87e-06 2.66e-05
   Reagowanie 1.31e-09 5.23e-09
      Pewność 9.95e-03 9.95e-03
      Empatia 1.94e-13 9.68e-13
7. Sufit i oczekiwania po wizycie: Rysunek 6
R
# Rysunek 6. Pułapki: sufit oczekiwań („wszystko 7”) i oczekiwania zapisane po wizycie
# (korzysta z kol, motyw, pozycje, wymiary, dane z przepisu 1 oraz E, P, L, E_w, P_w z przepisu 2)
library(ggplot2)
library(patchwork)
library(psych)

# 1. Sufit: ilu klientów zaznaczyło 7 przy oczekiwaniach – i co to robi z luką
siodemki <- sapply(wymiary, function(w) mean(as.matrix(E[, pozycje$wymiar == w]) == 7))
wszystko7 <- rowSums(E == 7) == ncol(E)
cat("Odsetek odpowiedzi 7 w oczekiwaniach wg wymiaru (%):", round(100 * siodemki, 1), "\n")
cat("Klienci z oczekiwaniem 7 we wszystkich 22 pozycjach:", sum(wszystko7), "(", round(100 * mean(wszystko7), 1),
    "% ) | ich luka ogólna:", round(mean(rowMeans(L)[wszystko7]), 2), "| pozostali:",
    round(mean(rowMeans(L)[!wszystko7]), 2), "\n")
cat("Przy E = 7 luka nie może być dodatnia; odsetek luk > 0 wśród par z E = 7:",
    round(100 * mean(as.matrix(L)[as.matrix(E) == 7] > 0), 1), "% | wśród par z E < 7:",
    round(100 * mean(as.matrix(L)[as.matrix(E) < 7] > 0), 1), "%\n")
cat("Korelacja luki ogólnej z ogólną satysfakcją:", round(cor(rowMeans(L), dane$satysfakcja), 2),
    "| z samą oceną ogólną:", round(cor(rowMeans(P), dane$satysfakcja), 2), "\n")

# 2. Oczekiwania zapisane po wizycie: część doświadczenia „przecieka” do pamiętanych oczekiwań.
#    Ręcznie: pamiętane E = E + 0.4 × (P − E) + szum, zaokrąglone do skali 1–7.
set.seed(7062)
przeciek <- 0.4
E_po <- round(as.matrix(E) + przeciek * as.matrix(P - E) + matrix(rnorm(nrow(E) * ncol(E), 0, 0.3), nrow(E)))
E_po <- as.data.frame(pmin(pmax(E_po, 1), 7))
L_po <- P - E_po
E_po_w <- sapply(wymiary, function(w) rowMeans(E_po[, pozycje$wymiar == w]))
por <- data.frame(wymiar = wymiary,
  luka_przed = colMeans(P_w - E_w), luka_po = colMeans(P_w - E_po_w),
  r_PE_przed = sapply(1:5, function(j) cor(P_w[, j], E_w[, j])),
  r_PE_po = sapply(1:5, function(j) cor(P_w[, j], E_po_w[, j])),
  alfa_luki_przed = sapply(wymiary, function(w) psych::alpha(L[, pozycje$wymiar == w], warnings = FALSE)$total$raw_alpha),
  alfa_luki_po = sapply(wymiary, function(w) psych::alpha(L_po[, pozycje$wymiar == w], warnings = FALSE)$total$raw_alpha))
print(data.frame(por[1], round(por[-1], 2)), row.names = FALSE)

dA <- do.call(rbind, lapply(wymiary, function(w) {
  x <- as.vector(as.matrix(E[, pozycje$wymiar == w]))
  data.frame(wymiar = w, odp = factor(c("1–4", "5", "6", "7"), levels = c("1–4", "5", "6", "7")),
             proc = 100 * c(mean(x <= 4), mean(x == 5), mean(x == 6), mean(x == 7)))
}))
dA$wymiar <- factor(dA$wymiar, levels = rev(wymiary))
pA <- ggplot(dA, aes(proc, wymiar, fill = odp)) +
  geom_col(width = 0.7, position = position_stack(reverse = TRUE)) +
  geom_text(data = subset(dA, odp == "7"), aes(x = 100 - proc / 2, label = sprintf("%.0f%%", proc)),
            colour = "white", size = 3.6, fontface = "bold") +
  scale_fill_manual(values = c("#dcebf6", kol[["blekit"]], kol[["niebieski"]], "#0f1d3a"), name = "Odpowiedź") +
  labs(title = "A. Oczekiwania przy suficie", subtitle = "rozkład odpowiedzi E (skala 1–7)", x = "%", y = NULL) +
  motyw + guides(fill = guide_legend(nrow = 1))
dB <- rbind(data.frame(wymiar = wymiary, luka = por$luka_przed, kiedy = "oczekiwania przed wizytą"),
            data.frame(wymiar = wymiary, luka = por$luka_po, kiedy = "oczekiwania zapisane po wizycie"))
dB$wymiar <- factor(dB$wymiar, levels = rev(wymiary))
pB <- ggplot(dB, aes(luka, wymiar)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_line(aes(group = wymiar), colour = "grey70", linewidth = 1) +
  geom_point(aes(colour = kiedy, shape = kiedy), size = 3.4) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(title = "B. Oczekiwania pytane po usłudze", subtitle = "średnia luka (przeciek 40%)",
       x = "Luka P − E", y = NULL) +
  motyw + guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1))
p6 <- pA + pB
p6                       # do pliku: ggsave("servqual-pulapki-sufit-pomiar-po.svg", p6, width = 10, height = 5.6)
Wynik w R
Odsetek odpowiedzi 7 w oczekiwaniach wg wymiaru (%): 45.8 54.9 45.4 59.4 34.9
Klienci z oczekiwaniem 7 we wszystkich 22 pozycjach: 72 ( 12 % ) | ich luka ogólna: -1.44 | pozostali: -0.81
Przy E = 7 luka nie może być dodatnia; odsetek luk > 0 wśród par z E = 7: 0 % | wśród par z E < 7: 23.8 %
Korelacja luki ogólnej z ogólną satysfakcją: 0.55 | z samą oceną ogólną: 0.68
       wymiar luka_przed luka_po r_PE_przed r_PE_po alfa_luki_przed
 Materialność      -0.55   -0.32       0.16    0.69            0.75
 Niezawodność      -1.10   -0.66       0.22    0.78            0.80
   Reagowanie      -1.38   -0.82       0.16    0.74            0.75
      Pewność      -0.53   -0.33       0.17    0.70            0.71
      Empatia      -0.83   -0.49       0.16    0.72            0.81
 alfa_luki_po
         0.68
         0.72
         0.67
         0.63
         0.75
8. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy" = c("#0072B2", "#D55E00"), "niebieski – szary" = c("#0072B2", "#999999"),
             "pomarańczowy – szary" = c("#D55E00", "#999999"), "pomarańczowy – granat" = c("#D55E00", "#0f1d3a"),
             "błękit – granat" = c("#56B4E9", "#0f1d3a"), "jasny błękit – granat" = c("#dcebf6", "#0f1d3a"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
niebieski – pomarańczowy                   114.6        108.3       91.9
niebieski – szary                           44.9         48.9       40.6
pomarańczowy – szary                        77.2         62.9       56.0
pomarańczowy – granat                      101.6         96.6       81.5
błękit – granat                             62.8         59.6       61.8
jasny błękit – granat                       82.6         82.5       81.4
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Test t, regresję, ANOVA i korektę Holma wykonano pakietem stats (z podstawowej instalacji R), dane wielowymiarowe wylosowano pakietem MASS, alfę i omegę policzono pakietem psych (omega korzysta z pakietu GPArotation), CFA – pakietem lavaan, model mieszany – pakietem lme4, średnie brzegowe i korektę Tukeya – pakietem emmeans, a bootstrap – pakietem boot. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Luka bez porównania z oceną – może wyjaśniać mniej (rysunek 4).
- Brak rzetelności luk – podawaj ją obok rzetelności ocen (rysunek 3).
- Sufit „wszystko 7” – sprawdź odsetek siódemek i osoby z identycznymi odpowiedziami (straightlining); pokaż wyniki z nimi i bez nich (rysunek 6A).
- Oczekiwania pytane po usłudze – luki maleją, a ich rzetelność spada (rysunek 6B).
- Średnia z 22 pozycji – zakrywa problem jednego wymiaru (rysunek 5).
- Pięć wymiarów przyjęte na wiarę – po adaptacji kwestionariusza sprawdź strukturę CFA.
Najczęstsze pytania
Jak policzyć lukę SERVQUAL?
Dla każdej pozycji odejmij oczekiwanie od oceny (P − E), a wynik wymiaru policz jako średnią luk jego pozycji. Ujemna luka znaczy, że usługa wypadła poniżej oczekiwań. Przedział ufności licz dla różnic sparowanych, jak w teście t dla prób zależnych – w przykładzie luka reagowania wyniosła −1.38 [−1.45, −1.30].
Czym różni się SERVQUAL od SERVPERF?
SERVQUAL używa luki między oceną a oczekiwaniem, SERVPERF – samych ocen wykonania, więc ankieta jest o połowę krótsza. W metaanalizie obie skale przewidywały ogólną jakość usług równie dobrze. W przykładzie przychodni same oceny wyjaśniały więcej wariancji satysfakcji (R² = .485 wobec .328), ale tak ustawiono dane – porównaj oba modele na swoich danych.
Czy luka SERVQUAL jest rzetelna?
Rzetelność różnicy dwóch wyników jest zwykle niższa niż rzetelność jej składników i spada, gdy ocena i oczekiwanie silnie korelują. Podawaj alfę lub omegę osobno dla ocen, oczekiwań i luk. W przykładzie luka niezawodności miała alfę 0.80 wobec 0.85 dla ocen, a przy korelacji 0.5 i podobnych odchyleniach spadłaby do ok. 0.63.
Co zrobić, gdy wszyscy zaznaczają 7 przy oczekiwaniach?
To efekt sufitu: przy oczekiwaniu 7 luka nie może być dodatnia i zależy głównie od stylu odpowiadania. Podaj odsetek siódemek, policz wyniki z osobami „wszystko 7” i bez nich i rozważ same oceny albo pytanie o ważność cech. W przykładzie 12% klientów miało 7 we wszystkich 22 pozycjach i ich luka była prawie dwa razy większa (−1.44 wobec −0.81).
Jak sprawdzić pięć wymiarów SERVQUAL w CFA?
Dopasuj model pięciu skorelowanych czynników (np. w lavaan z estymatorem MLR) i porównaj go z modelem jednego czynnika. Podaj χ², CFI, TLI, RMSEA z przedziałem i SRMR. W przykładzie model pięciu czynników miał CFI = .994 i RMSEA = .015, a jednoczynnikowy CFI = .694 i RMSEA = .111.
Powiązane hasła
Przeczytaj też
Alfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikKluczowe czynniki satysfakcji
Ankieta gości hotelu: korelacje, β przy współliniowości, wagi względne i dominacja, macierz ważność–ocena i bootstrap rankingu z kodem R.
Czytaj →PoradnikCSAT, CES czy NPS – który przewiduje odejście
8000 kontaktów z obsługą światłowodu: krzywe ROC, test DeLonga, kalibracja i przyrost AUC trzech wskaźników – z kodem R.
Czytaj →Badasz jakość usług albo piszesz pracę z SERVQUAL?
Pomożemy zaadaptować kwestionariusz, policzyć luki, rzetelność i CFA, porównać SERVQUAL z SERVPERF oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Carrillat, F. A., Jaramillo, F., & Mulki, J. P. (2007). The validity of the SERVQUAL and SERVPERF scales: A meta-analytic view of 17 years of research across five continents. International Journal of Service Industry Management, 18(5), 472–490. https://doi.org/10.1108/09564230710826250 ● Otwarty dostęp: pełny tekst
- Cronin, J. J., Jr., & Taylor, S. A. (1992). Measuring service quality: A reexamination and extension. Journal of Marketing, 56(3), 55–68. https://doi.org/10.1177/002224299205600304 ● Otwarty dostęp: pełny tekst
- Edwards, J. R. (2001). Ten difference score myths. Organizational Research Methods, 4(3), 265–287. https://doi.org/10.1177/109442810143005
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Parasuraman, A., Zeithaml, V. A., & Berry, L. L. (1985). A conceptual model of service quality and its implications for future research. Journal of Marketing, 49(4), 41–50. https://doi.org/10.1177/002224298504900403
- Peter, J. P., Churchill, G. A., Jr., & Brown, T. J. (1993). Caution in the use of difference scores in consumer research. Journal of Consumer Research, 19(4), 655–662. https://doi.org/10.1086/209329
- Revelle, W., & Condon, D. M. (2019). Reliability from α to ω: A tutorial. Psychological Assessment, 31(12), 1395–1411. https://doi.org/10.1037/pas0000754 ● Otwarty dostęp
Cytowania BibTeX
@article{carrillat2007validity, author={Carrillat, François A. and Jaramillo, Fernando and Mulki, Jay P.}, title={{The validity of the SERVQUAL and SERVPERF scales: A meta-analytic view of 17 years of research across five continents}}, journal={International Journal of Service Industry Management}, year={2007}, volume={18}, number={5}, pages={472--490}, doi={10.1108/09564230710826250}}@article{cronin1992measuring, author={Cronin, J. Joseph, Jr. and Taylor, Steven A.}, title={{Measuring service quality: A reexamination and extension}}, journal={Journal of Marketing}, year={1992}, volume={56}, number={3}, pages={55--68}, doi={10.1177/002224299205600304}}@article{edwards2001ten, author={Edwards, Jeffrey R.}, title={{Ten difference score myths}}, journal={Organizational Research Methods}, year={2001}, volume={4}, number={3}, pages={265--287}, doi={10.1177/109442810143005}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{parasuraman1985conceptual, author={Parasuraman, A. and Zeithaml, Valarie A. and Berry, Leonard L.}, title={{A conceptual model of service quality and its implications for future research}}, journal={Journal of Marketing}, year={1985}, volume={49}, number={4}, pages={41--50}, doi={10.1177/002224298504900403}}@article{peter1993caution, author={Peter, J. Paul and Churchill, Gilbert A., Jr. and Brown, Tom J.}, title={{Caution in the use of difference scores in consumer research}}, journal={Journal of Consumer Research}, year={1993}, volume={19}, number={4}, pages={655--662}, doi={10.1086/209329}}@article{revelle2019reliability, author={Revelle, William and Condon, David M.}, title={{Reliability from α to ω: A tutorial}}, journal={Psychological Assessment}, year={2019}, volume={31}, number={12}, pages={1395--1411}, doi={10.1037/pas0000754}}