Przykład: światłowód i 8000 rozmów z obsługą
Fikcyjny regionalny dostawca internetu światłowodowego wysyła dzień po każdym kontakcie z obsługą ankietę z trzema pytaniami: CSAT, CES i NPS. Dział utrzymania klientów pyta: który z nich lepiej przewiduje, że klient wypowie umowę w ciągu pół roku?
Mamy 8000 kontaktów z jednego roku, cztery powody kontaktu (awaria, faktura, zmiana pakietu, router i Wi-Fi) i informację z CRM, kto odszedł w ciągu 6 miesięcy. Na ankietę odpowiedziało 3617 osób (45.2%); odeszło z nich 442 (12.2%), a spośród milczących – 15.8%.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Każdy klient ma trzy ukryte cechy: stosunek do firmy, wysiłek włożony w załatwienie sprawy i jakość rozmowy z konsultantem. CSAT „widzi” głównie rozmowę, CES – wysiłek, NPS – stosunek do firmy, a odejście zależy od wysiłku i stosunku do firmy. Wagi, progi skal, udziały powodów kontaktu (w miesiącu 7 awaria sieci) i skłonność do odpowiadania ustawiliśmy ręcznie przed pierwszym uruchomieniem i ich nie zmienialiśmy; ziarno set.seed(707) jest pierwsze i jedyne. Dane pobierzesz jako csat-ces-nps-swiatlowod-8000-kontaktow.csv.
Rysunek 1: trzy pytania, trzy różne rzeczy
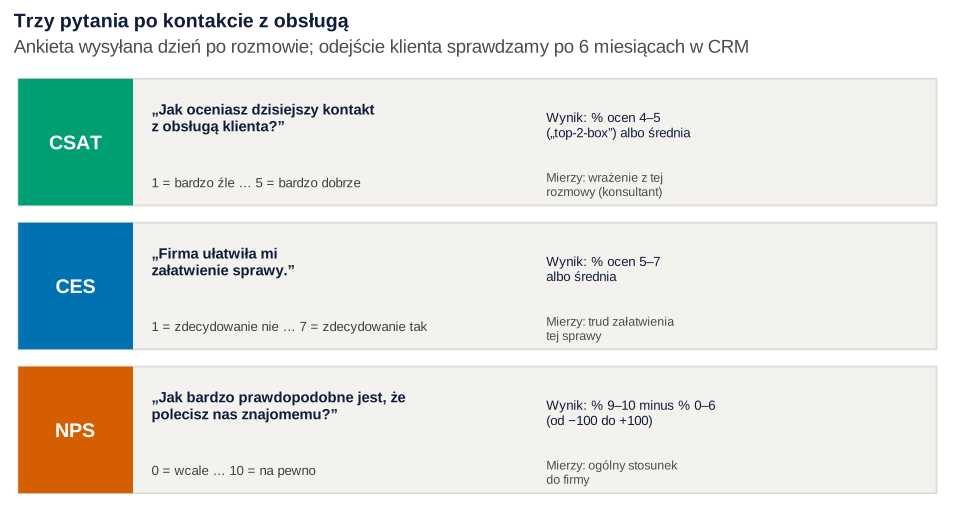
Co widać. CSAT dotyczy tej jednej rozmowy, CES – trudu załatwienia sprawy, NPS – stosunku do firmy w ogóle (wzór opisuje hasło Net Promoter Score). Korelacje rang między nimi są umiarkowane (ρ = .32–.38).
Jak może zmylić. Na pulpicie wszystkie trzy wyglądają podobnie: CSAT 59.9% ocen 4–5, CES 66.4% ocen 5–7, NPS −1.0. Tych liczb nie wolno porównywać – mają inne skale. Porównujemy to, jak dobrze każdy wskaźnik odróżnia odchodzących od zostających. Przedział ufności dla samego NPS opisuje wpis NPS – przedział ufności i porównania.
Podpis do pracy:
Rysunek 2: rozkłady odpowiedzi i odejścia
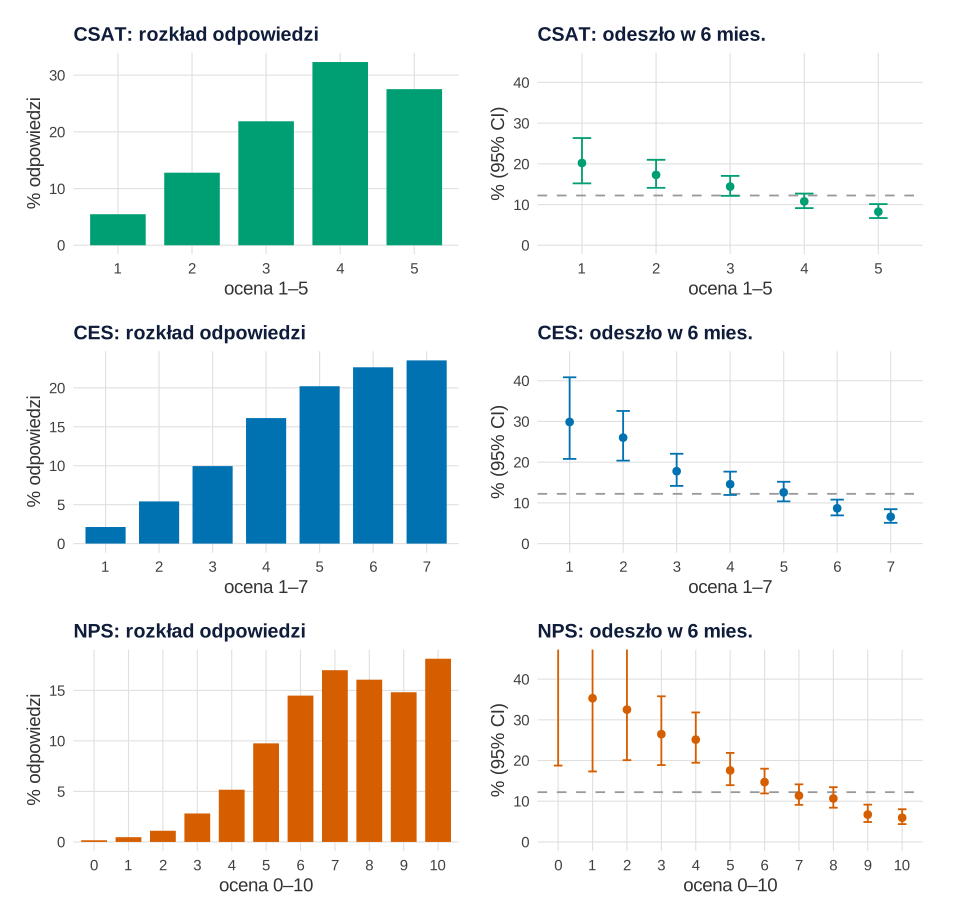
set.seed(707)).Co widać. Rozkłady są przesunięte ku górze skali. Im niższa ocena, tym więcej odejść, ale nachylenie się różni: przy CSAT od 20.2% (ocena 1) do 8.2% (ocena 5), przy CES od 29.9% do 6.6%, przy NPS od ponad 30% przy ocenach 1–2 do 5.9% przy ocenie 10. W kategoriach NPS odeszło 19.1% krytyków, 11.0% biernych i 6.3% promotorów.
Jak może zmylić. Najstromsze fragmenty dotyczą rzadkich ocen: ocenę 0 w NPS dało 6 osób, ocenę 1 w CES – 77. O sile wskaźnika decyduje cała skala, nie dwa krańce.
Podpis do pracy:
Rysunek 3: krzywe ROC i test DeLonga
Każdy wskaźnik traktujemy jak „test” na odejście: niska ocena = alarm. Krzywa ROC pokazuje czułość wobec odsetka fałszywych alarmów przy każdym progu skali. Pole pod krzywą (AUC) to prawdopodobieństwo, że losowo wybrany klient, który odszedł, dał niższą ocenę niż losowo wybrany klient, który został (Hanley i McNeil, 1982). AUC = .5 to rzut monetą.
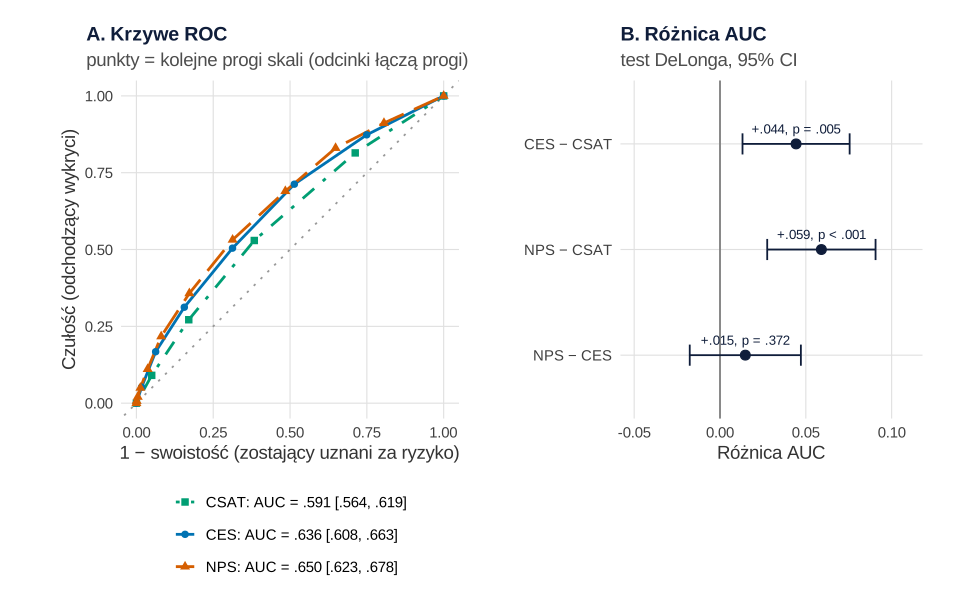
set.seed(707)).Co widać. NPS ma AUC = .650 [.623, .678], CES = .636 [.608, .663], a CSAT = .591 [.564, .619]. Krzywe NPS i CES prawie się pokrywają, CSAT leży niżej. Test DeLonga uwzględnia, że wszystkie trzy oceny pochodzą od tych samych klientów (DeLong i in., 1988): CES i NPS są lepsze od CSAT (różnice .044, z = 2.78, p = .005 i .059, z = 3.67, p < .001), ale różnica między NPS a CES wynosi .015 [−.018, .047], p = .372.
Jak może zmylić. „NPS wygrywa” to zbyt mocne zdanie: dane nie odróżniają NPS od CES. A AUC około .64 to umiarkowana dyskryminacja – pojedyncza ocena nie wskaże z pewnością, kto odejdzie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: czy przewidywane ryzyko jest prawdziwe?
AUC mówi tylko o kolejności klientów, a dział utrzymania potrzebuje też liczby: „25% ryzyka odejścia”. Dla każdego wskaźnika dopasowujemy regresję logistyczną i sprawdzamy kalibrację: dzielimy klientów na dziesięć grup według przewidywanego ryzyka i porównujemy je z odsetkiem odejść. Przewidywania pochodzą z 10-krotnej walidacji krzyżowej (każdego klienta ocenia model, który go nie widział).
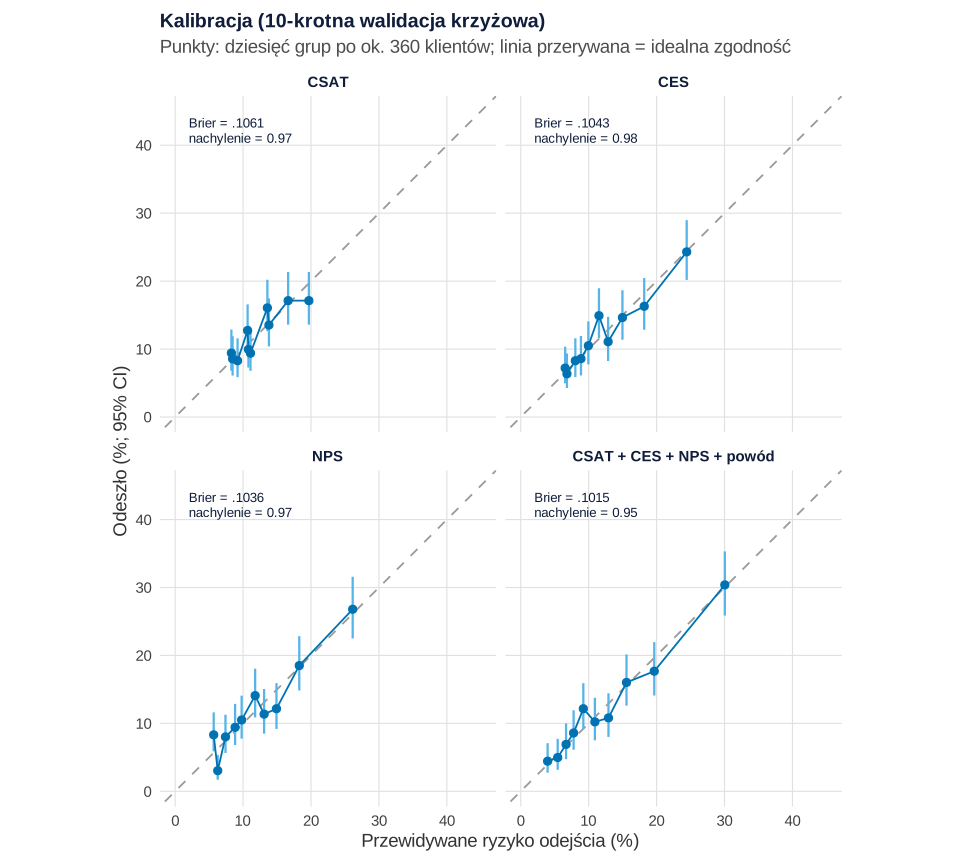
set.seed(7074) dla podziału na części).Co widać. Wszystkie modele są dobrze skalibrowane (nachylenie kalibracji 0.95–0.98, ideał to 1). Różnią się zakresem: model z CSAT przewiduje ryzyko tylko od 8.2% do 21.9%. NPS rozciąga ryzyko od 5.4% do 47.8%, a model z trzema wskaźnikami i powodem kontaktu – od 3.0% do 57.7%; w jego najwyższej grupie przewidywane 30.0% odpowiada 30.4% odejść. Wynik Briera spada z .1073 (wszystkim przypisujemy średnie 12.2%) do .1061 dla CSAT, .1036 dla NPS i .1015 dla modelu łącznego.
Jak może zmylić. Dobra kalibracja nie oznacza dobrej dyskryminacji: model z CSAT jest „uczciwy”, ale nie rozdziela klientów. Przy rzadkim zdarzeniu Brier jest zawsze mały – porównuj go z modelem bez predyktorów. Steyerberg i in. (2010) zalecają zawsze raportować razem dyskryminację i kalibrację; nachylenie poniżej 1 świadczy o przeuczeniu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: razem czy osobno – i od czego zależy zwycięzca
Skoro wskaźniki mierzą różne rzeczy, może razem przewidują lepiej? Sprawdzamy to poza próbą: 20 razy powtarzamy 10-krotną walidację krzyżową i liczymy AUC sześciu modeli. Panel B pokazuje AUC wskaźników w grupach powodu kontaktu.
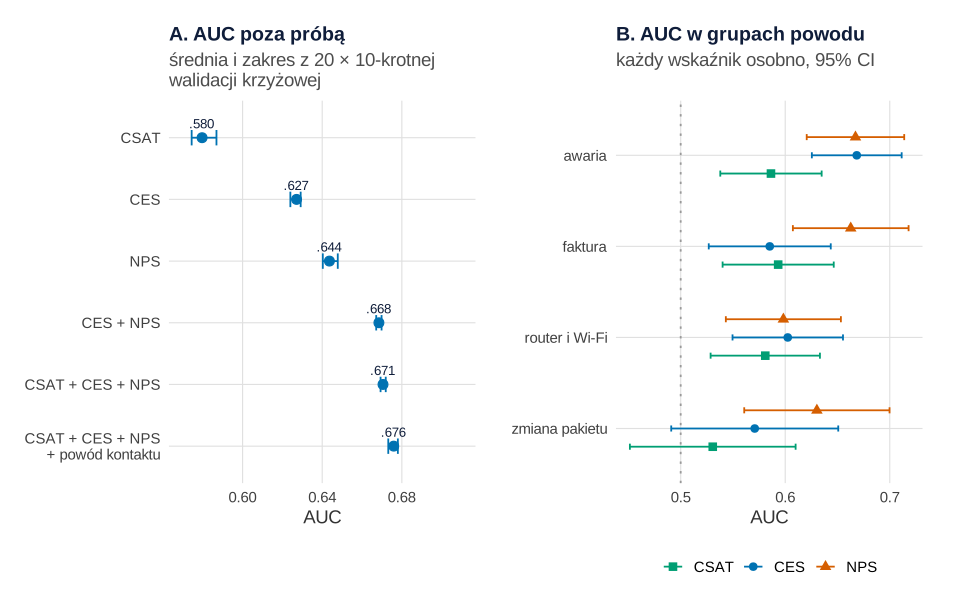
set.seed(7075) dla podziałów).Co widać. Poza próbą AUC wynosi .580 dla CSAT, .627 dla CES i .644 dla NPS. CES i NPS razem dają .668, a dodanie CSAT – tylko .671. Przyrost względem samego NPS to .027 (od .024 do .030 w 20 powtórzeniach; przybliżony test DeLonga na przewidywaniach poza próbą: z = 3.75, p < .001). W modelu z trzema wskaźnikami i powodem kontaktu CSAT nic już nie wnosi (OR = 0.97 [0.88, 1.06] na punkt skali), a CES i NPS tak (OR = 0.84 [0.78, 0.90] i 0.82 [0.78, 0.87]). Powód kontaktu dodaje jeszcze .005.
Zwycięzca zależy od powodu kontaktu. Po awarii CES i NPS są równie dobre (.668 i .667). Przy sprawach z fakturą CES traci (.585 [.527, .644]), a NPS trzyma poziom (.663 [.607, .718]).
Jak może zmylić. Przyrost AUC o .027 wygląda skromnie, ale AUC słabo reaguje na dodanie nowej zmiennej; Pencina i in. (2008) zaproponowali dlatego miary uzupełniające, m.in. wskaźnik reklasyfikacji netto (NRI). Grupy powodu są małe (59–158 odejść), więc różnice traktuj jako trop. W prawdziwym panelu ponad 8000 klientów, m.in. dostawców internetu, sama intencja polecenia nie wystarczała jako jedyny predyktor lojalności (Keiningham i in., 2007).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: wskaźnik miesiąca i ci, którzy milczą
Pulpit pokazuje jedną liczbę na miesiąc. To inne pytanie: ocena klienta odpowiada na „kto odejdzie?”, wskaźnik miesięczny – na „czy obsługa działała lepiej?”. Panel A pokazuje CSAT surowy i przeliczony do rocznej struktury powodów kontaktu (odsetki w powodach ważone ich udziałem w roku), panel B – odejścia odpowiadających i milczących.
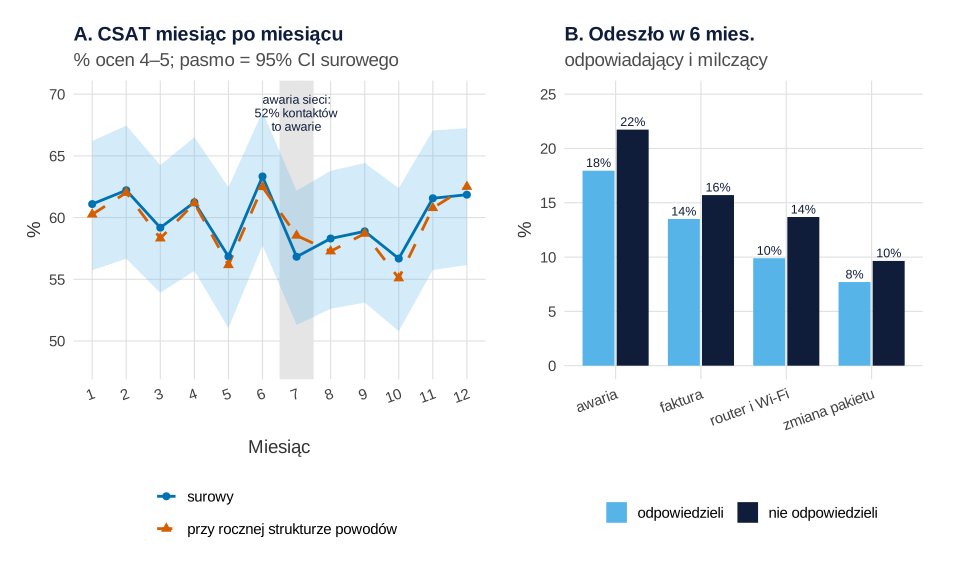
set.seed(707)).Co widać. W miesiącu 7 awarie stanowiły 52.4% kontaktów (zwykle około 20%), a surowy CSAT spadł do 56.8%. Po przeliczeniu na zwykłą strukturę powodów wynosi 58.5%, bo część spadku to po prostu więcej trudnych spraw. Tyle że miesiące 5 i 10 miały podobnie niski CSAT bez żadnej awarii: przy około 300 ankietach miesięcznie 95% przedział ma szerokość około 11 punktów procentowych. Korelacja miesięcznego NPS z odsetkiem odejść z 12 miesięcy to r = −.42, 95% CI [−.80, .21] – dwanaście punktów nie wystarcza do żadnego wniosku. Wnioskowanie z danych zbiorczych o pojedynczych klientach to błąd ekologiczny.
Panel B: na ankietę odpowiadają rzadziej klienci po awarii (40.3%) niż po zmianie pakietu (49.3%), a w każdej grupie milczący odchodzą częściej niż odpowiadający (po awarii 21.7% wobec 18.0%, przy routerze i Wi-Fi 13.7% wobec 9.9%).
Jak może zmylić. Wszystkie AUC z tego wpisu dotyczą tylko 45.2% klientów, którzy odpowiedzieli. Brak odpowiedzi może, ale nie musi obciążać wyników, a korekta wymaga dobrych zmiennych pomocniczych (Groves, 2006) – u operatora są nimi dane z CRM. Jak ważyć ankietę takimi danymi, pokazuje wpis ankieta po zakupie i brak odpowiedzi.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- Nie wybieraj jednego wskaźnika „na zawsze”. CES i NPS były nie do odróżnienia, a razem przewidywały lepiej. Jeśli ankieta ma mieć jedno pytanie: CES do oceny procesów obsługi, NPS do oceny relacji.
- CSAT zostaw do oceny konsultantów, nie do prognozy odejść.
- Ryzyko bierz z modelu skalibrowanego poza próbą, łącząc oceny z danymi z CRM; próg dobierz do budżetu działu utrzymania (krzywa zysku – model odejść klientów).
- Wskaźnik miesięczny pokazuj standaryzowany i z przedziałem ufności; zmian o 2–3 punkty przy 300 ankietach nie ogłaszaj jako trendu.
- Dzwoń także do milczących – po awarii odchodzili najczęściej (21.7%).
- Dalej: „kiedy odejdzie” – analiza przeżycia odejść; co poprawić – kluczowe czynniki satysfakcji albo SERVQUAL; nieliniowa zależność oceny od czasu – czas dostawy a ocena i ponowny zakup.
Jak opisać w pracy
Opisz pytania i skale, moment ankiety, odsetek odpowiedzi i definicję odejścia. Podaj AUC z 95% CI, test DeLonga, kalibrację i przyrost AUC z walidacji krzyżowej. Nazwij ograniczenia: wnioski dotyczą respondentów, a wskaźnik zbiorczy to inne pytanie – na poziomie firm Morgan i Rego (2006) stwierdzili, że lepszą wartość prognostyczną miała średnia satysfakcja niż miary oparte na poleceniu. Zobacz też statystykę w pracy z marketingu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane (klienci – wszystkie kontakty, ank – odpowiadający) i zapisuje plik CSV do katalogu roboczego. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje, zaczyna od własnego set.seed(): 707 w przepisie 1 (dane), 7074 w przepisie 4 (podział na 10 części), 7075 w przepisie 5 (20 podziałów walidacji krzyżowej); przepisy 2, 3, 6 i 7 nie losują. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono (przepis 1): liczbę kontaktów 8000, udziały powodów kontaktu (w miesiącu 7: 55% awarii), odsetki spraw załatwionych przy pierwszym kontakcie, wagi ukrytych cech w trzech pytaniach i w ryzyku odejścia, progi skal i skłonność do odpowiadania. Parametrów danych po pierwszym uruchomieniu nie zmieniano. Zmieniono tylko prezentację: krzywe ROC rysowane odcinkami między progami zamiast schodków, pasmo 95% CI i etykietę udziału awarii liczoną z danych w rysunku 6 oraz zapis liczb bez zera przed kropką na rysunkach. Wszystkie przepisy liczą się w kilka sekund.
1. Dane, paleta i karta trzech pytań: Rysunek 1
R
# Rysunek 1. Fikcyjny dostawca internetu światłowodowego: 8000 kontaktów z obsługą, ankieta po kontakcie
# (CSAT, CES, NPS) i odejścia w ciągu 6 miesięcy znane z systemu klientów (CRM)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", blekit = "#56B4E9", zielony = "#009E73",
         zolty = "#E69F00", rozowy = "#CC79A7", szary = "#999999", granat = "#0f1d3a")
kol_wsk <- c(CSAT = kol[["zielony"]], CES = kol[["niebieski"]], NPS = kol[["pomaranczowy"]])
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustawione ręcznie. Każdy klient ma trzy ukryte cechy (w prawdziwych danych ich nie widać):
#   relacja – ogólny stosunek do firmy, wysilek – ile trudu kosztowało załatwienie sprawy,
#   agent – jak uprzejmy i kompetentny był konsultant.
N <- 8000
powody <- c("awaria", "faktura", "zmiana pakietu", "router i Wi-Fi")
p_powod      <- c(0.25, 0.25, 0.20, 0.30)          # zwykły miesiąc
p_powod_m7   <- c(0.55, 0.15, 0.10, 0.20)          # miesiąc 7: duża awaria sieci
p_fcr        <- c(0.55, 0.75, 0.85, 0.70)          # sprawa załatwiona przy pierwszym kontakcie
wysilek_pow  <- c(0.40, 0.20, -0.20, 0.00)         # dodatkowy wysiłek wg powodu
odejscie_pow <- c(0.35, 0.25, -0.20, 0.00)         # dodatkowe ryzyko odejścia wg powodu (logit)

set.seed(707)
miesiac <- sample(1:12, N, replace = TRUE)
powod <- character(N)
powod[miesiac != 7] <- sample(powody, sum(miesiac != 7), replace = TRUE, prob = p_powod)
powod[miesiac == 7] <- sample(powody, sum(miesiac == 7), replace = TRUE, prob = p_powod_m7)
ip <- match(powod, powody)
fcr <- rbinom(N, 1, p_fcr[ip])
relacja <- rnorm(N)
agent <- rnorm(N)
wysilek <- wysilek_pow[ip] + 1.0 * (1 - fcr) + rnorm(N, 0, 0.7)
awaria <- as.numeric(powod == "awaria")

# Odpowiedzi w ankiecie: każdy wskaźnik „widzi” inną mieszankę ukrytych cech
l_csat <- 0.9 * agent - 0.45 * wysilek + 0.30 * relacja - 0.3 * awaria + rnorm(N, 0, 0.8)
l_ces  <- -1.0 * wysilek + 0.25 * agent + 0.15 * relacja + rnorm(N, 0, 0.7)
l_nps  <- 0.9 * relacja - 0.35 * wysilek + 0.25 * agent - 0.2 * awaria + rnorm(N, 0, 0.8)
csat <- as.integer(cut(l_csat, c(-Inf, -2.2, -1.3, -0.4, 0.7, Inf)))            # 1–5
ces  <- as.integer(cut(l_ces, c(-Inf, -2.6, -1.9, -1.3, -0.7, -0.1, 0.6, Inf)))  # 1–7
nps  <- pmin(10L, pmax(0L, as.integer(round(7.4 + 1.8 * l_nps))))              # 0–10

# Odejście w ciągu 6 miesięcy (CRM zna je u wszystkich) i odpowiedź na ankietę (niezadowoleni odpowiadają rzadziej)
odszedl <- rbinom(N, 1, plogis(-2.4 + 0.60 * wysilek - 0.65 * relacja - 0.10 * agent + odejscie_pow[ip]))
odpowiedzial <- rbinom(N, 1, plogis(-0.1 + 0.35 * relacja - 0.35 * wysilek + 0.10 * agent))

klienci <- data.frame(id = 1:N, miesiac, powod, rozwiazane_od_razu = fcr, odpowiedzial,
                      csat = ifelse(odpowiedzial == 1, csat, NA), ces = ifelse(odpowiedzial == 1, ces, NA),
                      nps = ifelse(odpowiedzial == 1, nps, NA), odszedl_6m = odszedl)
write.csv(klienci, "csat-ces-nps-swiatlowod-8000-kontaktow.csv", row.names = FALSE)
ank <- subset(klienci, odpowiedzial == 1)                    # dalsze przepisy: tylko odpowiadający

cat("Kontakty:", N, "| odpowiedzieli na ankietę:", nrow(ank), sprintf("(%.1f%%)", 100 * mean(klienci$odpowiedzial)), "\n")
cat(sprintf("Odeszło w 6 mies.: wszyscy %.1f%% | odpowiadający %.1f%% | bez odpowiedzi %.1f%%\n",
            100 * mean(klienci$odszedl_6m), 100 * mean(ank$odszedl_6m),
            100 * mean(klienci$odszedl_6m[klienci$odpowiedzial == 0])))
cat("Odejść wśród odpowiadających:", sum(ank$odszedl_6m), "\n")
cat(sprintf("CSAT (%% ocen 4–5): %.1f | CES (%% ocen 5–7): %.1f | NPS: %.1f\n",
            100 * mean(ank$csat >= 4), 100 * mean(ank$ces >= 5),
            100 * (mean(ank$nps >= 9) - mean(ank$nps <= 6))))
print(round(cor(ank[c("csat", "ces", "nps")], method = "spearman"), 2))

# Karta trzech pytań (grafika – prostokąty i tekst w ggplot2)
karta <- data.frame(
  y = 3:1, wsk = c("CSAT", "CES", "NPS"),
  pytanie = c("„Jak oceniasz dzisiejszy kontakt\nz obsługą klienta?”",
              "„Firma ułatwiła mi\nzałatwienie sprawy.”",
              "„Jak bardzo prawdopodobne jest, że\npolecisz nas znajomemu?”"),
  skala = c("1 = bardzo źle … 5 = bardzo dobrze", "1 = zdecydowanie nie … 7 = zdecydowanie tak",
            "0 = wcale … 10 = na pewno"),
  wynik = c("Wynik: % ocen 4–5\n(„top-2-box”) albo średnia", "Wynik: % ocen 5–7\nalbo średnia",
            "Wynik: % 9–10 minus % 0–6\n(od −100 do +100)"),
  mierzy = c("Mierzy: wrażenie z tej\nrozmowy (konsultant)", "Mierzy: trud załatwienia\ntej sprawy",
             "Mierzy: ogólny stosunek\ndo firmy"))
p1 <- ggplot(karta) +
  geom_rect(aes(xmin = 0, xmax = 10, ymin = y - 0.44, ymax = y + 0.44), fill = "#f4f2ee", colour = "#dedbd4") +
  geom_rect(aes(xmin = 0, xmax = 1.25, ymin = y - 0.44, ymax = y + 0.44, fill = wsk), colour = NA) +
  geom_text(aes(x = 0.625, y = y, label = wsk), colour = "white", fontface = "bold", size = 5.2) +
  geom_text(aes(x = 1.45, y = y + 0.17, label = pytanie), hjust = 0, size = 3.9, colour = "#0f1d3a",
            lineheight = 0.95, fontface = "bold") +
  geom_text(aes(x = 1.45, y = y - 0.28, label = skala), hjust = 0, size = 3.5, colour = "grey25") +
  geom_text(aes(x = 5.75, y = y + 0.12, label = wynik), hjust = 0, size = 3.5, colour = "#0f1d3a", lineheight = 0.95) +
  geom_text(aes(x = 5.75, y = y - 0.27, label = mierzy), hjust = 0, size = 3.3, colour = "grey30", lineheight = 0.95,
            vjust = 0.65) +
  scale_fill_manual(values = kol_wsk, guide = "none") +
  scale_x_continuous(limits = c(0, 10), expand = c(0, 0.05)) +
  scale_y_continuous(limits = c(0.5, 3.5), expand = c(0, 0.02)) +
  labs(title = "Trzy pytania po kontakcie z obsługą",
       subtitle = "Ankieta wysyłana dzień po rozmowie; odejście klienta sprawdzamy po 6 miesiącach w CRM") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
p1                       # do pliku: ggsave("csat-ces-nps-karta-pytan.svg", p1, width = 10, height = 5.4)
Wynik w R
Kontakty: 8000 | odpowiedzieli na ankietę: 3617 (45.2%)
Odeszło w 6 mies.: wszyscy 14.2% | odpowiadający 12.2% | bez odpowiedzi 15.8%
Odejść wśród odpowiadających: 442
CSAT (% ocen 4–5): 59.9 | CES (% ocen 5–7): 66.4 | NPS: -1.0
     csat  ces  nps
csat 1.00 0.38 0.34
ces  0.38 1.00 0.32
nps  0.34 0.32 1.00
2. Rozkłady odpowiedzi i odejścia przy każdej ocenie: Rysunek 2
R
# Rysunek 2. Rozkłady odpowiedzi i odsetek odejść przy każdej odpowiedzi
# (korzysta z kol, kol_wsk, motyw i obiektu ank z przepisu 1 – bez nowego losowania)
library(ggplot2)
library(patchwork)

dl <- rbind(data.frame(wsk = "CSAT", ocena = ank$csat, odszedl = ank$odszedl_6m),
            data.frame(wsk = "CES", ocena = ank$ces, odszedl = ank$odszedl_6m),
            data.frame(wsk = "NPS", ocena = ank$nps, odszedl = ank$odszedl_6m))
tab <- do.call(rbind, lapply(split(dl, list(dl$wsk, dl$ocena), drop = TRUE), function(d) {
  ci <- prop.test(sum(d$odszedl), nrow(d), correct = FALSE)$conf.int
  data.frame(wsk = d$wsk[1], ocena = d$ocena[1], n = nrow(d), odsetek_odpowiedzi = 100 * nrow(d) / nrow(ank),
             odejscia = 100 * mean(d$odszedl), dolna = 100 * ci[1], gorna = 100 * ci[2])
}))
tab$wsk <- factor(tab$wsk, levels = c("CSAT", "CES", "NPS"))
tab <- tab[order(tab$wsk, tab$ocena), ]
print(transform(tab, odsetek_odpowiedzi = round(odsetek_odpowiedzi, 1), odejscia = round(odejscia, 1),
                dolna = round(dolna, 1), gorna = round(gorna, 1)), row.names = FALSE)

# Odejścia w kategoriach NPS (krytycy 0–6, bierni 7–8, promotorzy 9–10)
kat <- cut(ank$nps, c(-1, 6, 8, 10), labels = c("krytycy 0–6", "bierni 7–8", "promotorzy 9–10"))
print(round(100 * tapply(ank$odszedl_6m, kat, mean), 1))

# Wiersz rysunku dla jednego wskaźnika: lewy panel – rozkład odpowiedzi, prawy – odejścia przy każdej odpowiedzi
wiersz <- function(w, etykieta_osi) {
  d <- subset(tab, wsk == w)
  pa <- ggplot(d, aes(factor(ocena), odsetek_odpowiedzi)) +
    geom_col(fill = kol_wsk[[w]], width = 0.75) +
    labs(title = paste0(w, ": rozkład odpowiedzi"), x = etykieta_osi, y = "% odpowiedzi") + motyw
  pb <- ggplot(d, aes(factor(ocena), odejscia)) +
    geom_hline(yintercept = 100 * mean(ank$odszedl_6m), colour = "grey60", linetype = "dashed") +
    geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.25, colour = kol_wsk[[w]]) +
    geom_point(size = 2.6, colour = kol_wsk[[w]], shape = 16) +
    coord_cartesian(ylim = c(0, 45)) +
    labs(title = paste0(w, ": odeszło w 6 mies."), x = etykieta_osi, y = "% (95% CI)") + motyw
  pa + pb
}
p2 <- wiersz("CSAT", "ocena 1–5") / wiersz("CES", "ocena 1–7") / wiersz("NPS", "ocena 0–10")
p2                       # do pliku: ggsave("csat-ces-nps-rozklady.svg", p2, width = 10, height = 9.6)
Wynik w R
  wsk ocena    n odsetek_odpowiedzi odejscia dolna gorna
 CSAT     1  198                5.5     20.2  15.2  26.3
 CSAT     2  463               12.8     17.3  14.1  21.0
 CSAT     3  791               21.9     14.4  12.1  17.0
 CSAT     4 1169               32.3     10.8   9.1  12.7
 CSAT     5  996               27.5      8.2   6.7  10.1
  CES     1   77                2.1     29.9  20.8  40.8
  CES     2  196                5.4     26.0  20.4  32.6
  CES     3  360               10.0     17.8  14.2  22.1
  CES     4  583               16.1     14.6  11.9  17.7
  CES     5  731               20.2     12.6  10.4  15.2
  CES     6  819               22.6      8.7   6.9  10.8
  CES     7  851               23.5      6.6   5.1   8.4
  NPS     0    6                0.2     50.0  18.8  81.2
  NPS     1   17                0.5     35.3  17.3  58.7
  NPS     2   40                1.1     32.5  20.1  48.0
  NPS     3  102                2.8     26.5  18.9  35.8
  NPS     4  187                5.2     25.1  19.5  31.8
  NPS     5  353                9.8     17.6  13.9  21.9
  NPS     6  524               14.5     14.7  11.9  18.0
  NPS     7  615               17.0     11.4   9.1  14.1
  NPS     8  581               16.1     10.7   8.4  13.4
  NPS     9  536               14.8      6.7   4.9   9.2
  NPS    10  656               18.1      5.9   4.4   8.0
    krytycy 0–6      bierni 7–8 promotorzy 9–10
           19.1            11.0             6.3
3. Krzywe ROC, AUC i test DeLonga: Rysunek 3
R
# Rysunek 3. Krzywe ROC trzech wskaźników, AUC z 95% CI i porównanie testem DeLonga
# (korzysta z kol_wsk, motyw i obiektu ank z przepisu 1 – bez nowego losowania)
library(ggplot2)
library(patchwork)
library(pROC)

# Niższa ocena = większe ryzyko odejścia, stąd direction = ">" (u odchodzących oceny są niższe)
roc_w <- lapply(c(CSAT = "csat", CES = "ces", NPS = "nps"), function(v)
  roc(ank$odszedl_6m, ank[[v]], levels = c(0, 1), direction = ">", quiet = TRUE))
auc_tab <- do.call(rbind, lapply(names(roc_w), function(w) {
  ci <- ci.auc(roc_w[[w]], method = "delong")
  data.frame(wsk = w, AUC = ci[2], dolna = ci[1], gorna = ci[3])
}))
print(transform(auc_tab, AUC = round(AUC, 3), dolna = round(dolna, 3), gorna = round(gorna, 3)), row.names = FALSE)

# Test DeLonga dla par skorelowanych krzywych (te same osoby), różnica AUC z 95% CI
pary <- list(c("CES", "CSAT"), c("NPS", "CSAT"), c("NPS", "CES"))
del <- do.call(rbind, lapply(pary, function(pr) {
  t <- roc.test(roc_w[[pr[1]]], roc_w[[pr[2]]], method = "delong", paired = TRUE)
  data.frame(para = paste(pr[1], "−", pr[2]), roznica = unname(diff(rev(t$estimate))),
             dolna = t$conf.int[1], gorna = t$conf.int[2], z = unname(t$statistic), p = t$p.value)
}))
print(transform(del, roznica = round(roznica, 3), dolna = round(dolna, 3), gorna = round(gorna, 3),
                z = round(z, 2), p = round(p, 4)), row.names = FALSE)

# Punkty krzywych do wykresu
kr <- do.call(rbind, lapply(names(roc_w), function(w) {
  r <- roc_w[[w]]
  d <- data.frame(wsk = w, fpr = 1 - r$specificities, tpr = r$sensitivities)
  d[order(d$fpr, d$tpr), ]
}))
auc_tab$etykieta <- sprintf("%s: AUC = %.3f [%.3f, %.3f]", auc_tab$wsk, auc_tab$AUC, auc_tab$dolna, auc_tab$gorna)
auc_tab$etykieta <- gsub("(^|[^0-9])0\\.", "\\1.", auc_tab$etykieta)      # APA: bez zera przed kropką
kr$wsk <- factor(kr$wsk, levels = c("CSAT", "CES", "NPS"), labels = auc_tab$etykieta[match(c("CSAT", "CES", "NPS"), auc_tab$wsk)])
pA <- ggplot(kr, aes(fpr, tpr, colour = wsk, linetype = wsk, shape = wsk)) +
  geom_abline(colour = "grey60", linetype = "dotted") +
  geom_path(linewidth = 1) + geom_point(size = 2.2) +
  scale_colour_manual(values = unname(kol_wsk), name = NULL) +
  scale_linetype_manual(values = c("dotdash", "solid", "longdash"), name = NULL) +
  scale_shape_manual(values = c(15, 16, 17), name = NULL) +
  coord_equal() +
  labs(title = "A. Krzywe ROC", subtitle = "punkty = kolejne progi skali (odcinki łączą progi)",
       x = "1 − swoistość (zostający uznani za ryzyko)", y = "Czułość (odchodzący wykryci)") +
  motyw + guides(colour = guide_legend(ncol = 1))
del$para <- factor(del$para, levels = rev(del$para))
zapis_p <- function(p) ifelse(p < .001, "p < .001", paste("p =", sub("^0", "", formatC(p, format = "f", digits = 3))))
del$etykieta <- gsub("(^|[^0-9])0\\.", "\\1.", sprintf("%+.3f, %s", del$roznica, zapis_p(del$p)))
pB <- ggplot(del, aes(roznica, para)) +
  geom_vline(xintercept = 0, colour = "grey50") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = "#0f1d3a") +
  geom_point(size = 3, colour = "#0f1d3a") +
  geom_text(aes(label = etykieta), vjust = -1.1, size = 3.5, colour = "#0f1d3a") +
  scale_x_continuous(limits = c(-0.05, 0.11)) +
  labs(title = "B. Różnica AUC", subtitle = "test DeLonga, 95% CI", x = "Różnica AUC", y = NULL) + motyw
p3 <- pA + pB + plot_layout(widths = c(1.35, 1))
p3                       # do pliku: ggsave("csat-ces-nps-krzywe-roc.svg", p3, width = 10, height = 6.4)
Wynik w R
  wsk   AUC dolna gorna
 CSAT 0.591 0.564 0.619
  CES 0.636 0.608 0.663
  NPS 0.650 0.623 0.678
       para roznica  dolna gorna    z      p
 CES − CSAT   0.044  0.013 0.076 2.78 0.0054
 NPS − CSAT   0.059  0.028 0.091 3.67 0.0002
  NPS − CES   0.015 -0.018 0.047 0.89 0.3720
4. Kalibracja przewidywań poza próbą: Rysunek 4
R
# Rysunek 4. Kalibracja: czy przewidywane ryzyko odejścia zgadza się z odsetkiem odejść?
# (korzysta z kol, motyw i obiektu ank z przepisu 1; losuje tylko podział na 10 części)
library(ggplot2)

ank$powod <- factor(ank$powod)
modele <- list("CSAT" = odszedl_6m ~ csat, "CES" = odszedl_6m ~ ces, "NPS" = odszedl_6m ~ nps,
               "CSAT + CES + NPS + powód" = odszedl_6m ~ csat + ces + nps + powod)

# Przewidywania poza próbą: 10-krotna walidacja krzyżowa (każdy klient oceniony modelem, który go nie widział)
set.seed(7074)
czesc <- sample(rep(1:10, length.out = nrow(ank)))
przew <- sapply(modele, function(f) {
  p <- numeric(nrow(ank))
  for (k in 1:10) {
    m <- glm(f, family = binomial, data = ank[czesc != k, ])
    p[czesc == k] <- predict(m, newdata = ank[czesc == k, ], type = "response")
  }
  p
})
y <- ank$odszedl_6m
miary <- do.call(rbind, lapply(colnames(przew), function(m) {
  p <- przew[, m]
  nach <- coef(glm(y ~ qlogis(p), family = binomial))[2]                 # nachylenie kalibracji (ideał 1)
  data.frame(model = m, brier = mean((p - y)^2), brier_bez_modelu = mean((mean(y) - y)^2),
             nachylenie = unname(nach), min_p = min(p), max_p = max(p))
}))
print(transform(miary, brier = round(brier, 4), brier_bez_modelu = round(brier_bez_modelu, 4),
                nachylenie = round(nachylenie, 2), min_p = round(min_p, 3), max_p = round(max_p, 3)), row.names = FALSE)

# Grupy po 10% klientów według przewidywanego ryzyka: średnie ryzyko vs odsetek odejść (95% CI Wilsona)
kal <- do.call(rbind, lapply(colnames(przew), function(m) {
  p <- przew[, m]
  g <- ceiling(10 * rank(p, ties.method = "first") / length(p))
  do.call(rbind, lapply(split(seq_along(p), g), function(i) {
    ci <- prop.test(sum(y[i]), length(i), correct = FALSE)$conf.int
    data.frame(model = m, przewidywane = 100 * mean(p[i]), obserwowane = 100 * mean(y[i]),
               dolna = 100 * ci[1], gorna = 100 * ci[2])
  }))
}))
kal$model <- factor(kal$model, levels = names(modele))
print(subset(transform(kal, przewidywane = round(przewidywane, 1), obserwowane = round(obserwowane, 1)),
             select = c(model, przewidywane, obserwowane))[c(1, 10, 11, 20, 21, 30, 31, 40), ], row.names = FALSE)

miary$model <- factor(miary$model, levels = names(modele))
miary$tekst <- sprintf("Brier = %s\nnachylenie = %.2f", sub("^0", "", sprintf("%.4f", miary$brier)), miary$nachylenie)
p4 <- ggplot(kal, aes(przewidywane, obserwowane)) +
  geom_abline(colour = "grey60", linetype = "dashed") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0, colour = kol[["blekit"]], linewidth = 0.8) +
  geom_line(colour = kol[["niebieski"]]) +
  geom_point(size = 2.4, colour = kol[["niebieski"]]) +
  geom_text(data = miary, aes(x = 2, y = 44, label = tekst), hjust = 0, vjust = 1, size = 3.5,
            colour = "#0f1d3a", lineheight = 0.95) +
  facet_wrap(~ model, ncol = 2) +
  coord_equal(xlim = c(0, 45), ylim = c(0, 45)) +
  labs(title = "Kalibracja (10-krotna walidacja krzyżowa)",
       subtitle = "Punkty: dziesięć grup po ok. 360 klientów; linia przerywana = idealna zgodność",
       x = "Przewidywane ryzyko odejścia (%)", y = "Odeszło (%; 95% CI)") + motyw
p4                       # do pliku: ggsave("csat-ces-nps-kalibracja.svg", p4, width = 10, height = 9)
Wynik w R
                    model  brier brier_bez_modelu nachylenie min_p max_p
                     CSAT 0.1061           0.1073       0.97 0.082 0.219
                      CES 0.1043           0.1073       0.98 0.064 0.313
                      NPS 0.1036           0.1073       0.97 0.054 0.478
 CSAT + CES + NPS + powód 0.1015           0.1073       0.95 0.030 0.577
                    model przewidywane obserwowane
                     CSAT          8.3         9.4
                     CSAT         19.7        17.1
                      CES          6.5         7.2
                      CES         24.4        24.3
                      NPS          5.7         8.3
                      NPS         26.1        26.8
 CSAT + CES + NPS + powód          4.0         4.4
 CSAT + CES + NPS + powód         30.0        30.4
5. Wskaźniki razem i osobno, AUC według powodu kontaktu: Rysunek 5
R
# Rysunek 5. Czy trzy wskaźniki razem przewidują lepiej niż osobno? AUC poza próbą i AUC według powodu kontaktu
# (korzysta z kol, kol_wsk, motyw i obiektu ank z przepisu 1; losuje podziały walidacji krzyżowej)
library(ggplot2)
library(patchwork)
library(pROC)

ank$powod <- factor(ank$powod)
modele <- list("CSAT" = odszedl_6m ~ csat, "CES" = odszedl_6m ~ ces, "NPS" = odszedl_6m ~ nps,
               "CES + NPS" = odszedl_6m ~ ces + nps, "CSAT + CES + NPS" = odszedl_6m ~ csat + ces + nps,
               "CSAT + CES + NPS\n+ powód kontaktu" = odszedl_6m ~ csat + ces + nps + powod)
auc_cv <- function(f, czesc) {
  p <- numeric(nrow(ank))
  for (k in 1:10) {
    m <- glm(f, family = binomial, data = ank[czesc != k, ])
    p[czesc == k] <- predict(m, newdata = ank[czesc == k, ], type = "response")
  }
  list(auc = as.numeric(auc(roc(ank$odszedl_6m, p, levels = c(0, 1), direction = "<", quiet = TRUE))), p = p)
}

# 20 powtórzeń 10-krotnej walidacji krzyżowej (każde z innym losowym podziałem)
set.seed(7075)
R <- 20
wyn <- matrix(NA, R, length(modele), dimnames = list(NULL, names(modele)))
oof1 <- NULL
for (r in 1:R) {
  czesc <- sample(rep(1:10, length.out = nrow(ank)))
  res <- lapply(modele, auc_cv, czesc = czesc)
  wyn[r, ] <- sapply(res, `[[`, "auc")
  if (r == 1) oof1 <- sapply(res, `[[`, "p")
}
cv <- data.frame(model = names(modele), AUC = colMeans(wyn), min = apply(wyn, 2, min), max = apply(wyn, 2, max))
print(transform(cv, model = gsub("\n", " ", model), AUC = round(AUC, 3), min = round(min, 3), max = round(max, 3)),
      row.names = FALSE)
przyrost <- wyn[, "CSAT + CES + NPS"] - wyn[, "NPS"]
cat(sprintf("Przyrost AUC: trzy wskaźniki vs sam NPS = %.3f (zakres w 20 powtórzeniach %.3f–%.3f)\n",
            mean(przyrost), min(przyrost), max(przyrost)))
cat(sprintf("Przyrost AUC: + powód kontaktu vs trzy wskaźniki = %.3f\n",
            mean(wyn[, 6] - wyn[, "CSAT + CES + NPS"])))
# Przybliżony test DeLonga na przewidywaniach poza próbą z pierwszego powtórzenia
t <- roc.test(roc(ank$odszedl_6m, oof1[, "CSAT + CES + NPS"], levels = c(0, 1), direction = "<", quiet = TRUE),
              roc(ank$odszedl_6m, oof1[, "NPS"], levels = c(0, 1), direction = "<", quiet = TRUE), method = "delong")
cat(sprintf("DeLong (1. powtórzenie): trzy wskaźniki vs NPS, z = %.2f, p = %s\n", t$statistic,
            sub("^0", "", sprintf("%.5f", t$p.value))))
m_pelny <- glm(odszedl_6m ~ csat + ces + nps + powod, family = binomial, data = ank)
print(round(cbind(OR = exp(coef(m_pelny)), exp(confint.default(m_pelny))), 2))

# AUC każdego wskaźnika osobno w czterech grupach powodu kontaktu (95% CI DeLonga)
grupy <- do.call(rbind, lapply(levels(ank$powod), function(g) {
  d <- ank[ank$powod == g, ]
  do.call(rbind, lapply(c(CSAT = "csat", CES = "ces", NPS = "nps"), function(v) {
    ci <- ci.auc(roc(d$odszedl_6m, d[[v]], levels = c(0, 1), direction = ">", quiet = TRUE), method = "delong")
    data.frame(powod = g, n = nrow(d), odejscia = sum(d$odszedl_6m), wsk = toupper(v),
               AUC = ci[2], dolna = ci[1], gorna = ci[3])
  }))
}))
print(transform(grupy, AUC = round(AUC, 3), dolna = round(dolna, 3), gorna = round(gorna, 3)), row.names = FALSE)
cat("Średnia ocena wg powodu (CSAT, CES, NPS) i odsetek odejść:\n")
print(round(cbind(aggregate(cbind(csat, ces, nps) ~ powod, data = ank, FUN = mean)[, -1],
                  odejscia_proc = 100 * tapply(ank$odszedl_6m, ank$powod, mean)), 2))

cv$model <- factor(cv$model, levels = rev(names(modele)))
pA <- ggplot(cv, aes(AUC, model)) +
  geom_errorbar(aes(xmin = min, xmax = max), width = 0.25, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 3, colour = kol[["niebieski"]]) +
  geom_text(aes(label = sub("^0", "", sprintf("%.3f", AUC))), vjust = -1, size = 3.5, colour = "#0f1d3a") +
  scale_x_continuous(limits = c(0.57, 0.71)) +
  labs(title = "A. AUC poza próbą", subtitle = "średnia i zakres z 20 × 10-krotnej\nwalidacji krzyżowej",
       x = "AUC", y = NULL) + motyw
grupy$wsk <- factor(grupy$wsk, levels = c("CSAT", "CES", "NPS"))
grupy$powod <- factor(grupy$powod, levels = rev(levels(ank$powod)))
pB <- ggplot(grupy, aes(AUC, powod, colour = wsk, shape = wsk)) +
  geom_vline(xintercept = 0.5, colour = "grey60", linetype = "dotted") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y",
                position = position_dodge(width = 0.6)) +
  geom_point(size = 2.6, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = kol_wsk, name = NULL) + scale_shape_manual(values = c(15, 16, 17), name = NULL) +
  labs(title = "B. AUC w grupach powodu", subtitle = "każdy wskaźnik osobno, 95% CI", x = "AUC", y = NULL) + motyw
p5 <- pA + pB + plot_layout(widths = c(1, 1))
p5                       # do pliku: ggsave("csat-ces-nps-razem-i-powod.svg", p5, width = 10, height = 6.4)
Wynik w R
                             model   AUC   min   max
                              CSAT 0.580 0.574 0.587
                               CES 0.627 0.624 0.629
                               NPS 0.644 0.640 0.648
                         CES + NPS 0.668 0.667 0.670
                  CSAT + CES + NPS 0.671 0.669 0.672
 CSAT + CES + NPS + powód kontaktu 0.676 0.673 0.678
Przyrost AUC: trzy wskaźniki vs sam NPS = 0.027 (zakres w 20 powtórzeniach 0.024–0.030)
Przyrost AUC: + powód kontaktu vs trzy wskaźniki = 0.005
DeLong (1. powtórzenie): trzy wskaźniki vs NPS, z = 3.75, p = .00018
                      OR 2.5 % 97.5 %
(Intercept)         1.85  1.23   2.78
csat                0.97  0.88   1.06
ces                 0.84  0.78   0.90
nps                 0.82  0.78   0.87
powodfaktura        0.86  0.65   1.13
powodrouter i Wi-Fi 0.65  0.49   0.85
powodzmiana pakietu 0.52  0.38   0.73
          powod    n odejscia  wsk   AUC dolna gorna
         awaria  880      158 CSAT 0.586 0.538 0.635
         awaria  880      158  CES 0.668 0.625 0.711
         awaria  880      158  NPS 0.667 0.621 0.714
        faktura  829      112 CSAT 0.593 0.540 0.646
        faktura  829      112  CES 0.585 0.527 0.644
        faktura  829      112  NPS 0.663 0.607 0.718
 router i Wi-Fi 1142      113 CSAT 0.581 0.529 0.633
 router i Wi-Fi 1142      113  CES 0.602 0.550 0.655
 router i Wi-Fi 1142      113  NPS 0.598 0.543 0.653
 zmiana pakietu  766       59 CSAT 0.531 0.451 0.610
 zmiana pakietu  766       59  CES 0.571 0.491 0.651
 zmiana pakietu  766       59  NPS 0.630 0.561 0.700
Średnia ocena wg powodu (CSAT, CES, NPS) i odsetek odejść:
               csat  ces  nps odejscia_proc
awaria         3.30 4.53 6.84         17.95
faktura        3.66 5.00 7.33         13.51
router i Wi-Fi 3.77 5.25 7.47          9.89
zmiana pakietu 3.80 5.59 7.53          7.70
6. Wskaźnik miesięczny i brak odpowiedzi: Rysunek 6
R
# Rysunek 6. Wskaźnik miesięczny vs ocena klienta i kto odpowiada na ankietę
# (korzysta z kol, motyw oraz obiektów klienci, ank i powody z przepisu 1 – bez nowego losowania)
library(ggplot2)
library(patchwork)

# Miesięczny CSAT (% ocen 4–5): surowy i standaryzowany do rocznej struktury powodów kontaktu
udzial_rok <- prop.table(table(factor(ank$powod, levels = powody)))
mies <- do.call(rbind, lapply(split(ank, ank$miesiac), function(d) {
  top_pow <- tapply(d$csat >= 4, factor(d$powod, levels = powody), mean)
  data.frame(miesiac = d$miesiac[1], n = nrow(d), udzial_awarii = 100 * mean(d$powod == "awaria"),
             csat_surowy = 100 * mean(d$csat >= 4),
             dolna = 100 * prop.test(sum(d$csat >= 4), nrow(d), correct = FALSE)$conf.int[1],
             gorna = 100 * prop.test(sum(d$csat >= 4), nrow(d), correct = FALSE)$conf.int[2],
             csat_standaryzowany = 100 * sum(top_pow * udzial_rok),
             nps = 100 * (mean(d$nps >= 9) - mean(d$nps <= 6)), odejscia = 100 * mean(d$odszedl_6m))
}))
print(round(mies, 1), row.names = FALSE)
cat(sprintf("Korelacja miesięcznego NPS z odsetkiem odejść (12 miesięcy): r = %.2f, 95%% CI [%.2f, %.2f]\n",
            cor(mies$nps, mies$odejscia), cor.test(mies$nps, mies$odejscia)$conf.int[1],
            cor.test(mies$nps, mies$odejscia)$conf.int[2]))

# Kto odpowiada: odsetek odpowiedzi i odejścia u odpowiadających i milczących, wg powodu kontaktu
odp <- do.call(rbind, lapply(split(klienci, list(klienci$powod, klienci$odpowiedzial)), function(d)
  data.frame(powod = d$powod[1], grupa = ifelse(d$odpowiedzial[1] == 1, "odpowiedzieli", "nie odpowiedzieli"),
             n = nrow(d), odejscia = 100 * mean(d$odszedl_6m))))
odp$odsetek_odpowiedzi <- 100 * tapply(klienci$odpowiedzial, klienci$powod, mean)[odp$powod]
print(transform(odp, odejscia = round(odejscia, 1), odsetek_odpowiedzi = round(odsetek_odpowiedzi, 1)), row.names = FALSE)

dl <- rbind(data.frame(miesiac = mies$miesiac, wartosc = mies$csat_surowy, co = "surowy"),
            data.frame(miesiac = mies$miesiac, wartosc = mies$csat_standaryzowany,
                       co = "przy rocznej strukturze powodów"))
dl$co <- factor(dl$co, levels = c("surowy", "przy rocznej strukturze powodów"))
pA <- ggplot(dl, aes(miesiac, wartosc, colour = co, shape = co, linetype = co)) +
  annotate("rect", xmin = 6.5, xmax = 7.5, ymin = -Inf, ymax = Inf, fill = "grey90") +
  annotate("text", x = 7, y = 68.5, label = sprintf("awaria sieci:\n%.0f%% kontaktów\nto awarie", mies$udzial_awarii[7]), size = 3.3, colour = "#0f1d3a",
           lineheight = 0.9) +
  geom_ribbon(data = mies, aes(x = miesiac, ymin = dolna, ymax = gorna), inherit.aes = FALSE,
              fill = kol[["blekit"]], alpha = 0.25) +
  geom_line(linewidth = 1) + geom_point(size = 2.4) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["pomaranczowy"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = 1:12) + coord_cartesian(ylim = c(48, 70)) +
  labs(title = "A. CSAT miesiąc po miesiącu", subtitle = "% ocen 4–5; pasmo = 95% CI surowego", x = "Miesiąc", y = "%") +
  motyw + guides(colour = guide_legend(ncol = 1))
odp$grupa <- factor(odp$grupa, levels = c("odpowiedzieli", "nie odpowiedzieli"))
pB <- ggplot(odp, aes(powod, odejscia, fill = grupa)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75) +
  geom_text(aes(label = sprintf("%.0f%%", odejscia)), position = position_dodge(width = 0.8), vjust = -0.4,
            size = 3.3, colour = "#0f1d3a") +
  scale_fill_manual(values = c(kol[["blekit"]], kol[["granat"]]), name = NULL) +
  scale_y_continuous(limits = c(0, 25)) +
  labs(title = "B. Odeszło w 6 mies.", subtitle = "odpowiadający i milczący", x = NULL, y = "%") +
  motyw + theme(axis.text.x = element_text(angle = 20, hjust = 1))
p6 <- pA + pB + plot_layout(widths = c(1.15, 1))
p6                       # do pliku: ggsave("csat-ces-nps-miesiac-i-brak-odpowiedzi.svg", p6, width = 10, height = 6)
Wynik w R
 miesiac   n udzial_awarii csat_surowy dolna gorna csat_standaryzowany  nps
       1 329          21.9        61.1  55.7  66.2                60.3 -2.7
       2 307          22.1        62.2  56.7  67.5                62.0 -4.2
       3 343          20.7        59.2  53.9  64.3                58.3  2.6
       4 307          23.8        61.2  55.7  66.5                61.2  0.7
       5 285          20.7        56.8  51.0  62.5                56.2 -6.3
       6 300          22.7        63.3  57.7  68.6                62.5  2.7
       7 315          52.4        56.8  51.3  62.2                58.5 -3.2
       8 295          20.0        58.3  52.6  63.8                57.3 -4.1
       9 287          22.6        58.9  53.1  64.4                58.7 -3.8
      10 277          18.8        56.7  50.8  62.4                55.1  1.1
      11 281          19.2        61.6  55.8  67.1                60.8  1.4
      12 291          25.4        61.9  56.2  67.2                62.5  3.4
 odejscia
     13.1
     13.4
     12.5
     11.4
     14.7
     11.3
     11.7
      9.5
     14.3
     10.1
     13.5
     11.0
Korelacja miesięcznego NPS z odsetkiem odejść (12 miesięcy): r = -0.42, 95% CI [-0.80, 0.21]
          powod             grupa    n odejscia odsetek_odpowiedzi
         awaria nie odpowiedzieli 1302     21.7               40.3
        faktura nie odpowiedzieli 1044     15.7               44.3
 router i Wi-Fi nie odpowiedzieli 1249     13.7               47.8
 zmiana pakietu nie odpowiedzieli  788      9.6               49.3
         awaria     odpowiedzieli  880     18.0               40.3
        faktura     odpowiedzieli  829     13.5               44.3
 router i Wi-Fi     odpowiedzieli 1142      9.9               47.8
 zmiana pakietu     odpowiedzieli  766      7.7               49.3
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("CES – NPS (niebieski – pomarańczowy)" = c("#0072B2", "#D55E00"),
             "CSAT – CES (zielony – niebieski)" = c("#009E73", "#0072B2"),
             "CSAT – NPS (zielony – pomarańczowy)" = c("#009E73", "#D55E00"),
             "odpowiadający – milczący (błękit – granat)" = c("#56B4E9", "#0f1d3a"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                           widzenie_typowe deuteranopia
CES – NPS (niebieski – pomarańczowy)                 114.6        108.3
CSAT – CES (zielony – niebieski)                      70.1         55.4
CSAT – NPS (zielony – pomarańczowy)                  102.4         53.5
odpowiadający – milczący (błękit – granat)            62.8         59.6
czerwony – zielony (do unikania)                     121.7         21.1
                                           protanopia
CES – NPS (niebieski – pomarańczowy)             91.9
CSAT – CES (zielony – niebieski)                 58.0
CSAT – NPS (zielony – pomarańczowy)              37.3
odpowiadający – milczący (błękit – granat)       61.8
czerwony – zielony (do unikania)                 31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie, regresję logistyczną (glm), przedziały Wilsona (prop.test) i korelacje wykonano pakietem stats (z podstawowej instalacji R). Krzywe ROC, przedziały AUC i test DeLonga policzono pakietem pROC. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pROC (wersja 1.19.0.1): Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J.-C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12, 77. https://doi.org/10.1186/1471-2105-12-77
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Porównywanie poziomów zamiast trafności. 66.4% CES i NPS −1.0 to liczby z różnych skal; porównuj AUC na tych samych klientach (rysunki 1 i 3).
- Zwykły test różnicy dwóch AUC zamiast testu DeLonga. Oceny pochodzą od tych samych osób, więc pola pod krzywymi są skorelowane (rysunek 3).
- AUC bez kalibracji. Model może dobrze porządkować klientów, a źle podawać ryzyko – albo odwrotnie (rysunek 4).
- Przyrost AUC liczony na tych samych danych, na których dopasowano model. Licz go poza próbą (rysunek 5).
- Pominięcie powodu kontaktu. Awaria obniża oceny i podnosi odejścia; ranking wskaźników zmienia się między powodami (rysunki 5B i 6A).
- Wniosek o wszystkich klientach z ankiety. Odpowiada mniej niż połowa, a milczący odchodzą częściej (rysunek 6B).
Najczęstsze pytania
Który wskaźnik lepiej przewiduje odejście klienta: CSAT, CES czy NPS?
Nie ma jednej odpowiedzi – trzeba to sprawdzić na własnych danych, porównując AUC na tych samych klientach testem DeLonga. W fikcyjnym przykładzie dostawcy światłowodu NPS (AUC = .650) i CES (.636) nie różniły się istotnie, a oba były lepsze od CSAT (.591), który mierzył głównie wrażenie z rozmowy z konsultantem.
Jak porównać AUC dwóch wskaźników zebranych od tych samych osób?
Testem DeLonga dla skorelowanych krzywych ROC, np. funkcją roc.test() w pakiecie pROC. Zwykłe porównanie dwóch niezależnych AUC pomija to, że oceny pochodzą od tych samych klientów, i daje błędne przedziały. Raportuj różnicę AUC z 95% przedziałem ufności i wartość p.
Czy warto łączyć CSAT, CES i NPS w jednym modelu?
Często tak, bo mierzą różne rzeczy. W przykładzie CES i NPS razem dały AUC poza próbą .668 wobec .644 dla samego NPS, a CSAT dodał już tylko .003. Przyrost licz w walidacji krzyżowej, a nie na danych, na których dopasowano model.
Dlaczego miesięczny NPS nie pokazuje, kto odejdzie?
Bo to inne pytanie. Wskaźnik miesięczny opisuje obsługę w danym miesiącu i zmienia się razem ze strukturą powodów kontaktu (np. przy awarii sieci) oraz z losowym szumem – przy 300 ankietach miesięcznie przedział CSAT ma szerokość około 11 punktów. Do przewidywania odejść potrzebne są oceny poszczególnych klientów.
Co z klientami, którzy nie odpowiadają na ankietę?
Model oparty na ankiecie ich nie widzi, a często odchodzą częściej: w przykładzie 15.8% wobec 12.2% u odpowiadających. Opisz to jako ograniczenie, a do przewidywania ryzyka w całej bazie dołącz dane z CRM, które są znane dla wszystkich klientów.
Powiązane hasła
Przeczytaj też
NPS – przedział ufności i porównania
Przedział ufności NPS ze wzoru i bootstrapu, liczba ankiet do wykrycia zmiany i porównanie dwóch NPS na przykładzie salonów optycznych – z kodem R.
Czytaj →PoradnikModel odejść klientów i kampania retencyjna
Operator komórkowy, 10 000 abonentów: regresja i las losowy, gain i lift, kalibracja, macierz decyzji, krzywa zysku i przeciek danych – pięć rysunków z kodem R.
Czytaj →PoradnikAnkieta po zakupie i brak odpowiedzi
Odpowiada 12% klientów sklepu z materacami: model odpowiedzi z CRM, wagi IPW, kalibracja, efekt schematu i symulacja MAR/MNAR – z kodem R.
Czytaj →PoradnikChurn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →Porównujesz wskaźniki satysfakcji w pracy z marketingu?
Pomożemy połączyć ankietę z danymi o odejściach, policzyć krzywe ROC, test DeLonga i kalibrację oraz opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Groves, R. M. (2006). Nonresponse rates and nonresponse bias in household surveys. Public Opinion Quarterly, 70(5), 646–675. https://doi.org/10.1093/poq/nfl033
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Keiningham, T. L., Cooil, B., Aksoy, L., Andreassen, T. W., & Weiner, J. (2007). The value of different customer satisfaction and loyalty metrics in predicting customer retention, recommendation, and share-of-wallet. Managing Service Quality: An International Journal, 17(4), 361–384. https://doi.org/10.1108/09604520710760526
- Morgan, N. A., & Rego, L. L. (2006). The value of different customer satisfaction and loyalty metrics in predicting business performance. Marketing Science, 25(5), 426–439. https://doi.org/10.1287/mksc.1050.0180
- Pencina, M. J., D'Agostino, R. B., Sr., D'Agostino, R. B., Jr., & Vasan, R. S. (2008). Evaluating the added predictive ability of a new marker: From area under the ROC curve to reclassification and beyond. Statistics in Medicine, 27(2), 157–172. https://doi.org/10.1002/sim.2929 ● Otwarty dostęp
- Steyerberg, E. W., Vickers, A. J., Cook, N. R., Gerds, T., Gonen, M., Obuchowski, N., Pencina, M. J., & Kattan, M. W. (2010). Assessing the performance of prediction models: A framework for traditional and novel measures. Epidemiology, 21(1), 128–138. https://doi.org/10.1097/ede.0b013e3181c30fb2 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{delong1988comparing, author={DeLong, Elizabeth R. and DeLong, David M. and Clarke-Pearson, Daniel L.}, title={{Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach}}, journal={Biometrics}, year={1988}, volume={44}, number={3}, pages={837--845}, doi={10.2307/2531595}}@article{groves2006nonresponse, author={Groves, Robert M.}, title={{Nonresponse rates and nonresponse bias in household surveys}}, journal={Public Opinion Quarterly}, year={2006}, volume={70}, number={5}, pages={646--675}, doi={10.1093/poq/nfl033}}@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@article{keiningham2007value, author={Keiningham, Timothy L. and Cooil, Bruce and Aksoy, Lerzan and Andreassen, Tor W. and Weiner, Jay}, title={{The value of different customer satisfaction and loyalty metrics in predicting customer retention, recommendation, and share-of-wallet}}, journal={Managing Service Quality: An International Journal}, year={2007}, volume={17}, number={4}, pages={361--384}, doi={10.1108/09604520710760526}}@article{morgan2006value, author={Morgan, Neil A. and Rego, Lopo Leotte}, title={{The value of different customer satisfaction and loyalty metrics in predicting business performance}}, journal={Marketing Science}, year={2006}, volume={25}, number={5}, pages={426--439}, doi={10.1287/mksc.1050.0180}}@article{pencina2008evaluating, author={Pencina, Michael J. and D'Agostino, Sr., Ralph B. and D'Agostino, Jr., Ralph B. and Vasan, Ramachandran S.}, title={{Evaluating the added predictive ability of a new marker: From area under the ROC curve to reclassification and beyond}}, journal={Statistics in Medicine}, year={2008}, volume={27}, number={2}, pages={157--172}, doi={10.1002/sim.2929}}@article{steyerberg2010assessing, author={Steyerberg, Ewout W. and Vickers, Andrew J. and Cook, Nancy R. and Gerds, Thomas and Gonen, Mithat and Obuchowski, Nancy and Pencina, Michael J. and Kattan, Michael W.}, title={{Assessing the performance of prediction models: A framework for traditional and novel measures}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={128--138}, doi={10.1097/ede.0b013e3181c30fb2}}