Sześć typowych projektów w pracy z marketingu
Część empiryczna pracy z marketingu ma zwykle jedną z dwóch postaci. Najczęściej jest to ankieta konsumencka: pytasz o postawy wobec marki, gotowość polecenia, wrażliwość na cenę i zamiar zakupu. Coraz częściej jest to też eksperyment: losowo pokazujesz dwie wersje oferty, opakowania albo strony sklepu i porównujesz reakcje. Te dwie postaci wymagają innych analiz i dają wnioski o innej sile. Ankieta opisuje związki, a dobrze zaprojektowany eksperyment pozwala mówić o wpływie. Tabela porządkuje sześć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Skala postaw wobec marki | Czy klienci oceniają markę lepiej niż osoby, które jej nie kupują? | 4 pozycje 1–7, wynik skali | α i ω, jednoczynnikowa CFA, test t Welcha | g Hedgesa z 95% CI |
| 2. NPS | Czy klienci kupujący przez internet chętniej polecają markę? | pytanie 0–10 | NPS z 95% CI, test Manna–Whitneya na pełnej skali | różnica NPS w punktach, korelacja rangowo-dwuseryjna |
| 3. Test A/B ceny | Czy sposób podania rabatu zmienia odsetek zakupów? | zakup tak/nie w dwóch wersjach strony | test dla dwóch proporcji | różnica proporcji z CI Newcombe’a, RR, OR, h Cohena |
| 4. Intencja zakupu | Co wiąże się z zamiarem kupienia produktu? | wyniki skal 1–7 i zmienne demograficzne | regresja wieloraka | b z 95% CI, β, R² |
| 5. Mediacja w eksperymencie | Czy etykieta ekologiczna działa przez zaufanie do produktu? | grupa losowa, mediator i wynik 1–7 | model mediacji z bootstrapem | efekt pośredni ab z 95% CI |
| 6. Segmentacja | Jakie grupy konsumentów różnią się poszukiwanymi korzyściami? | ważność 4 korzyści | analiza skupień k-średnich | wskaźnik sylwetki, opis profili |
Wszystkie dane w przykładach są symulowane, a „marka A” jest fikcyjna. Możesz je pobrać jako plik XLSX (ankieta, test A/B i eksperyment w osobnych arkuszach) i powtórzyć analizy w swoim programie. Jeśli Twoja praca dotyczy raczej pracowników i organizacji niż konsumentów albo opiera się na danych finansowych firm, zajrzyj do poradnika statystyka w pracy z zarządzania i ekonomii. Ogólny plan części empirycznej, od hipotez po rozdział wyników, znajdziesz w przewodniku statystyka w pracy dyplomowej.
Zanim zaczniesz: próba, pomiar i hipotezy
Najpierw zdecyduj, czy to ankieta, czy eksperyment. W ankiecie nie kontrolujesz, kto jest klientem marki, kto widział reklamę i kto jest wrażliwy na cenę. Wyniki opisujesz więc jako związki: „osoby o lepszej postawie wobec marki deklarowały wyższą intencję zakupu”. W eksperymencie to Ty decydujesz, kto zobaczy którą wersję, i robisz to losowo. Wtedy różnicę między grupami możesz przypisać samej wersji. Wybór schematu, kontrolę manipulacji i pułapki ankiet internetowych opisujemy w przewodniku ankiety i eksperymenty.
Opisz próbę uczciwie. Ankieta udostępniona w mediach społecznościowych albo wśród znajomych to próba dobrana wygodnie. Odpowiadają osoby zainteresowane tematem i podobne do autora, więc odsetki opisują badaną grupę, a nie „polskich konsumentów” (zob. reprezentatywność próby). Przy takiej próbie bezpieczniej jest wnioskować o związkach między zmiennymi niż o poziomie zjawiska w populacji. Jak przygotować pytania, opisujemy w poradniku jak zrobić ankietę do pracy dyplomowej, a jak wychwycić osoby klikające bez czytania – w poradniku o nieuważnych odpowiedziach w ankietach online.
Mierz konstrukty kilkoma pozycjami. Postawa wobec marki, postrzegana wartość czy intencja zakupu to konstrukty, których nie da się dobrze zmierzyć jednym pytaniem. Churchill (1979) uznał budowę lepszych miar zmiennych marketingowych za warunek rozwoju wiedzy i praktyki marketingu i zaproponował procedurę ich tworzenia. W pracy dyplomowej najprościej sięgnąć po skalę już opublikowaną i opisać jej źródło. Jeśli budujesz własną, potraktuj ją jak narzędzie, które musi przejść sprawdzenie rzetelności i struktury.
Uważaj na style odpowiadania i wspólną metodę. Baumgartner i Steenkamp (2001) zbadali konsumentów z 11 krajów Unii Europejskiej i wykazali, że style odpowiadania, takie jak tendencja do zgadzania się czy wybieranie odpowiedzi skrajnych, systematycznie zniekształcają wyniki skal i mogą zawyżać albo zaniżać korelacje między nimi. Gdy wszystkie skale pochodzą z jednej ankiety wypełnionej przez te same osoby, część korelacji może wynikać z samego sposobu pomiaru. Podsakoff i in. (2003) opisują źródła tego zjawiska oraz proceduralne i statystyczne sposoby jego kontroli (zob. wspólna wariancja metody). W praktyce zapewnij anonimowość, oddziel skale predyktorów od skali wyniku i opisz to ograniczenie w dyskusji.
Dobierz test do pytania, zanim zbierzesz dane. Hipotezy i analizy zapisz w planie pracy. Jeśli nie wiesz, który test pasuje do Twoich zmiennych, skorzystaj z kreatora doboru testu statystycznego. Liczebność próby dla porównania grup, tabeli 2 × 2 albo regresji policzysz w kalkulatorze mocy i liczebności.
Projekt 1. Skala postaw wobec marki
Przykład: 360 konsumentów kategorii produktu oceniło markę A na czterech skalach od 1 do 7 (np. „zła – dobra”, „nieatrakcyjna – atrakcyjna”). 200 osób kupuje markę A (klienci), a 160 jej nie kupuje. Pytanie brzmi: czy klienci oceniają markę lepiej i jak duża jest ta różnica?
Rzetelność i struktura skali
Zanim policzysz wynik skali jako średnią z pozycji, pokaż, że pozycje mierzą jedno. Współczynnik alfa Cronbacha wyniósł α = .84, a średnia korelacja między pozycjami .57. Jednoczynnikowa konfirmacyjna analiza czynnikowa dała ładunki standaryzowane od .68 do .83 i omegę McDonalda ω = .84. Model z czterema pozycjami ma tylko dwa stopnie swobody, więc niemal idealne dopasowanie (CFI = 1.000, SRMR = .009) niewiele tu dowodzi. Ważniejsze są wysokie i zbliżone ładunki. Gdy skala ma więcej pozycji albo kilka wymiarów, pełną procedurę znajdziesz w poradniku analiza czynnikowa EFA i CFA.
Porównanie klientów i nieklientów
Klienci oceniali markę wyżej (M = 4.53, SD = 1.00) niż osoby, które jej nie kupują (M = 3.93, SD = 0.97). Grupy mają różną liczebność, więc bezpieczniejszy jest test t Welcha, który nie zakłada równych wariancji. Różnica wyniosła 0.60 punktu, 95% CI [0.40, 0.81], t(345.97) = 5.80, p < .001. Wielkość efektu podaj jako g Hedgesa: g = 0.61, 95% CI [0.40, 0.82]. Wynik skali to średnia z czterech pozycji, więc ma wiele możliwych wartości i można go analizować testem parametrycznym. Pojedynczą pozycję lepiej opisywać rozkładem odpowiedzi (zob. czy skala Likerta jest ilościowa).
Pamiętaj, że to porównanie nie mówi, co jest przyczyną, a co skutkiem. Lepsza postawa mogła skłonić do zakupu, ale zakup i doświadczenie z produktem mogły też poprawić postawę. W pracy napisz więc, że klienci oceniali markę wyżej, a nie że kupowanie marki poprawia jej ocenę.
Projekt 2. NPS – gotowość polecenia marki
Net Promoter Score wymaga jednego pytania: „Jak bardzo prawdopodobne jest, że polecisz markę znajomemu?” w skali od 0 do 10. Osoby z odpowiedziami 9–10 to promotorzy, 7–8 to pasywni, a 0–6 to krytycy. NPS to odsetek promotorów minus odsetek krytyków, więc przyjmuje wartości od −100 do 100. Wskaźnik jest popularny w firmach, dlatego studenci chętnie go używają. W pracy dyplomowej trzeba jednak pokazać jego niepewność i ograniczenia.
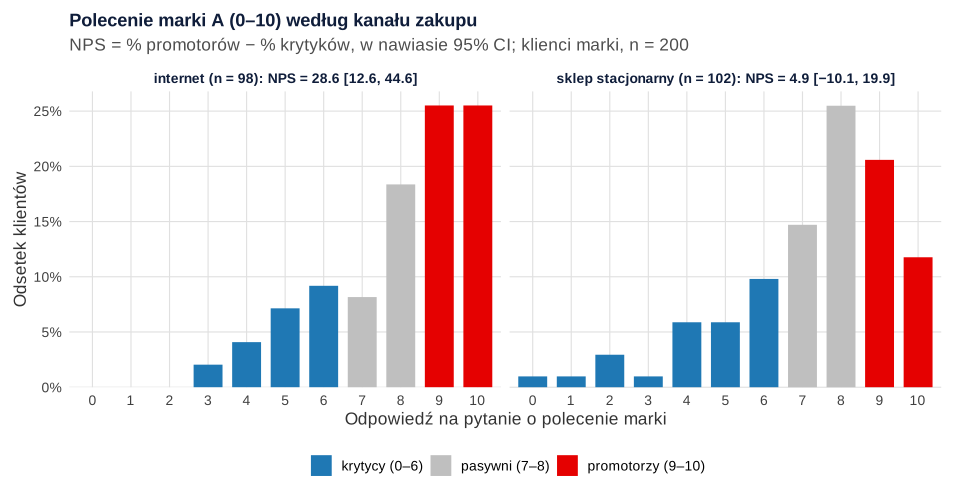
Przykład: 200 klientów marki A odpowiedziało na pytanie o polecenie i podało, gdzie zwykle kupuje markę (98 osób przez internet, 102 w sklepie stacjonarnym). W całej grupie promotorzy stanowili 41.5%, pasywni 33.5%, a krytycy 25.0%, więc NPS = 16.5.
Przedział ufności dla NPS
NPS jest różnicą dwóch odsetków z tej samej próby, więc jego błąd standardowy liczy się ze wzoru SE = 100 × √[(pP + pK − (pP − pK)²) / n], gdzie pP i pK to odsetki promotorów i krytyków zapisane jako ułamki. Dla całej grupy 95% CI wynosi [5.4, 27.6]. Przy 200 osobach przedział ma więc szerokość ponad 20 punktów. W kanale internetowym NPS = 28.6, 95% CI [12.6, 44.6], a w sklepie stacjonarnym NPS = 4.9, 95% CI [−10.1, 19.9]. Różnica wyniosła 23.7 punktu, 95% CI [1.8, 45.6], z = 2.12, p = .034. Dolna granica jest bliska zeru, więc dane są zgodne zarówno z bardzo małą, jak i z bardzo dużą przewagą internetu.
Analizuj też pełną skalę 0–10
NPS zamienia jedenaście możliwych odpowiedzi na trzy kategorie, a potem odrzuca pasywnych. Odpowiedź 6 liczy się tak samo jak 0, a 7 tak samo jak 8. Dlatego obok NPS opisz rozkład odpowiedzi i porównaj grupy na pełnej skali. Klienci internetowi wybierali wyższe wartości (M = 8.02, SD = 1.89, Me = 9) niż klienci sklepów stacjonarnych (M = 7.31, SD = 2.16, Me = 8). Odpowiedzi są skośne i porządkowe, więc użyj testu Manna–Whitneya: W = 6038.5, p = .010, korelacja rangowo-dwuseryjna r = .21, 95% CI [.05, .36]. Gotowość polecenia wiązała się też z postawą wobec marki, ρ Spearmana = .48, p < .001.
W dyskusji nie przedstawiaj NPS jako miary, która przewiduje wzrost firmy. Keiningham i in. (2007) na danych podłużnych z 21 firm nie potwierdzili, że ten wskaźnik jest wyraźnie lepszy od innych miar, np. satysfakcji. Dawes (2024) na danych z trzech branż nie znalazł potwierdzenia, że NPS wskazuje przyszły wzrost przychodów. W pracy dyplomowej NPS jest po prostu opisem gotowości polecenia w Twojej próbie. Wzór, kategorie i ograniczenia wskaźnika omawiamy w haśle Net Promoter Score (NPS).
Projekt 3. Eksperyment cenowy, czyli test A/B
Test A/B to eksperyment, w którym odwiedzający stronę losowo widzą jedną z dwóch wersji. Kohavi i in. (2009) nazywają takie kontrolowane eksperymenty najlepszym schematem do ustalania związków przyczynowych między zmianą na stronie a zachowaniem użytkowników. Zwracają też uwagę na moc statystyczną, liczebność próby i poprawność losowania. Jeśli nie masz dostępu do sklepu, ten sam schemat możesz zrealizować w ankiecie: losowo pokazujesz jedną z dwóch ofert i pytasz, czy respondent by ją kupił.
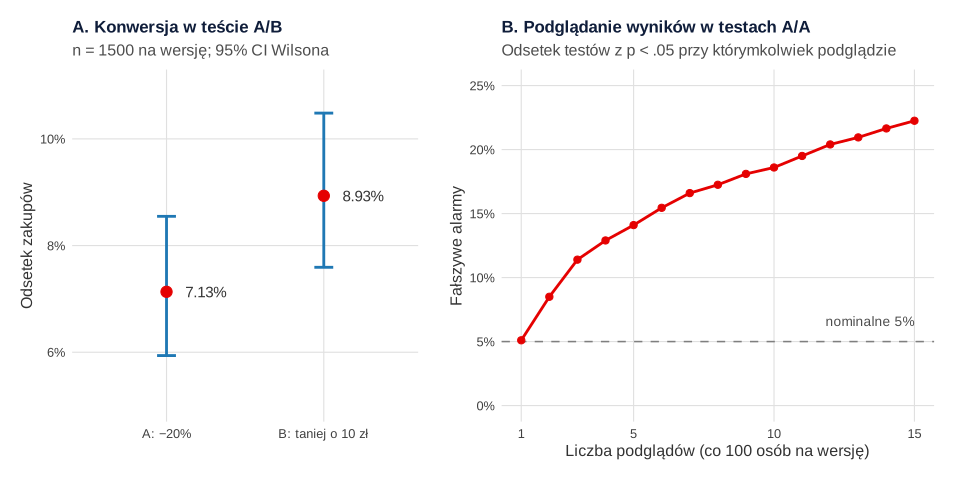
Przykład: sklep internetowy przez dwa tygodnie pokazywał tę samą cenę końcową na dwa sposoby. Wersja A podawała rabat jako „−20%”, a wersja B jako „taniej o 10 zł”. Każdą wersję zobaczyło 1500 losowo przydzielonych osób. Wynikiem był zakup w tej samej sesji.
Test dla dwóch proporcji i wielkość efektu
Wynik jest dwuwartościowy, a grupy są niezależne, więc właściwy jest test dla dwóch proporcji (bez poprawki na ciągłość daje ten sam wynik co test chi-kwadrat dla tabeli 2 × 2). Zakup wybrało 107 z 1500 osób w wersji A (7.13%) i 134 z 1500 w wersji B (8.93%). Różnica wyniosła 1.80 punktu procentowego, χ²(1) = 3.29, p = .070. Do różnicy proporcji podaj przedział ufności Newcombe’a, oparty na przedziałach Wilsona dla obu grup. Newcombe (1998) pokazał, że proste metody mają słabe pokrycie, a ta działa dobrze niezależnie od liczebności. Tutaj 95% CI wynosi [−0.15, 3.76] punktu procentowego. Ryzyko względne RR = 1.25, iloraz szans OR = 1.28, a h Cohena = 0.07. Te same liczby, razem z testem Fishera, policzysz w kalkulatorze tabeli 2 × 2, a szerzej o porównaniu odsetków piszemy w poradniku jak porównać odsetki w dwóch grupach.
Wynik nieistotny to nie dowód braku efektu
Dane są symulowane, więc znamy prawdę: w populacji wersja B daje 8% zakupów, a wersja A 6%. Efekt istnieje, a test go nie wykrył. Przy takich odsetkach do wykrycia różnicy z mocą 80% potrzeba około 2554 osób na wersję, a nie 1500. Przedział ufności dobrze to pokazuje. Obejmuje zero, ale także wzrost o prawie 4 punkty procentowe, który dla sklepu byłby bardzo ważny. Napisz więc, że badanie nie pozwala rozstrzygnąć, która wersja jest lepsza, a nie że „sposób podania rabatu nie ma znaczenia”. Liczebność zaplanuj przed startem testu (zob. moc testu).
Nie zaglądaj do wyników co kilka dni
W testach A/B kusi, by sprawdzać wynik na bieżąco i zakończyć test, gdy tylko p spadnie poniżej .05. Rysunek 2B pokazuje, czym to grozi. W 2000 symulowanych testach A/A obie wersje były identyczne. Jeden test na końcu dał wynik istotny w 5.2% przypadków, czyli zgodnie z poziomem α. Przy sprawdzaniu wyniku co 100 osób na wersję i zatrzymaniu przy pierwszym p < .05 fałszywy alarm pojawił się w 14.1% testów po pięciu podglądach i w 22.2% po piętnastu. Ustal więc z góry liczebność albo czas trwania testu i przeprowadź jeden test na końcu. Jeśli chcesz analizować wyniki po drodze, potrzebujesz planu analiz sekwencyjnych z odpowiednio skorygowanym progiem.
Projekt 4. Regresja intencji zakupu
Najczęstszy model w pracach z marketingu wyjaśnia intencję zakupu (średnia trzech pozycji 1–7) postawą wobec marki, postrzeganą wartością produktu i wrażliwością cenową, przy kontroli wieku i płci. W całej próbie 360 osób średnia intencja wyniosła 4.26 (SD = 1.10). Pełną procedurę, z diagnostyką reszt i interpretacją współczynników, opisujemy w poradniku regresja wieloraka krok po kroku. Tu skupiamy się na tym, co zwykle trzeba pokazać w pracy z marketingu.
| Predyktor | b | 95% CI | β | t(354) | p |
|---|---|---|---|---|---|
| Stała | 1.97 | [1.33, 2.60] | — | 6.08 | < .001 |
| Postawa wobec marki | 0.53 | [0.44, 0.63] | 0.50 | 11.15 | < .001 |
| Postrzegana wartość | 0.20 | [0.11, 0.29] | 0.20 | 4.33 | < .001 |
| Wrażliwość cenowa | −0.21 | [−0.29, −0.12] | −0.20 | −4.98 | < .001 |
| Wiek (lata) | −0.001 | [−0.009, 0.008] | −0.01 | −0.13 | .899 |
| Mężczyzna (vs kobieta) | 0.12 | [−0.06, 0.29] | 0.11 | 1.29 | .197 |
Model wyjaśniał 43% wariancji intencji zakupu, R² = .43, skorygowane R² = .42, F(5, 354) = 53.32, p < .001. Jak czytać te liczby w języku marketingu:
- Postawa, b = 0.53. Dwie osoby w tym samym wieku, tej samej płci, o tej samej ocenie wartości i wrażliwości cenowej, różniące się o 1 punkt postawy wobec marki, różnią się przeciętnie o 0.53 punktu intencji zakupu. To najsilniejszy predyktor (β = 0.50).
- Wrażliwość cenowa, b = −0.21. Osoby bardziej zwracające uwagę na cenę deklarowały niższą intencję zakupu marki A przy tej samej postawie i ocenie wartości.
- Wiek i płeć nie wiązały się istotnie z intencją, gdy uwzględniono postawy. Nie pisz jednak, że „wiek nie ma wpływu na zakupy”. Model opisuje tę próbę i ten zestaw zmiennych.
Największy współczynnik VIF wyniósł 1.27, więc współliniowość nie stanowiła problemu, choć postawa i wartość były ze sobą skorelowane. Jeśli wynik jest dwuwartościowy (np. „czy kupisz produkt w ciągu miesiąca: tak/nie”), zamiast regresji liniowej użyj regresji logistycznej (zob. regresja logistyczna krok po kroku). Tabelę wyników przygotuj w stylu APA, a zdania do rozdziału wyników możesz sprawdzić w generatorze opisu wyników APA.
Intencja zakupu to deklaracja, a nie zakup. W ankiecie zmierzysz zamiar, a o tym, czy przełoży się on na zachowanie, ankieta nie rozstrzyga. Pisz więc o „deklarowanej intencji zakupu”. Jeśli możesz, uzupełnij badanie o zachowanie mierzone obiektywnie, np. wybór w eksperymencie albo kliknięcie w ofertę.
Projekt 5. Mediacja w eksperymencie z etykietą ekologiczną
Hipotezy mediacyjne są w marketingu bardzo częste: reklama zmienia postawę, a postawa intencję zakupu; etykieta zwiększa zaufanie, a zaufanie skłonność do zakupu. Najmocniejszy schemat do ich testowania to eksperyment, w którym zmienną X jest losowo przydzielony warunek. Wtedy przynajmniej ścieżka od X do mediatora ma interpretację przyczynową. Związek mediatora z wynikiem pozostaje jednak korelacyjny, bo mediatora nie losowałeś.
Przykład: 240 osób losowo zobaczyło zdjęcie opakowania z etykietą ekologiczną albo bez niej (po 120 osób). Następnie oceniły zaufanie do produktu i intencję zakupu (po trzy pozycje 1–7). Kontrola manipulacji wypadła dobrze: etykietę zauważyło 92.5% osób, które ją widziały, i 5.8% osób z grupy bez etykiety.
Osoby, które widziały etykietę, deklarowały wyższą intencję zakupu (M = 4.17, SD = 1.17) niż grupa bez etykiety (M = 3.79, SD = 1.15). Efekt całkowity wyniósł c = 0.38, 95% CI [0.08, 0.67], t(237.93) = 2.53, p = .012, g = 0.33, 95% CI [0.07, 0.58]. Etykieta zwiększała zaufanie do produktu, a = 0.77, 95% CI [0.50, 1.03], p < .001. Zaufanie wiązało się z intencją przy kontroli warunku, b = 0.58, 95% CI [0.46, 0.70], p < .001. Efekt bezpośredni był bliski zeru, c′ = −0.07, 95% CI [−0.34, 0.20], p = .619.
Kluczową liczbą jest efekt pośredni ab = 0.45 z percentylowym przedziałem bootstrap z 5000 prób, 95% CI [0.27, 0.65]. Przedział nie obejmuje zera, więc dane są zgodne z hipotezą, że etykieta działa przez zaufanie. Zhao i in. (2010) opisują słabości logiki kroków Barona i Kenny’ego, wciąż wymaganych przez wielu recenzentów, i proponują procedurę testowania mediacji oraz klasyfikowania jej typu. W praktyce opieraj wniosek na teście efektu pośredniego, a nie na liczeniu, które kroki „przeszły”. Nie pisz też o „pełnej mediacji” tylko dlatego, że c′ jest nieistotne. Przy 240 osobach mały efekt bezpośredni łatwo przeoczyć, a brak istotności nie dowodzi, że go nie ma.
Krok po kroku, z wykresem ścieżek i wielkościami efektu, przechodzimy przez mediację w poradniku analiza mediacji krok po kroku.
Projekt 6. Segmentacja konsumentów według poszukiwanych korzyści
Segmentacja dzieli konsumentów na grupy o podobnym profilu odpowiedzi, np. według tego, jak ważne są dla nich cena, jakość, ekologia i wygoda zakupu. Punj i Stewart (1983) w przeglądzie zastosowań analizy skupień w badaniach marketingowych polecają podejście dwuetapowe: wstępne skupienia metodą hierarchiczną, a potem ich dopracowanie metodą iteracyjną, taką jak k-średnich. Zwracają też uwagę na walidację wyników.
W przykładzie te same 360 osoby oceniły ważność czterech korzyści (1–7). Zmienne zestandaryzowano, a analizę k-średnich uruchomiono z 50 startami dla od 2 do 6 skupień. Suma kwadratów wewnątrz skupień spadała wyraźnie do trzech skupień (z 658.1 przy dwóch do 495.1), a dalej już słabo (452.6 przy czterech). Wskaźnik sylwetki był najwyższy przy dwóch skupieniach (.456), a drugi przy trzech (.378). Rozwiązanie z dwoma skupieniami łączyło jednak osoby nastawione na jakość z osobami nastawionymi na ekologię, dlatego wybrano trzy segmenty. Taka sytuacja jest typowa: kryteria nie muszą się zgadzać, a ostateczna decyzja wymaga uzasadnienia merytorycznego.
| Segment | n | Cena | Jakość | Ekologia | Wygoda | Intencja zakupu |
|---|---|---|---|---|---|---|
| Cenowi | 151 | 5.96 | 4.56 | 3.24 | 5.45 | 4.15 |
| Jakościowi | 116 | 4.30 | 6.03 | 4.07 | 4.40 | 4.28 |
| Ekologiczni | 93 | 3.67 | 5.66 | 6.02 | 3.76 | 4.42 |
Nazwy segmentów to Twoja interpretacja profili, a nie wynik algorytmu. Opisz je ostrożnie i podaj liczebności. Dane są symulowane, więc mogliśmy sprawdzić, że k-średnich przypisało 96.4% osób do skupienia odpowiadającego ich prawdziwemu segmentowi. W prawdziwych danych takiej kontroli nie masz, dlatego zbadaj stabilność podziału, np. bootstrapem. Pamiętaj też, że analiza skupień zawsze coś znajdzie, także w danych bez żadnych grup. Pełną procedurę – wybór zmiennych, liczby skupień, stabilność i porównanie z analizą profili latentnych – opisujemy w poradniku segmentacja respondentów: k-średnich i LPA.
Jak opisać analizę statystyczną w pracy
Akapit o analizie statystycznej powinien pozwolić innej osobie powtórzyć obliczenia. W pracy z marketingu opisz dobór próby i sposób rekrutacji, źródło skal, losowanie w eksperymencie, kontrolę manipulacji i liczbę osób wykluczonych z analizy. Poniżej wzór dla ankiety i eksperymentu.
Jeśli potrzebujesz pomocy w doborze analiz do swojego projektu albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z sześciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu, a ostatni przepis – rysunki i plik XLSX do pobrania. Każdy z pierwszych trzech przepisów tworzy własne dane symulowane, więc możesz go uruchomić osobno. Najważniejszy jest przepis 1 z pełną analizą ankiety konsumenckiej. Wielkości efektu liczy pakiet effectsize, przedział Newcombe’a – pakiet DescTools, a CFA – pakiet lavaan.
1. Projekty 1, 2, 4 i 6: ankieta konsumencka – skala postaw, NPS, regresja intencji zakupu i segmentacja
R
# Projekty 1, 2, 4 i 6: ankieta konsumencka o marce A (dane symulowane).
# 360 konsumentów kategorii produktu; 200 kupuje markę A (klienci), 160 nie.
# Skale 1–7: postawa wobec marki (4 pozycje), postrzegana wartość (3), wrażliwość cenowa (3),
# intencja zakupu (3), ważność czterech korzyści (cena, jakość, ekologia, wygoda);
# klienci odpowiadają też na pytanie o polecenie marki (0–10) i podają kanał zakupu.
suppressPackageStartupMessages({ library(effectsize); library(psych); library(lavaan); library(car); library(cluster) })
set.seed(22701)
n <- 360
klient <- factor(sample(rep(c("klient", "nieklient"), c(200, 160))), levels = c("klient", "nieklient"))
plec <- factor(sample(c("kobieta", "mężczyzna"), n, TRUE, prob = c(.58, .42)))
wiek <- round(pmin(70, pmax(18, rnorm(n, 34, 11))))
segment_prawdziwy <- sample(1:3, n, TRUE, prob = c(.40, .35, .25))   # znany tylko w symulacji
postawa_lat <- 0.75 * (klient == "klient") + rnorm(n)
wartosc_lat <- 0.5 * postawa_lat + rnorm(n, 0, 0.9)
cena_lat <- c(0.8, -0.3, -0.6)[segment_prawdziwy] + rnorm(n, 0, 0.8)
pozycja <- function(lat, lad, prog = c(-2.2, -1.4, -0.6, 0.2, 1.0, 1.8)) {
  as.integer(cut(lad * scale(lat)[, 1] + rnorm(length(lat), 0, sqrt(1 - lad^2)), c(-Inf, prog, Inf)))
}
d <- data.frame(id = 1:n, klient, plec, wiek,
  post1 = pozycja(postawa_lat, .85), post2 = pozycja(postawa_lat, .80), post3 = pozycja(postawa_lat, .78), post4 = pozycja(postawa_lat, .70),
  wart1 = pozycja(wartosc_lat, .80), wart2 = pozycja(wartosc_lat, .78), wart3 = pozycja(wartosc_lat, .72),
  cen1 = pozycja(cena_lat, .80), cen2 = pozycja(cena_lat, .75), cen3 = pozycja(cena_lat, .70))
d$postawa <- rowMeans(d[, paste0("post", 1:4)])
d$wartosc <- rowMeans(d[, paste0("wart", 1:3)])
d$wrazliwosc_cenowa <- rowMeans(d[, paste0("cen", 1:3)])
int_lat <- 0.45 * scale(d$postawa)[, 1] + 0.25 * scale(d$wartosc)[, 1] - 0.20 * scale(d$wrazliwosc_cenowa)[, 1] + rnorm(n, 0, 0.75)
d$intencja <- rowMeans(sapply(c(.85, .80, .75), function(l) pozycja(int_lat, l)))
# ważność korzyści (średnie z dwóch pozycji 1–7) – profile trzech segmentów
prof <- rbind(c(cena = 6.0, jakosc = 4.6, ekologia = 3.2, wygoda = 5.4),
              c(cena = 4.2, jakosc = 6.0, ekologia = 4.2, wygoda = 4.4),
              c(cena = 3.6, jakosc = 5.6, ekologia = 6.1, wygoda = 3.8))
kor <- sapply(1:4, function(j) pmin(7, pmax(1, round(2 * (prof[segment_prawdziwy, j] + rnorm(n, 0, 0.6))) / 2)))
colnames(kor) <- paste0("wazn_", colnames(prof)); d <- cbind(d, kor)
# polecenie marki 0–10 (tylko klienci) i kanał zakupu
kl <- d$klient == "klient"
d$kanal <- factor(ifelse(kl, ifelse(runif(n) < .5, "internet", "sklep stacjonarny"), NA), levels = c("internet", "sklep stacjonarny"))
pol_lat <- 0.55 * scale(d$postawa)[, 1] + 0.20 * (d$kanal == "internet") + rnorm(n, 0, 0.8)
d$polecenie <- ifelse(kl, as.integer(as.character(cut(pol_lat, c(-Inf, -2.3, -1.9, -1.6, -1.3, -1.0, -0.7, -0.35, -0.05, 0.4, 1.0, Inf), labels = 0:10))), NA)

# --- Projekt 1: skala postawy wobec marki – rzetelność i porównanie klientów z nieklientami
pozp <- d[, paste0("post", 1:4)]
round(psych::alpha(pozp, warnings = FALSE)$total[c("raw_alpha", "average_r")], 2)
fit1 <- cfa("P =~ post1 + post2 + post3 + post4", data = d, std.lv = TRUE)
pe <- standardizedSolution(fit1); lam <- pe$est.std[pe$op == "=~"]
round(c(ladunki = lam, omega = sum(lam)^2 / (sum(lam)^2 + sum(1 - lam^2)),
        CFI = unname(fitMeasures(fit1, "cfi")), RMSEA = unname(fitMeasures(fit1, "rmsea")), SRMR = unname(fitMeasures(fit1, "srmr"))), 3)
aggregate(postawa ~ klient, d, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
t.test(postawa ~ klient, data = d)
hedges_g(postawa ~ klient, data = d, pooled_sd = FALSE)

# --- Projekt 2: Net Promoter Score wśród klientów
k <- d[kl, ]
k$kategoria <- cut(k$polecenie, c(-1, 6, 8, 10), labels = c("krytycy (0–6)", "pasywni (7–8)", "promotorzy (9–10)"))
nps <- function(x) { n <- length(x); pP <- mean(x >= 9); pD <- mean(x <= 6)
  c(n = n, promotorzy = 100 * pP, pasywni = 100 * (1 - pP - pD), krytycy = 100 * pD, NPS = 100 * (pP - pD),
    SE = 100 * sqrt((pP + pD - (pP - pD)^2) / n)) }
wyn_nps <- rbind(ogolem = nps(k$polecenie), internet = nps(k$polecenie[k$kanal == "internet"]),
                 stacjonarny = nps(k$polecenie[k$kanal == "sklep stacjonarny"]))
wyn_nps <- cbind(wyn_nps, CI_d = wyn_nps[, "NPS"] - 1.96 * wyn_nps[, "SE"], CI_g = wyn_nps[, "NPS"] + 1.96 * wyn_nps[, "SE"]); round(wyn_nps, 1)
# różnica NPS (internet − sklep) z 95% CI i test z
roz <- wyn_nps["internet", "NPS"] - wyn_nps["stacjonarny", "NPS"]
se_roz <- sqrt(wyn_nps["internet", "SE"]^2 + wyn_nps["stacjonarny", "SE"]^2)
round(c(roznica = roz, CI_d = roz - 1.96 * se_roz, CI_g = roz + 1.96 * se_roz, z = roz / se_roz, p = 2 * pnorm(-abs(roz / se_roz))), 3)
# ta sama porównywana różnica na pełnej skali 0–10
aggregate(polecenie ~ kanal, k, function(x) round(c(M = mean(x), SD = sd(x), Me = median(x)), 2))
suppressWarnings(wilcox.test(polecenie ~ kanal, data = k, exact = FALSE))
rank_biserial(polecenie ~ kanal, data = k)
# związek polecenia z postawą wobec marki
cor.test(k$polecenie, k$postawa, method = "spearman", exact = FALSE)

# --- Projekt 4: regresja intencji zakupu (cała próba)
d$plec <- relevel(d$plec, "kobieta")
m4 <- lm(intencja ~ postawa + wartosc + wrazliwosc_cenowa + wiek + plec, data = d)
s4 <- summary(m4); s4
round(cbind(b = coef(m4), confint(m4)), 3)
st <- standardize_parameters(m4); data.frame(parametr = st$Parameter, beta = round(st$Std_Coefficient, 2))
round(c(R2 = s4$r.squared, R2_skor = s4$adj.r.squared), 3)
round(vif(m4), 2)
round(sapply(d[, c("intencja", "postawa", "wartosc", "wrazliwosc_cenowa")], function(x) c(M = mean(x), SD = sd(x))), 2)

# --- Projekt 6: segmentacja konsumentów według ważności korzyści (k-średnich)
Z <- scale(d[, c("wazn_cena", "wazn_jakosc", "wazn_ekologia", "wazn_wygoda")])
odl <- dist(Z)
sylw <- sapply(2:6, function(kk) { set.seed(100 + kk); km <- kmeans(Z, kk, nstart = 50)
  c(k = kk, WSS = km$tot.withinss, sylwetka = mean(silhouette(km$cluster, odl)[, 3])) })
round(t(sylw), 3)
set.seed(103); km3 <- kmeans(Z, 3, nstart = 50)
d$segment <- km3$cluster
profil <- aggregate(cbind(wazn_cena, wazn_jakosc, wazn_ekologia, wazn_wygoda, intencja) ~ segment, d, function(x) round(mean(x), 2))
profil$n <- as.vector(table(d$segment)); profil
table(segment_k_srednich = d$segment, prawdziwy = segment_prawdziwy)
# odsetek osób przypisanych do skupienia odpowiadającego ich prawdziwemu segmentowi
round(100 * sum(apply(table(d$segment, segment_prawdziwy), 1, max)) / n, 1)
Wynik w R
 raw_alpha average_r
      0.84      0.57
ladunki1 ladunki2 ladunki3 ladunki4    omega      CFI    RMSEA     SRMR
   0.815    0.825    0.699    0.679    0.842    1.000    0.000    0.009
     klient postawa.n postawa.M postawa.SD
1    klient    200.00      4.53       1.00
2 nieklient    160.00      3.93       0.97

	Welch Two Sample t-test

data:  postawa by klient
t = 5.8021, df = 345.97, p-value = 1.48e-08
alternative hypothesis: true difference in means between group klient and group nieklient is not equal to 0
95 percent confidence interval:
 0.3997051 0.8096699
sample estimates:
   mean in group klient mean in group nieklient
               4.531250                3.926563

Hedges' g |       95% CI
------------------------
0.61      | [0.40, 0.82]

- Estimated using un-pooled SD.              n promotorzy pasywni krytycy  NPS  SE  CI_d CI_g
ogolem      200       41.5    33.5    25.0 16.5 5.6   5.4 27.6
internet     98       51.0    26.5    22.4 28.6 8.2  12.6 44.6
stacjonarny 102       32.4    40.2    27.5  4.9 7.6 -10.1 19.9
roznica    CI_d    CI_g       z       p
 23.669   1.753  45.586   2.117   0.034
              kanal polecenie.M polecenie.SD polecenie.Me
1          internet        8.02         1.89         9.00
2 sklep stacjonarny        7.31         2.16         8.00

	Wilcoxon rank sum test with continuity correction

data:  polecenie by kanal
W = 6038.5, p-value = 0.009789
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.21              | [0.05, 0.36]

	Spearman's rank correlation rho

data:  k$polecenie and k$postawa
S = 699082, p-value = 1.094e-12
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.4756754


Call:
lm(formula = intencja ~ postawa + wartosc + wrazliwosc_cenowa +
    wiek + plec, data = d)

Residuals:
     Min       1Q   Median       3Q      Max
-2.66410 -0.52884 -0.00738  0.54811  2.02664

Coefficients:
                    Estimate Std. Error t value Pr(>|t|)
(Intercept)        1.9659964  0.3232717   6.082 3.09e-09 ***
postawa            0.5337884  0.0478858  11.147  < 2e-16 ***
wartosc            0.2011301  0.0464599   4.329 1.95e-05 ***
wrazliwosc_cenowa -0.2051033  0.0411669  -4.982 9.85e-07 ***
wiek              -0.0005561  0.0043902  -0.127    0.899
plecmężczyzna      0.1154515  0.0892787   1.293    0.197
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.8339 on 354 degrees of freedom
Multiple R-squared:  0.4296,	Adjusted R-squared:  0.4215
F-statistic: 53.32 on 5 and 354 DF,  p-value: < 2.2e-16

                       b  2.5 % 97.5 %
(Intercept)        1.966  1.330  2.602
postawa            0.534  0.440  0.628
wartosc            0.201  0.110  0.293
wrazliwosc_cenowa -0.205 -0.286 -0.124
wiek              -0.001 -0.009  0.008
plecmężczyzna      0.115 -0.060  0.291
           parametr  beta
1       (Intercept) -0.05
2           postawa  0.50
3           wartosc  0.20
4 wrazliwosc_cenowa -0.20
5              wiek -0.01
6     plecmężczyzna  0.11
     R2 R2_skor
  0.430   0.422
          postawa           wartosc wrazliwosc_cenowa              wiek              plec
             1.26              1.27              1.01              1.02              1.01
   intencja postawa wartosc wrazliwosc_cenowa
M      4.26    4.26    4.24              4.21
SD     1.10    1.03    1.07              1.08
     k     WSS sylwetka
[1,] 2 658.083    0.456
[2,] 3 495.110    0.378
[3,] 4 452.592    0.255
[4,] 5 412.798    0.221
[5,] 6 378.967    0.210
  segment wazn_cena wazn_jakosc wazn_ekologia wazn_wygoda intencja   n
1       1      3.67        5.66          6.02        3.76     4.42  93
2       2      5.96        4.56          3.24        5.45     4.15 151
3       3      4.30        6.03          4.07        4.40     4.28 116
                  prawdziwy
segment_k_srednich   1   2   3
                 1   0   6  87
                 2 150   1   0
                 3   5 110   1
[1] 96.4
2. Projekt 3: test A/B – test dla dwóch proporcji, CI Newcombe’a, moc i podglądanie wyników
R
# Projekt 3: test A/B sposobu podania ceny w sklepie internetowym (dane symulowane).
# Ta sama cena końcowa; wersja A: „−20%”, wersja B: „taniej o 10 zł”. Odwiedzający przydzielani losowo.
# Wynik: zakup w tej samej sesji (tak/nie).
suppressPackageStartupMessages(library(DescTools))
set.seed(22702)
nA <- 1500; nB <- 1500
wersja <- factor(rep(c("A: −20%", "B: taniej o 10 zł"), c(nA, nB)))
zakup <- rbinom(nA + nB, 1, ifelse(wersja == "A: −20%", .060, .080))
dane_ab <- data.frame(id = 1:(nA + nB), wersja, zakup)
tab <- table(dane_ab$wersja, factor(dane_ab$zakup, 1:0, c("zakup", "brak zakupu"))); tab
round(100 * prop.table(tab, 1), 2)
x <- tab[, "zakup"]; nn <- rowSums(tab)
# test dla dwóch proporcji (bez poprawki na ciągłość = test chi-kwadrat 2 × 2)
prop.test(x[2:1], nn[2:1], correct = FALSE)
# różnica proporcji B − A z 95% CI Newcombe'a (hybrydowy przedział score)
round(100 * BinomDiffCI(x[2], nn[2], x[1], nn[1], method = "score"), 2)
# ryzyko względne, iloraz szans i h Cohena (2·arcsin√p2 − 2·arcsin√p1)
p <- x / nn
round(c(RR = unname(p[2] / p[1]), OR = unname((p[2] / (1 - p[2])) / (p[1] / (1 - p[1])))), 3)
round(c(h_Cohena = unname(2 * asin(sqrt(p[2])) - 2 * asin(sqrt(p[1])))), 3)
# Ilu odwiedzających potrzeba na wersję, aby wykryć wzrost z 6% do 8% z mocą 80%?
power.prop.test(p1 = .06, p2 = .08, power = .80)

# Podglądanie wyników: 2000 testów A/A (obie wersje identyczne, 6%),
# test po każdych 100 odwiedzających na wersję (15 podglądów) i zatrzymanie przy pierwszym p < .05.
set.seed(22712)
kroki <- seq(100, 1500, 100)
pv <- replicate(2000, { a <- rbinom(1500, 1, .06); b <- rbinom(1500, 1, .06)
  sapply(kroki, function(m) { xa <- sum(a[1:m]); xb <- sum(b[1:m])
    if (xa + xb == 0) 1 else suppressWarnings(prop.test(c(xa, xb), c(m, m), correct = FALSE)$p.value) }) })
fpr <- 100 * rowMeans(apply(pv < .05, 2, cummax))     # % testów z p < .05 przy którymkolwiek z pierwszych k podglądów
round(c(jeden_test_na_koncu = 100 * mean(pv[15, ] < .05), po_5_podgladach = fpr[5], po_15_podgladach = fpr[15]), 1)
Wynik w R
                    zakup brak zakupu
  A: −20%             107        1393
  B: taniej o 10 zł   134        1366

                    zakup brak zakupu
  A: −20%            7.13       92.87
  B: taniej o 10 zł  8.93       91.07

	2-sample test for equality of proportions without continuity correction

data:  x[2:1] out of nn[2:1]
X-squared = 3.2891, df = 1, p-value = 0.06974
alternative hypothesis: two.sided
95 percent confidence interval:
 -0.001442064  0.037442064
sample estimates:
    prop 1     prop 2
0.08933333 0.07133333

     est.B: taniej o 10 zł lwr.ci upr.ci
[1,]                   1.8  -0.15   3.76
   RR    OR
1.252 1.277
h_Cohena
   0.066

     Two-sample comparison of proportions power calculation

              n = 2553.631
             p1 = 0.06
             p2 = 0.08
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group

jeden_test_na_koncu     po_5_podgladach    po_15_podgladach
                5.2                14.1                22.2
3. Projekt 5: eksperyment z etykietą ekologiczną – efekt całkowity i mediacja z bootstrapem
R
# Projekt 5: eksperyment z etykietą ekologiczną i mediacja przez zaufanie (dane symulowane).
# 240 osób losowo widzi opakowanie z etykietą ekologiczną albo bez niej (po 120).
# Mediator: zaufanie do produktu (średnia 3 pozycji, 1–7); wynik: intencja zakupu (średnia 3 pozycji, 1–7).
suppressPackageStartupMessages(library(effectsize))
set.seed(22703)
n <- 240
etykieta <- sample(rep(0:1, n / 2))                     # 1 = opakowanie z etykietą
zauw <- rbinom(n, 1, ifelse(etykieta == 1, .86, .07))     # kontrola manipulacji: „widziałem/am etykietę”
zaufanie <- pmin(7, pmax(1, round(3 * (4.0 + 0.55 * etykieta + rnorm(n, 0, 1.1))) / 3))
intencja <- pmin(7, pmax(1, round(3 * (1.6 + 0.10 * etykieta + 0.55 * zaufanie + rnorm(n, 0, 1.0))) / 3))
me <- data.frame(id = 1:n, etykieta, zauwazyl_etykiete = zauw, zaufanie, intencja)

# Kontrola manipulacji
round(100 * tapply(me$zauwazyl_etykiete, me$etykieta, mean), 1)
# Opis i efekt całkowity (test t Welcha, g Hedgesa)
aggregate(cbind(zaufanie, intencja) ~ etykieta, me, function(x) round(c(M = mean(x), SD = sd(x)), 2))
t.test(intencja ~ factor(etykieta, 1:0), data = me)
hedges_g(intencja ~ factor(etykieta, 1:0), data = me, pooled_sd = FALSE)
# Ścieżki a, b, c′ i c
ma <- lm(zaufanie ~ etykieta, me); mb <- lm(intencja ~ etykieta + zaufanie, me); mc <- lm(intencja ~ etykieta, me)
sciezki <- rbind(a = summary(ma)$coef["etykieta", ], b = summary(mb)$coef["zaufanie", ],
                 c_prim = summary(mb)$coef["etykieta", ], c = summary(mc)$coef["etykieta", ])
ci <- rbind(confint(ma)["etykieta", ], confint(mb)["zaufanie", ], confint(mb)["etykieta", ], confint(mc)["etykieta", ])
w <- data.frame(round(cbind(sciezki[, 1:3], ci), 3), p = signif(sciezki[, 4], 3), check.names = FALSE); w
# Efekt pośredni ab z percentylowym przedziałem bootstrap (5000 prób)
ab <- coef(ma)["etykieta"] * coef(mb)["zaufanie"]
set.seed(22713)
boot_ab <- replicate(5000, { i <- sample.int(n, n, TRUE); dd <- me[i, ]
  coef(lm(zaufanie ~ etykieta, dd))[2] * coef(lm(intencja ~ etykieta + zaufanie, dd))[3] })
round(c(ab = unname(ab), CI_d = unname(quantile(boot_ab, .025)), CI_g = unname(quantile(boot_ab, .975))), 3)
Wynik w R
   0    1
 5.8 92.5
  etykieta zaufanie.M zaufanie.SD intencja.M intencja.SD
1        0       3.89        1.03       3.79        1.15
2        1       4.65        1.03       4.17        1.17

	Welch Two Sample t-test

data:  intencja by factor(etykieta, 1:0)
t = 2.5325, df = 237.93, p-value = 0.01197
alternative hypothesis: true difference in means between group 1 and group 0 is not equal to 0
95 percent confidence interval:
 0.08391112 0.67164444
sample estimates:
mean in group 1 mean in group 0
       4.166667        3.788889

Hedges' g |       95% CI
------------------------
0.33      | [0.07, 0.58]

- Estimated using un-pooled SD.       Estimate Std. Error t value  2.5 % 97.5 %        p
a         0.767      0.133   5.772  0.505  1.028 2.44e-08
b         0.581      0.062   9.317  0.458  0.704 8.62e-18
c_prim   -0.068      0.137  -0.498 -0.337  0.201 6.19e-01
c         0.378      0.149   2.532  0.084  0.672 1.20e-02
   ab  CI_d  CI_g
0.446 0.268 0.648
4. Rysunki i plik XLSX
R
# Rysunki i plik XLSX do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b227-rysunki.R > b227-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(svglite); library(patchwork); library(openxlsx) })
# Motyw i pomocnicze funkcje rysunków (zdefiniowane lokalnie)
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", neutralny = "#8C8C8C", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 14) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          strip.text = element_text(face = "bold", colour = KOLORY[["granat"]]), legend.position = "bottom",
          plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100),
              round(file.info(plik)$size / 1024)))
}
apa_p <- function(p) if (p < .001) "p < .001" else paste0("p = ", sub("^0\\.", ".", formatC(p, format = "f", digits = 3)))
minus <- function(x) gsub("-", "−", x)
pdf(NULL)
invisible(capture.output({ for (f in c("b227-1-ankieta-konsumencka.R", "b227-2-test-ab.R", "b227-3-mediacja-etykieta.R")) source(f) }))

# Rysunek 1: rozkład odpowiedzi 0–10 na pytanie o polecenie marki według kanału zakupu
r1d <- as.data.frame(prop.table(table(kanal = k$kanal, odp = factor(k$polecenie, 0:10)), 1))
r1d$proc <- 100 * r1d$Freq
r1d$kategoria <- cut(as.integer(as.character(r1d$odp)), c(-1, 6, 8, 10), labels = c("krytycy (0–6)", "pasywni (7–8)", "promotorzy (9–10)"))
etyk <- sprintf("%s (n = %d): NPS = %s [%s, %s]", c("internet", "sklep stacjonarny"), c(98, 102),
                minus(sprintf("%.1f", wyn_nps[2:3, "NPS"])), minus(sprintf("%.1f", wyn_nps[2:3, "CI_d"])), minus(sprintf("%.1f", wyn_nps[2:3, "CI_g"])))
r1d$panel <- factor(etyk[as.integer(r1d$kanal)], levels = etyk)
print(aggregate(proc ~ kanal + kategoria, r1d, sum), digits = 3)
r1 <- ggplot(r1d, aes(odp, proc, fill = kategoria)) + geom_col(width = .75) +
  facet_wrap(~ panel, ncol = 2) +
  scale_fill_manual(values = c("krytycy (0–6)" = KOLORY[["drugi"]], "pasywni (7–8)" = "grey75", "promotorzy (9–10)" = KOLORY[["akcent"]]), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(x, "%"), expand = expansion(mult = c(0, .05))) +
  labs(title = "Polecenie marki A (0–10) według kanału zakupu", subtitle = "NPS = % promotorów − % krytyków, w nawiasie 95% CI; klienci marki, n = 200",
       x = "Odpowiedź na pytanie o polecenie marki", y = "Odsetek klientów") + theme_metodolog(13)
zapisz_svg(r1, "../statystyka-marketing-nps-kanal.svg", szer = 10, wys = 5.2)

# Rysunek 2: test A/B – konwersja z 95% CI (A) i podglądanie wyników w testach A/A (B)
wil <- function(x, n) { z <- qnorm(.975); p <- x / n; c0 <- p + z^2 / (2 * n); h <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
  100 * c(p = p, lo = (c0 - h) / (1 + z^2 / n), hi = (c0 + h) / (1 + z^2 / n)) }
r2d <- data.frame(wersja = names(x), t(mapply(wil, x, nn))); print(r2d, digits = 3)
r2a <- ggplot(r2d, aes(wersja, p)) +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = .12, colour = KOLORY[["drugi"]], linewidth = 1) +
  geom_point(colour = KOLORY[["akcent"]], size = 3.6) +
  geom_text(aes(label = sprintf("%.2f%%", p)), nudge_x = .25, size = 4, colour = "grey20") +
  scale_y_continuous(limits = c(5, 11), labels = function(v) paste0(v, "%")) +
  labs(title = "A. Konwersja w teście A/B", subtitle = "n = 1500 na wersję; 95% CI Wilsona",
       x = NULL, y = "Odsetek zakupów") + theme_metodolog(12)
r2bd <- data.frame(liczba_podgladow = seq_along(kroki), fpr = fpr); print(r2bd[c(1, 5, 10, 15), ], digits = 3)
r2b <- ggplot(r2bd, aes(liczba_podgladow, fpr)) + geom_hline(yintercept = 5, linetype = 2, colour = "grey50") +
  geom_line(colour = KOLORY[["akcent"]], linewidth = 1) + geom_point(colour = KOLORY[["akcent"]], size = 2.2) +
  annotate("text", x = 15, y = 6.6, label = "nominalne 5%", hjust = 1, size = 3.6, colour = "grey30") +
  scale_x_continuous(breaks = c(1, 5, 10, 15)) + scale_y_continuous(limits = c(0, 25), labels = function(v) paste0(v, "%")) +
  labs(title = "B. Podglądanie wyników w testach A/A", subtitle = "Odsetek testów z p < .05 przy którymkolwiek podglądzie",
       x = "Liczba podglądów (co 100 osób na wersję)", y = "Fałszywe alarmy") + theme_metodolog(12)
zapisz_svg(r2a + r2b + plot_layout(widths = c(1, 1.25)), "../statystyka-marketing-test-ab.svg", szer = 10, wys = 5)

# Plik XLSX z danymi do pobrania
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z marketingu – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
opis <- data.frame(arkusz = c("Ankieta", "Test_AB", "Eksperyment_etykieta"),
  zawartosc = c("360 konsumentów: pozycje i wyniki skal 1–7 (postawa wobec marki, wartość, wrażliwość cenowa, intencja zakupu), ważność korzyści, polecenie 0–10 i kanał (tylko klienci)",
                "3000 odwiedzających sklepu: wersja strony (A: −20%, B: taniej o 10 zł) i zakup (1 = tak)",
                "240 uczestników: etykieta ekologiczna (1 = tak), kontrola manipulacji, zaufanie i intencja zakupu (1–7)"),
  uwaga = "Dane symulowane do nauki analizy; nie pochodzą z prawdziwego badania.")
ank <- d[, setdiff(names(d), c("segment"))]
for (ark in list(list("Opis", opis), list("Ankieta", ank), list("Test_AB", dane_ab), list("Eksperyment_etykieta", me))) {
  addWorksheet(wb, ark[[1]]); writeData(wb, ark[[1]], ark[[2]]); setColWidths(wb, ark[[1]], 1:ncol(ark[[2]]), "auto") }
saveWorkbook(wb, "../statystyka-marketing-dane-przyklad.xlsx", overwrite = TRUE)
sapply(getSheetNames("../statystyka-marketing-dane-przyklad.xlsx"), function(s) nrow(read.xlsx("../statystyka-marketing-dane-przyklad.xlsx", s)))
cat("rozmiar KB:", round(file.info("../statystyka-marketing-dane-przyklad.xlsx")$size / 1024), "\n")
Wynik w R
              kanal         kategoria proc
1          internet     krytycy (0–6) 22.4
2 sklep stacjonarny     krytycy (0–6) 27.5
3          internet     pasywni (7–8) 26.5
4 sklep stacjonarny     pasywni (7–8) 40.2
5          internet promotorzy (9–10) 51.0
6 sklep stacjonarny promotorzy (9–10) 32.4
Zapisano ../statystyka-marketing-nps-kanal.svg: w HTML width="1000" height="520" (17 KB)
                             wersja    p   lo    hi
A: −20%                     A: −20% 7.13 5.94  8.55
B: taniej o 10 zł B: taniej o 10 zł 8.93 7.59 10.48
   liczba_podgladow  fpr
1                 1  5.1
5                 5 14.1
10               10 18.6
15               15 22.2
Zapisano ../statystyka-marketing-test-ab.svg: w HTML width="1000" height="500" (12 KB)
                Opis              Ankieta              Test_AB
                   3                  360                 3000
Eksperyment_etykieta
                 240
rozmiar KB: 88
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje t.test(), wilcox.test(), cor.test(), prop.test(), power.prop.test(), lm() i kmeans() z pakietów stats); rysunki przygotowano w pakietach ggplot2, svglite i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- cluster (wersja 2.1.8.2): Maechler, M., Rousseeuw, P., Struyf, A., Hubert, M., & Hornik, K. (2026). cluster: Cluster analysis basics and extensions (R package version 2.1.8.2) [Computer software]. https://CRAN.R-project.org/package=cluster
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizach prac z marketingu
- Uogólnianie wyników ankiety z mediów społecznościowych na wszystkich konsumentów albo „Polaków”.
- Wnioski przyczynowe z ankiety. „Postawa wpływa na zakup” to wniosek eksperymentu, a nie korelacji w jednym badaniu przekrojowym.
- Konstrukt mierzony jednym pytaniem albo autorska skala bez sprawdzenia rzetelności i struktury.
- NPS bez przedziału ufności i porównywanie wyników różniących się o kilka punktów przy stu osobach w grupie.
- Test A/B zakończony, gdy tylko wynik stał się istotny. W symulacji przy piętnastu podglądach fałszywe alarmy pojawiły się w 22.2% testów zamiast w 5%.
- Wynik nieistotny przedstawiony jako dowód braku efektu, choć badanie miało za małą moc.
- Mediacja oceniana krokami Barona i Kenny’ego albo testem Sobela zamiast przedziału bootstrap dla efektu pośredniego.
- Segmenty nazwane i opisane bez uzasadnienia liczby skupień i bez sprawdzenia stabilności.
- Intencja zakupu opisana jak zakup. Deklaracja w ankiecie nie jest zachowaniem.
Najczęstsze pytania
Jak policzyć NPS i jego przedział ufności w pracy magisterskiej?
Policz odsetek promotorów (odpowiedzi 9–10) i krytyków (0–6) i odejmij drugi od pierwszego. Błąd standardowy to 100 × √[(pP + pK − (pP − pK)²) / n], a 95% CI to NPS ± 1.96 × SE. Przy 200 osobach przedział ma zwykle ponad 20 punktów szerokości, dlatego obok NPS pokaż rozkład odpowiedzi 0–10 i porównuj grupy także na pełnej skali, np. testem Manna–Whitneya.
Jak przeanalizować test A/B w pracy z marketingu?
Porównaj odsetki konwersji w obu wersjach testem dla dwóch proporcji (albo chi-kwadrat 2 × 2) i podaj różnicę w punktach procentowych z 95% CI Newcombe’a, a obok ryzyko względne. Liczebność zaplanuj przed startem testu i przeprowadź jeden test na końcu. Sprawdzanie wyniku co kilka dni i kończenie testu przy pierwszym p < .05 wielokrotnie zwiększa ryzyko fałszywego alarmu.
Czy wynik nieistotny w teście A/B oznacza, że obie wersje działają tak samo?
Nie. Przy małych odsetkach zakupów nawet kilka tysięcy osób to często za mało, by wykryć różnicę ważną dla sklepu. Spójrz na przedział ufności: jeśli obejmuje zarówno zero, jak i duży wzrost, badanie nie rozstrzyga, która wersja jest lepsza. Napisz o tym wprost i podaj, jaka liczebność byłaby potrzebna.
Jak sprawdzić, czy etykieta albo reklama działa na intencję zakupu przez zaufanie do marki?
Najlepiej w eksperymencie: losowo przydziel osoby do wersji z etykietą i bez niej, zmierz zaufanie (mediator) i intencję zakupu (wynik). Oszacuj ścieżki a i b regresją, a efekt pośredni ab przetestuj przedziałem bootstrap z co najmniej 5000 prób. Nie opieraj wniosku na krokach Barona i Kenny’ego ani na samej nieistotności efektu bezpośredniego.
Czy wyniki ankiety udostępnionej w mediach społecznościowych mogę uogólnić na konsumentów?
Nie wprost. Taka próba jest dobrana wygodnie: odpowiadają osoby zainteresowane tematem i podobne do autora. Odsetki, np. NPS albo odsetek klientów marki, opisuj jako cechę badanej grupy. Ostrożniej, ale z większym sensem, możesz wnioskować o związkach między zmiennymi, np. postawą wobec marki a intencją zakupu, opisując ograniczenia doboru próby.
Powiązane hasła
Przeczytaj też
Segmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikKalkulator tabeli 2×2 i r×c
Chi-kwadrat, test dokładny Fishera, V Craméra i reszty dla tabel do 5 × 5, a dla 2 × 2 także OR, RR i różnica odsetków z przedziałami ufności.
Czytaj →Piszesz pracę z marketingu i masz dane z ankiety albo testu A/B?
Pomożemy dobrać analizy do Twojego badania – skal postaw, NPS, eksperymentu albo segmentacji – policzyć je z wielkością efektu i wyjaśnić tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baumgartner, H., & Steenkamp, J.-B. E. M. (2001). Response styles in marketing research: A cross-national investigation. Journal of Marketing Research, 38(2), 143–156. https://doi.org/10.1509/jmkr.38.2.143.18840 ● Otwarty dostęp: pełny tekst
- Churchill, G. A. (1979). A paradigm for developing better measures of marketing constructs. Journal of Marketing Research, 16(1), 64–73. https://doi.org/10.1177/002224377901600110
- Dawes, J. G. (2024). Net Promoter and revenue growth: An examination across three industries. Australasian Marketing Journal, 32(1), 4–18. https://doi.org/10.1177/14413582221132039
- Keiningham, T. L., Cooil, B., Andreassen, T. W., & Aksoy, L. (2007). A longitudinal examination of net promoter and firm revenue growth. Journal of Marketing, 71(3), 39–51. https://doi.org/10.1509/jmkg.71.3.039
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Punj, G., & Stewart, D. W. (1983). Cluster analysis in marketing research: Review and suggestions for application. Journal of Marketing Research, 20(2), 134–148. https://doi.org/10.1177/002224378302000204
- Zhao, X., Lynch, J. G., & Chen, Q. (2010). Reconsidering Baron and Kenny: Myths and truths about mediation analysis. Journal of Consumer Research, 37(2), 197–206. https://doi.org/10.1086/651257 ● Otwarty dostęp
Cytowania BibTeX
@article{baumgartner2001response, author={Baumgartner, Hans and Steenkamp, Jan-Benedict E. M.}, title={{Response styles in marketing research: A cross-national investigation}}, journal={Journal of Marketing Research}, year={2001}, volume={38}, number={2}, pages={143--156}, doi={10.1509/jmkr.38.2.143.18840}}@article{churchill1979paradigm, author={Churchill, Gilbert A.}, title={{A paradigm for developing better measures of marketing constructs}}, journal={Journal of Marketing Research}, year={1979}, volume={16}, number={1}, pages={64--73}, doi={10.1177/002224377901600110}}@article{dawes2024net, author={Dawes, John G.}, title={{Net Promoter and revenue growth: An examination across three industries}}, journal={Australasian Marketing Journal}, year={2024}, volume={32}, number={1}, pages={4--18}, doi={10.1177/14413582221132039}}@article{keiningham2007longitudinal, author={Keiningham, Timothy L. and Cooil, Bruce and Andreassen, Tor Wallin and Aksoy, Lerzan}, title={{A longitudinal examination of net promoter and firm revenue growth}}, journal={Journal of Marketing}, year={2007}, volume={71}, number={3}, pages={39--51}, doi={10.1509/jmkg.71.3.039}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{podsakoff2003common, author={Podsakoff, Philip M. and MacKenzie, Scott B. and Lee, Jeong-Yeon and Podsakoff, Nathan P.}, title={{Common method biases in behavioral research: A critical review of the literature and recommended remedies}}, journal={Journal of Applied Psychology}, year={2003}, volume={88}, number={5}, pages={879--903}, doi={10.1037/0021-9010.88.5.879}}@article{punj1983cluster, author={Punj, Girish and Stewart, David W.}, title={{Cluster analysis in marketing research: Review and suggestions for application}}, journal={Journal of Marketing Research}, year={1983}, volume={20}, number={2}, pages={134--148}, doi={10.1177/002224378302000204}}@article{zhao2010reconsidering, author={Zhao, Xinshu and Lynch, John G. and Chen, Qimei}, title={{Reconsidering Baron and Kenny: Myths and truths about mediation analysis}}, journal={Journal of Consumer Research}, year={2010}, volume={37}, number={2}, pages={197--206}, doi={10.1086/651257}}