Kiedy potrzebujesz analizy mediacji?
Wiesz już, że studenci z wyższym stresem gorzej śpią. Promotor zadaje jednak kolejne pytanie: dlaczego? Może stres odbiera sen dlatego, że uruchamia ruminacje – uporczywe, powracające myśli o problemach, które nie pozwalają zasnąć. To pytanie o mediację: czy związek zmiennej niezależnej X ze zmienną zależną Y przebiega – choćby częściowo – przez trzecią zmienną M, nazywaną mediatorem. MacKinnon i in. (2007) definiują mediator jako zmienną, która przekazuje wpływ zmiennej niezależnej na zależną, i odróżniają go od zmiennych zakłócających, moderatorów i kowariantów.
Mediacja odpowiada na pytania „dlaczego?” i „jak?”, a moderacja – na pytania „kiedy?” i „dla kogo?”. Jeśli Twoja hipoteza mówi, że siła związku zależy od trzeciej zmiennej, przejdź do poradnika analiza moderacji krok po kroku. Krótką definicję znajdziesz w haśle mediacja (analiza mediacji). Tutaj przechodzimy przez całą analizę: od hipotezy, przez makro PROCESS w SPSS i pakiet lavaan w R, po modele z dwoma mediatorami, moc i gotowy opis w stylu APA.
Przez większość tekstu pracujemy na jednym zbiorze danych (dane symulowane): 200 studentów wypełniło skalę stresu (0–40 punktów), skalę ruminacji (10–40) i skalę jakości snu (0–30; wyższy wynik oznacza lepszy sen). Do modeli z dwoma mediatorami użyjemy drugiego przykładu. Wszystkie liczby pochodzą z kodu z sekcji Przykład w R.
Krok 1. Sformułuj hipotezę mediacyjną i narysuj model
Hipoteza mediacyjna łączy dwa ogniwa w łańcuch: X → M i M → Y. W przykładzie brzmi ona: „Wyższy stres wiąże się z silniejszymi ruminacjami, a silniejsze ruminacje – przy tym samym poziomie stresu – z gorszą jakością snu; dlatego stres wiąże się z gorszym snem pośrednio, przez ruminacje”. Taką hipotezę badawczą sformułuj przed zebraniem danych i zapisz kierunek obu ścieżek, najlepiej w prerejestracji.
Prosty model mediacji (w makrze PROCESS: model 4) to dwa równania regresji liniowej. Efekt całkowity daje trzecia regresja – Y na samym X:
Y = iY + c′X + bM + eY
Y = i + cX + e
Z tych równań powstaje pięć wielkości, które opiszesz w pracy:
- a – związek X z mediatorem;
- b – związek mediatora z Y przy kontroli X;
- efekt pośredni ab – iloczyn obu ścieżek, czyli część związku X z Y przenoszona przez M;
- efekt bezpośredni c′ – związek X z Y przy stałym poziomie mediatora;
- efekt całkowity c – suma obu dróg, c = c′ + ab. Ta równość zachodzi dokładnie, gdy M i Y są zmiennymi ilościowymi, a modele szacuje się zwykłą metodą najmniejszych kwadratów.
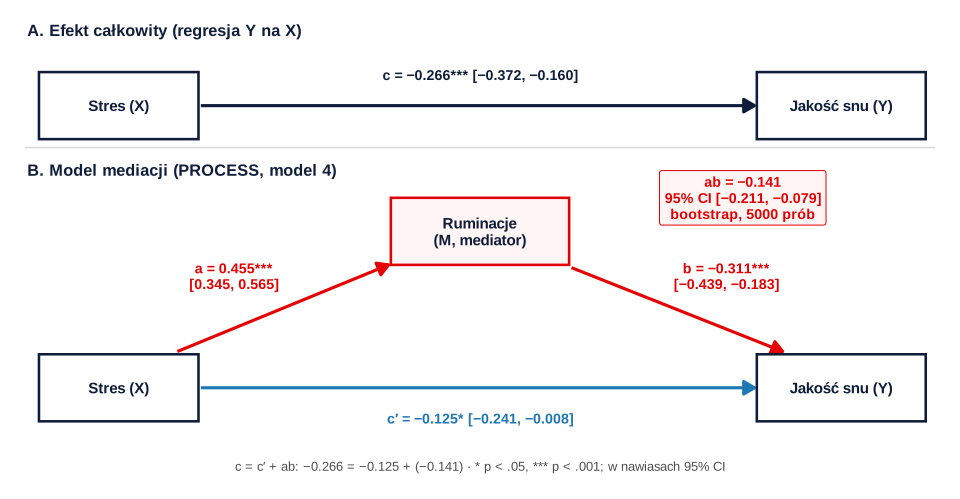
Model rysuje się jako wykres ścieżkowy. Rysunek 1 pokazuje go od razu z wynikami, które omawiamy w krokach 3 i 4: u góry efekt całkowity, u dołu ten sam związek rozłożony na drogę pośrednią (czerwone strzałki) i bezpośrednią (niebieska).
Takie modele – z efektami bezpośrednimi i pośrednimi szacowanymi w ramach regresji metodą najmniejszych kwadratów – opisuje podręcznik Hayesa (2022), na którym opiera się makro PROCESS. Przykład zastosowania makra w badaniach klinicznych, razem z omówieniem popularnych mitów wokół analizy mediacji, pokazują Hayes i Rockwood (2017).
Krok 2. Opisz dane i sprawdź korelacje
Średni stres wyniósł M = 18.78 (SD = 6.29), ruminacje M = 22.91 (SD = 5.72), a jakość snu M = 16.72 (SD = 5.04). Stres korelował dodatnio z ruminacjami, r = .50, i ujemnie z jakością snu, r = −.33, a ruminacje korelowały z jakością snu ujemnie, r = −.43 (wszystkie p < .001). Korelacje Pearsona pasują do hipotezy, ale jej nie testują – żadna z nich nie mówi, jaka część związku stresu ze snem przebiega przez ruminacje.
Zanim przejdziesz dalej, sprawdź to samo, co przed każdą regresją: zakresy wyników (czy nie ma błędów kodowania), braki danych, obserwacje odstające i liniowość związków. Zwróć też uwagę na kierunek skal. Jakość snu jest tu kodowana „im więcej, tym lepiej”, więc ścieżki b i c wyjdą ujemne, a efekt pośredni również będzie ujemny. To nie błąd, tylko konsekwencja kodowania – gdyby Y oznaczało problemy ze snem, wszystkie znaki byłyby dodatnie.
Krok 3. Oszacuj ścieżki a, b, c′ i c
Model 4 to w gruncie rzeczy dwie regresje: ruminacji na stres oraz jakości snu na stres i ruminacje. Efekt całkowity daje trzecia regresja – jakości snu na sam stres. Wyniki zebraliśmy w tabeli poniżej (współczynniki niestandaryzowane z 95% przedziałami ufności z regresji, β – współczynniki standaryzowane).
| Ścieżka | Równanie | b [95% CI] | SE | t | p | β |
|---|---|---|---|---|---|---|
| a | ruminacje na stres | 0.455 [0.345, 0.565] | 0.056 | 8.15 | < .001 | 0.50 |
| b | jakość snu na ruminacje (przy kontroli stresu) | −0.311 [−0.439, −0.183] | 0.065 | −4.79 | < .001 | −0.35 |
| c′ | jakość snu na stres (przy kontroli ruminacji) | −0.125 [−0.241, −0.008] | 0.059 | −2.12 | .036 | −0.16 |
| c | jakość snu na stres (bez mediatora) | −0.266 [−0.372, −0.160] | 0.054 | −4.95 | < .001 | −0.33 |
Jak czytać te liczby:
- a = 0.455 – osoby, których stres jest wyższy o 1 punkt, mają średnio o 0.46 punktu silniejsze ruminacje (o 10 punktów stresu – o 4.6 punktu).
- b = −0.311 – przy tym samym stresie osoba ruminująca silniej o 1 punkt ma średnio o 0.31 punktu gorszą jakość snu.
- c′ = −0.125 – przy tym samym poziomie ruminacji stres wyższy o 1 punkt wiąże się z jakością snu niższą o 0.12 punktu.
- c = −0.266 – bez uwzględnienia ruminacji każdy punkt stresu wiąże się z jakością snu niższą o 0.27 punktu.
Efekt pośredni to iloczyn ścieżek: ab = 0.455 × (−0.311) = −0.141. Sprawdź rachunek: c′ + ab = −0.125 + (−0.141) = −0.266, czyli dokładnie c. Efekt całkowity rozkłada się więc na część przenoszoną przez ruminacje i część, która zostaje poza nimi. Stres wyższy o 10 punktów to średnio o 2.66 punktu gorsza jakość snu, z czego 1.41 punktu przypada na drogę przez ruminacje.
Model wyjaśniał 25% wariancji ruminacji, R² = .25, F(1, 198) = 66.40, p < .001, i 20% wariancji jakości snu, R² = .20, F(2, 197) = 25.09, p < .001. Istotność poszczególnych ścieżek to jednak tylko tło. O mediacji mówi efekt pośredni, a tego nie da się rzetelnie sprawdzić zwykłym testem t.
Krok 4. Przetestuj efekt pośredni bootstrapem
Efekt pośredni ab jest iloczynem dwóch oszacowań, a rozkład takiego iloczynu zwykle nie jest normalny. Dlatego standardem jest bootstrap percentylowy:
- z danych losujesz ze zwracaniem próbę 200 osób (niektóre osoby trafią do niej kilka razy, inne wcale);
- w wylosowanej próbie szacujesz obie regresje i liczysz ab;
- powtarzasz to 5000 razy;
- za granice 95% przedziału ufności przyjmujesz 2.5. i 97.5. percentyl otrzymanych 5000 wartości ab.
Jeśli przedział nie obejmuje zera, efekt pośredni jest istotny na poziomie .05. W przykładzie ab = −0.141, 95% CI [−0.211, −0.079]. Rysunek 2 pokazuje, skąd wzięły się te granice.
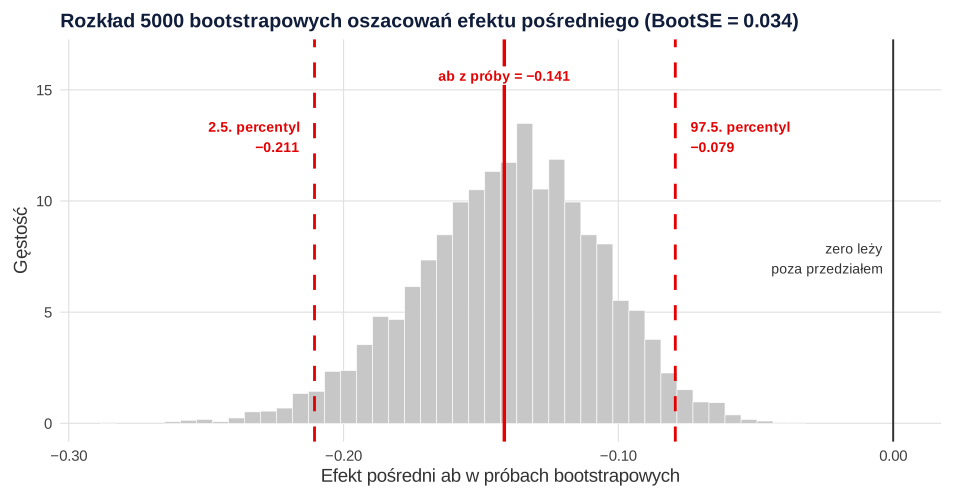
Odchylenie standardowe 5000 oszacowań wynosi 0.034 – to bootstrapowy błąd standardowy (w PROCESS kolumna BootSE). Rozkład jest lekko asymetryczny (skośność −0.28): dolna granica leży 0.069 poniżej oszacowania, a górna – 0.062 powyżej. Żadna z 5000 prób nie dała wartości dodatniej. Granice zależą jednak od wylosowanych prób, więc przy innym ziarnie generatora albo w innym programie mogą się różnić w trzecim miejscu dziesiętnym. Dlatego zawsze podawaj liczbę prób i ustaw ziarno: w lavaan argument iseed, w PROCESS opcję seed.
Jaki przedział wybrać? Hayes i Scharkow (2013) porównali popularne testy efektu pośredniego: zgadzają się one znacznie częściej, niż się różnią, a rozbieżności zdarzają się częściej wtedy, gdy efekt pośredni istnieje, niż gdy go nie ma. Przedział bootstrap z korektą obciążenia (bias-corrected) autorzy polecają, gdy najważniejsza jest moc, choć w niektórych warunkach bywa nieco liberalny, a bootstrap percentylowy uznają za dobry kompromis. Metody ponownego próbkowania do oceny efektów pośrednich – także w modelach z kilkoma mediatorami – omawiają Preacher i Hayes (2008). Jak bootstrap działa w modelach strukturalnych, wyjaśniamy w haśle bootstrap w SEM.
Dlaczego nie kroki Barona i Kenny’ego ani test Sobela?
Klasyczny artykuł Barona i Kenny’ego (1986) uporządkował różnice między moderatorami i mediatorami oraz zebrał procedury ich analizy. Wyrosło z niego podejście przyczynowych kroków: najpierw istotny efekt całkowity c, potem istotne a i b, a na koniec spadek efektu X po dodaniu mediatora. Ma ono dwie wady. Po pierwsze, w ogóle nie testuje ab. Po drugie, wymóg istotnego c drastycznie obniża moc: Fritz i MacKinnon (2007) wyliczyli, że przy małych ścieżkach a i b (0.14 w jednostkach standaryzowanych) i zerowym efekcie bezpośrednim test przyczynowych kroków potrzebuje 20 886 osób, by osiągnąć moc .80, a bootstrap percentylowy – 558 osób.
Zhao i in. (2010) zwracają uwagę, że wiele projektów badawczych przerywano – na wczesnym etapie albo w trakcie recenzji – tylko dlatego, że dane nie spełniały kryteriów Barona i Kenny’ego, co hamowało rozwój teorii. Rucker i in. (2011) idą dalej: koncentrowanie się na istotności związku X–Y przed dodaniem mediatora i po nim uznają za nieuzasadnione, a uwagę każą przenieść na wielkość i istotność efektu pośredniego.
Test Sobela dzieli ab przez błąd standardowy obliczony ze wzoru i porównuje wynik z rozkładem normalnym. W przykładzie dałby z = −4.13, p < .001 i symetryczny przedział [−0.209, −0.074] – wniosek ten sam. Test zakłada jednak normalność rozkładu ab, a w symulacjach Fritza i MacKinnona (2007) przy małych ścieżkach potrzebował 667 osób do mocy .80, czyli więcej niż bootstrap. W pracy podawaj więc przedział bootstrapowy, a test Sobela najwyżej jako uzupełnienie.
Krok 5. Oceń wielkość efektu pośredniego
Istotny efekt pośredni to dopiero połowa odpowiedzi – czytelnik chce też wiedzieć, czy jest duży. Preacher i Kelley (2011) zauważają, że sposobom raportowania wielkości efektu w mediacji poświęcano niewiele uwagi; formułują wymagania wobec takich miar, oceniają dotychczasowe wskaźniki i proponują nowe. W pracy dyplomowej zwykle wystarczą dwie miary:
- Efekt pośredni w jednostkach skali: ab = −0.141 punktu jakości snu na każdy punkt stresu. To najbardziej konkretna informacja, gdy skale są znane czytelnikowi.
- W pełni standaryzowany efekt pośredni (ang. completely standardized indirect effect): abcs = ab × SDX / SDY. Mówi, o ile odchyleń standardowych różni się Y za pośrednictwem M u osób różniących się o jedno odchylenie standardowe X. W przykładzie abcs = −0.141 × 6.29 / 5.04 = −0.176, 95% CI [−0.264, −0.097].
Gdy X jest zmienną dwuwartościową (np. grupa eksperymentalna i kontrolna), odchylenie standardowe X nie ma sensu. Stosuje się wtedy efekt częściowo standaryzowany, ab / SDY, który czyta się podobnie jak d Cohena – przykład znajdziesz w haśle o efekcie pośrednim. Nie przypisuj miarom standaryzowanym progów „mały – średni – duży” bez uzasadnienia; więcej o interpretacji w poradniku wielkość efektu.
Popularny jest też odsetek mediacji, czyli ab / c – w przykładzie 53%. Traktuj go ostrożnie: MacKinnon i in. (2007) przypominają, że jest niestabilny, dopóki próba nie liczy co najmniej 500 osób, a przy przeciwnych znakach ab i c′ przestaje być odsetkiem. Szerzej piszemy o tym w haśle mediacja częściowa.
Mediacja całkowita czy częściowa? Lepiej opisz liczby
W przykładzie efekt bezpośredni pozostał istotny (c′ = −0.125, p = .036), więc w starszej terminologii nazwano by to mediacją częściową, a gdyby c′ był nieistotny – mediacją całkowitą. Ten podział opiera się na teście istotności c′, który zależy od liczebności próby. Przedział dla c′ kończy się tu na −0.008, więc w nieco mniejszej próbie ta sama mediacja mogłaby wyjść „całkowita”. Rucker i in. (2011) wskazują, że rozstrzyganie na podstawie istotności związku X–Y, czy mediator wyjaśnia efekt w pełni, czy częściowo, jest nieuzasadnione. Zamiast etykiety podaj ab, c′ i c z przedziałami ufności.
Odwrotna sytuacja też się zdarza: efekt pośredni bywa istotny, choć efekt całkowity nie jest. Tak dzieje się na przykład wtedy, gdy droga pośrednia i bezpośrednia mają przeciwne znaki i częściowo się znoszą (zob. supresja). Dlatego nieistotne c nie jest powodem do rezygnacji z analizy mediacji, o ile hipoteza mediacyjna była sformułowana wcześniej.
Mediacja w SPSS: PROCESS, model 4 krok po kroku
PROCESS to bezpłatne makro Andrew F. Hayesa do SPSS, SAS i R, opisane w jego podręczniku (Hayes, 2022). W SPSS najwygodniej używać go przez okno dialogowe:
- Pobierz PROCESS ze strony autora i zainstaluj plik okna dialogowego (Extensions → Utilities → Install Custom Dialog). Na komputerach uczelnianych może to wymagać uprawnień administratora.
- Otwórz Analiza → Regresja → PROCESS (Analyze → Regression → PROCESS).
- Przenieś jakość snu do pola Y variable, stres do pola X variable, a ruminacje do pola Mediator(s) M. Zmienne kontrolne trafiają do pola Covariate(s).
- Z listy Model number wybierz 4.
- Pozostaw 95% poziom ufności i 5000 prób bootstrap (Number of bootstrap samples).
- W Options zaznacz Show total effect model (efekt całkowity c) oraz opcję efektów standaryzowanych (w zależności od wersji makra nazywa się ona nieco inaczej). Przy dwóch mediatorach zaznacz także Pairwise contrasts of indirect effects.
- Kliknij OK.
To samo w składni, z ustalonym ziarnem generatora: process y=sen /x=stres /m=ruminacje /model=4 /total=1 /boot=5000 /seed=2026. Polecenie zadziała po uruchomieniu w tej samej sesji SPSS pliku z definicją makra (process.sps).
W wyniku znajdziesz kolejno: regresję mediatora (ścieżka a w wierszu ze stresem), regresję Y (ścieżki c′ i b), model efektu całkowitego oraz zestawienie efektów całkowitego, bezpośredniego i pośredniego. Efekt pośredni ma tam kolumny Effect, BootSE, BootLLCI i BootULCI – dwie ostatnie to dolna i górna granica przedziału bootstrapowego. Współczynniki PROCESS są identyczne z tymi z kroku 3, a granice bootstrapowe mogą się nieznacznie różnić od podanych tutaj, bo zależą od wylosowanych prób. Jeśli Twoja wersja makra nie wypisuje efektu standaryzowanego, policz go ze wzoru z kroku 5.
Bez PROCESS oszacujesz w SPSS obie regresje (Analiza → Regresja → Liniowa), ale nie dostaniesz przedziału bootstrapowego dla iloczynu ab – a to on jest testem mediacji. Model 4 policzysz także w programie jamovi (moduł medmod).
To samo w R: lavaan i parametry zdefiniowane
W R model mediacji najwygodniej zapisać w pakiecie lavaan, służącym do modelowania równań strukturalnych. Składnia ma trzy elementy:
~– równanie regresji, np.ruminacje ~ a * stres; mnożnik przed zmienną to etykieta ścieżki;~~– wariancja albo kowariancja; w przykładzie etykietujemy wariancje, bo posłużą do standaryzacji;:=– parametr zdefiniowany, czyli dowolna funkcja etykiet:ab := a * b(efekt pośredni),c_calk := cp + a * b(efekt całkowity) albo w pełni standaryzowany efekt pośredni.
Argument se = "bootstrap" z bootstrap = 5000 sprawia, że lavaan powtarza estymację w 5000 próbach bootstrapowych, a parameterEstimates(fit, boot.ci.type = "perc") zwraca przedziały percentylowe dla wszystkich parametrów, także zdefiniowanych. Argument iseed = 2026 ustala ziarno generatora – bez niego granice zmieniają się przy każdym uruchomieniu. fixed.x = FALSE traktuje X jako zmienną losową, więc jej wariancja staje się parametrem modelu potrzebnym do standaryzacji.
Współczynniki z lavaan są takie same jak z regresji (np. c′ = −0.125), ale przedziały ufności ścieżek pochodzą z bootstrapu, więc nieco różnią się od przedziałów z lm(): dla c′ wynoszą [−0.249, −0.008] zamiast [−0.241, −0.008]. Pełny kod i wynik znajdziesz w sekcji Przykład w R, a szerszy przykład pracy z tym pakietem – w poradniku CB-SEM w R (lavaan). Jeśli mediator albo Y mierzysz kilkoma pozycjami i chcesz uwzględnić błąd pomiaru, ten sam model zapiszesz ze zmiennymi latentnymi.
Mediacja równoległa: dwa mediatory naraz
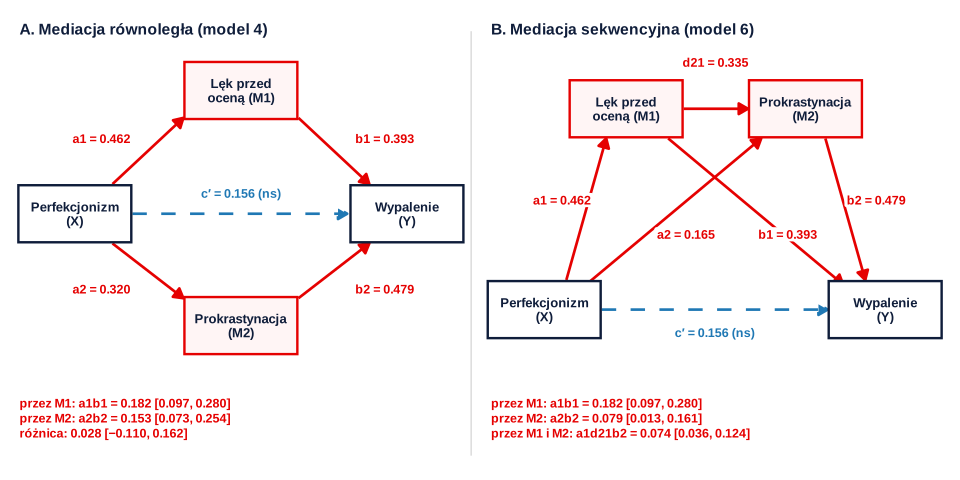
Rzadko jeden mediator wyjaśnia cały związek. Drugi przykład (dane symulowane, N = 250) dotyczy perfekcjonizmu – obaw przed popełnieniem błędu (skala 1–5) – i wypalenia akademickiego (1–7). Hipoteza zakłada dwie drogi: perfekcjonizm nasila lęk przed oceną (M1) i prokrastynację (M2), a obie te zmienne wiążą się z silniejszym wypaleniem. W modelu równoległym (w PROCESS: model 4 z dwoma mediatorami) oba mediatory wchodzą jednocześnie do regresji Y, a ich reszty mogą korelować. Preacher i Hayes (2008) opisują, jak w takim modelu oceniać i porównywać efekty pośrednie przez różne mediatory.
Model równoległy daje trzy rodzaje efektów pośrednich:
- specyficzne efekty pośrednie: przez lęk przed oceną a1b1 = 0.182, 95% CI [0.097, 0.280], i przez prokrastynację a2b2 = 0.153, 95% CI [0.073, 0.254];
- łączny efekt pośredni, czyli ich suma: 0.335, 95% CI [0.219, 0.464];
- kontrast, czyli różnica specyficznych efektów: 0.028, 95% CI [−0.110, 0.162].
Oba specyficzne efekty są istotne, ale kontrast nie – dane nie pozwalają stwierdzić, że któryś mediator przenosi więcej. To częsta pułapka: z tego, że jeden efekt pośredni ma węższy przedział albo mniejsze p, nie wynika, że jest większy od drugiego. Porównania testuj kontrastem, i to tylko wtedy, gdy mediatory mierzono na porównywalnych skalach (tu obie mają zakres 1–5).
Efekt bezpośredni perfekcjonizmu przy kontroli obu mediatorów wyniósł c′ = 0.156, 95% CI [−0.045, 0.343], a efekt całkowity c = 0.491, 95% CI [0.317, 0.655]. Nieistotny c′ nie znaczy, że poza dwoma mediatorami nic już nie zostało: przedział obejmuje zarówno zero, jak i wartości porównywalne z każdym z efektów pośrednich.
Mediacja sekwencyjna: łańcuch dwóch mediatorów
A jeśli lęk przed oceną prowadzi do prokrastynacji (odkładam pisanie, bo boję się oceny), a dopiero prokrastynacja – do wypalenia? To model sekwencyjny, nazywany też seryjnym (w PROCESS: model 6). Do modelu równoległego dochodzi ścieżka d21 od M1 do M2, a z nią trzecia droga pośrednia X → M1 → M2 → Y o wartości a1d21b2 (rysunek 3B).
Na tych samych danych d21 = 0.335, 95% CI [0.216, 0.458], a droga przez oba mediatory wyniosła 0.074, 95% CI [0.036, 0.124]. Efekt pośredni „tylko przez prokrastynację” zmalał z 0.153 do 0.079, 95% CI [0.013, 0.161], bo część tej drogi przypisaliśmy teraz łańcuchowi. Zwróć uwagę na to, czego model nie zmienił: łączny efekt pośredni (0.335) i efekt bezpośredni (0.156) są w obu modelach identyczne. Oba modele odtwarzają dane równie dobrze, a różnią się tylko podziałem efektu pośredniego między drogi.
O wyborze między modelem równoległym a sekwencyjnym decyduje więc teoria i plan badania, a nie dopasowanie. Rohrer i in. (2022) wyjaśniają, że ani odwracanie strzałek, ani porównywanie wskaźników dopasowania nie rozstrzyga, który model jest właściwy. Model sekwencyjny wymaga ponadto mocniejszych założeń o kolejności zmiennych – najlepiej, gdy mediatory mierzono w kolejnych falach badania.
Czego analiza mediacji nie udowodni: plan badania
Strzałki na diagramie wyglądają jak opis mechanizmu, ale analiza mediacji to wciąż analiza związków. Rohrer i in. (2022) podkreślają, że standardowe procedury analizy mediacji prowadzą do trafnych wniosków przyczynowych tylko w ograniczonych warunkach. Trzy zagrożenia warto omówić w ograniczeniach każdej pracy:
- Kolejność w czasie. Mediacja to proces: X musi poprzedzać M, a M – Y. W schemacie przekrojowym wszystkie zmienne mierzy się naraz, więc te same korelacje pasują też do odwrotnego łańcucha (źle śpię, więc rozmyślam i czuję się zestresowany).
- Obciążenie danych przekrojowych. Maxwell i Cole (2007) pokazali, że przekrojowa analiza procesu, który w rzeczywistości rozwija się w czasie, daje zwykle wyraźnie obciążone oszacowania – nawet w idealnych warunkach, gdy mediacja jest pełna. Efekt bezpośredni, efekt pośredni i odsetek mediacji mogą wtedy poważnie wprowadzać w błąd. Lepszy jest schemat podłużny z pomiarem X, M i Y w kolejnych falach (zob. też modele cross-lagged).
- Zmienne zakłócające. Ścieżka b opisuje korelacyjny związek mediatora z Y. Jeśli obie zmienne zależą od czegoś trzeciego – na przykład od neurotyczności albo nastroju depresyjnego – b i ab będą obciążone. Mierz takie zmienne zakłócające i uwzględniaj je jako kowarianty (w PROCESS pole Covariate(s)).
Nawet eksperyment nie rozwiązuje wszystkiego. Bullock i in. (2010) przypominają, że analizy mediacji na danych nieeksperymentalnych są prawdopodobnie obciążone, a i eksperyment nie usuwa części zagrożeń typowych dla mediacji; wnioski o mediatorach najlepiej budować w programie eksperymentów zaprojektowanych specjalnie w tym celu. Losowy przydział do warunków chroni przed zakłóceniami ścieżkę a i efekt całkowity, ale związek mediatora z Y pozostaje korelacyjny, dopóki nie manipulujesz także mediatorem (zob. manipulacja eksperymentalna). W pracy dyplomowej pisz ostrożnie: „wyniki są zgodne z hipotezą, że ruminacje pośredniczą w związku stresu z jakością snu”, a nie „ruminacje powodują, że stres pogarsza sen”.
Ile osób potrzebujesz? Moc w analizie mediacji
Moc testu efektu pośredniego zależy od obu ścieżek jednocześnie – wystarczy, że jedna z nich jest słaba, by efekt był trudny do wykrycia. Fritz i MacKinnon (2007) podali liczebności potrzebne do osiągnięcia mocy .80 dla sześciu testów mediacji. Dla bootstrapu percentylowego przy obu ścieżkach małych (0.14 w jednostkach standaryzowanych) było to 558 osób, przy obu średnich (0.39) – 78, a przy obu dużych (0.59) – 36. Autorzy podkreślają, że to dolne granice: w symulacji zmienne mierzono bez błędu, a błąd pomiaru zwiększa potrzebną liczebność.
Dla własnego modelu moc najlepiej oszacować symulacją. Schoemann i in. (2017) zwracają uwagę, że zalecana symulacja Monte Carlo z bootstrapowym testem efektu pośredniego jest rzadko stosowana – z braku wygodnych narzędzi i z powodu czasu obliczeń – i udostępniają aplikację, która ten proces upraszcza. W naszej symulacji dla każdej liczebności wygenerowaliśmy 2000 zbiorów danych, a efekt pośredni w każdym oceniliśmy przedziałem Monte Carlo (5000 losowań a × b), który liczy się dużo szybciej niż bootstrap. Pierwszy scenariusz ma ścieżki jak w przykładzie (standaryzowane a = 0.50, b = −0.35, c′ = −0.15), drugi – obie ścieżki o połowę słabsze.
| N | Moc: ścieżki jak w przykładzie | Moc: ścieżki o połowę słabsze |
|---|---|---|
| 50 | .59 | .09 |
| 75 | .80 | .16 |
| 100 | .91 | .27 |
| 150 | .98 | .49 |
| 200 | .99 | .65 |
| 300 | > .99 | .85 |
| 400 | > .99 | .93 |
| 600 | > .99 | .99 |
Przy ścieżkach takich jak w przykładzie moc .80 daje już 75 osób. Gdy obie ścieżki są o połowę słabsze, efekt pośredni maleje czterokrotnie i moc .85 osiąga się dopiero przy 300 osobach, a przy 100 osobach wynosi ona .27. Nie planuj więc próby na podstawie optymistycznych korelacji z jednego małego badania. Ogólne zasady uzasadniania liczebności opisujemy w poradniku dobór liczebności próby.
Jak opisać analizę mediacji w pracy (APA)
W części o metodzie i w wynikach podaj:
- hipotezę z kierunkiem ścieżek, rolę zmiennych (X, M, Y) i kowarianty;
- program i model (np. PROCESS, model 4, albo lavaan), liczbę prób bootstrap i rodzaj przedziału (percentylowy);
- ścieżki a, b, c′ i c z błędami standardowymi, testami i 95% CI;
- efekt pośredni ab z bootstrapowym 95% CI i miarą wielkości efektu (np. abcs);
- ograniczenia wynikające z planu badania (kolejność pomiaru, możliwe zakłócenia).
Gotowy opis dla przykładu z jednym mediatorem:
W modelu z dwoma mediatorami dopisz specyficzne efekty pośrednie i kontrast:
Pełne wyniki zbierz w tabeli. Poniżej wzór dla pierwszego przykładu; inne warianty znajdziesz w haśle tabela mediacji w APA, a ogólne zasady zapisu statystyk – w poradniku jak opisać wyniki w stylu APA.
Tabela 1
Ruminacje jako mediator związku stresu z jakością snu
| Efekt | b | SE | 95% CI | β | p | |
|---|---|---|---|---|---|---|
| LL | UL | |||||
| a: stres → ruminacje | 0.455 | 0.056 | 0.345 | 0.565 | 0.50 | < .001 |
| b: ruminacje → jakość snu | −0.311 | 0.065 | −0.439 | −0.183 | −0.35 | < .001 |
| c′: efekt bezpośredni | −0.125 | 0.059 | −0.241 | −0.008 | −0.16 | .036 |
| c: efekt całkowity | −0.266 | 0.054 | −0.372 | −0.160 | −0.33 | < .001 |
| ab: efekt pośredni | −0.141 | 0.034 | −0.211 | −0.079 | −0.18 | — |
Uwaga. N = 200. b – współczynniki niestandaryzowane; β – współczynniki standaryzowane (dla efektu pośredniego – efekt w pełni standaryzowany). Dla ścieżek podano błędy standardowe i przedziały ufności z regresji metodą najmniejszych kwadratów, dla efektu pośredniego – bootstrapowy błąd standardowy i percentylowy 95% CI z 5000 prób. R² = .25 dla ruminacji i R² = .20 dla jakości snu. LL i UL – dolna i górna granica przedziału ufności. Dane symulowane.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Uruchom przepisy po kolei w jednej sesji R – przepis 2 korzysta z danych z przepisu 1. Przepisy 2 i 3 wykonują po 5000 prób bootstrap i trwają po kilkadziesiąt sekund, a symulacja mocy – około pół minuty.
1. Dane, statystyki opisowe i ścieżki z regresji
R
# Dane symulowane: stres (0–40), ruminacje (10–40), jakość snu (0–30; wyżej = lepszy sen), N = 200
set.seed(101)
n <- 200
z_stres <- rnorm(n)
z_rum   <- 0.45 * z_stres + sqrt(1 - 0.45^2) * rnorm(n)
z_sen   <- -0.30 * z_rum - 0.15 * z_stres + rnorm(n, sd = 0.90)
stres     <- pmin(pmax(round(19 + 6.5 * z_stres), 0), 40)
ruminacje <- pmin(pmax(round(23 + 6 * z_rum), 10), 40)
sen       <- pmin(pmax(round(17 + 5 * z_sen / sd(z_sen)), 0), 30)
dane <- data.frame(stres, ruminacje, sen)

# Statystyki opisowe i korelacje
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2)
round(cor(dane), 2)

# Model 4 to dwie regresje (tak liczy go PROCESS) plus regresja dla efektu całkowitego
m_a <- lm(ruminacje ~ stres, data = dane)          # ścieżka a
m_b <- lm(sen ~ stres + ruminacje, data = dane)    # efekt bezpośredni c' i ścieżka b
m_c <- lm(sen ~ stres, data = dane)                # efekt całkowity c
round(cbind(coef(summary(m_a)), confint(m_a)), 3)
round(cbind(coef(summary(m_b)), confint(m_b)), 3)
round(cbind(coef(summary(m_c)), confint(m_c)), 3)

# Efekt pośredni ab i rozkład efektu całkowitego: c = c' + ab
a  <- coef(m_a)[["stres"]]
b  <- coef(m_b)[["ruminacje"]]
cp <- coef(m_b)[["stres"]]
c_calk <- coef(m_c)[["stres"]]
round(c(a = a, b = b, ab = a * b, cp = cp, c = c_calk, "cp + ab" = cp + a * b), 4)
Wynik w R
    stres ruminacje   sen
M   18.78     22.91 16.72
SD   6.29      5.72  5.04
min  1.00     10.00  5.00
max 33.00     38.00 30.00
          stres ruminacje   sen
stres      1.00      0.50 -0.33
ruminacje  0.50      1.00 -0.43
sen       -0.33     -0.43  1.00
            Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)   14.352      1.107  12.969        0 12.170 16.534
stres          0.455      0.056   8.149        0  0.345  0.565
            Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)   26.175      1.374  19.052    0.000 23.466 28.884
stres         -0.125      0.059  -2.115    0.036 -0.241 -0.008
ruminacje     -0.311      0.065  -4.790    0.000 -0.439 -0.183
            Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)   21.715      1.065  20.395        0 19.615 23.815
stres         -0.266      0.054  -4.951        0 -0.372 -0.160
      a       b      ab      cp       c cp + ab
 0.4553 -0.3108 -0.1415 -0.1247 -0.2662 -0.2662
2. Model 4 w lavaan z bootstrapem (5000 prób)
R
library(lavaan)   # sem(), parameterEstimates()

# Model 4 w lavaan: etykiety ścieżek i parametry zdefiniowane (:=)
model <- '
  ruminacje ~ a * stres
  sen       ~ b * ruminacje + cp * stres
  stres     ~~ vx * stres       # wariancja X
  ruminacje ~~ vm * ruminacje   # wariancja reszt mediatora
  sen       ~~ vy * sen         # wariancja reszt Y
  ab     := a * b               # efekt pośredni
  c_calk := cp + a * b          # efekt całkowity
  # w pełni standaryzowany efekt pośredni: ab × SD(X) / SD(Y), SD(Y) z wariancji modelu
  ab_std := a * b * sqrt(vx) / sqrt(cp^2 * vx + b^2 * (a^2 * vx + vm) + 2 * cp * b * a * vx + vy)
'
fit <- sem(model, data = dane, fixed.x = FALSE,
           se = "bootstrap", bootstrap = 5000, iseed = 2026)   # 5000 prób, stałe ziarno
pe <- parameterEstimates(fit, boot.ci.type = "perc", standardized = TRUE)
pe <- pe[pe$label %in% c("a", "b", "cp", "ab", "c_calk", "ab_std"),
         c("label", "est", "se", "pvalue", "ci.lower", "ci.upper", "std.all")]
pe[, -1] <- round(pe[, -1], 3)
print(pe, row.names = FALSE)
round(inspect(fit, "rsquare"), 3)   # R² mediatora i zmiennej zależnej
Wynik w R
This is lavaan 0.7-2
lavaan is FREE software! Please report any bugs.
  label    est    se pvalue ci.lower ci.upper std.all
      a  0.455 0.061  0.000    0.333    0.572   0.501
      b -0.311 0.064  0.000   -0.434   -0.180  -0.352
     cp -0.125 0.062  0.043   -0.249   -0.008  -0.155
     ab -0.141 0.034  0.000   -0.211   -0.079  -0.176
 c_calk -0.266 0.055  0.000   -0.371   -0.159  -0.332
 ab_std -0.176 0.042  0.000   -0.264   -0.097  -0.176
ruminacje       sen
    0.251     0.203
3. Mediacja równoległa i sekwencyjna
R
library(lavaan)

# Drugi przykład (dane symulowane, N = 250): perfekcjonizm (X, 1–5), lęk przed oceną (M1, 1–5),
# prokrastynacja (M2, 1–5), wypalenie akademickie (Y, 1–7)
set.seed(7)
n <- 250
zx <- rnorm(n)
z1 <- 0.50 * zx + sqrt(0.75) * rnorm(n)
z2 <- 0.15 * zx + 0.35 * z1 + rnorm(n, sd = 0.88)
zy <- 0.10 * zx + 0.25 * z1 + 0.35 * z2 + rnorm(n, sd = 0.82)
skala <- function(x, min, max, pozycji) pmin(pmax(round(x * pozycji) / pozycji, min), max)
dane2 <- data.frame(perfekcjonizm  = skala(3.0 + 0.75 * zx, 1, 5, 8),
                    lek_oceny      = skala(2.9 + 0.80 * z1, 1, 5, 6),
                    prokrastynacja = skala(2.7 + 0.75 * z2 / sd(z2), 1, 5, 10),
                    wypalenie      = skala(3.6 + 1.10 * zy / sd(zy), 1, 7, 9))
round(sapply(dane2, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane2), 2)

# Mediacja równoległa (PROCESS: model 4 z dwoma mediatorami)
model_rown <- '
  lek_oceny      ~ a1 * perfekcjonizm
  prokrastynacja ~ a2 * perfekcjonizm
  wypalenie      ~ b1 * lek_oceny + b2 * prokrastynacja + cp * perfekcjonizm
  lek_oceny ~~ prokrastynacja          # reszty mediatorów mogą korelować
  ind_lek   := a1 * b1                 # efekt pośredni przez lęk przed oceną
  ind_prok  := a2 * b2                 # efekt pośredni przez prokrastynację
  ind_razem := a1 * b1 + a2 * b2       # łączny efekt pośredni
  roznica   := a1 * b1 - a2 * b2       # kontrast dwóch efektów pośrednich
  c_calk    := cp + a1 * b1 + a2 * b2
'
fit_rown <- sem(model_rown, data = dane2, fixed.x = FALSE,
                se = "bootstrap", bootstrap = 5000, iseed = 2026)
pr <- parameterEstimates(fit_rown, boot.ci.type = "perc", standardized = TRUE)
pr <- pr[pr$label != "", c("label", "est", "se", "pvalue", "ci.lower", "ci.upper", "std.all")]
pr[, -1] <- round(pr[, -1], 3)
print(pr, row.names = FALSE)

# Mediacja sekwencyjna (PROCESS: model 6): lęk przed oceną → prokrastynacja
model_sekw <- '
  lek_oceny      ~ a1 * perfekcjonizm
  prokrastynacja ~ a2 * perfekcjonizm + d21 * lek_oceny
  wypalenie      ~ b1 * lek_oceny + b2 * prokrastynacja + cp * perfekcjonizm
  ind_lek      := a1 * b1
  ind_prok     := a2 * b2
  ind_lek_prok := a1 * d21 * b2        # droga X → M1 → M2 → Y
  ind_razem    := a1 * b1 + a2 * b2 + a1 * d21 * b2
'
fit_sekw <- sem(model_sekw, data = dane2, fixed.x = FALSE,
                se = "bootstrap", bootstrap = 5000, iseed = 2026)
ps <- parameterEstimates(fit_sekw, boot.ci.type = "perc", standardized = TRUE)
ps <- ps[ps$label != "", c("label", "est", "se", "pvalue", "ci.lower", "ci.upper", "std.all")]
ps[, -1] <- round(ps[, -1], 3)
print(ps, row.names = FALSE)
Wynik w R
   perfekcjonizm lek_oceny prokrastynacja wypalenie
M           3.07      2.94           2.72      3.57
SD          0.72      0.78           0.74      1.09
               perfekcjonizm lek_oceny prokrastynacja wypalenie
perfekcjonizm           1.00      0.43           0.31      0.32
lek_oceny               0.43      1.00           0.42      0.46
prokrastynacja          0.31      0.42           1.00      0.48
wypalenie               0.32      0.46           0.48      1.00
     label   est    se pvalue ci.lower ci.upper std.all
        a1 0.462 0.061  0.000    0.346    0.583   0.426
        a2 0.320 0.068  0.000    0.183    0.452   0.309
        b1 0.393 0.083  0.000    0.231    0.557   0.283
        b2 0.479 0.093  0.000    0.294    0.661   0.328
        cp 0.156 0.099  0.114   -0.045    0.343   0.103
   ind_lek 0.182 0.047  0.000    0.097    0.280   0.120
  ind_prok 0.153 0.046  0.001    0.073    0.254   0.101
 ind_razem 0.335 0.063  0.000    0.219    0.464   0.222
   roznica 0.028 0.068  0.677   -0.110    0.162   0.019
    c_calk 0.491 0.087  0.000    0.317    0.655   0.325
        label   est    se pvalue ci.lower ci.upper std.all
           a1 0.462 0.061  0.000    0.346    0.583   0.426
           a2 0.165 0.069  0.016    0.027    0.299   0.159
          d21 0.335 0.062  0.000    0.216    0.458   0.351
           b1 0.393 0.083  0.000    0.231    0.557   0.283
           b2 0.479 0.093  0.000    0.294    0.661   0.328
           cp 0.156 0.099  0.114   -0.045    0.343   0.103
      ind_lek 0.182 0.047  0.000    0.097    0.280   0.120
     ind_prok 0.079 0.038  0.037    0.013    0.161   0.052
 ind_lek_prok 0.074 0.023  0.001    0.036    0.124   0.049
    ind_razem 0.335 0.063  0.000    0.219    0.464   0.222
4. Symulacja mocy testu efektu pośredniego
R
# Moc testu efektu pośredniego: symulacja Monte Carlo (model populacyjny w jednostkach standaryzowanych)
# W każdej z 2000 symulowanych prób efekt ab oceniamy przedziałem Monte Carlo (5000 losowań a × b)
moc_ab <- function(n, a, b, cp, powtorzen = 2000, losowan = 5000) {
  istotny <- replicate(powtorzen, {
    x <- rnorm(n)
    m <- a * x + rnorm(n, sd = sqrt(1 - a^2))
    y <- cp * x + b * m + rnorm(n, sd = sqrt(1 - (cp^2 + b^2 + 2 * a * b * cp)))
    ka <- coef(summary(lm(m ~ x)))         # ścieżka a i jej SE
    kb <- coef(summary(lm(y ~ x + m)))     # ścieżka b i jej SE
    ab <- rnorm(losowan, ka["x", 1], ka["x", 2]) * rnorm(losowan, kb["m", 1], kb["m", 2])
    granice <- quantile(ab, c(.025, .975))
    granice[1] > 0 | granice[2] < 0        # czy 95% CI wyklucza zero?
  })
  mean(istotny)
}
set.seed(2026)
N <- c(50, 75, 100, 150, 200, 300, 400, 600)
data.frame(N,
           moc_jak_w_przykladzie = sapply(N, moc_ab, a = 0.50, b = -0.35, cp = -0.15),
           moc_sciezki_o_polowe_slabsze = sapply(N, moc_ab, a = 0.25, b = -0.175, cp = -0.15))
Wynik w R
    N moc_jak_w_przykladzie moc_sciezki_o_polowe_slabsze
1  50                0.5940                       0.0940
2  75                0.8000                       0.1610
3 100                0.9100                       0.2685
4 150                0.9820                       0.4875
5 200                0.9945                       0.6510
6 300                0.9995                       0.8510
7 400                1.0000                       0.9340
8 600                1.0000                       0.9905
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizie mediacji
- Rezygnacja z analizy, bo efekt całkowity jest nieistotny. Efekt pośredni może istnieć mimo słabego c – na przykład gdy droga bezpośrednia i pośrednia mają przeciwne znaki. Uzależnianie analizy od istotności związku X–Y jest nieuzasadnione (Rucker i in., 2011).
- Kroki przyczynowe albo test Sobela zamiast bootstrapu. Kroki przyczynowe tracą moc zwłaszcza wtedy, gdy efekt bezpośredni jest mały, a test Sobela we wszystkich warunkach symulacji wymagał większej próby niż bootstrap percentylowy (Fritz i MacKinnon, 2007).
- Porównywanie dwóch efektów pośrednich po ich wartościach p. To, że jeden jest istotny, a drugi nie, nie dowodzi różnicy między nimi – do tego służy kontrast z własnym przedziałem ufności.
- Etykieta „mediacja całkowita” na podstawie nieistotnego c′. Zależy ona od liczebności próby; podaj c′ z przedziałem ufności.
- Brak liczby prób bootstrap i ziarna generatora. Bez nich nikt nie odtworzy przedziału – także Ty po ponownym uruchomieniu analizy.
- Język przyczynowy w badaniu przekrojowym. Dane zebrane w jednym pomiarze nie ustalają kolejności X → M → Y, a oszacowania mogą być obciążone (Maxwell i Cole, 2007).
- Testowanie kolejnych mediatorów do skutku i raportowanie tylko istotnych. To p-hacking, a mediator dopisany do hipotez po poznaniu wyników to HARKing. Zaplanuj mediatory przed analizą.
- Za mała próba. Przy słabych ścieżkach nawet 200 osób może nie wystarczyć – zaplanuj moc przed zebraniem danych.
- Mylenie mediacji z moderacją. Mediator leży na drodze od X do Y, a moderator zmienia siłę związku między nimi. Analizę z moderatorem pokazujemy w poradniku analiza moderacji krok po kroku, a jeśli potrzebujesz pomocy przy własnych danych, zajrzyj do oferty analiz statystycznych dla studentów.
Najczęstsze pytania
Jak zrobić analizę mediacji w SPSS?
Najprościej makrem PROCESS: w oknie dialogowym wskaż Y, X i mediator M, wybierz model 4, pozostaw 5000 prób bootstrap i w opcjach zaznacz model efektu całkowitego. O mediacji świadczy efekt pośredni w tabeli efektów: jeśli przedział od BootLLCI do BootULCI nie obejmuje zera, efekt pośredni jest istotny. Same regresje liniowe w SPSS nie dają tego przedziału.
Jak zrobić analizę mediacji w R?
W pakiecie lavaan zapisz dwa równania z etykietami ścieżek (M ~ a*X, Y ~ b*M + cp*X), zdefiniuj efekt pośredni ab := a*b i oszacuj model z se = "bootstrap", bootstrap = 5000 oraz ustalonym ziarnem iseed. Percentylowe przedziały zwraca parameterEstimates(fit, boot.ci.type = "perc").
Jak interpretować efekt pośredni ab?
To część związku X z Y przenoszona przez mediator, wyrażona w jednostkach Y na jednostkę X. W przykładzie ab = −0.141 oznacza, że stres wyższy o 1 punkt wiąże się – za pośrednictwem ruminacji – z jakością snu niższą o 0.14 punktu. Efekt jest istotny, gdy bootstrapowy 95% przedział ufności nie obejmuje zera.
Czym różni się mediacja równoległa od sekwencyjnej?
W mediacji równoległej (PROCESS, model 4 z kilkoma mediatorami) każdy mediator tworzy osobną drogę od X do Y. W sekwencyjnej (model 6) mediatory tworzą łańcuch X → M1 → M2 → Y, więc dochodzi droga przez oba mediatory. Łączny efekt pośredni i efekt bezpośredni są w obu modelach takie same – o wyborze decyduje teoria i kolejność pomiaru.
Ile osób potrzeba do analizy mediacji?
To zależy od siły obu ścieżek. Według symulacji Fritza i MacKinnona (2007) bootstrap percentylowy osiąga moc .80 przy około 558 osobach, gdy obie ścieżki są małe (0.14 w jednostkach standaryzowanych), i przy 78 osobach, gdy są średnie (0.39). Najlepiej oszacuj moc symulacją dla własnego modelu.
Czy można robić analizę mediacji na danych przekrojowych?
Można ją policzyć, ale wyniki opisują układ związków, a nie dowiedziony mechanizm. Maxwell i Cole (2007) pokazali, że przekrojowe oszacowania mediacji procesów rozwijających się w czasie bywają silnie obciążone. Opisz to w ograniczeniach i pisz o wynikach „zgodnych z hipotezą mediacyjną”, a nie o przyczynach.
Powiązane hasła
Przeczytaj też
Analiza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Baron, R. M., & Kenny, D. A. (1986). The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Bullock, J. G., Green, D. P., & Ha, S. E. (2010). Yes, but what’s the mechanism? (Don’t expect an easy answer). Journal of Personality and Social Psychology, 98(4), 550–558. https://doi.org/10.1037/a0018933 ● Otwarty dostęp: pełny tekst
- Fritz, M. S., & MacKinnon, D. P. (2007). Required sample size to detect the mediated effect. Psychological Science, 18(3), 233–239. https://doi.org/10.1111/j.1467-9280.2007.01882.x ● Otwarty dostęp: pełny tekst
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Hayes, A. F., & Rockwood, N. J. (2017). Regression-based statistical mediation and moderation analysis in clinical research: Observations, recommendations, and implementation. Behaviour Research and Therapy, 98, 39–57. https://doi.org/10.1016/j.brat.2016.11.001
- Hayes, A. F., & Scharkow, M. (2013). The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter? Psychological Science, 24(10), 1918–1927. https://doi.org/10.1177/0956797613480187
- MacKinnon, D. P., Fairchild, A. J., & Fritz, M. S. (2007). Mediation analysis. Annual Review of Psychology, 58(1), 593–614. https://doi.org/10.1146/annurev.psych.58.110405.085542 ● Otwarty dostęp: pełny tekst
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989x.12.1.23
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879 ● Otwarty dostęp
- Preacher, K. J., & Kelley, K. (2011). Effect size measures for mediation models: Quantitative strategies for communicating indirect effects. Psychological Methods, 16(2), 93–115. https://doi.org/10.1037/a0022658
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Rucker, D. D., Preacher, K. J., Tormala, Z. L., & Petty, R. E. (2011). Mediation analysis in social psychology: Current practices and new recommendations. Social and Personality Psychology Compass, 5(6), 359–371. https://doi.org/10.1111/j.1751-9004.2011.00355.x
- Schoemann, A. M., Boulton, A. J., & Short, S. D. (2017). Determining power and sample size for simple and complex mediation models. Social Psychological and Personality Science, 8(4), 379–386. https://doi.org/10.1177/1948550617715068
- Zhao, X., Lynch, J. G., & Chen, Q. (2010). Reconsidering Baron and Kenny: Myths and truths about mediation analysis. Journal of Consumer Research, 37(2), 197–206. https://doi.org/10.1086/651257 ● Otwarty dostęp
Cytowania BibTeX
@article{baron1986moderator, author={Baron, Reuben M. and Kenny, David A.}, title={{The moderator–mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations}}, journal={Journal of Personality and Social Psychology}, year={1986}, volume={51}, number={6}, pages={1173--1182}, doi={10.1037/0022-3514.51.6.1173}}@article{bullock2010yes, author={Bullock, John G. and Green, Donald P. and Ha, Shang E.}, title={{Yes, but what’s the mechanism? (Don’t expect an easy answer)}}, journal={Journal of Personality and Social Psychology}, year={2010}, volume={98}, number={4}, pages={550--558}, doi={10.1037/a0018933}}@article{fritz2007required, author={Fritz, Matthew S. and MacKinnon, David P.}, title={{Required sample size to detect the mediated effect}}, journal={Psychological Science}, year={2007}, volume={18}, number={3}, pages={233--239}, doi={10.1111/j.1467-9280.2007.01882.x}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@article{hayes2017regression, author={Hayes, Andrew F. and Rockwood, Nicholas J.}, title={{Regression-based statistical mediation and moderation analysis in clinical research: Observations, recommendations, and implementation}}, journal={Behaviour Research and Therapy}, year={2017}, volume={98}, pages={39--57}, doi={10.1016/j.brat.2016.11.001}}@article{hayes2013relative, author={Hayes, Andrew F. and Scharkow, Michael}, title={{The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter?}}, journal={Psychological Science}, year={2013}, volume={24}, number={10}, pages={1918--1927}, doi={10.1177/0956797613480187}}@article{mackinnon2007mediation, author={MacKinnon, David P. and Fairchild, Amanda J. and Fritz, Matthew S.}, title={{Mediation analysis}}, journal={Annual Review of Psychology}, year={2007}, volume={58}, number={1}, pages={593--614}, doi={10.1146/annurev.psych.58.110405.085542}}@article{maxwell2007bias, author={Maxwell, Scott E. and Cole, David A.}, title={{Bias in cross-sectional analyses of longitudinal mediation}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={23--44}, doi={10.1037/1082-989x.12.1.23}}@article{preacher2008asymptotic, author={Preacher, Kristopher J. and Hayes, Andrew F.}, title={{Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models}}, journal={Behavior Research Methods}, year={2008}, volume={40}, number={3}, pages={879--891}, doi={10.3758/brm.40.3.879}}@article{preacher2011effect, author={Preacher, Kristopher J. and Kelley, Ken}, title={{Effect size measures for mediation models: Quantitative strategies for communicating indirect effects}}, journal={Psychological Methods}, year={2011}, volume={16}, number={2}, pages={93--115}, doi={10.1037/a0022658}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{rucker2011mediation, author={Rucker, Derek D. and Preacher, Kristopher J. and Tormala, Zakary L. and Petty, Richard E.}, title={{Mediation analysis in social psychology: Current practices and new recommendations}}, journal={Social and Personality Psychology Compass}, year={2011}, volume={5}, number={6}, pages={359--371}, doi={10.1111/j.1751-9004.2011.00355.x}}@article{schoemann2017determining, author={Schoemann, Alexander M. and Boulton, Aaron J. and Short, Stephen D.}, title={{Determining power and sample size for simple and complex mediation models}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={379--386}, doi={10.1177/1948550617715068}}@article{zhao2010reconsidering, author={Zhao, Xinshu and Lynch, John G. and Chen, Qimei}, title={{Reconsidering Baron and Kenny: Myths and truths about mediation analysis}}, journal={Journal of Consumer Research}, year={2010}, volume={37}, number={2}, pages={197--206}, doi={10.1086/651257}}