Co to jest supresja?
Supresja (efekt supresji, ang. suppression effect) to sytuacja w regresji wielorakiej, w której dodanie predyktora – zmiennej supresyjnej (supresora) – zwiększa wartość predykcyjną innego predyktora ponad to, co wynika z jego zwykłej korelacji z wynikiem. Pojęcie wprowadził Horst w 1941 roku, gdy zauważył, że zmienna zupełnie nieskorelowana z kryterium może poprawić przewidywanie tylko dlatego, że koreluje z innymi predyktorami; nazwa oddaje to, że supresor „tłumi” w nich wariancję nieistotną dla kryterium (Tzelgov i Henik, 1991).
Conger (1974) zaproponował szerszą definicję: supresor to zmienna, która zwiększa wartość predykcyjną innego predyktora ponad jego trafność zerowego rzędu, czyli ponad korelację z kryterium. Pokazał też, jak rozpoznać supresory w równaniu regresji i odróżnić zmienne, które przewidują kryterium bezpośrednio, od tych, które działają pośrednio – usuwając nieistotną wariancję z innego predyktora. W praktyce supresja objawia się tym, że współczynnik β predyktora jest większy od jego korelacji z wynikiem albo ma przeciwny znak.
Rodzaje supresji
Przy dwóch predyktorach współczynniki standaryzowane wynikają wprost z trzech korelacji:
gdzie rY1 i rY2 to korelacje predyktorów z wynikiem, a r12 – korelacja predyktorów ze sobą. Gdy rY2 = 0, wzór upraszcza się do β1 = rY1 / (1 − r12²), a to zawsze więcej niż rY1. Z tego wzoru wynikają trzy typowe sytuacje:
| Rodzaj | Układ korelacji | Co widać w modelu |
|---|---|---|
| Klasyczna (Horsta) | Supresor nie koreluje z Y, ale koreluje z drugim predyktorem | Supresor dostaje ujemne β, β drugiego predyktora i R² rosną |
| Negatywna (netto) | Supresor koreluje z Y dodatnio, ale słabiej, niż wynikałoby z jego korelacji z drugim predyktorem | Supresor dostaje β o znaku przeciwnym do swojej korelacji z Y |
| Wzajemna (kooperacyjna) | Oba predyktory korelują z Y dodatnio, a ze sobą – ujemnie | Oba β są większe od korelacji, a R² przekracza sumę r² |
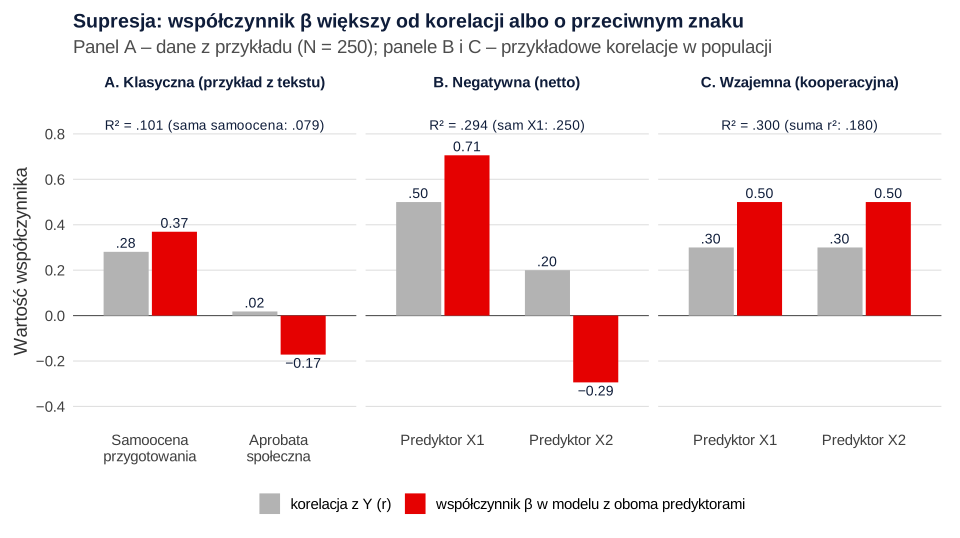
Typ wzajemny Conger (1974) opisał jako nowy rodzaj supresji, wcześniej niewyodrębniany. Rysunek 1 zestawia wszystkie trzy przypadki.
Przykład: samoocena przygotowania i aprobata społeczna
250 studentów (dane symulowane) oceniło przed egzaminem ze statystyki, jak dobrze są przygotowani (1–10; M = 6.04, SD = 1.80), i wypełniło skalę aprobaty społecznej (0–13; M = 6.43, SD = 2.77). Wynik egzaminu wyniósł średnio 62.06 pkt (SD = 14.82). Samoocena korelowała z wynikiem umiarkowanie, r = .28, a aprobata społeczna – praktycznie wcale, r = .02, p = .775. Osoby z wysoką aprobatą społeczną deklarowały jednak lepsze przygotowanie (r = .51): część wariancji samooceny to autoprezentacja, a nie wiedza.
| Model | Predyktor | b [SE] | β | p | R² |
|---|---|---|---|---|---|
| 1 | Samoocena przygotowania | 2.31 [0.50] | 0.28 | < .001 | .079 |
| 2 | Samoocena przygotowania | 3.04 [0.58] | 0.37 | < .001 | .101 |
| Aprobata społeczna | −0.92 [0.38] | −0.17 | .015 |
Po dodaniu aprobaty społecznej współczynnik samooceny wzrósł z 2.31 do 3.04 punktu egzaminu na punkt skali (β z 0.28 do 0.37), a R² – z .079 do .101, ΔR² = .022, F(1, 247) = 5.96, p = .015. Aprobata dostała ujemny współczynnik, choć sama z wynikiem nie koreluje. To klasyczna supresja: model „odejmuje” od samooceny część związaną z autoprezentacją, a to, co zostaje, lepiej przewiduje wynik. Ujemne β aprobaty nie oznacza więc, że autoprezentacja obniża wynik egzaminu – mówi tylko, że przy tej samej samoocenie osoby o wyższej aprobacie wypadają gorzej, bo ich samoocena jest bardziej zawyżona.
Supresja a mediacja i zmienna zakłócająca
MacKinnon i in. (2000) pokazali, że mediację, zakłócanie i supresję opisuje ta sama arytmetyka: każdy z tych efektów mierzy się zmianą związku X–Y po dodaniu trzeciej zmiennej. Mediacja i zakłócanie są statystycznie identyczne i różnią się tylko interpretacją, a przedziały ufności dla efektów zakłócenia i supresji można liczyć metodami opracowanymi dla efektu pośredniego. Przy mediacji i zakłócaniu związek X–Y po dodaniu trzeciej zmiennej słabnie, a przy supresji – rośnie.
W przykładzie efekt samooceny bez kontroli aprobaty wynosił c = 2.31, a po jej uwzględnieniu c′ = 3.04. Różnica c − c′ = −0.73 jest równa iloczynowi a × b (ścieżka samoocena → aprobata razy ścieżka aprobata → wynik), a jej 95% przedział bootstrapowy [−1.31, −0.18] nie obejmuje zera. Efekt pośredni i bezpośredni o przeciwnych znakach to właśnie supresja – w języku analizy mediacji tzw. mediacja niespójna (MacKinnon i in., 2000). Statystyka nie rozstrzyga jednak, która interpretacja jest właściwa: aprobata społeczna nie jest mechanizmem, przez który samoocena wpływa na wynik, tylko zakłóca pomiar samooceny. Ten sam układ liczb może też powstać jako artefakt, dlatego o interpretacji decyduje teoria (zob. też korelacja pozorna).
Jak rozpoznać supresję w wynikach?
- Porównaj β z korelacją zerowego rzędu każdego predyktora. Sygnałem jest |β| > |r| albo przeciwny znak β i r.
- Porównaj korelację semicząstkową z korelacją zwykłą. Velicer (1978) zaproponował definicję supresji opartą na tej relacji; w przykładzie korelacja semicząstkowa samooceny (.32) jest wyższa od jej korelacji z wynikiem (.28). Z kolei korelacja cząstkowa pokazuje związek po usunięciu trzeciej zmiennej z obu zmiennych.
- Dodawaj predyktory blokami (regresja hierarchiczna) i śledź, jak zmieniają się współczynniki i R².
- Sprawdź współliniowość. Supresja wymaga skorelowanych predyktorów, ale nie musi oznaczać problemu: w przykładzie VIF = 1.36.
- Szukaj replikacji i teorii. Paulhus i in. (2004) odpowiadają na zarzut, że efekty supresji rzadko się replikują: poczucie winy i wstyd oraz samoocena i narcyzm konsekwentnie działały jako wzajemne supresory w przewidywaniu agresji i zachowań antyspołecznych. Watson i in. (2013) pokazali, że powtarzalne efekty supresji pomagają odkryć przeciwstawne składniki ukryte w jednej skali objawów.
Jak opisać supresję w pracy (APA)
Pokaż oba modele, podaj korelacje zerowego rzędu obok współczynników i nazwij efekt. Wzór dla przykładu:
Wyniki obu kroków zbierz w tabeli – wzór znajdziesz w haśle tabela regresji w APA, a cały tok analizy w poradniku regresja wieloraka krok po kroku.
Przykład w R
Kod tworzy dane z przykładu, porównuje modele bez supresora i z supresorem, liczy współczynniki β, test przyrostu R², korelację semicząstkową, VIF oraz różnicę c − c′ = a × b z bootstrapowym przedziałem ufności. W SPSS: Analiza → Regresja → Liniowa; w bloku 1 wpisz samoocenę, w bloku 2 aprobatę społeczną, a w Statystykach zaznacz zmianę R kwadrat oraz korelacje cząstkowe i semicząstkowe – tabela „Współczynniki” pokaże wtedy obok β korelację zerowego rzędu, cząstkową i semicząstkową (part).
Model bez supresora i z supresorem
R
# Samoocena przygotowania, aprobata społeczna i wynik egzaminu. Dane symulowane, N = 250
library(MASS)                                     # mvrnorm()
set.seed(243)
R <- matrix(c(1, .30, .00,
              .30, 1, .45,
              .00, .45, 1), 3, byrow = TRUE)      # korelacje w populacji
z <- mvrnorm(250, mu = c(0, 0, 0), Sigma = R)
dane <- data.frame(egzamin   = pmin(100, pmax(0, round(62 + 15 * z[, 1]))),   # wynik egzaminu, 0–100 pkt
                   samoocena = pmin(10, pmax(1, round(6 + 1.8 * z[, 2]))),    # samoocena przygotowania, 1–10
                   aprobata  = pmin(13, pmax(0, round(6.5 + 2.8 * z[, 3]))))  # aprobata społeczna, 0–13
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane), 3)
cor.test(dane$egzamin, dane$aprobata)$p.value    # aprobata nie wiąże się z wynikiem egzaminu

# Model 1: sama samoocena; model 2: samoocena + aprobata społeczna (supresor)
m1 <- lm(egzamin ~ samoocena, data = dane)
m2 <- lm(egzamin ~ samoocena + aprobata, data = dane)
round(summary(m1)$coefficients, 3)
summary(m2)
z_dane <- as.data.frame(scale(dane))             # współczynniki standaryzowane (β)
round(c(beta_m1 = unname(coef(lm(egzamin ~ samoocena, z_dane))[2]),
        coef(lm(egzamin ~ samoocena + aprobata, z_dane))[2:3]), 3)
round(c(R2_m1 = summary(m1)$r.squared, R2_m2 = summary(m2)$r.squared), 3)
anova(m1, m2)                                     # czy dodanie supresora zwiększa R²?
# Korelacja semicząstkowa samooceny w modelu 2 (wyższa od zwykłej r = .281) i VIF predyktorów
round(sqrt(summary(m2)$r.squared - cor(dane$egzamin, dane$aprobata)^2), 3)
round(1 / (1 - cor(dane$samoocena, dane$aprobata)^2), 2)

# Supresja jako „niespójna mediacja”: c − c' = a × b (MacKinnon i in., 2000)
c_calk <- unname(coef(m1)["samoocena"]); c_bezp <- unname(coef(m2)["samoocena"])
a <- unname(coef(lm(aprobata ~ samoocena, data = dane))["samoocena"])
b <- unname(coef(m2)["aprobata"])
round(c(c = c_calk, c_prim = c_bezp, roznica = c_calk - c_bezp, a_razy_b = a * b), 3)
set.seed(1)
boot_ab <- replicate(2000, {
  d <- dane[sample(nrow(dane), replace = TRUE), ]
  coef(lm(aprobata ~ samoocena, d))[2] * coef(lm(egzamin ~ samoocena + aprobata, d))[3]
})
round(quantile(boot_ab, c(.025, .975)), 3)       # 95% przedział bootstrapowy dla a × b
Wynik w R
   egzamin samoocena aprobata
M    62.06      6.04     6.43
SD   14.82      1.80     2.77
          egzamin samoocena aprobata
egzamin     1.000     0.281    0.018
samoocena   0.281     1.000    0.515
aprobata    0.018     0.515    1.000
[1] 0.7746964
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   48.086      3.165  15.191        0
samoocena      2.313      0.502   4.607        0

Call:
lm(formula = egzamin ~ samoocena + aprobata, data = dane)

Residuals:
    Min      1Q  Median      3Q     Max
-38.323  -9.608   0.474   9.626  35.718

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  49.5899     3.1942  15.525  < 2e-16 ***
samoocena     3.0412     0.5797   5.246 3.35e-07 ***
aprobata     -0.9189     0.3764  -2.441   0.0153 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 14.12 on 247 degrees of freedom
Multiple R-squared:  0.1005,	Adjusted R-squared:  0.09325
F-statistic:  13.8 on 2 and 247 DF,  p-value: 2.075e-06

  beta_m1 samoocena  aprobata
    0.281     0.369    -0.172
R2_m1 R2_m2
0.079 0.101
Analysis of Variance Table

Model 1: egzamin ~ samoocena
Model 2: egzamin ~ samoocena + aprobata
  Res.Df   RSS Df Sum of Sq      F  Pr(>F)
1    248 50409
2    247 49221  1    1187.6 5.9594 0.01534 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1] 0.317
[1] 1.36
       c   c_prim  roznica a_razy_b
   2.313    3.041   -0.728   -0.728
  2.5%  97.5%
-1.309 -0.182
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; dane wygenerowano funkcją mvrnorm() z pakietu MASS, a rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Usuwanie predyktora tylko dlatego, że nie koreluje z wynikiem. Supresor może poprawiać model, choć jego korelacja z Y jest bliska zera.
- Dosłowna interpretacja ujemnego β supresora („aprobata społeczna obniża wynik egzaminu”). Współczynnik opisuje różnicę przy stałym drugim predyktorze, a nie samodzielny związek.
- Ogłaszanie silnego efektu bez replikacji. Supresja w jednej próbie może być przypadkowa; szukaj powtórzeń i uzasadnienia teoretycznego (Paulhus i in., 2004).
- Porównywanie ważności predyktorów wyłącznie po β. Przy supresji β zawyża rolę jednego predyktora i „karze” drugi; zestaw je z korelacjami zerowego rzędu i semicząstkowymi.
- Mylenie supresji z mediacją w sensie przyczynowym. Ta sama arytmetyka (MacKinnon i in., 2000) nie przesądza, czy trzecia zmienna jest mechanizmem, zakłóceniem pomiaru, czy zmienną zakłócającą.
Najczęstsze pytania
Co to jest supresja w regresji?
To sytuacja, w której po dodaniu predyktora (supresora) inny predyktor zyskuje na znaczeniu: jego współczynnik β rośnie ponad jego korelację z wynikiem, a R² modelu się zwiększa. Supresor usuwa z drugiego predyktora wariancję, która nie ma związku z wynikiem, dlatego sam może prawie nie korelować z kryterium.
Jak rozpoznać zmienną supresyjną?
Porównaj współczynnik β każdego predyktora z jego korelacją zerowego rzędu z wynikiem. Sygnałem supresji jest β większe co do wartości bezwzględnej od korelacji albo β o przeciwnym znaku niż korelacja. Pomocne jest też porównanie korelacji semicząstkowej z korelacją zwykłą i dodawanie predyktorów blokami.
Dlaczego predyktor ma ujemne beta, choć koreluje z wynikiem dodatnio?
To częsty objaw supresji negatywnej (netto): predyktor jest silniej skorelowany z innym predyktorem niż z wynikiem, więc po kontroli tego predyktora jego unikalny związek z wynikiem okazuje się ujemny. Nie interpretuj takiego β jako samodzielnego, ujemnego wpływu – opisuje ono różnicę przy stałej wartości drugiego predyktora.
Czym różni się supresja od mediacji?
Statystycznie obie mierzy się zmianą związku X–Y po dodaniu trzeciej zmiennej (MacKinnon i in., 2000). Przy mediacji związek po dodaniu mediatora słabnie, a przy supresji – rośnie, co bywa nazywane mediacją niespójną. O tym, czy trzecia zmienna jest mechanizmem, zakłóceniem pomiaru czy zmienną zakłócającą, rozstrzyga teoria i plan badania, a nie sama regresja.
Czy supresja to błąd w analizie?
Nie musi. Supresja wynika z korelacji między predyktorami i bywa merytorycznie ważna – Paulhus i in. (2004) opisali powtarzalne efekty supresji w badaniach osobowości. W pojedynczej, małej próbie może jednak być przypadkowa, dlatego podawaj obok β korelacje zerowego rzędu i szukaj replikacji.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja wieloraka w obrazkach
Wykres zmiennej dodanej, zmiana znaku współczynnika, elipsa ufności przy współliniowości i ten sam predyktor w pięciu modelach – „kontrolując” na rysunkach z R.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Conger, A. J. (1974). A revised definition for suppressor variables: A guide to their identification and interpretation. Educational and Psychological Measurement, 34(1), 35–46. https://doi.org/10.1177/001316447403400105
- MacKinnon, D. P., Krull, J. L., & Lockwood, C. M. (2000). Equivalence of the mediation, confounding and suppression effect. Prevention Science, 1(4), 173–181. https://doi.org/10.1023/a:1026595011371 ● Otwarty dostęp: pełny tekst
- Paulhus, D. L., Robins, R. W., Trzesniewski, K. H., & Tracy, J. L. (2004). Two replicable suppressor situations in personality research. Multivariate Behavioral Research, 39(2), 303–328. https://doi.org/10.1207/s15327906mbr3902_7
- Tzelgov, J., & Henik, A. (1991). Suppression situations in psychological research: Definitions, implications, and applications. Psychological Bulletin, 109(3), 524–536. https://doi.org/10.1037/0033-2909.109.3.524
- Velicer, W. F. (1978). Suppressor variables and the semipartial correlation coefficient. Educational and Psychological Measurement, 38(4), 953–958. https://doi.org/10.1177/001316447803800415
- Watson, D., Clark, L. A., Chmielewski, M., & Kotov, R. (2013). The value of suppressor effects in explicating the construct validity of symptom measures. Psychological Assessment, 25(3), 929–941. https://doi.org/10.1037/a0032781 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{conger1974revised, author={Conger, Anthony J.}, title={{A revised definition for suppressor variables: A guide to their identification and interpretation}}, journal={Educational and Psychological Measurement}, year={1974}, volume={34}, number={1}, pages={35--46}, doi={10.1177/001316447403400105}}@article{mackinnon2000equivalence, author={MacKinnon, David P. and Krull, Jennifer L. and Lockwood, Chondra M.}, title={{Equivalence of the mediation, confounding and suppression effect}}, journal={Prevention Science}, year={2000}, volume={1}, number={4}, pages={173--181}, doi={10.1023/a:1026595011371}}@article{paulhus2004two, author={Paulhus, Delroy L. and Robins, Richard W. and Trzesniewski, Kali H. and Tracy, Jessica L.}, title={{Two replicable suppressor situations in personality research}}, journal={Multivariate Behavioral Research}, year={2004}, volume={39}, number={2}, pages={303--328}, doi={10.1207/s15327906mbr3902_7}}@article{tzelgov1991suppression, author={Tzelgov, Joseph and Henik, Avishai}, title={{Suppression situations in psychological research: Definitions, implications, and applications}}, journal={Psychological Bulletin}, year={1991}, volume={109}, number={3}, pages={524--536}, doi={10.1037/0033-2909.109.3.524}}@article{velicer1978suppressor, author={Velicer, Wayne F.}, title={{Suppressor variables and the semipartial correlation coefficient}}, journal={Educational and Psychological Measurement}, year={1978}, volume={38}, number={4}, pages={953--958}, doi={10.1177/001316447803800415}}@article{watson2013value, author={Watson, David and Clark, Lee Anna and Chmielewski, Michael and Kotov, Roman}, title={{The value of suppressor effects in explicating the construct validity of symptom measures}}, journal={Psychological Assessment}, year={2013}, volume={25}, number={3}, pages={929--941}, doi={10.1037/a0032781}}