Mediacja w jamovi: który moduł wybrać
Podstawowa wersja jamovi nie ma analizy mediacji w menu. Dodają ją moduły z biblioteki programu. Do mediacji służą głównie dwa: medmod (autor: Ravi Selker) i jAMM – Advanced Mediation Models (autor: Marcello Gallucci). W bibliotece modułów widnieją jako medmod 1.2.0 i jamm 1.2.4 (The jamovi project, b.d.). Oba liczą model w pakiecie R lavaan (Gallucci, b.d.; Selker, 2026).
| Cecha | medmod → Mediation | jAMM → GLM Mediation Model |
|---|---|---|
| Modele | tylko mediacja prosta: jeden predyktor, jeden mediator | mediacja prosta, kilka mediatorów, kilka zmiennych niezależnych, mediacja moderowana |
| Predyktory kategorialne | nie – pola przyjmują tylko zmienne liczbowe | tak – pole Factors |
| Przedział ufności domyślnie | metoda delta (Standard) | metoda delta (Standard) |
| Bootstrap | Bootstrap, domyślnie 1000 prób | Bootstrap (Percent) lub Bootstrap (BC), domyślnie 1000 prób |
| Wynik standaryzowany | brak | kolumna β (domyślnie włączona) |
| Dodatki | % mediacji, wykres oszacowań, diagram ścieżek | diagram modelu, składowe efektu pośredniego, regresje MNK |
Do pracy z jedną hipotezą „X → M → Y” wystarczy medmod i na nim opieramy przykład. Teorię – ścieżki a, b, c′, test efektu pośredniego, mediację równoległą i sekwencyjną – opisuje poradnik analiza mediacji krok po kroku. Tutaj pokazujemy tylko obsługę jamovi i odczyt tabel. Odpowiednikiem w SPSS jest makro PROCESS, model 4 (mediacja i moderacja w SPSS z PROCESS).
Liczby policzono w R pakietem lavaan, tą samą składnią modelu, którą buduje medmod. Samego jamovi tu nie uruchamialiśmy. Nazwy pól i kolumn pochodzą z plików definicji modułu (Selker, 2026). Moduły nie mają polskiego tłumaczenia w repozytoriach, więc nazwy podajemy po angielsku.
Przykład i pliki do pobrania
Fikcyjna ankieta 180 osób studiujących (dane symulowane):
wsparcie– wsparcie rówieśników, średnia z pozycji skali 1–5 (X, predyktor);samoskutecznosc– samoskuteczność akademicka, 1–5 (M, mediator); trzy osoby nie odpowiedziały na te pytania;zaangazowanie– zaangażowanie w naukę, 1–7 (Y, zmienna zależna).
Pobierz plik CSV albo ten sam zbiór jako plik .sav z etykietami. Hipoteza: wsparcie rówieśników wiąże się z wyższym zaangażowaniem między innymi przez wyższą samoskuteczność. Średnie: wsparcie M = 3.40 (SD = 0.72), samoskuteczność M = 3.16 (SD = 0.66), zaangażowanie M = 3.86 (SD = 1.04).
Instalacja modułu i przygotowanie danych
- Zainstaluj moduł. Kliknij przycisk Modules w prawym górnym rogu okna, wybierz jamovi library, znajdź medmod i kliknij przycisk instalacji. Moduł działa od razu, bez ponownego uruchamiania programu (The jamovi project, b.d.). Ogólną obsługę modułów i interfejsu opisuje wpis jamovi krok po kroku.
- Otwórz dane (CSV lub .sav) i sprawdź typ zmiennych. Pola medmod przyjmują wyłącznie zmienne liczbowe, a plik definicji podpowiada typ Continuous (Selker, 2026). Zmiennej tekstowej moduł nie przyjmie. Jak ustawić typy, braki i wynik skali, pokazuje wpis przygotowanie danych i statystyki opisowe w jamovi.
- Policz wyniki skal przed analizą. Do okna mediacji trafiają gotowe wyniki (średnie lub sumy pozycji), nie pojedyncze pytania.
- Sprawdź braki. Model jest dopasowywany w lavaan, który domyślnie usuwa osoby z brakiem w którejkolwiek z trzech zmiennych. W przykładzie analiza obejmuje 177 z 180 osób. Jeśli braków jest więcej, przeczytaj braki danych w ankiecie – co zrobić.
Okno Mediation krok po kroku
Po instalacji na karcie Analyses pojawia się menu medmod z pozycjami Mediation i Moderation. Wybierz medmod → Mediation i wypełnij pola:
| Część okna | Pole lub opcja | Domyślnie | W przykładzie |
|---|---|---|---|
| zmienne | Dependent Variable / Mediator / Predictor | puste | zaangazowanie / samoskutecznosc / wsparcie |
| Estimation Method for SE's | Standard albo Bootstrap z liczbą prób (samples) | Standard; 1000 prób | najpierw Standard, potem Bootstrap |
| Estimates | Labels | wyłączone | włącz (podpisy a × b, c′) |
| Test statistics (kolumny Z i p) | włączone | zostaw | |
| Confidence interval, Interval 95% | wyłączone | włącz | |
| Percent mediation | wyłączone | włącz tylko do wglądu | |
| Additional Output | Path estimates | wyłączone | włącz (ścieżki a, b, c′) |
| Estimate plot, Path diagram | wyłączone | według potrzeby |
Uwaga na domyślne ustawienia. Bez zaznaczenia Confidence interval tabela nie pokaże przedziału ufności, a przy Standard wynik efektu pośredniego opiera się na metodzie delta. Dokumentacja modułu opisuje ją jako równoważną testowi Sobela (Selker, 2026).
Jak czytać tabele medmod
Poniżej wyniki przy ustawieniu Standard, w układzie tabel modułu: kolumny i podpisy wierszy według pliku definicji wyników (Selker, 2026), liczby policzone w R, zaokrąglone do trzech miejsc.
| Effect | Label | Estimate | SE | 95% Confidence Interval | Z | p | % Mediation | |
|---|---|---|---|---|---|---|---|---|
| Lower | Upper | |||||||
| Indirect | a × b | 0.199 | 0.058 | 0.085 | 0.312 | 3.434 | < .001 | 52.160 |
| Direct | c′ | 0.182 | 0.111 | −0.036 | 0.400 | 1.639 | 0.101 | 47.840 |
| Total | c′ + a × b | 0.381 | 0.104 | 0.177 | 0.585 | 3.660 | < .001 | 100.000 |
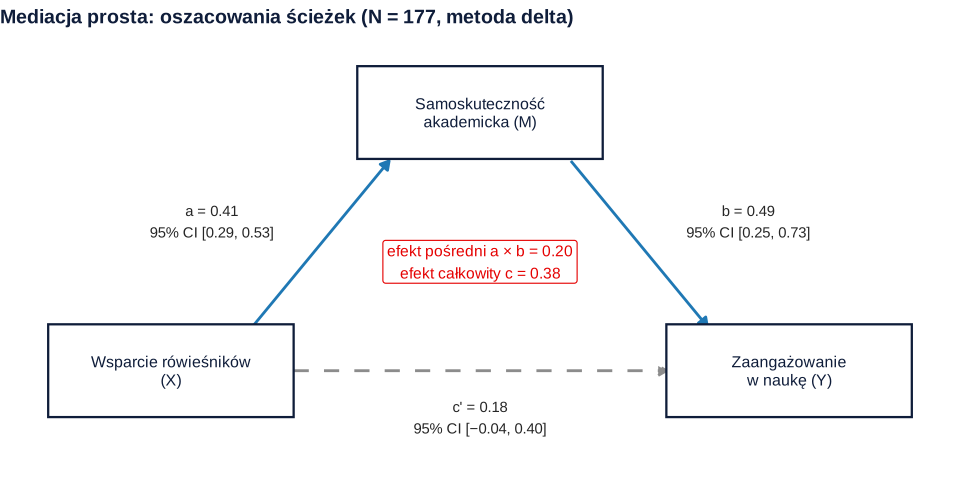
- Indirect – efekt pośredni a × b = 0.199: o tyle punktów wyższe jest przewidywane zaangażowanie przy wsparciu wyższym o 1 punkt, „przez” samoskuteczność.
- Direct – efekt bezpośredni c′ = 0.182, przy stałej samoskuteczności. Przedział obejmuje zero, p = .101.
- Total – efekt całkowity c = 0.381, czyli suma dwóch powyższych.
- Z i p – test z dla każdego efektu (bez stopni swobody), a nie test t z regresji.
| Label | Estimate | SE | 95% Confidence Interval | Z | p | ||||
|---|---|---|---|---|---|---|---|---|---|
| Lower | Upper | ||||||||
| wsparcie | → | samoskutecznosc | a | 0.406 | 0.062 | 0.285 | 0.526 | 6.597 | < .001 |
| samoskutecznosc | → | zaangazowanie | b | 0.490 | 0.122 | 0.251 | 0.728 | 4.022 | < .001 |
| wsparcie | → | zaangazowanie | c′ | 0.182 | 0.111 | −0.036 | 0.400 | 1.639 | 0.101 |
Iloczyn 0.406 × 0.490 daje efekt pośredni z pierwszej tabeli. Oszacowania pochodzą z metody największej wiarygodności, więc błędy standardowe minimalnie różnią się od dwóch zwykłych regresji: dla ścieżki b SE = 0.122 zamiast 0.123 (kod niżej). Na to samo zwraca uwagę dokumentacja jAMM (Gallucci, b.d.).
Kolumna % Mediation – ostrożnie
W kodzie modułu procent mediacji to |a × b| / (|a × b| + |c′|) × 100 (Selker, 2026). Tu daje 52.2%. To wartość z próby, bez przedziału ufności. Przy małym efekcie całkowitym łatwo o wartości niestabilne, a gdy a × b i c′ mają przeciwne znaki, wartości bezwzględne ukrywają, że efekty się znoszą. Preacher i Kelley (2011) przeglądają miary wielkości efektu w mediacji i ich ograniczenia. W pracy raportuj przede wszystkim same efekty z przedziałami. Etykiety „mediacja częściowa” i „całkowita” stosuj oszczędnie: zero w przedziale c′ to brak dowodu na efekt bezpośredni, a nie dowód jego braku.
Standard czy Bootstrap?
Rozkład iloczynu a × b jest normalny tylko w szczególnych przypadkach, dlatego przedział oparty na rozkładzie normalnym ma niezrównoważone granice, a metody ponownego losowania dawały w symulacjach dokładniejsze przedziały (MacKinnon i in., 2004). Hayes i Scharkow (2013) uznają bootstrap percentylowy za dobry kompromis między mocą a kontrolą błędu I rodzaju. W medmod wybierz więc Bootstrap i wpisz liczbę prób. Moduł przekazuje ją do lavaan, a przedział bierze z funkcji parameterEstimates() bez zmiany typu przedziału (Selker, 2026). W lavaan domyślny typ takiego przedziału to przedział percentylowy (według dokumentacji funkcji parameterEstimates()).
| Effect | Label | Estimate | SE | 95% Confidence Interval | Z | p | % Mediation | |
|---|---|---|---|---|---|---|---|---|
| Lower | Upper | |||||||
| Indirect | a × b | 0.199 | 0.063 | 0.087 | 0.326 | 3.165 | 0.002 | 52.160 |
| Direct | c′ | 0.182 | 0.120 | −0.071 | 0.412 | 1.524 | 0.127 | 47.840 |
| Total | c′ + a × b | 0.381 | 0.112 | 0.152 | 0.598 | 3.404 | < .001 | 100.000 |
Oszacowania się nie zmieniły, zmieniły się błędy standardowe i przedziały. Granice dla a × b to teraz 2.5. i 97.5. percentyl z 1000 prób: [0.087, 0.326] zamiast [0.085, 0.312]. Górna granica przesunęła się w prawo, bo rozkład iloczynu jest prawoskośny (rysunek 2). O efekcie pośrednim wnioskuj z przedziału bootstrapowego. Wartość p z kolumny p to dalej test z (oszacowanie podzielone przez bootstrapowy SE), więc nie traktuj jej jako osobnego „testu bootstrapowego”.
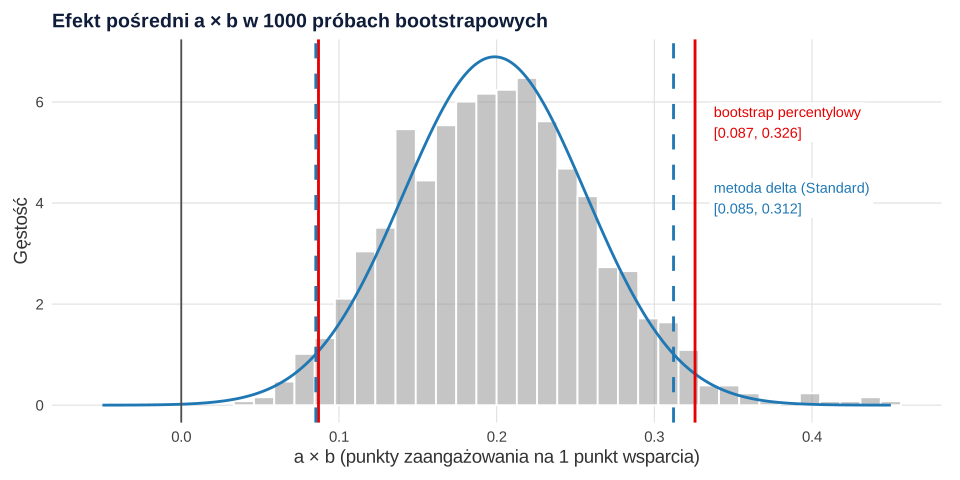
Granice bootstrapu zmieniają się między uruchomieniami. W pliku opcji medmod nie ma pola na ziarno losowania (Selker, 2026), więc każde przeliczenie losuje nowe próby. W R trzy uruchomienia z różnym ziarnem dały dolne granice 0.082–0.087 i górne 0.322–0.324. Zapisz w pracy liczbę prób, a przy granicy bliskiej zera zwiększ ich liczbę (opis opcji podaje zakres od 1 do 100 000 prób). To samo zjawisko w PROCESS opisuje wpis o PROCESS w SPSS.
Kiedy sięgnąć po jAMM
medmod nie przyjmie drugiego mediatora, zmiennej kontrolnej ani moderatora. Wtedy zainstaluj jAMM. Według pliku definicji modułu jego analiza GLM Mediation Model trafia do tego samego menu medmod, pod podtytuł jAMM. Przykład w dokumentacji opisuje ją jeszcze w menu modeli liniowych, więc w swojej wersji sprawdź oba miejsca. W oknie wpisujesz Dependent Variable, Mediators oraz predyktory: ciągłe w Covariates, kategorialne w Factors. Moduł sam buduje model równoległy, a zmienić go można na kartach Mediators models i Full model (Gallucci, b.d.).
- Domyślne przedziały to metoda delta. Bootstrap ustawisz w Mediation options → Confidence Intervals: Bootstrap (Percent) odpowiada przedziałowi percentylowemu z medmod, a Bootstrap (BC) to wariant z korektą obciążenia.
- Główna tabela nazywa się Indirect and Total Effects i ma domyślnie kolumnę β. To rozwiązanie w pełni standaryzowane (Gallucci, b.d.). W przykładzie takie rozwiązanie policzone w lavaan daje dla a × b wartość 0.138.
- Opcja Individual regressions pokazuje zwykłe regresje MNK, których wyniki mogą się nieco różnić od oszacowań w tabelach mediacji (Gallucci, b.d.).
Modele z kilkoma mediatorami omawia wpis mediacja równoległa i szeregowa, a mediację moderowaną – moderowana mediacja i modele PROCESS w R.
Czego jamovi nie sprawdzi
Istotny efekt pośredni w danych przekrojowych to zgodność danych z modelem, a nie dowód mechanizmu. Program nie wie, czy wsparcie poprzedza samoskuteczność, czy jest odwrotnie, ani czy obu zmiennych nie wyjaśnia trzecia zmienna. Interpretacja przyczynowa wymaga m.in. braku niezmierzonych zakłóceń między mediatorem a wynikiem. Opisują to wpisy mediacja przyczynowa i analiza wrażliwości oraz grafy przyczynowe (DAG). O kolejności pomiarów przeczytasz we wpisie mediacja w danych podłużnych. W pracy pisz „pośredniczy statystycznie” albo „efekt pośredni”, a nie „powoduje”.
Zapis wyników w stylu APA
Wzór do dostosowania (bootstrap; liczby z tabel wyżej):
W części „Metoda” podaj nazwę i wersję modułu, metodę przedziału i liczbę prób. Tabelę wyników w stylu APA zbudujesz według hasła tabela mediacji w APA, a zdanie sprawdzisz w generatorze opisu wyników APA.
To samo w R (lavaan)
Moduł medmod zapisuje model w składni lavaan: dwie regresje z etykietami ścieżek i dwa parametry zdefiniowane (ab := a*b, total := c + (a*b)). Te same polecenia w R dają tabele z tego wpisu (Rosseel, 2012; Selker, 2026). Wyniki bootstrapu w jamovi będą się nieco różnić, bo zależą od losowania.
1. Dane do pobrania: CSV i .sav
R
# Mediacja w jamovi – fikcyjne dane do pobrania (dane symulowane)
# 180 osób studiujących: wsparcie rówieśników (X, 1–5), samoskuteczność akademicka (M, 1–5),
# zaangażowanie w naukę (Y, 1–7); trzy osoby nie odpowiedziały na pytania o samoskuteczność.
suppressPackageStartupMessages(library(haven))
set.seed(541)
n <- 180
wsparcie <- rnorm(n, 3.4, 0.75)
samoskutecznosc <- 1.85 + 0.38 * wsparcie + rnorm(n, 0, 0.62)
zaangazowanie <- 1.20 + 0.62 * samoskutecznosc + 0.20 * wsparcie + rnorm(n, 0, 0.95)
ogr <- function(x, lo, hi) round(pmin(hi, pmax(lo, x)), 2)
dane <- data.frame(id = 1:n,
                   wsparcie = ogr(wsparcie, 1, 5),
                   samoskutecznosc = ogr(samoskutecznosc, 1, 5),
                   zaangazowanie = ogr(zaangazowanie, 1, 7))
dane$samoskutecznosc[c(23, 97, 151)] <- NA
write.csv(dane, "mediacja-jamovi-dane.csv", row.names = FALSE, na = "")

# Ten sam zbiór w formacie .sav z etykietami zmiennych
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$wsparcie <- labelled(sav$wsparcie, label = "Wsparcie rówieśników (1–5)")
sav$samoskutecznosc <- labelled(sav$samoskutecznosc, label = "Samoskuteczność akademicka (1–5)")
sav$zaangazowanie <- labelled(sav$zaangazowanie, label = "Zaangażowanie w naukę (1–7)")
write_sav(sav, "mediacja-jamovi-dane.sav")

# Kontrola: liczba wierszy, braki i statystyki opisowe
cat("Wiersze:", nrow(dane), " Braki w samoskutecznosc:", sum(is.na(dane$samoskutecznosc)),
    " Pełne wiersze:", sum(complete.cases(dane)), "\n")
opis <- sapply(dane[, -1], function(x) c(n = sum(!is.na(x)), M = mean(x, na.rm = TRUE),
                                          SD = sd(x, na.rm = TRUE), min = min(x, na.rm = TRUE),
                                          max = max(x, na.rm = TRUE)))
print(round(t(opis), 2))
cat("\nKorelacje (pełne wiersze):\n")
print(round(cor(dane[complete.cases(dane), -1]), 2))
Wynik w R
Wiersze: 180  Braki w samoskutecznosc: 3  Pełne wiersze: 177
                  n    M   SD  min  max
wsparcie        180 3.40 0.72 1.21 5.00
samoskutecznosc 177 3.16 0.66 1.61 4.94
zaangazowanie   180 3.86 1.04 1.00 6.95

Korelacje (pełne wiersze):
                wsparcie samoskutecznosc zaangazowanie
wsparcie            1.00            0.44          0.27
samoskutecznosc     0.44            1.00          0.37
zaangazowanie       0.27            0.37          1.00
2. Mediacja jak w medmod: Standard i Bootstrap
R
# Mediacja prosta tak jak w module medmod (jamovi): model lavaan, metoda delta i bootstrap
suppressPackageStartupMessages(library(lavaan))
dane <- read.csv("mediacja-jamovi-dane.csv")

# Składnia modelu w takiej postaci, jaką moduł medmod buduje z pól okna
model <- '
# Direct effect
zaangazowanie ~ c*wsparcie

# Mediator
samoskutecznosc ~ a*wsparcie
zaangazowanie ~ b*samoskutecznosc

# Indirect effect (a*b)
ab := a*b

# Total effect
total := c + (a*b)
'

tabela_med <- function(est) {
  w <- est[match(c("ab", "c", "total"), est$label), c("est", "se", "ci.lower", "ci.upper", "z", "pvalue")]
  razem <- abs(w$est[1]) + abs(w$est[2])                     # |a×b| + |c'|
  w$proc <- c(abs(w$est[1]) / razem * 100, abs(w$est[2]) / razem * 100, 100)
  pw <- ifelse(w$pvalue < .001, "< .001", sprintf("%.3f", w$pvalue))   # zapis p jak w jamovi
  w <- format(round(w, 3), nsmall = 3); w$pvalue <- pw
  names(w) <- c("Estimate", "SE", "Lower", "Upper", "Z", "p", "% Mediation")
  rownames(w) <- c("Indirect", "Direct", "Total")
  w
}
tabela_sciezek <- function(est) {
  w <- est[match(c("a", "b", "c"), est$label), c("est", "se", "ci.lower", "ci.upper", "z", "pvalue")]
  pw <- ifelse(w$pvalue < .001, "< .001", sprintf("%.3f", w$pvalue))
  w <- format(round(w, 3), nsmall = 3); w$pvalue <- pw
  names(w) <- c("Estimate", "SE", "Lower", "Upper", "Z", "p")
  rownames(w) <- c("wsparcie → samoskutecznosc (a)", "samoskutecznosc → zaangazowanie (b)",
                   "wsparcie → zaangazowanie (c')")
  w
}

# 1. Ustawienie domyślne modułu: Standard (błędy standardowe metodą delta)
fit <- sem(model, data = dane, se = "standard")
cat("Użyte obserwacje:", lavInspect(fit, "nobs"), "z", nrow(dane), "\n\n")
est <- parameterEstimates(fit, level = 0.95)
cat("Mediation Estimates (Standard)\n"); print(tabela_med(est))
cat("\nPath Estimates (Standard)\n"); print(tabela_sciezek(est))

# 2. Bootstrap: 1000 prób; parameterEstimates() domyślnie daje przedział percentylowy
set.seed(2026)
fit_b <- sem(model, data = dane, se = "bootstrap", bootstrap = 1000)
est_b <- parameterEstimates(fit_b, level = 0.95)
cat("\nMediation Estimates (Bootstrap, 1000 prób)\n"); print(tabela_med(est_b))
cat("\nPath Estimates (Bootstrap, 1000 prób)\n"); print(tabela_sciezek(est_b))

# 3. Ten sam bootstrap uruchomiony z innym ziarnem: granice przedziału dla a×b
for (s in c(1, 2, 4)) {
  set.seed(s)
  e <- parameterEstimates(sem(model, data = dane, se = "bootstrap", bootstrap = 1000))
  w <- e[e$label == "ab", ]
  cat(sprintf("seed %d: a×b = %.4f, 95%% CI [%.4f, %.4f]\n", s, w$est, w$ci.lower, w$ci.upper))
}

# 4. Wyniki standaryzowane (std.all) dla a, b, c' i a×b
std <- standardizedSolution(fit)
print(round(setNames(std$est.std[match(c("a", "b", "c", "ab"), std$label)],
                     c("a", "b", "c'", "a×b")), 3))

# 5. Dla porównania: dwie regresje MNK na tych samych 177 osobach
pelne <- dane[complete.cases(dane), ]
m1 <- lm(samoskutecznosc ~ wsparcie, data = pelne)
m2 <- lm(zaangazowanie ~ samoskutecznosc + wsparcie, data = pelne)
print(round(coef(summary(m1)), 4)); print(round(coef(summary(m2)), 4))
cat("R2 mediatora =", round(summary(m1)$r.squared, 3), " R2 zaangażowania =", round(summary(m2)$r.squared, 3), "\n")
Wynik w R
Użyte obserwacje: 177 z 180

Mediation Estimates (Standard)
         Estimate    SE  Lower Upper     Z      p % Mediation
Indirect    0.199 0.058  0.085 0.312 3.434 < .001      52.160
Direct      0.182 0.111 -0.036 0.400 1.639  0.101      47.840
Total       0.381 0.104  0.177 0.585 3.660 < .001     100.000

Path Estimates (Standard)
                                    Estimate    SE  Lower Upper     Z      p
wsparcie → samoskutecznosc (a)         0.406 0.062  0.285 0.526 6.597 < .001
samoskutecznosc → zaangazowanie (b)    0.490 0.122  0.251 0.728 4.022 < .001
wsparcie → zaangazowanie (c')          0.182 0.111 -0.036 0.400 1.639  0.101

Mediation Estimates (Bootstrap, 1000 prób)
         Estimate    SE  Lower Upper     Z      p % Mediation
Indirect    0.199 0.063  0.087 0.326 3.165  0.002      52.160
Direct      0.182 0.120 -0.071 0.412 1.524  0.127      47.840
Total       0.381 0.112  0.152 0.598 3.404 < .001     100.000

Path Estimates (Bootstrap, 1000 prób)
                                    Estimate    SE  Lower Upper     Z      p
wsparcie → samoskutecznosc (a)         0.406 0.057  0.292 0.519 7.066 < .001
samoskutecznosc → zaangazowanie (b)    0.490 0.136  0.237 0.775 3.608 < .001
wsparcie → zaangazowanie (c')          0.182 0.120 -0.071 0.412 1.524  0.127
seed 1: a×b = 0.1987, 95% CI [0.0870, 0.3223]
seed 2: a×b = 0.1987, 95% CI [0.0820, 0.3240]
seed 4: a×b = 0.1987, 95% CI [0.0862, 0.3228]
    a     b    c'   a×b
0.444 0.311 0.127 0.138
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   1.7853     0.2147  8.3137        0
wsparcie      0.4059     0.0619  6.5601        0
                Estimate Std. Error t value Pr(>|t|)
(Intercept)       1.6963     0.4120  4.1171   0.0001
samoskutecznosc   0.4897     0.1228  3.9877   0.0001
wsparcie          0.1823     0.1122  1.6249   0.1060
R2 mediatora = 0.197  R2 zaangażowania = 0.148
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję jamovi i modułu, których faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy w mediacji w jamovi
- Przepisanie wyniku z ustawieniami domyślnymi. Domyślnie nie ma przedziału ufności, a test efektu pośredniego opiera się na metodzie delta. Włącz Confidence interval i Bootstrap.
- Zamienione pola. Mediator w polu Predictor daje zupełnie inny model. Sprawdź podpisy w tabeli Path Estimates: pierwszy wiersz to X → M.
- Wnioskowanie z kroków Barona i Kenny’ego. Nieistotny efekt całkowity nie wyklucza efektu pośredniego, a istotne a i b nie zastępują przedziału dla a × b (podejście Barona i Kenny’ego).
- Procent mediacji jako główny wynik. Bez przedziału ufności i przy przeciwnych znakach efektów wprowadza w błąd.
- Brak liczby prób i metody przedziału w Metodzie. Czytelnik nie odtworzy wyniku, a granice i tak różnią się między uruchomieniami.
- Kategorialny predyktor w medmod. Moduł przyjmuje tylko zmienne liczbowe. Przy więcej niż dwóch grupach użyj jAMM (Factors).
- Słownictwo przyczynowe przy danych przekrojowych. „Samoskuteczność wyjaśnia wpływ wsparcia” to za mocne zdanie dla jednego pomiaru – pisz o efekcie pośrednim.
Najczęstsze pytania
Jaki moduł do mediacji w jamovi wybrać: medmod czy jAMM?
Do mediacji prostej (jeden predyktor liczbowy, jeden mediator) wystarczy medmod – ma jedno okno i dwie tabele. jAMM wybierz, gdy masz kilka mediatorów, kilka predyktorów, predyktor kategorialny albo moderator. Oba liczą model w pakiecie lavaan, a domyślnie podają przedziały z metody delta.
Czy medmod w jamovi liczy bootstrap percentylowy?
Po wybraniu Bootstrap moduł przekazuje liczbę prób do lavaan i bierze przedziały z funkcji parameterEstimates() bez zmiany typu przedziału, a domyślny typ w lavaan to przedział percentylowy. Przy domyślnym ustawieniu Standard bootstrapu nie ma – przedział pochodzi z metody delta.
Dlaczego przedział bootstrapowy w jamovi zmienia się po ponownym uruchomieniu?
Bootstrap losuje próby, a w oknie medmod nie ma pola na ziarno losowania, więc każde przeliczenie daje nieco inne granice. W przykładzie z 1000 próbami dolna granica wahała się od 0.082 do 0.087. Podaj w pracy liczbę prób, a przy granicy bliskiej zera zwiększ ją.
Co oznacza % Mediation w jamovi?
W medmod to |a × b| / (|a × b| + |c′|) × 100, czyli udział efektu pośredniego w sumie wartości bezwzględnych obu efektów. Kolumna nie ma przedziału ufności i myli, gdy efekty mają przeciwne znaki albo efekt całkowity jest mały. W pracy raportuj przede wszystkim efekty z przedziałami.
Czy w medmod mogę dodać zmienną kontrolną do mediacji?
Nie – okno Mediation ma tylko pola Dependent Variable, Mediator i Predictor. Zmienną kontrolną dodasz w jAMM (jako kolejny predyktor w Covariates lub Factors, z poprawionym modelem na kartach Mediators models i Full model) albo w R w lavaan.
Powiązane hasła
Przeczytaj też
Analiza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikMediacja i moderacja w SPSS z PROCESS
Instalacja makra Hayesa, modele 1, 4 i 7, efekt pośredni z bootstrapem, efekty warunkowe, indeks moderowanej mediacji i zapis APA – z plikiem .sav.
Czytaj →Poradnikjamovi krok po kroku
Descriptives, test t Welcha, Correlation Matrix i One-Way ANOVA na jednym zbiorze danych: nazwy opcji z dokumentacji, gotowe zdania APA, kod jmv.
Czytaj →Masz mediację z jamovi i nie wiesz, co przepisać do pracy?
Sprawdzimy model, ustawienia przedziałów i opis efektów pośrednich oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Gallucci, M. (b.d.). jAMM: jamovi Advanced Mediation Models – documentation (GLM mediation models, Model estimates, jAMM: simple mediation). jAMM documentation. https://jamovi-amm.github.io/ ● Otwarty dostęp
- Hayes, A. F., & Scharkow, M. (2013). The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter? Psychological Science, 24(10), 1918–1927. https://doi.org/10.1177/0956797613480187
- MacKinnon, D. P., Lockwood, C. M., & Williams, J. (2004). Confidence limits for the indirect effect: Distribution of the product and resampling methods. Multivariate Behavioral Research, 39(1), 99–128. https://doi.org/10.1207/s15327906mbr3901_4 ● Otwarty dostęp
- Preacher, K. J., & Kelley, K. (2011). Effect size measures for mediation models: Quantitative strategies for communicating indirect effects. Psychological Methods, 16(2), 93–115. https://doi.org/10.1037/a0022658
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Selker, R. (2026). medmod: Simple mediation and moderation analysis (R package and jamovi module, version 1.2.0) [Computer software]. https://CRAN.R-project.org/package=medmod ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.). Library modules. https://www.jamovi.org/modules.html ● Otwarty dostęp
Cytowania BibTeX
@misc{galluccindjamm, author={Gallucci, Marcello}, title={{jAMM: jamovi Advanced Mediation Models – documentation (GLM mediation models, Model estimates, jAMM: simple mediation)}}, howpublished={jAMM documentation}, year={b.d.}, url={https://jamovi-amm.github.io/}}@article{hayes2013relative, author={Hayes, Andrew F. and Scharkow, Michael}, title={{The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter?}}, journal={Psychological Science}, year={2013}, volume={24}, number={10}, pages={1918--1927}, doi={10.1177/0956797613480187}}@article{mackinnon2004confidence, author={MacKinnon, David P. and Lockwood, Chondra M. and Williams, Jason}, title={{Confidence limits for the indirect effect: Distribution of the product and resampling methods}}, journal={Multivariate Behavioral Research}, year={2004}, volume={39}, number={1}, pages={99--128}, doi={10.1207/s15327906mbr3901_4}}@article{preacher2011effect, author={Preacher, Kristopher J. and Kelley, Ken}, title={{Effect size measures for mediation models: Quantitative strategies for communicating indirect effects}}, journal={Psychological Methods}, year={2011}, volume={16}, number={2}, pages={93--115}, doi={10.1037/a0022658}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@misc{selker2026medmod, author={Selker, Ravi}, title={{medmod: Simple mediation and moderation analysis (R package and jamovi module, version 1.2.0) [Computer software]}}, year={2026}, url={https://CRAN.R-project.org/package=medmod}}@misc{jamovindmodules, author={{The jamovi project}}, title={{Library modules}}, howpublished={jamovi}, year={b.d.}, url={https://www.jamovi.org/modules.html}}