Mediacja to proces w czasie, a nie korelacja w jednej chwili
Hipoteza mediacyjna opisuje łańcuch zdarzeń: stres w pracy zwiększa wyczerpanie emocjonalne, a wyczerpanie po pewnym czasie nasila objawy depresyjne. Każde ogniwo potrzebuje czasu. Dlatego efekt pośredni policzony na danych z jednego pomiaru jest odpowiedzią na inne pytanie niż to, które zadaje teoria. Maxwell i Cole (2007) pokazali, że przekrojowe analizy procesów podłużnych dają zwykle wyraźnie obciążone oszacowania. Tę pracę i podstawy mediacji omawia wpis analiza mediacji krok po kroku. Tu zajmiemy się praktyką: które schematy z kilkoma falami trafiają w prawdziwy efekt, jak policzyć efekt pośredni w modelach cross-lagged i ile zależy od odstępu między pomiarami.
Selig i Preacher (2009) wskazują trzy decyzje, od których zależy model mediacji podłużnej: jak zmieniają się zmienne, jaką rolę gra czas i jaki efekt pośredni chcemy oszacować. Wszystkie trzy wracają poniżej na jednym przykładzie.
Przykład: stres w pracy, wyczerpanie i objawy depresyjne
Dane symulowane: 500 pracowników, cztery fale co pół roku, w każdej stres w pracy (X), wyczerpanie emocjonalne (M) i objawy depresyjne (Y) na skalach 1–5. Proces wewnątrz osoby jest prosty i znany:
- każda zmienna zależy od własnego poprzedniego poziomu (autoregresja 0.50);
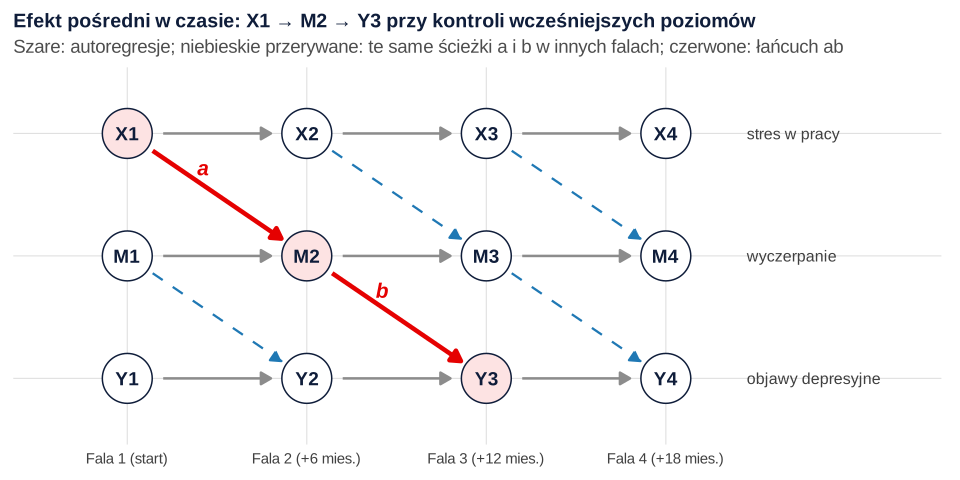
- stres podnosi wyczerpanie pół roku później (a = 0.30), a wyczerpanie podnosi objawy pół roku później (b = 0.30);
- stres nie działa na objawy bezpośrednio (c′ = 0), więc prawdziwy efekt pośredni X1 → M2 → Y3 wynosi ab = 0.09.
Do tego osoby różnią się stale poziomem wszystkich trzech zmiennych (stałe cechy skorelowane .50), jak w schemacie podłużnym z prawdziwego życia. Rysunek 1 pokazuje, czego szukamy: łańcucha przez trzy fale przy kontroli wcześniejszych poziomów każdej zmiennej.
Skróty, które nie działają: przekrój i X1 → M2 → Y3 bez kontroli
W schemacie przekrojowym z fali 4 regresje dały a = 0.360, b = 0.459 i ab = 0.165, czyli prawie dwa razy więcej niż prawdziwe 0.09. Co gorsze, pojawił się efekt bezpośredni c′ = 0.195, którego w procesie nie ma. Korelacje w jednej chwili gromadzą całą wcześniejszą historię wpływów, stabilność zmiennych i stałe różnice między osobami.
Popularną odpowiedzią jest schemat sekwencyjny: stres z fali 1, wyczerpanie z fali 2, objawy z fali 3. Kolejność wygląda poprawnie, ale wynik był jeszcze gorszy: a = 0.449, b = 0.447, ab = 0.200. Bez kontroli wyczerpania z fali 1 ścieżka a mierzy też to, że osoby zestresowane już wcześniej były wyczerpane. Mitchell i Maxwell (2013) wyprowadzili wzory na to obciążenie i doszli do wniosku, że schemat sekwencyjny na ogół nie ocenia mediacji podłużnej trafniej niż przekrojowy. O'Laughlin, Martin i Ferrer (2018) na dwóch zbiorach danych pokazali, że wnioski z modeli przekrojowych i podłużnych potrafią się wyraźnie różnić.
Łańcuch X1 → M2 → Y3 ma sens dopiero wtedy, gdy w każdym równaniu kontrolujesz wcześniejszy poziom zmiennej zależnej. Z kontrolą (M2 na X1, M1 i Y1; Y3 na M2, Y2, X1 i M1) oszacowanie spadło do ab = 0.047. To z kolei za mało, bo stałe różnice między osobami wciąż mieszają się z dynamiką. Wrócimy do tego przy RI-CLPM.
Tylko dwie fale: schemat półpodłużny
Gdy masz dwa pomiary X, M i Y, możesz oszacować ścieżkę a z równania M2 na X1 przy kontroli M1 i ścieżkę b z równania Y2 na M1 przy kontroli Y1. To schemat półpodłużny (half-longitudinal) z pracy Cole'a i Maxwella (2003). Iloczyn ab szacuje efekt pośredni przez dwa odstępy, choć żaden łańcuch nie został zmierzony w całości. Działa to tylko przy założeniu stacjonarności: ścieżka b między falami 1 i 2 musi być taka sama jak między 2 i 3. Przy dwóch falach nie da się tego sprawdzić, więc trzeba to napisać wprost.
W przykładzie schemat półpodłużny dał a = 0.181, b = 0.133 i ab = 0.024. Przy danych bez stałych różnic między osobami ten sam schemat był nieobciążony (symulacja niżej). Cole i Maxwell (2003) proponują przy podłużnych testach mediacji pięć kroków: sprawdzenie modelu pomiarowego, dodatkowych komponentów, pominiętych ścieżek, założenia stacjonarności i dopiero na końcu oszacowanie efektów mediacyjnych. Przy konstruktach latentnych pierwszy krok obejmuje inwariancję podłużną pomiaru.
Trzy i więcej fal: CLPM z efektem pośrednim w lavaan
Przy trzech i więcej falach wszystkie równania szacuje się naraz jako model cross-lagged (CLPM, opis modelu we wpisie modele cross-lagged CLPM i RI-CLPM). Każda zmienna w fali t zależy od wszystkich trzech zmiennych z fali t − 1, a reszty w tej samej fali są skorelowane. W lavaan nadaj ścieżkom te same etykiety we wszystkich falach (a, b, cp) i zdefiniuj efekt pośredni ab := a*b. Te same etykiety oznaczają założenie stacjonarności, które przy czterech falach możesz przetestować, porównując model z ograniczeniami z modelem o ścieżkach swobodnych.
CLPM dopasował się przeciętnie: χ²(45) = 136.06, CFI = .980, RMSEA = .064, SRMR = .039. Efekt pośredni wyniósł ab = 0.031, 95% CI [0.022, 0.039], czyli mniej niż jedną trzecią prawdziwej wartości. Ścieżka c′ = 0.005 była bliska zeru. Przedział jest wąski, a oszacowanie i tak chybione: precyzja nie chroni przed złą specyfikacją.
RI-CLPM: efekt pośredni wewnątrz osoby
Hamaker, Kuiper i Grasman (2015) pokazali, że gdy stabilność zmiennych ma w części charakter stałej cechy, ścieżki CLPM nie opisują zależności wewnątrzosobowych. RI-CLPM dodaje dla każdej zmiennej losowe przechwycenie, które przejmuje stałe różnice między osobami. Autoregresje i ścieżki krzyżowe, a więc i a, b oraz ab, dotyczą wtedy odchyleń osoby od jej własnego typowego poziomu. To ta sama logika co w rozdzieleniu efektów wewnątrz- i międzyosobowych.
RI-CLPM dopasował się bardzo dobrze: χ²(39) = 43.53, CFI = .999, RMSEA = .015, SRMR = .028. Test różnicy chi-kwadrat wyraźnie wskazał RI-CLPM: Δχ²(6) = 92.52, p < .001. Ponieważ CLPM odpowiada RI-CLPM z wariancjami przechwyceń ustalonymi na granicy przestrzeni parametrów (zero), zwykły test jest tu konserwatywny. Oszacowania: a = 0.285, 95% CI [0.207, 0.362], b = 0.312, 95% CI [0.238, 0.386], c′ = −0.046, 95% CI [−0.127, 0.035], ab = 0.089. Losowe przechwycenia korelowały ze sobą na poziomie .41–.44.
Przedział dla ab z metody delta wyniósł [0.057, 0.121], a przedział Monte Carlo z 20 000 losowań [0.059, 0.122]. Preacher i Selig (2012) pokazali, że przedział Monte Carlo działa porównywalnie z innymi uznanymi metodami, wymaga tylko oszacowań i ich kowariancji i nadaje się tam, gdzie bootstrap w SEM jest uciążliwy. Przy RI-CLPM z wieloma falami to częsta sytuacja. Ten sam przedział policzysz w kalkulatorze efektu pośredniego Monte Carlo. Mulder i Hamaker (2021) opisują rozszerzenia RI-CLPM: stałe cechy osoby jako predyktory, wersję wielogrupową i model z wieloma wskaźnikami w każdej fali.
300 powtórzeń: które oszacowanie trafia
Jeden zbiór danych może być nietypowy. Dlatego to samo badanie powtórzyliśmy 300 razy w dwóch scenariuszach: bez stałych różnic między osobami (A) i ze stałymi różnicami jak w przykładzie (B). Tabela zestawia przykład i średnie z powtórzeń; rysunek 2 pokazuje rozrzut.
| Sposób liczenia ab | Przykład (N = 500) | Scenariusz A: średnia (SD) | Scenariusz B: średnia (SD) |
|---|---|---|---|
| Przekrojowo (fala 4) | 0.165 | 0.159 (0.026) | 0.170 (0.024) |
| Sekwencyjnie X1 → M2 → Y3 | 0.200 | 0.252 (0.032) | 0.214 (0.030) |
| X1 → M2 → Y3 z kontrolą wcześniejszych poziomów | 0.047 | 0.089 (0.020) | 0.044 (0.012) |
| Półpodłużnie (fale 1–2) | 0.024 | 0.088 (0.018) | 0.032 (0.008) |
| CLPM (4 fale) | 0.031 | 0.090 (0.010) | 0.033 (0.005) |
| RI-CLPM (4 fale) | 0.089 | 0.089 (0.015) | 0.088 (0.016) |
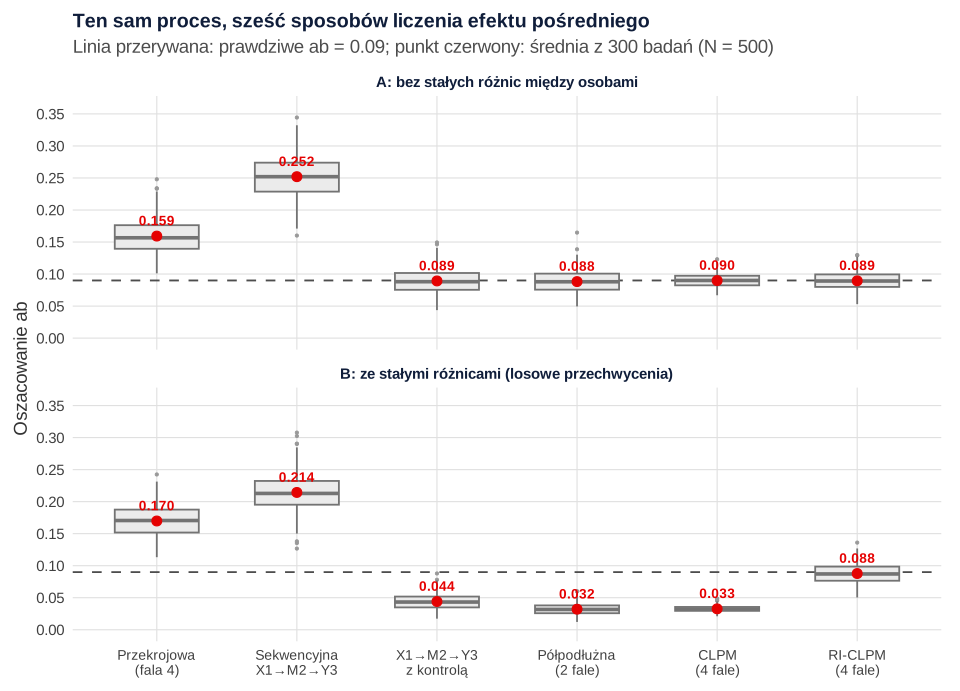
Wnioski są jednoznaczne. Przekrój i schemat sekwencyjny zawyżały ab w obu scenariuszach. Gdy osoby nie różniły się stale, wszystkie schematy z kontrolą wcześniejszych poziomów trafiały, a CLPM był najbardziej precyzyjny (SD = 0.010). Gdy stałe różnice istniały, schemat półpodłużny i CLPM zaniżały efekt mniej więcej o dwie trzecie. 95% przedział CLPM nie objął wtedy prawdziwej wartości w żadnym z 300 badań, a przedział RI-CLPM – w 95.0% badań. Błąd Monte Carlo średnich nie przekraczał 0.002.
Ceną RI-CLPM jest mniejsza precyzja, gdy stałych różnic nie ma (SD 0.015 zamiast 0.010), i wymóg co najmniej trzech fal. Wybór między modelami to jednak przede wszystkim wybór pytania: RI-CLPM mówi o procesie w osobie, CLPM o mieszaninie procesu i różnic między osobami.
Odstęp między falami zmienia efekt pośredni
Ścieżki a i b nie są stałymi relacji, tylko własnością relacji i odstępu. Dormann i Griffin (2015) pokazali, że współczynniki krzyżowo-opóźnione zależą od odstępu, a optymalne odstępy są zwykle dość krótkie. W mediacji problem się podwaja, bo chodzi o iloczyn dwóch takich ścieżek. Rysunek 3 pokazuje wartości populacyjne dla procesu z przykładu przy pomiarach co 6, 12, …, 36 miesięcy.
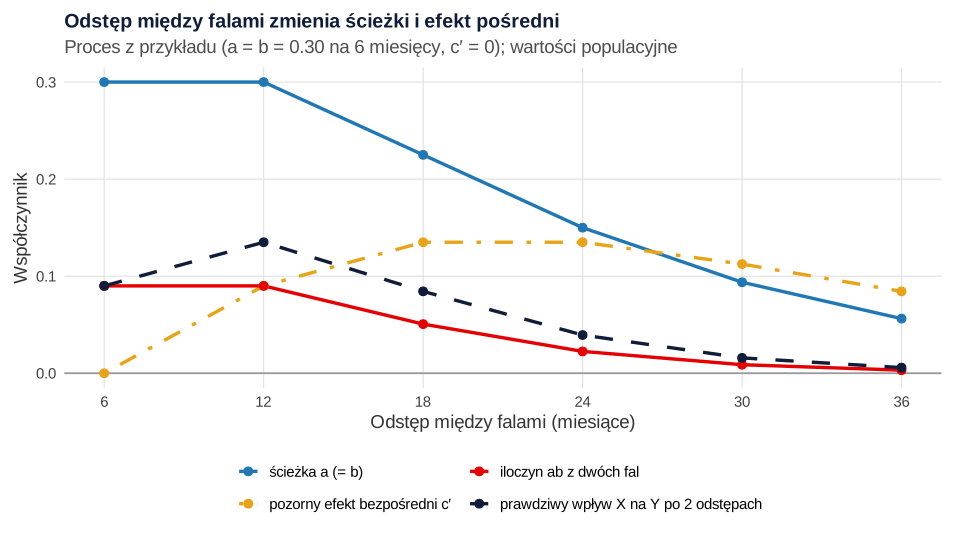
Przy odstępie 6 miesięcy, zgodnym z tempem procesu, ab = 0.090 i c′ = 0. Przy 12 miesiącach ścieżka a nadal wynosi 0.300, ale część mediacji dzieje się już wewnątrz odstępu. Model widzi ją jako efekt bezpośredni c′ = 0.090, a ab = 0.090 nie odpowiada prawdziwemu wpływowi stresu na objawy po 24 miesiącach (0.135). Przy 36 miesiącach ab spada do 0.003. „Mediacja częściowa” może więc być skutkiem zbyt rzadkich pomiarów. Odstęp dobierz z teorii, pilotażu lub badań z gęstymi pomiarami, a planowanie fal i odpadania uczestników opisuje wpis badanie podłużne w doktoracie.
Jak opisać mediację podłużną w artykule
Podaj liczbę fal i odstęp z uzasadnieniem, model (CLPM czy RI-CLPM) i powód wyboru, ograniczenia stacjonarności i ich test, dopasowanie modeli, ścieżki a, b i c′ z przedziałami, efekt pośredni z metodą przedziału oraz sposób obsługi braków danych. Interpretuj wynik jako zależność czasową przy przyjętym modelu, a nie dowód przyczynowości – założenia przyczynowe i analizę wrażliwości omawia wpis o mediacji przyczynowej, a wybór zmiennych kontrolnych – grafy przyczynowe.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji R odtwarzają wszystkie liczby z tekstu. Przepis 1 tworzy plik mediacja-podluzna-dane.csv (możesz go pobrać tutaj), przepis 3 powtarza badanie 600 razy i trwa około minuty. Potrzebne pakiety: lavaan i MASS.
1. Dane i proste schematy
R
# Krok 1. Dane symulowane: stres w pracy (X), wyczerpanie emocjonalne (M) i objawy depresyjne (Y),
# 4 fale co pół roku, N = 500. Proces wewnątrzosobowy: X(t-1) -> M(t) -> Y(t+1), a = 0.30, b = 0.30, c' = 0.
# Do tego stałe różnice między osobami (losowe przechwycenia), skorelowane .50.
library(MASS)
symuluj_panel <- function(n, fale = 4, a = 0.30, b = 0.30, ar = 0.50,
                          wariancja_cechy = 1, kor_cech = 0.50, rozgrzewka = 30) {
  B <- matrix(c(ar, 0,  0,     # X(t) = 0.5 X(t-1)
                a,  ar, 0,     # M(t) = 0.3 X(t-1) + 0.5 M(t-1)
                0,  b,  ar),   # Y(t) = 0.3 M(t-1) + 0.5 Y(t-1)
              3, 3, byrow = TRUE)
  Psi <- matrix(0.15, 3, 3); diag(Psi) <- 0.75          # innowacje skorelowane w tej samej fali
  S_cech <- matrix(kor_cech, 3, 3); diag(S_cech) <- 1
  cechy <- mvrnorm(n, rep(0, 3), wariancja_cechy * S_cech)
  w <- matrix(0, n, 3); wynik <- list()
  for (t in seq_len(rozgrzewka + fale)) {
    w <- w %*% t(B) + mvrnorm(n, rep(0, 3), Psi)        # składnik wewnątrzosobowy
    if (t > rozgrzewka) wynik[[t - rozgrzewka]] <- w + cechy
  }
  d <- do.call(cbind, wynik)
  colnames(d) <- paste0(rep(c("x", "m", "y"), fale), rep(seq_len(fale), each = 3))
  # skala wyników: średnie 3.0, 2.5 i 2.0 (skale 1–5); to samo przesunięcie i mnożnik dla wszystkich zmiennych
  as.data.frame(round(0.6 * d + rep(c(3.0, 2.5, 2.0), fale)[col(d)], 3))
}
set.seed(3601)
dane <- symuluj_panel(500)
write.csv(dane, "../mediacja-podluzna-dane.csv", row.names = FALSE)
round(sapply(dane[, c("x1", "m1", "y1", "x4", "m4", "y4")], function(v) c(M = mean(v), SD = sd(v))), 2)
round(cor(dane[, c("x1", "m2", "y3")]), 2)

# Pomocnik: ścieżki a, b i efekt pośredni ab
pokaz <- function(a, b) round(c(a = unname(a), b = unname(b), ab = unname(a * b)), 3)
# Prawdziwy efekt pośredni (wewnątrzosobowy, w jednostkach surowych)
pokaz(0.30, 0.30)

# 1a. Mediacja przekrojowa w fali 4
a_prz <- coef(lm(m4 ~ x4, dane))["x4"]
mod_prz <- lm(y4 ~ m4 + x4, dane)
c(pokaz(a_prz, coef(mod_prz)["m4"]), c_prim = round(unname(coef(mod_prz)["x4"]), 3))

# 1b. Schemat sekwencyjny X1 -> M2 -> Y3 bez kontroli wcześniejszych poziomów
a_sek <- coef(lm(m2 ~ x1, dane))["x1"]
b_sek <- coef(lm(y3 ~ m2 + x1, dane))["m2"]
pokaz(a_sek, b_sek)

# 1c. Ten sam łańcuch X1 -> M2 -> Y3 z kontrolą wcześniejszych poziomów
a_kon <- coef(lm(m2 ~ x1 + m1 + y1, dane))["x1"]
b_kon <- coef(lm(y3 ~ m2 + y2 + x1 + m1, dane))["m2"]
pokaz(a_kon, b_kon)

# 1d. Schemat „half-longitudinal” (Cole i Maxwell, 2003): tylko fale 1 i 2
a_pol <- coef(lm(m2 ~ x1 + m1 + y1, dane))["x1"]   # a: X1 -> M2 przy kontroli M1 (i Y1)
b_pol <- coef(lm(y2 ~ m1 + y1 + x1, dane))["m1"]   # b: M1 -> Y2 przy kontroli Y1 (i X1)
pokaz(a_pol, b_pol)
Wynik w R
     x1   m1   y1   x4   m4   y4
M  3.05 2.55 2.15 3.06 2.54 2.09
SD 0.84 0.86 0.92 0.86 0.88 0.93
     x1   m2   y3
x1 1.00 0.44 0.25
m2 0.44 1.00 0.45
y3 0.25 0.45 1.00
   a    b   ab
0.30 0.30 0.09
     a      b     ab c_prim
 0.360  0.459  0.165  0.195
    a     b    ab
0.449 0.447 0.200
    a     b    ab
0.181 0.261 0.047
    a     b    ab
0.181 0.133 0.024
2. CLPM i RI-CLPM z efektem pośrednim
R
# Krok 2. CLPM i RI-CLPM w lavaan z efektem pośrednim a*b (uruchom po przepisie 1)
suppressPackageStartupMessages(library(lavaan))
fale <- 1:4
# Składnia budowana pętlą: te same etykiety w każdej fali = założenie stacjonarności ścieżek
sciezki <- function(p) unlist(lapply(fale[-1], function(t) c(
  sprintf("%sx%d ~ ar_x*%sx%d + mx*%sm%d + yx*%sy%d", p, t, p, t-1, p, t-1, p, t-1),
  sprintf("%sm%d ~ a*%sx%d + ar_m*%sm%d + ym*%sy%d",  p, t, p, t-1, p, t-1, p, t-1),
  sprintf("%sy%d ~ cp*%sx%d + b*%sm%d + ar_y*%sy%d",  p, t, p, t-1, p, t-1, p, t-1),
  sprintf("%sx%d ~~ %sm%d + %sy%d\n%sm%d ~~ %sy%d", p, t, p, t, p, t, p, t, p, t))))
start <- function(p) sprintf("%sx1 ~~ %sm1 + %sy1\n%sm1 ~~ %sy1", p, p, p, p, p)
efekt <- "ab := a*b"

clpm <- paste(c(start(""), sciezki(""), efekt), collapse = "\n")
fit_clpm <- sem(clpm, data = dane, auto.cov.y = FALSE)

ri <- c("RIx =~ 1*x1 + 1*x2 + 1*x3 + 1*x4",   # stałe różnice między osobami
        "RIm =~ 1*m1 + 1*m2 + 1*m3 + 1*m4",
        "RIy =~ 1*y1 + 1*y2 + 1*y3 + 1*y4",
        unlist(lapply(fale, function(t) sprintf(   # składniki wewnątrzosobowe
          "wx%d =~ 1*x%d\nwm%d =~ 1*m%d\nwy%d =~ 1*y%d\nx%d ~~ 0*x%d\nm%d ~~ 0*m%d\ny%d ~~ 0*y%d",
          t, t, t, t, t, t, t, t, t, t, t, t))),
        "wx1 + wm1 + wy1 ~~ 0*RIx + 0*RIm + 0*RIy")
riclpm <- paste(c(ri, start("w"), sciezki("w"), efekt), collapse = "\n")
fit_ri <- sem(riclpm, data = dane, auto.cov.y = FALSE)

# Dopasowanie obu modeli i test różnicy (CLPM = RI-CLPM z wariancjami RI równymi 0)
round(rbind(CLPM = fitMeasures(fit_clpm, c("chisq", "df", "cfi", "rmsea", "srmr")),
            RI_CLPM = fitMeasures(fit_ri, c("chisq", "df", "cfi", "rmsea", "srmr"))), 3)
anova(fit_clpm, fit_ri)

# Ścieżki a, b, c' i efekt pośredni z przedziałem delta
wybierz <- function(fit) {
  pe <- parameterEstimates(fit)
  pe <- pe[pe$label %in% c("a", "b", "cp", "ab") & !duplicated(pe$label), ]
  data.frame(par = pe$label, est = round(pe$est, 3), se = round(pe$se, 3),
             ci_dol = round(pe$ci.lower, 3), ci_gor = round(pe$ci.upper, 3))
}
wybierz(fit_clpm)
wybierz(fit_ri)

# Przedział Monte Carlo dla ab (Preacher i Selig, 2012): 20 000 losowań z rozkładu (a, b)
mc_ci <- function(fit, R = 20000) {
  est <- coef(fit)[c("a", "b")]
  V <- vcov(fit)[c("a", "b"), c("a", "b")]
  los <- MASS::mvrnorm(R, est, V)
  round(c(ab = prod(est), quantile(los[, 1] * los[, 2], c(.025, .975))), 3)
}
set.seed(3602)
rbind(CLPM = mc_ci(fit_clpm), RI_CLPM = mc_ci(fit_ri))

# Wariancje losowych przechwyceń i ich korelacje w RI-CLPM
round(lavInspect(fit_ri, "cov.lv")[c("RIx", "RIm", "RIy"), c("RIx", "RIm", "RIy")], 3)
round(lavInspect(fit_ri, "cor.lv")[c("RIx", "RIm", "RIy"), c("RIx", "RIm", "RIy")], 2)
Wynik w R
          chisq df   cfi rmsea  srmr
CLPM    136.057 45 0.980 0.064 0.039
RI_CLPM  43.533 39 0.999 0.015 0.028

Chi-Squared Difference Test

         Df   AIC   BIC   Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit_ri   39 10891 11055  43.533
fit_clpm 45 10971 11110 136.057     92.524 0.16983       6  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  par   est    se ci_dol ci_gor
1   a 0.167 0.018  0.131  0.203
2  cp 0.005 0.019 -0.032  0.042
3   b 0.183 0.019  0.146  0.221
4  ab 0.031 0.005  0.022  0.039
  par    est    se ci_dol ci_gor
1   a  0.285 0.039  0.207  0.362
2  cp -0.046 0.041 -0.127  0.035
3   b  0.312 0.038  0.238  0.386
4  ab  0.089 0.016  0.057  0.121
           ab  2.5% 97.5%
CLPM    0.031 0.022 0.040
RI_CLPM 0.089 0.059 0.122
      RIx   RIm   RIy
RIx 0.328 0.126 0.143
RIm 0.126 0.284 0.132
RIy 0.143 0.132 0.325
     RIx  RIm  RIy
RIx 1.00 0.41 0.44
RIm 0.41 1.00 0.43
RIy 0.44 0.43 1.00
3. Symulacja: 300 badań na scenariusz
R
# Krok 3. Powtórzenia: 300 badań na scenariusz, N = 500 (uruchom po przepisach 1–2)
# Scenariusz A: bez stałych różnic między osobami; B: stałe różnice jak w przykładzie.
jedno_badanie <- function(wariancja_cechy) {
  d <- symuluj_panel(500, wariancja_cechy = wariancja_cechy)
  ab_lm <- function(fa, fb, pa, pb) coef(lm(fa, d))[pa] * coef(lm(fb, d))[pb]
  wynik <- c(
    przekrojowa  = ab_lm(m4 ~ x4, y4 ~ m4 + x4, "x4", "m4"),
    sekwencyjna  = ab_lm(m2 ~ x1, y3 ~ m2 + x1, "x1", "m2"),
    z_kontrola   = ab_lm(m2 ~ x1 + m1 + y1, y3 ~ m2 + y2 + x1 + m1, "x1", "m2"),
    polpodluzna  = ab_lm(m2 ~ x1 + m1 + y1, y2 ~ m1 + y1 + x1, "x1", "m1"))
  for (m in c("CLPM", "RI_CLPM")) {
    fit <- try(sem(if (m == "CLPM") clpm else riclpm, data = d, auto.cov.y = FALSE), silent = TRUE)
    ok <- !inherits(fit, "try-error") && lavInspect(fit, "converged")
    pe <- if (ok) parameterEstimates(fit) else NULL
    pe <- if (ok) pe[pe$label == "ab", ] else NULL
    wynik[m] <- if (ok) pe$est else NA
    wynik[paste0(m, "_pokrycie")] <- if (ok) as.numeric(pe$ci.lower <= 0.09 & pe$ci.upper >= 0.09) else NA
  }
  wynik
}
set.seed(3603)
R <- 300
sym <- rbind(
  data.frame(scenariusz = "A", t(replicate(R, suppressWarnings(jedno_badanie(0))))),
  data.frame(scenariusz = "B", t(replicate(R, suppressWarnings(jedno_badanie(1))))))
names(sym) <- sub("\\..*$", "", names(sym))
write.csv(sym, "b360-symulacja.csv", row.names = FALSE)

metody <- c("przekrojowa", "sekwencyjna", "z_kontrola", "polpodluzna", "CLPM", "RI_CLPM")
podsumuj <- function(s) t(sapply(metody, function(m) {
  v <- s[[m]][!is.na(s[[m]])]
  c(n = length(v), srednia = mean(v), obciazenie = mean(v) - 0.09, SD = sd(v),
    blad_MC = sd(v) / sqrt(length(v)), RMSE = sqrt(mean((v - 0.09)^2)))
}))
lapply(split(sym, sym$scenariusz), function(s) round(podsumuj(s), 3))
# Pokrycie 95% CI (delta) dla prawdziwego ab = 0.09
round(sapply(split(sym, sym$scenariusz), function(s)
  colMeans(s[, c("CLPM_pokrycie", "RI_CLPM_pokrycie")], na.rm = TRUE)), 3)
Wynik w R
$A
              n srednia obciazenie    SD blad_MC  RMSE
przekrojowa 300   0.159      0.069 0.026   0.002 0.074
sekwencyjna 300   0.252      0.162 0.032   0.002 0.165
z_kontrola  300   0.089     -0.001 0.020   0.001 0.020
polpodluzna 300   0.088     -0.002 0.018   0.001 0.018
CLPM        300   0.090      0.000 0.010   0.001 0.010
RI_CLPM     300   0.089     -0.001 0.015   0.001 0.015

$B
              n srednia obciazenie    SD blad_MC  RMSE
przekrojowa 300   0.170      0.080 0.024   0.001 0.083
sekwencyjna 300   0.214      0.124 0.030   0.002 0.128
z_kontrola  300   0.044     -0.046 0.012   0.001 0.047
polpodluzna 300   0.032     -0.058 0.008   0.000 0.059
CLPM        300   0.033     -0.057 0.005   0.000 0.058
RI_CLPM     300   0.088     -0.002 0.016   0.001 0.016

                     A    B
CLPM_pokrycie    0.933 0.00
RI_CLPM_pokrycie 0.933 0.95
4. Odstęp między falami
R
# Krok 4. Odstęp między falami: te same procesy, różne odstępy (wartości populacyjne, bez losowania)
# Przy procesie VAR(1) regresja fali t+k na fali t daje macierz B^k, więc ścieżki zależą od k.
B <- matrix(c(0.5, 0, 0, 0.3, 0.5, 0, 0, 0.3, 0.5), 3, 3, byrow = TRUE,
            dimnames = list(c("x", "m", "y"), c("x", "m", "y")))
potega <- function(M, k) Reduce(`%*%`, replicate(k, M, simplify = FALSE))
odstep <- data.frame(t(sapply(1:6, function(k) {
  Bk <- potega(B, k); B2k <- potega(B, 2 * k)
  c(k = k, miesiace = 6 * k, a = Bk["m", "x"], b = Bk["y", "m"], c_prim = Bk["y", "x"],
    ab = Bk["m", "x"] * Bk["y", "m"], X_na_Y_po_2k = B2k["y", "x"])
})))
write.csv(odstep, "b360-odstep.csv", row.names = FALSE)
round(odstep, 3)
# Po ilu krokach wpływ X na Y jest największy?
wplyw <- sapply(1:10, function(j) potega(B, j)["y", "x"])
round(wplyw, 3); which.max(wplyw)
Wynik w R
  k miesiace     a     b c_prim    ab X_na_Y_po_2k
1 1        6 0.300 0.300  0.000 0.090        0.090
2 2       12 0.300 0.300  0.090 0.090        0.135
3 3       18 0.225 0.225  0.135 0.051        0.084
4 4       24 0.150 0.150  0.135 0.022        0.039
5 5       30 0.094 0.094  0.112 0.009        0.016
6 6       36 0.056 0.056  0.084 0.003        0.006
 [1] 0.000 0.090 0.135 0.135 0.112 0.084 0.059 0.039 0.025 0.016
[1] 3
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–4 w R 4.5.3 z pakietami lavaan i MASS; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Mediacja podłużna” bez kontroli wcześniejszych poziomów. Pomiar X, M i Y w kolejnych falach po jednym razie nie usuwa obciążenia; w symulacji było ono nawet większe niż w przekroju.
- Nazywanie schematu X1 → M2 → Y3 półpodłużnym. Schemat półpodłużny wymaga pomiaru M i Y w obu falach i kontroli ich wcześniejszych poziomów.
- Milczące założenie stacjonarności. Równe ścieżki w czasie to hipoteza: przetestuj ją, gdy masz trzy lub więcej fal, i nazwij ją, gdy masz dwie.
- CLPM przy stałych różnicach między osobami. Gdy osoby różnią się trwale poziomem zmiennych, efekt pośredni z CLPM może być daleki od procesu wewnątrzosobowego mimo wąskiego przedziału.
- Odstęp wybrany z wygody. Zbyt długi odstęp osłabia ab i tworzy pozorny efekt bezpośredni.
- Usuwanie osób z brakami. Przy utracie uczestników między falami użyj FIML w lavaan (
missing = "fiml") i opisz wzorzec braków.
Najczęstsze pytania
Dlaczego mediacja na danych z jednego pomiaru daje zły efekt pośredni?
Bo korelacje w jednym momencie są sumą całej wcześniejszej historii procesu, a nie wpływem z jednego odstępu. W symulacji z prawdziwym efektem pośrednim 0.09 analiza przekrojowa dawała średnio 0.159–0.170, a w przykładzie także fałszywy efekt bezpośredni c′ = 0.195. Kierunek i wielkość obciążenia zależą od stabilności zmiennych, więc nie da się go po prostu „odjąć”.
Czy schemat X1 → M2 → Y3 wystarczy do mediacji podłużnej?
Sama kolejność pomiarów nie wystarczy. Bez kontroli wcześniejszych poziomów M i Y ścieżki a i b zbierają stabilność zmiennych; w symulacji schemat sekwencyjny dawał średnio 0.214–0.252 zamiast 0.09. Mitchell i Maxwell (2013) pokazali analitycznie, że taki schemat na ogół nie jest trafniejszy od przekrojowego. Potrzebne są pomiary M i Y także na początku.
Czym różni się efekt pośredni w CLPM i RI-CLPM?
W CLPM ścieżki a i b mieszają różnice między osobami z dynamiką wewnątrz osoby. W RI-CLPM stałe różnice przejmują losowe przechwycenia, więc ab opisuje proces wewnątrzosobowy: czy wzrost stresu ponad typowy dla danej osoby poziom zapowiada jej późniejsze wyczerpanie, a to – objawy. W przykładzie CLPM dał ab = 0.031, a RI-CLPM 0.089.
Ile fal pomiaru potrzeba do mediacji podłużnej?
Minimum to dwie fale z pomiarem X, M i Y w każdej – wtedy można zastosować schemat półpodłużny przy założeniu stacjonarności ścieżek. Trzy fale pozwalają oszacować łańcuch X1 → M2 → Y3, a RI-CLPM wymaga co najmniej trzech fal; cztery i więcej pozwalają sprawdzić stacjonarność i stałe różnice między osobami.
Jaki odstęp między pomiarami wybrać w badaniu mediacji?
Taki, w jakim według teorii lub pilotażu X zdąży wpłynąć na M, a M na Y. Zbyt długi odstęp osłabia ścieżki i tworzy pozorny efekt bezpośredni: w przykładzie przy 12 miesiącach zamiast 6 pojawiło się c′ = 0.09, choć proces nie miał efektu bezpośredniego. Dormann i Griffin (2015) wskazują, że optymalne odstępy są zwykle krótsze, niż się przyjmuje.
Powiązane hasła
Przeczytaj też
Analiza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikModele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikMediacja przyczynowa i analiza wrażliwości
NDE, NIE i ACME zamiast samego ab, interakcja ekspozycja × mediator, sekwencyjna ignorowalność i analiza wrażliwości ρ – na jednym przykładzie w R.
Czytaj →Masz dane z kilku fal i hipotezę mediacyjną?
Pomożemy dobrać model do liczby fal i pytania (półpodłużny, CLPM, RI-CLPM), oszacować efekt pośredni z przedziałem i przygotować opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Cole, D. A., & Maxwell, S. E. (2003). Testing mediational models with longitudinal data: Questions and tips in the use of structural equation modeling. Journal of Abnormal Psychology, 112(4), 558–577. https://doi.org/10.1037/0021-843x.112.4.558
- Dormann, C., & Griffin, M. A. (2015). Optimal time lags in panel studies. Psychological Methods, 20(4), 489–505. https://doi.org/10.1037/met0000041
- Hamaker, E. L., Kuiper, R. M., & Grasman, R. P. P. P. (2015). A critique of the cross-lagged panel model. Psychological Methods, 20(1), 102–116. https://doi.org/10.1037/a0038889 ● Otwarty dostęp: pełny tekst
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989x.12.1.23
- Mitchell, M. A., & Maxwell, S. E. (2013). A comparison of the cross-sectional and sequential designs when assessing longitudinal mediation. Multivariate Behavioral Research, 48(3), 301–339. https://doi.org/10.1080/00273171.2013.784696
- Mulder, J. D., & Hamaker, E. L. (2021). Three extensions of the random intercept cross-lagged panel model. Structural Equation Modeling: A Multidisciplinary Journal, 28(4), 638–648. https://doi.org/10.1080/10705511.2020.1784738 ● Otwarty dostęp
- O'Laughlin, K. D., Martin, M. J., & Ferrer, E. (2018). Cross-sectional analysis of longitudinal mediation processes. Multivariate Behavioral Research, 53(3), 375–402. https://doi.org/10.1080/00273171.2018.1454822
- Preacher, K. J., & Selig, J. P. (2012). Advantages of Monte Carlo confidence intervals for indirect effects. Communication Methods and Measures, 6(2), 77–98. https://doi.org/10.1080/19312458.2012.679848
- Selig, J. P., & Preacher, K. J. (2009). Mediation models for longitudinal data in developmental research. Research in Human Development, 6(2–3), 144–164. https://doi.org/10.1080/15427600902911247
Cytowania BibTeX
@article{cole2003testing, author={Cole, David A. and Maxwell, Scott E.}, title={{Testing mediational models with longitudinal data: Questions and tips in the use of structural equation modeling}}, journal={Journal of Abnormal Psychology}, year={2003}, volume={112}, number={4}, pages={558--577}, doi={10.1037/0021-843x.112.4.558}}@article{dormann2015optimal, author={Dormann, Christian and Griffin, Mark A.}, title={{Optimal time lags in panel studies}}, journal={Psychological Methods}, year={2015}, volume={20}, number={4}, pages={489--505}, doi={10.1037/met0000041}}@article{hamaker2015critique, author={Hamaker, Ellen L. and Kuiper, Rebecca M. and Grasman, Raoul P. P. P.}, title={{A critique of the cross-lagged panel model}}, journal={Psychological Methods}, year={2015}, volume={20}, number={1}, pages={102--116}, doi={10.1037/a0038889}}@article{maxwell2007bias, author={Maxwell, Scott E. and Cole, David A.}, title={{Bias in cross-sectional analyses of longitudinal mediation}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={23--44}, doi={10.1037/1082-989x.12.1.23}}@article{mitchell2013comparison, author={Mitchell, Melissa A. and Maxwell, Scott E.}, title={{A comparison of the cross-sectional and sequential designs when assessing longitudinal mediation}}, journal={Multivariate Behavioral Research}, year={2013}, volume={48}, number={3}, pages={301--339}, doi={10.1080/00273171.2013.784696}}@article{mulder2021three, author={Mulder, Jeroen D. and Hamaker, Ellen L.}, title={{Three extensions of the random intercept cross-lagged panel model}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2021}, volume={28}, number={4}, pages={638--648}, doi={10.1080/10705511.2020.1784738}}@article{olaughlin2018cross, author={O'Laughlin, Kristine D. and Martin, Monica J. and Ferrer, Emilio}, title={{Cross-sectional analysis of longitudinal mediation processes}}, journal={Multivariate Behavioral Research}, year={2018}, volume={53}, number={3}, pages={375--402}, doi={10.1080/00273171.2018.1454822}}@article{preacher2012advantages, author={Preacher, Kristopher J. and Selig, James P.}, title={{Advantages of Monte Carlo confidence intervals for indirect effects}}, journal={Communication Methods and Measures}, year={2012}, volume={6}, number={2}, pages={77--98}, doi={10.1080/19312458.2012.679848}}@article{selig2009mediation, author={Selig, James P. and Preacher, Kristopher J.}, title={{Mediation models for longitudinal data in developmental research}}, journal={Research in Human Development}, year={2009}, volume={6}, number={2–3}, pages={144--164}, doi={10.1080/15427600902911247}}