Jeden współczynnik, dwa pytania
W badaniu dzienniczkowym pytasz, czy sen wiąże się ze stresem. Każda osoba podaje przez dwa tygodnie, ile spała i jak bardzo była zestresowana. Wpisujesz sen jako predyktor do modelu wielopoziomowego z losowym wyrazem wolnym i dostajesz jeden współczynnik. Odpowiada on jednak na dwa różne pytania naraz:
- wewnątrz osoby: czy w dniu po nocy dłuższej niż zwykle ta sama osoba jest mniej zestresowana?
- między osobami: czy osoby, które przeciętnie śpią dłużej, są przeciętnie mniej zestresowane?
Pierwsze dotyczy procesu u jednej osoby, drugie – różnic między ludźmi, na które wpływają ich stałe cechy. Curran i Bauer (2011) pokazują, że dane podłużne pozwalają te efekty rozdzielić, ale badacze często z tego nie korzystają. Hoffman i Stawski (2009) dodają, że niepełne wprowadzenie predyktora zmiennego w czasie zwykle obciąża oszacowania. Osoby trzeba traktować jak konteksty, w których zachodzą zmiany.
Ten wpis uzupełnia ogólny opis centrowania w haśle centrowanie zmiennych i przykład z pracownikami w zespołach z wpisu model wielopoziomowy krok po kroku. Tutaj chodzi o pomiary powtarzane u tych samych osób: efekty o przeciwnych znakach, trzy równoważne zapisy modelu, losowe nachylenie i nierzetelną średnią osoby.
Przykład: sen i stres w dzienniczku
Sto osób przez 14 dni rano notowało czas snu w godzinach, a wieczorem oceniało stres w ciągu dnia na skali 0–10. Około 10% dni pominięto, więc w analizie jest 1260 dni, średnio 12.6 na osobę. Dane są symulowane (set.seed(3471)) i możesz je pobrać jako plik CSV. Jeden wiersz to jeden dzień.
W symulacji zadaliśmy dwa przeciwne efekty. U każdej osoby noc o godzinę dłuższa niż jej norma obniża stres przeciętnie o 0.45 pkt, a siła tego efektu różni się między osobami. Jednocześnie osoby, które przeciętnie śpią o godzinę dłużej, mają stres wyższy o 0.90 pkt. Taki układ powstaje, gdy stała cecha osoby, np. przewlekła choroba albo nasilone objawy depresyjne, wydłuża czas w łóżku i podnosi stres. To scenariusz ilustracyjny, a nie wynik badań nad snem.
Średnio uczestnicy spali 7.00 h. Odchylenie standardowe średnich osób wynosi 0.59 h, a wahań dzień do dnia – 0.84 h. ICC snu wynosi .273, czyli 27.3% wariancji snu to różnice między osobami, a reszta to wahania wewnątrz osób. ICC stresu wynosi .313.
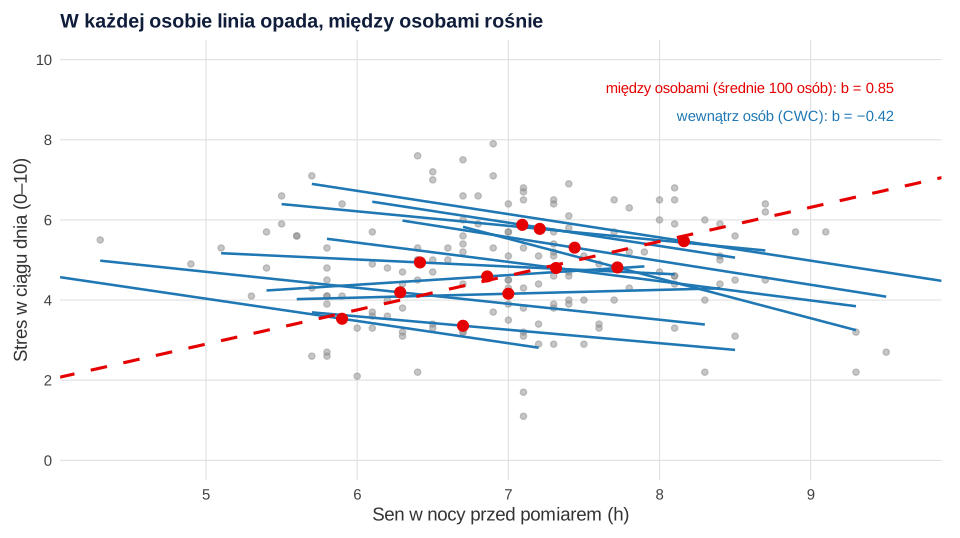
Rozdzielenie: odchylenie od normy i średnia osoby
Każdy pomiar predyktora rozkładasz na dwie części:
Pierwsza część to średnia osoby i ze wszystkich jej dni. Druga to odchylenie dnia j od tej średniej, czyli centrowanie w osobie (CWC, ang. centering within cluster, w danych podłużnych także person-mean centering). Odchylenie ma średnią 0 u każdej osoby, więc niesie wyłącznie zmienność wewnątrzosobową. Średnią osoby centrujesz do średniej wszystkich osób i wpisujesz jako predyktor poziomu 2. Enders i Tofighi (2007) podkreślają, że wybór sposobu centrowania wyznacza znaczenie współczynników i powinien wynikać z pytania badawczego. Jeśli pytasz o proces w osobie, potrzebujesz odchylenia.
W R obie zmienne tworzy funkcja demean() z pakietu datawizard: zwraca kolumny sen_between (średnia osoby) i sen_within (odchylenie). Średnie licz z tych samych wierszy, które trafią do modelu. Modele dopasowujemy w lme4 (Bates i in., 2015), a df liczymy metodą Satterthwaite’a z lmerTest (Kuznetsova i in., 2017).
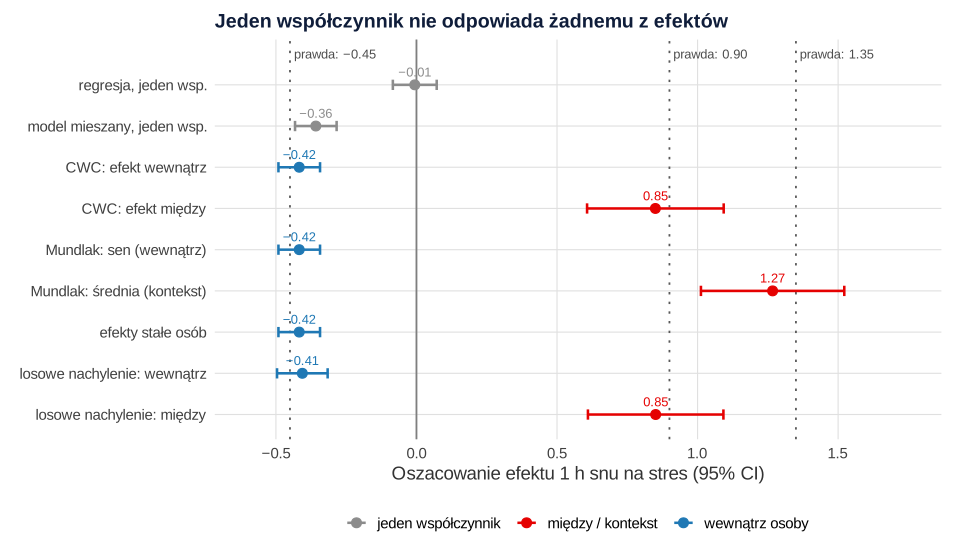
Model z rozdzielonymi efektami daje dwa współczynniki o przeciwnych znakach. Wewnątrz osoby godzina snu ponad własną normę wiązała się ze stresem niższym o 0.417 pkt (SE = 0.038). Między osobami każda godzina przeciętnego snu więcej wiązała się z przeciętnym stresem wyższym o 0.850 pkt (SE = 0.124). Model z jednym współczynnikiem dał −0.358, a zwykła regresja na wszystkich dniach −0.006, 95% CI [−0.084, 0.072]. Na podstawie zwykłej regresji uznałbyś, że sen nie ma związku ze stresem. Ten sam mechanizm stoi za paradoksem Simpsona i błędem ekologicznym.
Wartość −0.358 nie jest średnią obu efektów. Model z losowym wyrazem wolnym waży informację wewnątrzosobową i międzyosobową według ich precyzji, a przy 12–13 dniach na osobę informacja wewnątrzosobowa przeważa. Przy innej liczbie dni albo innym ICC predyktora ten sam proces dałby inną liczbę, więc jeden współczynnik nie odpowiada na żadne z dwóch pytań.
CWC, Mundlak i efekty stałe: trzy zapisy jednego efektu
Efekt wewnątrzosobowy da się oszacować na trzy sposoby.
- CWC i średnia osoby. Współczynnik odchylenia to efekt wewnątrz osoby, a współczynnik średniej osoby – efekt między osobami.
- Model Mundlaka. Do modelu wchodzi surowy predyktor (albo wycentrowany do średniej ogólnej) i średnia osoby. Współczynnik predyktora to znów efekt wewnątrz osoby, a współczynnik średniej to efekt kontekstowy, czyli różnica efektu między osobami i wewnątrz osoby. To sformułowanie wywodzi się z pracy Mundlaka (1978). Bell i in. (2019) nazywają taki model losowym modelem within–between i zalecają go jako punkt wyjścia. Nazwę „model hybrydowy” uważają za mylącą.
- Efekty stałe osób. Regresja z osobną zmienną zero-jedynkową dla każdej osoby porównuje osobę wyłącznie z nią samą (zob. estymator efektów stałych). Daje efekt wewnątrz osoby, ale nie daje efektu między osobami ani efektów zmiennych stałych w czasie.
Hamaker i Muthén (2020) pokazują, że spór o efekty stałe i losowe w ekonometrii oraz spór o centrowanie w psychologii dotyczą w istocie tego samego problemu. W przykładzie trzy zapisy dały identyczny efekt wewnątrzosobowy. Ekonometryczną stronę tego zagadnienia, z testem Hausmana, opisuje wpis dane panelowe: FE, RE i test Hausmana.
| Model | Współczynnik | b (SE) | 95% CI |
|---|---|---|---|
| Zwykła regresja | sen (jeden efekt) | −0.006 (0.040) | [−0.084, 0.072] |
| Model mieszany, losowy wyraz wolny | sen (jeden efekt) | −0.358 (0.038) | [−0.432, −0.284] |
| CWC + średnia osoby | wewnątrz osoby | −0.417 (0.038) | [−0.491, −0.343] |
| CWC + średnia osoby | między osobami | 0.850 (0.124) | [0.607, 1.093] |
| Mundlak | sen (wewnątrz osoby) | −0.417 (0.038) | [−0.491, −0.343] |
| Mundlak | średnia osoby (efekt kontekstowy) | 1.267 (0.130) | [1.012, 1.522] |
| Efekty stałe osób | sen (wewnątrz osoby) | −0.417 (0.038) | [−0.491, −0.343] |
| CWC + losowe nachylenie | wewnątrz osoby | −0.406 (0.046) | [−0.496, −0.316] |
| CWC + losowe nachylenie | między osobami | 0.851 (0.123) | [0.610, 1.092] |
Efekt kontekstowy z modelu Mundlaka to dokładnie różnica 0.850 − (−0.417) = 1.267. Nie interpretuj go jako efektu między osobami. Mówi on, o ile różni się stres dwóch osób, które w danym dniu spały tyle samo, ale jedna z nich śpi przeciętnie o godzinę dłużej.
Losowe nachylenie efektu wewnątrzosobowego
Model z samym losowym wyrazem wolnym zakłada, że u każdej osoby dodatkowa godzina snu obniża stres o tyle samo. To założenie rzadko jest prawdziwe. Gdy osoby różnią się siłą efektu, a model to pomija, błąd standardowy efektu wewnątrzosobowego jest za mały. Bell i in. (2019) pokazali w symulacjach, że pominięcie losowych nachyleń daje zaniżone błędy standardowe. Hamaker i Muthén (2020) omawiają konsekwencje dodania losowych nachyleń do modelu z rozdzielonymi efektami.
Dodaliśmy więc losowe nachylenie odchylenia snu: (1 + sen_within | id). Średnia osoby jest stała u danej osoby, więc nie może mieć nachylenia zmiennego między osobami. Odchylenie standardowe nachyleń wyniosło 0.257, a test ilorazu wiarygodności wypadł χ²(2) = 8.34, p = .015. Wartość p jest tu konserwatywna, bo wariancja leży na granicy przestrzeni parametrów. Efekt wewnątrzosobowy wyniósł b = −0.406, SE = 0.046, t(89.44) = −8.77, p < .001. Błąd standardowy wzrósł z 0.038 do 0.046, a stopnie swobody Satterthwaite’a (89.44) są bliższe liczbie osób niż liczbie dni. O precyzji tego efektu decyduje teraz głównie liczba osób. Przewidywane nachylenia osób mieściły się w przedziale od −0.822 do 0.076. Ujemne nachylenie miało 99% osób.
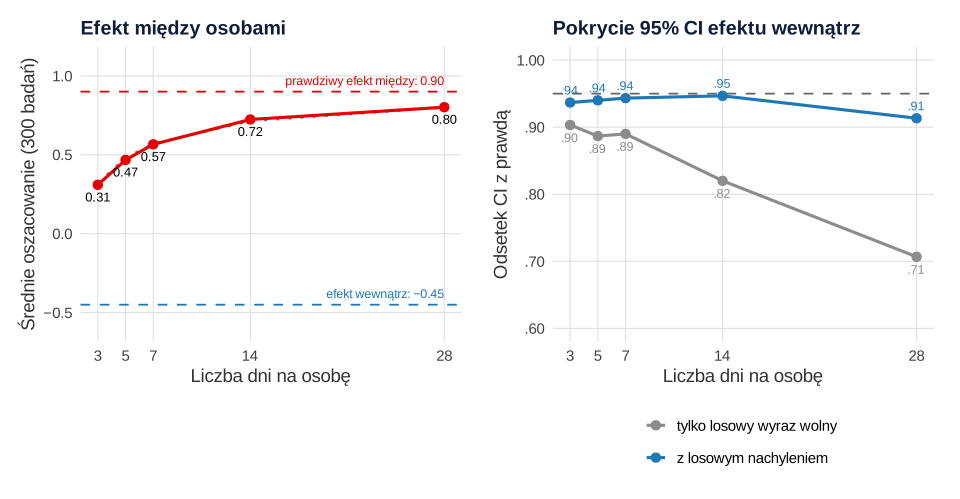
Ile kosztuje pominięcie nachylenia, pokazuje symulacja z prawym panelem rysunku 3. Wygenerowaliśmy po 300 badań ze 100 osobami i 3, 5, 7, 14 albo 28 dniami. Przy 3 dniach 95% przedział ufności modelu bez losowego nachylenia obejmował prawdziwy efekt w 90% badań. Przy 14 dniach odsetek ten spadł do 82%, a przy 28 dniach do 71%. Model z losowym nachyleniem miał pokrycie od 91% do 95%. Im więcej dni, tym mniejszy błąd liczony z reszt, ale zmienność nachyleń między osobami zostaje. Gdy model z losowym nachyleniem się nie zbiega, skorzystaj z procedury z wpisu model mieszany się nie zbiega, zamiast od razu usuwać nachylenie. Jeśli pytasz, kto reaguje silniej, dodaj interakcję międzypoziomową z cechą osoby.
Średnia z kilku dni to nierzetelna miara osoby
Efekt między osobami wymaga przeciętnego poziomu snu każdej osoby. Znasz go jednak tylko ze średniej z kilkunastu nocy, a ta zawiera błąd losowy. Rzetelność obserwowanej średniej opisuje wzór Spearmana–Browna (zob. rzetelność wielopoziomowa):
Przy ICC snu .273 i średnio 12.6 dniach rzetelność wynosi .825. Nierzetelna średnia nie tylko osłabia efekt. Błąd średniej to uśrednione odchylenia dzień do dnia, a te mają własny, wewnątrzosobowy związek ze stresem. Dlatego oszacowanie efektu między osobami przesuwa się w stronę efektu wewnątrzosobowego:
Przy przeciwnych znakach to obciążenie jest szczególnie mylące. W symulacji przy 3 dniach efekt między osobami wyniósł średnio 0.31 zamiast 0.90, przy 7 dniach 0.57, przy 14 dniach 0.72, a przy 28 dniach 0.80. Wartości ze wzoru (0.32, 0.57, 0.71, 0.80) prawie pokrywają się z symulacją. Efekt wewnątrzosobowy pozostał nieobciążony przy każdej liczbie dni (średnio od −0.455 do −0.439). Oszacowanie z naszej próby (0.85) wypadło bliżej prawdy niż przeciętne, ale na to nie licz.
Lüdtke i in. (2008) opisali ten problem dla średnich grup w badaniach kontekstowych. Pokazali, że traktowanie obserwowanej średniej jako bezbłędnej obciąża efekty kontekstowe i zaniża ich błędy standardowe. Zaproponowali model z latentną kowariantą. Ta sama logika dotyczy średniej osoby z kilku pomiarów. W praktyce masz trzy wyjścia:
- planuj więcej pomiarów, gdy efekt między osobami jest ważnym pytaniem;
- podaj rzetelność średniej osoby i ostrożnie interpretuj efekt między osobami, gdy jest niska;
- użyj centrowania latentnego, w którym średnia osoby jest zmienną latentną, np. w dwupoziomowym SEM albo w dynamicznym SEM (ten opisujemy we wpisie model autoregresyjny i braki danych w ESM).
Trend w czasie i inne pułapki danych podłużnych
Odchylenie od średniej osoby zawiera wszystko, co zmienia się w czasie, także systematyczny trend. Jeśli w trakcie badania stres i sen jednocześnie rosną lub maleją, np. przed sesją egzaminacyjną, efekt wewnątrzosobowy połączy dzienną współzmienność z trendem. Wang i Maxwell (2015) porównali sposoby centrowania i usuwania trendu (ang. detrending) z X, z Y albo z obu zmiennych. Podają zalecenia, kiedy trend trzeba usunąć i jak to zrobić. Najprostsze sprawdzenie to dodanie czasu jako predyktora poziomu 1. W przykładzie dzień badania nie miał związku ze stresem (b = 0.004, SE = 0.008, p = .659), a efekt wewnątrzosobowy się nie zmienił (−0.406). Gdy pytasz o samą zmianę w czasie, skorzystaj z modeli wzrostu (zob. modele wzrostu w lme4).
Przy opóźnionej zmiennej zależnej centrowanie w osobie obciąża efekt autoregresyjny (zob. wpis o modelu autoregresyjnym). Przy kilku falach panelu w SEM tę samą logikę realizuje RI-CLPM z wpisu modele cross-lagged. Rozdzielenie wskaźnika dynamiki pokazuje wpis zmienność regulacji emocji w ESM, a przygotowanie danych – wpis badania dzienniczkowe i EMA.
Pamiętaj też, że efekt wewnątrzosobowy nie jest automatycznie przyczynowy. Usuwa wpływ stałych cech osób, ale nie usuwa czynników zmiennych w czasie (np. dnia z chorobą, który skraca sen i podnosi stres) ani odwrotnego kierunku zależności.
Jak opisać rozdzielenie efektów w artykule
Podaj, jak utworzono obie części predyktora i z jakich wierszy liczono średnie, strukturę efektów losowych, oba efekty z CI, liczbę osób i pomiarów oraz ICC predyktora. Ogólne zasady raportowania znajdziesz we wpisie jak opisać wyniki modelu mieszanego.
Jeśli potrzebujesz kogoś, kto sprawdzi taki model przed wysłaniem artykułu, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Dwa przepisy. Pierwszy tworzy dane i zapisuje plik sen-stres-dzienniczek.csv (możesz go pobrać tutaj), a potem dopasowuje wszystkie modele z tekstu. Drugi to symulacja do rysunku 3; liczy się około dwóch minut. Potrzebne pakiety: lme4, lmerTest i datawizard.
1. Dane, rozdzielenie snu i porównanie modeli
R
# Krok 1. Dane dzienniczkowe: sen i stres u 100 osób przez 14 dni (dane symulowane)
# Prawda w symulacji: wewnątrz osoby +1 h snu ponad własną normę = stres niższy o 0.45 pkt,
# między osobami +1 h przeciętnego snu = przeciętny stres wyższy o 0.90 pkt (cecha stała osoby).
suppressPackageStartupMessages({library(lme4); library(lmerTest); library(datawizard)})
set.seed(3471)
N <- 100; dni <- 14
osoby <- data.frame(id = 1:N, sen_os = rnorm(N, 7, 0.6),          # przeciętny sen osoby (h)
                    u0 = rnorm(N, 0, 0.7), u1 = rnorm(N, 0, 0.35))  # odchylenia poziomu i nachylenia
d <- merge(expand.grid(id = 1:N, dzien = 1:dni), osoby, by = "id")
d$sen <- d$sen_os + rnorm(nrow(d), 0, 0.9)                          # sen w danej nocy
d$stres <- 4.5 + 0.90 * (d$sen_os - 7) + (-0.45 + d$u1) * (d$sen - d$sen_os) + d$u0 +
  rnorm(nrow(d), 0, 1.1)
d$sen <- round(d$sen, 1); d$stres <- round(pmin(pmax(d$stres, 0), 10), 1)  # stres 0–10
d <- d[order(d$id, d$dzien), c("id", "dzien", "sen", "stres")]
d[runif(nrow(d)) < .10, c("sen", "stres")] <- NA                    # ok. 10% pominiętych dni
write.csv(d, "sen-stres-dzienniczek.csv", row.names = FALSE)
d <- na.omit(d)
c(osoby = length(unique(d$id)), dni_z_danymi = nrow(d))

# Rozdzielenie snu na część między- i wewnątrzosobową (datawizard::demean)
d <- cbind(d, demean(d, select = "sen", by = "id"))   # sen_between (średnia osoby), sen_within (odchylenie)
sr_ogolna <- mean(tapply(d$sen, d$id, mean))
d$sen_b <- d$sen_between - sr_ogolna                   # średnia osoby wycentrowana do średniej osób
d$sen_gc <- d$sen - sr_ogolna                          # sen wycentrowany do średniej ogólnej
round(c(sr_ogolna = sr_ogolna, sd_srednich_osob = sd(tapply(d$sen, d$id, mean)),
        sd_wewnatrz = sd(d$sen_within)), 2)

# ICC snu i stresu: jaka część wariancji to różnice między osobami
icc <- function(m) { v <- as.data.frame(VarCorr(m))$vcov; v[1] / sum(v) }
icc_sen <- icc(lmer(sen ~ 1 + (1 | id), d))
round(c(ICC_sen = icc_sen, ICC_stres = icc(lmer(stres ~ 1 + (1 | id), d))), 3)

# Rzetelność średniej osoby (wzór Spearmana–Browna dla średniej z k dni)
k_sr <- mean(table(d$id))
round(c(sr_liczba_dni = k_sr, rzetelnosc_sredniej = k_sr * icc_sen / (1 + (k_sr - 1) * icc_sen)), 3)

# Modele: jeden współczynnik a rozdzielone efekty
m_ols  <- lm(stres ~ sen_gc, data = d)                                # zwykła regresja na wszystkich dniach
m_jed  <- lmer(stres ~ sen_gc + (1 | id), data = d)                   # jeden współczynnik, losowy wyraz wolny
m_cwc  <- lmer(stres ~ sen_within + sen_b + (1 | id), data = d)       # CWC + średnia osoby
m_mund <- lmer(stres ~ sen_gc + sen_b + (1 | id), data = d)           # Mundlak: surowy sen + średnia osoby
m_fe   <- lm(stres ~ sen + factor(id), data = d)                      # efekty stałe osób
m_ln   <- lmer(stres ~ sen_within + sen_b + (1 + sen_within | id), data = d)  # + losowe nachylenie
wsp <- function(m, x) { s <- coef(summary(m))[x, ]; c(b = s[["Estimate"]], SE = s[["Std. Error"]]) }
tab <- rbind(
  "regresja, jeden wsp."           = wsp(m_ols, "sen_gc"),
  "model mieszany, jeden wsp."     = wsp(m_jed, "sen_gc"),
  "CWC: efekt wewnątrz"            = wsp(m_cwc, "sen_within"),
  "CWC: efekt między"              = wsp(m_cwc, "sen_b"),
  "Mundlak: sen (wewnątrz)"        = wsp(m_mund, "sen_gc"),
  "Mundlak: średnia (kontekst)"    = wsp(m_mund, "sen_b"),
  "efekty stałe osób"              = wsp(m_fe, "sen"),
  "losowe nachylenie: wewnątrz"    = wsp(m_ln, "sen_within"),
  "losowe nachylenie: między"      = wsp(m_ln, "sen_b"))
tab <- data.frame(model = rownames(tab), round(tab, 3), row.names = NULL)
tab$dolna <- round(tab$b - 1.96 * tab$SE, 3); tab$gorna <- round(tab$b + 1.96 * tab$SE, 3)
print(tab, row.names = FALSE)
write.csv(tab, "oszacowania-modeli.csv", row.names = FALSE)

# Efekt kontekstowy = efekt między − efekt wewnątrz (sprawdzenie zgodności CWC i Mundlaka)
round(fixef(m_cwc)[["sen_b"]] - fixef(m_cwc)[["sen_within"]], 3)

# Model z losowym nachyleniem: efekty stałe z df Satterthwaite'a, SD nachyleń, test LRT
round(coef(summary(m_ln)), 3)
print(VarCorr(m_ln), comp = "Std.Dev.", digits = 3)
anova(m_ln, m_cwc, refit = FALSE)
round(confint(m_ln, parm = c("sen_within", "sen_b"), method = "Wald"), 3)

# Odsetek osób z ujemnym nachyleniem wewnątrzosobowym (przewidywania BLUP)
nach <- coef(m_ln)$id$sen_within
round(c(min = min(nach), max = max(nach), odsetek_ujemnych = mean(nach < 0)), 3)

# Kontrola trendu w czasie: dzień badania jako predyktor poziomu 1
d$dzien_c <- d$dzien - 7.5
m_tr <- lmer(stres ~ sen_within + sen_b + dzien_c + (1 + sen_within | id), data = d)
round(coef(summary(m_tr))[, c("Estimate", "Std. Error", "Pr(>|t|)")], 3)
Wynik w R
       osoby dni_z_danymi
         100         1260
       sr_ogolna sd_srednich_osob      sd_wewnatrz
            7.00             0.59             0.84
  ICC_sen ICC_stres
    0.273     0.313
      sr_liczba_dni rzetelnosc_sredniej
             12.600               0.825
                       model      b    SE  dolna  gorna
        regresja, jeden wsp. -0.006 0.040 -0.084  0.072
  model mieszany, jeden wsp. -0.358 0.038 -0.432 -0.284
         CWC: efekt wewnątrz -0.417 0.038 -0.491 -0.343
           CWC: efekt między  0.850 0.124  0.607  1.093
     Mundlak: sen (wewnątrz) -0.417 0.038 -0.491 -0.343
 Mundlak: średnia (kontekst)  1.267 0.130  1.012  1.522
           efekty stałe osób -0.417 0.038 -0.491 -0.343
 losowe nachylenie: wewnątrz -0.406 0.046 -0.496 -0.316
   losowe nachylenie: między  0.851 0.123  0.610  1.092
[1] 1.267
            Estimate Std. Error     df t value Pr(>|t|)
(Intercept)    4.609      0.073 97.877  63.066        0
sen_within    -0.406      0.046 89.442  -8.767        0
sen_b          0.851      0.123 97.801   6.905        0
 Groups   Name        Std.Dev. Corr
 id       (Intercept) 0.657
          sen_within  0.257    0.19
 Residual             1.129
Data: d
Models:
m_cwc: stres ~ sen_within + sen_b + (1 | id)
m_ln: stres ~ sen_within + sen_b + (1 + sen_within | id)
      npar    AIC    BIC  logLik -2*log(L) Chisq Df Pr(>Chisq)
m_cwc    5 4109.0 4134.7 -2049.5    4099.0
m_ln     7 4104.7 4140.6 -2045.3    4090.7 8.338  2    0.01547 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            2.5 % 97.5 %
sen_within -0.497 -0.316
sen_b       0.610  1.093
             min              max odsetek_ujemnych
          -0.822            0.076            0.990
            Estimate Std. Error Pr(>|t|)
(Intercept)    4.609      0.073    0.000
sen_within    -0.406      0.046    0.000
sen_b          0.852      0.123    0.000
dzien_c        0.004      0.008    0.659
2. Symulacja: liczba dni, efekt między osobami i pokrycie CI
R
# Krok 2. Symulacja: ile dni potrzeba, by średnia osoby dobrze reprezentowała jej przeciętny sen,
# i co daje pominięcie losowego nachylenia (ten sam mechanizm danych co w kroku 1, bez braków)
suppressPackageStartupMessages({library(lme4)})
generuj <- function(N, dni) {
  sen_os <- rnorm(N, 7, 0.6); u0 <- rnorm(N, 0, 0.7); u1 <- rnorm(N, 0, 0.35)
  id <- rep(1:N, each = dni); sen <- sen_os[id] + rnorm(N * dni, 0, 0.9)
  stres <- 4.5 + 0.90 * (sen_os[id] - 7) + (-0.45 + u1[id]) * (sen - sen_os[id]) + u0[id] +
    rnorm(N * dni, 0, 1.1)
  sr <- ave(sen, id)                                   # obserwowana średnia osoby
  data.frame(id = factor(id), stres, sen_w = sen - sr, sen_b = sr - mean(sr))
}
jedno <- function(N, dni) {
  d <- generuj(N, dni)
  m_ri <- lmer(stres ~ sen_w + sen_b + (1 | id), data = d)
  m_ln <- suppressMessages(lmer(stres ~ sen_w + sen_b + (1 + sen_w | id), data = d))
  s1 <- coef(summary(m_ri)); s2 <- coef(summary(m_ln))
  c(miedzy = s1["sen_b", 1], wewn = s1["sen_w", 1],
    pokrycie_ri = abs(s1["sen_w", 1] + 0.45) < 1.96 * s1["sen_w", 2],
    pokrycie_ln = abs(s2["sen_w", 1] + 0.45) < 1.96 * s2["sen_w", 2])
}
set.seed(3472)
R <- 300; siatka <- c(3, 5, 7, 14, 28)
wyn <- do.call(rbind, lapply(siatka, function(k) {
  w <- t(replicate(R, jedno(N = 100, dni = k)))
  data.frame(dni = k, sr_miedzy = mean(w[, "miedzy"]), sr_wewn = mean(w[, "wewn"]),
             pokrycie_ri = mean(w[, "pokrycie_ri"]), pokrycie_ln = mean(w[, "pokrycie_ln"]))
}))
# Rzetelność średniej osoby i oczekiwany efekt między osobami przy obserwowanej średniej:
# lambda = tau² / (tau² + sigma²/k); E(b_między) = lambda·0.90 + (1 − lambda)·(−0.45)
tau2 <- 0.6^2; s2 <- 0.9^2
wyn$rzetelnosc <- tau2 / (tau2 + s2 / wyn$dni)
wyn$oczekiwany <- wyn$rzetelnosc * 0.90 + (1 - wyn$rzetelnosc) * (-0.45)
wyn$mcse_pokrycia <- sqrt(.95 * .05 / R)
print(round(wyn, 3), row.names = FALSE)
write.csv(round(wyn, 4), "symulacja-dni.csv", row.names = FALSE)
Wynik w R
Warning: Model failed to converge with 1 negative eigenvalue: -2.3e+00
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model failed to converge with max|grad| = 0.00602809 (tol = 0.002, component 1)
  See ?lme4::convergence and ?lme4::troubleshooting.
Warning in checkConv(attr(opt, "derivs"), opt$par, ctrl = control$checkConv,  :
  Model failed to converge with max|grad| = 0.00383155 (tol = 0.002, component 1)
  See ?lme4::convergence and ?lme4::troubleshooting.
Warning: Model failed to converge with 1 negative eigenvalue: -1.2e+00
 dni sr_miedzy sr_wewn pokrycie_ri pokrycie_ln rzetelnosc oczekiwany
   3     0.310  -0.439       0.903       0.937      0.571      0.321
   5     0.467  -0.447       0.887       0.940      0.690      0.481
   7     0.566  -0.444       0.890       0.943      0.757      0.572
  14     0.724  -0.451       0.820       0.947      0.862      0.713
  28     0.802  -0.455       0.707       0.913      0.926      0.800
 mcse_pokrycia
         0.013
         0.013
         0.013
         0.013
         0.013
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 z pakietami lme4, lmerTest i datawizard; rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- datawizard (wersja 1.3.0): Patil, I., Makowski, D., Ben-Shachar, M. S., Wiernik, B. M., Bacher, E., & Lüdecke, D. (2022). datawizard: An R package for easy data preparation and statistical transformations. Journal of Open Source Software, 7(78), 4684. https://doi.org/10.21105/joss.04684
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Interpretacja efektu między osobami jako procesu w osobie. „Osoby śpiące dłużej są bardziej zestresowane” nie znaczy, że dłuższy sen podnosi stres. To dwa różne pytania.
- Średnie liczone z innych wierszy niż model. Jeśli usuwasz dni z brakami w zmiennej zależnej, policz średnie osób dopiero po ich usunięciu.
- Brak losowego nachylenia przy wielu pomiarach. Przedziały ufności efektu wewnątrzosobowego są wtedy za wąskie, tym bardziej, im więcej dni.
- Silne wnioski o efekcie między osobami z kilku pomiarów. Przy 3–5 dniach efekt jest silnie przesunięty w stronę efektu wewnątrzosobowego.
Najczęstsze pytania
Czym różni się efekt wewnątrzosobowy od międzyosobowego?
Efekt wewnątrzosobowy opisuje, co dzieje się z wynikiem, gdy ta sama osoba ma wyższą niż zwykle wartość predyktora (np. śpi dłużej niż zwykle). Efekt międzyosobowy porównuje osoby o różnym przeciętnym poziomie predyktora. Mogą mieć różną siłę, a nawet przeciwne znaki, bo na efekt międzyosobowy wpływają stałe cechy osób.
Jak policzyć odchylenie od średniej osoby w R?
Policz średnią predyktora dla każdej osoby (ave() albo datawizard::demean(d, select = "x", by = "id")) i odejmij ją od każdego pomiaru. Do modelu wpisz to odchylenie oraz średnią osoby wycentrowaną do średniej wszystkich osób. Średnie licz z tych samych wierszy, które trafią do modelu.
Czy model Mundlaka daje to samo co efekty stałe?
Tak, w zakresie efektu wewnątrzosobowego. W przykładzie model z surowym predyktorem i średnią osoby, model z centrowaniem w osobie i regresja z efektami stałymi osób dały ten sam współczynnik −0.417 (SE = 0.038). Model Mundlaka dodatkowo pozwala oszacować efekty predyktorów stałych w czasie i losowe nachylenia.
Czy efekt wewnątrzosobowy powinien mieć losowe nachylenie?
Zwykle tak, jeśli liczba pomiarów na osobę na to pozwala. Gdy osoby różnią się siłą efektu, a model ma tylko losowy wyraz wolny, błąd standardowy efektu wewnątrzosobowego jest za mały. W symulacji przy 28 dniach 95% przedział ufności takiego modelu obejmował prawdziwą wartość tylko w 71% badań, a model z losowym nachyleniem w 91%.
Ile pomiarów na osobę potrzeba, żeby oszacować efekt międzyosobowy?
Zależy od rzetelności średniej osoby, czyli od tego, ile zmienności predyktora przypada na różnice między osobami. Przy 3 dniach efekt międzyosobowy w symulacji wyniósł średnio 0.31 zamiast 0.90, przy 14 dniach 0.72, a przy 28 dniach 0.80. Przy kilku pomiarach rozważ centrowanie latentne.
Powiązane hasła
Przeczytaj też
Dane podłużne na wykresie
Wykres spaghetti, średnie z 95% CI i liczbą osób, rzeczywista oś czasu i trajektorie z modelu mieszanego – sześć rysunków z kodem R i podpisami.
Czytaj →PoradnikBadania dzienniczkowe i EMA – analiza danych
Compliance, ICC, centrowanie w osobie, opóźnienia w obrębie dnia, reaktywność afektywna w lme4 i rzetelność zmiany – z kodem R i wzorem opisu.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikDane panelowe: FE, RE i test Hausmana
Pooled OLS, efekty stałe i losowe, test Hausmana liczony ręcznie, błędy klastrowane CR2, efekty czasu, model within–between i przykład w R.
Czytaj →Masz dane podłużne i nie wiesz, który efekt raportujesz?
Pomożemy rozdzielić efekty wewnątrz- i międzyosobowe, dobrać strukturę efektów losowych i sprawdzić analizę tak, żebyś mógł(a) samodzielnie opisać i obronić wyniki przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Bell, A., Fairbrother, M., & Jones, K. (2019). Fixed and random effects models: Making an informed choice. Quality & Quantity, 53(2), 1051–1074. https://doi.org/10.1007/s11135-018-0802-x ● Otwarty dostęp
- Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62(1), 583–619. https://doi.org/10.1146/annurev.psych.093008.100356 ● Otwarty dostęp: pełny tekst
- Enders, C. K., & Tofighi, D. (2007). Centering predictor variables in cross-sectional multilevel models: A new look at an old issue. Psychological Methods, 12(2), 121–138. https://doi.org/10.1037/1082-989x.12.2.121
- Hamaker, E. L., & Muthén, B. (2020). The fixed versus random effects debate and how it relates to centering in multilevel modeling. Psychological Methods, 25(3), 365–379. https://doi.org/10.1037/met0000239 ● Otwarty dostęp: pełny tekst
- Hoffman, L., & Stawski, R. S. (2009). Persons as contexts: Evaluating between-person and within-person effects in longitudinal analysis. Research in Human Development, 6(2–3), 97–120. https://doi.org/10.1080/15427600902911189
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13 ● Otwarty dostęp
- Lüdtke, O., Marsh, H. W., Robitzsch, A., Trautwein, U., Asparouhov, T., & Muthén, B. (2008). The multilevel latent covariate model: A new, more reliable approach to group-level effects in contextual studies. Psychological Methods, 13(3), 203–229. https://doi.org/10.1037/a0012869
- Mundlak, Y. (1978). On the pooling of time series and cross section data. Econometrica, 46(1), 69–85. https://doi.org/10.2307/1913646
- Wang, L. P., & Maxwell, S. E. (2015). On disaggregating between-person and within-person effects with longitudinal data using multilevel models. Psychological Methods, 20(1), 63–83. https://doi.org/10.1037/met0000030
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{bell2019fixed, author={Bell, Andrew and Fairbrother, Malcolm and Jones, Kelvyn}, title={{Fixed and random effects models: Making an informed choice}}, journal={Quality \& Quantity}, year={2019}, volume={53}, number={2}, pages={1051--1074}, doi={10.1007/s11135-018-0802-x}}@article{curran2011disaggregation, author={Curran, Patrick J. and Bauer, Daniel J.}, title={{The disaggregation of within-person and between-person effects in longitudinal models of change}}, journal={Annual Review of Psychology}, year={2011}, volume={62}, number={1}, pages={583--619}, doi={10.1146/annurev.psych.093008.100356}}@article{enders2007centering, author={Enders, Craig K. and Tofighi, Davood}, title={{Centering predictor variables in cross-sectional multilevel models: A new look at an old issue}}, journal={Psychological Methods}, year={2007}, volume={12}, number={2}, pages={121--138}, doi={10.1037/1082-989x.12.2.121}}@article{hamaker2020fixed, author={Hamaker, Ellen L. and Muthén, Bengt}, title={{The fixed versus random effects debate and how it relates to centering in multilevel modeling}}, journal={Psychological Methods}, year={2020}, volume={25}, number={3}, pages={365--379}, doi={10.1037/met0000239}}@article{hoffman2009persons, author={Hoffman, Lesa and Stawski, Robert S.}, title={{Persons as contexts: Evaluating between-person and within-person effects in longitudinal analysis}}, journal={Research in Human Development}, year={2009}, volume={6}, number={2–3}, pages={97--120}, doi={10.1080/15427600902911189}}@article{kuznetsova2017lmertest, author={Kuznetsova, Alexandra and Brockhoff, Per B. and Christensen, Rune H. B.}, title={{lmerTest package: Tests in linear mixed effects models}}, journal={Journal of Statistical Software}, year={2017}, volume={82}, number={13}, pages={1--26}, doi={10.18637/jss.v082.i13}}@article{ludtke2008multilevel, author={Lüdtke, Oliver and Marsh, Herbert W. and Robitzsch, Alexander and Trautwein, Ulrich and Asparouhov, Tihomir and Muthén, Bengt}, title={{The multilevel latent covariate model: A new, more reliable approach to group-level effects in contextual studies}}, journal={Psychological Methods}, year={2008}, volume={13}, number={3}, pages={203--229}, doi={10.1037/a0012869}}@article{mundlak1978pooling, author={Mundlak, Yair}, title={{On the pooling of time series and cross section data}}, journal={Econometrica}, year={1978}, volume={46}, number={1}, pages={69--85}, doi={10.2307/1913646}}@article{wang2015disaggregating, author={Wang, Lijuan Peggy and Maxwell, Scott E.}, title={{On disaggregating between-person and within-person effects with longitudinal data using multilevel models}}, journal={Psychological Methods}, year={2015}, volume={20}, number={1}, pages={63--83}, doi={10.1037/met0000030}}