Czym są dane z EMA i badań dzienniczkowych
W badaniu dzienniczkowym, metodzie próbkowania doświadczeń (ESM) albo ekologicznej chwilowej ocenie (EMA, ang. ecological momentary assessment) pytasz te same osoby wiele razy: kilka razy dziennie przez tydzień lub dwa albo raz dziennie przez kilka tygodni. EMA ma zmniejszać błąd przypominania i badać procesy tam, gdzie zachodzą, czyli w codziennym życiu (Shiffman i in., 2008). Pomiary mogą być uruchamiane w losowych lub stałych porach albo przez zdarzenie, np. konflikt czy napad bólu. W badaniach zdrowia psychicznego ESM pozwala uchwycić zmienność objawów w czasie i ich związek z sytuacją (Myin-Germeys i in., 2018).
Taki zbiór różni się od zwykłego schematu podłużnego skalą i pytaniami. Masz dziesiątki pomiarów na osobę, więc możesz pytać o proces wewnątrz osoby: czy ktoś czuje się gorzej w chwilach, gdy coś przykrego się wydarzyło, i jak długo ten stan się utrzymuje (Hamaker i Wichers, 2017). Poniżej przechodzimy przez analizę krok po kroku na jednym przykładzie. Modele wzrostu, w których pytasz o trend w czasie, opisujemy osobno we wpisie modele wzrostu w lme4.
Przykład: przykre zdarzenia i negatywny afekt
Stu dwudziestu dorosłych przez 14 dni odpowiadało na 5 sygnałów dziennie, łącznie 70 sygnałów na osobę. Przy każdym sygnale oceniali negatywny afekt (NA) trzema pozycjami na suwaku 0–100 i odpowiadali, czy od poprzedniego sygnału wydarzyło się coś przykrego (tak/nie). Pytanie badawcze dotyczy reaktywności afektywnej: o ile rośnie NA w chwilach po przykrym zdarzeniu w porównaniu z chwilami bez zdarzenia u tej samej osoby. Dane są symulowane (set.seed(2014)), a pełny kod znajdziesz w sekcji z przykładem w R.
Krok 1. Struktura danych: osoba × dzień × sygnał
Dane zapisz w formacie długim: jeden wiersz to jeden sygnał. Potrzebujesz identyfikatora osoby, numeru dnia, numeru sygnału w dniu i znacznika czasu. Brak odpowiedzi zostaw jako pusty wiersz z NA, zamiast go usuwać. Tylko wtedy policzysz compliance i poprawnie zbudujesz zmienne opóźnione.
| id | dzień | sygnał | zdarzenie | NA (0–100) |
|---|---|---|---|---|
| o001 | 1 | 1 | 0 | 23.75 |
| o001 | 1 | 2 | 0 | 24.56 |
| o001 | 1 | 3 | 1 | 18.03 |
| o001 | 2 | 1 | brak | brak |
Sygnały są zagnieżdżone w osobach, więc analizujesz je modelem wielopoziomowym. Poziom 1 to sygnał, poziom 2 to osoba. Część badań dodaje poziom dnia między nimi. Ogólną logikę takich modeli, z centrowaniem, losowymi nachyleniami i porównaniem modeli, omawia wpis model wielopoziomowy krok po kroku. Tu skupiamy się na tym, co jest swoiste dla EMA.
Krok 2. Compliance i braki danych
Compliance to odsetek sygnałów, na które osoba odpowiedziała. W metaanalizie 477 artykułów średnie compliance w badaniach EMA wyniosło 79%. Było wyższe tam, gdzie płacono uczestnikom, a liczba pomiarów dziennie go nie przewidywała (Wrzus i Neubauer, 2023). W przykładzie compliance wyniosło 71.2%, a u poszczególnych osób od 21.4% do 94.3% (mediana 74.3%). Spadało w trakcie badania: 80.5% pierwszego dnia, 71.3% siódmego i 64.7% czternastego.
Przed analizą zapisz w planie analizy regułę wykluczania osób z małą liczbą odpowiedzi. Na przykład von Klipstein i in. (2023) wykluczyli osoby, które odpowiedziały na mniej niż 50% pomiarów. Tę samą regułę zastosowaliśmy w przykładzie: odpadło 11 osób i zostało 109 osób z 5 690 odpowiedziami. W raporcie podaj compliance ogółem i jego rozrzut, a nie tylko liczbę wykluczonych.
Ważniejsze od samego odsetka jest pytanie, dlaczego sygnały przepadają. Jeśli ktoś pomija sygnały w najgorszych chwilach, braki zależą od mierzonej wartości, czyli są typu MNAR (zob. MCAR, MAR i MNAR). Model w lmer wykorzysta wszystkie dostępne odpowiedzi, ale przy takich brakach i tak może dać obciążone wyniki. Skutki dla modelu z opóźnieniem pokazujemy we wpisie wielopoziomowy model autoregresyjny i braki danych w ESM.
Krok 3. Model pusty: ile zmienności jest wewnątrz osób
Model bez predyktorów rozkłada wariancję NA na część między osobami (82.16) i wewnątrz osób (117.16). ICC wynosi .412. Różnice w średnim poziomie afektu odpowiadają więc za 41.2% zmienności, a 58.8% to wahania wokół własnej średniej. Ta druga część jest materiałem do pytań o reaktywność i dynamikę. Przy ICC bliskim 1 niewiele zostaje do wyjaśnienia na poziomie sygnałów.
Krok 4. Rozdziel efekty wewnątrz i między osobami
Zmienna „zdarzenie” niesie dwie informacje. Mówi, czy w danej chwili coś się wydarzyło, a uśredniona po sygnałach mówi, jak często ta osoba doświadcza przykrych zdarzeń. To dwa różne pytania i mogą mieć różne odpowiedzi. Curran i Bauer (2011) pokazują, że w danych podłużnych trzeba je rozdzielić i że ta możliwość jest często niewykorzystywana.
Robisz to przez centrowanie do średniej osoby. Do modelu wchodzą dwa predyktory:
- zdarzenie wycentrowane w osobie (0 lub 1 minus odsetek sygnałów ze zdarzeniem u tej osoby): efekt wewnątrz osoby, czyli reaktywność;
- średnia osoby (odsetek sygnałów ze zdarzeniem, wycentrowany do średniej próby): efekt między osobami, nazywany też obciążeniem zdarzeniami.
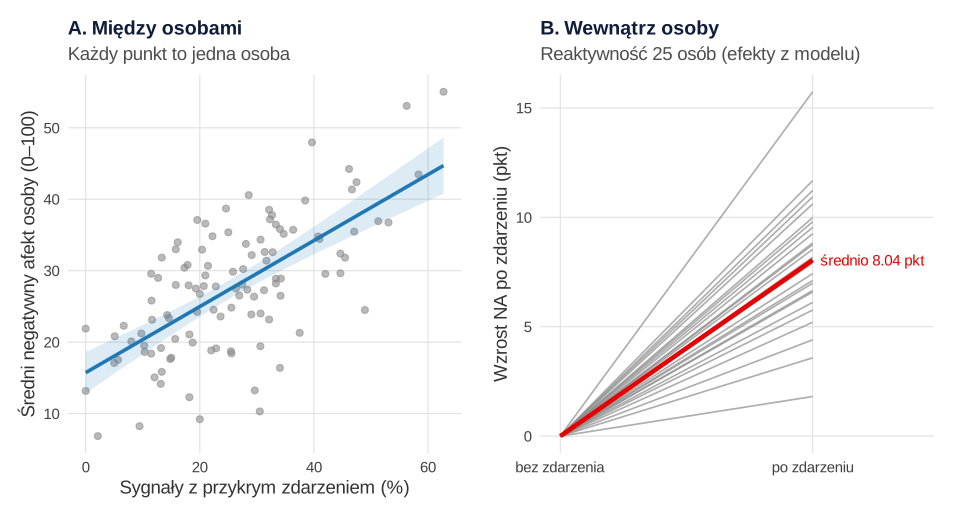
W przykładzie efekty wyraźnie się różnią. Wewnątrz osoby przykre zdarzenie podnosi NA o 8.04 pkt. Między osobami każde 10 punktów procentowych więcej sygnałów ze zdarzeniem wiąże się z wyższym średnim NA o 4.41 pkt. Gdyby połączyć wszystko w jednej zwykłej regresji, dostałbyś 11.88 pkt, czyli mieszaninę obu efektów. Model z losowym wyrazem wolnym bez rozdzielenia dał 8.54 pkt. To bliżej efektu wewnątrzosobowego, ale nadal nie jest to czysta odpowiedź na żadne z dwóch pytań. Różnicę między oboma efektami w modelu z centrowaniem w grupach opisuje hasło efekt kontekstowy. Przenoszenie wniosku z poziomu osób na poziom chwil to błąd ekologiczny.
Krok 5. Zmienne opóźnione: poprzedni sygnał, ale nie przez noc
Afekt w danej chwili zależy od afektu sprzed chwili. Dlatego w modelach reaktywności często dodaje się wartość z poprzedniego sygnału, również wycentrowaną w osobie. Tak postąpili von Klipstein i in. (2023), by uwzględnić zależność czasową. Zbudowanie tej zmiennej wymaga dwóch decyzji:
- Nie łącz ostatniego sygnału z wieczora z pierwszym sygnałem następnego dnia. Między nimi mija noc, a nie 3 godziny, więc opóźnienie licz w obrębie dnia.
- Nie przeskakuj braków. Jeśli poprzedni sygnał jest pusty, opóźnienie też jest puste. Nie bierz ostatniej dostępnej odpowiedzi sprzed 6 czy 9 godzin.
Koszt jest duży. Z 5 690 odpowiedzi tylko 3 498 ma ważną wartość z poprzedniego sygnału tego samego dnia. Odpadają pierwsze sygnały każdego dnia i odpowiedzi po brakach. W modelu współczynnik NA z poprzedniego sygnału wyniósł 0.18, 95% CI [0.15, 0.22]. Ten parametr, nazywany inercją, jest tematem osobnej analizy. Na tle autokorelacji omawiamy go we wpisie o modelu autoregresyjnym, do którego odsyłaliśmy przy brakach danych.
Krok 6. Reaktywność afektywna w modelu wielopoziomowym
Model główny ma postać na ~ zdarz_cw + zdarz_os_c + na_lag_cw + (1 + zdarz_cw | id). Losowe nachylenie zdarzenia pozwala, by każda osoba miała własną reaktywność. Model oszacowano metodą REML (zob. REML a ML), a stopnie swobody przybliżono metodą Satterthwaite’a w pakiecie lmerTest (Kuznetsova i in., 2017; zob. stopnie swobody Kenwarda–Rogera i Satterthwaite’a).
| Efekt | b (SE) | 95% CI | t (df) | p |
|---|---|---|---|---|
| Zdarzenie wewnątrz osoby (reaktywność) | 8.04 (0.56) | [6.95, 9.14] | 14.43 (96.0) | < .001 |
| Obciążenie zdarzeniami (średnia osoby) | 44.06 (5.10) | [34.07, 54.04] | 8.65 (108.3) | < .001 |
| NA z poprzedniego sygnału (w osobie) | 0.18 (0.02) | [0.15, 0.22] | 11.33 (3379.3) | < .001 |
Średnia reaktywność to 8.04 pkt na skali 0–100. Ważniejsze bywa jednak jej zróżnicowanie. Odchylenie standardowe losowego nachylenia wynosi 3.67 pkt. Model z losowym nachyleniem dopasował się lepiej niż model bez niego, χ²(2) = 28.61, p < .001. Przy rozkładzie normalnym reaktywność ok. 95% osób mieści się między 0.85 a 15.24 pkt. Gdy chcesz wyjaśnić te różnice cechą osoby, np. diagnozą, dodaj interakcję międzypoziomową grupa × zdarzenie (wycentrowane w osobie). Do opisu wyjaśnionej wariancji służy R² w modelach wielopoziomowych.
Reaktywność a efekt podłogowy: czego uczy badanie osób z depresją
Von Klipstein i in. (2023) porównali reaktywność afektywną 346 osób z depresją, w remisji i bez depresji. Uczestnicy odpowiadali przez dwa tygodnie, pięć razy dziennie. Autorzy zastosowali najpierw strategię typową dla wcześniejszych badań: liniowe modele wielopoziomowe, opóźniony afekt w osobie i interakcje grupy ze zdarzeniem wycentrowanym w osobie. Odtworzyli w ten sposób znany wynik, czyli silniejszą reakcję negatywnego afektu u osób z depresją.
Negatywny afekt w grupie bez depresji miał jednak wyraźny efekt podłogowy: około połowa odpowiedzi to wartość najniższa. Reszty modeli NA nie miały rozkładu normalnego ani jednorodnej wariancji. Nie pomogły transformacja logarytmiczna ani modele z rozkładem gamma lub odwrotnym gaussowskim. Dopiero modele dwuczęściowe, które osobno modelują wystąpienie wartości zerowej i jej wielkość (podobnie jak model hurdle), dały poprawne reszty. W tych modelach różnice w reaktywności NA między osobami z depresją i bez depresji zniknęły. Jedyny wyjątek dotyczył osób w remisji i zdarzeń pozytywnych. Pozostał natomiast wynik dla afektu pozytywnego: silniejsza reakcja na zdarzenia pozytywne w grupie z depresją i w remisji, gdzie założenia nie były naruszone.
Wniosek autorów dotyczy metody: wyniki reaktywności są bardzo wrażliwe na decyzje modelowe. Sprawdź więc rozkład zmiennej zależnej w każdej grupie i rozkład reszt, zanim porównasz współczynniki. Pamiętaj też, że przy skali ograniczonej z obu stron zmienność jest uwikłana w średnią (Mestdagh i in., 2018). W naszych danych problem nie występuje: skośność reszt wynosi 0.14, a NA poniżej 5 pkt to 4.2% odpowiedzi.
Krok 7. Rzetelność pomiaru wewnątrz osoby
Alfa policzona na wszystkich sygnałach razem miesza rzetelność różnic między osobami z rzetelnością zmian w czasie. Cranford i in. (2006) pokazują, jak z komponentów wariancji pozycji wyznaczyć rzetelność zmiany wewnątrz osoby:
Tutaj m to liczba pozycji w skali. W przykładzie wariancja osoba × pomiar wyniosła 96.86, a wariancja błędu 60.89, co przy trzech pozycjach daje RC = .827. Ta liczba mówi, na ile skala odróżnia chwile lepsze od gorszych u tej samej osoby. Rzetelność na poziomie osób to inna wielkość. Podejście oparte na wielopoziomowej CFA opisujemy w haśle rzetelność wielopoziomowa. Przy pomiarze jedną pozycją tej rzetelności nie policzysz z danych, co warto zaznaczyć w ograniczeniach.
Jak opisać analizę danych EMA
W artykule podaj schemat próbkowania (liczba dni, sygnałów, sposób ich uruchamiania), compliance z rozrzutem i regułę wykluczeń, sposób budowy zmiennych opóźnionych, centrowanie, strukturę efektów losowych, metodę estymacji i program. Jeśli porównujesz grupy, dodaj opis sprawdzenia reszt.
Jeśli przygotowujesz artykuł z danymi EMA albo odpowiadasz recenzentowi na pytanie o centrowanie lub braki, możemy wspólnie sprawdzić plan modeli i ich opis w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Jeden przepis tworzy dane i liczy wszystkie wyniki z tekstu: compliance, ICC, opóźnienie w obrębie dnia, model reaktywności z rozdzieleniem efektów, porównanie z modelami bez rozdzielenia i rzetelność RC. Potrzebujesz pakietów lme4 i lmerTest.
Dane EMA, reaktywność afektywna i rzetelność zmiany
R
# Dane symulowane: badanie EMA, 120 dorosłych, 14 dni × 5 sygnałów dziennie (co ok. 3 godziny) = 70 sygnałów na osobę.
# Przy każdym sygnale: negatywny afekt (NA) z trzech pozycji na suwaku 0–100 i pytanie o przykre zdarzenie od poprzedniego sygnału.
suppressPackageStartupMessages({library(lme4); library(lmerTest)})
set.seed(2014)
n <- 120; dni <- 14; syg <- 5
osoby <- data.frame(id = sprintf("o%03d", 1:n),
                    p_zdarz = rbeta(n, 3, 9),                 # jak często dana osoba doświadcza przykrych zdarzeń
                    reakt = rnorm(n, 8, 4),                   # reaktywność: wzrost NA po zdarzeniu (różna u różnych osób)
                    zgodnosc = rbeta(n, 7, 1.8))              # skłonność do odpowiadania na sygnały
osoby$poziom <- 25 + 40 * (osoby$p_zdarz - .25) + rnorm(n, 0, 7)   # osoby z częstszymi zdarzeniami mają wyższy średni NA
dl <- do.call(rbind, lapply(1:n, function(i) {
  o <- osoby[i, ]
  d <- expand.grid(sygnal = 1:syg, dzien = 1:dni)[, c("dzien", "sygnal")]
  d$zdarzenie <- rbinom(nrow(d), 1, o$p_zdarz)
  u <- numeric(nrow(d))                                       # proces AR(1) w obrębie dnia (bez przenoszenia przez noc)
  for (t in seq_len(nrow(d))) u[t] <- (if (d$sygnal[t] > 1) 0.30 * u[t - 1] else 0) + rnorm(1, 0, 9)
  stan <- o$poziom + o$reakt * d$zdarzenie + u
  pozycje <- sapply(c(-3, 0, 3), function(b) pmin(pmax(stan + b + rnorm(1, 0, 3) + rnorm(nrow(d), 0, 8), 0), 100))
  colnames(pozycje) <- c("na1", "na2", "na3")
  # odpowiedź na sygnał: skłonność osoby, spadek w kolejnych dniach badania
  odp <- runif(nrow(d)) < pmin(o$zgodnosc - 0.012 * (d$dzien - 1), .99)
  cbind(id = o$id, d, pozycje, odp = odp)
}))
dl$na <- rowMeans(dl[, c("na1", "na2", "na3")])
dl[!dl$odp, c("zdarzenie", "na1", "na2", "na3", "na")] <- NA

# 1. Struktura danych i compliance
head(dl[, c("id", "dzien", "sygnal", "zdarzenie", "na")], 6)
zg <- tapply(dl$odp, dl$id, mean)
round(c(compliance_ogolem = mean(dl$odp), mediana_osob = median(zg), min = min(zg), max = max(zg)), 3)
c(osoby_ponizej_50proc = sum(zg < .50))
round(tapply(dl$odp, dl$dzien, mean)[c(1, 7, 14)], 3)            # compliance w dniu 1, 7 i 14
dane <- subset(dl, id %in% names(zg)[zg >= .50])                 # reguła wykluczenia zapisana w planie analizy
c(osoby = length(unique(dane$id)), odpowiedzi = sum(dane$odp))

# 2. Model pusty: ile zmienności NA leży między osobami?
m0 <- lmer(na ~ 1 + (1 | id), data = dane)
vc <- as.data.frame(VarCorr(m0))$vcov
round(c(var_miedzy = vc[1], var_wewnatrz = vc[2], ICC = vc[1] / sum(vc)), 3)

# 3. Opóźnienie: NA z poprzedniego sygnału tego samego dnia (nie przez noc i nie przez brak)
dane <- dane[order(dane$id, dane$dzien, dane$sygnal), ]
dane$na_lag <- ave(dane$na, dane$id, dane$dzien, FUN = function(x) c(NA, head(x, -1)))
c(odpowiedzi = sum(!is.na(dane$na)), pary_z_opoznieniem = sum(!is.na(dane$na) & !is.na(dane$na_lag)))

# 4. Rozdzielenie efektów wewnątrz i między osobami (centrowanie do średniej osoby)
dane$zdarz_os <- ave(dane$zdarzenie, dane$id, FUN = function(x) mean(x, na.rm = TRUE))   # odsetek sygnałów ze zdarzeniem
dane$zdarz_cw <- dane$zdarzenie - dane$zdarz_os                                           # odchylenie od własnej średniej
dane$zdarz_os_c <- dane$zdarz_os - mean(tapply(dane$zdarz_os, dane$id, mean))             # średnia osoby, wyśrodkowana
dane$na_lag_cw <- dane$na_lag - ave(dane$na, dane$id, FUN = function(x) mean(x, na.rm = TRUE))

# Modele bez rozdzielenia: jeden współczynnik miesza efekt wewnątrz i między osobami
round(coef(summary(lm(na ~ zdarzenie, data = dane)))["zdarzenie", ], 3)          # zwykła regresja na wszystkich sygnałach
m_naiw <- lmer(na ~ zdarzenie + (1 | id), data = dane)                               # losowy wyraz wolny, zdarzenie bez centrowania
round(summary(m_naiw)$coefficients["zdarzenie", ], 3)
# Model reaktywności: efekt zdarzenia wewnątrz osoby, obciążenie zdarzeniami między osobami, NA z poprzedniego sygnału
m1 <- lmer(na ~ zdarz_cw + zdarz_os_c + na_lag_cw + (1 + zdarz_cw | id), data = dane,
           control = lmerControl(optimizer = "bobyqa"))
round(summary(m1)$coefficients, 3)
round(confint(m1, parm = "beta_", method = "Wald"), 2)
print(VarCorr(m1), comp = c("Variance", "Std.Dev."))
c(obserwacje_w_modelu = nobs(m1))
# Czy reaktywność różni się między osobami? (losowe nachylenie, porównanie na REML)
m1a <- lmer(na ~ zdarz_cw + zdarz_os_c + na_lag_cw + (1 | id), data = dane, control = lmerControl(optimizer = "bobyqa"))
anova(m1a, m1, refit = FALSE)
# Rozrzut reaktywności między osobami: przedział, w którym leży ok. 95% osób
b <- fixef(m1)[["zdarz_cw"]]; sd_b <- attr(VarCorr(m1)$id, "stddev")[["zdarz_cw"]]
round(c(od = b - 1.96 * sd_b, do = b + 1.96 * sd_b), 2)

# 5. Rozkład reszt (efekty podłogowe zaburzają normalność i homoskedastyczność)
r <- resid(m1)
round(c(skosnosc_reszt = mean((r - mean(r))^3) / sd(r)^3, odsetek_NA_ponizej_5 = mean(dane$na < 5, na.rm = TRUE)), 3)

# 6. Rzetelność zmiany wewnątrz osoby (R_C, Cranford i in., 2006) z komponentów wariancji pozycji
dp <- reshape(dane[!is.na(dane$na), c("id", "dzien", "sygnal", "na1", "na2", "na3")], direction = "long",
              varying = c("na1", "na2", "na3"), v.names = "wynik", timevar = "pozycja", idvar = c("id", "dzien", "sygnal"))
dp$pomiar <- interaction(dp$id, dp$dzien, dp$sygnal, drop = TRUE)
mg <- lmer(wynik ~ factor(pozycja) + (1 | id) + (1 | id:pomiar) + (1 | id:pozycja), data = dp)
v <- setNames(as.data.frame(VarCorr(mg))$vcov, as.data.frame(VarCorr(mg))$grp)
round(v, 2)
round(c(R_C = v[["id:pomiar"]] / (v[["id:pomiar"]] + v[["Residual"]] / 3)), 3)
Wynik w R
    id dzien sygnal zdarzenie       na
1 o001     1      1         0 23.74963
2 o001     1      2         0 24.56414
3 o001     1      3         1 18.03232
4 o001     1      4         0 29.59665
5 o001     1      5         0 28.64481
6 o001     2      1        NA       NA
compliance_ogolem      mediana_osob               min               max
            0.712             0.743             0.214             0.943
osoby_ponizej_50proc
                  11
    1     7    14
0.805 0.713 0.647
     osoby odpowiedzi
       109       5690
  var_miedzy var_wewnatrz          ICC
      82.156      117.155        0.412
        odpowiedzi pary_z_opoznieniem
              5690               3498
  Estimate Std. Error    t value   Pr(>|t|)
    11.878      0.399     29.802      0.000
  Estimate Std. Error         df    t value   Pr(>|t|)
     8.535      0.325   5608.508     26.267      0.000
            Estimate Std. Error       df t value Pr(>|t|)
(Intercept)   27.617      0.685  106.768  40.309        0
zdarz_cw       8.044      0.557   96.041  14.431        0
zdarz_os_c    44.060      5.095  108.320   8.648        0
na_lag_cw      0.183      0.016 3379.317  11.327        0
            2.5 % 97.5 %
(Intercept) 26.27  28.96
zdarz_cw     6.95   9.14
zdarz_os_c  34.07  54.04
na_lag_cw    0.15   0.22
 Groups   Name        Variance Std.Dev. Corr
 id       (Intercept)  47.707   6.9071
          zdarz_cw     13.464   3.6693  0.385
 Residual             100.452  10.0226
obserwacje_w_modelu
               3498
Data: dane
Models:
m1a: na ~ zdarz_cw + zdarz_os_c + na_lag_cw + (1 | id)
m1: na ~ zdarz_cw + zdarz_os_c + na_lag_cw + (1 + zdarz_cw | id)
    npar   AIC   BIC logLik -2*log(L)  Chisq Df Pr(>Chisq)
m1a    6 26438 26475 -13213     26426
m1     8 26414 26463 -13199     26398 28.612  2  6.123e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   od    do
 0.85 15.24
      skosnosc_reszt odsetek_NA_ponizej_5
               0.139                0.042
 id:pomiar id:pozycja         id   Residual
     96.86       7.35      79.71      60.89
  R_C
0.827
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4 (wersja 2.0.1) i lmerTest (wersja 3.2.1); rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Jeden współczynnik zamiast dwóch. Predyktor zmienny w czasie bez centrowania w osobie miesza efekt chwilowy z różnicami między osobami (w przykładzie 11.88 pkt zamiast 8.04).
- Opóźnienie przez noc albo przez brak. Model AR zakłada równe odstępy; poprzedni wiersz w pliku to nie zawsze poprzedni sygnał.
- Usuwanie pustych wierszy przed analizą. Tracisz informację o compliance i o tym, które opóźnienia są ważne.
- Brak opisu compliance i reguły wykluczeń. Bez nich czytelnik nie oceni, czy braki mogą zniekształcać wynik.
- Porównanie reaktywności grup bez sprawdzenia reszt. Efekt podłogowy w jednej grupie może wytworzyć różnicę, której nie ma (von Klipstein i in., 2023).
- Alfa ze wszystkich sygnałów jako jedyna miara rzetelności. Podaj rzetelność zmiany wewnątrz osoby, jeśli skala ma kilka pozycji.
Jeśli interesuje Cię nie średni poziom ani reaktywność, lecz zmienność samych strategii regulacji emocji, przejdź do wpisu o wskaźnikach zmienności regulacji emocji w ESM. Mechanizm pośredni w danych dzienniczkowych opisuje wpis mediacja wielopoziomowa w R, a binarne wyniki (np. czy wystąpił objaw) – wielopoziomowa regresja logistyczna.
Najczęstsze pytania
Jak policzyć compliance w badaniu EMA?
Podziel liczbę sygnałów z odpowiedzią przez liczbę wysłanych sygnałów, ogółem i osobno dla każdej osoby. Raportuj średnią lub medianę z zakresem, a regułę wykluczania osób z niskim compliance zapisz przed analizą. W metaanalizie badań EMA średnie compliance wyniosło 79% (Wrzus i Neubauer, 2023).
Dlaczego w danych EMA centruje się predyktory do średniej osoby?
Bo predyktor zmienny w czasie niesie dwie informacje: co działo się w danej chwili i jaka jest osoba średnio. Odchylenie od średniej osoby daje efekt wewnątrzosobowy, a średnia osoby – międzyosobowy. Bez rozdzielenia dostajesz mieszaninę obu, np. 11.88 zamiast 8.04 pkt w przykładzie z tego wpisu.
Jak utworzyć zmienną opóźnioną w danych ESM w R?
Posortuj dane według osoby, dnia i numeru sygnału, a opóźnienie licz w grupach osoba × dzień, np. ave(na, id, dzien, FUN = function(x) c(NA, head(x, -1))). Puste wiersze po nieodebranych sygnałach muszą zostać w danych, inaczej opóźnienie przeskoczy brak. Pierwszy sygnał dnia nie ma opóźnienia.
Jak sprawdzić rzetelność skali w badaniu dzienniczkowym?
Przy skali z kilku pozycji rozłóż wariancję pozycji na składniki: osoba, osoba × pomiar, osoba × pozycja i błąd. Rzetelność zmiany wewnątrz osoby to σ²osoba×pomiar / (σ²osoba×pomiar + σ²błąd/m) (Cranford i in., 2006). Alfa ze wszystkich sygnałów razem miesza rzetelność różnic między osobami i zmian w czasie.
Czym jest reaktywność afektywna w badaniach ESM?
To siła, z jaką afekt danej osoby zmienia się w chwilach po zdarzeniu, np. przykrym, w porównaniu z chwilami bez zdarzenia. W modelu wielopoziomowym to nachylenie zdarzenia wycentrowanego w osobie, zwykle z losowym nachyleniem. Porównując grupy, sprawdź reszty, bo efekt podłogowy może zawyżyć różnice (von Klipstein i in., 2023).
Powiązane hasła
Przeczytaj też
Model autoregresyjny i braki danych w ESM
Inercja afektu w modelu MLAR(1), centrowanie opóźnienia, compliance oraz braki MCAR i ogonowe – z symulacją w lme4 i zaleceniami projektowymi.
Czytaj →PoradnikZmienność regulacji emocji w ESM
SD i względne SD, Bray–Curtis z podziałem na przełączanie i zmianę nasilenia, RMSSD, AR, %DET i entropia – wzory, R i interpretacja.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →Masz dane z EMA i nie wiesz, jak zbudować model?
Pomożemy przygotować dane, zaplanować centrowanie, opóźnienia i efekty losowe, przeprowadzić analizę i wyjaśnić wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Cranford, J. A., Shrout, P. E., Iida, M., Rafaeli, E., Yip, T., & Bolger, N. (2006). A procedure for evaluating sensitivity to within-person change: Can mood measures in diary studies detect change reliably? Personality and Social Psychology Bulletin, 32(7), 917–929. https://doi.org/10.1177/0146167206287721 ● Otwarty dostęp: pełny tekst
- Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62(1), 583–619. https://doi.org/10.1146/annurev.psych.093008.100356 ● Otwarty dostęp: pełny tekst
- Hamaker, E. L., & Wichers, M. (2017). No time like the present: Discovering the hidden dynamics in intensive longitudinal data. Current Directions in Psychological Science, 26(1), 10–15. https://doi.org/10.1177/0963721416666518 ● Otwarty dostęp: pełny tekst
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13 ● Otwarty dostęp
- Mestdagh, M., Pe, M., Pestman, W., Verdonck, S., Kuppens, P., & Tuerlinckx, F. (2018). Sidelining the mean: The relative variability index as a generic mean-corrected variability measure for bounded variables. Psychological Methods, 23(4), 690–707. https://doi.org/10.1037/met0000153
- Myin-Germeys, I., Kasanova, Z., Vaessen, T., Vachon, H., Kirtley, O., Viechtbauer, W., & Reininghaus, U. (2018). Experience sampling methodology in mental health research: New insights and technical developments. World Psychiatry, 17(2), 123–132. https://doi.org/10.1002/wps.20513 ● Otwarty dostęp
- Shiffman, S., Stone, A. A., & Hufford, M. R. (2008). Ecological momentary assessment. Annual Review of Clinical Psychology, 4(1), 1–32. https://doi.org/10.1146/annurev.clinpsy.3.022806.091415
- von Klipstein, L., Servaas, M. N., Lamers, F., Schoevers, R. A., Wardenaar, K. J., & Riese, H. (2023). Increased affective reactivity among depressed individuals can be explained by floor effects: An experience sampling study. Journal of Affective Disorders, 334, 370–381. https://doi.org/10.1016/j.jad.2023.04.118 ● Otwarty dostęp
- Wrzus, C., & Neubauer, A. B. (2023). Ecological momentary assessment: A meta-analysis on designs, samples, and compliance across research fields. Assessment, 30(3), 825–846. https://doi.org/10.1177/10731911211067538 ● Otwarty dostęp
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{cranford2006procedure, author={Cranford, James A. and Shrout, Patrick E. and Iida, Masumi and Rafaeli, Eshkol and Yip, Tiffany and Bolger, Niall}, title={{A procedure for evaluating sensitivity to within-person change: Can mood measures in diary studies detect change reliably?}}, journal={Personality and Social Psychology Bulletin}, year={2006}, volume={32}, number={7}, pages={917--929}, doi={10.1177/0146167206287721}}@article{curran2011disaggregation, author={Curran, Patrick J. and Bauer, Daniel J.}, title={{The disaggregation of within-person and between-person effects in longitudinal models of change}}, journal={Annual Review of Psychology}, year={2011}, volume={62}, number={1}, pages={583--619}, doi={10.1146/annurev.psych.093008.100356}}@article{hamaker2017no, author={Hamaker, Ellen L. and Wichers, Marieke}, title={{No time like the present: Discovering the hidden dynamics in intensive longitudinal data}}, journal={Current Directions in Psychological Science}, year={2017}, volume={26}, number={1}, pages={10--15}, doi={10.1177/0963721416666518}}@article{kuznetsova2017lmertest, author={Kuznetsova, Alexandra and Brockhoff, Per B. and Christensen, Rune H. B.}, title={{lmerTest package: Tests in linear mixed effects models}}, journal={Journal of Statistical Software}, year={2017}, volume={82}, number={13}, pages={1--26}, doi={10.18637/jss.v082.i13}}@article{mestdagh2018sidelining, author={Mestdagh, Merijn and Pe, Madeline and Pestman, Wiebe and Verdonck, Stijn and Kuppens, Peter and Tuerlinckx, Francis}, title={{Sidelining the mean: The relative variability index as a generic mean-corrected variability measure for bounded variables}}, journal={Psychological Methods}, year={2018}, volume={23}, number={4}, pages={690--707}, doi={10.1037/met0000153}}@article{myingermeys2018experience, author={Myin-Germeys, Inez and Kasanova, Zuzana and Vaessen, Thomas and Vachon, Hugo and Kirtley, Olivia and Viechtbauer, Wolfgang and Reininghaus, Ulrich}, title={{Experience sampling methodology in mental health research: New insights and technical developments}}, journal={World Psychiatry}, year={2018}, volume={17}, number={2}, pages={123--132}, doi={10.1002/wps.20513}}@article{shiffman2008ecological, author={Shiffman, Saul and Stone, Arthur A. and Hufford, Michael R.}, title={{Ecological momentary assessment}}, journal={Annual Review of Clinical Psychology}, year={2008}, volume={4}, number={1}, pages={1--32}, doi={10.1146/annurev.clinpsy.3.022806.091415}}@article{vonklipstein2023increased, author={von Klipstein, Lino and Servaas, Michelle N. and Lamers, Femke and Schoevers, Robert A. and Wardenaar, Klaas J. and Riese, Harriëtte}, title={{Increased affective reactivity among depressed individuals can be explained by floor effects: An experience sampling study}}, journal={Journal of Affective Disorders}, year={2023}, volume={334}, pages={370--381}, doi={10.1016/j.jad.2023.04.118}}@article{wrzus2023ecological, author={Wrzus, Cornelia and Neubauer, Andreas B.}, title={{Ecological momentary assessment: A meta-analysis on designs, samples, and compliance across research fields}}, journal={Assessment}, year={2023}, volume={30}, number={3}, pages={825--846}, doi={10.1177/10731911211067538}}