Mediacja w danych zagnieżdżonych: 1-1-1 i 2-1-1
Zwykła analiza mediacji (definicje ścieżek znajdziesz w haśle mediacja) zakłada niezależne obserwacje. Gdy pacjenci leżą na różnych oddziałach, a uczniowie chodzą do różnych szkół, to założenie nie obowiązuje. Krull i MacKinnon (2001) pokazali w symulacji, że jednopoziomowa analiza takich danych zaniża błędy standardowe efektu pośredniego, często o 20% lub więcej. Najbardziej wtedy, gdy zmienne są grupowe, grupy duże, a ICC mediatora i wyniku wysokie.
Schemat mediacji wielopoziomowej opisuje się trzema cyframi: poziomem X, mediatora M i wyniku Y. W tym wpisie omawiamy dwa najczęstsze układy:
| Schemat | X | M i Y | Przykład | Efekt pośredni |
|---|---|---|---|---|
| 1-1-1 | poziom 1 (pacjent) | poziom 1 | ból → zaburzenia snu → lęk | dwa: wewnątrz i między oddziałami |
| 2-1-1 | poziom 2 (oddział) | poziom 1 | program „cicha noc” → zaburzenia snu → lęk | tylko między oddziałami |
Istnieją też schematy z wynikiem na poziomie 2, np. 1-1-2. Preacher i in. (2010) zauważają, że podejścia oparte na zwykłym modelu wielopoziomowym nie obsługują takich ścieżek. Ogólną budowę modelu wielopoziomowego, ICC i centrowanie opisujemy we wpisie model wielopoziomowy krok po kroku. Tu skupiamy się na efekcie pośrednim.
Efekt zlany: główny problem mediacji wielopoziomowej
W schemacie 1-1-1 ból, sen i lęk zmieniają się na dwóch poziomach. Pacjent może cierpieć bardziej niż inni na swoim oddziale, a cały oddział może mieć przeciętnie wyższy ból, np. z powodu rodzaju zabiegów. Te dwa źródła zmienności nie muszą mieć tego samego związku z wynikiem. Jeśli wprowadzisz do modelu predyktor bez rozdzielenia poziomów, dostaniesz jeden współczynnik. Jest on ważoną mieszaniną efektu wewnątrz grup i między grupami, czyli efektem zlanym (ang. conflated). To bliski krewny błędu ekologicznego.
Zhang i in. (2009) pokazali, że w dwóch z trzech typów modeli mediacji wielopoziomowej popularne procedury dają takie zlane oszacowania, gdy efekty wewnątrz i między grupami się różnią. W ich symulacji prowadziło to do zaniżania albo zawyżania efektu mediacji. Preacher i in. (2010) uogólnili ten wniosek na wielopoziomowy SEM. W schemacie 2-1-1 problem ma inną postać. X jest cechą oddziału, więc wpływa na sen tylko przez średnie oddziałów, a efekt pośredni istnieje tylko między oddziałami. Ścieżka b musi więc być efektem między oddziałami. Zwykła regresja Y na M bez centrowania daje zamiast tego mieszaninę b wewnątrz i między.
Rozwiązanie w modelu wielopoziomowym to centrowanie w grupach (CWC): każdą zmienną poziomu 1 rozkładasz na odchylenie od średniej grupy i średnią grupy. Średnie wracają do modelu jako predyktory poziomu 2, więc żadna część zmienności nie ginie. Różnica między efektem średnich a efektem odchyleń to efekt kontekstowy. Zasady wyboru centrowania opisują Enders i Tofighi (2007).
Przykład: ból, sen i lęk na 60 oddziałach
W badaniu (dane symulowane, set.seed(1744)) wzięło udział 842 pacjentów z 60 oddziałów, od 8 do 20 osób na oddział. W trzeciej dobie hospitalizacji pacjenci ocenili nasilenie bólu (0–10; M = 5.04, SD = 2.05), zaburzenia snu (0–21; M = 9.07, SD = 3.47) i lęk (0–21; M = 6.38, SD = 3.06). Na 30 oddziałach wylosowanych spośród 60 wprowadzono program „cicha noc”, czyli ograniczenie hałasu i światła po godzinie 22. ICC wynoszą .242 dla bólu, .245 dla snu i .251 dla lęku, więc około jednej czwartej wariancji każdej zmiennej przypada na różnice między oddziałami. Dane możesz pobrać jako plik CSV.
Pytania są dwa. Czy ból wiąże się z lękiem pośrednio przez zaburzenia snu, i to osobno wewnątrz oddziałów oraz między nimi (1-1-1)? Czy program zmniejsza lęk pośrednio przez poprawę snu (2-1-1)? Dane są przekrojowe, więc ścieżki ból → sen → lęk opisują związki, a nie dowiedzione przyczyny. Tylko program był losowany.
Krok 1. Dwa równania w lme4 z centrowaniem w grupach
Model mediacji to dwa równania wielopoziomowe dopasowane funkcją lmer() z pakietu lme4 (Bates i in., 2015). Zmienne z przyrostkiem _cwc to odchylenia od średniej oddziału, a _sr to średnie oddziałów:
lękij = γ0 + bW·sen_cwcij + bB·sen_srj + c′W·ból_cwcij + c′B·ból_srj + c′P·programj + uj + eij
Efekt pośredni wewnątrz oddziałów to aW × bW, między oddziałami aB × bB, a w schemacie 2-1-1 aP × bB. Wewnątrz oddziałów pacjent z bólem o 1 punkt silniejszym niż przeciętny na jego oddziale miał zaburzenia snu wyższe o 0.47 pkt (SE = 0.06). Każdy punkt zaburzeń snu ponad średnią oddziału wiązał się z lękiem wyższym o 0.24 pkt (SE = 0.03). Między oddziałami te same ścieżki były wyraźnie silniejsze: aB = 1.23 (SE = 0.15) i bB = 0.55 (SE = 0.12). Program obniżał przeciętne zaburzenia snu o 1.38 pkt (SE = 0.33). Bezpośredni efekt programu na lęk był niewielki i niepewny: −0.28 pkt (SE = 0.34).
Dla porównania model bez centrowania daje jedno a = 0.55 dla bólu i jedno b = 0.27 dla snu. Oba współczynniki leżą między wartościami z obu poziomów, bliżej poziomu pacjentów, bo tam jest większość wariancji.
Krok 2. Przedział Monte Carlo dla efektu pośredniego
Iloczyn a × b nie ma rozkładu normalnego, więc test Sobela jest tu złym wyborem. W zwykłej mediacji używa się bootstrapu, ale w danych wielopoziomowych trzeba by losować całe oddziały i dopasowywać modele tysiące razy. Prostszy jest przedział Monte Carlo. Preacher i Selig (2012) pokazali, że działa porównywalnie z innymi uznanymi metodami. Wymaga tylko oszacowań i ich błędów standardowych, a sprawdza się tam, gdzie bootstrap jest trudny.
Procedura ma trzy kroki:
- Wylosuj 20 000 par (a, b) z rozkładu normalnego o średnich równych oszacowaniom i macierzy kowariancji z ich błędów standardowych. W R robi to
MASS::mvrnorm(). Ścieżki pochodzą z osobnych równań, więc ich kowariancja wynosi 0. - Dla każdej pary policz iloczyn a × b.
- Granicami 95% przedziału są percentyle 2.5 i 97.5 tych iloczynów.
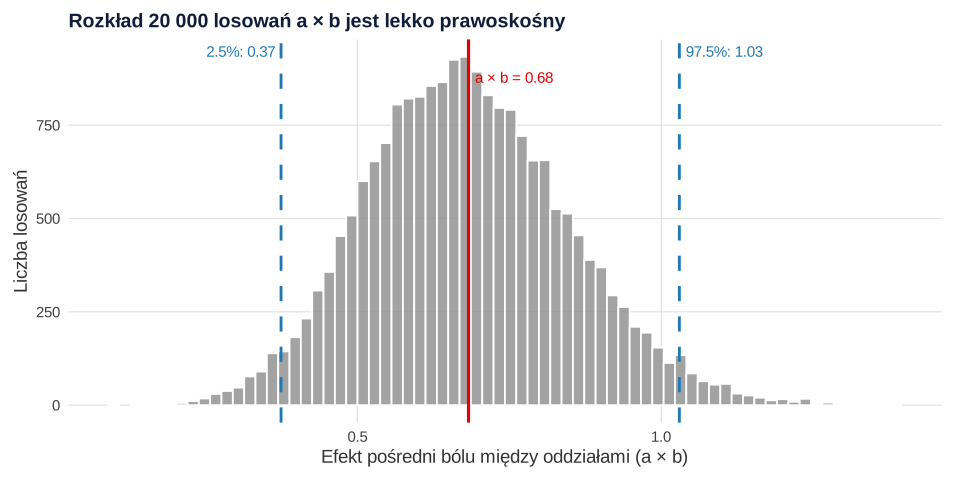
Wyniki z lme4 zestawia tabela. Kolumna „zlany” pochodzi z modelu bez centrowania.
| Schemat i efekt | Zlany (bez centrowania) | Wewnątrz oddziałów | Między oddziałami |
|---|---|---|---|
| 1-1-1: ból → sen → lęk | 0.15 [0.11, 0.19] | 0.11 [0.08, 0.16] | 0.68 [0.37, 1.03] |
| 2-1-1: program → sen → lęk | −0.30 [−0.52, −0.10] | nie istnieje | −0.77 [−1.29, −0.35] |
Efekt zlany w 1-1-1 (0.15) nie opisuje ani pacjentów (0.11), ani oddziałów (0.68). W 2-1-1 model bez centrowania zaniża efekt programu ponad dwukrotnie: −0.30 zamiast −0.77. Dzieje się tak, bo do iloczynu wchodzi b zlane (0.27) zamiast b między oddziałami (0.55).
Krok 3. Dwupoziomowy SEM w lavaan
Centrowanie obserwowanymi średnimi ma słabość: średnia z kilkunastu pacjentów to nierzetelny pomiar cechy oddziału. Lüdtke i in. (2008) pokazali, że traktowanie obserwowanej średniej grupy jako bezbłędnej może obciążać efekty na poziomie 2 i zaniżać ich błędy standardowe. Zależy to od liczebności grup, liczby grup i ICC. Wielopoziomowy SEM (MSEM; Preacher i in., 2010) rozkłada każdą zmienną poziomu 1 na latentne składniki wewnątrz i między grupami. W symulacji Preachera i in. (2011) MSEM miał mniejsze obciążenie i lepsze pokrycie przedziałów niż dwie techniki oparte na zwykłym modelu wielopoziomowym.
W lavaan (Rosseel, 2012; wersja 0.7-2) zapisujesz ścieżki w blokach level: 1 i level: 2 i podajesz cluster = "oddzial". Zmienna program, stała w oddziale, pojawia się tylko na poziomie 2. Efekty pośrednie definiujesz operatorem :=, tak jak w jednopoziomowym modelu z wpisu CB-SEM w R. Ten sam podział na poziomy stosuje się w modelach pomiarowych, co pokazujemy we wpisie o wielopoziomowej analizie czynnikowej. Przedziały Monte Carlo daje funkcja monteCarloCI() z pakietu semTools. Bierze ona pod uwagę kowariancje oszacowań z całego modelu.
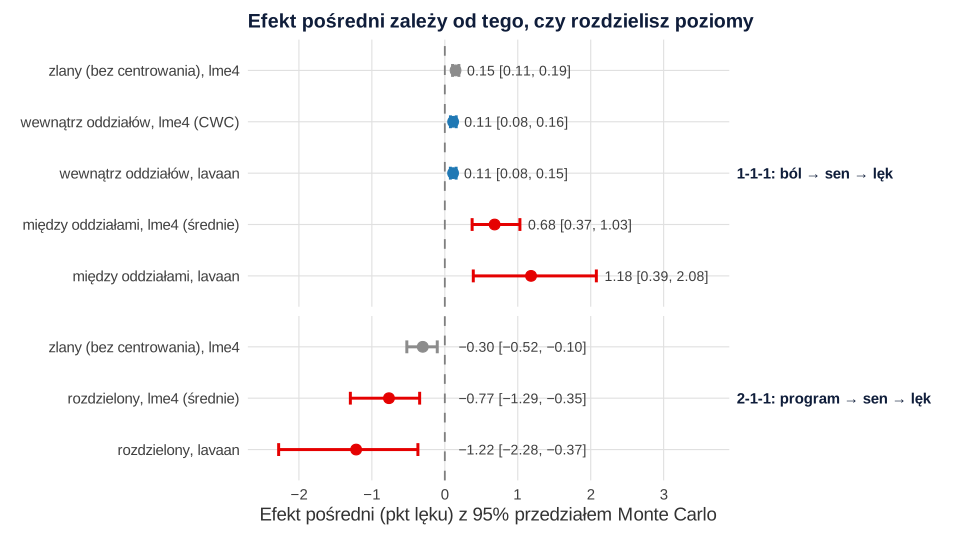
Efekt wewnątrz oddziałów jest w obu podejściach praktycznie taki sam: 0.113, 95% CI [0.076, 0.155] w lavaan. Efekty między oddziałami są w lavaan większe i mniej precyzyjne. Efekt bólu wynosi 1.182 [0.391, 2.078], a efekt programu −1.215 [−2.278, −0.369]. Różnica wynika z tego, że lavaan traktuje średnie oddziałów jako zmienne latentne i uwzględnia ich nierzetelność. Przy 60 oddziałach przedziały na poziomie 2 są szerokie niezależnie od metody. Różnica efektów między i wewnątrz oddziałów wyniosła 1.069 [0.275, 1.967], więc rozdzielenie poziomów nie jest tu formalnością.
Losowe nachylenia: zastrzeżenie Bauera, Preachera i Gil
Dotąd zakładaliśmy, że ścieżki aW i bW są takie same na każdym oddziale. Jeśli różnią się między oddziałami, czyli mają losowe nachylenia, przeciętny efekt pośredni nie jest już iloczynem przeciętnych ścieżek. Bauer i in. (2006) podali wzór na średnią efektu pośredniego, gdy wszystkie efekty w modelu 1-1-1 są losowe:
σajbj to kowariancja nachyleń a i b między grupami. Jeśli na oddziałach, gdzie ból silniej zakłóca sen, sen silniej wiąże się z lękiem, iloczyn średnich zaniży przeciętny efekt pośredni. Kowariancji ścieżek z dwóch osobnych modeli lmer() nie da się oszacować. Oba równania trzeba wtedy oszacować w jednym modelu. Procedura Bauera i in. (2006) daje też przedziały ufności i rozszerzenie na moderowaną mediację, którą w modelu jednopoziomowym omawiamy we wpisie moderowana mediacja w R.
W praktyce zacznij od sprawdzenia, czy nachylenia w ogóle się różnią. W przykładzie dodanie losowego nachylenia snu w równaniu lęku nie poprawiło modelu w teście ilorazu wiarygodności: χ²(2) = 0.02, p = .990, a lme4 zgłosił osobliwe dopasowanie, czyli wariancję nachyleń bliską zeru. Można więc zostać przy stałych ścieżkach. W lavaan 0.7-2 dokumentacja składni opisuje modyfikator rv(), który zamienia ścieżkę poziomu 1 w losowe nachylenie w modelu dwupoziomowym. Takie modele szacuje się jednak znacznie dłużej i wymagają one wielu grup. Rozróżnienie efektów stałych i losowych wyjaśnia hasło w słowniku. Więcej o testowaniu wariancji nachyleń piszemy we wpisie o modelu wielopoziomowym.
Jak opisać mediację wielopoziomową
W metodzie podaj schemat (1-1-1, 2-1-1), liczbę osób i grup, ICC, sposób rozdzielenia poziomów (CWC ze średnimi grup albo latentny rozkład w MSEM), decyzję o losowych nachyleniach i metodę przedziału dla efektu pośredniego. W wynikach podaj ścieżki na każdym poziomie i efekty pośrednie z 95% CI. Gotowy układ tabeli znajdziesz w haśle tabela mediacji w APA.
Jeśli recenzent pyta, czy Twój efekt pośredni nie miesza poziomów, albo planujesz badanie z mediacją w danych z wielu ośrodków, możemy razem sprawdzić model i opis w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik mediacja-oddzialy-dane.csv (możesz go pobrać tutaj), dopasowuje modele lme4 i liczy przedziały Monte Carlo. Drugi dopasowuje dwupoziomowy SEM w lavaan. Potrzebujesz pakietów lme4, MASS, lavaan i semTools.
1. Dane, modele lme4 i przedziały Monte Carlo
R
# Dane symulowane: 60 oddziałów szpitalnych, pacjenci w 3. dobie hospitalizacji
# bol – nasilenie bólu (0–10, poziom 1), sen – zaburzenia snu (0–21, poziom 1), lek – nasilenie lęku (0–21, poziom 1)
# program – program „cicha noc” na oddziale (0/1, poziom 2, losowany między oddziałami)
suppressPackageStartupMessages(library(lme4))
set.seed(1744)
J <- 60
n_j <- sample(8:20, J, replace = TRUE)
oddzial <- rep(seq_len(J), n_j)
N <- length(oddzial)
program <- rep(0:1, each = J / 2)[sample(J)]
bol_odd <- rnorm(J, 0, 0.9)                                  # przeciętny ból na oddziale (odchylenie od 5)
bol <- 5 + bol_odd[oddzial] + rnorm(N, 0, 1.8)
bol_w <- bol - (5 + bol_odd[oddzial])
sen_odd <- 1.2 * bol_odd - 2.0 * program + rnorm(J, 0, 0.8)
sen <- 10 + sen_odd[oddzial] + 0.5 * bol_w + rnorm(N, 0, 3)
sen_w <- sen - (10 + sen_odd[oddzial])
lek <- 7 + 0.6 * sen_odd[oddzial] + 0.2 * bol_odd[oddzial] + rnorm(J, 0, 0.7)[oddzial] +
       0.25 * sen_w + 0.2 * bol_w + rnorm(N, 0, 2.5)
dane <- data.frame(oddzial, program = program[oddzial],
                   bol = pmin(pmax(round(bol), 0), 10), sen = pmin(pmax(round(sen), 0), 21),
                   lek = pmin(pmax(round(lek), 0), 21))
write.csv(dane, "mediacja-oddzialy-dane.csv", row.names = FALSE)
c(pacjenci = N, oddzialy = J, min_n = min(n_j), max_n = max(n_j), program = sum(program))
round(sapply(dane[c("bol", "sen", "lek")], function(x) c(M = mean(x), SD = sd(x))), 2)

# ICC z modeli pustych
icc <- function(y) { v <- as.data.frame(VarCorr(lmer(reformulate("(1 | oddzial)", y), data = dane)))$vcov; v[1] / sum(v) }
round(sapply(c(bol = "bol", sen = "sen", lek = "lek"), icc), 3)

# Centrowanie w grupach (CWC) i średnie oddziałów
dane$bol_sr <- ave(dane$bol, dane$oddzial); dane$bol_cwc <- dane$bol - dane$bol_sr
dane$sen_sr <- ave(dane$sen, dane$oddzial); dane$sen_cwc <- dane$sen - dane$sen_sr
dane$bol_sr_c <- dane$bol_sr - mean(dane$bol)           # średnia oddziału wycentrowana względem średniej ogólnej

# Przedział Monte Carlo dla iloczynu a × b (Preacher i Selig, 2012): a i b z osobnych równań, więc kowariancja = 0
mc_ci <- function(a, se_a, b, se_b, R = 20000) {
  los <- MASS::mvrnorm(R, c(a, b), diag(c(se_a^2, se_b^2)))
  ab <- los[, 1] * los[, 2]
  wynik <- c(efekt = a * b, dolny = unname(quantile(ab, .025)), gorny = unname(quantile(ab, .975)))
  attr(wynik, "losowania") <- ab
  wynik
}
wsp <- function(m, x) unname(c(fixef(m)[x], sqrt(diag(vcov(m)))[match(x, names(fixef(m)))]))

# A. Model zlany (conflated): predyktory bez centrowania
ma_z <- lmer(sen ~ bol + program + (1 | oddzial), data = dane, REML = FALSE)
mb_z <- lmer(lek ~ sen + bol + program + (1 | oddzial), data = dane, REML = FALSE)
# B. Model rozdzielony (CWC + średnie oddziałów; Zhang i in., 2009)
ma_r <- lmer(sen ~ bol_cwc + bol_sr_c + program + (1 | oddzial), data = dane, REML = FALSE)
mb_r <- lmer(lek ~ sen_cwc + sen_sr + bol_cwc + bol_sr_c + program + (1 | oddzial), data = dane, REML = FALSE)
round(rbind(a_bol = summary(ma_z)$coefficients["bol", 1:2], a_program = summary(ma_z)$coefficients["program", 1:2],
            b_sen = summary(mb_z)$coefficients["sen", 1:2]), 3)            # model zlany: wybrane ścieżki
round(summary(ma_r)$coefficients, 3)
round(summary(mb_r)$coefficients, 3)

set.seed(2026)
lista <- list(
  "1-1-1 zlany (bol -> sen -> lek)"       = do.call(mc_ci, as.list(c(wsp(ma_z, "bol"), wsp(mb_z, "sen")))),
  "1-1-1 wewnatrz oddzialow"              = do.call(mc_ci, as.list(c(wsp(ma_r, "bol_cwc"), wsp(mb_r, "sen_cwc")))),
  "1-1-1 miedzy oddzialami"               = do.call(mc_ci, as.list(c(wsp(ma_r, "bol_sr_c"), wsp(mb_r, "sen_sr")))),
  "2-1-1 zlany (program -> sen -> lek)"   = do.call(mc_ci, as.list(c(wsp(ma_z, "program"), wsp(mb_z, "sen")))),
  "2-1-1 rozdzielony (b miedzy)"          = do.call(mc_ci, as.list(c(wsp(ma_r, "program"), wsp(mb_r, "sen_sr")))))
wyn <- do.call(rbind, lista)
round(wyn, 3)

# Czy ścieżka b różni się między oddziałami? Losowe nachylenie sen_cwc, test ilorazu wiarygodności
mb_los <- lmer(lek ~ sen_cwc + sen_sr + bol_cwc + bol_sr_c + program + (1 + sen_cwc | oddzial), data = dane, REML = FALSE)
anova(mb_r, mb_los)
Wynik w R
pacjenci oddzialy    min_n    max_n  program
     842       60        8       20       30
    bol  sen  lek
M  5.04 9.07 6.38
SD 2.05 3.47 3.06
  bol   sen   lek
0.242 0.245 0.251
          Estimate Std. Error
a_bol        0.549      0.055
a_program   -1.127      0.379
b_sen        0.268      0.029
            Estimate Std. Error t value
(Intercept)    9.707      0.226  42.914
bol_cwc        0.473      0.058   8.133
bol_sr_c       1.231      0.148   8.317
program       -1.381      0.328  -4.213
            Estimate Std. Error t value
(Intercept)    1.490      1.139   1.308
sen_cwc        0.241      0.031   7.909
sen_sr         0.554      0.115   4.802
bol_cwc        0.262      0.052   5.065
bol_sr_c       0.233      0.195   1.196
program       -0.283      0.335  -0.845
                                     efekt  dolny  gorny
1-1-1 zlany (bol -> sen -> lek)      0.147  0.106  0.193
1-1-1 wewnatrz oddzialow             0.114  0.077  0.156
1-1-1 miedzy oddzialami              0.683  0.374  1.030
2-1-1 zlany (program -> sen -> lek) -0.302 -0.521 -0.103
2-1-1 rozdzielony (b miedzy)        -0.766 -1.295 -0.345
boundary (singular) fit: see help('isSingular')
Data: dane
Models:
mb_r: lek ~ sen_cwc + sen_sr + bol_cwc + bol_sr_c + program + (1 | oddzial)
mb_los: lek ~ sen_cwc + sen_sr + bol_cwc + bol_sr_c + program + (1 + sen_cwc | oddzial)
       npar    AIC    BIC logLik -2*log(L)  Chisq Df Pr(>Chisq)
mb_r      8 3990.0 4027.8  -1987    3974.0
mb_los   10 3993.9 4041.3  -1987    3973.9 0.0198  2     0.9901
2. Dwupoziomowy SEM w lavaan
R
# Dwupoziomowy model mediacji w lavaan (MSEM; Preacher i in., 2010): ten sam zbiór (obiekt dane z przepisu 1)
# lavaan rozkłada bol, sen i lek na składniki wewnątrz i między oddziałami (średnie latentne)
suppressPackageStartupMessages({library(lavaan); library(semTools)})
model <- "
level: 1
  sen ~ aw*bol
  lek ~ bw*sen + cw*bol
level: 2
  sen ~ ab*bol + ap*program
  lek ~ bb*sen + cb*bol + cp*program
  posredni_w   := aw*bw        # 1-1-1, wewnątrz oddziałów
  posredni_b   := ab*bb        # 1-1-1, między oddziałami
  roznica_wb   := ab*bb - aw*bw
  posredni_211 := ap*bb        # 2-1-1: program -> sen -> lek
"
fit <- sem(model, data = dane[c("oddzial", "program", "bol", "sen", "lek")], cluster = "oddzial")
pe <- parameterEstimates(fit)
sc <- subset(pe, op %in% c("~", ":="))
data.frame(poziom = sc$level, parametr = ifelse(sc$label == "", paste(sc$lhs, sc$op, sc$rhs), sc$label),
           est = round(sc$est, 3), SE = round(sc$se, 3), z = round(sc$z, 2), p = format.pval(sc$pvalue, digits = 2, eps = .001))
lavInspect(fit, "icc")
# Przedziały Monte Carlo dla parametrów zdefiniowanych (20 000 losowań z asymptotycznego rozkładu oszacowań)
set.seed(2026)
monteCarloCI(fit, nRep = 20000)
Wynik w R
   poziom     parametr    est    SE     z      p
1       1           aw  0.471 0.058  8.09 <0.001
2       1           bw  0.241 0.030  7.91 <0.001
3       1           cw  0.264 0.052  5.11 <0.001
4       2           ab  1.437 0.183  7.87 <0.001
5       2           ap -1.477 0.327 -4.51 <0.001
6       2           bb  0.823 0.266  3.09 0.0020
7       2           cb -0.151 0.447 -0.34 0.7352
8       2           cp  0.106 0.508  0.21 0.8345
9       0   posredni_w  0.113 0.020  5.65 <0.001
10      0   posredni_b  1.182 0.425  2.78 0.0054
11      0   roznica_wb  1.069 0.427  2.50 0.0124
12      0 posredni_211 -1.215 0.484 -2.51 0.0121
  sen   lek   bol
0.242 0.248 0.235
                est ci.lower ci.upper
posredni_w    0.113    0.076    0.155
posredni_b    1.182    0.391    2.078
roznica_wb    1.069    0.275    1.967
posredni_211 -1.215   -2.278   -0.369
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0-1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5-8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Predyktory poziomu 1 bez centrowania. Efekt pośredni jest wtedy zlany i nie opisuje żadnego poziomu.
- W schemacie 2-1-1 ścieżka b z modelu bez średnich grup. Efekt pośredni zmiennej grupowej musi używać b między grupami.
- Test Sobela albo „istotne a i istotne b” zamiast przedziału dla iloczynu. Użyj przedziału Monte Carlo lub bootstrapu (zob. efekt pośredni).
- Pominięcie kowariancji losowych nachyleń, gdy ścieżki różnią się między grupami.
- Język przyczynowy przy zmiennych mierzonych jednocześnie. Przyczynowo zinterpretujesz tylko ścieżkę od zmiennej losowanej, a i tak tylko przy dodatkowych założeniach o mediatorze.
- Zbyt mało grup do oszacowania efektów między grupami. Przy kilkudziesięciu oddziałach przedziały na poziomie 2 są szerokie. Uwzględnij to przy planowaniu (zob. badanie z randomizacją klastrową i przewodnik po modelowaniu SEM).
Najczęstsze pytania
Czym różni się mediacja 1-1-1 od 2-1-1?
W schemacie 1-1-1 zmienna niezależna, mediator i wynik są mierzone u osób, więc efekt pośredni może istnieć zarówno wewnątrz grup, jak i między nimi. W 2-1-1 zmienna niezależna jest cechą grupy (np. program na oddziale), a efekt pośredni istnieje tylko między grupami, więc ścieżka mediator → wynik musi być efektem między grupami (Zhang i in., 2009).
Co to jest zlany efekt pośredni w mediacji wielopoziomowej?
To efekt policzony z predyktorami poziomu 1 bez rozdzielenia zmienności wewnątrz i między grupami. Jest ważoną mieszaniną obu efektów i może zaniżać lub zawyżać mediację, gdy efekty na poziomach się różnią (Zhang i in., 2009). W przykładzie zlany efekt programu wyniósł −0.30, a rozdzielony −0.77.
Jak policzyć przedział Monte Carlo dla efektu pośredniego w R?
Wylosuj wiele par ścieżek a i b z rozkładu normalnego o średnich równych oszacowaniom i macierzy kowariancji z ich błędów standardowych (MASS::mvrnorm()), policz iloczyny i weź percentyle 2.5 i 97.5. Dla modelu lavaan zrobi to semTools::monteCarloCI(). Metoda wymaga tylko oszacowań i ich niepewności (Preacher i Selig, 2012).
Mediacja wielopoziomowa w lme4 czy w lavaan?
lme4 z centrowaniem w grupach i średnimi grup jest prosty i dobrze rozdziela poziomy, ale traktuje średnie grup jako bezbłędne. Dwupoziomowy SEM w lavaan rozkłada zmienne na latentne składniki poziomów i w symulacjach miał mniejsze obciążenie i lepsze pokrycie przedziałów (Preacher i in., 2011). Przy małej liczbie grup oba dają szerokie przedziały na poziomie 2.
Czy losowe nachylenia zmieniają efekt pośredni?
Tak. Gdy ścieżki a i b różnią się między grupami, przeciętny efekt pośredni to iloczyn średnich ścieżek plus kowariancja ich losowych nachyleń (Bauer i in., 2006). Dwa osobne modele lmer() tej kowariancji nie oszacują, więc najpierw sprawdź, czy nachylenia rzeczywiście się różnią.
Powiązane hasła
Przeczytaj też
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikWielopoziomowa analiza czynnikowa (MCFA)
ICC pozycji, dwupoziomowa CFA w lavaan, równe ładunki na poziomach, konstrukty wspólne i konfiguralne oraz rzetelność ucznia i szkoły.
Czytaj →Masz mediację w danych z wielu oddziałów, szkół lub ośrodków?
Pomożemy rozdzielić efekty wewnątrz i między grupami, dobrać model w lme4 lub lavaan, policzyć przedziały dla efektów pośrednich i wyjaśnić wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Bauer, D. J., Preacher, K. J., & Gil, K. M. (2006). Conceptualizing and testing random indirect effects and moderated mediation in multilevel models: New procedures and recommendations. Psychological Methods, 11(2), 142–163. https://doi.org/10.1037/1082-989x.11.2.142 ● Otwarty dostęp: pełny tekst
- Enders, C. K., & Tofighi, D. (2007). Centering predictor variables in cross-sectional multilevel models: A new look at an old issue. Psychological Methods, 12(2), 121–138. https://doi.org/10.1037/1082-989x.12.2.121
- Krull, J. L., & MacKinnon, D. P. (2001). Multilevel modeling of individual and group level mediated effects. Multivariate Behavioral Research, 36(2), 249–277. https://doi.org/10.1207/s15327906mbr3602_06
- Lüdtke, O., Marsh, H. W., Robitzsch, A., Trautwein, U., Asparouhov, T., & Muthén, B. (2008). The multilevel latent covariate model: A new, more reliable approach to group-level effects in contextual studies. Psychological Methods, 13(3), 203–229. https://doi.org/10.1037/a0012869
- Preacher, K. J., & Selig, J. P. (2012). Advantages of Monte Carlo confidence intervals for indirect effects. Communication Methods and Measures, 6(2), 77–98. https://doi.org/10.1080/19312458.2012.679848
- Preacher, K. J., Zhang, Z., & Zyphur, M. J. (2011). Alternative methods for assessing mediation in multilevel data: The advantages of multilevel SEM. Structural Equation Modeling: A Multidisciplinary Journal, 18(2), 161–182. https://doi.org/10.1080/10705511.2011.557329
- Preacher, K. J., Zyphur, M. J., & Zhang, Z. (2010). A general multilevel SEM framework for assessing multilevel mediation. Psychological Methods, 15(3), 209–233. https://doi.org/10.1037/a0020141
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Zhang, Z., Zyphur, M. J., & Preacher, K. J. (2009). Testing multilevel mediation using hierarchical linear models: Problems and solutions. Organizational Research Methods, 12(4), 695–719. https://doi.org/10.1177/1094428108327450
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{bauer2006conceptualizing, author={Bauer, Daniel J. and Preacher, Kristopher J. and Gil, Karen M.}, title={{Conceptualizing and testing random indirect effects and moderated mediation in multilevel models: New procedures and recommendations}}, journal={Psychological Methods}, year={2006}, volume={11}, number={2}, pages={142--163}, doi={10.1037/1082-989x.11.2.142}}@article{enders2007centering, author={Enders, Craig K. and Tofighi, Davood}, title={{Centering predictor variables in cross-sectional multilevel models: A new look at an old issue}}, journal={Psychological Methods}, year={2007}, volume={12}, number={2}, pages={121--138}, doi={10.1037/1082-989x.12.2.121}}@article{krull2001multilevel, author={Krull, Jennifer L. and MacKinnon, David P.}, title={{Multilevel modeling of individual and group level mediated effects}}, journal={Multivariate Behavioral Research}, year={2001}, volume={36}, number={2}, pages={249--277}, doi={10.1207/s15327906mbr3602_06}}@article{ludtke2008multilevel, author={Lüdtke, Oliver and Marsh, Herbert W. and Robitzsch, Alexander and Trautwein, Ulrich and Asparouhov, Tihomir and Muthén, Bengt}, title={{The multilevel latent covariate model: A new, more reliable approach to group-level effects in contextual studies}}, journal={Psychological Methods}, year={2008}, volume={13}, number={3}, pages={203--229}, doi={10.1037/a0012869}}@article{preacher2012advantages, author={Preacher, Kristopher J. and Selig, James P.}, title={{Advantages of Monte Carlo confidence intervals for indirect effects}}, journal={Communication Methods and Measures}, year={2012}, volume={6}, number={2}, pages={77--98}, doi={10.1080/19312458.2012.679848}}@article{preacher2011alternative, author={Preacher, Kristopher J. and Zhang, Zhen and Zyphur, Michael J.}, title={{Alternative methods for assessing mediation in multilevel data: The advantages of multilevel SEM}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2011}, volume={18}, number={2}, pages={161--182}, doi={10.1080/10705511.2011.557329}}@article{preacher2010general, author={Preacher, Kristopher J. and Zyphur, Michael J. and Zhang, Zhen}, title={{A general multilevel SEM framework for assessing multilevel mediation}}, journal={Psychological Methods}, year={2010}, volume={15}, number={3}, pages={209--233}, doi={10.1037/a0020141}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{zhang2009testing, author={Zhang, Zhen and Zyphur, Michael J. and Preacher, Kristopher J.}, title={{Testing multilevel mediation using hierarchical linear models: Problems and solutions}}, journal={Organizational Research Methods}, year={2009}, volume={12}, number={4}, pages={695--719}, doi={10.1177/1094428108327450}}