Dla kogo jest ten przewodnik i jak z niego korzystać
Przewodnik jest dla doktorantów i badaczy, którzy planują albo właśnie wykonują analizę modelowania równań strukturalnych (SEM) do artykułu, rozprawy lub raportu z grantu. Zakładamy, że znasz regresję i podstawy analizy czynnikowej, a potrzebujesz uporządkowanej drogi przez decyzje, które w SEM łatwo pomylić: jak mierzyć konstrukt, którą metodę wybrać, jak ocenić model pomiarowy i co pokazać w raporcie. Nie jest to nowy poradnik krok po kroku, tylko mapa wpisów, haseł i przykładów w R, które już są w serwisie.
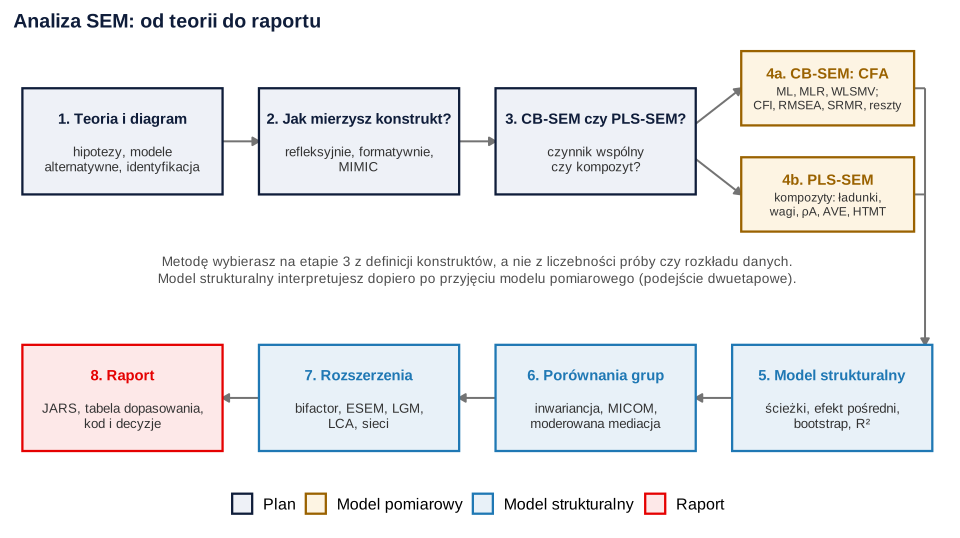
Ścieżka ma osiem etapów (rysunek 1). Trzy pierwsze to decyzje teoretyczne, które podejmujesz przed analizą. Etap 4 ma dwa warianty: osobny dla CB-SEM (model czynnika wspólnego, CFA) i osobny dla PLS-SEM (model kompozytowy). Dalej obie drogi łączą się w modelu strukturalnym, porównaniach grup, rozszerzeniach i raporcie. Jeśli masz konkretny kłopot, np. słabe dopasowanie albo ujemną wariancję błędu, zacznij od tabeli problemów.
Przy każdym etapie znajdziesz kilka zdań o tym, co zrobić, i listę stron z jednozdaniowym opisem. Wpisy z przykładem w R mają pełny kod i wyniki, więc możesz na nich przećwiczyć analizę, zanim uruchomisz własny model.
Etap 1. Teoria, diagram ścieżkowy i identyfikacja
SEM sprawdza, czy model wynikający z teorii odtwarza zależności w danych, więc analiza zaczyna się od rysunku, a nie od programu. Zapisz każdą hipotezę jako strzałkę albo jej brak, bo brak strzałki też jest założeniem, które model testuje. Przygotuj z góry jeden lub dwa modele alternatywne, z którymi porównasz model główny. Zanim uruchomisz estymację, sprawdź, czy model jest zidentyfikowany: każda zmienna ukryta potrzebuje skali, a liczba wolnych parametrów nie może przekraczać liczby wariancji i kowariancji zmiennych obserwowanych.
- Modelowanie równań strukturalnych (SEM) – czym jest SEM, co daje w porównaniu z regresją na sumach pozycji i jak czytać model w cudzym artykule.
- SEM w słowniku – model pomiarowy, model strukturalny i kolejność ich oceny w jednym miejscu.
- Wykres ścieżkowy – symbole (prostokąty, owale, strzałki, łuki) i zasada, że każda strzałka to szacowany parametr.
- Zmienna ukryta (latentna) – jak model oddziela cechę od błędu pomiaru i jak nadać jej skalę.
- Zmienna jawna – rola wskaźnika, jawnego predyktora i zmiennej zależnej oraz co sprawdzić w danych przed analizą.
- Identyfikacja modelu SEM – reguła t, skalowanie czynników i identyfikacja empiryczna.
Etap 2. Jak mierzysz konstrukt: refleksyjnie czy formatywnie
To decyzja teoretyczna, której nie rozstrzygnie alfa Cronbacha ani dopasowanie modelu. Jeśli konstrukt jest wspólną przyczyną odpowiedzi, pozycje są wymienne i powinny korelować – to model refleksyjny. Jeśli wskaźniki współtworzą konstrukt (np. kilka źródeł stresu składa się na obciążenie), nie muszą korelować, a usunięcie któregoś zmienia definicję konstruktu – to model formatywny. Przy konstruktach wielowymiarowych zdecyduj też, czy potrzebujesz czynnika wyższego rzędu.
- Model refleksyjny czy formatywny? – kryteria decyzji, symulacja skutków błędnej specyfikacji i model MIMIC krok po kroku.
- Modele refleksyjne i formatywne – kierunek zależności między konstruktem a wskaźnikami i jak rozpoznać właściwy model.
- Refleksyjna zmienna latentna – konsekwencje założenia, że konstrukt jest wspólną przyczyną wskaźników.
- Formatywna zmienna latentna – dlaczego alfa i ładunki nie służą do jej oceny i jak ją zidentyfikować w CB-SEM.
- Model MIMIC – wiele wskaźników i wiele przyczyn, także do porównania grup i wykrywania DIF.
- Hierarchiczna zmienna latentna – model drugiego rzędu i warunki jego identyfikacji.
- Modelowanie konstruktów wyższego rzędu – praktyczne podejścia do konstruktów zbudowanych z kilku wymiarów.
- Jak zaprojektować pomiar latentny – co zaplanować przed zebraniem danych: pozycja globalna, zmienne do MIMIC, liczba wskaźników.
- Analiza redundancji – walidacja konstruktu formatywnego pozycją globalną.
Etap 3. CB-SEM czy PLS-SEM
CB-SEM szacuje model czynnika wspólnego z błędem pomiaru, a PLS-SEM – model, w którym konstrukt jest ważoną sumą wskaźników (kompozytem). Sarstedt i in. (2016) oddzielają sposób pomiaru (refleksyjny lub formatywny) od modelu estymacji i pokazują, że metoda niedopasowana do natury danych daje obciążone oszacowania. Wybór uzasadnij tym, czym jest konstrukt w Twojej teorii, a nie małą próbą czy brakiem normalności. Gdy konstrukty traktujesz jak czynniki, a pracujesz w środowisku PLS, rozważ PLSc.
- PLS-SEM czy CB-SEM? – porównanie metod, symulacja obciążeń, trzy mity i pięć pytań do decyzji.
- PLSc (consistent PLS) – jak spójny PLS koryguje zaniżone ścieżki i zawyżone ładunki przy konstruktach refleksyjnych.
- Confirmatory Composite Analysis (CCA) – odpowiednik CFA dla modeli kompozytowych i czym CCA różni się od CFA.
- Mode A i Mode B w PLS-PM – dwa sposoby liczenia wag zewnętrznych i kiedy który wybrać.
Etap 4a. CB-SEM: dane, estymator i model pomiarowy
Najpierw dopasuj estymator do danych: ML przy zmiennych zbliżonych do normalnych, MLR przy skośnych pozycjach z co najmniej pięcioma kategoriami, WLSMV przy pozycjach o 2–4 kategoriach; braki danych obsłuż metodą FIML. Model pomiarowy (CFA) oceń przed strukturalnym, globalnie i lokalnie. Hu i Bentler (1999) zaproponowali wartości odcięcia bliskie .95 dla CFI i TLI, .06 dla RMSEA i .08 dla SRMR, ale Marsh i in. (2004) pokazali, że traktowanie ich jak uniwersalnych „złotych reguł” przepuszcza modele błędnie określone. Dlatego obok wskaźników przejrzyj reszty i indeksy modyfikacji, a każdą zmianę modelu uzasadnij teorią i opisz.
- CB-SEM – założenia i interpretacja – specyfikacja, identyfikacja, estymatory, ocena dopasowania bez polowania na progi, moc i liczebność próby.
- CB-SEM w R (lavaan) – kompletny przykład od CFA z MLR i FIML do bootstrapowego przedziału efektu pośredniego i tabeli APA.
- Analiza czynnikowa EFA i CFA – od liczby czynników w EFA do modelu potwierdzonego na nowych danych.
- CFA (konfirmacyjna analiza czynnikowa) – jak określić model, ocenić dopasowanie globalne i lokalne i opisać wynik.
- MLR – odporne błędy standardowe i skalowany χ² przy danych skośnych oraz jak to raportować.
- WLSMV – estymator dla pozycji porządkowych oparty na korelacjach polichorycznych.
- Macierz reszt standaryzowanych – jak znaleźć parę zmiennych, której model nie odtwarza.
- Indeksy modyfikacji – jak czytać MI razem z SEPC i kiedy wolno uwolnić parametr.
- Kategorialna CFA (WLSMV) – pozycje Likerta jako dane porządkowe, progi i skalowane indeksy.
- Trafność zbieżna i różnicowa – AVE, CR, HTMT i krytyka kryterium Fornella–Larckera.
- Skalowany chi-kwadrat Satorry–Bentlera – jak poprawnie porównać modele zagnieżdżone przy MLR i MLM.
Etap 4b. PLS-SEM: ocena kompozytów
W PLS-SEM model pomiarowy oceniasz inaczej niż w CFA. Dla konstruktów refleksyjnych sprawdzasz ładunki, rzetelność (ρA, ρC), AVE i trafność różnicową w HTMT, a dla formatywnych – współliniowość, istotność i wielkość wag oraz trafność zbieżną (analizę redundancji). Progi w PLS-SEM to reguły kciuka, więc podawaj ich źródło. Model strukturalny oceniasz potem przez ścieżki z przedziałami bootstrapowymi, R², f² i zdolność predykcyjną poza próbą.
- PLS-SEM krok po kroku – ocena modelu pomiarowego i strukturalnego z tabelą progów i ich źródeł.
- PLS-SEM w R: seminr i cSEM – kompletny przykład od danych do raportu i wyjaśnienie, dlaczego pakiety dają różne liczby.
- Ładunek zewnętrzny – próg .708 i co zrobić ze wskaźnikiem o ładunku .40–.70.
- Waga zewnętrzna – wkład wskaźnika formatywnego ponad pozostałe i dlaczego waga bywa nieistotna przy wysokim ładunku.
- Rzetelność kompozytowa (ρC) – wzór, obliczenie i interpretacja wobec alfy.
- AVE – trafność zbieżna i kryterium Fornella–Larckera.
- HTMT – stosunek korelacji między konstruktami do korelacji wewnątrz konstruktów jako miara trafności różnicowej.
- PLSpredict – czy model przewiduje wskaźniki u osób, które nie brały udziału w estymacji.
Etap 5. Model strukturalny i efekty pośrednie
Ścieżki między konstruktami interpretuj dopiero po przyjęciu modelu pomiarowego. Takie podejście dwuetapowe zalecili Anderson i Gerbing (1988), proponując serię modeli zagnieżdżonych porównywanych testem różnicy χ². Efekty pośrednie testuj przedziałem bootstrapowym, a w badaniu przekrojowym opisuj je jako zgodne z modelem, a nie jako dowód przyczynowości. Modele zagnieżdżone porównuj testem Δχ² (przy estymatorach odpornych – w wersji skalowanej), niezagnieżdżone – kryteriami informacyjnymi.
- Analiza mediacji krok po kroku – efekt pośredni ab z przedziałem bootstrap w PROCESS i lavaan, bez kroków Barona i Kenny’ego.
- Efekt pośredni – wzór ab, przedział bootstrap i interpretacja.
- Efekt bezpośredni – co oznacza c′ i dlaczego jego brak nie dowodzi mediacji całkowitej.
- Bootstrap w SEM – przedziały dla efektów pośrednich i bootstrap Bollena–Stine’a przy danych nienormalnych.
- Test różnicy chi-kwadrat – porównanie modeli zagnieżdżonych i jego wersja dla estymatorów odpornych.
- AIC i BIC w SEM – porównanie modeli konkurencyjnych i co zrobić, gdy kryteria wskazują różne modele.
- Tabela mediacji w APA – wzór tabeli ze ścieżkami a, b, c′ i efektem pośrednim.
Etap 6. Porównania grup i moderacja
Zanim porównasz ścieżki albo średnie konstruktów między grupami, sprawdź, czy narzędzie mierzy to samo w każdej z nich. W CB-SEM robisz to kolejnymi modelami CFA (konfiguracyjny, metryczny, skalarny, ścisły), w PLS-SEM – procedurą MICOM. Gdy efekt pośredni ma zależeć od trzeciej zmiennej, testuj moderowaną mediację jej indeksem, a nie osobnymi analizami w podgrupach. Jeśli podejrzewasz, że w próbie są nieoznaczone segmenty o różnych zależnościach, sięgnij po modele mieszanin.
- Inwariancja pomiaru krok po kroku – wielogrupowa CFA w lavaan, kryteria ΔCFI i ΔRMSEA i pozycje porządkowe.
- Inwariancja pomiaru w CB-SEM – poziomy inwariancji, kryteria i inwariancja podłużna.
- MICOM – trzy kroki sprawdzania inwariancji kompozytów przed wielogrupowym PLS-SEM.
- Moderowana mediacja i modele PROCESS w R – warunkowe efekty pośrednie i porównanie modeli krok po kroku.
- Moderowana mediacja – moderator na ścieżce a, b albo obu i efekty warunkowe z bootstrapem.
- Indeks moderowanej mediacji – jedna liczba z przedziałem ufności, która testuje, czy efekt pośredni zależy od moderatora.
- FIMIX-PLS – wykrywanie ukrytych segmentów o różnych współczynnikach ścieżek w PLS-SEM.
Etap 7. Rozszerzenia: wielowymiarowość, zmiana w czasie i podgrupy latentne
Część pytań wymaga modelu, który wykracza poza standardowy model pomiarowy i strukturalny. Gdy skala ma podskale i wynik ogólny, porównaj CFA, ESEM i bifactor, a o modelu rozstrzygaj wskaźnikami ω i ECV, nie samym CFI. Gdy mierzysz te same osoby co najmniej trzy razy, modeluj trajektorie krzywą wzrostu. Gdy szukasz typów osób zamiast związków między zmiennymi, użyj analizy klas latentnych, a gdy interesują Cię związki między objawami – sieci psychometrycznej.
- Model bifactor i ESEM – od CFA do bifactor-ESEM w lavaan, ze wskaźnikami ωH, ωHS i ECV.
- Model bifactor – czynnik ogólny i czynniki specyficzne oraz dlaczego lepsze dopasowanie to za mało.
- ESEM – pomiar w postaci EFA z rotacją, który nie zawyża korelacji czynników przez wyzerowane ładunki krzyżowe.
- Krzywe wzrostu (LGM) i modele zmiany – kształt zmiany, kodowanie czasu, predyktory i ten sam model jako model mieszany.
- Krzywa wzrostu (LGM) – poziom początkowy i nachylenie jako zmienne ukryte.
- Modele cross-lagged: CLPM i RI-CLPM – logika i interpretacja modeli opóźnień krzyżowych.
- Analiza klas latentnych (LCA) – wyodrębnianie ukrytych podgrup w odpowiedziach kategorialnych krok po kroku.
- Sieci psychometryczne – estymacja sieci, stabilność krawędzi i centralności krok po kroku.
- Wielopoziomowa CFA (MCFA) – struktura skali na poziomie osób i grup.
- Mediacja wielopoziomowa – schematy 1-1-1 i 2-1-1, efekty wewnątrz i między grupami.
Etap 8. Raport
Standardy JARS-Quant mają osobny moduł dla SEM (Appelbaum i in., 2018). McDonald i Ho (2002) zalecają, żeby raport uzasadniał model i jego alternatywy, omawiał identyfikację, nienormalność i braki danych, podawał pełny zestaw parametrów z błędami standardowymi, a obok wskaźników dopasowania także macierz korelacji i reszty. Dzięki temu czytelnik może sam ocenić model. Opisz każdą modyfikację wprowadzoną po zobaczeniu danych i udostępnij kod oraz, jeśli to możliwe, dane albo macierz kowariancji.
- Wytyczne APA i JARS-Quant – co raportować w metodzie i wynikach, w tym w modułach dla poszczególnych schematów.
- Tabela dopasowania modelu CFA w APA – wzór tabeli z χ², df, CFI, TLI, RMSEA z 90% CI i SRMR dla modeli konkurencyjnych.
- Pakiet replikacyjny – dane, książka kodowa, skrypty i README w repozytorium z DOI.
- Tabele i rysunki do artykułu – wymogi czasopism, rysunki w R i materiały uzupełniające.
- Zarzuty recenzentów do statystyki – czego recenzenci najczęściej się czepiają i jak temu zapobiec przed wysłaniem tekstu.
- Odpowiedź recenzentom – wzory odpowiedzi po polsku i angielsku, m.in. w sprawie błędu wspólnej metody.
Mam problem – co przeczytać
Najczęstsze sytuacje z analiz SEM i strony, od których warto zacząć.
| Mój problem | Przeczytaj |
|---|---|
| Recenzent pyta, dlaczego użyłem(-am) PLS-SEM, skoro próba była duża | PLS-SEM czy CB-SEM? |
| Pozycje są w skali Likerta 1–4. ML, MLR czy WLSMV? | WLSMV, korelacja polichoryczna |
| CFI = .93, a RMSEA = .05. Czy model pasuje? | CFI, RMSEA |
| Test χ² modelu jest istotny przy N = 800 | CMIN i zależność χ² od liczebności |
| Program podpowiada skorelowanie kilkunastu reszt | kowariancja reszt w SEM |
| Ujemna wariancja błędu albo ładunek standaryzowany powyżej 1 | przypadek Heywooda |
| Model się nie zbiega albo program zgłasza brak identyfikacji | identyfikacja modelu SEM, ostrzeżenia lavaan we wpisie o CB-SEM w R |
| Wskaźniki konstruktu prawie nie korelują ze sobą | model refleksyjny czy formatywny? |
| Dwa konstrukty korelują na poziomie .90 | HTMT, ładunki krzyżowe |
| Alfa jest niska, choć ładunki są wysokie i nierówne | omega McDonalda |
| Mam braki danych w kilku pozycjach | braki danych MCAR, MAR i MNAR |
| Chcę porównać ścieżki u kobiet i mężczyzn | inwariancja pomiaru krok po kroku |
| Wszystkie zmienne pochodzą z jednej ankiety w jednym pomiarze | błąd wspólnej metody we wzorach odpowiedzi recenzentom |
| Podskale korelują tak wysoko, że nie wiem, czy liczyć wynik ogólny | model bifactor i ESEM |
| Ile osób potrzebuję do modelu SEM? | moc i liczebność próby we wpisie o CB-SEM |
| Recenzent chce zobaczyć, czy model PLS przewiduje coś poza próbą | Q² Stone’a-Geissera, PLSpredict |
| Nie wiem, co dodać do ankiety, żeby zwalidować konstrukt formatywny. | Jak zaprojektować pomiar latentny |
| HTMT wyszło powyżej .85. | Trafność zbieżna i różnicowa |
| Mam dane z zespołów albo klas i chcę zrobić CFA. | Wielopoziomowa CFA |
| Ilu osób potrzebuję do mojego modelu SEM? | Liczebność próby do SEM – Monte Carlo |
| Chcę sprawdzić moderację między zmiennymi latentnymi. | Interakcja latentna w SEM |
| Mam braki danych i model SEM. | Imputacja wielokrotna w regresji i SEM |
| Mam kilka mediatorów naraz. | Mediacja równoległa i szeregowa |
| Chcę znaleźć grupy osób o różnych trajektoriach zmian. | Trajektorie: LCGA i GMM |
| Mam model z kilkoma zmiennymi zależnymi, ale bez zmiennych latentnych. | Analiza ścieżek w lavaan |
Najważniejsze hasła ze słownika
Hasła, które uzupełniają listy etapów: wskaźniki dopasowania, estymatory, rzetelność i dodatkowe narzędzia PLS-SEM. Każde ma definicję, wzór i przykład.
Wskaźniki dopasowania CB-SEM
- TLI – indeks Tuckera–Lewisa i wartości powyżej 1.
- SRMR – przeciętna różnica między korelacjami z danych i z modelu.
- FMIN – minimum funkcji rozbieżności, z którego powstają χ² i RMSEA.
- GFI – klasyczny wskaźnik bezwzględny i jego zależność od liczebności próby.
- NFI – normowany indeks Bentlera i Boneta bez kary za złożoność.
- PCFI i PNFI – oszczędnościowe wersje CFI i NFI do porównywania modeli.
- PGFI – GFI z karą za złożoność, bez progu akceptowalności.
Estymatory
- Metoda największej wiarygodności (ML) – estymator domyślny w CFA i SEM i kiedy zawodzi.
- ADF – estymator bez założenia normalności, który wymaga bardzo dużej próby.
- GLS – uogólnione najmniejsze kwadraty i różnice wobec ML.
Ładunki i rzetelność
- Ładunek czynnikowy – interpretacja, umowne progi i niepewność oszacowania.
- Bootstrap – ogólna logika przedziałów bootstrapowych poza SEM.
Dodatkowe narzędzia PLS-SEM
- Blindfolding – procedura, z której powstaje Q² Stone’a–Geissera.
- dULS i dG – globalne dopasowanie modelu PLS porównywane z kwantylami bootstrapu.
- IPMA – mapa ważności i wydajności konstruktów.
- Niejawna heterogeniczność – gdy jeden model uśrednia podgrupy o przeciwnych zależnościach.
Modele ukrytych podgrup i sieci
- Analiza klas latentnych (LCA) – wybór liczby klas według BIC i BLRT.
- Analiza profili latentnych (LPA) – to samo dla zmiennych ciągłych.
- Sieć psychometryczna – węzły, krawędzie i regularyzacja.
- Centralność w sieci – siła węzła i zastrzeżenia wobec pośrednictwa i bliskości.
Kalkulatory a SEM
W serwisie nie ma kalkulatora liczebności dla SEM i to nie przypadek: potrzebna próba zależy od liczby wskaźników, wielkości ładunków, braków danych i tego, który parametr chcesz wykryć, więc uczciwą odpowiedź daje analiza mocy oparta na RMSEA albo symulacja Monte Carlo (opisane we wpisie CB-SEM – założenia i interpretacja). Kalkulator liczebności próby nadaje się do pojedynczej korelacji między dwoma wynikami, ale nie do całego modelu. Przy planowaniu przyda się natomiast konwerter wielkości efektu, gdy w literaturze związek między konstruktami podano jako d, a Ty potrzebujesz r do założeń symulacji.
- Kalkulator AVE, CR i HTMT – AVE, CR, tabela Fornella–Larckera i HTMT/HTMT2 z wklejonej macierzy korelacji.
- Kalkulator alfy i omegi – omega i współczynnik H z ładunków czynnikowych.
- Kalkulator ICC i efektu schematu – ICC i efekt schematu, gdy planujesz model wielopoziomowy albo MCFA.
- Kalkulator efektu pośredniego – przedział Monte Carlo z a, b i ich błędów standardowych.
- Kalkulator efektów prostych i Johnsona–Neymana – sondowanie interakcji z wykresem efektu warunkowego.
Kiedy warto skonsultować model
W SEM najdroższe błędy powstają na etapach 2 i 3: źle określony model pomiaru i metoda niedopasowana do natury konstruktu dają obciążone ścieżki, których nie naprawi żadna modyfikacja po fakcie. Konsultacja ma więc największy sens przed zebraniem danych albo przed wysłaniem artykułu do recenzji. Możemy sprawdzić specyfikację i identyfikację modelu, dobrać estymator, wykonać analizę z kodem w R i pomóc przygotować tabele oraz odpowiedź na uwagi recenzentów; szczegóły są na stronie analiz statystycznych dla badaczy. Autorem analizy w artykule zostajesz Ty, a pomoc ujawniasz zgodnie z zasadami czasopisma.
Inne przewodniki w serwisie: psychometria i budowa skal (trafność, rzetelność i IRT), analiza kwestionariusza oraz doktorat i publikacje naukowe.
Najczęstsze pytania
Od czego zacząć analizę SEM do artykułu?
Od diagramu ścieżkowego wynikającego z teorii i jednego lub dwóch modeli alternatywnych. Potem zdecyduj, czy konstrukty mierzysz refleksyjnie czy formatywnie, i dopiero na tej podstawie wybierz CB-SEM albo PLS-SEM. Model strukturalny interpretuj po przyjęciu modelu pomiarowego (Anderson i Gerbing, 1988).
Czy progi CFI ≥ .95 i RMSEA ≤ .06 wystarczą do oceny modelu SEM?
Nie. Hu i Bentler (1999) zaproponowali je na podstawie konkretnych symulacji, a Marsh i in. (2004) pokazali, że w tych samych warunkach wiele modeli błędnie określonych mieściło się w progach. Traktuj wskaźniki jako orientację, a model oceniaj także lokalnie: przez reszty standaryzowane, indeksy modyfikacji i sens oszacowań.
Kiedy w SEM użyć WLSMV zamiast MLR?
Gdy pozycje są dychotomiczne albo mają 3–4 kategorie – wtedy traktowanie odpowiedzi jak liczb zaniża ładunki. WLSMV traktuje odpowiedzi jak pocięte progami ciągłe skłonności i pracuje na korelacjach polichorycznych. Przy co najmniej pięciu kategoriach i umiarkowanej skośności dobrym wyborem jest zwykle MLR. Szczegóły w haśle WLSMV.
Co powinien zawierać raport z analizy SEM w artykule?
Uzasadnienie modelu i alternatyw, opis identyfikacji, estymatora, braków danych i nienormalności, pełny zestaw parametrów z błędami standardowymi, wskaźniki dopasowania z RMSEA i 90% CI oraz macierz korelacji lub reszty (McDonald i Ho, 2002). Opisz każdą modyfikację wprowadzoną po zobaczeniu danych i udostępnij kod.
Czy mała próba to dobry powód, żeby wybrać PLS-SEM?
Nie. CB-SEM i PLS-SEM szacują różne modele: czynnik wspólny i kompozyt. Metoda niedopasowana do natury konstruktu daje obciążone ścieżki niezależnie od liczebności (Sarstedt i in., 2016). Wybór uzasadnij definicją konstruktu, a o liczebności zdecyduj analizą mocy lub symulacją.
Powiązane hasła
Przeczytaj też
CB-SEM – założenia i interpretacja
Identyfikacja, ML, MLR i WLSMV, test χ² i indeksy dopasowania bez magicznych progów, moc, modele równoważne i raport – z symulacjami w R.
Czytaj →PoradnikPLS-SEM czy CB-SEM?
Model czynnikowy a kompozytowy, mity o małej próbie, symulacja obciążeń PLS, PLSc i CB-SEM w R oraz wzory uzasadnienia wyboru metody w artykule.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Budujesz model SEM do artykułu albo rozprawy?
Sprawdzimy specyfikację i identyfikację modelu, dobierzemy estymator i metodę, wykonamy analizę z kodem w R i pomożemy przygotować tabele oraz odpowiedź na uwagi recenzentów.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, J. C., & Gerbing, D. W. (1988). Structural equation modeling in practice: A review and recommended two-step approach. Psychological Bulletin, 103(3), 411–423. https://doi.org/10.1037/0033-2909.103.3.411
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. https://doi.org/10.1207/s15328007sem1103_2
- McDonald, R. P., & Ho, M.-H. R. (2002). Principles and practice in reporting structural equation analyses. Psychological Methods, 7(1), 64–82. https://doi.org/10.1037/1082-989x.7.1.64
- Sarstedt, M., Hair, J. F., Ringle, C. M., Thiele, K. O., & Gudergan, S. P. (2016). Estimation issues with PLS and CBSEM: Where the bias lies! Journal of Business Research, 69(10), 3998–4010. https://doi.org/10.1016/j.jbusres.2016.06.007 ● Otwarty dostęp
Cytowania BibTeX
@article{anderson1988structural, author={Anderson, James C. and Gerbing, David W.}, title={{Structural equation modeling in practice: A review and recommended two-step approach}}, journal={Psychological Bulletin}, year={1988}, volume={103}, number={3}, pages={411--423}, doi={10.1037/0033-2909.103.3.411}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{marsh2004search, author={Marsh, Herbert W. and Hau, Kit-Tai and Wen, Zhonglin}, title={{In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2004}, volume={11}, number={3}, pages={320--341}, doi={10.1207/s15328007sem1103_2}}@article{mcdonald2002principles, author={McDonald, Roderick P. and Ho, Moon-Ho Ringo}, title={{Principles and practice in reporting structural equation analyses}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={64--82}, doi={10.1037/1082-989x.7.1.64}}@article{sarstedt2016estimation, author={Sarstedt, Marko and Hair, Joseph F. and Ringle, Christian M. and Thiele, Kai O. and Gudergan, Siegfried P.}, title={{Estimation issues with PLS and CBSEM: Where the bias lies!}}, journal={Journal of Business Research}, year={2016}, volume={69}, number={10}, pages={3998--4010}, doi={10.1016/j.jbusres.2016.06.007}}