Co to jest IPMA?
IPMA (ang. importance-performance map analysis, analiza mapy ważności i wydajności) to rozszerzenie wyników PLS-SEM, które dla każdego poprzednika wybranej zmiennej docelowej zestawia dwie informacje:
- ważność (importance) – jak silnie poprzednik wpływa na zmienną docelową (niestandaryzowany efekt całkowity);
- wydajność (performance) – jak wysoko respondenci oceniają poprzednik (średni wynik konstruktu na skali 0–100).
Idea pochodzi z analizy ważności i wykonania w marketingu. Martilla i James (1977) opisali ją jako prostą technikę łącznego pomiaru ważności i wykonania cech usługi. Ringle i Sarstedt (2016) przenieśli ją do PLS-SEM. Zwykła analiza ścieżek mówi tylko, co jest ważne. IPMA dodaje drugi wymiar: gdzie jest jeszcze miejsce na poprawę. W psychologii przydaje się wszędzie tam, gdzie wyniki mają prowadzić do działań: w badaniach satysfakcji studentów, klimatu pracy czy oceny programów profilaktycznych.
Jak liczy się ważność i wydajność?
Procedura według Ringle i Sarstedt (2016) ma cztery kroki.
- Przeskaluj wskaźniki na 0–100 według teoretycznego zakresu skali, a nie wartości obserwowanych:
x′ = (x − min) / (max − min) × 100Dla pozycji 1–7 odpowiedź 4 daje 50, a odpowiedź 7 – 100.
- Policz wyniki konstruktów na skali 0–100. Użyj niestandaryzowanych wag zewnętrznych (waga standaryzowana podzielona przez SD wskaźnika), przeskalowanych tak, by sumowały się do 1 w każdym konstrukcie. Wynik konstruktu to średnia ważona przeskalowanych wskaźników.
- Wydajność to średnia tego wyniku w próbie.
- Ważność to niestandaryzowany efekt całkowity poprzednika na zmienną docelową w modelu oszacowanym na wynikach 0–100. Efekt całkowity to efekt bezpośredni plus efekty pośrednie.
Ważność ma prostą interpretację: wzrost wydajności poprzednika o 1 punkt (na 100) zmienia wydajność zmiennej docelowej o tyle punktów, ile wynosi ważność. Ringle i Sarstedt (2016) zaznaczają, że IPMA ma wymagania dotyczące skal pomiaru, kodowania zmiennych i oszacowań wag wskaźników oraz zakłada zależności liniowe. W praktyce oznacza to skale o tej samej orientacji (wyżej = lepiej) i dodatnie wagi zewnętrzne. Jeśli któraś pozycja jest odwrócona, przekoduj ją przed analizą.
Przykład: co zwiększy zaangażowanie studentów w naukę?
320 studentów (dane symulowane) oceniło na skali 1–7 (po 3 pozycje): wsparcie prowadzących, jasność wymagań, autonomię w nauce, satysfakcję ze studiów i zaangażowanie w naukę (zmienna docelowa). W modelu PLS-SEM trzy pierwsze konstrukty wpływają na satysfakcję i zaangażowanie, a satysfakcja – na zaangażowanie. Model wyjaśnia 27.7% wariancji zaangażowania (R² = .277). Standaryzowane efekty całkowite na zaangażowanie wynoszą: jasność wymagań .335, satysfakcja .317, wsparcie .159 i autonomia .104.
| Poprzednik | Ważność (efekt całkowity, niestand.) | Wydajność (0–100) | Wniosek |
|---|---|---|---|
| Jasność wymagań | 0.32 | 44.1 | Priorytet: ważne i najsłabiej oceniane |
| Satysfakcja ze studiów | 0.32 | 61.4 | Ważne, ocenione dobrze – utrzymać |
| Wsparcie prowadzących | 0.16 | 64.9 | Najlepiej oceniane, umiarkowanie ważne |
| Autonomia w nauce | 0.10 | 56.4 | Mało ważne dla zaangażowania |
Wydajność samego zaangażowania wynosi 56.2. Średnia ważność czterech poprzedników to 0.23, a średnia wydajność 56.7. Te dwie wartości dzielą mapę na ćwiartki (rysunek 1). Jasność wymagań ląduje w prawej dolnej ćwiartce: ma najwyższą ważność, a najniższą wydajność. Wzrost jej wydajności o 10 punktów, np. z 44 do 54, przewiduje wzrost zaangażowania o 3.23 punktu. Ten sam wzrost wsparcia prowadzących dałby tylko ok. 1.6 punktu, a przy tym wsparcie jest już oceniane najwyżej.
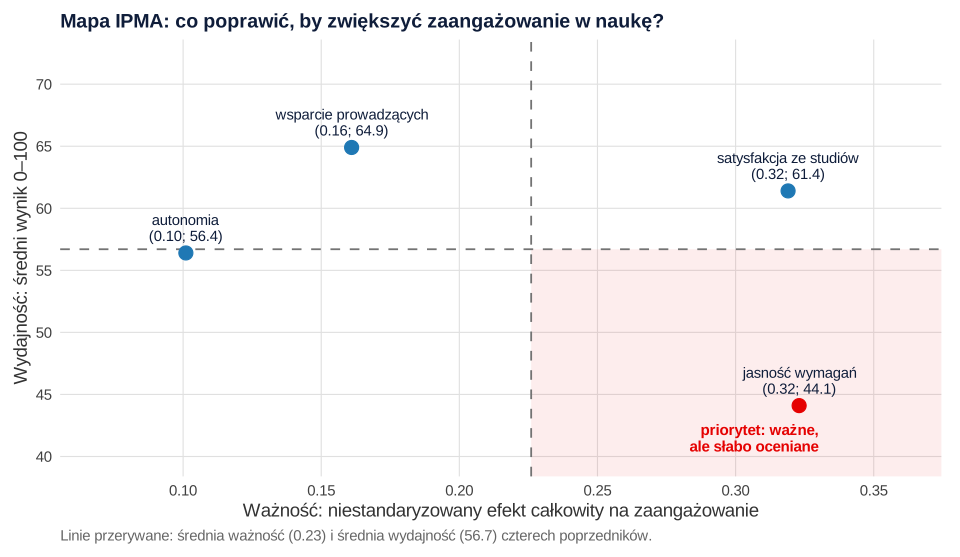
Dwa szczegóły interpretacji:
- Ważność to efekt całkowity, a nie ścieżka bezpośrednia. Wsparcie ma małą ścieżkę bezpośrednią na zaangażowanie (.083), ale działa też przez satysfakcję. IPMA bierze pod uwagę oba kanały.
- Ćwiartki są względne. Granice wyznaczają średnie z analizowanych konstruktów, więc „niska wydajność” znaczy „niższa niż pozostałych poprzedników”, a nie „zła” w sensie bezwzględnym.
Analizę można też zrobić na poziomie wskaźników. Wtedy ważność to efekt całkowity pojedynczej pozycji (np. „wiem, jakie są kryteria zaliczenia”), a wydajność – jej średnia na 0–100. Tak wskazuje się bardzo konkretne obszary działań.
Kiedy IPMA ma sens, a kiedy nie?
IPMA najlepiej działa, gdy spełnione są cztery warunki:
- Skale z sensownym zakresem. Wskaźniki mierzone na skalach typu Likerta albo ocenach 0–10 mają naturalne minimum i maksimum, więc wynik 0–100 jest łatwy do wyjaśnienia. Przy zmiennych bez górnej granicy, np. liczbie godzin nauki, wydajność traci interpretację.
- Zmienna docelowa ma praktyczne znaczenie, np. zaangażowanie, satysfakcja albo intencja kontynuowania studiów, a poprzedniki da się zmieniać działaniami.
- Model ma rozsądną moc wyjaśniającą. Gdy R² zmiennej docelowej jest bardzo niskie, różnice ważności są małe i mapa niewiele mówi. Do oceny trafności predykcyjnej służy PLSpredict.
- Porównania grup na tej samej mapie wymagają wcześniej sprawdzenia, czy kompozyty mierzą to samo w grupach (MICOM). Inaczej różnica wydajności może wynikać z różnego pomiaru.
IPMA nie zastępuje testowania hipotez o ścieżkach. To narzędzie do porządkowania priorytetów, które uzupełnia raport z oceny modelu. Pomysł pochodzi z badań satysfakcji klientów, ale w psychologii pasuje do ewaluacji programów, badań klimatu w zespole i ocen jakości kształcenia.
Jak opisać IPMA w pracy
Najpierw opisz ocenę modelu pomiarowego i strukturalnego według przyjętych kryteriów PLS-SEM (Hair i in., 2019). IPMA to analiza dodatkowa, sensowna tylko przy poprawnym modelu. Podaj zmienną docelową, sposób przeskalowania, ważność i wydajność w tabeli albo na mapie oraz wniosek praktyczny. Wzór:
Pamiętaj, że dane są przekrojowe. Ważność to przewidywanie w modelu, a nie dowód, że interwencja zwiększająca jasność wymagań na pewno podniesie zaangażowanie. W rozdziale dyskusji pisz o tym ostrożnie. Pełny przebieg analizy PLS-SEM w R pokazuje wpis PLS-SEM w R: seminr i cSEM.
Przykład w R
Kod tworzy dane z przykładu, szacuje model PLS-SEM w seminr i krok po kroku liczy IPMA: przeskalowanie, niestandaryzowane wagi, wyniki 0–100, wydajność i efekty całkowite. Liczby w tabeli, tekście i na rysunku 1 pochodzą z tego kodu.
IPMA na wynikach seminr
R
# IPMA (importance-performance map analysis) na wynikach PLS-SEM w seminr
library(seminr)

# Dane symulowane: 320 studentów, pozycje na skali 1–7.
# Wsparcie prowadzących (WSP), jasność wymagań (JAS), autonomia (AUT) -> satysfakcja (SAT) -> zaangażowanie (ZAN)
set.seed(111)
n <- 320
WSP <- rnorm(n); JAS <- 0.35 * WSP + rnorm(n, sd = 0.94); AUT <- 0.30 * WSP + rnorm(n, sd = 0.95)
SAT <- 0.35 * WSP + 0.15 * JAS + 0.25 * AUT + rnorm(n, sd = 0.78)
ZAN <- 0.45 * SAT + 0.10 * WSP + 0.30 * JAS + 0.05 * AUT + rnorm(n, sd = 0.78)
pozycje <- function(lv, srodki, nazwa) {
  m <- sapply(srodki, function(s) pmin(pmax(round(s + 1.25 * (0.82 * as.numeric(scale(lv)) + 0.57 * rnorm(n))), 1), 7))
  colnames(m) <- paste0(nazwa, seq_along(srodki)); m
}
dane <- as.data.frame(cbind(pozycje(WSP, c(4.9, 5.1, 4.8), "wsp"), pozycje(JAS, c(3.6, 3.8, 3.5), "jas"),
                            pozycje(AUT, c(4.4, 4.2, 4.5), "aut"), pozycje(SAT, c(4.6, 4.8, 4.7), "sat"),
                            pozycje(ZAN, c(4.3, 4.5, 4.2), "zan")))

mm <- constructs(
  composite("WSP", multi_items("wsp", 1:3)), composite("JAS", multi_items("jas", 1:3)),
  composite("AUT", multi_items("aut", 1:3)), composite("SAT", multi_items("sat", 1:3)),
  composite("ZAN", multi_items("zan", 1:3)))
sm <- relationships(paths(from = c("WSP", "JAS", "AUT"), to = c("SAT", "ZAN")), paths(from = "SAT", to = "ZAN"))
pls <- estimate_pls(data = dane, measurement_model = mm, structural_model = sm)
s <- summary(pls)
round(s$paths, 3)
round(s$total_effects, 3)

# --- IPMA krok po kroku (Ringle i Sarstedt, 2016) ---
# 1. Przeskalowanie wskaźników na 0–100 według teoretycznego zakresu skali (1–7)
d100 <- (dane - 1) / (7 - 1) * 100
# 2. Wagi niestandaryzowane (waga standaryzowana / SD wskaźnika), sumujące się do 1 w każdym konstrukcie
W <- pls$outer_weights
konstrukty <- colnames(W)
wyniki <- sapply(konstrukty, function(k) {
  w <- W[W[, k] != 0, k]
  w_n <- w / apply(dane[, names(w)], 2, sd)
  w_n <- w_n / sum(w_n)
  as.matrix(d100[, names(w)]) %*% w_n          # wynik konstruktu na skali 0–100
})
colnames(wyniki) <- konstrukty
# 3. Wydajność (performance) = średni wynik konstruktu 0–100
wydajnosc <- colMeans(wyniki)
# 4. Ważność (importance) = niestandaryzowany efekt całkowity na ZAN w modelu na wynikach 0–100
w <- as.data.frame(wyniki)
b_sat <- coef(lm(SAT ~ WSP + JAS + AUT, data = w))
b_zan <- coef(lm(ZAN ~ WSP + JAS + AUT + SAT, data = w))
waznosc <- c(WSP = b_zan[["WSP"]] + b_zan[["SAT"]] * b_sat[["WSP"]],
             JAS = b_zan[["JAS"]] + b_zan[["SAT"]] * b_sat[["JAS"]],
             AUT = b_zan[["AUT"]] + b_zan[["SAT"]] * b_sat[["AUT"]],
             SAT = b_zan[["SAT"]])
ipma <- data.frame(konstrukt = names(waznosc), waznosc = round(waznosc, 3),
                   wydajnosc = round(wydajnosc[names(waznosc)], 1))
print(ipma, row.names = FALSE)
cat("Średnia ważność:", round(mean(waznosc), 3), "| średnia wydajność:", round(mean(wydajnosc[names(waznosc)]), 1),
    "| wydajność ZAN:", round(wydajnosc[["ZAN"]], 1), "\n")
# Interpretacja ważności: wzrost wydajności JAS o 10 punktów -> przewidywany wzrost ZAN
cat("Wzrost JAS o 10 pkt -> ZAN +", round(10 * waznosc[["JAS"]], 2), "pkt\n")
saveRDS(ipma, "ipma.rds")
Wynik w R
         SAT   ZAN
R^2    0.197 0.277
AdjR^2 0.190 0.268
WSP    0.240 0.083
JAS    0.157 0.285
AUT    0.235 0.030
SAT        . 0.317
      WSP   JAS   AUT   SAT   ZAN
WSP 0.000 0.000 0.000 0.240 0.159
JAS 0.000 0.000 0.000 0.157 0.335
AUT 0.000 0.000 0.000 0.235 0.104
SAT 0.000 0.000 0.000 0.000 0.317
ZAN 0.000 0.000 0.000 0.000 0.000
 konstrukt waznosc wydajnosc
       WSP   0.161      64.9
       JAS   0.323      44.1
       AUT   0.101      56.4
       SAT   0.319      61.4
Średnia ważność: 0.226 | średnia wydajność: 56.7 | wydajność ZAN: 56.2
Wzrost JAS o 10 pkt -> ZAN + 3.23 pkt
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- seminr (wersja 2.5.0): Ray, S., Danks, N. P., & Calero Valdez, A. (2026). seminr: Building and estimating structural equation models (Version 2.5.0) [R package]. https://doi.org/10.32614/CRAN.package.seminr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- IPMA na niezweryfikowanym modelu. Jeśli model pomiarowy ma słabe ładunki albo problemy z trafnością, ważność i wydajność też będą obciążone.
- Przeskalowanie według minimum i maksimum z próby. Wydajność ma odnosić się do pełnej skali odpowiedzi (1–7), inaczej dwie grupy czy dwa badania nie będą porównywalne.
- Pozycje odwrócone i ujemne wagi. Przed analizą przekoduj pozycje odwrócone. Ujemna waga zewnętrzna sprawia, że wynik 0–100 traci interpretację.
- Standaryzowane efekty jako ważność. IPMA wymaga efektów niestandaryzowanych na wynikach 0–100, bo tylko one wyrażają zmianę w punktach wydajności.
- Ćwiartki traktowane jako sztywne kategorie. Konstrukt tuż przy linii średniej nie różni się istotnie od sąsiada po drugiej stronie. Rozważ przedziały bootstrap dla efektów całkowitych.
- Wnioski przyczynowe z danych przekrojowych. IPMA wskazuje, co warto sprawdzić w interwencji, ale jej nie zastępuje.
Najczęstsze pytania
Jak interpretować mapę IPMA?
Oś pozioma to ważność (efekt całkowity), pionowa – wydajność (średnia 0–100). Linie średnich dzielą mapę na ćwiartki. Konstrukty w prawej dolnej ćwiartce, ważne i słabo oceniane, są priorytetem działań. Te w prawej górnej warto utrzymać, a te w lewej części mają mniejsze znaczenie dla zmiennej docelowej.
Jak obliczyć wydajność w IPMA?
Przeskaluj wskaźniki na 0–100 według teoretycznego zakresu skali, np. dla skali 1–7: (x − 1)/6 × 100. Następnie policz wynik konstruktu jako średnią ważoną z niestandaryzowanymi wagami zewnętrznymi sumującymi się do 1. Wydajność to średnia tego wyniku w próbie.
Co oznacza ważność w IPMA?
Ważność to niestandaryzowany efekt całkowity poprzednika na zmienną docelową w modelu oszacowanym na wynikach 0–100. Wartość 0.32 oznacza, że wzrost wydajności poprzednika o 1 punkt wiąże się ze wzrostem wydajności zmiennej docelowej o 0.32 punktu.
Czy IPMA można zrobić w R, a nie w SmartPLS?
Tak. Wystarczy model PLS-SEM, np. z pakietu seminr, i kilka linii kodu: przeskalowanie wskaźników, niestandaryzowane wagi, wyniki konstruktów 0–100, ich średnie i efekty całkowite z regresji na tych wynikach. Kompletny kod jest na tej stronie.
Jakie warunki musi spełniać model przed IPMA?
Model pomiarowy i strukturalny musi być wcześniej poprawnie oceniony. Wskaźniki powinny mieć tę samą orientację (wyżej = lepiej), więc pozycje odwrócone trzeba przekodować. Wagi zewnętrzne powinny być dodatnie, a zależności w modelu – w przybliżeniu liniowe.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
PLS-SEM krok po kroku: założenia, model pomiarowy i strukturalny
Praktyczny przewodnik po PLS-SEM: kiedy metoda odpowiada pytaniu, jak odróżnić kompozyt od wspólnego czynnika, ocenić model i uczciwie raportować wynik.
Czytaj →PoradnikPLS-SEM w R: kompletny przykład w seminr i cSEM
Odtwarzalny przykład PLS-SEM w R: specyfikacja refleksyjna i kompozytowa, PLSc, bootstrap, HTMT, R², f² i ocena predykcyjna w seminr oraz cSEM.
Czytaj →PoradnikPLS-SEM czy CB-SEM? Porównanie metod i praktyczna decyzja
Neutralne porównanie PLS-SEM i CB-SEM: cel, rodzaj konstruktu, estymacja, dopasowanie, predykcja, próba i raportowanie bez popularnych mitów.
Czytaj →PoradnikModel Kano krok po kroku
Ankieta 400 klientów banku o funkcjach aplikacji: tabela oceny, kategorie, SI i DI z bootstrapem, remisy i segmenty – sześć rysunków z kodem R.
Czytaj →PoradnikKluczowe czynniki satysfakcji
Ankieta gości hotelu: korelacje, β przy współliniowości, wagi względne i dominacja, macierz ważność–ocena i bootstrap rankingu z kodem R.
Czytaj →PoradnikSatysfakcja i lojalność w PLS-SEM
Ankieta 450 kursantów szkoły językowej w modelu w stylu ECSI: diagram ścieżek, pomiar, efekty pośrednie, f² i mapa IPMA – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. https://doi.org/10.1108/ebr-11-2018-0203 ● Otwarty dostęp: pełny tekst
- Martilla, J. A., & James, J. C. (1977). Importance-performance analysis. Journal of Marketing, 41(1), 77–79. https://doi.org/10.1177/002224297704100112
- Ringle, C. M., & Sarstedt, M. (2016). Gain more insight from your PLS-SEM results. Industrial Management & Data Systems, 116(9), 1865–1886. https://doi.org/10.1108/imds-10-2015-0449
Cytowania BibTeX
@article{hair2019when, author={Hair, Joseph F. and Risher, Jeffrey J. and Sarstedt, Marko and Ringle, Christian M.}, title={{When to use and how to report the results of PLS-SEM}}, journal={European Business Review}, year={2019}, volume={31}, number={1}, pages={2--24}, doi={10.1108/ebr-11-2018-0203}}@article{martilla1977importance, author={Martilla, John A. and James, John C.}, title={{Importance-performance analysis}}, journal={Journal of Marketing}, year={1977}, volume={41}, number={1}, pages={77--79}, doi={10.1177/002224297704100112}}@article{ringle2016gain, author={Ringle, Christian M. and Sarstedt, Marko}, title={{Gain more insight from your PLS-SEM results}}, journal={Industrial Management \& Data Systems}, year={2016}, volume={116}, number={9}, pages={1865--1886}, doi={10.1108/imds-10-2015-0449}}