lm() z pakietem boot albo w lavaan, który dodatkowo pokazuje test χ² pominiętych ścieżek.Kiedy mediacja „zależy od”: pytanie o moderowaną mediację
Zwykła mediacja odpowiada na pytanie, przez co X wiąże się z Y. Moderacja odpowiada na pytanie, kiedy i dla kogo ten związek jest silniejszy. W wielu projektach doktorskich i artykułach oba pytania pojawiają się naraz: „obciążenie pracą wiąże się z wyczerpaniem, a przez nie z chęcią odejścia z firmy, ale czy tak samo wtedy, gdy przełożony wspiera pracownika?”. Takie hipotezy nazywa się moderowaną mediacją, a Hayes (2022) opisuje je ogólniej jako warunkową analizę procesu (ang. conditional process analysis).
Ten poradnik zakłada, że znasz już podstawy obu analiz. Jeśli nie, zacznij od wpisów analiza mediacji krok po kroku i analiza moderacji krok po kroku. Tutaj nie powtarzamy logiki efektu pośredniego ani prostych nachyleń. Pokazujemy, jak je połączyć: jak wybrać model PROCESS, jak policzyć warunkowe efekty pośrednie i indeks moderowanej mediacji, jak zrobić to samo w R bez makra (w lm() z pakietem boot oraz w lavaan) i jak opisać wynik w artykule. Poradnik jest pisany dla badaczy i doktorantów, którzy przygotowują analizę do publikacji albo rozprawy.
Zanim zaczniesz, rozróżnij dwa pojęcia, które w recenzjach często się mylą. Muller i in. (2005) definiują moderowaną mediację jako sytuację, w której proces pośredni zależy od moderatora, a mediowaną moderację jako sytuację, w której przez mediator przechodzi sama interakcja. Edwards i Lambert (2007) pokazali, że oba przypadki da się opisać w jednych ramach: moderator może działać na każdą ze ścieżek, które tworzą efekt bezpośredni, pośredni i całkowity. W praktyce pytanie brzmi więc: na którą ścieżkę działa moderator? Od odpowiedzi zależy model.
Krok 1. Wybierz model PROCESS, zanim zobaczysz dane
Hayes (2022) ponumerował szablony modeli w makrze PROCESS. Numery stały się językiem, którym recenzenci i autorzy opisują modele („zastosowano model 7”), dlatego warto je znać, nawet jeśli liczysz w R. Poniższa tabela zestawia modele z jednym mediatorem i jednym moderatorem, które pojawiają się najczęściej. W kolumnie „efekt pośredni” a1, a3, b1 i b3 to współczynniki z równań regresji: indeks 3 oznacza współczynnik przy iloczynie z moderatorem W.
| Model | Gdzie działa W | Równanie M | Równanie Y | Efekt pośredni X → M → Y |
|---|---|---|---|---|
| 4 | nigdzie (zwykła mediacja) | M = aX | Y = c′X + bM | ab |
| 7 | ścieżka a (X → M) | M = a1X + a2W + a3XW | Y = c′X + bM | (a1 + a3W)b |
| 8 | ścieżka a i efekt bezpośredni | jak w modelu 7 | Y = c′1X + c′2W + c′3XW + bM | (a1 + a3W)b |
| 14 | ścieżka b (M → Y) | M = aX | Y = c′X + b1M + b2W + b3MW | a(b1 + b3W) |
| 15 | ścieżka b i efekt bezpośredni | M = aX | jak w modelu 14 + XW | a(b1 + b3W) |
| 58 | ścieżki a i b | jak w modelu 7 | jak w modelu 14 | (a1 + a3W)(b1 + b3W) |
| 59 | ścieżki a, b i efekt bezpośredni | jak w modelu 7 | jak w modelu 58 + XW | (a1 + a3W)(b1 + b3W) |
Model wynika z hipotezy, a nie z tego, który „wyszedł”. Jeśli teoria mówi, że wsparcie przełożonego chroni przed wyczerpaniem przy dużym obciążeniu (bufor stresu), moderator działa na ścieżkę a i właściwy jest model 7. Jeśli teoria mówi, że wsparcie sprawia, że wyczerpany pracownik rzadziej myśli o odejściu, moderator działa na ścieżkę b (model 14). Zapisz to w planie analizy przed zebraniem danych. Rysunek 1 pokazuje trzy modele koncepcyjne, które porównamy na jednych danych.
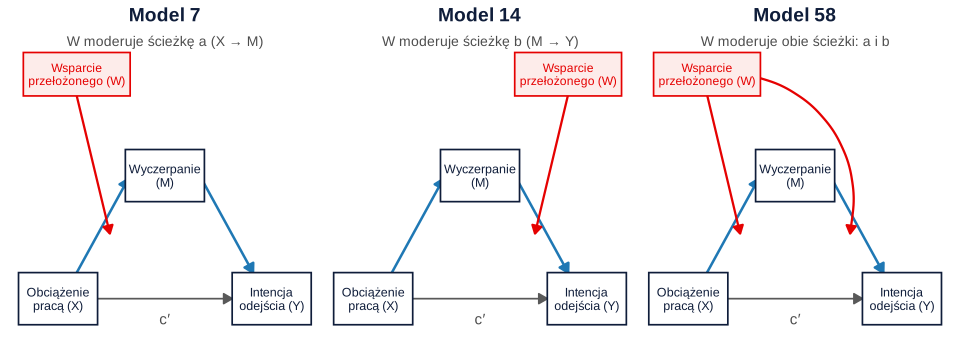
Diagram koncepcyjny to nie diagram statystyczny. W modelu 7 „strzałka do strzałki” oznacza w równaniu dwa dodatkowe predyktory mediatora: W i iloczyn XW. Model 58 jest najbardziej ogólny z trzech, ale nie jest „bezpieczniejszym wyborem na wszelki wypadek”. Ma więcej parametrów, a efekt pośredni zależy w nim od W nieliniowo, więc traci prosty test w postaci jednego indeksu (wrócimy do tego w kroku 7).
Przykład: obciążenie pracą, wyczerpanie i intencja odejścia
Pracujemy na danych symulowanych od 420 pracowników. Mierzymy obciążenie pracą (X; średnia z pozycji, skala 1–5), wsparcie przełożonego (W; 1–5), wyczerpanie emocjonalne (M; 1–7) i intencję odejścia z pracy (Y; 1–7). Staż pracy w latach traktujemy jako kowariant. Hipoteza: obciążenie wiąże się z intencją odejścia pośrednio przez wyczerpanie, a efekt pośredni słabnie wraz ze wzrostem wsparcia, bo wsparcie osłabia związek obciążenia z wyczerpaniem (model 7). Dane możesz pobrać i przeliczyć: moderowana-mediacja-dane.csv.
| Zmienna | M | SD | Zakres | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|---|---|
| 1. Obciążenie pracą (X) | 3.20 | 0.69 | 1.32–5.00 | — | |||
| 2. Wsparcie przełożonego (W) | 3.44 | 0.79 | 1.00–5.00 | −.12 | — | ||
| 3. Wyczerpanie emocjonalne (M) | 3.65 | 1.07 | 1.00–6.47 | .37 | −.29 | — | |
| 4. Intencja odejścia (Y) | 3.00 | 1.18 | 1.00–6.32 | .32 | −.24 | .52 | — |
| 5. Staż pracy (lata) | 7.35 | 4.80 | 0.30–25.80 | .02 | .00 | .04 | −.11 |
Korelacje są zgodne z hipotezą, ale nie mówią nic o moderacji. Interakcja może być silna przy zerowej korelacji W z X, a słaba przy wysokiej. Pełną macierz w układzie APA przygotujesz według wzoru tabeli korelacji APA.
Krok 2. Przygotuj zmienne: centrowanie, kowarianty i braki
Centrowanie. Odejmij średnią od X i od W, a iloczyn policz z wycentrowanych zmiennych (centrowanie zmiennych). Dalal i Zickar (2012) pokazują, że centrowanie nie zmienia współczynnika przy iloczynie, dopasowania modelu ani mocy testu interakcji. Zmienia tylko współczynniki niższego rzędu i to jest jego zaleta. Po centrowaniu a1 to efekt obciążenia przy przeciętnym wsparciu, a nie przy wsparciu równym zeru, którego na skali 1–5 nikt nie ma. Centrowanie nie jest lekarstwem na współliniowość istotną merytorycznie i nie wpływa na indeks moderowanej mediacji.
Mediator. W modelu 7 mediatora nie musisz centrować, bo nie wchodzi do żadnego iloczynu. W modelach 14 i 58 centruj go tak samo jak X i W. Wtedy b1 to związek M z Y przy przeciętnym W.
Kowarianty. Staż może wiązać się zarówno z wyczerpaniem, jak i z intencją odejścia, dlatego wchodzi do obu równań, mediatora i wyniku. Kowariant dodany tylko do jednego równania zmienia znaczenie efektów i trzeba to uzasadnić.
Braki danych. W przykładzie braków nie ma. W prawdziwym badaniu usuwanie przypadków zmniejsza próbę i może obciążać wyniki. Rozważ imputację wielokrotną albo FIML w lavaan (krok 6). Procedurę opisuje wpis braki danych i imputacja wielokrotna w R.
Krok 3. Oszacuj dwa równania regresji
Model 7 to dwie regresje wielorakie metodą najmniejszych kwadratów. Tak liczy je też PROCESS, bo opiera się na regresji MNK (Hayes, 2022). W R wystarczy lm():
- Równanie mediatora:
lm(m ~ x * w + staz). Wyjaśniło 25.3% wariancji wyczerpania, F(4, 415) = 35.15, p < .001. Obciążenie wiązało się z wyczerpaniem przy przeciętnym wsparciu, a1 = 0.55, SE = 0.07, t(415) = 8.26, p < .001. Iloczyn był ujemny, a3 = −0.47, SE = 0.08, t(415) = −5.64, p < .001, 95% CI [−0.64, −0.31]: każdy punkt wsparcia więcej zmniejsza nachylenie obciążenia o 0.47 punktu wyczerpania. - Równanie wyniku:
lm(y ~ m + x + staz). Wyjaśniło 30.9% wariancji, F(3, 416) = 62.02, p < .001. Wyczerpanie wiązało się z intencją odejścia, b = 0.52, SE = 0.05, t(416) = 10.73, p < .001. Efekt bezpośredni obciążenia pozostał istotny, c′ = 0.26, SE = 0.08, t(416) = 3.44, p < .001. Dłuższy staż wiązał się z nieco mniejszą intencją odejścia, b = −0.03, p = .001.
Nie interpretuj a2 = −0.36 jako „efektu głównego” wsparcia w sensie ANOVA. To związek wsparcia z wyczerpaniem przy przeciętnym obciążeniu (X = 0 po centrowaniu). Igartua i Hayes (2021) wymieniają błędne czytanie współczynników w modelu z iloczynem wśród najczęstszych nieporozumień. Szerzej o tym piszemy w haśle efekt interakcji.
Na tym etapie masz już wszystkie składniki: efekt pośredni w modelu 7 to (a1 + a3W) × b. Brakuje tylko przedziałów ufności.
Krok 4. Warunkowe efekty pośrednie i indeks moderowanej mediacji
Indeks moderowanej mediacji to współczynnik kierunkowy funkcji, która łączy efekt pośredni z moderatorem. W modelu 7 równa się a3b. Hayes (2015) zaproponował go jako formalny test: jeśli przedział ufności indeksu nie obejmuje zera, efekt pośredni zależy od moderatora. Iloczyn dwóch współczynników nie ma rozkładu normalnego, dlatego przedziały wyznaczamy bootstrapem. Preacher i in. (2007) zalecali bootstrap zamiast asymptotycznych błędów standardowych. Hayes i Scharkow (2013) uznali przedział percentylowy za dobry kompromis między mocą a kontrolą błędu I rodzaju. W symulacjach Biesanza i in. (2010) przedział BCa miał zawyżony błąd I rodzaju, a percentylowy wypadł najlepiej z metod bootstrapowych. Stosujemy 5000 prób i przedział percentylowy.
Funkcja efekty7() z sekcji z kodem w każdej próbie bootstrapowej losuje osoby ze zwracaniem, szacuje oba równania i zwraca indeks oraz efekty warunkowe. Wynik:
- Indeks moderowanej mediacji: −0.25, bootstrapowe SE = 0.05, 95% CI [−0.36, −0.15]. Przedział nie obejmuje zera; żadna z 5000 prób nie dała indeksu ≥ 0. Każdy punkt wsparcia więcej zmniejsza efekt pośredni o około 0.25 punktu intencji odejścia na punkt obciążenia.
- Efekt pośredni przy niskim wsparciu (16. percentyl, W = 2.72): 0.46, 95% CI [0.34, 0.60].
- Przy medianie (W = 3.45): 0.28, 95% CI [0.20, 0.37].
- Przy wysokim wsparciu (84. percentyl, W = 4.23): 0.09, 95% CI [−0.01, 0.18].
Dla porównania: efekt całkowity obciążenia na intencję odejścia (z kontrolą stażu) wyniósł 0.55, SE = 0.08, p < .001. Przy niskim wsparciu większa jego część przechodzi przez wyczerpanie niż przy wysokim.
Najważniejsze zdanie tego poradnika: o moderowanej mediacji świadczy przedział indeksu, a nie porównanie istotności efektów warunkowych. To, że efekt jest „istotny” przy niskim wsparciu, a „nieistotny” przy wysokim, nie jest testem różnicy między nimi. Gdyby indeks miał przedział obejmujący zero, taki układ efektów warunkowych niczego by nie dowodził.
Krok 5. Sonduj efekty warunkowe w całym zakresie moderatora
Wartości W, przy których podajesz efekty warunkowe, są umowne. Stosuje się dwie konwencje: średnią ±1 odchylenie standardowe albo 16., 50. i 84. percentyl. Percentyle mają tę zaletę, że zawsze leżą w zakresie danych, także przy skośnym moderatorze. Przy rozkładzie zbliżonym do normalnego obie konwencje dają podobne wartości: −1 SD, średnia i +1 SD wsparcia to 2.65, 3.44 i 4.22, a efekty pośrednie wynoszą 0.48, 95% CI [0.35, 0.62], 0.29, 95% CI [0.20, 0.37], i 0.09, 95% CI [−0.01, 0.18]. Podaj w metodzie, którą konwencję wybrałeś.
Lepiej jednak pokazać cały zakres. Bauer i Curran (2005) uogólnili technikę Johnsona–Neymana, która wyznacza wartości moderatora, przy których efekt jest istotny. Preacher i in. (2007) przenieśli ten pomysł na warunkowe efekty pośrednie. Dla efektu pośredniego wystarczy policzyć go z tych samych prób bootstrapowych przy kolejnych wartościach W i odczytać percentyle (panel B rysunku 2).
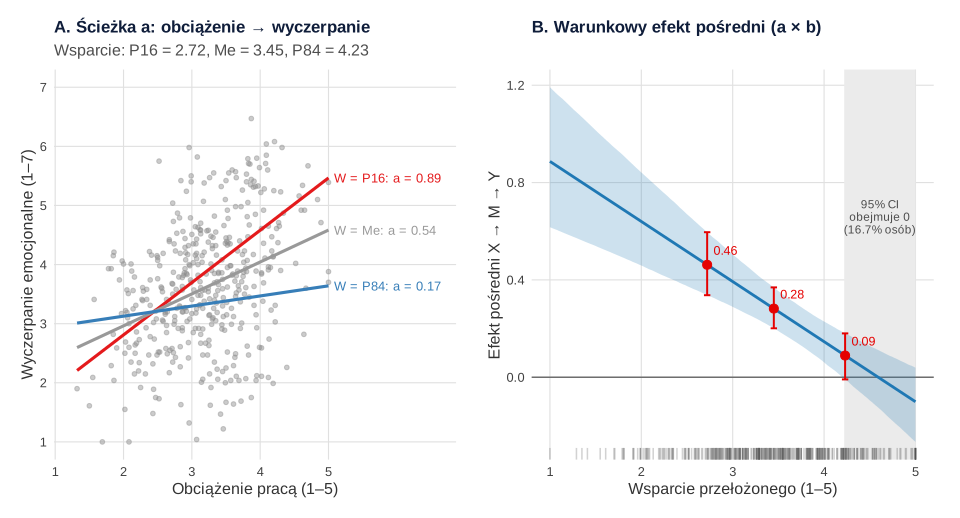
Panel A pokazuje źródło moderacji. Proste nachylenie obciążenia wynosiło 0.89 (SE = 0.09, p < .001) przy niskim wsparciu, 0.54 (SE = 0.07, p < .001) przy medianie i 0.17 (SE = 0.09, p = .059) przy wysokim. Przedział Johnsona–Neymana dla ścieżki a ma dolną granicę 4.22: poniżej tej wartości wsparcia obciążenie istotnie wiąże się z wyczerpaniem. Górna granica (5.27) leży poza skalą, więc jej nie interpretuj. Powyżej 4.22 znalazło się 16.9% badanych.
Panel B pokazuje efekt pośredni. Pasmo 95% przestaje wykluczać zero przy wsparciu 4.22, co dotyczy 16.7% osób w próbie. Linia efektu przecina zero dopiero przy wsparciu 4.59, a niemal cały zakres skali leży po stronie efektów dodatnich. Wniosek nie brzmi „przy wysokim wsparciu mediacji nie ma”. Brzmi: przy najwyższym wsparciu efekt pośredni jest mały i oszacowany zbyt nieprecyzyjnie, by odróżnić go od zera. Obie granice wyszły tu prawie identyczne, ale to zbieg okoliczności. Granica dla efektu pośredniego uwzględnia też niepewność ścieżki b i zwykle różni się od granicy dla samej ścieżki a.
Krok 6. Ten sam model w lavaan
Model 7 to model ścieżkowy z obserwowalnym iloczynem XW, więc da się go zapisać w lavaan (Rosseel, 2012). Ścieżki dostają etykiety, a efekty warunkowe i indeks definiuje się operatorem :=. Argument se = "bootstrap" daje bootstrapowe błędy standardowe, a parameterEstimates(..., boot.ci.type = "perc") przedziały percentylowe.
Oszacowania punktowe są identyczne jak w lm(): a1 = 0.547, a3 = −0.473, b = 0.522, c′ = 0.258, indeks = −0.247. Przy wspólnej strukturze modelu ML i MNK dają tu te same współczynniki. Przedziały różnią się tylko w trzecim miejscu po przecinku, bo to inne losowania bootstrapowe: indeks 95% CI [−0.351, −0.153], efekt przy 84. percentylu [−0.007, 0.177]. Różnice tej wielkości są normalne, dlatego w artykule podaj liczbę prób i ziarno generatora (set.seed()), a kod umieść w pakiecie replikacyjnym.
lavaan daje coś, czego nie pokazują dwie osobne regresje: test χ² całego modelu. Model 7 zakłada, że W i XW nie wpływają na Y bezpośrednio. To dwa ograniczenia, stąd df = 2. W przykładzie test je odrzucił: χ²(2) = 8.05, p = .018. To sygnał, że wsparcie może wiązać się z intencją odejścia także poza wyczerpaniem. Nie zmieniaj modelu po cichu. Pokaż analizę wrażliwości, czyli model 7 z wsparciem dodanym do równania Y. W tym wariancie wsparcie wiązało się z intencją odejścia, b = −0.14, SE = 0.06, p = .025. Indeks wyniósł −0.23, 95% CI [−0.34, −0.14], a efekty pośrednie przy 16., 50. i 84. percentylu 0.44, 0.27 i 0.08, z przedziałem przy 84. percentylu [−0.01, 0.17]. Wniosek o moderowanej mediacji się nie zmienia.
lavaan przydaje się też wtedy, gdy masz braki danych (missing = "fiml") albo kilka mediatorów. Moderowana mediacja ze zmiennymi latentnymi wymaga interakcji zmiennych latentnych, a to osobny, trudniejszy temat. Jeśli zostajesz przy wynikach skal, opisz ich rzetelność. Błąd pomiaru osłabia interakcje.
Krok 7. Modele 14, 58 i 8 na tych samych danych
Żeby zobaczyć, jak bardzo wnioski zależą od wyboru modelu, policzyliśmy na tych samych danych trzy alternatywy. To ćwiczenie dydaktyczne. W prawdziwym badaniu model wybierasz z góry, a alternatywy raportujesz jako analizy dodatkowe, jasno oznaczone.
- Model 14 (W moderuje ścieżkę b): ścieżka a bez moderacji wyniosła 0.57, a iloczyn M × W w równaniu Y był bliski zera, b3 = 0.05, SE = 0.06, p = .366. Indeks ab3 = 0.03, 95% CI [−0.03, 0.09], nie wskazuje moderowanej mediacji. Efekty warunkowe są prawie równe: 0.26, 0.28 i 0.31.
- Model 58 (W moderuje obie ścieżki): efekty pośrednie przy 16., 50. i 84. percentylu wyniosły 0.41, 95% CI [0.28, 0.55], 0.27, 95% CI [0.19, 0.36], i 0.09, 95% CI [−0.01, 0.19]. Obraz jest podobny jak w modelu 7, bo b3 jest bliskie zera. Efekt pośredni (a1 + a3W)(b1 + b3W) jest jednak funkcją kwadratową W, a indeks Hayesa (2015) opisuje tylko zależność liniową. Wnioskuj więc z porównań efektów warunkowych między wybranymi wartościami W, z przedziałem bootstrapowym dla ich różnicy.
- Model 8 (W moderuje ścieżkę a i efekt bezpośredni): iloczyn XW w równaniu Y nie był istotny, c′3 = −0.16, SE = 0.09, p = .088. Część danych wskazuje więc, że wsparcie może osłabiać także bezpośredni związek obciążenia z intencją odejścia, ale oszacowanie jest nieprecyzyjne.
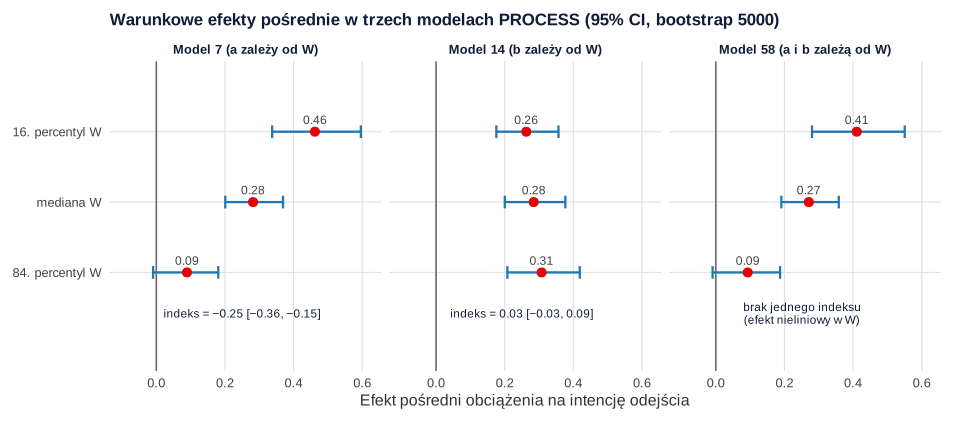
Rysunek 3 dobrze pokazuje ryzyko „przeszukiwania modeli”. Gdyby autor nie miał hipotezy, mógłby policzyć wszystkie trzy i wybrać ten z najładniejszym wynikiem. Taka praktyka zawyża błąd I rodzaju tak samo jak każde inne wielokrotne testowanie. Jeżeli teoria dopuszcza moderację obu ścieżek, zaplanuj model 58 z góry i przyjmij, że do wnioskowania użyjesz porównań efektów warunkowych, a nie jednego indeksu.
PROCESS w R, w SPSS i własny kod
PROCESS jest dostępny dla SPSS, SAS i R (Igartua i Hayes, 2021). Ten poradnik celowo liczy wszystko „ręcznie”, z dwóch powodów. Po pierwsze, widzisz, z czego składa się każdy efekt, więc łatwiej odpowiesz na pytanie recenzenta. Po drugie, ten sam kod łatwo rozszerzyć: o analizę wrażliwości, inny kowariant w jednym równaniu, FIML albo kontrast efektów warunkowych. Jeśli korzystasz z PROCESS, wyniki powinny zgadzać się z lm() co do współczynników. Przedziały bootstrapowe będą się nieznacznie różnić, bo zależą od losowania. W metodzie podaj wersję makra, numer modelu, liczbę prób i rodzaj przedziału.
Moderator nie musi być ciągły. Przy moderatorze dwuwartościowym (np. typ umowy) efekty warunkowe liczy się dla obu grup, a przy kodowaniu 0/1 indeks jest po prostu różnicą efektów pośrednich między grupami. Nie dziel natomiast ciągłego moderatora medianą, żeby „zrobić grupy” (zob. dzielenie medianą). Tracisz informację i moc, a granica podziału jest arbitralna.
Jak opisać moderowaną mediację w artykule (APA)
W części „Metoda” podaj model (numer PROCESS i równania albo diagram), centrowanie, kowarianty, liczbę prób bootstrapowych, rodzaj przedziału i wartości W, przy których sondowałeś efekty. W „Wynikach” podaj tabelę obu równań, indeks z przedziałem i efekty warunkowe. Wzór tabeli mediacji znajdziesz w tabeli mediacji w APA. Poniżej wersja rozszerzona o moderację.
Tabela 1
Moderowana mediacja związku obciążenia pracą z intencją odejścia przez wyczerpanie emocjonalne: model 7 (N = 420)
| Predyktor | b | SE | t | p | 95% CI |
|---|---|---|---|---|---|
| Wynik: wyczerpanie emocjonalne (M), R² = .25 | |||||
| Obciążenie pracą (X) | 0.55 | 0.07 | 8.26 | < .001 | [0.42, 0.68] |
| Wsparcie przełożonego (W) | −0.36 | 0.06 | −6.18 | < .001 | [−0.47, −0.25] |
| X × W | −0.47 | 0.08 | −5.64 | < .001 | [−0.64, −0.31] |
| Staż pracy | 0.01 | 0.01 | 0.87 | .387 | [−0.01, 0.03] |
| Wynik: intencja odejścia (Y), R² = .31 | |||||
| Wyczerpanie emocjonalne (M) | 0.52 | 0.05 | 10.73 | < .001 | [0.43, 0.62] |
| Obciążenie pracą (X) | 0.26 | 0.08 | 3.44 | < .001 | [0.11, 0.41] |
| Staż pracy | −0.03 | 0.01 | −3.31 | .001 | [−0.05, −0.01] |
| Efekty pośrednie X → M → Y (bootstrap) | |||||
| Wsparcie = 2.72 (16. percentyl) | 0.46 | 0.07 | — | — | [0.34, 0.60] |
| Wsparcie = 3.45 (mediana) | 0.28 | 0.04 | — | — | [0.20, 0.37] |
| Wsparcie = 4.23 (84. percentyl) | 0.09 | 0.05 | — | — | [−0.01, 0.18] |
| Indeks moderowanej mediacji | −0.25 | 0.05 | — | — | [−0.36, −0.15] |
Uwaga. Współczynniki niestandaryzowane z regresji MNK; obciążenie i wsparcie wycentrowane względem średniej. Przedziały dla współczynników regresji – klasyczne; dla efektów pośrednich i indeksu – bootstrap percentylowy (5000 prób), SE – bootstrapowe. Dane symulowane.
Wzór opisu (metoda i wyniki):
W dyskusji pisz o zależności efektu pośredniego od wsparcia, a nie o tym, że „wsparcie zapobiega odejściom”. Dane przekrojowe nie pokazują kolejności zdarzeń (zob. błędy niżej). Gotowe odpowiedzi na typowe uwagi recenzentów, np. „dlaczego nie Sobel?” albo „skąd wiadomo, że to nie mediowana moderacja?”, zbiera wpis zarzuty recenzentów do statystyki. Jeśli przygotowujesz taki model do artykułu albo rozprawy i chcesz, by ktoś sprawdził specyfikację i opis, zajrzyj do oferty dla badaczy.
Moderowana mediacja w R – pełny kod
Sześć przepisów odtwarza całą analizę, od danych symulowanych po analizę wrażliwości. Uruchamiaj je po kolei w jednej sesji R, w folderze z plikiem CSV, bo kolejne przepisy korzystają z obiektów utworzonych wcześniej (np. dane, w_sond, bt7). Wszystkie liczby w tekście, tabelach i na rysunkach pochodzą z tego kodu. Bootstrap w lavaan trwa około minuty.
1. Dane symulowane (plik CSV)
R
# Dane symulowane: 420 pracowników. X = obciążenie pracą (1–5), W = wsparcie przełożonego (1–5),
# M = wyczerpanie emocjonalne (1–7), Y = intencja odejścia z pracy (1–7), staż pracy w latach (kowariant)
set.seed(83)
n <- 420
staz        <- round(pmin(rgamma(n, shape = 2.2, scale = 3.2), 35), 1)
obciazenie  <- pmin(pmax(round(rnorm(n, 3.2, 0.70), 2), 1), 5)
wsparcie    <- pmin(pmax(round(rnorm(n, 3.4, 0.85) - 0.15 * (obciazenie - 3.2), 2), 1), 5)
xc <- obciazenie - 3.2; wc <- wsparcie - 3.4
wyczerpanie <- pmin(pmax(round(3.6 + 0.60 * xc - 0.30 * wc - 0.35 * xc * wc + 0.02 * (staz - 7) +
                                 rnorm(n, 0, 0.90), 2), 1), 7)
odejscie    <- pmin(pmax(round(3.0 + 0.55 * (wyczerpanie - 3.6) + 0.15 * xc - 0.15 * wc - 0.03 * (staz - 7) +
                                 rnorm(n, 0, 1.00), 2), 1), 7)
dane <- data.frame(id = 1:n, obciazenie, wsparcie, wyczerpanie, odejscie, staz)
write.csv(dane, "moderowana-mediacja-dane.csv", row.names = FALSE)
str(read.csv("moderowana-mediacja-dane.csv"))         # kontrola zapisanego pliku
Wynik w R
'data.frame':	420 obs. of  6 variables:
 $ id         : int  1 2 3 4 5 6 7 8 9 10 ...
 $ obciazenie : num  3.3 3.45 3.57 2.97 2.28 3.7 3.32 4.05 1.82 3.71 ...
 $ wsparcie   : num  3.58 2.85 4.25 3.35 4.23 2.59 1.71 2.49 3.62 4.59 ...
 $ wyczerpanie: num  3.08 3.59 2.04 3.08 3.61 4.4 5.55 4.92 2.29 2.92 ...
 $ odejscie   : num  1 1.62 2.67 3.56 4.44 5.44 2.64 4.77 2.09 1.75 ...
 $ staz       : num  20.7 4.7 2.1 13.3 1 8.6 6.6 2.2 4.6 13.8 ...
2. Statystyki opisowe, korelacje i centrowanie
R
# Statystyki opisowe, korelacje i centrowanie predyktorów
dane <- read.csv("moderowana-mediacja-dane.csv")
zm <- c("obciazenie", "wsparcie", "wyczerpanie", "odejscie", "staz")
round(sapply(dane[zm], function(v) c(M = mean(v), SD = sd(v), min = min(v), max = max(v))), 2)
round(cor(dane[zm]), 2)
# centrowanie względem średniej: X i W (iloczyn liczymy z wycentrowanych zmiennych)
dane$x  <- dane$obciazenie - mean(dane$obciazenie)
dane$w  <- dane$wsparcie   - mean(dane$wsparcie)
dane$m  <- dane$wyczerpanie
dane$y  <- dane$odejscie
dane$xw <- dane$x * dane$w
c(M_obciazenie = mean(dane$obciazenie), M_wsparcie = mean(dane$wsparcie), SD_wsparcie = sd(dane$wsparcie))
Wynik w R
    obciazenie wsparcie wyczerpanie odejscie  staz
M         3.20     3.44        3.65     3.00  7.35
SD        0.69     0.79        1.07     1.18  4.80
min       1.32     1.00        1.00     1.00  0.30
max       5.00     5.00        6.47     6.32 25.80
            obciazenie wsparcie wyczerpanie odejscie  staz
obciazenie        1.00    -0.12        0.37     0.32  0.02
wsparcie         -0.12     1.00       -0.29    -0.24  0.00
wyczerpanie       0.37    -0.29        1.00     0.52  0.04
odejscie          0.32    -0.24        0.52     1.00 -0.11
staz              0.02     0.00        0.04    -0.11  1.00
M_obciazenie   M_wsparcie  SD_wsparcie
   3.2029762    3.4360238    0.7852213
3. Model 7: dwa równania MNK i bootstrap
R
# Model 7 (PROCESS): moderacja ścieżki a. Dwa równania regresji MNK i bootstrap percentylowy
mod_m <- lm(m ~ x * w + staz, data = dane)            # równanie mediatora
mod_y <- lm(y ~ m + x + staz, data = dane)            # równanie wyniku
round(summary(mod_m)$coefficients, 3); round(summary(mod_m)$r.squared, 3)
round(summary(mod_y)$coefficients, 3); round(summary(mod_y)$r.squared, 3)
round(confint(mod_m), 3); round(confint(mod_y), 3)

# wartości moderatora do sondowania: percentyle 16, 50 i 84 oraz −1 SD, M, +1 SD (w jednostkach wycentrowanych)
w_pct <- quantile(dane$w, c(.16, .50, .84), names = FALSE)
w_sd  <- c(-1, 0, 1) * sd(dane$w)
w_sond <- c(w_pct, w_sd)
round(w_sond + mean(dane$wsparcie), 2)                # te same wartości na skali 1–5

efekty7 <- function(d, i = seq_len(nrow(d))) {
  d <- d[i, ]
  a <- coef(lm(m ~ x * w + staz, data = d))
  b <- coef(lm(y ~ m + x + staz, data = d))
  c(indeks = unname(a["x:w"] * b["m"]),
    warunkowe = unname((a["x"] + a["x:w"] * w_sond) * b["m"]),
    a1 = unname(a["x"]), a3 = unname(a["x:w"]), b = unname(b["m"]), c_prim = unname(b["x"]))
}
oszac <- efekty7(dane); round(oszac, 3)
library(boot)
set.seed(2026)
bt7 <- boot(dane, efekty7, R = 5000)
ci7 <- t(sapply(seq_along(oszac), function(k) boot.ci(bt7, type = "perc", index = k)$percent[4:5]))
tab7 <- data.frame(efekt = c("indeks", paste0("pct", c(16, 50, 84)), "minus1SD", "M", "plus1SD", "a1", "a3", "b", "c_prim"),
                   oszacowanie = round(oszac, 3), BootSE = round(apply(bt7$t, 2, sd), 3),
                   CI_dolna = round(ci7[, 1], 3), CI_gorna = round(ci7[, 2], 3), row.names = NULL)
tab7
Wynik w R
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    3.558      0.083  42.893    0.000
x              0.547      0.066   8.263    0.000
w             -0.359      0.058  -6.182    0.000
staz           0.008      0.009   0.867    0.387
x:w           -0.473      0.084  -5.640    0.000
[1] 0.253
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    1.336      0.196   6.818    0.000
m              0.522      0.049  10.735    0.000
x              0.258      0.075   3.435    0.001
staz          -0.033      0.010  -3.309    0.001
[1] 0.309
             2.5 % 97.5 %
(Intercept)  3.395  3.721
x            0.417  0.677
w           -0.474 -0.245
staz        -0.010  0.027
x:w         -0.638 -0.308
             2.5 % 97.5 %
(Intercept)  0.951  1.721
m            0.426  0.618
x            0.110  0.405
staz        -0.053 -0.013
[1] 2.72 3.45 4.23 2.65 3.44 4.22
    indeks warunkowe1 warunkowe2 warunkowe3 warunkowe4 warunkowe5 warunkowe6
    -0.247      0.462      0.282      0.089      0.479      0.285      0.092
        a1         a3          b     c_prim
     0.547     -0.473      0.522      0.258
      efekt oszacowanie BootSE CI_dolna CI_gorna
1    indeks      -0.247  0.052   -0.356   -0.151
2     pct16       0.462  0.066    0.337    0.596
3     pct50       0.282  0.043    0.201    0.369
4     pct84       0.089  0.047   -0.009    0.180
5  minus1SD       0.479  0.069    0.349    0.619
6         M       0.285  0.043    0.204    0.373
7   plus1SD       0.092  0.047   -0.007    0.182
8        a1       0.547  0.066    0.412    0.673
9        a3      -0.473  0.085   -0.644   -0.306
10        b       0.522  0.047    0.428    0.616
11   c_prim       0.258  0.075    0.110    0.406
4. Ten sam model w lavaan
R
# Ten sam model 7 w lavaan: parametry zdefiniowane (:=) i bootstrap
library(lavaan)
w_lo <- w_sond[1]; w_hi <- w_sond[3]                   # percentyl 16 i 84
model7 <- paste0('
  m ~ a1*x + a2*w + a3*xw + staz
  y ~ b*m + cp*x + staz
  indeks  := a3*b
  ind_p16 := (a1 + a3*(', w_lo, '))*b
  ind_p50 := (a1 + a3*(', w_sond[2], '))*b
  ind_p84 := (a1 + a3*(', w_hi, '))*b
')
set.seed(2026)
fit7 <- sem(model7, data = dane, se = "bootstrap", bootstrap = 5000)
pe <- parameterEstimates(fit7, boot.ci.type = "perc")
pe[pe$label != "", c("label", "est", "se", "ci.lower", "ci.upper")] |> transform(est = round(est, 3), se = round(se, 3),
  ci.lower = round(ci.lower, 3), ci.upper = round(ci.upper, 3))
round(fitMeasures(fit7, c("chisq", "df", "pvalue")), 3)  # test ograniczeń: brak ścieżek W → Y i XW → Y
Wynik w R
This is lavaan 0.7-2
lavaan is FREE software! Please report any bugs.
     label    est    se ci.lower ci.upper
1       a1  0.547 0.064    0.418    0.671
2       a2 -0.359 0.055   -0.468   -0.251
3       a3 -0.473 0.084   -0.640   -0.311
5        b  0.522 0.047    0.429    0.610
6       cp  0.258 0.077    0.110    0.413
20  indeks -0.247 0.051   -0.351   -0.153
21 ind_p16  0.462 0.065    0.339    0.593
22 ind_p50  0.282 0.042    0.202    0.366
23 ind_p84  0.089 0.047   -0.007    0.177
 chisq     df pvalue
 8.053  2.000  0.018
5. Modele 14, 58 i 8 na tych samych danych
R
# Alternatywne modele na tych samych danych: model 14 (moderacja ścieżki b) i model 58 (obie ścieżki)
dane$mw <- (dane$m - mean(dane$m)) * dane$w           # iloczyn wycentrowanego mediatora i moderatora
m14_y <- lm(y ~ m * w + x + staz, data = transform(dane, m = m - mean(m)))
round(summary(m14_y)$coefficients, 3)
m58_y <- lm(y ~ m * w + x + staz, data = transform(dane, m = m - mean(m)))   # w modelu 58 równanie Y jest takie samo jak w 14
# model 58: równanie M z interakcją X × W (jak w modelu 7) + równanie Y z interakcją M × W
efekty58 <- function(d, i = seq_len(nrow(d)), w_val = w_sond[1:3]) {
  d <- d[i, ]; d$mc <- d$m - mean(d$m)
  a <- coef(lm(m ~ x * w + staz, data = d))
  b <- coef(lm(y ~ mc * w + x + staz, data = d))
  unname((a["x"] + a["x:w"] * w_val) * (b["mc"] + b["mc:w"] * w_val))
}
round(efekty58(dane), 3)
set.seed(2026)
bt58 <- boot(dane, efekty58, R = 5000)
round(t(sapply(1:3, function(k) boot.ci(bt58, type = "perc", index = k)$percent[4:5])), 3)
# model 14: a bez moderacji, b zależne od W
efekty14 <- function(d, i = seq_len(nrow(d))) {
  d <- d[i, ]; d$mc <- d$m - mean(d$m)
  a <- coef(lm(m ~ x + staz, data = d))["x"]
  b <- coef(lm(y ~ mc * w + x + staz, data = d))
  c(indeks = unname(a * b["mc:w"]), unname(a * (b["mc"] + b["mc:w"] * w_sond[1:3])))
}
round(efekty14(dane), 3)
set.seed(2026)
bt14 <- boot(dane, efekty14, R = 5000)
round(t(sapply(1:4, function(k) boot.ci(bt14, type = "perc", index = k)$percent[4:5])), 3)
# model 8: W moderuje ścieżkę a i efekt bezpośredni (X × W także w równaniu Y)
m8_y <- lm(y ~ m + x * w + staz, data = dane)
round(summary(m8_y)$coefficients, 3)
Wynik w R
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    3.253      0.089  36.599    0.000
m              0.501      0.051   9.806    0.000
w             -0.138      0.064  -2.149    0.032
x              0.263      0.075   3.492    0.001
staz          -0.033      0.010  -3.318    0.001
m:w            0.052      0.058   0.905    0.366
[1] 0.411 0.271 0.093
       [,1]  [,2]
[1,]  0.280 0.550
[2,]  0.191 0.358
[3,] -0.009 0.187
indeks
 0.030  0.263  0.284  0.307
       [,1]  [,2]
[1,] -0.028 0.088
[2,]  0.176 0.357
[3,]  0.200 0.377
[4,]  0.208 0.419
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    1.514      0.205   7.403    0.000
m              0.469      0.052   9.024    0.000
x              0.276      0.076   3.653    0.000
w             -0.160      0.064  -2.483    0.013
staz          -0.032      0.010  -3.243    0.001
x:w           -0.158      0.092  -1.713    0.088
6. Proste nachylenia, Johnson–Neyman i analiza wrażliwości
R
# Liczby pomocnicze: proste nachylenia ścieżki a, przedział Johnsona–Neymana,
# zakres W, w którym 95% CI efektu pośredniego nie obejmuje zera, i analiza wrażliwości (W w równaniu Y)
library(interactions)
sim_slopes(mod_m, pred = x, modx = w, modx.values = w_sond[1:3], johnson_neyman = FALSE, digits = 3)
jn <- johnson_neyman(mod_m, pred = x, modx = w, alpha = .05, plot = FALSE)
round(jn$bounds + mean(dane$wsparcie), 2)              # granice J–N na skali wsparcia 1–5
mean(dane$w > jn$bounds[1])                            # odsetek osób powyżej dolnej granicy J–N

# pasmo 95% CI warunkowego efektu pośredniego z draws bootstrapu (kolumny a1, a3, b)
siatka <- seq(min(dane$w), max(dane$w), length.out = 201)
draws <- bt7$t[, 8:10]; colnames(draws) <- c("a1", "a3", "b")
pasmo <- t(sapply(siatka, function(v) {
  e <- (draws[, "a1"] + draws[, "a3"] * v) * draws[, "b"]
  c(w = v, est = unname((oszac["a1"] + oszac["a3"] * v) * oszac["b"]), quantile(e, c(.025, .975), names = FALSE))
}))
colnames(pasmo) <- c("w", "est", "lo", "hi")
granica <- min(pasmo[pasmo[, "lo"] <= 0, "w"])       # najmniejsze W, przy którym dolna granica CI ≤ 0
round(granica + mean(dane$wsparcie), 2); round(mean(dane$w >= granica), 3)
round(-oszac["a1"] / oszac["a3"] + mean(dane$wsparcie), 2)   # W, przy którym efekt pośredni = 0
round(range(dane$wsparcie), 2)

# analiza wrażliwości: model 7 z wsparciem także w równaniu Y
mod_y_w <- lm(y ~ m + x + w + staz, data = dane)
round(summary(mod_y_w)$coefficients, 3)
efekty7w <- function(d, i = seq_len(nrow(d))) {
  d <- d[i, ]
  a <- coef(lm(m ~ x * w + staz, data = d)); b <- coef(lm(y ~ m + x + w + staz, data = d))
  c(indeks = unname(a["x:w"] * b["m"]), unname((a["x"] + a["x:w"] * w_sond[1:3]) * b["m"]))
}
round(efekty7w(dane), 3)
set.seed(2026)
bt7w <- boot(dane, efekty7w, R = 5000)
round(t(sapply(1:4, function(k) boot.ci(bt7w, type = "perc", index = k)$percent[4:5])), 3)
# efekt całkowity X na Y (dla kontekstu) i liczba prób bootstrapu z dodatnim indeksem
round(summary(lm(y ~ x + staz, data = dane))$coefficients["x", ], 3)
sum(bt7$t[, 1] >= 0)
# dokładne wartości p i stopnie swobody (do zapisu APA)
signif(summary(mod_m)$coefficients[, 4], 3); summary(mod_m)$df[2]
signif(summary(mod_y)$coefficients[, 4], 3); summary(mod_y)$df[2]
signif(summary(m14_y)$coefficients[, 4], 3); signif(summary(m8_y)$coefficients[, 4], 3)
round(coef(lm(m ~ x + staz, data = dane))["x"], 3)    # ścieżka a w modelu 14 (bez moderacji)
round(summary(mod_m)$fstatistic, 2); round(summary(mod_y)$fstatistic, 2)
Wynik w R
SIMPLE SLOPES ANALYSIS

Slope of x when w = -0.71562381:

   Est.    S.E.   t val.       p
------- ------- -------- -------
  0.885   0.092    9.582   0.000

Slope of x when w =  0.01397619:

   Est.    S.E.   t val.       p
------- ------- -------- -------
  0.540   0.066    8.172   0.000

Slope of x when w =  0.79397619:

   Est.    S.E.   t val.       p
------- ------- -------- -------
  0.171   0.091    1.890   0.059

 Lower Higher
  4.22   5.27
[1] 0.1690476
[1] 4.22
[1] 0.167
  a1
4.59
[1] 1 5
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    1.443      0.201   7.189    0.000
m              0.492      0.050   9.815    0.000
x              0.255      0.075   3.412    0.001
w             -0.143      0.064  -2.249    0.025
staz          -0.033      0.010  -3.307    0.001
indeks
-0.233  0.436  0.266  0.084
       [,1]   [,2]
[1,] -0.341 -0.141
[2,]  0.311  0.571
[3,]  0.186  0.351
[4,] -0.009  0.170
  Estimate Std. Error    t value   Pr(>|t|)
     0.554      0.079      7.026      0.000
[1] 0
(Intercept)           x           w        staz         x:w
  1.30e-154    1.93e-15    1.52e-09    3.87e-01    3.15e-08
[1] 415
(Intercept)           m           x        staz
   3.26e-11    6.80e-24    6.52e-04    1.02e-03
[1] 416
(Intercept)           m           w           x        staz         m:w
  7.60e-132    1.50e-20    3.22e-02    5.30e-04    9.86e-04    3.66e-01
(Intercept)           m           x           w        staz         x:w
   7.49e-13    6.86e-18    2.92e-04    1.34e-02    1.28e-03    8.75e-02
    x
0.567
 value  numdf  dendf
 35.15   4.00 415.00
 value  numdf  dendf
 62.02   3.00 416.00
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- interactions (wersja 1.2.0): Long, J. A. (2024). interactions: Comprehensive, user-friendly toolkit for probing interactions (R package version 1.2.0) [Computer software]. https://doi.org/10.32614/CRAN.package.interactions
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w moderowanej mediacji
- Wnioskowanie z istotności efektów warunkowych. „Istotny przy niskim, nieistotny przy wysokim” to nie test moderacji. Testem jest przedział indeksu (Hayes, 2015), a w modelu 58 przedział różnicy efektów warunkowych.
- Mediacja w podgrupach zamiast jednego modelu. Osobne analizy mediacji dla „niskiego” i „wysokiego” wsparcia marnują dane i nie testują różnicy. Igartua i Hayes (2021) wymieniają to wśród częstych nieporozumień.
- Kroki przyczynowe i test Sobela. Warunek „najpierw istotny efekt całkowity” nie jest potrzebny (zob. podejście Barona i Kenny’ego), a test Sobela zakłada normalny rozkład iloczynu. Używaj przedziałów bootstrapowych.
- Model wybrany po wynikach. Liczenie modeli 7, 14, 58 i 59 „aż coś wyjdzie” to forma wielokrotnego testowania. Model wynika z hipotezy i z planu analizy.
- Interpretacja współczynników niższego rzędu jak efektów głównych. Po dodaniu iloczynu a1 to efekt X przy W = 0. Bez centrowania to często wartość spoza skali.
- Sondowanie poza danymi. Wartość −1 SD przy skośnym moderatorze może leżeć poniżej minimum skali. Sprawdź zakres i rozważ percentyle. Granice Johnsona–Neymana spoza zakresu danych (u nas 5.27) pomiń.
- Język przyczynowy przy danych przekrojowych. Maxwell i Cole (2007) pokazali, że przekrojowe oszacowania mediacji procesów rozwijających się w czasie bywają poważnie obciążone. Rohrer i in. (2022) wyjaśniają, że modele ścieżkowe dają wnioski przyczynowe tylko w ograniczonych warunkach, a dopasowanie modelu ich nie rozstrzyga. Pisz o modelu procesu, który dane uprawdopodobniają, i rozważ schemat podłużny (zob. modele cross-lagged).
- Za mała próba. Interakcje mają małą moc. W metabadaniu Sommeta i in. (2023) mediana mocy wykrycia interakcji typowej wielkości wyniosła .18. Planuj liczebność symulacyjnie, dla iloczynu ścieżek, a nie według reguły „20 osób na predyktor” (zob. dobór liczebności próby).
- Standaryzowanie iloczynu. Standaryzowany współczynnik przy iloczynie z typowego wydruku regresji nie odpowiada iloczynowi standaryzowanych zmiennych. Jeśli chcesz wyników w jednostkach z, najpierw standaryzuj X, W i M, a potem policz iloczyn.
- Brak informacji o wartościach W. Indeks zależy od jednostki moderatora, a efekty warunkowe od wybranych wartości. Bez tych informacji czytelnik nie odtworzy wyniku.
Najczęstsze pytania
Jak zrobić moderowaną mediację w R bez makra PROCESS?
Oszacuj dwa równania w lm(): mediatora z iloczynem X × W (model 7) i wyniku z mediatorem i X. Efekt pośredni to (a1 + a3W)b, a indeks moderowanej mediacji to a3b. Przedziały ufności wyznacz funkcją boot() z pakietu boot (np. 5000 prób, przedział percentylowy). W przykładzie z tego poradnika indeks wyniósł −0.25, 95% CI [−0.36, −0.15].
Jak policzyć indeks moderowanej mediacji w lavaan?
Nadaj ścieżkom etykiety (np. m ~ a1*x + a2*w + a3*xw, y ~ b*m + cp*x), a indeks zdefiniuj operatorem :=, np. indeks := a3*b. Model oszacuj z se = "bootstrap" i odczytaj przedział funkcją parameterEstimates(fit, boot.ci.type = "perc"). Iloczyn XW utwórz wcześniej z wycentrowanych zmiennych.
Czym różnią się modele 7, 14 i 58 w PROCESS?
W modelu 7 moderator działa na ścieżkę a (X → M), w modelu 14 na ścieżkę b (M → Y), a w modelu 58 na obie. W modelach 7 i 14 efekt pośredni zależy od W liniowo i opisuje go jeden indeks. W modelu 58 zależność jest kwadratowa, więc wnioskuje się z porównań efektów warunkowych przy wybranych wartościach W.
Przy jakich wartościach moderatora podawać warunkowe efekty pośrednie?
Najczęściej przy 16., 50. i 84. percentylu albo przy średniej ±1 SD. Percentyle zawsze leżą w zakresie danych, co ma znaczenie przy skośnym moderatorze. Najwięcej informacji daje wykres efektu pośredniego w całym zakresie W z bootstrapowym pasmem ufności. Gdy moderator ma wartości ważne merytorycznie, np. progi kliniczne, sonduj przy nich.
Czy w moderowanej mediacji trzeba centrować zmienne?
Centrowanie X i W nie zmienia współczynnika przy iloczynie ani indeksu moderowanej mediacji. Ułatwia jednak interpretację: a1 staje się efektem X przy przeciętnym W, a nie przy W = 0, którego na skali 1–5 nie ma. W modelach 14 i 58 wycentruj także mediator, bo wchodzi do iloczynu z W.
Powiązane hasła
Przeczytaj też
Analiza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →Testujesz moderowaną mediację w artykule lub rozprawie?
Pomożemy dobrać model do hipotezy, policzyć efekty warunkowe i indeks z bootstrapem, przygotować analizę wrażliwości oraz tabelę i opis wyników do publikacji.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bauer, D. J., & Curran, P. J. (2005). Probing interactions in fixed and multilevel regression: Inferential and graphical techniques. Multivariate Behavioral Research, 40(3), 373–400. https://doi.org/10.1207/s15327906mbr4003_5 ● Otwarty dostęp
- Biesanz, J. C., Falk, C. F., & Savalei, V. (2010). Assessing mediational models: Testing and interval estimation for indirect effects. Multivariate Behavioral Research, 45(4), 661–701. https://doi.org/10.1080/00273171.2010.498292
- Dalal, D. K., & Zickar, M. J. (2012). Some common myths about centering predictor variables in moderated multiple regression and polynomial regression. Organizational Research Methods, 15(3), 339–362. https://doi.org/10.1177/1094428111430540
- Edwards, J. R., & Lambert, L. S. (2007). Methods for integrating moderation and mediation: A general analytical framework using moderated path analysis. Psychological Methods, 12(1), 1–22. https://doi.org/10.1037/1082-989x.12.1.1
- Hayes, A. F. (2015). An index and test of linear moderated mediation. Multivariate Behavioral Research, 50(1), 1–22. https://doi.org/10.1080/00273171.2014.962683
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Hayes, A. F., & Scharkow, M. (2013). The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter? Psychological Science, 24(10), 1918–1927. https://doi.org/10.1177/0956797613480187
- Igartua, J.-J., & Hayes, A. F. (2021). Mediation, moderation, and conditional process analysis: Concepts, computations, and some common confusions. The Spanish Journal of Psychology, 24, Article e49. https://doi.org/10.1017/sjp.2021.46
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989x.12.1.23
- Muller, D., Judd, C. M., & Yzerbyt, V. Y. (2005). When moderation is mediated and mediation is moderated. Journal of Personality and Social Psychology, 89(6), 852–863. https://doi.org/10.1037/0022-3514.89.6.852
- Preacher, K. J., Rucker, D. D., & Hayes, A. F. (2007). Addressing moderated mediation hypotheses: Theory, methods, and prescriptions. Multivariate Behavioral Research, 42(1), 185–227. https://doi.org/10.1080/00273170701341316 ● Otwarty dostęp: pełny tekst
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Sommet, N., Weissman, D. L., Cheutin, N., & Elliot, A. J. (2023). How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction. Advances in Methods and Practices in Psychological Science, 6(3), Article 25152459231178728. https://doi.org/10.1177/25152459231178728 ● Otwarty dostęp
Cytowania BibTeX
@article{bauer2005probing, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Probing interactions in fixed and multilevel regression: Inferential and graphical techniques}}, journal={Multivariate Behavioral Research}, year={2005}, volume={40}, number={3}, pages={373--400}, doi={10.1207/s15327906mbr4003_5}}@article{biesanz2010assessing, author={Biesanz, Jeremy C. and Falk, Carl F. and Savalei, Victoria}, title={{Assessing mediational models: Testing and interval estimation for indirect effects}}, journal={Multivariate Behavioral Research}, year={2010}, volume={45}, number={4}, pages={661--701}, doi={10.1080/00273171.2010.498292}}@article{dalal2012some, author={Dalal, Dev K. and Zickar, Michael J.}, title={{Some common myths about centering predictor variables in moderated multiple regression and polynomial regression}}, journal={Organizational Research Methods}, year={2012}, volume={15}, number={3}, pages={339--362}, doi={10.1177/1094428111430540}}@article{edwards2007methods, author={Edwards, Jeffrey R. and Lambert, Lisa Schurer}, title={{Methods for integrating moderation and mediation: A general analytical framework using moderated path analysis}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={1--22}, doi={10.1037/1082-989x.12.1.1}}@article{hayes2015index, author={Hayes, Andrew F.}, title={{An index and test of linear moderated mediation}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={1}, pages={1--22}, doi={10.1080/00273171.2014.962683}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@article{hayes2013relative, author={Hayes, Andrew F. and Scharkow, Michael}, title={{The relative trustworthiness of inferential tests of the indirect effect in statistical mediation analysis: Does method really matter?}}, journal={Psychological Science}, year={2013}, volume={24}, number={10}, pages={1918--1927}, doi={10.1177/0956797613480187}}@article{igartua2021mediation, author={Igartua, Juan-José and Hayes, Andrew F.}, title={{Mediation, moderation, and conditional process analysis: Concepts, computations, and some common confusions}}, journal={The Spanish Journal of Psychology}, year={2021}, volume={24}, eid={e49}, doi={10.1017/sjp.2021.46}}@article{maxwell2007bias, author={Maxwell, Scott E. and Cole, David A.}, title={{Bias in cross-sectional analyses of longitudinal mediation}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={23--44}, doi={10.1037/1082-989x.12.1.23}}@article{muller2005when, author={Muller, Dominique and Judd, Charles M. and Yzerbyt, Vincent Y.}, title={{When moderation is mediated and mediation is moderated}}, journal={Journal of Personality and Social Psychology}, year={2005}, volume={89}, number={6}, pages={852--863}, doi={10.1037/0022-3514.89.6.852}}@article{preacher2007addressing, author={Preacher, Kristopher J. and Rucker, Derek D. and Hayes, Andrew F.}, title={{Addressing moderated mediation hypotheses: Theory, methods, and prescriptions}}, journal={Multivariate Behavioral Research}, year={2007}, volume={42}, number={1}, pages={185--227}, doi={10.1080/00273170701341316}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{sommet2023how, author={Sommet, Nicolas and Weissman, David L. and Cheutin, Nicolas and Elliot, Andrew J.}, title={{How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction}}, journal={Advances in Methods and Practices in Psychological Science}, year={2023}, volume={6}, number={3}, eid={25152459231178728}, doi={10.1177/25152459231178728}}