Kiedy potrzebujesz analizy moderacji?
Załóżmy, że badasz studentów i wiesz już, że wyższy stres wiąże się z niższym dobrostanem. Promotor dopytuje jednak: czy u wszystkich tak samo? Może osoby z silnym wsparciem społecznym są przed skutkami stresu lepiej chronione? To pytanie o moderację: czy siła (albo kierunek) związku między predyktorem X a wynikiem Y zależy od trzeciej zmiennej – moderatora W. Statystycznie odpowiada na nie efekt interakcji w regresji liniowej.
Moderacja odpowiada na pytania „kiedy?” i „dla kogo?”. Nie myl jej z mediacją, która pyta „dlaczego?”, czyli przez jaki mechanizm X wiąże się z Y. Krótką definicję i porównanie obu pojęć znajdziesz w haśle moderacja. Tutaj przechodzimy przez całą analizę – od hipotezy po gotowy opis w stylu APA.
Przez cały tekst pracujemy na jednym zbiorze danych (dane symulowane): 300 studentów wypełniło skalę stresu (0–40 punktów), skalę wsparcia społecznego (średnia z 12 pozycji ocenianych na skali Likerta 1–7) i skalę dobrostanu (0–25 punktów). Wszystkie liczby w tekście, tabelach i na rysunkach pochodzą z kodu z sekcji Przykład w R.
Krok 1. Sformułuj hipotezę moderacyjną i narysuj model
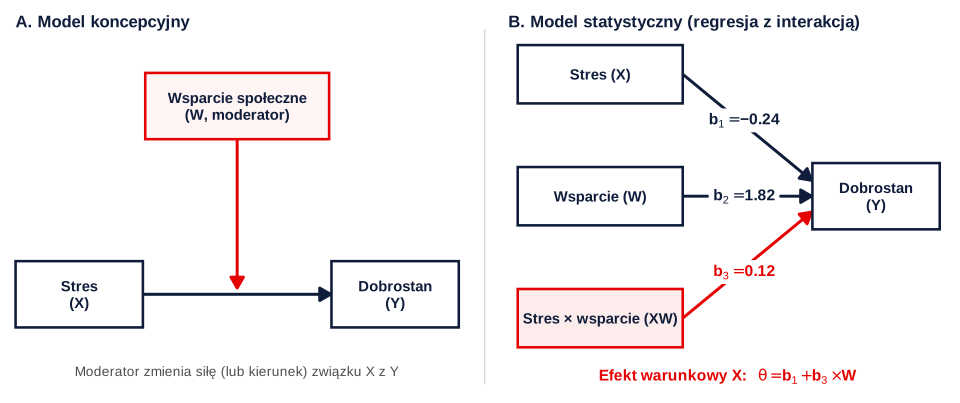
Dobra hipoteza moderacyjna mówi nie tylko, że interakcja istnieje, ale też, jaki ma kształt. W przykładzie brzmi ona: „Wsparcie społeczne osłabia ujemny związek stresu z dobrostanem – im wyższe wsparcie, tym słabszy ten związek”. To tak zwana hipoteza buforowa. Predyktorem (X) jest stres, moderatorem (W) – wsparcie, a zmienną zależną (Y) – dobrostan.
Rysunek 1 pokazuje dwa zapisy tej samej hipotezy. Model koncepcyjny (A) to strzałka od moderatora do strzałki X → Y. Model statystyczny (B) to zwykła regresja z trzema predyktorami: X, W i ich iloczynem XW.
Równanie modelu statystycznego:
Po przegrupowaniu widać, dlaczego iloczyn wyraża moderację: Y = b0 + b2W + (b1 + b3W)X + e. Nachylenie X nie jest już jedną liczbą, tylko funkcją moderatora – efektem warunkowym θ = b1 + b3W. Tak ujmuje moderację podręcznik Hayesa (2022), który opisuje szacowanie efektów warunkowych oraz sondowanie i wizualizację interakcji w regresji. Gdy b3 = 0, związek X z Y jest taki sam przy każdym poziomie W.
Matematycznie interakcja jest symetryczna: ten sam b3 mówi, że efekt stresu zależy od wsparcia i że efekt wsparcia zależy od stresu. O tym, która zmienna jest moderatorem, decyduje teoria. Nieprzypadkowo Memon i in. (2019) zaczynają listę kluczowych kwestii analizy moderacji od identyfikacji i konceptualizacji moderatora. Zapisz tę decyzję przed zebraniem danych, najlepiej w prerejestracji.
Krok 2. Opisz dane i wycentruj predyktory
Zacznij od statystyk opisowych i korelacji. Średni stres wyniósł M = 20.20 (SD = 6.50), wsparcie M = 5.04 (SD = 1.07), a dobrostan M = 12.91 (SD = 4.82). Dobrostan korelował ujemnie ze stresem, r = −.46, i dodatnio ze wsparciem, r = .48; stres i wsparcie korelowały ze sobą słabiej, r = −.28 (wszystkie p < .001). Korelacje Pearsona nie mówią jednak nic o moderacji – do tego potrzebny jest model z iloczynem.
Centrowanie to odjęcie średniej od każdego wyniku: stres_c = stres − 20.20, wsparcie_c = wsparcie − 5.04. Po centrowaniu zero oznacza „przeciętny poziom”, więc b1 to efekt stresu przy przeciętnym wsparciu, a b2 – efekt wsparcia przy przeciętnym stresie. Wpływ skalowania predyktorów na współczynniki modelu z interakcją szczegółowo omawiają Aiken i West (1991), a praktyczne wskazówki do testowania i interpretowania moderacji podaje Dawson (2014). Tabela 1 porównuje ten sam model bez centrowania i po nim.
| Element modelu | Bez centrowania | Po centrowaniu |
|---|---|---|
| b1 (stres) | −0.83 – efekt stresu przy wsparciu równym 0 (poza skalą 1–7) | −0.24 – efekt stresu przy przeciętnym wsparciu |
| b2 (wsparcie) | −0.53, p = .421 – efekt wsparcia przy stresie równym 0 | 1.82, p < .001 – efekt wsparcia przy przeciętnym stresie |
| b3 (stres × wsparcie) | 0.12, t(296) = 3.67, p < .001 | 0.12, t(296) = 3.67, p < .001 – bez zmian |
| VIF: stres; wsparcie; iloczyn | 21.74; 9.76; 22.72 | 1.10; 1.10; 1.02 |
| R² modelu | .37 | .37 |
Bez centrowania b2 sugeruje, że wsparcie „nie działa”, a nawet obniża dobrostan. To jednak efekt wsparcia u osób bez żadnego stresu – w próbie była jedna taka osoba. Centrowanie nie zmienia współczynnika interakcji, jego testu ani R²; zmienia tylko znaczenie b1 i b2.
Spada też VIF. Iloczyn surowych wyników korelował ze stresem na poziomie r = .78, a iloczyn wycentrowanych – na poziomie r = −.08. Taka współliniowość zmiennej z jej własnym iloczynem wynika wyłącznie z położenia zera na skali i nie zniekształca testu interakcji. Wysoki VIF w modelu bez centrowania nie jest więc powodem do usuwania zmiennych.
Jeśli chcesz podać współczynniki standaryzowane (β), standaryzuj X, W i Y przed utworzeniem iloczynu. Współczynnik iloczynu w kolumnie „Beta” w SPSS nie jest poprawnym β interakcji, bo iloczyn standaryzowanych zmiennych to nie to samo, co standaryzowany iloczyn. W R robi to funkcja standardize_parameters(model, method = "refit"); w przykładzie β interakcji wyniósł 0.17, 95% CI [0.08, 0.26].
Krok 3. Oszacuj model z interakcją
Najczytelniej jest liczyć model w dwóch krokach, jak w regresji hierarchicznej: najpierw same efekty X i W, potem iloczyn XW. Przyrost R² (ΔR²) pokazuje, ile wariancji wyjaśnia sama interakcja. W R wystarczy zapis lm(dobrostan ~ stres_c * wsparcie_c) – gwiazdka dodaje do modelu oba predyktory i ich iloczyn. W SPSS iloczyn trzeba najpierw obliczyć jako nową zmienną (zob. sekcję o SPSS).
- Krok 1 (stres, wsparcie): R² = .34, F(2, 297) = 77.09, p < .001.
- Krok 2 (+ stres × wsparcie): R² = .37, F(3, 296) = 58.04, p < .001.
- Zmiana: ΔR² = .03, F(1, 296) = 13.47, p < .001.
Współczynnik interakcji wyniósł b3 = 0.12, SE = 0.03, 95% CI [0.05, 0.18], t(296) = 3.67, p < .001. W modelu z jedną interakcją test t dla b3 i test F zmiany R² to ten sam test: F = t² (3.67² ≈ 13.47). Nie oceniaj interakcji wyłącznie po ΔR²: przyrost o 3 punkty procentowe oznacza tu, że nachylenie stresu przy niskim i przy wysokim wsparciu różni się mniej więcej trzykrotnie (krok 5).
Model jest szacowany zwykłą metodą najmniejszych kwadratów, tak jak każda regresja wieloraka. Polski przewodnik po analizie interakcji – z przykładami w SPSS i regresją ze zmiennymi wycentrowanymi – przygotował Sosnowski (2010).
Krok 4. Zinterpretuj współczynniki b1, b2 i b3
W modelu z wycentrowanymi predyktorami:
- b3 = 0.12 – o tyle zmienia się nachylenie stresu, gdy wsparcie rośnie o 1 punkt. Nachylenie stresu jest ujemne, więc dodatni b3 oznacza, że wraz ze wzrostem wsparcia ujemny związek stresu z dobrostanem słabnie – zgodnie z hipotezą buforową.
- b1 = −0.24 – przy przeciętnym wsparciu (5.04) każdy dodatkowy punkt stresu wiąże się z dobrostanem niższym średnio o 0.24 punktu.
- b2 = 1.82 – przy przeciętnym stresie (20.20) osoby różniące się o 1 punkt wsparcia różnią się średnio o 1.82 punktu dobrostanu.
- b0 = 13.13 – przewidywany dobrostan osoby o przeciętnym stresie i przeciętnym wsparciu.
W modelu z interakcją b1 i b2 są efektami warunkowymi, a nie efektami głównymi w rozumieniu ANOVA: opisują związek przy jednej konkretnej wartości drugiej zmiennej (tu przy jej średniej). Odwrotny odczyt b3 jest równie poprawny: wraz ze wzrostem stresu rośnie znaczenie wsparcia. Przy stresie równym 10 punktów różnica 1 punktu wsparcia wiąże się z różnicą 0.63 punktu dobrostanu, a przy stresie równym 30 punktów – aż 2.95 punktu. Tak wygląda interakcja zmiennych: żadnego z dwóch efektów nie da się opisać jedną liczbą.
Krok 5. Sprawdź proste nachylenia (−1 SD, M, +1 SD)
Istotny b3 mówi, że nachylenie X zmienia się wraz z W, ale nie mówi, przy jakich wartościach W związek X z Y jest istotny. Do tego służą proste nachylenia (ang. simple slopes): efekty warunkowe θ = b1 + b3W obliczone przy wybranych wartościach moderatora, każdy z własnym błędem standardowym, testem t i przedziałem ufności (Aiken i West, 1991). Metody sondowania interakcji – proste nachylenia, regiony istotności i pasma ufności – przeglądają Preacher i in. (2006). Błąd standardowy prostego nachylenia zależy od wariancji i kowariancji współczynników:
Tradycyjnie wybiera się średnią moderatora oraz wartości o jedno odchylenie standardowe niższą i wyższą. W naszych danych to 3.98, 5.04 i 6.11 punktu wsparcia (tabela 2).
| Poziom wsparcia | W | b (nachylenie stresu) | SE | 95% CI | t(296) | p |
|---|---|---|---|---|---|---|
| Niskie (M − 1 SD) | 3.98 | −0.37 | 0.05 | [−0.46, −0.28] | −7.89 | < .001 |
| Przeciętne (M) | 5.04 | −0.24 | 0.04 | [−0.31, −0.17] | −6.78 | < .001 |
| Wysokie (M + 1 SD) | 6.11 | −0.12 | 0.05 | [−0.22, −0.02] | −2.31 | .022 |
Przy niskim wsparciu każdy punkt stresu wiąże się z dobrostanem niższym o 0.37 punktu, przy wysokim – tylko o 0.12 punktu, czyli około trzy razy słabiej. Wszystkie trzy nachylenia są ujemne i istotne, więc wsparcie osłabia, ale nie znosi związku stresu z dobrostanem. Rysunek 2 pokazuje te same trzy proste na tle danych.
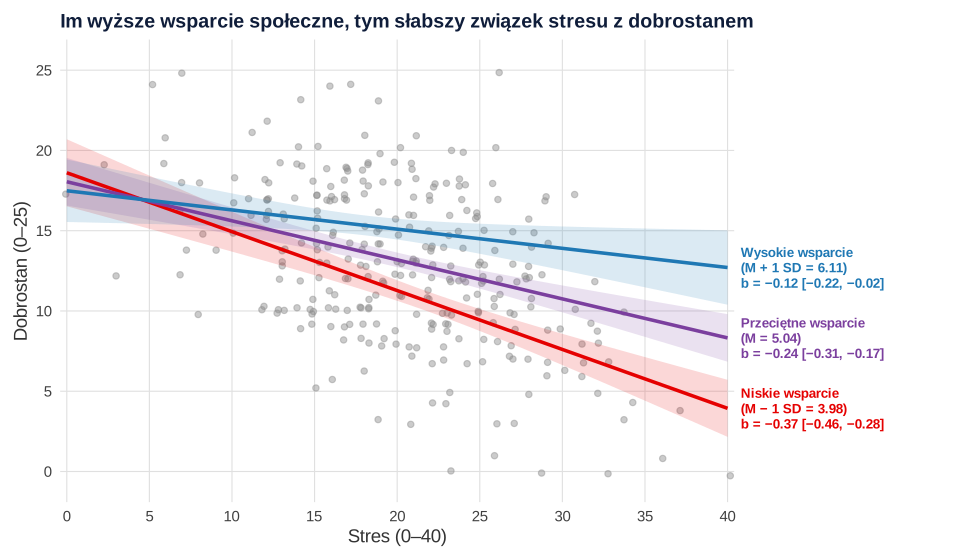
Wykres pokazuje też drugą stronę interakcji: przy niskim stresie linie się schodzą, a przy wysokim – rozchodzą. Przy stresie równym 30 punktów przewidywany dobrostan wynosi 7.60 punktu przy niskim wsparciu i 13.90 przy wysokim; przy stresie równym 10 punktów – odpowiednio 14.94 i 16.29.
Wartości ±1 SD są wygodne, ale arbitralne – zależą od tego, kogo akurat zbadano. Spiller i in. (2013) zalecają raportowanie efektów prostych („spotlight”) przy wartościach moderatora, które mają znaczenie merytoryczne. Na skali wsparcia 1–7 mogą to być punkty 3 („raczej się nie zgadzam”), 5 („raczej się zgadzam”) i 7 („zdecydowanie się zgadzam”). Nachylenie stresu wynosiło w nich odpowiednio b = −0.48, 95% CI [−0.62, −0.34], p < .001; b = −0.25, 95% CI [−0.32, −0.18], p < .001; oraz b = −0.02, 95% CI [−0.16, 0.13], p = .826. U osób z maksymalnym wsparciem związek stresu z dobrostanem był więc bliski zera.
Krok 6. Wyznacz przedział Johnsona–Neymana
Zamiast wybierać kilka punktów, możesz sprawdzić wszystkie naraz. Technika Johnsona–Neymana – nazwana od autorów pracy z 1936 roku (Johnson i Neyman, 1936) – wyznacza te wartości moderatora, przy których przedział ufności prostego nachylenia dotyka zera. Oś moderatora dzieli się wtedy na region, w którym efekt X jest istotny, i region, w którym nie jest. Bauer i Curran (2005) porównują testowanie prostych nachyleń przy wybranych wartościach moderatora z tą ogólniejszą techniką, a Spiller i in. (2013) nazywają ją „floodlight” – reflektorem, który oświetla cały zakres moderatora, a nie kilka punktów.
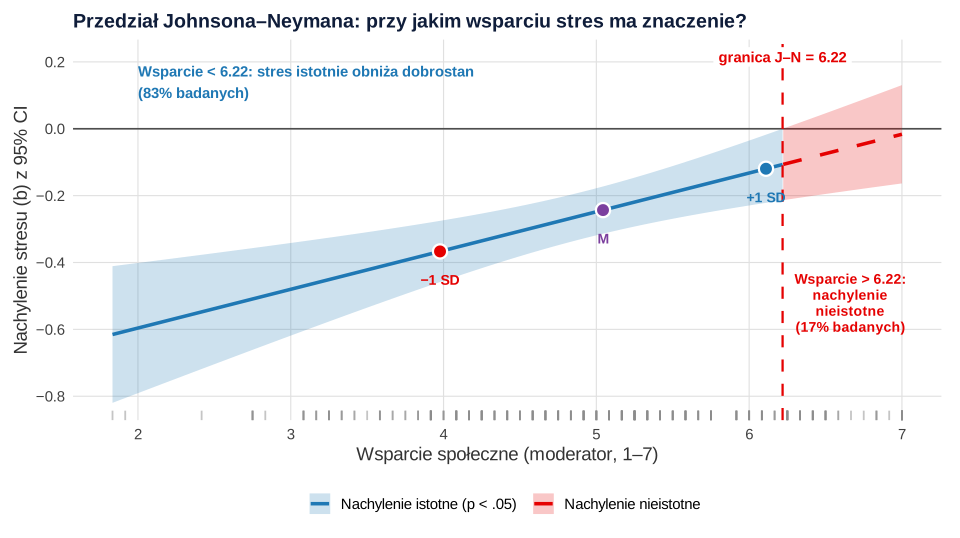
W przykładzie funkcja johnson_neyman() z pakietu interactions (Long, 2024) zwróciła przedział [6.22, 9.86]. Związek stresu z dobrostanem jest istotny, gdy wsparcie leży poza tym przedziałem. Górna granica przekracza maksimum skali (7), więc w praktyce wniosek brzmi: przy wsparciu niższym niż 6.22 stres istotnie wiąże się z niższym dobrostanem (83% badanych), a przy wsparciu od 6.22 do 7 – nie (17% badanych, czyli 51 osób).
Trzy uwagi do interpretacji:
- Brak istotności to nie brak efektu. Przy wysokim wsparciu przedział ufności jest szeroki (przy W = 7 wynosi [−0.16, 0.13]), bo takich osób jest niewiele. Dane są zgodne zarówno z brakiem związku, jak i z umiarkowanie ujemnym związkiem.
- Granica zależy od liczebności próby. W większej próbie przedziały ufności się zwężają, a region istotności się poszerza, choć sam efekt jest taki sam.
- Interpretuj tylko obserwowany zakres moderatora. Granica leżąca poza skalą (tu 9.86) jest wynikiem rachunku, a nie obserwacją. Pakiet interactions wypisuje obok przedziału obserwowany zakres moderatora ([1.83, 7.00]).
Krok 7. Narysuj interakcję tak, by nie wprowadzała w błąd
McCabe i in. (2018) zwracają uwagę, że typowe wykresy prostych nachyleń pokazują same linie – bez niepewności oszacowań i bez obserwowanych danych – a to może prowadzić do błędnych wniosków o moderacji. Dobry wykres interakcji, taki jak rysunek 2:
- pokazuje surowe dane na wykresie rozrzutu – widać, gdzie leżą obserwacje i czy proste nie wychodzą poza dane;
- ma pasma 95% przedziałów ufności wokół każdej prostej;
- używa oryginalnych jednostek X i Y oraz podaje wartości moderatora (np. „M − 1 SD = 3.98”), a nie tylko etykiety „niskie” i „wysokie”;
- rysuje proste wyłącznie w zakresie obserwowanych wartości X;
- idzie w parze z wykresem Johnsona–Neymana (rysunek 3), który pokazuje efekt X w całym zakresie moderatora oraz rozkład moderatora;
- ma podpis wyjaśniający, co oznaczają linie, pasma i punkty.
Tak samo działają wykresy w aplikacji SZTOS: linia ciągła oznacza istotne proste nachylenie, a przerywana – nieistotne, i ten sam kod zastosowaliśmy na rysunku 3. Unikaj natomiast dzielenia moderatora medianą na grupy „niskie” i „wysokie” wsparcie tylko po to, by narysować dwie linie. Tracisz wtedy część informacji i mocy, a punkt podziału zależy od tego, kogo zbadano.
Krok 8. Sprawdź założenia modelu
Model moderacji to zwykła regresja, więc obowiązują go te same założenia: liniowość, niezależność obserwacji, stała wariancja reszt (homoskedastyczność), normalność reszt (ważna zwłaszcza w małych próbach) i brak obserwacji nadmiernie wpływowych. Rysunek 4 to panel diagnostyczny z funkcji check_model() z pakietu performance, taki sam jak w raportach aplikacji SZTOS.
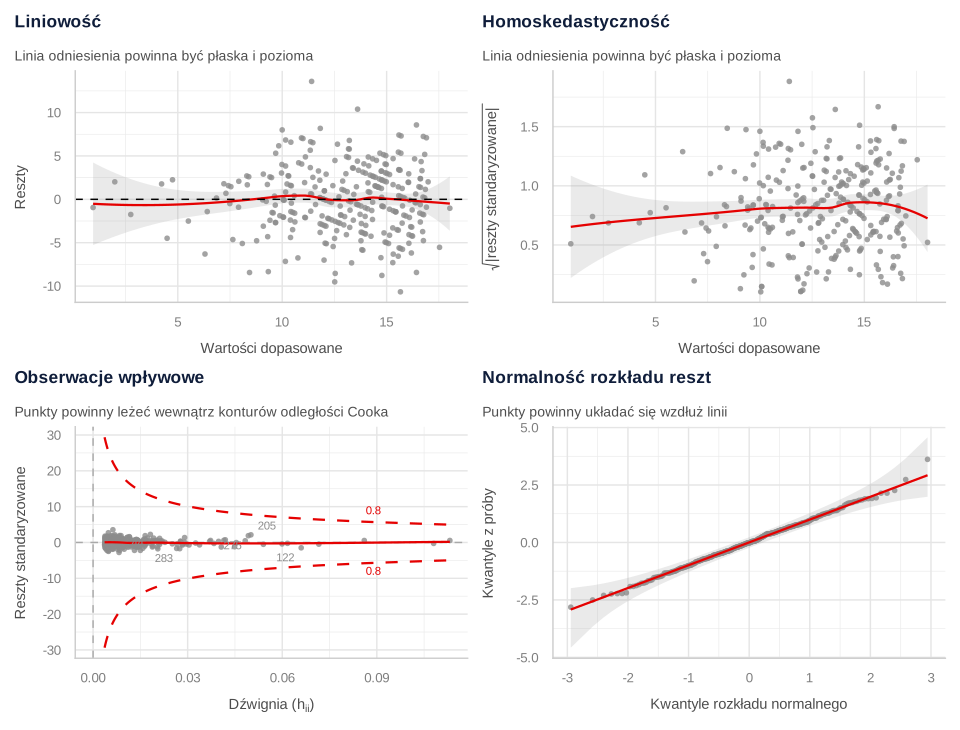
check_model()): liniowość, homoskedastyczność, obserwacje wpływowe i normalność rozkładu reszt. Czerwone linie ciągłe to wygładzone trendy, szare pasma – ich niepewność, przerywane krzywe – kontury odległości Cooka, a liczby przy punktach – numery najbardziej wpływowych obserwacji. Obliczenia: R (dane symulowane).W przykładzie linie odniesienia są prawie płaskie, a punkty na wykresie kwantylowym (Q-Q) leżą wzdłuż prostej. Formalne testy dają ten sam obraz (heteroskedastyczność: p = .387; normalność reszt: p = .974). Największa odległość Cooka wynosi 0.06. Liberalny próg 4/N = 0.013 przekracza 15 osób (5% próby). Takie przypadki warto obejrzeć, ale nie usuwaj ich automatycznie – zamiast tego sprawdź, czy wpływają na wnioski. Po wykluczeniu tych 15 osób współczynnik interakcji wyniósł b3 = 0.13, SE = 0.03, t = 3.98, p < .001, więc żadna obserwacja odstająca nie „tworzy” interakcji. W pracy opisz taką analizę wrażliwości jednym zdaniem.
Przy moderacji szczególnie uważaj na obserwacje z krańców moderatora: kilka osób z bardzo niskim lub bardzo wysokim wsparciem potrafi „przechylić” nachylenia. Jeśli dane mają strukturę zagnieżdżoną (np. uczniowie w klasach albo wiele pomiarów tej samej osoby), potrzebujesz modelu wielopoziomowego; sondowanie interakcji w takich modelach opisują Bauer i Curran (2005) oraz Preacher i in. (2006).
Moderator kategorialny: grupy zamiast skali
Moderatorem może być też zmienna kategorialna, np. płeć, warunek eksperymentalny albo tryb studiów. Logika jest ta sama, tylko moderator wchodzi do modelu jako zmienna zero-jedynkowa (dummy coding). Przy kodowaniu 0 = studia stacjonarne, 1 = niestacjonarne:
- b1 to nachylenie stresu w grupie odniesienia (studia stacjonarne),
- b3 to różnica nachyleń między grupami (niestacjonarne minus stacjonarne).
W naszych danych (197 osób na studiach stacjonarnych, 103 na niestacjonarnych) nachylenie stresu wyniosło −0.37, 95% CI [−0.46, −0.27], w grupie stacjonarnej i −0.29, 95% CI [−0.41, −0.17], w niestacjonarnej. Różnica nachyleń nie była istotna: b3 = 0.08, SE = 0.08, 95% CI [−0.08, 0.23], t(296) = 0.95, p = .344. Nie znaczy to, że tryb studiów na pewno nie moderuje związku – przedział ufności obejmuje i zero, i różnicę nachyleń rzędu 0.2 punktu. Znaczy tylko, że te dane nie dają podstaw do takiego wniosku.
Dwóch błędów tu unikaj. Pierwszy to porównywanie istotności z osobnych analiz w grupach („w jednej grupie korelacja jest istotna, w drugiej nie, więc jest moderacja”) – o moderacji świadczy test różnicy nachyleń, czyli b3. Drugi to dzielenie zmiennej ciągłej na grupy tylko po to, by móc policzyć ANOVA. Gdy oba czynniki są naprawdę kategorialne, interakcję testuje dwuczynnikowa ANOVA. Wszystkie trzy przypadki – dwie zmienne kategorialne, kategorialną z ciągłą i dwie ciągłe – omawia z przykładami w SPSS Sosnowski (2010), a Memon i in. (2019) wyjaśniają, czym prosta analiza moderacji różni się od analizy wielogrupowej.
Ile osób potrzebujesz? Moc testu interakcji
Interakcje wykrywa się trudniej niż pojedyncze związki. Sommet i in. (2023) przeanalizowali 159 badań i ustalili, że mediana mocy wykrycia interakcji typowej wielkości wynosiła zaledwie .18. Autorzy podają zalecane liczebności próby zależne od kształtu interakcji oraz sposoby zwiększenia mocy bez powiększania próby, np. plan mieszany albo prerejestrowane testy jednostronne.
Moc dla własnego modelu najłatwiej oszacować symulacją: wygeneruj wiele zbiorów danych z założonymi efektami, dopasuj model i policz, jak często p dla b3 spada poniżej .05. Tabela 3 pokazuje wynik 2000 symulacji dla każdej liczebności – dla interakcji takiej jak w przykładzie (b3 = 0.12) i dla interakcji o połowę słabszej (b3 = 0.06).
| N | Moc dla b3 = 0.12 | Moc dla b3 = 0.06 |
|---|---|---|
| 100 | .55 | .18 |
| 200 | .86 | .35 |
| 300 | .96 | .49 |
| 400 | .99 | .60 |
| 600 | > .99 | .77 |
| 800 | > .99 | .87 |
| 1200 | > .99 | .96 |
Dla interakcji z przykładu 200 osób daje moc około .86. Interakcja o połowę słabsza wymaga mniej więcej czterokrotnie większej próby: moc .87 osiągamy dopiero przy 800 osobach, a przy 100 osobach wynosi ona .18. Moc dla regresji możesz też policzyć w programie G*Power (zob. analiza mocy a priori), ale trzeba wtedy przełożyć oczekiwaną interakcję na wielkość efektu f² dla przyrostu R². Szerzej o planowaniu próby piszemy w poradniku dobór liczebności próby.
Moderacja w SPSS: regresja z iloczynem i PROCESS (model 1)
Regresja hierarchiczna z iloczynem
- Przekształcenia → Oblicz wartości (Transform → Compute Variable): utwórz stres_c = stres − 20.20 i wsparcie_c = wsparcie − 5.04 (średnie odczytaj wcześniej ze statystyk opisowych), a następnie iloczyn = stres_c * wsparcie_c.
- Analiza → Regresja → Liniowa (Analyze → Regression → Linear): zmienna zależna – dobrostan; blok 1 – stres_c i wsparcie_c; przycisk Następny; blok 2 – iloczyn.
- W oknie Statystyki zaznacz zmianę R² (R squared change), przedziały ufności i diagnostykę współliniowości.
- Odczytaj ΔR² i F zmiany dla bloku 2 oraz b, t i p dla iloczynu. Proste nachylenia trzeba w tym wariancie policzyć osobno.
Makro PROCESS, model 1
PROCESS to bezpłatne makro do SPSS, SAS i R opisane w podręczniku Hayesa (2022); przykład jego użycia w analizie moderacji i mediacji pokazują Hayes i Rockwood (2017). Moderacja z jednym moderatorem to model 1:
- Zainstaluj okno dialogowe PROCESS (Extensions → Utilities → Install Custom Dialog) i otwórz je z menu Analiza → Regresja.
- Wskaż Y = dobrostan, X = stres, W = wsparcie i wybierz Model number = 1.
- W Options włącz centrowanie zmiennych tworzących iloczyn (Mean center for construction of products), wyniki Johnsona–Neymana i wybierz wartości moderatora (Conditioning values).
W wyniku znajdziesz współczynnik iloczynu (Int_1), test przyrostu R² dla interakcji (R2-chng), efekty warunkowe X przy wybranych wartościach W i tabelę Johnsona–Neymana. Nowsze wersje PROCESS domyślnie liczą efekty warunkowe przy 16., 50. i 84. percentylu moderatora (u nas 3.99, 5.08 i 6.25), a nie przy M ± 1 SD – w opisie wyników podaj, które wartości wybrałeś. Tę samą analizę wykonasz w R (sekcja niżej) albo w jamovi (moduł medmod).
Jak opisać analizę moderacji w pracy (APA)
Memon i in. (2019) traktują raportowanie jako jeden z kluczowych etapów analizy moderacji. W części o metodzie i w wynikach podaj co najmniej:
- hipotezę z przewidywanym kierunkiem interakcji i rolę zmiennych (X, W, Y);
- sposób przygotowania predyktorów (centrowanie, standaryzacja) i użyte oprogramowanie;
- b3 z błędem standardowym, 95% CI i testem oraz ΔR² dla interakcji;
- proste nachylenia przy wybranych – i uzasadnionych – wartościach moderatora albo region Johnsona–Neymana;
- wykres z danymi i przedziałami ufności;
- wynik diagnostyki modelu (choćby jedno zdanie).
Gotowy opis dla danych z przykładu:
Pełne wyniki modelu zbierz w tabeli. Poniżej wzór; inne warianty (regresja wieloraka i hierarchiczna) znajdziesz w haśle tabela regresji w APA, a ogólne zasady zapisu statystyk – w poradniku jak opisać wyniki w stylu APA.
Tabela 1
Regresja dobrostanu na stres, wsparcie społeczne i ich interakcję
| Predyktor | b | SE | 95% CI dla b | β | t | p | |
|---|---|---|---|---|---|---|---|
| LL | UL | ||||||
| Stała | 13.13 | 0.23 | 12.68 | 13.59 | — | 56.96 | < .001 |
| Stres | −0.24 | 0.04 | −0.31 | −0.17 | −0.33 | −6.78 | < .001 |
| Wsparcie społeczne | 1.82 | 0.22 | 1.39 | 2.25 | 0.40 | 8.30 | < .001 |
| Stres × wsparcie | 0.12 | 0.03 | 0.05 | 0.18 | 0.17 | 3.67 | < .001 |
Uwaga. N = 300. Stres i wsparcie wycentrowano wokół średnich (M = 20.20 i M = 5.04). β obliczono po standaryzacji zmiennych przed utworzeniem iloczynu. R² = .37, F(3, 296) = 58.04, p < .001; dodanie interakcji: ΔR² = .03, F(1, 296) = 13.47, p < .001. LL i UL – dolna i górna granica przedziału ufności. Dane symulowane.
Więcej wzorów tabel do pracy dyplomowej zebraliśmy w poradniku tabele APA w pracy z psychologii.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R – przepisy 2–4 korzystają z obiektów utworzonych w przepisie 1. Rysunki na stronie przedstawiają te same wyniki narysowane w ggplot2 w szacie graficznej serwisu.
1. Dane, centrowanie i model z interakcją
R
library(interactions)   # sim_slopes(), johnson_neyman(), interact_plot()
library(car)            # vif()
library(effectsize)     # standardize_parameters()

# Dane symulowane: stres (0–40), wsparcie społeczne (1–7), dobrostan (0–25), N = 300
set.seed(251)
n <- 300
w_lat <- rnorm(n)
s_lat <- -0.3 * w_lat + sqrt(0.91) * rnorm(n)
stres    <- pmin(pmax(round(20 + 6.5 * s_lat), 0), 40)
wsparcie <- pmin(pmax(round((5.1 + 1.1 * w_lat) * 12) / 12, 1), 7)
dobrostan <- 13 - 0.25 * (stres - 20) + 1.8 * (wsparcie - 5) +
  0.12 * (stres - 20) * (wsparcie - 5) + rnorm(n, sd = 4)
dobrostan <- pmin(pmax(round(dobrostan), 0), 25)
tryb <- factor(sample(c("stacjonarne", "niestacjonarne"), n, replace = TRUE, prob = c(.6, .4)),
               levels = c("stacjonarne", "niestacjonarne"))
dane <- data.frame(stres, wsparcie, dobrostan, tryb)

# Statystyki opisowe i korelacje
round(sapply(dane[1:3], function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane[1:3]), 2)

# Centrowanie: od każdego wyniku odejmujemy średnią
dane$stres_c    <- dane$stres - mean(dane$stres)
dane$wsparcie_c <- dane$wsparcie - mean(dane$wsparcie)

# Krok 1: model bez interakcji, krok 2: model z interakcją
m1 <- lm(dobrostan ~ stres_c + wsparcie_c, data = dane)
m2 <- lm(dobrostan ~ stres_c * wsparcie_c, data = dane)
summary(m2)
confint(m2)
anova(m1, m2)                                   # test zmiany R²
summary(m2)$r.squared - summary(m1)$r.squared   # ΔR²
standardize_parameters(m2, method = "refit")    # β: standaryzacja przed utworzeniem iloczynu

# Współliniowość bez centrowania i po centrowaniu
vif(lm(dobrostan ~ stres * wsparcie, data = dane), type = "terms")
vif(m2, type = "terms")
Wynik w R
Loading required package: carData
   stres wsparcie dobrostan
M   20.2     5.04     12.91
SD   6.5     1.07      4.82
          stres wsparcie dobrostan
stres      1.00    -0.28     -0.46
wsparcie  -0.28     1.00      0.48
dobrostan -0.46     0.48      1.00

Call:
lm(formula = dobrostan ~ stres_c * wsparcie_c, data = dane)

Residuals:
    Min      1Q  Median      3Q     Max
-10.662  -2.556  -0.059   2.590  13.591

Coefficients:
                   Estimate Std. Error t value Pr(>|t|)
(Intercept)        13.13434    0.23058  56.963  < 2e-16 ***
stres_c            -0.24321    0.03589  -6.776 6.65e-11 ***
wsparcie_c          1.81677    0.21886   8.301 3.71e-15 ***
stres_c:wsparcie_c  0.11593    0.03159   3.670 0.000288 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 3.846 on 296 degrees of freedom
Multiple R-squared:  0.3704,	Adjusted R-squared:  0.364
F-statistic: 58.04 on 3 and 296 DF,  p-value: < 2.2e-16

                         2.5 %     97.5 %
(Intercept)        12.68055579 13.5881182
stres_c            -0.31384396 -0.1725785
wsparcie_c          1.38605794  2.2474886
stres_c:wsparcie_c  0.05375546  0.1781037
Analysis of Variance Table

Model 1: dobrostan ~ stres_c + wsparcie_c
Model 2: dobrostan ~ stres_c * wsparcie_c
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    297 4578.6
2    296 4379.4  1    199.22 13.466 0.0002881 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1] 0.02864324
# Standardization method: refit

Parameter            | Std. Coef. |         95% CI
--------------------------------------------------
(Intercept)          |       0.05 | [-0.05,  0.14]
stres c              |      -0.33 | [-0.42, -0.23]
wsparcie c           |       0.40 | [ 0.31,  0.50]
stres c × wsparcie c |       0.17 | [ 0.08,  0.26]
there are higher-order terms (interactions) in this model
consider setting type = 'predictor'; see ?vif
         stres       wsparcie stres:wsparcie
     21.741308       9.756309      22.718913
there are higher-order terms (interactions) in this model
consider setting type = 'predictor'; see ?vif
           stres_c         wsparcie_c stres_c:wsparcie_c
          1.100540           1.101345           1.018809
2. Proste nachylenia i przedział Johnsona–Neymana
R
# Ten sam model na zmiennych surowych: b3 bez zmian, moderator w jednostkach skali 1–7
m2_surowy <- lm(dobrostan ~ stres * wsparcie, data = dane)
round(coef(summary(m2_surowy)), 3)

# Proste nachylenia przy M − 1 SD, M i M + 1 SD wsparcia oraz przedział Johnsona–Neymana
sim_slopes(m2_surowy, pred = stres, modx = wsparcie, johnson_neyman = TRUE,
           confint = TRUE, digits = 3)
jn <- johnson_neyman(m2_surowy, pred = stres, modx = wsparcie, plot = FALSE)
mean(dane$wsparcie > jn$bounds["Lower"])        # odsetek osób powyżej granicy J–N

# Nachylenia w wybranych punktach skali wsparcia (spotlight)
sim_slopes(m2_surowy, pred = stres, modx = wsparcie, modx.values = c(3, 5, 7),
           johnson_neyman = FALSE, confint = TRUE, digits = 3)
Wynik w R
               Estimate Std. Error t value Pr(>|t|)
(Intercept)      20.698      3.423   6.048    0.000
stres            -0.828      0.160  -5.190    0.000
wsparcie         -0.525      0.651  -0.807    0.421
stres:wsparcie    0.116      0.032   3.670    0.000
JOHNSON-NEYMAN INTERVAL

When wsparcie is OUTSIDE the interval [6.219, 9.857], the slope of stres is
p < .05.

Note: The range of observed values of wsparcie is [1.833, 7.000]

SIMPLE SLOPES ANALYSIS

Slope of stres when wsparcie = 3.976959 (- 1 SD):

    Est.    S.E.     2.5%    97.5%   t val.       p
-------- ------- -------- -------- -------- -------
  -0.367   0.047   -0.458   -0.275   -7.887   0.000

Slope of stres when wsparcie = 5.043611 (Mean):

    Est.    S.E.     2.5%    97.5%   t val.       p
-------- ------- -------- -------- -------- -------
  -0.243   0.036   -0.314   -0.173   -6.776   0.000

Slope of stres when wsparcie = 6.110263 (+ 1 SD):

    Est.    S.E.     2.5%    97.5%   t val.       p
-------- ------- -------- -------- -------- -------
  -0.120   0.052   -0.222   -0.018   -2.308   0.022

[1] 0.17
SIMPLE SLOPES ANALYSIS

Slope of stres when wsparcie = 3.000:

    Est.    S.E.     2.5%    97.5%   t val.       p
-------- ------- -------- -------- -------- -------
  -0.480   0.070   -0.619   -0.342   -6.819   0.000

Slope of stres when wsparcie = 5.000:

    Est.    S.E.     2.5%    97.5%   t val.       p
-------- ------- -------- -------- -------- -------
  -0.248   0.036   -0.319   -0.178   -6.941   0.000

Slope of stres when wsparcie = 7.000:

    Est.    S.E.     2.5%   97.5%   t val.       p
-------- ------- -------- ------- -------- -------
  -0.016   0.075   -0.163   0.131   -0.220   0.826
3. Moderator kategorialny
R
# Moderator kategorialny: tryb studiów (kodowanie 0–1, grupa odniesienia: stacjonarne)
m_tryb <- lm(dobrostan ~ stres_c * tryb, data = dane)
round(coef(summary(m_tryb)), 3)
sim_slopes(m_tryb, pred = stres_c, modx = tryb, johnson_neyman = FALSE,
           confint = TRUE, digits = 3)
Wynik w R
                           Estimate Std. Error t value Pr(>|t|)
(Intercept)                  12.865      0.307  41.902    0.000
stres_c                      -0.366      0.048  -7.566    0.000
trybniestacjonarne            0.102      0.524   0.194    0.847
stres_c:trybniestacjonarne    0.075      0.079   0.947    0.344
SIMPLE SLOPES ANALYSIS

Slope of stres_c when tryb = stacjonarne:

    Est.    S.E.     2.5%    97.5%   t val.       p
-------- ------- -------- -------- -------- -------
  -0.366   0.048   -0.461   -0.271   -7.566   0.000

Slope of stres_c when tryb = niestacjonarne:

    Est.    S.E.     2.5%    97.5%   t val.       p
-------- ------- -------- -------- -------- -------
  -0.291   0.063   -0.415   -0.167   -4.631   0.000
4. Wykresy, diagnostyka i analiza wrażliwości
R
# Wykres interakcji: punkty, proste nachylenia przy M − 1 SD, M, M + 1 SD i 95% CI
interact_plot(m2_surowy, pred = stres, modx = wsparcie, plot.points = TRUE,
              interval = TRUE, point.alpha = 0.4, x.label = "Stres (0–40)",
              y.label = "Dobrostan (0–25)", legend.main = "Wsparcie społeczne")

# Wykres Johnsona–Neymana: nachylenie stresu w całym zakresie wsparcia
johnson_neyman(m2_surowy, pred = stres, modx = wsparcie)$plot

# Diagnostyka reszt modelu: wykresy, wartości p testów założeń i największa odległość Cooka
library(performance)
check_model(m2, check = c("linearity", "homogeneity", "qq", "outliers"))
round(c(normalnosc_reszt = as.numeric(check_normality(m2)),
        heteroskedastycznosc = as.numeric(check_heteroscedasticity(m2))), 3)
round(max(cooks.distance(m2)), 3)

# Analiza wrażliwości: model bez obserwacji o odległości Cooka > 4/N
wplywowe <- cooks.distance(m2) > 4 / nrow(dane)
sum(wplywowe)
round(coef(summary(update(m2, subset = !wplywowe))), 3)
Wynik w R
    normalnosc_reszt heteroskedastycznosc
               0.974                0.387
[1] 0.06
[1] 15
                   Estimate Std. Error t value Pr(>|t|)
(Intercept)          13.190      0.216  61.152        0
stres_c              -0.218      0.035  -6.287        0
wsparcie_c            1.869      0.213   8.795        0
stres_c:wsparcie_c    0.125      0.031   3.979        0
5. Symulacja mocy testu interakcji
R
# Moc wykrycia interakcji: b3 = 0.12 (jak w przykładzie) i b3 = 0.06 (o połowę słabsza)
moc_interakcji <- function(n, b3, powtorzen = 2000) {
  p <- replicate(powtorzen, {
    w <- rnorm(n)
    s <- -0.3 * w + sqrt(0.91) * rnorm(n)
    st <- 20 + 6.5 * s
    ws <- 5.1 + 1.1 * w
    y <- 13 - 0.25 * (st - 20) + 1.8 * (ws - 5) + b3 * (st - 20) * (ws - 5) + rnorm(n, sd = 4)
    summary(lm(y ~ st * ws))$coefficients[4, 4]
  })
  mean(p < .05)
}
set.seed(2026)
N <- c(100, 200, 300, 400, 600, 800, 1200)
data.frame(N,
           moc_b3_0.12 = sapply(N, moc_interakcji, b3 = 0.12),
           moc_b3_0.06 = sapply(N, moc_interakcji, b3 = 0.06))
Wynik w R
     N moc_b3_0.12 moc_b3_0.06
1  100      0.5500      0.1830
2  200      0.8615      0.3470
3  300      0.9570      0.4910
4  400      0.9890      0.6045
5  600      0.9985      0.7660
6  800      1.0000      0.8735
7 1200      1.0000      0.9635
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2 (panel diagnostyczny – w pakietach performance, see i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- interactions (wersja 1.2.0): Long, J. A. (2024). interactions: Comprehensive, user-friendly toolkit for probing interactions [R package]. https://doi.org/10.32614/CRAN.package.interactions
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- performance (wersja 0.16.0): Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- see (wersja 0.13.0): Lüdecke, D., Patil, I., Ben-Shachar, M. S., Wiernik, B. M., Waggoner, P., & Makowski, D. (2021). see: An R package for visualizing statistical models. Journal of Open Source Software, 6(64), 3393. https://doi.org/10.21105/joss.03393
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w analizie moderacji
- Odczytywanie b1 jako „efektu głównego” w modelu bez centrowania. Bez centrowania b1 to efekt X przy W = 0, czyli często przy wartości spoza skali (w przykładzie −0.83 zamiast −0.24).
- Zatrzymanie się na istotnym b3. Bez prostych nachyleń, regionu Johnsona–Neymana i wykresu nie wiadomo, jaki kształt ma interakcja ani przy jakich wartościach moderatora efekt X jest istotny.
- Wykres bez danych i bez przedziałów ufności. Same linie przesadnie upraszczają wynik (McCabe i in., 2018).
- Mechaniczne ±1 SD. Lepiej wybrać wartości o znaczeniu merytorycznym albo podać region Johnsona–Neymana (Spiller i in., 2013).
- Dzielenie moderatora medianą zamiast modelu z interakcją zmiennej ciągłej.
- Wniosek „moderacji nie ma”, bo p > .05. Przy niskiej mocy typowej dla testów interakcji (Sommet i in., 2023) brak istotności niewiele dowodzi – patrz na przedział ufności b3 i opisz moc.
- Testowanie wielu moderatorów i raportowanie tylko istotnych. To p-hacking, a hipoteza dopisana po poznaniu wyników to HARKing. Zaplanuj moderatory przed analizą.
- Język przyczynowy w badaniu korelacyjnym. „Wsparcie chroni przed stresem” to interpretacja; dane przekrojowe pokazują tylko, że związek stresu z dobrostanem zmienia się wraz z poziomem wsparcia. Rohrer i in. (2022) wyjaśniają, że standardowe procedury analizy moderacji i mediacji prowadzą do trafnych wniosków przyczynowych tylko w ograniczonych warunkach.
- Mylenie moderacji z mediacją. Moderator nie musi korelować ani z X, ani z Y – ważne jest, czy zmienia związek między nimi. Mediator ma leżeć na drodze od X do Y.
Najczęstsze pytania
Co to jest analiza moderacji?
To sprawdzenie, czy związek zmiennej X z wynikiem Y zależy od poziomu trzeciej zmiennej – moderatora W. W regresji testuje się ją, dodając do modelu iloczyn XW: jego współczynnik b3 mówi, o ile zmienia się nachylenie X, gdy W rośnie o jednostkę. Moderacja odpowiada na pytania „kiedy?” i „dla kogo?” – zob. hasło moderacja.
Czym różni się moderacja od mediacji?
Moderator zmienia siłę lub kierunek związku X z Y (pytanie „kiedy?”), a mediator przenosi wpływ X na Y (pytanie „dlaczego?”). Moderację testuje współczynnik iloczynu XW, a mediację – efekt pośredni a × b z bootstrapowym przedziałem ufności. Ta sama zmienna może pełnić różne role w różnych hipotezach.
Czy w analizie moderacji trzeba centrować zmienne?
Nie jest to konieczne do testu interakcji: centrowanie nie zmienia b3, jego wartości p ani R². Zmienia natomiast znaczenie b1 i b2 – po centrowaniu są to efekty przy średniej drugiej zmiennej – i obniża VIF iloczynu (w przykładzie z 22.72 do 1.02). Dlatego centrowanie zaleca się dla czytelności wyników.
Co zrobić, gdy interakcja jest istotna?
Sprawdź proste nachylenia, czyli efekt X przy wybranych wartościach moderatora (np. M − 1 SD, M, M + 1 SD albo wartości ważne merytorycznie), oraz przedział Johnsona–Neymana, który pokazuje, przy jakich wartościach moderatora efekt X jest istotny. Narysuj interakcję z danymi i przedziałami ufności. W R zrobisz to funkcjami sim_slopes() i interact_plot() z pakietu interactions.
Jak zrobić analizę moderacji w SPSS?
Najprościej makrem PROCESS (model 1): Y – zmienna zależna, X – predyktor, W – moderator; w opcjach włącz centrowanie zmiennych tworzących iloczyn i wyniki Johnsona–Neymana. Bez PROCESS oblicz iloczyn wycentrowanych zmiennych i wprowadź go do regresji liniowej w drugim bloku, zaznaczając zmianę R².
Ile osób potrzeba do analizy moderacji?
Zwykle więcej niż do wykrycia pojedynczego związku, bo interakcje są małe. W symulacji z tego poradnika interakcję taką jak w przykładzie (ΔR² = .03 w próbie) wykrywało z mocą .86 badanie z udziałem 200 osób, ale interakcja o połowę słabsza wymagała około 800 osób. Moc zaplanuj przed badaniem – symulacją albo w programie G*Power.
Powiązane hasła
Przeczytaj też
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikDobór liczebności próby: moc, precyzja i uzasadnienie badania
Jak dobrać liczebność próby? Moc testu, precyzja, symulacja, przewidywane braki danych i zasady rzetelnego uzasadnienia liczby uczestników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage.
- Bauer, D. J., & Curran, P. J. (2005). Probing interactions in fixed and multilevel regression: Inferential and graphical techniques. Multivariate Behavioral Research, 40(3), 373–400. https://doi.org/10.1207/s15327906mbr4003_5 ● Otwarty dostęp
- Dawson, J. F. (2014). Moderation in management research: What, why, when, and how. Journal of Business and Psychology, 29(1), 1–19. https://doi.org/10.1007/s10869-013-9308-7 ● Otwarty dostęp: pełny tekst
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Hayes, A. F., & Rockwood, N. J. (2017). Regression-based statistical mediation and moderation analysis in clinical research: Observations, recommendations, and implementation. Behaviour Research and Therapy, 98, 39–57. https://doi.org/10.1016/j.brat.2016.11.001
- Johnson, P. O., & Neyman, J. (1936). Tests of certain linear hypotheses and their application to some educational problems. Statistical Research Memoirs, 1, 57–93.
- Long, J. A. (2024). interactions: Comprehensive, user-friendly toolkit for probing interactions (Version 1.2.0) [R package]. The Comprehensive R Archive Network (CRAN). https://doi.org/10.32614/CRAN.package.interactions ● Otwarty dostęp
- McCabe, C. J., Kim, D. S., & King, K. M. (2018). Improving present practices in the visual display of interactions. Advances in Methods and Practices in Psychological Science, 1(2), 147–165. https://doi.org/10.1177/2515245917746792 ● Otwarty dostęp: pełny tekst
- Memon, M. A., Cheah, J.-H., Ramayah, T., Ting, H., Chuah, F., & Cham, T. H. (2019). Moderation analysis: Issues and guidelines. Journal of Applied Structural Equation Modeling, 3(1), i–xi. https://doi.org/10.47263/JASEM.3(1)01 ● Otwarty dostęp
- Preacher, K. J., Curran, P. J., & Bauer, D. J. (2006). Computational tools for probing interactions in multiple linear regression, multilevel modeling, and latent curve analysis. Journal of Educational and Behavioral Statistics, 31(4), 437–448. https://doi.org/10.3102/10769986031004437 ● Otwarty dostęp: pełny tekst
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Sommet, N., Weissman, D. L., Cheutin, N., & Elliot, A. J. (2023). How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction. Advances in Methods and Practices in Psychological Science, 6(3), Article 25152459231178728. https://doi.org/10.1177/25152459231178728 ● Otwarty dostęp
- Sosnowski, T. (2010). Analiza interakcji zmiennych kategorialnych i ciągłych. Psychologia Społeczna, 5(2–3), 162–190. https://www.ceeol.com/search/article-detail?id=229293 ● Otwarty dostęp
- Spiller, S. A., Fitzsimons, G. J., Lynch, J. G., Jr., & McClelland, G. H. (2013). Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression. Journal of Marketing Research, 50(2), 277–288. https://doi.org/10.1509/jmr.12.0420
Cytowania BibTeX
@book{aiken1991multiple, author={Aiken, Leona S. and West, Stephen G.}, title={{Multiple regression: Testing and interpreting interactions}}, year={1991}, publisher={Sage}}@article{bauer2005probing, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Probing interactions in fixed and multilevel regression: Inferential and graphical techniques}}, journal={Multivariate Behavioral Research}, year={2005}, volume={40}, number={3}, pages={373--400}, doi={10.1207/s15327906mbr4003_5}}@article{dawson2014moderation, author={Dawson, Jeremy F.}, title={{Moderation in management research: What, why, when, and how}}, journal={Journal of Business and Psychology}, year={2014}, volume={29}, number={1}, pages={1--19}, doi={10.1007/s10869-013-9308-7}}@book{hayes2022introduction, author={Hayes, Andrew F.}, title={{Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.)}}, year={2022}, publisher={Guilford Press}, url={https://www.guilford.com/books/Introduction-to-Mediation-Moderation-and-Conditional-Process-Analysis/Andrew-Hayes/9781462549030}}@article{hayes2017regression, author={Hayes, Andrew F. and Rockwood, Nicholas J.}, title={{Regression-based statistical mediation and moderation analysis in clinical research: Observations, recommendations, and implementation}}, journal={Behaviour Research and Therapy}, year={2017}, volume={98}, pages={39--57}, doi={10.1016/j.brat.2016.11.001}}@article{johnson1936tests, author={Johnson, Palmer O. and Neyman, Jerzy}, title={{Tests of certain linear hypotheses and their application to some educational problems}}, journal={Statistical Research Memoirs}, year={1936}, volume={1}, pages={57--93}}@misc{long2024interactions, author={Long, Jacob A.}, title={{interactions: Comprehensive, user-friendly toolkit for probing interactions (R package version 1.2.0) [Computer software]}}, year={2024}, publisher={The Comprehensive R Archive Network (CRAN)}, doi={10.32614/cran.package.interactions}}@article{mccabe2018improving, author={McCabe, Connor J. and Kim, Dale S. and King, Kevin M.}, title={{Improving present practices in the visual display of interactions}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={147--165}, doi={10.1177/2515245917746792}}@article{memon2019moderation, author={Memon, Mumtaz Ali and Cheah, Jun-Hwa and Ramayah, T. and Ting, Hiram and Chuah, Francis and Cham, Tat Huei}, title={{Moderation analysis: Issues and guidelines}}, journal={Journal of Applied Structural Equation Modeling}, year={2019}, volume={3}, number={1}, pages={i--xi}, doi={10.47263/jasem.3(1)01}}@article{preacher2006computational, author={Preacher, Kristopher J. and Curran, Patrick J. and Bauer, Daniel J.}, title={{Computational tools for probing interactions in multiple linear regression, multilevel modeling, and latent curve analysis}}, journal={Journal of Educational and Behavioral Statistics}, year={2006}, volume={31}, number={4}, pages={437--448}, doi={10.3102/10769986031004437}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{sommet2023how, author={Sommet, Nicolas and Weissman, David L. and Cheutin, Nicolas and Elliot, Andrew J.}, title={{How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction}}, journal={Advances in Methods and Practices in Psychological Science}, year={2023}, volume={6}, number={3}, eid={25152459231178728}, doi={10.1177/25152459231178728}}@article{sosnowski2010analiza, author={Sosnowski, Tytus}, title={{Analiza interakcji zmiennych kategorialnych i ciągłych}}, journal={Psychologia Społeczna}, year={2010}, volume={5}, number={2–3}, pages={162--190}, url={https://www.ceeol.com/search/article-detail?id=229293}}@article{spiller2013spotlights, author={Spiller, Stephen A. and Fitzsimons, Gavan J. and Lynch, Jr., John G. and McClelland, Gary H.}, title={{Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression}}, journal={Journal of Marketing Research}, year={2013}, volume={50}, number={2}, pages={277--288}, doi={10.1509/jmr.12.0420}}