Moderacja w jamovi: trzy drogi do tego samego modelu
Moderacja to sytuacja, w której związek predyktora z wynikiem zależy od wartości trzeciej zmiennej. W regresji sprawdza się ją interakcją, czyli iloczynem predyktora i moderatora (Aiken i West, 1991). Teorię, hipotezy i diagnostykę opisuje poradnik analiza moderacji krok po kroku. Tutaj pokazujemy tylko obsługę jamovi, w którym ten sam model policzysz na trzy sposoby.
| Cecha | Regression → Linear Regression | medmod → Moderation | GAMLj3 → General Linear Model |
|---|---|---|---|
| Skąd | wbudowana w jamovi | moduł z biblioteki | moduł z biblioteki |
| Interakcja | dodajesz w Model Builder | tworzona automatycznie z pól Predictor i Moderator | dodajesz na karcie Model |
| Centrowanie | brak – zrób zmienną obliczaną | zawsze: wszystkie zmienne, także zależna | domyślnie Centered dla zmiennych ciągłych |
| Estymacja i test | MNK, test t | największa wiarygodność (lavaan), test Z | MNK (lm()), test t |
| Proste nachylenia | brak; średnie brzegowe przy M ± 1 SD | Simple Slope Estimates przy M − 1 SD, M, M + 1 SD | Simple Effects: domyślnie M ± 1 SD, także percentyle |
| Johnson–Neyman | nie | nie | Johnson-Neyman plot |
| Moderator kategorialny | tak (Factors) | nie – tylko zmienne liczbowe | tak (Factors) |
Źródła tabeli: dokumentacja jamovi i pliki definicji analizy Linear Regression (The jamovi project, b.d.-a, b.d.-c), pliki modułu medmod (Selker, 2026) oraz dokumentacja i repozytorium GAMLj (Gallucci, b.d.). Moduły instaluje się z biblioteki (Modules → jamovi library); krok po kroku pokazuje to wpis mediacja w jamovi. Moduły nie mają polskich etykiet w repozytoriach, więc nazwy podajemy po angielsku; w polskiej wersji samego jamovi nazwy menu mogą się różnić.
Liczby policzyliśmy w R: tabele Linear Regression pakietem jmv (silnik analiz jamovi), a proste nachylenia i przedział Johnsona–Neymana pakietami interactions i emmeans. Modułów medmod i GAMLj tu nie uruchamialiśmy – ich opcje opisujemy z dokumentacji.
Przykład i pliki do pobrania
Fikcyjna ankieta 220 osób studiujących (dane symulowane):
stres– stres akademicki, średnia z pozycji 1–5 (X, predyktor), M = 3.15, SD = 0.77;ruch– aktywność fizyczna w godzinach tygodniowo, 0.5–12 (W, moderator), M = 4.03, SD = 2.28;dobrostan– średnia 1–7 (Y, zmienna zależna), M = 4.50, SD = 0.99.
Pobierz plik CSV albo plik .sav z etykietami. Hipoteza: im więcej ruchu, tym słabszy ujemny związek stresu z dobrostanem. Ziarno losowania (set.seed(5487)) dobraliśmy tak, żeby granica Johnsona–Neymana wypadła w zakresie danych. Sprawdź, czy wszystkie trzy zmienne mają typ Continuous – jak to zrobić, pokazuje wpis przygotowanie danych w jamovi.
Centrowanie: kiedy robić je ręcznie
W modelu z interakcją współczynnik stresu to jego efekt przy zerowej wartości moderatora. Zero godzin ruchu leży na skraju danych, a zero stresu – poza skalą 1–5. Po centrowaniu zero oznacza średnią, więc efekty główne stają się efektami „przy przeciętnym poziomie drugiej zmiennej” (Aiken i West, 1991). Współczynnik interakcji, jego test i R² się nie zmieniają.
medmod centruje zawsze, GAMLj domyślnie. W Linear Regression utwórz dwie zmienne obliczane (Compute) z formułami stres - VMEAN(stres) i ruch - VMEAN(ruch). Funkcja VMEAN zwraca średnią całej kolumny, a MEAN – średnią w wierszu (The jamovi project, b.d.-b). Iloczynu nie licz ręcznie: interakcję doda Model Builder.
Droga 1: Linear Regression z interakcją
- Wybierz Analyses → Regression → Linear Regression. Przenieś
dobrostando Dependent Variable, astresiruchdo Covariates (The jamovi project, b.d.-a). Resztę okna opisuje wpis korelacja i regresja w jamovi. - Rozwiń Model Builder. W Block 1 zostaw
stresiruch. Kliknij Add New Block, zaznacz obie zmienne na liście Predictors i przenieś je do Block 2 jako interakcję – przenoszenie do bloku obsługuje wyrazy interakcji (The jamovi project, b.d.-c). - W Model Fit zaznacz Adjusted R² i F test (Overall Model Test), a w Model Coefficients pod Estimate – Confidence interval.
Dwa bloki dają tabelę Model Comparisons – przyrost R² po dodaniu interakcji, czyli odpowiednik „R2-chng” z PROCESS:
| Model | ΔR² | F | df1 | df2 | p | ||
|---|---|---|---|---|---|---|---|
| 1 | − | 2 | 0.042 | 10.757 | 1 | 216 | 0.001 |
| Predictor | Estimate | SE | 95% Confidence Interval | t | p | |
|---|---|---|---|---|---|---|
| Lower | Upper | |||||
| Intercept | 7.092 | 0.582 | 5.944 | 8.239 | 12.182 | < .001 |
| stres | −0.888 | 0.175 | −1.232 | −0.544 | −5.082 | < .001 |
| ruch | −0.344 | 0.129 | −0.598 | −0.090 | −2.671 | 0.008 |
| stres:ruch | 0.125 | 0.038 | 0.050 | 0.199 | 3.280 | 0.001 |
Jak czytać. Interakcja b = 0.125: każda dodatkowa godzina ruchu tygodniowo zmniejsza ujemne nachylenie stresu o 0.125 punktu. Interakcja dodała 4.2% wyjaśnionej wariancji (R² wzrósł z .108 do .151). Wierszy stres i ruch nie interpretuj jako „efektów głównych”. −0.888 to efekt stresu przy zerze godzin ruchu, a ujemne −0.344 dla ruchu to efekt przy stresie równym 0, którego nie ma na skali. Do takiego błędu prowadzi brak centrowania.
Nazwy wierszy podajemy tak, jak wypisuje je pakiet jmv; w oknie jamovi znak łączący zmienne w interakcji może wyglądać inaczej. Na zmiennych wycentrowanych interakcja i jej p są identyczne, ale wiersze efektów głównych zmieniają sens:
| Predictor | Estimate | SE | 95% Confidence Interval | t | p | |
|---|---|---|---|---|---|---|
| Lower | Upper | |||||
| Intercept | 4.488 | 0.062 | 4.366 | 4.610 | 72.595 | < .001 |
| stres_c | −0.386 | 0.081 | −0.545 | −0.227 | −4.775 | < .001 |
| ruch_c | 0.049 | 0.028 | −0.006 | 0.103 | 1.748 | 0.082 |
| stres_c:ruch_c | 0.125 | 0.038 | 0.050 | 0.199 | 3.280 | 0.001 |
Teraz −0.386 to efekt stresu przy przeciętnym ruchu (4.03 h), a 0.049 – efekt ruchu przy przeciętnym stresie. Takie same oszacowania dadzą medmod i GAMLj, bo też centrują predyktory. Linear Regression nie ma tabeli prostych nachyleń. Część Estimated Marginal Means z wyrazem stres_c:ruch_c pokaże przewidywane średnie przy średniej oraz średniej ± 1 SD obu zmiennych (The jamovi project, b.d.-c). Przy ruchu −1 SD przewidywany dobrostan spada z 4.891 (stres −1 SD) do 3.863 (stres +1 SD), a przy ruchu +1 SD – tylko z 4.676 do 4.521. To opis interakcji, ale bez testu nachyleń.
Droga 2: medmod → Moderation
Moduł medmod (autor: Ravi Selker) dodaje menu medmod z pozycjami Mediation i Moderation. W Moderation wpisz dobrostan w Dependent Variable, stres w Predictor, a ruch w Moderator. Kolejność ma znaczenie: proste nachylenia dotyczą predyktora przy poziomach moderatora. Opcje według plików definicji modułu (Selker, 2026):
- Estimation Method for SE's: Standard (domyślnie, metoda delta) albo Bootstrap z liczbą prób (domyślnie 1000);
- Estimates: Labels (b₁, b₂, b₃), Test statistics (kolumny Z i p, domyślnie włączone), Confidence interval (domyślnie wyłączony – włącz);
- Simple Slope Analysis: Estimates i Plot (oba domyślnie wyłączone – włącz);
- Additional Output: Path diagram.
Tabela Moderation Estimates ma trzy wiersze: predyktor (b₁), moderator (b₂) i ich iloczyn (b₃), z kolumnami Estimate, SE, przedziałem, Z i p. Wyrazu wolnego nie ma, bo moduł przed dopasowaniem centruje wszystkie zmienne, także zależną i sam iloczyn. Oszacowania b₁ = −0.386, b₂ = 0.049 i b₃ = 0.125 są takie jak w tabeli z centrowaniem wyżej. Model jest jednak dopasowywany w lavaan metodą największej wiarygodności z testem Z (Selker, 2026). Błędy standardowe i p mogą się więc minimalnie różnić od regresji MNK.
Tabela Simple Slope Estimates ma wiersze Average, Low (-1SD) i High (+1SD): proste nachylenia stresu przy średnim ruchu i ± 1 SD. Wartości z regresji MNK:
| Ruch (godz./tydz.) | Wiersz w medmod | Nachylenie | SE | 95% CI | t(216) | p |
|---|---|---|---|---|---|---|
| M − 1 SD = 1.75 | Low (-1SD) | −0.671 | 0.120 | [−0.907, −0.434] | −5.59 | < .001 |
| M = 4.03 | Average | −0.386 | 0.081 | [−0.545, −0.227] | −4.78 | < .001 |
| M + 1 SD = 6.31 | High (+1SD) | −0.101 | 0.117 | [−0.332, 0.130] | −0.86 | .389 |
Przy małej aktywności stres wiąże się wyraźnie z niższym dobrostanem, przy dużej – nie widać tego związku. medmod liczy wariancję moderatora w lavaan i podaje test Z, więc jego liczby mogą się różnić w trzecim miejscu po przecinku. Przedziału Johnsona–Neymana moduł nie oferuje.
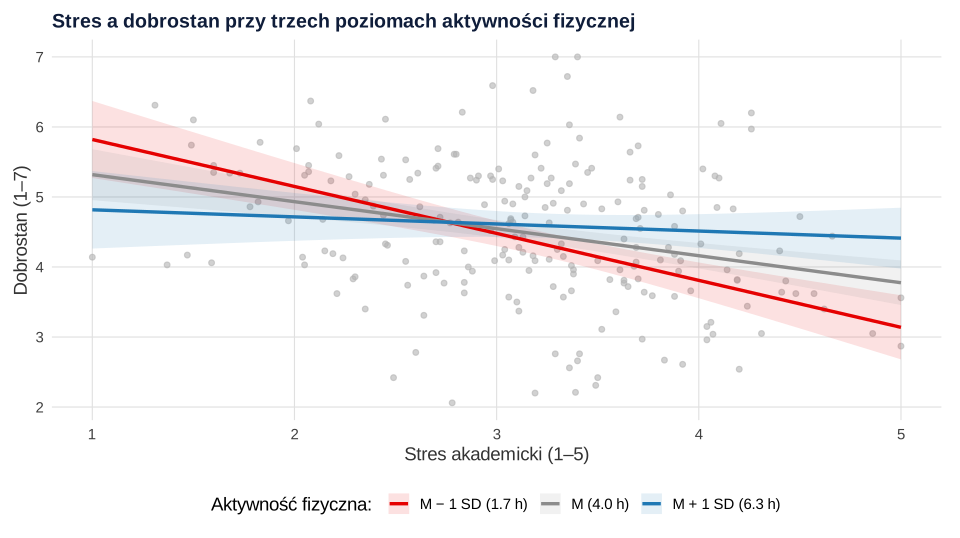
ruch w Separate lines. Obliczenia: R, lm (dane symulowane, N = 220).Pokazanie danych i niepewności to zasada dobrego wykresu interakcji – same trzy linie sugerują większą pewność, niż daje próba.
Droga 3: GAMLj – proste efekty i wykres
Moduł GAMLj3 (autor: Marcello Gallucci) dodaje w menu Linear Models podgrupę GAMLj3 z analizą General Linear Model. Model szacuje funkcją lm(), więc daje te same liczby co regresja MNK (Gallucci, b.d.). Krok po kroku:
dobrostando Dependent Variable,stresiruchdo Covariates.- Na karcie Model dodaj interakcję. Przy dwóch zmiennych ciągłych domyślny model ma tylko efekty główne – zaznacz obie zmienne i dodaj je jako interakcję do Model Terms.
- Covariates Scaling: zostaw Centered (domyślne). Tu też ustawisz Covariates conditioning – Mean ± SD (domyślnie 1 SD) albo Percentiles 50 ± offset.
- Simple Effects:
stresw Simple effects variable,ruchw Moderators. - Plots:
stresw Horizontal axis,ruchw Separate lines; zaznacz Johnson-Neyman plot.
Główna tabela Parameter Estimates (Coefficients) ma kolumny Effect, Estimate, SE, Lower, Upper, β, df, t, p. Wartości odpowiadają tabeli z centrowaniem wyżej; kolumny β nie odtwarzaliśmy. Proste efekty trafiają do dwóch tabel: ANOVA for Simple Effects of stres (test F) i Parameter Estimates for simple effects of stres (nachylenia z SE, przedziałem i t). Przy ustawieniach domyślnych powinny to być nachylenia z tabeli prostych nachyleń wyżej (ten sam model lm() i test t). GAMLj ma też moderatory kategorialne – wtedy proste efekty liczy osobno dla każdej grupy (por. interakcja w ANOVA). Moduł obsługuje również modele mieszane, opisane we wpisie model mieszany w jamovi (GAMLj).
Wykres Johnsona–Neymana
Nachylenia przy ± 1 SD to tylko trzy arbitralne punkty. Technika Johnsona–Neymana wyznacza cały zakres moderatora, w którym prosty efekt jest istotny (Bauer i Curran, 2005). Spiller i in. (2013) zalecają raportować proste efekty przy merytorycznie ważnych wartościach moderatora. Gdy takich wartości nie ma – podawać zakres istotności zamiast rutynowego ± 1 SD.
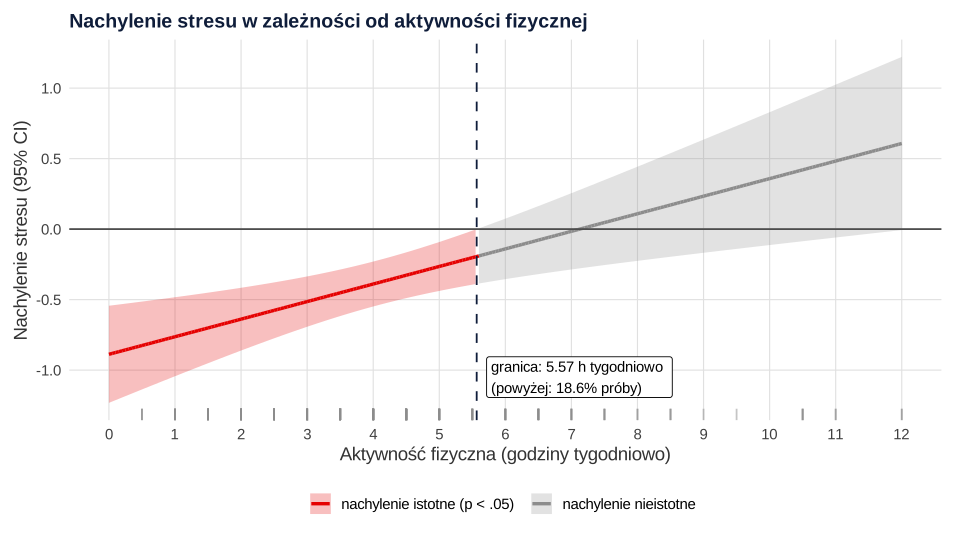
Ujemny związek stresu z dobrostanem jest istotny (p < .05) przy aktywności poniżej 5.57 h tygodniowo. Powyżej tej granicy przedział obejmuje zero; w tym zakresie jest 18.6% próby. Górna granica wyliczona w R (12.13 h) leży poza danymi, więc jej nie interpretuj. Brak istotności przy dużym ruchu nie dowodzi, że stres „przestaje działać”. Danych jest tam mało i przedział jest szeroki. Przedział Johnsona–Neymana sprawdzisz też w kalkulatorze efektów prostych. Dokumentacja GAMLj opisuje wykres, a nie tabelę z granicami (Gallucci, b.d.), więc liczbę do pracy odczytaj z R albo z kalkulatora.
Odpowiedniki PROCESS (model 1) w jamovi
Jeśli promotor zna wydruk PROCESS z SPSS (mediacja i moderacja w SPSS z PROCESS), ta tabela pokazuje, co odpowiada czemu:
| PROCESS (model 1) | Linear Regression | medmod | GAMLj |
|---|---|---|---|
wiersz Int_1 | wiersz interakcji w Model Coefficients | wiersz b₃ w Moderation Estimates | wiersz interakcji w Parameter Estimates |
center=1 | zmienne obliczane z VMEAN | zawsze | Covariates Scaling: Centered |
R2-chng interakcji | ΔR² w Model Comparisons (dwa bloki) | – | – |
efekty warunkowe (domyślnie 16., 50., 84. percentyl; moments=1: M ± 1 SD) | – | Simple Slope Estimates (M ± 1 SD) | Simple Effects (Mean ± SD albo Percentiles 50 ± offset) |
jn=1 | – | – | Johnson-Neyman plot (wykres) |
Myślnik oznacza, że w opisanych plikach definicji i dokumentacji nie znaleźliśmy takiej opcji. Mediację moderowaną (model 7 PROCESS) liczy moduł jAMM – zobacz mediację w jamovi i moderowaną mediację w R.
Zapis wyników w stylu APA
Wzór do dostosowania (liczby z tabel wyżej):
W części „Metoda” podaj analizę i moduł z wersją, sposób centrowania i wartości moderatora. Tabelę zbudujesz według hasła tabela regresji w APA, a zdanie sprawdzisz w generatorze opisu wyników APA. Interakcje mają zwykle niską moc – zanim zaplanujesz badanie, przeczytaj wpis o mocy testu dla interakcji.
To samo w R (jmv, interactions, emmeans)
Pakiet jmv zawiera analizy jamovi, więc funkcja linReg() z argumentem blocks daje te same tabele co okno Linear Regression. Proste nachylenia i przedział Johnsona–Neymana liczą funkcje sim_slopes() i johnson_neyman() z pakietu interactions; emtrends() z emmeans daje te same nachylenia z przedziałami ufności.
1. Dane do pobrania: CSV i .sav
R
# Moderacja w jamovi – fikcyjne dane do pobrania (dane symulowane)
# 220 osób studiujących: stres akademicki (X, średnia 1–5), aktywność fizyczna
# (W, godziny tygodniowo) i dobrostan (Y, średnia 1–7). Ziarno dobrano tak,
# żeby granica Johnsona–Neymana wypadła w zakresie danych.
suppressPackageStartupMessages(library(haven))
set.seed(5487)
n <- 220
ruch <- pmin(12, pmax(0, round(rgamma(n, shape = 3, scale = 1.4) * 2) / 2))
stres <- pmin(5, pmax(1, round(rnorm(n, 3.1, 0.8), 2)))
dobrostan <- 4.5 - 0.50 * (stres - 3.1) + 0.07 * (ruch - 4.2) +
  0.13 * (stres - 3.1) * (ruch - 4.2) + rnorm(n, 0, 0.95)
dane <- data.frame(id = 1:n, stres, ruch,
                   dobrostan = pmin(7, pmax(1, round(dobrostan, 2))))
write.csv(dane, "moderacja-jamovi-dane.csv", row.names = FALSE)

# Ten sam zbiór w formacie .sav z etykietami zmiennych
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$stres <- labelled(sav$stres, label = "Stres akademicki (1–5)")
sav$ruch <- labelled(sav$ruch, label = "Aktywność fizyczna – godziny tygodniowo")
sav$dobrostan <- labelled(sav$dobrostan, label = "Dobrostan (1–7)")
write_sav(sav, "moderacja-jamovi-dane.sav")

# Kontrola: statystyki opisowe i korelacje
opis <- sapply(dane[, -1], function(x) c(n = length(x), M = mean(x), SD = sd(x),
                                          min = min(x), max = max(x)))
print(round(t(opis), 2))
cat("\nKorelacje:\n")
print(round(cor(dane[, -1]), 2))
Wynik w R
            n    M   SD  min max
stres     220 3.15 0.77 1.00   5
ruch      220 4.03 2.28 0.50  12
dobrostan 220 4.50 0.99 2.06   7

Korelacje:
          stres ruch dobrostan
stres      1.00 0.04     -0.29
ruch       0.04 1.00      0.15
dobrostan -0.29 0.15      1.00
2. Linear Regression z interakcją (jmv)
R
# Regression → Linear Regression z interakcją (pakiet jmv – silnik analiz jamovi)
library(jmv)
dane <- read.csv("moderacja-jamovi-dane.csv")

# A. Zmienne surowe; blok 1: efekty główne, blok 2: dodana interakcja stres × ruch
linReg(data = dane, dep = "dobrostan", covs = c("stres", "ruch"),
       blocks = list(list("stres", "ruch"),
                     list(c("stres", "ruch"))),
       r2Adj = TRUE, modelTest = TRUE, ci = TRUE)

# B. Zmienne wycentrowane – odpowiednik formuł Compute: stres - VMEAN(stres), ruch - VMEAN(ruch)
dane$stres_c <- dane$stres - mean(dane$stres)
dane$ruch_c  <- dane$ruch - mean(dane$ruch)
linReg(data = dane, dep = "dobrostan", covs = c("stres_c", "ruch_c"),
       blocks = list(list("stres_c", "ruch_c", c("stres_c", "ruch_c"))),
       ci = TRUE, emMeans = ~ stres_c:ruch_c, emmTables = TRUE, emmPlots = FALSE)
Wynik w R
 LINEAR REGRESSION

 Model Fit Measures
 ─────────────────────────────────────────────────────────────────────────────────────────
   Model    R            R²           Adjusted R²    F           df1    df2    p
 ─────────────────────────────────────────────────────────────────────────────────────────
       1    0.3292176    0.1083842      0.1001665    13.18919      2    217    0.0000039
       2    0.3881758    0.1506804      0.1388843    12.77375      3    216    0.0000001
 ─────────────────────────────────────────────────────────────────────────────────────────
   Note. Models estimated using sample size of N=220


 Model Comparisons
 ────────────────────────────────────────────────────────────────────────────
   Model         Model    ΔR²           F           df1    df2    p
 ────────────────────────────────────────────────────────────────────────────
       1    -        2    0.04229624    10.75683      1    216    0.0012111
 ────────────────────────────────────────────────────────────────────────────


 MODEL SPECIFIC RESULTS

 MODEL 1

 Model Coefficients - dobrostan
 ──────────────────────────────────────────────────────────────────────────────────────────────────
   Predictor    Estimate       SE            Lower          Upper         t            p
 ──────────────────────────────────────────────────────────────────────────────────────────────────
   Intercept     5.41692705    0.28582627     4.85357595     5.9802781    18.951816    < .0000001
   stres        -0.37976004    0.08258185    -0.54252526    -0.2169948    -4.598590     0.0000072
   ruch          0.06895702    0.02772022     0.01432168     0.1235924     2.487607     0.0136135
 ──────────────────────────────────────────────────────────────────────────────────────────────────


 MODEL 2

 Model Coefficients - dobrostan
 ───────────────────────────────────────────────────────────────────────────────────────────────────
   Predictor     Estimate      SE            Lower          Upper          t            p
 ───────────────────────────────────────────────────────────────────────────────────────────────────
   Intercept      7.0915375    0.58213635     5.94414236     8.23893256    12.181918    < .0000001
   stres         -0.8879222    0.17473508    -1.23232634    -0.54351805    -5.081534     0.0000008
   ruch          -0.3442464    0.12887115    -0.59825236    -0.09024034    -2.671244     0.0081326
   stres:ruch     0.1246007    0.03799080     0.04972059     0.19948089     3.279761     0.0012111
 ───────────────────────────────────────────────────────────────────────────────────────────────────


 LINEAR REGRESSION

 Model Fit Measures
 ───────────────────────────────────
   Model    R            R²
 ───────────────────────────────────
       1    0.3881758    0.1506804
 ───────────────────────────────────
   Note. Models estimated using
   sample size of N=220


 MODEL SPECIFIC RESULTS

 MODEL 1

 Model Coefficients - dobrostan
 ────────────────────────────────────────────────────────────────────────────────────────────────────────
   Predictor         Estimate       SE            Lower           Upper         t            p
 ────────────────────────────────────────────────────────────────────────────────────────────────────────
   Intercept          4.48783437    0.06182042     4.365985870     4.6096829    72.594696    < .0000001
   stres_c           -0.38583786    0.08080691    -0.545108889    -0.2265668    -4.774812     0.0000033
   ruch_c             0.04861977    0.02781722    -0.006208181     0.1034477     1.747830     0.0819144
   stres_c:ruch_c     0.12460074    0.03799080     0.049720590     0.1994809     3.279761     0.0012111
 ────────────────────────────────────────────────────────────────────────────────────────────────────────


 ESTIMATED MARGINAL MEANS

 STRES_C:RUCH_C

 Estimated Marginal Means - stres_c:ruch_c
 ───────────────────────────────────────────────────────────────────────────────────────
   ruch_c          stres_c         Marginal Mean    SE            Lower       Upper
 ───────────────────────────────────────────────────────────────────────────────────────
      -2.284610      -0.7668742         4.890948    0.13201660    4.630742    5.151153
                   4.163336e-18         4.376757    0.08819209    4.202930    4.550584
                      0.7668742         3.862567    0.12266390    3.620795    4.104338
   2.745279e-16      -0.7668742         4.783723    0.08748480    4.611290    4.956157
                   4.163336e-18         4.487834    0.06182042    4.365986    4.609683
                      0.7668742         4.191945    0.08757959    4.019325    4.364565
       2.284610      -0.7668742         4.676499    0.13634002    4.407772    4.945226
                   4.163336e-18         4.598912    0.08912503    4.423245    4.774578
                      0.7668742         4.521324    0.11601875    4.292650    4.749998
 ───────────────────────────────────────────────────────────────────────────────────────
   Note. ⁻ mean - 1SD, <sup>μ</sup> mean, ⁺ mean + 1SD
3. Proste nachylenia i Johnson–Neyman (lm, interactions, emmeans)
R
# Proste nachylenia i przedział Johnsona–Neymana: lm + interactions + emmeans
suppressPackageStartupMessages({ library(interactions); library(emmeans) })
dane <- read.csv("moderacja-jamovi-dane.csv")
dane$stres_c <- dane$stres - mean(dane$stres)
dane$ruch_c  <- dane$ruch - mean(dane$ruch)
cat("Średnia i SD ruchu:", round(mean(dane$ruch), 3), round(sd(dane$ruch), 3), "\n\n")

# 1. Model na zmiennych wycentrowanych (takie oszacowania b1, b2, b3 dają medmod i GAMLj)
m <- lm(dobrostan ~ stres_c * ruch_c, data = dane)
print(round(coef(summary(m)), 4))
print(round(confint(m), 4))
cat("R2 =", round(summary(m)$r.squared, 4), "\n\n")

# 2. Proste nachylenia stresu przy ruchu M − 1 SD, M, M + 1 SD (interactions)
sim_slopes(m, pred = stres_c, modx = ruch_c, johnson_neyman = FALSE, digits = 3)

# 3. To samo w emmeans: nachylenie stresu (emtrends) przy tych samych wartościach ruchu
w <- c(-1, 0, 1) * sd(dane$ruch)
print(emtrends(m, ~ ruch_c, var = "stres_c", at = list(ruch_c = w)), digits = 3)

# 4. Przedział Johnsona–Neymana na skali surowej ruchu (model z tymi samymi zmiennymi bez centrowania)
m_surowy <- lm(dobrostan ~ stres * ruch, data = dane)
jn <- johnson_neyman(m_surowy, pred = stres, modx = ruch, plot = FALSE, digits = 2)
print(jn)
cat("Odsetek osób z ruchem powyżej dolnej granicy:",
    round(100 * mean(dane$ruch > jn$bounds[1]), 1), "%\n")
Wynik w R
Średnia i SD ruchu: 4.03 2.285

               Estimate Std. Error t value Pr(>|t|)
(Intercept)      4.4878     0.0618 72.5947   0.0000
stres_c         -0.3858     0.0808 -4.7748   0.0000
ruch_c           0.0486     0.0278  1.7478   0.0819
stres_c:ruch_c   0.1246     0.0380  3.2798   0.0012
                 2.5 %  97.5 %
(Intercept)     4.3660  4.6097
stres_c        -0.5451 -0.2266
ruch_c         -0.0062  0.1034
stres_c:ruch_c  0.0497  0.1995
R2 = 0.1507

SIMPLE SLOPES ANALYSIS

Slope of stres_c when ruch_c = -2.284610e+00 (- 1 SD):

    Est.    S.E.   t val.       p
-------- ------- -------- -------
  -0.671   0.120   -5.590   0.000

Slope of stres_c when ruch_c =  1.534126e-16 (Mean):

    Est.    S.E.   t val.       p
-------- ------- -------- -------
  -0.386   0.081   -4.775   0.000

Slope of stres_c when ruch_c =  2.284610e+00 (+ 1 SD):

    Est.    S.E.   t val.       p
-------- ------- -------- -------
  -0.101   0.117   -0.863   0.389

 ruch_c stres_c.trend     SE  df lower.CL upper.CL
  -2.28        -0.671 0.1200 216   -0.907   -0.434
   0.00        -0.386 0.0808 216   -0.545   -0.227
   2.28        -0.101 0.1170 216   -0.332    0.130

Confidence level used: 0.95
JOHNSON-NEYMAN INTERVAL

When ruch is OUTSIDE the interval [5.57, 12.13], the slope of stres is p <
.05.

Note: The range of observed values of ruch is [0.50, 12.00]

Odsetek osób z ruchem powyżej dolnej granicy: 18.6 %
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję jamovi i modułu, których faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- interactions (wersja 1.2.0): Long, J. A. (2024). interactions: Comprehensive, user-friendly toolkit for probing interactions [R package]. https://doi.org/10.32614/CRAN.package.interactions
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy w moderacji w jamovi
- Interpretacja efektów głównych bez centrowania. W Linear Regression współczynnik predyktora to efekt przy zerze moderatora – w przykładzie −0.888 zamiast −0.386.
- Brak interakcji w GAMLj. Przy dwóch zmiennych ciągłych domyślny model ma tylko efekty główne. Sprawdź, czy w Parameter Estimates jest wiersz iloczynu.
- Zamienione pola w medmod. Proste nachylenia dotyczą zmiennej z pola Predictor. Zamiana z Moderator nie zmieni b₃, ale da nachylenia ruchu zamiast stresu.
- Przepisanie wyniku bez przedziałów. W medmod przedział ufności jest domyślnie wyłączony – włącz Confidence interval.
- Wniosek „przy dużym ruchu stres nie szkodzi”. Nieistotne nachylenie to brak dowodu, a nie dowód braku związku – zwłaszcza tam, gdzie danych jest mało.
- Ręcznie policzony iloczyn wpisany jako zwykły predyktor. Wynik interakcji będzie poprawny, ale analiza nie „wie”, że to interakcja (np. przy średnich brzegowych). Lepiej dodać ją w Model Builder.
Najczęstsze pytania
Czy moderację w jamovi da się zrobić bez instalowania modułu?
Tak. W Regression → Linear Regression dodaj w Model Builder wyraz interakcji dwóch predyktorów – iloczynu nie musisz liczyć ręcznie. Ta analiza nie centruje jednak zmiennych i nie ma tabeli prostych nachyleń. Centrowanie zrobisz zmienną obliczaną (np. stres - VMEAN(stres)), a nachylenia odczytasz w module medmod lub GAMLj albo policzysz w R.
Dlaczego efekt główny zmienia się po centrowaniu, a interakcja nie?
W modelu z interakcją współczynnik predyktora to jego efekt przy zerowej wartości moderatora. Bez centrowania zero aktywności fizycznej to skrajny koniec skali, po centrowaniu – średnia. W przykładzie efekt stresu zmienia się z −0.888 na −0.386, a współczynnik interakcji zostaje równy 0.125 z tym samym p = .001.
Który moduł jamovi pokazuje przedział Johnsona–Neymana?
Z opisanych tu analiz tylko GAMLj: na karcie Plots ma opcję Johnson-Neyman plot, która rysuje, przy jakich wartościach moderatora prosty efekt jest istotny. medmod i Linear Regression tej opcji nie mają. Dokładną granicę policzysz w R funkcją johnson_neyman() z pakietu interactions.
Czym różnią się wyniki medmod od Linear Regression w jamovi?
Oszacowania współczynników są takie same jak w regresji na wycentrowanych zmiennych, ale medmod dopasowuje model w lavaan metodą największej wiarygodności i podaje test Z zamiast t. Błędy standardowe i wartości p mogą się więc minimalnie różnić. Do pracy wystarczy jedna analiza – podaj, której użyłeś.
Czy w medmod mogę użyć moderatora kategorialnego, np. płci?
Nie – pola modułu przyjmują tylko zmienne liczbowe, a centrowanie zmiennej 0/1 zmienia interpretację efektów głównych. Moderator kategorialny wpisz w Factors w Linear Regression albo w GAMLj, gdzie proste efekty policzysz osobno dla każdej grupy.
Powiązane hasła
Przeczytaj też
Analiza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikMediacja i moderacja w SPSS z PROCESS
Instalacja makra Hayesa, modele 1, 4 i 7, efekt pośredni z bootstrapem, efekty warunkowe, indeks moderowanej mediacji i zapis APA – z plikiem .sav.
Czytaj →PoradnikKorelacja i regresja w jamovi
Correlation Matrix i Linear Regression z blokami: które opcje zaznaczyć, jak czytać Model Comparisons, β, VIF, Cook i wykresy reszt oraz zapis APA.
Czytaj →Masz moderację z jamovi i nie wiesz, co przepisać do pracy?
Sprawdzimy model, centrowanie i proste nachylenia oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage.
- Bauer, D. J., & Curran, P. J. (2005). Probing interactions in fixed and multilevel regression: Inferential and graphical techniques. Multivariate Behavioral Research, 40(3), 373–400. https://doi.org/10.1207/s15327906mbr4003_5 ● Otwarty dostęp
- Gallucci, M. (b.d.). GAMLj: General analyses for linear models in jamovi – documentation (General Linear Model; Multiple regression, moderated regression, and simple slopes; Johnson-Neyman plot). GAMLj documentation. https://gamlj.github.io/ ● Otwarty dostęp
- Selker, R. (2026). medmod: Simple mediation and moderation analysis (R package and jamovi module, version 1.2.0) [Computer software]. https://CRAN.R-project.org/package=medmod ● Otwarty dostęp: pełny tekst
- Spiller, S. A., Fitzsimons, G. J., Lynch, J. G., Jr., & McClelland, G. H. (2013). Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression. Journal of Marketing Research, 50(2), 277–288. https://doi.org/10.1509/jmr.12.0420
- The jamovi project. (b.d.-a). Linear Regression. jamovi documentation. https://docs.jamovi.org/analyses/jg_42_regression-linear.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). List of functions. jamovi documentation. https://docs.jamovi.org/data/data_5_list_of_functions.html ● Otwarty dostęp
- The jamovi project. (b.d.-c). jmv: Linear Regression – analysis, results and user-interface definitions (jamovi/linreg.a.yaml, linreg.r.yaml, linreg.u.yaml). GitHub. https://github.com/jamovi/jmv/tree/master/jamovi ● Otwarty dostęp
Cytowania BibTeX
@book{aiken1991multiple, author={Aiken, Leona S. and West, Stephen G.}, title={{Multiple regression: Testing and interpreting interactions}}, year={1991}, publisher={Sage}}@article{bauer2005probing, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Probing interactions in fixed and multilevel regression: Inferential and graphical techniques}}, journal={Multivariate Behavioral Research}, year={2005}, volume={40}, number={3}, pages={373--400}, doi={10.1207/s15327906mbr4003_5}}@misc{galluccindgamlj, author={Gallucci, Marcello}, title={{GAMLj: General analyses for linear models in jamovi – documentation (General Linear Model; Multiple regression, moderated regression, and simple slopes; Johnson-Neyman plot)}}, howpublished={GAMLj documentation}, year={b.d.}, url={https://gamlj.github.io/}}@misc{selker2026medmod, author={Selker, Ravi}, title={{medmod: Simple mediation and moderation analysis (R package and jamovi module, version 1.2.0) [Computer software]}}, year={2026}, url={https://CRAN.R-project.org/package=medmod}}@article{spiller2013spotlights, author={Spiller, Stephen A. and Fitzsimons, Gavan J. and Lynch, Jr., John G. and McClelland, Gary H.}, title={{Spotlights, floodlights, and the magic number zero: Simple effects tests in moderated regression}}, journal={Journal of Marketing Research}, year={2013}, volume={50}, number={2}, pages={277--288}, doi={10.1509/jmr.12.0420}}@misc{jamovindlinreg, author={{The jamovi project}}, title={{Linear Regression}}, howpublished={jamovi documentation}, year={b.d.-a}, publisher={The jamovi project}, url={https://docs.jamovi.org/analyses/jg_42_regression-linear.html}}@misc{jamovindfunctions, author={{The jamovi project}}, title={{List of functions}}, howpublished={jamovi documentation}, year={b.d.-b}, publisher={The jamovi project}, url={https://docs.jamovi.org/data/data_5_list_of_functions.html}}@misc{jamovijmvlinregdef, author={{The jamovi project}}, title={{jmv: Linear Regression – analysis, results and user-interface definitions (jamovi/linreg.a.yaml, linreg.r.yaml, linreg.u.yaml)}}, howpublished={GitHub}, year={b.d.-c}, url={https://github.com/jamovi/jmv/tree/master/jamovi}}