Dlaczego interakcje tak często „nie wychodzą”
Hipoteza moderacyjna brzmi zwykle niewinnie: trening działa, ale silniej u osób z wysokim lękiem; stres obniża dobrostan, ale słabiej przy dużym wsparciu. Badanie planuje się jednak często tak, jakby chodziło o sam efekt treningu albo stresu. Potem test efektu interakcji daje p = .20, a efekt główny jest wyraźnie istotny.
To nie jest pech. Sommet i in. (2023) przeanalizowali 159 badań z wpływowych czasopism psychologicznych i oszacowali medianę mocy wykrycia interakcji typowej wielkości na .18. Aguinis i in. (2005) przejrzeli 30 lat badań z moderatorami kategorialnymi w regresji wielorakiej. Mediana zaobserwowanego efektu interakcji wyniosła tam zaledwie f² = 0.002. Ten wpis wyjaśnia, skąd bierze się ta różnica. Pokazuje też w symulacji, ile osób naprawdę potrzeba, i podpowiada, jak zaplanować i opisać analizę mocy dla moderacji. Samą analizę i interpretację interakcji opisują wpisy analiza moderacji krok po kroku i interakcja w ANOVA.
Trzy powody: mniejszy efekt, większy błąd standardowy, gorszy pomiar
Weźmy najprostszy schemat 2 × 2: manipulacja A (kontrola albo trening) i moderator B (niski albo wysoki lęk), oba zakodowane jako −0.5 i +0.5, czyli kodowaniem efektów. Przy takim kodowaniu współczynnik A to średnia z dwóch efektów prostych, a współczynnik interakcji to ich różnica. Przy równych komórkach i odchyleniu standardowym σ wewnątrz komórek błędy standardowe wynoszą:
Błąd standardowy interakcji jest dwa razy większy. Żeby oszacować różnicę efektów prostych tak samo precyzyjnie jak ich średnią, potrzebujesz więc czterech razy więcej osób. Jeśli dodatkowo różnica efektów jest o połowę mniejsza od efektu, który badasz, potrzebna próba rośnie szesnastokrotnie. Wynika to wprost z tego, że wariancja oszacowania maleje proporcjonalnie do N.
Drugi powód to kształt interakcji. Sommet i in. (2023) dzielą interakcje na odwrócone (krzyżowe), w pełni osłabione i częściowo osłabione. Od kształtu zależy, jak duża jest różnica efektów prostych. W interakcji krzyżowej efekt zmienia znak, więc różnica jest duża. W interakcji osłabiającej (ang. attenuated) efekt w jednej grupie jest tylko słabszy, więc różnica jest mała. Tymczasem w psychologii najczęściej przewiduje się właśnie osłabienie: „działa, ale słabiej”.
Trzeci powód to błąd pomiaru i rozkład predyktorów. McClelland i Judd (1993) pokazali, że testy interakcji w badaniach terenowych mają mniejszą efektywność niż w eksperymentach. Wynika to z małej wariancji resztowej iloczynu po usunięciu efektów głównych, a ta zależy od łącznego rozkładu predyktorów. Według autorów test w badaniu terenowym ma często mniej niż 20% efektywności optymalnego testu eksperymentalnego. Do tego dochodzi błąd pomiaru, który iloczyn dwóch zmiennych mnoży (sekcja o rzetelności niżej).
Symulacja: schemat 2 × 2 i trzy kształty interakcji
Punkt odniesienia to zwykłe badanie dwóch grup z d Cohena = 0.5. Moc .80 przy dwustronnym teście daje 64 osoby w grupie, czyli N = 128. Teraz dodajemy moderator i zakładamy, że w grupie B1 efekt treningu nadal wynosi d = 0.5, a w grupie B2:
- odwraca się (d = −0.5) – interakcja krzyżowa;
- znika (d = 0) – pełne osłabienie;
- spada o połowę (d = 0.25) – połowiczne osłabienie.
Liczebność policzyliśmy z niecentralnego rozkładu t (logikę opisuje hasło parametr niecentralności i symulacyjna analiza mocy). Wyniki sprawdziliśmy symulacją 2000 badań dla każdego N. Największy błąd Monte Carlo wynosił 0.011.
| Kształt interakcji | Efekty proste A w B1 i B2 | Różnica efektów (bA×B) | N dla interakcji (moc .80) | Krotność N = 128 |
|---|---|---|---|---|
| Krzyżowa | 0.5 i −0.5 | 1.00 | 128 | 1.0 |
| Pełne osłabienie | 0.5 i 0 | 0.50 | 508 | 4.0 |
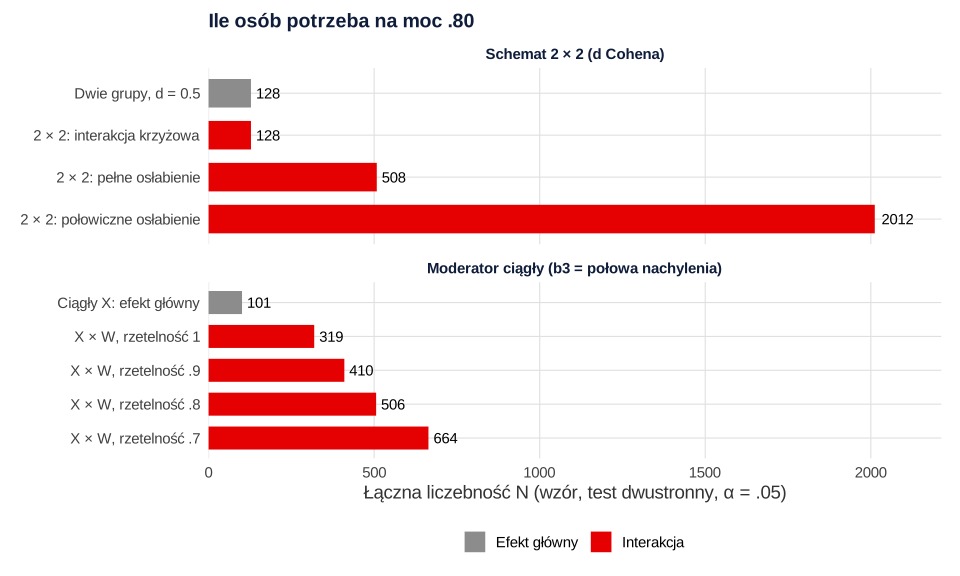
| Połowiczne osłabienie | 0.5 i 0.25 | 0.25 | 2012 | 15.7 |
Interakcja krzyżowa jest „tania”: wystarcza ta sama próba co w badaniu dwóch grup. Pełne osłabienie wymaga czterech razy więcej osób, a połowiczne – prawie szesnastu. Przy N = 128 test interakcji w pełni osłabionej miał w symulacji moc .288. To niemal dokładnie 29%, które podają Brookes i in. (2004) dla badania zaplanowanego na moc 80% dla efektu ogólnego. Autorzy ci również wyliczyli, że do wykrycia takiej interakcji z tą samą mocą potrzeba około czterokrotnie większej próby.
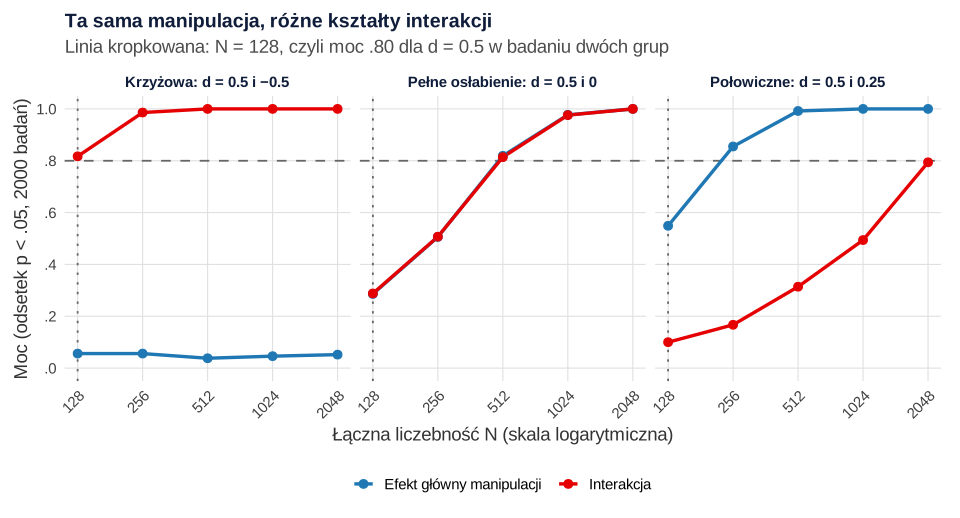
Rysunek 1 pokazuje coś jeszcze. Przy połowicznym osłabieniu efekt główny ma dużą moc już przy 256 osobach (.855), a interakcja przy tej samej próbie tylko .167. Badacz dostaje wtedy wyraźny efekt główny i „nieistotną” interakcję, choć interakcja w populacji istnieje. Przy interakcji krzyżowej jest odwrotnie: efekt główny wynosi zero, a odsetek istotnych wyników (.038–.056) to tylko błąd I rodzaju. Dlatego nie wnioskuj o interakcji z tego, że efekt prosty był istotny w jednej grupie, a w drugiej nie. Brookes i in. (2004) pokazali, że takie wyniki w osobnych analizach podgrup pojawiały się w 7–64% symulacji, zależnie od cech badania.
Moderator ciągły: realistyczna interakcja i moc
W badaniach korelacyjnych oba predyktory są zwykle ciągłe. W drugim przykładzie X i W są standaryzowane i korelują na poziomie .30, a model to Y = 0.30·X + 0.20·W + 0.15·X·W + e. Współczynnik interakcji jest połową efektu głównego. Nachylenie X wynosi więc 0.15 przy W o 1 SD poniżej średniej i 0.45 przy W o 1 SD powyżej. Kształt sprawdzisz na prostych nachyleniach albo w przedziale Johnsona–Neymana. Taką interakcję badacz zwykle opisałby jako wyraźną.
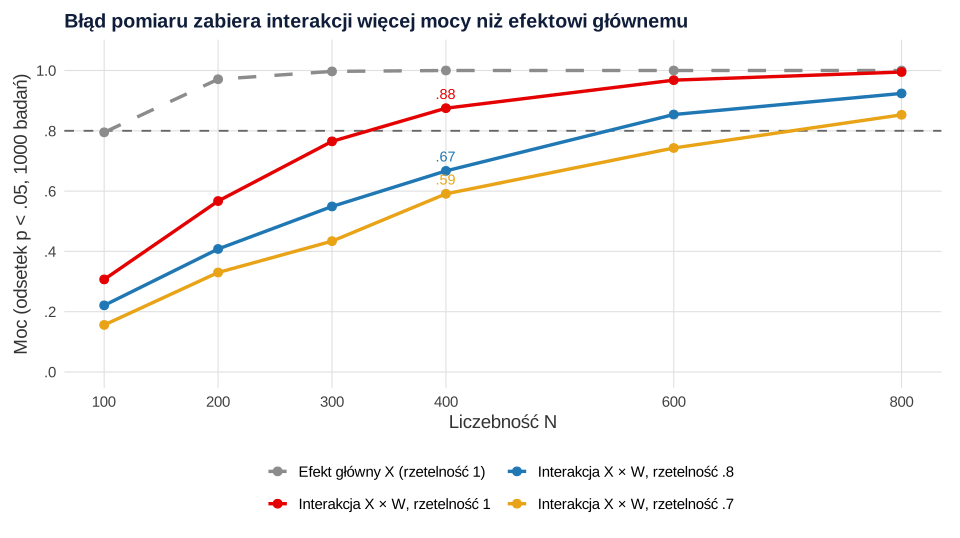
Z dużej próby „populacyjnej” (milion obserwacji) policzyliśmy f² Cohena obu efektów i liczebność na moc .80. Efekt główny X miał f² = 0.081 i wymagał 101 osób. Interakcja miała f² = 0.025 i wymagała 319 osób, czyli ponad trzy razy więcej. Symulacja 1000 badań na punkt to potwierdza: przy N = 100 moc efektu głównego wynosiła .795, a interakcji .307. Przy N = 300 moc interakcji wynosiła .765, a przy N = 400 – .875.
Rzetelność predyktorów: błąd pomiaru razy dwa
Predyktory w psychologii mierzymy skalami o ograniczonej rzetelności. Błąd pomiaru zaniża współczynnik efektu głównego (to opisuje wpis błąd pomiaru w regresji i korekta na atenuację). Iloczyn dwóch zmiennych mierzonych z błędem jest jednak mniej rzetelny niż każda z nich. Dla wycentrowanych zmiennych o rozkładzie normalnym rzetelność iloczynu wynosi:
Gdy predyktory są nieskorelowane, to po prostu iloczyn rzetelności. Dwie skale o rzetelności .80 dają iloczyn o rzetelności około .64, a dwie skale o rzetelności .70 – około .49. W symulacji predyktory były skorelowane, więc wzór dał nieco więcej: .660 i .512. Rzetelność policzona z danych wynosiła .661 i .510.
| Rzetelność X i W | Rzetelność iloczynu | Oszacowane b3 (prawdziwe 0.15) | f² interakcji | N dla interakcji (moc .80) |
|---|---|---|---|---|
| 1 | 1 | 0.151 | 0.025 | 319 |
| .90 | .822 | 0.136 | 0.019 | 410 |
| .80 | .661 | 0.124 | 0.016 | 506 |
| .70 | .510 | 0.110 | 0.012 | 664 |
Przy rzetelności .70 potrzebna próba rośnie z 319 do 664 osób, a efekt główny X wymaga wtedy tylko 131 osób. Rysunek 2 pokazuje to samo w symulacji. Przy 400 osobach moc testu interakcji spada z .875 przy pomiarze bezbłędnym do .667 przy rzetelności .80 i .591 przy rzetelności .70.
Korekta po fakcie niewiele tu pomoże. Lepiej od początku mierzyć rzetelnie: dłuższą skalą, kilkoma wskaźnikami albo modelem zmiennych latentnych z interakcją w SEM. Whisman i McClelland (2005) wymieniają rzetelne miary wśród głównych zaleceń przy planowaniu badań nad moderatorami.
Jak ustalić realistyczną wielkość interakcji
Najtrudniejszą decyzją w analizie mocy jest wybór efektu. Przy interakcjach łatwo się tu pomylić, bo konwencjonalne progi „małego” efektu bywają dla moderacji zbyt optymistyczne. Aguinis i in. (2005) zauważają, że 72% przejrzanych testów miało moc co najmniej .80 dla konwencjonalnie „małego” efektu, a mimo to obserwowane efekty były dużo mniejsze. Autorzy radzą planować badania na mniejsze, realistyczne efekty i kwestionują konwencjonalne definicje wielkości efektu moderacji.
- Zacznij od efektów prostych, nie od f². Zapisz, jak duży jest efekt w jednej grupie (albo nachylenie przy przeciętnym moderatorze) i co dzieje się w drugiej: znika, słabnie o połowę czy się odwraca. Sommet i in. (2023) pokazują, że oczekiwana wielkość interakcji zależy właśnie od jej kształtu. Liczebność dla 2 × 2 policzysz z czterech średnich w kalkulatorze mocy dla ANOVA i regresji.
- Przyjmij domyślnie osłabienie o połowę. Jeśli teoria nie przewiduje odwrócenia efektu, rozsądnym punktem wyjścia jest interakcja równa połowie efektu prostego, jak w przykładzie z moderatorem ciągłym.
- Nie bierz efektu wprost z opublikowanego badania. Opublikowane interakcje pochodzą zwykle z badań o niskiej mocy, a istotny wynik z takiego badania przeszacowuje efekt. Gelman i Carlin (2014) nazywają to błędem typu M (zob. błędy typu S i typu M). Lepiej oprzyj się na najmniejszym interesującym efekcie.
- Uwzględnij rzetelność. Jeśli efekty w literaturze dotyczą konstruktów, a Ty mierzysz je skalą o rzetelności .80, policz moc dla efektu osłabionego, jak w tabeli wyżej.
- Dodaj analizę wrażliwości. Podaj, jaki najmniejszy efekt wykryjesz z mocą .80 przy próbie, którą realnie zbierzesz. W przykładzie przy N = 300 jest to f² = 0.027, czyli b3 ≈ 0.156, a w schemacie 2 × 2 różnica efektów prostych d = 0.65.
Dla nietypowych planów (powtarzane pomiary, modele wielopoziomowe, wyniki porządkowe) moc liczy się symulacją. Przykład dla modelu mieszanego opisuje wpis analiza mocy dla modelu mieszanego, a zasady planowania symulacji – jak zaplanować badanie symulacyjne. Przegląd analizy mocy dla planów z moderatorem dychotomicznym i ciągłym, z przykładami w R, podają też Perugini i in. (2018).
Jak zwiększyć moc bez podwajania próby
- Plan mieszany. Jeśli manipulację da się powtórzyć u tej samej osoby, porównanie wewnątrzosobowe usuwa zmienność między osobami. W symulacjach Sommeta i in. (2023) plan mieszany dawał zysk mocy 75%.
- Test jednostronny ustalony z góry. Gdy kierunek interakcji wynika z teorii i jest zapisany w prerejestracji, test jednostronny dawał w tych symulacjach zysk 21%.
- Kontrast zamiast testu interakcji. Przy przewidywanym pełnym osłabieniu prerejestrowana analiza kontrastu dawała zysk 62% (Sommet i in., 2023).
- Rzetelny pomiar i szeroki rozkład moderatora. Whisman i McClelland (2005) zalecają rzetelne miary i nadreprezentację osób o skrajnych wynikach, bo zwiększa to wariancję iloczynu.
- Bez dychotomizacji. Podział moderatora medianą odbiera moc, zamiast ją dodawać (zob. dychotomizacja zmiennych ciągłych).
Jak opisać analizę mocy dla interakcji
Opis ma pozwolić recenzentowi odtworzyć obliczenia. Podaj model, test (dwustronny czy jednostronny), założone efekty proste i kształt interakcji, wielkość efektu i jej źródło, rzetelność pomiaru, metodę (wzór czy symulacja z liczbą powtórzeń) oraz wynik analizy wrażliwości. Wzór dla przykładu z moderatorem ciągłym:
Jeśli interakcja okaże się nieistotna, nie licz mocy post hoc z uzyskanego efektu. Podaj oszacowanie interakcji z przedziałem ufności i analizę wrażliwości z etapu planowania.
Przykład w R
Dwa przepisy są niezależne i odtwarzają wszystkie liczby z tekstu. Pierwszy liczy moc w schemacie 2 × 2 ze wzoru i z symulacji (kilka sekund), drugi – moc dla moderatora ciągłego przy różnej rzetelności (kilkanaście sekund). Oba zapisują wyniki do plików CSV, z których powstały rysunki. Potrzebny pakiet: pwr (tylko przepis 2).
1. Schemat 2 × 2: wzór i symulacja
R
# Krok 1. Moc efektu głównego i interakcji w schemacie 2 × 2 (dane symulowane)
# Manipulacja A (kontrola / trening) i moderator B (np. niski / wysoki lęk), oba kodowane −0.5 i +0.5.
# Wynik w jednostkach SD wewnątrz komórek (σ = 1), więc efekty proste to d Cohena.
# Przy takim kodowaniu: b_A = średnia z dwóch efektów prostych, b_AB = ich różnica.

# Punkt odniesienia: dwie grupy i d = 0.5 – ile osób na moc .80?
n_grupa <- ceiling(power.t.test(delta = 0.5, sd = 1, power = .80)$n)
c(n_na_grupe = n_grupa, N_lacznie = 2 * n_grupa)

# Trzy kształty interakcji: efekt prosty A w grupie B1 (d1) i w grupie B2 (d2)
ksztalty <- data.frame(ksztalt = c("krzyżowa", "pełne osłabienie", "połowiczne osłabienie"),
                       d1 = c(0.5, 0.5, 0.5), d2 = c(-0.5, 0, 0.25))
ksztalty$b_A  <- (ksztalty$d1 + ksztalty$d2) / 2
ksztalty$b_AB <- ksztalty$d1 - ksztalty$d2

# Błędy standardowe przy równych komórkach: SE(b_A) = 2σ/√N, SE(b_AB) = 4σ/√N
# Moc analityczna z niecentralnego rozkładu t (df = N − 4), test dwustronny
moc_t <- function(b, se_mnoznik, N, alfa = .05) {
  ncp <- b / (se_mnoznik / sqrt(N)); kryt <- qt(1 - alfa / 2, N - 4)
  pt(kryt, N - 4, ncp, lower.tail = FALSE) + pt(-kryt, N - 4, ncp)
}
N_na_moc <- function(b, se_mnoznik, moc = .80) {          # najmniejsze N podzielne przez 4
  N <- 8; while (moc_t(b, se_mnoznik, N) < moc) N <- N + 4; N
}
ksztalty$N_efekt_A <- sapply(ksztalty$b_A, function(b) if (b == 0) NA else N_na_moc(b, 2))
ksztalty$N_interakcja <- sapply(ksztalty$b_AB, N_na_moc, se_mnoznik = 4)
ksztalty$krotnosc <- round(ksztalty$N_interakcja / (2 * n_grupa), 1)   # względem badania 2 grup
print(ksztalty, row.names = FALSE)
write.csv(ksztalty, "n-2x2.csv", row.names = FALSE)

# Symulacja: 2000 badań na komórkę siatki, model liniowy z kodowaniem ±0.5
symuluj_2x2 <- function(N, b_A, b_AB, R = 2000) {
  A <- rep(c(-0.5, 0.5), each = N / 2); B <- rep(rep(c(-0.5, 0.5), each = N / 4), 2)
  X <- cbind(1, A, B, A * B)
  XtX_inv <- diag(solve(crossprod(X)))
  p <- replicate(R, {
    y <- b_A * A + b_AB * A * B + rnorm(N)
    m <- lm.fit(X, y); s2 <- sum(m$residuals^2) / (N - 4)
    t_wart <- m$coefficients[c(2, 4)] / sqrt(XtX_inv[c(2, 4)] * s2)
    2 * pt(-abs(t_wart), N - 4)
  })
  rowMeans(p < .05)
}
set.seed(3391)
siatka <- expand.grid(N = c(128, 256, 512, 1024, 2048), ksztalt = ksztalty$ksztalt, stringsAsFactors = FALSE)
wyn <- t(mapply(function(N, k) {
  s <- ksztalty[ksztalty$ksztalt == k, ]
  sym <- symuluj_2x2(N, s$b_A, s$b_AB)
  c(moc_A_sym = sym[[1]], moc_AB_sym = sym[[2]], moc_AB_wzor = moc_t(s$b_AB, 4, N))
}, siatka$N, siatka$ksztalt))
moc_2x2 <- cbind(siatka, round(wyn, 3))
write.csv(moc_2x2, "moc-2x2.csv", row.names = FALSE)
print(moc_2x2, row.names = FALSE)
round(sqrt(.5 * .5 / 2000), 3)                       # największy błąd Monte Carlo (moc = .50)

# Analiza wrażliwości: najmniejsza różnica efektów prostych (d1 − d2) wykrywalna z mocą .80 przy N = 300
round(uniroot(function(b) moc_t(b, 4, 300) - .80, c(0.01, 2))$root, 3)
Wynik w R
n_na_grupe  N_lacznie
        64        128
               ksztalt  d1    d2   b_A b_AB N_efekt_A N_interakcja krotnosc
              krzyżowa 0.5 -0.50 0.000 1.00        NA          128      1.0
      pełne osłabienie 0.5  0.00 0.250 0.50       508          508      4.0
 połowiczne osłabienie 0.5  0.25 0.375 0.25       228         2012     15.7
    N               ksztalt moc_A_sym moc_AB_sym moc_AB_wzor
  128              krzyżowa     0.056      0.817       0.801
  256              krzyżowa     0.056      0.986       0.979
  512              krzyżowa     0.038      1.000       1.000
 1024              krzyżowa     0.046      1.000       1.000
 2048              krzyżowa     0.052      1.000       1.000
  128      pełne osłabienie     0.286      0.288       0.289
  256      pełne osłabienie     0.506      0.507       0.513
  512      pełne osłabienie     0.819      0.814       0.806
 1024      pełne osłabienie     0.977      0.976       0.979
 2048      pełne osłabienie     1.000      1.000       1.000
  128 połowiczne osłabienie     0.549      0.100       0.108
  256 połowiczne osłabienie     0.855      0.167       0.169
  512 połowiczne osłabienie     0.992      0.314       0.292
 1024 połowiczne osłabienie     1.000      0.494       0.515
 2048 połowiczne osłabienie     1.000      0.794       0.807
[1] 0.011
[1] 0.649
2. Moderator ciągły i rzetelność predyktorów
R
# Krok 2. Moderator ciągły: moc efektu głównego i interakcji przy różnej rzetelności (dane symulowane)
# Model prawdziwych wyników (zmienne standaryzowane, korelacja X i W = .30):
#   Y = 0.30·X + 0.20·W + 0.15·X·W + e,  SD(e) = 1
# Nachylenie X wynosi 0.15 przy W = −1 SD i 0.45 przy W = +1 SD (interakcja = połowa efektu prostego).
# Obserwujemy X i W z błędem pomiaru: x = √rel·X + √(1 − rel)·szum.
library(pwr)

generuj <- function(N, rel, r_xw = .30, b = c(0.30, 0.20, 0.15)) {
  X <- rnorm(N); W <- r_xw * X + sqrt(1 - r_xw^2) * rnorm(N)
  y <- b[1] * X + b[2] * W + b[3] * X * W + rnorm(N)
  x_obs <- sqrt(rel) * X + sqrt(1 - rel) * rnorm(N)
  w_obs <- sqrt(rel) * W + sqrt(1 - rel) * rnorm(N)
  data.frame(y, X, W, x = x_obs - mean(x_obs), w = w_obs - mean(w_obs))
}

# a) Duża próba „populacyjna”: rzetelność iloczynu i f² interakcji, a z nich N na moc .80
set.seed(3392)
populacja <- as.data.frame(t(sapply(c(1, .9, .8, .7), function(rel) {
  d <- generuj(1e6, rel)
  rel_iloczynu <- cor(d$X * d$W, d$x * d$w)^2          # wariancja prawdziwa / obserwowana iloczynu
  r_obs <- cor(d$x, d$w)
  wzor <- (rel^2 + r_obs^2) / (1 + r_obs^2)           # rzetelność iloczynu ze wzoru
  r2_pelny <- summary(lm(y ~ x * w, d))$r.squared
  r2_bez <- summary(lm(y ~ x + w, d))$r.squared
  f2_XW <- (r2_pelny - r2_bez) / (1 - r2_pelny)
  f2_X <- (r2_pelny - summary(lm(y ~ w + x:w, d))$r.squared) / (1 - r2_pelny)
  N_XW <- ceiling(pwr.f2.test(u = 1, f2 = f2_XW, power = .80)$v) + 4
  N_X <- ceiling(pwr.f2.test(u = 1, f2 = f2_X, power = .80)$v) + 4
  c(rel_xw = rel, rel_iloczynu = rel_iloczynu, wzor = wzor, b3 = coef(lm(y ~ x * w, d))[["x:w"]],
    f2_X = f2_X, f2_XW = f2_XW, N_X = N_X, N_XW = N_XW)
})))
print(round(populacja, 4), row.names = FALSE)
write.csv(populacja, "n-moderator-ciagly.csv", row.names = FALSE)

# b) Symulacja mocy: 1000 badań na komórkę, ten sam model lm(y ~ x * w)
moc_komorki <- function(N, rel, R = 1000) {
  p <- replicate(R, {
    m <- summary(lm(y ~ x * w, generuj(N, rel)))$coefficients
    c(m["x", 4], m["x:w", 4])
  })
  rowMeans(p < .05)
}
set.seed(3393)
siatka <- expand.grid(N = c(100, 200, 300, 400, 600, 800), rel = c(1, .8, .7))
wyn <- t(mapply(moc_komorki, siatka$N, siatka$rel))
moc_ciagly <- cbind(siatka, moc_X = wyn[, 1], moc_XW = wyn[, 2])
write.csv(moc_ciagly, "moc-moderator-ciagly.csv", row.names = FALSE)
print(round(moc_ciagly, 3), row.names = FALSE)

# c) Analiza wrażliwości: jaką interakcję wykryjesz z mocą .80, mając N = 300 (rzetelność 1)?
f2_min <- pwr.f2.test(u = 1, v = 300 - 4, power = .80)$f2
b3_min <- populacja$b3[1] * sqrt(f2_min / populacja$f2_XW[1])   # f² rośnie z kwadratem b3
round(c(f2_min = f2_min, b3_min = b3_min), 3)
Wynik w R
 rel_xw rel_iloczynu   wzor     b3   f2_X  f2_XW N_X N_XW
    1.0       1.0000 1.0000 0.1513 0.0814 0.0249 101  319
    0.9       0.8223 0.8229 0.1358 0.0756 0.0193 108  410
    0.8       0.6607 0.6600 0.1237 0.0692 0.0157 118  506
    0.7       0.5097 0.5116 0.1097 0.0620 0.0119 131  664
   N rel moc_X moc_XW
 100 1.0 0.795  0.307
 200 1.0 0.971  0.567
 300 1.0 0.997  0.765
 400 1.0 1.000  0.875
 600 1.0 1.000  0.968
 800 1.0 1.000  0.995
 100 0.8 0.710  0.221
 200 0.8 0.956  0.408
 300 0.8 0.991  0.549
 400 0.8 1.000  0.667
 600 0.8 1.000  0.854
 800 0.8 1.000  0.924
 100 0.7 0.705  0.156
 200 0.7 0.915  0.330
 300 0.7 0.987  0.434
 400 0.7 0.999  0.591
 600 0.7 1.000  0.743
 800 0.7 1.000  0.853
f2_min b3_min
 0.027  0.156
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 (przepis 2: pakiet pwr); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Liczebność dla efektu głównego. Próba wyliczona dla efektu głównego da przy osłabiającej interakcji moc rzędu .10–.30.
- Interakcja „z różnicy istotności”. Istotny efekt w jednej grupie i nieistotny w drugiej nie jest testem interakcji.
- Konwencjonalny „mały” efekt bez uzasadnienia. Wielkość interakcji wyprowadź z przewidywanych efektów prostych.
- Pominięcie rzetelności. Przy rzetelności .70 obu skal potrzebna próba w przykładzie rosła ponad dwukrotnie.
- Efekt z opublikowanego badania 1:1. Opublikowane interakcje są zwykle zawyżone, więc planuj na mniejszy efekt.
Najczęstsze pytania
Ile osób potrzeba do wykrycia interakcji?
To zależy od kształtu interakcji. W przykładzie, w którym efekt treningu wynosi d = 0.5 w jednej grupie, interakcja krzyżowa (efekt −0.5 w drugiej grupie) wymagała 128 osób, pełne osłabienie (efekt 0) – 508, a połowiczne (efekt 0.25) – 2012 osób na moc .80. Badanie dwóch grup z d = 0.5 wymaga 128 osób.
Dlaczego test interakcji ma mniejszą moc niż test efektu głównego?
Przy kodowaniu ±0.5 w schemacie 2 × 2 błąd standardowy interakcji jest dwa razy większy niż efektu głównego, bo interakcja to różnica dwóch efektów prostych, a nie ich średnia. Do tego przewidywane interakcje są zwykle osłabiające, więc różnica efektów prostych jest mała. W metabadaniu Sommeta i in. (2023) mediana mocy wykrycia typowej interakcji wyniosła .18.
Jak rzetelność skal wpływa na moc testu moderacji?
Iloczyn dwóch zmiennych mierzonych z błędem jest mniej rzetelny niż każda z nich: przy nieskorelowanych predyktorach jego rzetelność to w przybliżeniu iloczyn rzetelności. W przykładzie przy rzetelności .70 obu skal próba potrzebna do wykrycia interakcji wzrosła z 319 do 664 osób.
Jaką wielkość interakcji przyjąć w analizie mocy?
Wyprowadź ją z przewidywanych efektów prostych: jak duży jest efekt w jednej grupie i co dzieje się w drugiej. Gdy teoria nie przewiduje odwrócenia, rozsądnym punktem wyjścia jest interakcja równa połowie efektu prostego. Nie bierz efektu wprost z opublikowanego badania, bo istotne wyniki badań o niskiej mocy są zawyżone.
Czy da się zwiększyć moc testu interakcji bez zwiększania próby?
Częściowo tak. Pomaga plan mieszany z manipulacją wewnątrzosobową, prerejestrowany test jednostronny lub kontrast przy przewidywanym pełnym osłabieniu, rzetelniejszy pomiar i szerszy rozkład moderatora. Szkodzi natomiast dzielenie moderatora medianą.
Powiązane hasła
Przeczytaj też
Liczebność próby w eksperymencie ankietowym
Ile osób na warunek przy małych efektach, ile daje kowariata przed bodźcem i plan wewnątrzosobowy, ile kosztują dodatkowe warunki i ubytek.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikAnaliza mocy dla modelu mieszanego
Własna pętla symulacyjna w lme4: parametry z pilotażu, siatka osób i prób, krzywa mocy, błąd Monte Carlo i analiza wrażliwości.
Czytaj →PoradnikBłąd pomiaru w regresji i korekta na atenuację
Atenuacja i zakłócenie resztkowe przy nierzetelnych skalach, korekta Spearmana, SEM z jednym wskaźnikiem w lavaan, pełny SEM i symulacja estymatorów.
Czytaj →Planujesz badanie z hipotezą moderacyjną i nie wiesz, ile osób zebrać?
Pomożemy przełożyć przewidywany kształt interakcji na wielkość efektu, policzyć moc wzorem lub symulacją i przygotować opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Aguinis, H., Beaty, J. C., Boik, R. J., & Pierce, C. A. (2005). Effect size and power in assessing moderating effects of categorical variables using multiple regression: A 30-year review. Journal of Applied Psychology, 90(1), 94–107. https://doi.org/10.1037/0021-9010.90.1.94
- Brookes, S. T., Whitely, E., Egger, M., Davey Smith, G., Mulheran, P. A., & Peters, T. J. (2004). Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test. Journal of Clinical Epidemiology, 57(3), 229–236. https://doi.org/10.1016/j.jclinepi.2003.08.009
- Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641–651. https://doi.org/10.1177/1745691614551642
- McClelland, G. H., & Judd, C. M. (1993). Statistical difficulties of detecting interactions and moderator effects. Psychological Bulletin, 114(2), 376–390. https://doi.org/10.1037/0033-2909.114.2.376
- Perugini, M., Gallucci, M., & Costantini, G. (2018). A practical primer to power analysis for simple experimental designs. International Review of Social Psychology, 31(1), Article 20. https://doi.org/10.5334/irsp.181 ● Otwarty dostęp
- Sommet, N., Weissman, D. L., Cheutin, N., & Elliot, A. J. (2023). How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction. Advances in Methods and Practices in Psychological Science, 6(3), Article 25152459231178728. https://doi.org/10.1177/25152459231178728 ● Otwarty dostęp
- Whisman, M. A., & McClelland, G. H. (2005). Designing, testing, and interpreting interactions and moderator effects in family research. Journal of Family Psychology, 19(1), 111–120. https://doi.org/10.1037/0893-3200.19.1.111
Cytowania BibTeX
@article{aguinis2005effect, author={Aguinis, Herman and Beaty, James C. and Boik, Robert J. and Pierce, Charles A.}, title={{Effect size and power in assessing moderating effects of categorical variables using multiple regression: A 30-year review}}, journal={Journal of Applied Psychology}, year={2005}, volume={90}, number={1}, pages={94--107}, doi={10.1037/0021-9010.90.1.94}}@article{brookes2004subgroup, author={Brookes, Sara T. and Whitely, Elise and Egger, Matthias and Davey Smith, George and Mulheran, Paul A. and Peters, Tim J.}, title={{Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test}}, journal={Journal of Clinical Epidemiology}, year={2004}, volume={57}, number={3}, pages={229--236}, doi={10.1016/j.jclinepi.2003.08.009}}@article{gelman2014beyond, author={Gelman, Andrew and Carlin, John}, title={{Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors}}, journal={Perspectives on Psychological Science}, year={2014}, volume={9}, number={6}, pages={641--651}, doi={10.1177/1745691614551642}}@article{mcclelland1993statistical, author={McClelland, Gary H. and Judd, Charles M.}, title={{Statistical difficulties of detecting interactions and moderator effects}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={2}, pages={376--390}, doi={10.1037/0033-2909.114.2.376}}@article{perugini2018practical, author={Perugini, Marco and Gallucci, Marcello and Costantini, Giulio}, title={{A practical primer to power analysis for simple experimental designs}}, journal={International Review of Social Psychology}, year={2018}, volume={31}, number={1}, eid={20}, doi={10.5334/irsp.181}}@article{sommet2023how, author={Sommet, Nicolas and Weissman, David L. and Cheutin, Nicolas and Elliot, Andrew J.}, title={{How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction}}, journal={Advances in Methods and Practices in Psychological Science}, year={2023}, volume={6}, number={3}, eid={25152459231178728}, doi={10.1177/25152459231178728}}@article{whisman2005designing, author={Whisman, Mark A. and McClelland, Gary H.}, title={{Designing, testing, and interpreting interactions and moderator effects in family research}}, journal={Journal of Family Psychology}, year={2005}, volume={19}, number={1}, pages={111--120}, doi={10.1037/0893-3200.19.1.111}}