Skąd pokusa dzielenia na grupy
Masz wynik skali stresu, perfekcjonizmu albo satysfakcji od 0 do 40 i chcesz porównać osoby „niskie” z „wysokimi”. Taki podział wygląda na prostszy: zamiast regresji wystarczy test t albo ANOVA, a wynik łatwo opisać jednym zdaniem. Często podsuwa go też promotor albo wzór z cudzej pracy. MacCallum i in. (2002) przejrzeli argumenty za tą praktyką i doszli do wniosku, że dychotomizacja rzadko daje się obronić, a często prowadzi do mylących wyników.
Podstawowe koszty jednego podziału medianą (utrata mocy i informacji) opisuje hasło dzielenie medianą, a podział na trzy i więcej grup – hasło o tercylach i podziale kwantylowym. Ten wpis idzie dalej. Na jednym przykładzie i trzech symulacjach pokazujemy, że strata zależy od miejsca podziału i że dwa podziały naraz mogą dać efekty, których w danych nie ma. Omawiamy też, kiedy próg jest naprawdę uzasadniony, co analizować zamiast grup i jak to zapisać w pracy.
Przykład: perfekcjonizm, lęk przed oceną i prokrastynacja
Wszystkie liczby pochodzą z danych symulowanych w R. 160 osób studiujących wypełniło trzy skale: perfekcjonizmu i lęku przed oceną (0–40) oraz prokrastynacji (0–50). Dane są w pliku CSV. Perfekcjonizm i lęk przed oceną są ze sobą wyraźnie powiązane (r = .59). Dane wygenerowaliśmy tak, że w populacji prokrastynacja zależy tylko od perfekcjonizmu, a lęk przed oceną nie ma własnego efektu. To pozwala sprawdzić, która analiza mówi prawdę.
Na zmiennych ciągłych perfekcjonizm korelował z prokrastynacją: r = .57, 95% CI [.46, .67]. Po podziale perfekcjonizmu medianą ta sama zależność, liczona jako korelacja punktowo-dwuseryjna, spadła do r = .46, 95% CI [.33, .57]. Wynik wciąż jest istotny, ale opisuje słabszy związek, niż jest w danych.
Ciekawiej robi się przy drugim pytaniu: czy lęk przed oceną wiąże się z prokrastynacją po uwzględnieniu perfekcjonizmu?
- Regresja wieloraka na zmiennych ciągłych daje odpowiedź zgodną z prawdą. Efekt perfekcjonizmu wyniósł b = 0.69, 95% CI [0.51, 0.87], p < .001, a efekt lęku był bliski zera: b = −0.08, 95% CI [−0.29, 0.13], t(157) = −0.73, p = .468.
- ANOVA 2 × 2 po podziale obu zmiennych medianą pokazała dodatnią różnicę między grupami lęku: osoby z „wysokim” lękiem prokrastynowały średnio o 1.67 punktu więcej, 95% CI [−0.56, 3.90], F(1, 157) = 2.18, p = .142. Tym razem wynik nie przekroczył progu istotności, ale efekt zmienił znak: zamiast zera wyszła różnica „na korzyść” hipotezy o lęku.
Skąd ten efekt? W grupie „niskiego” perfekcjonizmu osoby z wysokim lękiem miały średnio 17.4 punktu perfekcjonizmu, a osoby z niskim lękiem – 14.2. Etykieta „niski perfekcjonizm” obejmuje więc ludzi o różnym perfekcjonizmie. Ta niewyjaśniona reszta przechodzi na drugą zmienną, z którą perfekcjonizm jest skorelowany. W jednej próbie to tylko zapowiedź problemu. Jak często kończy się on wynikiem fałszywie istotnym, pokazujemy w symulacji poniżej.
Ile mocy kosztuje podział
Pierwsza symulacja dotyczy pojedynczej korelacji. W populacji ρ = .30. Dla każdej liczebności wylosowaliśmy 5000 prób i liczyliśmy trzy analizy: korelację na zmiennej ciągłej, po podziale medianą oraz po podziale 80/20, czyli gdy do grupy „wysokiej” trafia górne 20% wyników.
| n | Średnie r: ciągła | Średnie r: mediana | Średnie r: 80/20 | Moc: ciągła | Moc: mediana | Moc: 80/20 |
|---|---|---|---|---|---|---|
| 40 | .29 | .23 | .21 | .47 | .31 | .25 |
| 80 | .30 | .24 | .21 | .78 | .58 | .46 |
| 150 | .30 | .24 | .21 | .97 | .85 | .75 |
Przy 80 osobach analiza zmiennej ciągłej wykrywa prawdziwy związek w 78% prób, a po podziale medianą – w 58%. Podział nie usuwa przy tym samego związku, tylko zaniża jego ocenę: średnie r spada z .30 do .24. Jeśli planujesz liczebność próby dla zmiennej ciągłej, a potem ją dzielisz, realna moc testu jest niższa od zaplanowanej. Cohen (1983) wyliczył te straty dla rozkładu normalnego i zauważył, że rosną, gdy punkt podziału oddala się od średniej.
Im dalej od mediany, tym gorzej
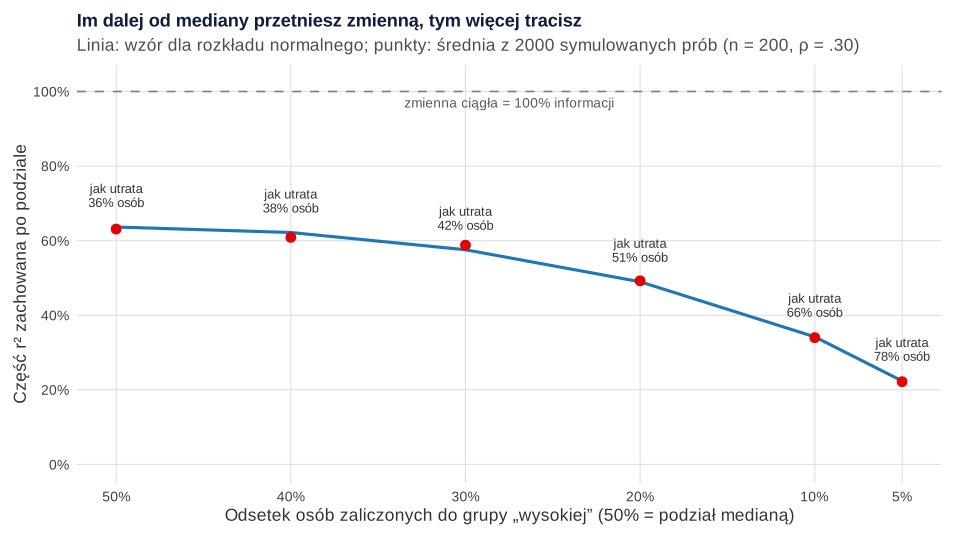
Studenci rzadko dzielą dokładnie w medianie. Częściej wyróżniają „osoby z wysokim wynikiem”, czyli górne 25% albo 10% próby. Rysunek 1 pokazuje, ile zostaje wtedy z wyjaśnianej wariancji (r²). Przy podziale medianą zostaje 64% i odpowiada to wyrzuceniu 36% osób. Przy podziale 80/20 zostaje 49%, a gdy grupa „wysoka” to 10% próby – już tylko 34%. Wtedy z 200 osób zostaje informacja warta mniej więcej 70.
Czym innym jest schemat grup skrajnych. Badacz celowo bada tylko osoby z najniższymi i najwyższymi wynikami, a środek pomija. Preacher i in. (2005) pokazują, że taki schemat może zwiększyć moc, ale zmienia standaryzowaną wielkość efektu i rzetelność, komplikuje specyfikację modelu i utrudnia interpretację wyników w odniesieniu do całej populacji. Jeśli korzystasz z grup skrajnych, opisz to jako świadomy schemat doboru, a nie jako sposób kodowania danych.
Dwa podziały: pozorne efekty i pozorne interakcje
Przy jednym predyktorze podział „tylko” odbiera moc. Gdy dzielisz dwa skorelowane predyktory, pojawia się poważniejszy problem: wyniki istotne, za którymi nie stoi żaden efekt w populacji. Maxwell i Delaney (1993) pokazali, że dwa podziały medianą mogą prowadzić do fałszywej istotności. Dlatego argument „podzieliłem, a wynik i tak wyszedł istotny” niczego nie broni.
Druga symulacja (rysunek 2) zakłada korelację predyktorów .50 i obejmuje dwa scenariusze, po 2000 prób na każdą liczebność:
- Panel A. Wynik zależy tylko od X1, a testujemy efekt X2. W regresji na zmiennych ciągłych odsetek wyników istotnych trzyma się nominalnych 5%. W ANOVA 2 × 2 po podziale obu zmiennych medianą rośnie z liczebnością: 8.8% przy n = 50, 19.0% przy 200 i 32.5% przy 400. Ten sam mechanizm działa, gdy „kontrolujesz” zmienną w grupach. Gdy X1 wchodzi do regresji jako trzy grupy tercylowe, fałszywie istotny efekt X2 pojawia się w 23.4% prób przy n = 400. Austin i Brunner (2004) opisali to dla zmiennej zakłócającej podzielonej na kategorie. Zawyżenie błędu I rodzaju rosło u nich z liczebnością próby i z korelacją, a malało z liczbą kategorii.
- Panel B. Oba predyktory działają addytywnie, bez interakcji. Przy podziale obu w medianie test interakcji w ANOVA 2 × 2 nie był zawyżony (3.8–4.2%). Gdy jednak „wysocy” to górne 30% na obu zmiennych, pozorna interakcja pojawiała się w 9.9% prób przy n = 200 i w 16.8% przy n = 400. Thoresen (2019) wyprowadził to analitycznie. W modelu liniowym z dwiema skorelowanymi zmiennymi podzielonymi w tym samym punkcie pozorna interakcja pojawia się zawsze, chyba że podział jest w medianie albo zmienne są nieskorelowane. Maxwell i Delaney (1993) opisali z kolei pozorną interakcję po podziale medianą w sytuacji, gdy związek jednego predyktora z wynikiem jest nieliniowy.
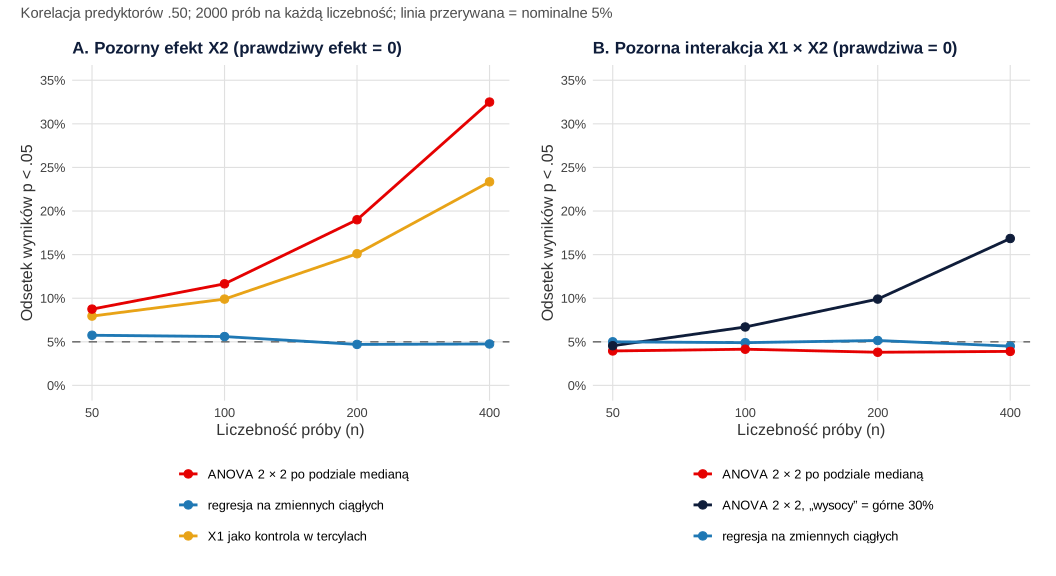
Dwa wnioski są ważne dla pracy dyplomowej. Po pierwsze, większa próba nie chroni przed tym błędem, tylko go nasila. Po drugie, wynik zależy od miejsca podziału, a to łatwo dobrać po fakcie. Próbowanie mediany, tercyli i „górnych 25%”, aż coś wyjdzie, to odmiana p-hackingu.
Czy podział medianą bywa niegroźny?
Literatura nie jest tu zupełnie jednomyślna. Iacobucci i in. (2015) w symulacjach wskazali sytuację, w której podział medianą działał równie dobrze jak zmienna ciągła, głównie przy nieskorelowanych predyktorach. Uznali, że nie trzeba go bezwarunkowo odrzucać. W tym samym zeszycie McClelland i in. (2015) zakwestionowali te argumenty i wskazali błędy techniczne w symulacjach. Ich zdaniem podział nie daje realnych korzyści, a kosztuje więcej błędów II rodzaju przez utratę mocy i więcej wyników fałszywie dodatnich.
Dla studenta praktyczny wniosek jest prosty. Nawet w najkorzystniejszym scenariuszu podział niczego nie zyskuje, a w typowym (skorelowane predyktory, podział poza medianą) wiele kosztuje. W pracy dyplomowej nie warto bronić rozwiązania, które w najlepszym razie jest równie dobre.
Kiedy podział jest uzasadniony
Grupy mają sens, gdy próg ma znaczenie poza Twoją próbą i ustalasz go przed zebraniem danych. Typowe sytuacje:
- Próg kliniczny z walidacji narzędzia. W PHQ-9 wynik 10 lub więcej miał w badaniu walidacyjnym czułość i swoistość po 88% dla dużej depresji względem wywiadu specjalisty (Kroenke i in., 2001). Taki punkt odcięcia wyznaczono względem kryterium zewnętrznego, zwykle krzywą ROC, a nie z mediany jednej próby. Jak liczyć ten wynik, opisujemy we wpisie GAD-7 i PHQ-9 – jak policzyć wynik.
- Pytanie badawcze dotyczy kategorii. Na przykład: jaki odsetek osób przekracza próg przesiewowy albo czy narzędzie trafnie wskazuje osoby z diagnozą.
- Decyzja jest dwuwartościowa. Kwalifikacja do programu, spełnienie kryterium, zdał albo nie zdał. Wtedy dychotomiczna jest sama decyzja, a nie pomiar.
Nawet wtedy analizę główną warto prowadzić na wyniku ciągłym, a próg pokazać jako uzupełnienie. Przykładem jest odsetek osób powyżej progu w opisie próby albo regresja logistyczna jako analiza dodatkowa. Royston i in. (2006) przypominają też, że próg „optymalny”, wybrany na tych samych danych, poważnie obciąża wyniki. Mediana z własnej próby nie jest progiem klinicznym, nawet jeśli tak ją nazwiesz. „Wysoki stres” w jednym badaniu może być „średnim” w innym.
Co zamiast podziału
| Co chcesz pokazać | Zamiast grup | Gdzie szczegóły |
|---|---|---|
| Czy X wiąże się z Y | Korelacja albo regresja na zmiennej ciągłej, wynik z 95% CI | regresja wieloraka krok po kroku |
| Czy efekt X zależy od W („u osób z wysokim W”) | Moderacja z ciągłym moderatorem po centrowaniu, proste nachylenia i przedział Johnsona–Neymana | analiza moderacji krok po kroku, kalkulator efektów prostych |
| Czy związek jest nieliniowy, np. „dopiero od pewnego poziomu” | Splajn albo model GAM, ewentualnie składnik kwadratowy | splajny i modele GAM |
| Kontrola zmiennej zakłócającej | Zmienna kontrolna wchodzi do modelu jako ciągła, w razie potrzeby ze splajnem | zmienna zakłócająca |
| Wynik (zmienna zależna) jest skośny albo ma efekt sufitowy | Model dopasowany do rozkładu, np. regresja porządkowa, zamiast regresji logistycznej na „wysoki/niski” | regresja porządkowa krok po kroku |
| Czytelny opis dla odbiorcy | Analiza na zmiennej ciągłej, a grupy tylko na wykresie albo w tabeli opisowej | wykres rozrzutu |
W przykładzie wystarczyła zwykła regresja z dwoma predyktorami. Efekty proste da się pokazać dla konkretnych wartości, np. średniej ± 1 SD. Działa to jak grupy, ale bez wyrzucania danych.
Jak to opisać w pracy
Decyzję o pozostawieniu zmiennej ciągłej zapisz w planie analizy i w rozdziale metodologicznym. Wtedy nikt nie zarzuci Ci, że wybrałeś(-aś) analizę pod wynik. Wzór:
Jeśli używasz progu klinicznego, podaj jego źródło i kierunek nierówności („≥ 10”, a nie „> 10”) oraz zaznacz, że próg ustalono przed analizą:
Gdy promotor prosi o grupy „wysokie” i „niskie”, zaproponuj kompromis. Analizę testującą hipotezę wykonaj na zmiennej ciągłej, a grupy pokaż opisowo albo na wykresie. Dołącz dwa zdania uzasadnienia i jedno źródło.
Najczęstsze błędy
- Podział, „bo test t jest prostszy”. Regresja z jednym predyktorem nie jest trudniejsza do opisania, a nie traci mocy (tabela 1).
- Dwa podziały i ANOVA 2 × 2 zamiast regresji. Przy skorelowanych predyktorach grozi to pozornym efektem głównym, a przy podziale poza medianą także pozorną interakcją (rysunek 2).
- Szukanie punktu podziału po danych. Mediana, tercyle, górne 25% – każdy wybór daje inny wynik. Próg „optymalny” wybrany na tych samych danych jest obciążony (Royston i in., 2006).
- Kontrola zmiennej w kategoriach. „Wiek kontrolowano w trzech grupach” zostawia część zakłócania w modelu (Austin i Brunner, 2004). Wprowadź zmienną kontrolną jako ciągłą.
- Mediana próby nazwana normą. „Wysoki poziom stresu” to w takim badaniu tylko „wyższy niż u połowy badanych”. Do norm testowych to się nie odnosi.
- Dychotomizacja zmiennej zależnej. Zamiana wyniku na „poprawa/brak poprawy” też odbiera moc. Jeśli kryterium odpowiedzi jest potrzebne, pokaż je obok analizy wyniku ciągłego.
Przykład i symulacje w R
Przepis 1 tworzy dane z przykładu i porównuje regresję na zmiennych ciągłych z ANOVA 2 × 2 po dwóch podziałach medianą. Przepis 2 zawiera trzy symulacje: moc przy podziale (tabela 1), stratę zależną od miejsca podziału (rysunek 1) i odsetek fałszywie istotnych wyników (rysunek 2). Przepis 3 rysuje oba rysunki. Wszystko działa w bazowym R, a rysunki wymagają pakietów ggplot2, patchwork i svglite.
1. Jeden zbiór: regresja a ANOVA po podziale medianą
R
# B316 – jeden zbiór, dwie analizy: zmienne ciągłe w regresji a podział medianą i ANOVA 2 × 2
# Dane symulowane, set.seed(3161): 160 osób studiujących. Perfekcjonizm i lęk przed oceną
# (wyniki skal 0–40) są skorelowane; prokrastynacja (0–50) zależy w populacji TYLKO od perfekcjonizmu.
set.seed(3161)
n <- 160
z1 <- rnorm(n); z2 <- 0.6 * z1 + sqrt(1 - 0.6^2) * rnorm(n)        # korelacja predyktorów w populacji .60
perfekcjonizm <- round(20 + 6 * z1, 1)
lek_oceny <- round(20 + 6 * z2, 1)
prokrastynacja <- round(25 + 0.6 * (perfekcjonizm - 20) + rnorm(n, 0, 6), 1)   # lęk nie ma własnego efektu
dane <- data.frame(perfekcjonizm, lek_oceny, prokrastynacja)
write.csv(dane, "../dychotomizacja-dane-przyklad.csv", row.names = FALSE, fileEncoding = "UTF-8")

# 1. Korelacja perfekcjonizmu z prokrastynacją przed podziałem i po podziale medianą
dane$perf_gr <- factor(ifelse(dane$perfekcjonizm > median(dane$perfekcjonizm), "wysoki", "niski"), levels = c("niski", "wysoki"))
dane$lek_gr  <- factor(ifelse(dane$lek_oceny > median(dane$lek_oceny), "wysoki", "niski"), levels = c("niski", "wysoki"))
r_c <- cor.test(dane$perfekcjonizm, dane$prokrastynacja)
r_g <- cor.test(as.numeric(dane$perf_gr == "wysoki"), dane$prokrastynacja)
print(round(c(r_predyktorow = cor(dane$perfekcjonizm, dane$lek_oceny),
              r_ciagla = unname(r_c$estimate), CI_dol = r_c$conf.int[1], CI_gor = r_c$conf.int[2],
              r_po_podziale = unname(r_g$estimate), CI_dol = r_g$conf.int[1], CI_gor = r_g$conf.int[2]), 3))

# 2. Regresja na zmiennych ciągłych: efekt lęku przy kontroli perfekcjonizmu
m_c <- lm(prokrastynacja ~ perfekcjonizm + lek_oceny, data = dane)
print(round(cbind(coef(summary(m_c)), confint(m_c)), 3))

# 3. Ta sama hipoteza po dwóch podziałach medianą: ANOVA 2 × 2 (efekty główne typu II = drop1 z modelu addytywnego)
print(table(perfekcjonizm = dane$perf_gr, lek = dane$lek_gr))
m_g <- lm(prokrastynacja ~ perf_gr + lek_gr, data = dane)
print(drop1(m_g, test = "F"))
print(round(cbind(coef(summary(m_g)), confint(m_g)), 3))
print(anova(m_g, lm(prokrastynacja ~ perf_gr * lek_gr, data = dane)))          # test interakcji
print(round(tapply(dane$perfekcjonizm, dane$lek_gr, mean), 2))                   # perfekcjonizm w grupach lęku
print(round(sapply(split(dane$perfekcjonizm, dane$perf_gr:dane$lek_gr), mean), 2))  # perfekcjonizm w komórkach
Wynik w R
r_predyktorow      r_ciagla        CI_dol        CI_gor r_po_podziale        CI_dol        CI_gor
        0.594         0.572         0.457         0.668         0.460         0.328         0.574
              Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)     13.585      1.867   7.276    0.000  9.897 17.273
perfekcjonizm    0.688      0.092   7.473    0.000  0.506  0.870
lek_oceny       -0.077      0.105  -0.728    0.468 -0.285  0.131
             lek
perfekcjonizm niski wysoki
       niski     56     24
       wysoki    24     56
Single term deletions

Model:
prokrastynacja ~ perf_gr + lek_gr
        Df Sum of Sq    RSS    AIC F value    Pr(>F)
<none>               6739.3 604.49
perf_gr  1    1251.6 7990.9 629.74 29.1576 2.425e-07 ***
lek_gr   1      93.7 6833.0 604.69  2.1829    0.1416
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
              Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 %
(Intercept)     22.329      0.807  27.663    0.000 20.735 23.923
perf_grwysoki    6.103      1.130   5.400    0.000  3.871  8.336
lek_grwysoki     1.670      1.130   1.477    0.142 -0.563  3.902
Analysis of Variance Table

Model 1: prokrastynacja ~ perf_gr + lek_gr
Model 2: prokrastynacja ~ perf_gr * lek_gr
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1    157 6739.3
2    156 6725.5  1    13.822 0.3206 0.5721
 niski wysoki
 17.20  23.92
  niski:niski  niski:wysoki  wysoki:niski wysoki:wysoki
        14.20         17.42         24.22         26.71
2. Symulacje: moc, miejsce podziału i fałszywie istotne wyniki
R
# B316 – symulacje: moc przy podziale, miejsce podziału i fałszywie istotne wyniki po dwóch podziałach
# set.seed(3162); rozkład normalny; każdy wiersz to osobna seria symulowanych prób.
set.seed(3162)
podziel <- function(x, q = 0.5) as.numeric(x > quantile(x, q))       # 1 = grupa „wysoka”
para <- function(n, rho) { z1 <- rnorm(n); cbind(z1, rho * z1 + sqrt(1 - rho^2) * rnorm(n)) }

# 1. Moc testu korelacji rho = .30 (alfa = .05): zmienna ciągła, podział medianą, podział 80/20
moc <- t(sapply(c(40, 80, 150), function(n) {
  w <- replicate(5000, {
    xy <- para(n, 0.30); x <- xy[, 1]; y <- xy[, 2]
    c(r_ciagla = cor(x, y), r_mediana = cor(podziel(x), y), r_80_20 = cor(podziel(x, 0.8), y),
      p_ciagla = cor.test(x, y)$p.value, p_mediana = cor.test(podziel(x), y)$p.value,
      p_80_20 = cor.test(podziel(x, 0.8), y)$p.value)
  })
  c(n = n, rowMeans(w[1:3, ]), moc = rowMeans(w[4:6, ] < .05))
}))
print(round(moc, 3))

# 2. Ile zostaje z r^2 zależnie od miejsca podziału (teoria dla rozkładu normalnego + symulacja n = 200)
gora <- c(0.50, 0.40, 0.30, 0.20, 0.10, 0.05)                        # odsetek osób w grupie „wysokiej”
teoria <- dnorm(qnorm(1 - gora))^2 / (gora * (1 - gora))           # (r_pb / r)^2
symul <- sapply(gora, function(g) mean(replicate(2000, {
  xy <- para(200, 0.30); cor(podziel(xy[, 1], 1 - g), xy[, 2])
}))^2 / 0.30^2)
miejsce <- data.frame(proc_wysokich = 100 * gora, zostaje_r2_teoria = teoria, zostaje_r2_symul = symul,
                      jak_utrata_proc_osob = 100 * (1 - teoria))
print(round(miejsce, 3))

# 3. Fałszywie istotne wyniki (alfa = .05), korelacja predyktorów .50, 2000 prób na liczebność
# A: Y zależy tylko od X1 (beta = .50); test efektu X2 po kontroli X1
# B: Y = .50 X1 + .50 X2, bez interakcji; test interakcji X1 × X2
fp <- t(sapply(c(50, 100, 200, 400), function(n) {
  w <- replicate(2000, {
    x <- para(n, 0.50); x1 <- x[, 1]; x2 <- x[, 2]
    ya <- 0.5 * x1 + rnorm(n, 0, sqrt(0.75))
    yb <- 0.5 * x1 + 0.5 * x2 + rnorm(n, 0, 0.5)
    t1 <- cut(x1, quantile(x1, c(0, 1/3, 2/3, 1)), include.lowest = TRUE)          # tercyle zmiennej kontrolnej
    g1 <- podziel(x1); g2 <- podziel(x2); h1 <- podziel(x1, 0.7); h2 <- podziel(x2, 0.7)
    c(A_regresja = coef(summary(lm(ya ~ x1 + x2)))["x2", 4],
      A_anova_mediana = coef(summary(lm(ya ~ g1 + g2)))["g2", 4],
      A_kontrola_tercyle = coef(summary(lm(ya ~ t1 + x2)))["x2", 4],
      B_regresja = coef(summary(lm(yb ~ x1 * x2)))["x1:x2", 4],
      B_anova_mediana = coef(summary(lm(yb ~ g1 * g2)))["g1:g2", 4],
      B_anova_gorne30 = coef(summary(lm(yb ~ h1 * h2)))["h1:h2", 4])
  })
  c(n = n, rowMeans(w < .05))
}))
print(round(fp, 3))
Wynik w R
       n r_ciagla r_mediana r_80_20 moc.p_ciagla moc.p_mediana moc.p_80_20
[1,]  40    0.294     0.233   0.207        0.469         0.307       0.251
[2,]  80    0.299     0.237   0.207        0.775         0.576       0.458
[3,] 150    0.300     0.240   0.211        0.966         0.850       0.751
  proc_wysokich zostaje_r2_teoria zostaje_r2_symul jak_utrata_proc_osob
1            50             0.637            0.631               36.338
2            40             0.622            0.609               37.808
3            30             0.576            0.588               42.433
4            20             0.490            0.492               51.013
5            10             0.342            0.340               65.778
6             5             0.224            0.222               77.606
       n A_regresja A_anova_mediana A_kontrola_tercyle B_regresja B_anova_mediana B_anova_gorne30
[1,]  50      0.058           0.088              0.080      0.050           0.040           0.046
[2,] 100      0.056           0.116              0.099      0.049           0.042           0.067
[3,] 200      0.047           0.190              0.151      0.052           0.038           0.099
[4,] 400      0.048           0.325              0.234      0.045           0.039           0.168
3. Rysunki 1 i 2
R
# B316 – rysunki do wpisu /blog/dychotomizacja-zmiennych-ciaglych/
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b316-rysunki.R
# Podgląd PNG trafia do katalogu ze zmiennej PNG_DIR (domyślnie katalog tymczasowy).
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", trzeci = "#7CAE00", granat = "#0f1d3a", bursztyn = "#E8A317")
theme_metodolog <- function(base_size = 14) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: width=\"%d\" height=\"%d\"\n", plik, round(szer * 100), round(wys * 100)))
}
podglad_png <- function(plik_svg, katalog = Sys.getenv("PNG_DIR", tempdir())) {
  if (requireNamespace("magick", quietly = TRUE))
    magick::image_write(magick::image_read_svg(plik_svg, width = 1100), file.path(katalog, sub("\\.svg$", ".png", basename(plik_svg))))
}
proc <- function(x) paste0(round(100 * x), "%")
invisible(capture.output(source("b316-2-symulacje.R")))   # obiekty: miejsce, fp (ok. 30 s)

# Rysunek 1: ile zostaje z r^2 zależnie od tego, gdzie przetniesz zmienną
m <- miejsce
p1 <- ggplot(m, aes(proc_wysokich)) +
  geom_line(aes(y = zostaje_r2_teoria), colour = KOLORY[["drugi"]], linewidth = 1.1) +
  geom_point(aes(y = zostaje_r2_symul), colour = KOLORY[["akcent"]], size = 3) +
  geom_text(aes(y = zostaje_r2_teoria, label = sprintf("jak utrata\n%d%% osób", round(jak_utrata_proc_osob))),
            nudge_y = 0.085, size = 3.4, colour = "grey20", lineheight = 0.9) +
  geom_hline(yintercept = 1, linetype = "dashed", colour = "grey50") +
  annotate("text", x = 27.5, y = 0.97, label = "zmienna ciągła = 100% informacji", colour = "grey35", size = 3.6) +
  scale_x_reverse(breaks = m$proc_wysokich, labels = function(x) paste0(x, "%")) +
  scale_y_continuous(limits = c(0, 1.02), breaks = seq(0, 1, 0.2), labels = proc) +
  labs(title = "Im dalej od mediany przetniesz zmienną, tym więcej tracisz",
       subtitle = "Linia: wzór dla rozkładu normalnego; punkty: średnia z 2000 symulowanych prób (n = 200, ρ = .30)",
       x = "Odsetek osób zaliczonych do grupy „wysokiej” (50% = podział medianą)",
       y = "Część r² zachowana po podziale") +
  theme_metodolog(13)
zapisz_svg(p1, "../dychotomizacja-utrata-informacji.svg", szer = 10, wys = 5.6)
podglad_png("../dychotomizacja-utrata-informacji.svg")

# Rysunek 2: odsetek fałszywie istotnych wyników po dwóch podziałach
d <- as.data.frame(fp)
dl <- function(kol, nazwy) do.call(rbind, lapply(seq_along(kol), function(i)
  data.frame(n = d$n, analiza = nazwy[i], odsetek = d[[kol[i]]])))
a <- dl(c("A_regresja", "A_kontrola_tercyle", "A_anova_mediana"),
        c("regresja na zmiennych ciągłych", "X1 jako kontrola w tercylach", "ANOVA 2 × 2 po podziale medianą"))
b <- dl(c("B_regresja", "B_anova_mediana", "B_anova_gorne30"),
        c("regresja na zmiennych ciągłych", "ANOVA 2 × 2 po podziale medianą", "ANOVA 2 × 2, „wysocy” = górne 30%"))
kol <- c("regresja na zmiennych ciągłych" = KOLORY[["drugi"]], "X1 jako kontrola w tercylach" = KOLORY[["bursztyn"]],
         "ANOVA 2 × 2 po podziale medianą" = KOLORY[["akcent"]], "ANOVA 2 × 2, „wysocy” = górne 30%" = KOLORY[["granat"]])
panel <- function(dd, tytul) {
  ggplot(dd, aes(n, odsetek, colour = analiza)) +
    geom_hline(yintercept = 0.05, linetype = "dashed", colour = "grey45") +
    geom_line(linewidth = 1) + geom_point(size = 2.6) +
    scale_colour_manual(values = kol, name = NULL) +
    scale_x_continuous(breaks = c(50, 100, 200, 400), trans = "log2") +
    scale_y_continuous(limits = c(0, 0.35), breaks = seq(0, 0.35, 0.05), labels = proc) +
    labs(title = tytul, x = "Liczebność próby (n)", y = "Odsetek wyników p < .05") +
    theme_metodolog(12) + guides(colour = guide_legend(ncol = 1))
}
p2 <- panel(a, "A. Pozorny efekt X2 (prawdziwy efekt = 0)") +
  panel(b, "B. Pozorna interakcja X1 × X2 (prawdziwa = 0)") +
  plot_annotation(subtitle = "Korelacja predyktorów .50; 2000 prób na każdą liczebność; linia przerywana = nominalne 5%",
                  theme = theme(plot.subtitle = element_text(colour = "grey30")))
zapisz_svg(p2, "../dychotomizacja-falszywe-efekty.svg", szer = 11, wys = 6)
podglad_png("../dychotomizacja-falszywe-efekty.svg")
Wynik w R
Zapisano ../dychotomizacja-utrata-informacji.svg: width="1000" height="560"
Zapisano ../dychotomizacja-falszywe-efekty.svg: width="1100" height="600"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki powstały w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy po podziale zmiennej na grupy wynik może być istotny, choć efektu nie ma?
Tak, gdy dzielisz dwa skorelowane predyktory albo zmienną kontrolną. W naszej symulacji, przy korelacji predyktorów .50 i n = 400, ANOVA 2 × 2 po podziale obu zmiennych medianą wykazała nieistniejący efekt w 32.5% prób zamiast 5%. Opisali to Maxwell i Delaney (1993), a dla zmiennej zakłócającej podzielonej na kategorie – Austin i Brunner (2004).
Czy podział na górne 25% jest lepszy niż podział medianą?
Nie, jest gorszy. Im dalej od mediany leży punkt podziału, tym więcej informacji tracisz. Przy grupie „wysokiej” liczącej 20% próby zostaje około 49% wyjaśnianej wariancji, a przy 10% – około 34% (Cohen, 1983, opisał ten wzrost strat). Przy dwóch zmiennych podzielonych poza medianą może też pojawić się pozorna interakcja (Thoresen, 2019).
Kiedy wolno podzielić wynik kwestionariusza na dwie grupy?
Gdy próg pochodzi spoza Twojej próby i ma znaczenie merytoryczne, np. jest punktem odcięcia z badania walidacyjnego. Tak jest w PHQ-9, gdzie wynik 10 lub więcej wskazuje na prawdopodobną dużą depresję (Kroenke i in., 2001). Nawet wtedy analizę główną prowadź na wyniku ciągłym, a odsetek osób powyżej progu podaj jako uzupełnienie.
Czym zastąpić ANOVA 2 × 2 po podziale dwóch zmiennych?
Regresją wieloraką z oboma predyktorami jako zmiennymi ciągłymi, a jeśli pytasz o interakcję – dodaj ich iloczyn po wycentrowaniu. Efekty proste możesz pokazać dla średniej ± 1 SD moderatora, co daje czytelność podobną do grup bez utraty danych.
Czy grupy wysoka i niska mogę pokazać chociaż na wykresie?
Tak, jako opis. Analizę testującą hipotezę wykonaj na zmiennych ciągłych, a grupy pokaż w tabeli opisowej lub na wykresie z jasną informacją, że granicą jest mediana próby. Mediany próby nie nazywaj normą ani progiem klinicznym.
Powiązane hasła
Przeczytaj też
Podział na medianie – wizualizacja
Schodek zamiast prostej, 1000 badań przed podziałem i po nim, krzywe mocy, pozorny efekt przy dwóch podziałach i mediana a próg – pięć rysunków z kodem R.
Czytaj →PoradnikNieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →Promotor chce grup „wysokich” i „niskich”?
Sprawdzimy plan analizy, zaproponujemy model na zmiennych ciągłych, który odpowie na to samo pytanie, i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C., & Brunner, L. J. (2004). Inflation of the type I error rate when a continuous confounding variable is categorized in logistic regression analyses. Statistics in Medicine, 23(7), 1159–1178. https://doi.org/10.1002/sim.1687
- Cohen, J. (1983). The cost of dichotomization. Applied Psychological Measurement, 7(3), 249–253. https://doi.org/10.1177/014662168300700301 ● Otwarty dostęp: pełny tekst
- Iacobucci, D., Posavac, S. S., Kardes, F. R., Schneider, M. J., & Popovich, D. L. (2015). Toward a more nuanced understanding of the statistical properties of a median split. Journal of Consumer Psychology, 25(4), 652–665. https://doi.org/10.1016/j.jcps.2014.12.002 ● Otwarty dostęp: pełny tekst
- Kroenke, K., Spitzer, R. L., & Williams, J. B. W. (2001). The PHQ-9: Validity of a brief depression severity measure. Journal of General Internal Medicine, 16(9), 606–613. https://doi.org/10.1046/j.1525-1497.2001.016009606.x ● Otwarty dostęp: pełny tekst
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- Maxwell, S. E., & Delaney, H. D. (1993). Bivariate median splits and spurious statistical significance. Psychological Bulletin, 113(1), 181–190. https://doi.org/10.1037/0033-2909.113.1.181
- McClelland, G. H., Lynch, J. G., Jr., Irwin, J. R., Spiller, S. A., & Fitzsimons, G. J. (2015). Median splits, Type II errors, and false–positive consumer psychology: Don't fight the power. Journal of Consumer Psychology, 25(4), 679–689. https://doi.org/10.1016/j.jcps.2015.05.006 ● Otwarty dostęp: pełny tekst
- Preacher, K. J., Rucker, D. D., MacCallum, R. C., & Nicewander, W. A. (2005). Use of the extreme groups approach: A critical reexamination and new recommendations. Psychological Methods, 10(2), 178–192. https://doi.org/10.1037/1082-989x.10.2.178 ● Otwarty dostęp: pełny tekst
- Royston, P., Altman, D. G., & Sauerbrei, W. (2006). Dichotomizing continuous predictors in multiple regression: A bad idea. Statistics in Medicine, 25(1), 127–141. https://doi.org/10.1002/sim.2331
- Thoresen, M. (2019). Spurious interaction as a result of categorization. BMC Medical Research Methodology, 19(1), Article 28. https://doi.org/10.1186/s12874-019-0667-2 ● Otwarty dostęp
Cytowania BibTeX
@article{austin2004inflation, author={Austin, Peter C. and Brunner, Lawrence J.}, title={{Inflation of the type I error rate when a continuous confounding variable is categorized in logistic regression analyses}}, journal={Statistics in Medicine}, year={2004}, volume={23}, number={7}, pages={1159--1178}, doi={10.1002/sim.1687}}@article{cohen1983cost, author={Cohen, Jacob}, title={{The cost of dichotomization}}, journal={Applied Psychological Measurement}, year={1983}, volume={7}, number={3}, pages={249--253}, doi={10.1177/014662168300700301}}@article{iacobucci2015toward, author={Iacobucci, Dawn and Posavac, Steven S. and Kardes, Frank R. and Schneider, Matthew J. and Popovich, Deidre L.}, title={{Toward a more nuanced understanding of the statistical properties of a median split}}, journal={Journal of Consumer Psychology}, year={2015}, volume={25}, number={4}, pages={652--665}, doi={10.1016/j.jcps.2014.12.002}}@article{kroenke2001phq9, author={Kroenke, Kurt and Spitzer, Robert L. and Williams, Janet B. W.}, title={{The PHQ-9: Validity of a brief depression severity measure}}, journal={Journal of General Internal Medicine}, year={2001}, volume={16}, number={9}, pages={606--613}, doi={10.1046/j.1525-1497.2001.016009606.x}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{maxwell1993bivariate, author={Maxwell, Scott E. and Delaney, Harold D.}, title={{Bivariate median splits and spurious statistical significance}}, journal={Psychological Bulletin}, year={1993}, volume={113}, number={1}, pages={181--190}, doi={10.1037/0033-2909.113.1.181}}@article{mcclelland2015median, author={McClelland, Gary H. and Lynch, Jr., John G. and Irwin, Julie R. and Spiller, Stephen A. and Fitzsimons, Gavan J.}, title={{Median splits, Type II errors, and false–positive consumer psychology: Don't fight the power}}, journal={Journal of Consumer Psychology}, year={2015}, volume={25}, number={4}, pages={679--689}, doi={10.1016/j.jcps.2015.05.006}}@article{preacher2005use, author={Preacher, Kristopher J. and Rucker, Derek D. and MacCallum, Robert C. and Nicewander, W. Alan}, title={{Use of the extreme groups approach: A critical reexamination and new recommendations}}, journal={Psychological Methods}, year={2005}, volume={10}, number={2}, pages={178--192}, doi={10.1037/1082-989x.10.2.178}}@article{royston2006dichotomizing, author={Royston, Patrick and Altman, Douglas G. and Sauerbrei, Willi}, title={{Dichotomizing continuous predictors in multiple regression: A bad idea}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={1}, pages={127--141}, doi={10.1002/sim.2331}}@article{thoresen2019spurious, author={Thoresen, Magne}, title={{Spurious interaction as a result of categorization}}, journal={BMC Medical Research Methodology}, year={2019}, volume={19}, number={1}, eid={28}, doi={10.1186/s12874-019-0667-2}}